27회 실험 · 계산하기 전에 안다#
이 실험
짝 서술 |
|
확인하는 것 |
보조함수의 상쇄를 sympy로 재현한다. 두 나머지항 형태가 같은 값인지 본다. 상계가 실제 오차 위에 있는지 확인한다 |
26회 실험은 오차를 재고 끝났다. 값을 계산한 뒤에야 얼마나 틀렸는지 알 수 있었다.
이 노트북은 다르다. 3절이 계산하기 전에 오차의 상한을 준다. (27.6)이 \(f^{(n+1)}\)의 상계 하나만으로 그것을 하고, 그 상계가 실제 오차 위에 있는지를 표로 확인한다.
1절이 증명의 핵심을 재현한다. 정리 83의 증명은 보조함수를 미분하면 대부분이 상쇄된다는 관찰 하나로 굴러가는데, 그 상쇄를 sympy가 그대로 보여 준다.
서술 파트의 내용 |
여기서 확인하는 방법 |
|---|---|
(27.4)의 상쇄 |
1절이 \(n\)을 바꾸어 가며 미분한다 |
\(n=0\)이 평균값 정리 |
1절이 두 식을 나란히 놓는다 |
2절이 두 형태를 대조한다 |
|
3절이 상계와 실제 오차를 견준다 |
|
5절의 미결 |
4절이 \(M\)이 커지는 예를 본다 |
0. 준비#
# def-26-factorial and def-26-taylor, as in the previous lab
def factorial(n):
    return 1 if n == 0 else n * factorial(n - 1)


def taylor(expr, n, point=0, var=x):
    return sum(sp.diff(expr, var, k).subs(var, point) / sp.factorial(k)
               * (var - point) ** k for k in range(n + 1))
1. 상쇄를 재현한다#
정리 83의 증명이 (27.3)의 \(F\)를 세우고 미분했다. \(n+1\)개의 항에서 이웃한 것끼리 지워지고 하나만 남는다.
sympy 에게 그 미분을 시킨다. \(f\)를 정해진 함수가 아니라 이름만 있는 함수로 두면 상쇄가 계산 규칙만으로 일어나는 것이 보인다.
# (27.3) with an unspecified f: the cancellation is structural
f = sp.Function("f")


def auxiliary(n):
    return f(x) - sum(sp.diff(f(t), t, k) / sp.factorial(k) * (x - t) ** k
                      for k in range(n + 1))


n = 3
print("F(t) =", auxiliary(n))
print()
print("F'(t) =", sp.simplify(sp.diff(auxiliary(n), t)))
F(t) = -(-t + x)**3*Derivative(f(t), (t, 3))/6 - (-t + x)**2*Derivative(f(t), (t, 2))/2 - (-t + x)*Derivative(f(t), t) - f(t) + f(x)

F'(t) = (t - x)**3*Derivative(f(t), (t, 4))/6
\(n+1=4\)개의 항에서 하나만 남았다.
(27.4)와 맞는지 확인한다. 여러 \(n\)에서 돌려 본다.
# (27.4): only the last piece survives, for every n
print(f"{'n':>4} {'F prime matches (27.4)':>26}")
print("-" * 32)
for n in (0, 1, 2, 3, 5, 8):
    expected = -sp.diff(f(t), t, n + 1) / sp.factorial(n) * (x - t) ** n
    matches = sp.simplify(sp.diff(auxiliary(n), t) - expected) == 0
    print(f"{n:>4} {str(matches):>26}")
   n     F prime matches (27.4)
--------------------------------
   0                       True
   1                       True
   2                       True
   3                       True
   5                       True
8 True
여섯 경우 모두 맞는다. \(f\)가 무엇인지 정하지 않았으므로 이 상쇄는 특정 함수의 성질이 아니라 곱의 미분과 연쇄법칙에서 오는 구조이다.
\(n=0\)이면 (27.2)가 평균값 정리가 된다.
# n = 0 gives back thm-18-mvt
n = 0
print("Lagrange remainder at n = 0 :")
print("  R_0(x) = f'(c) (x-p)**1 / 1!")
print("  1! =", factorial(1))
print("  so  R_0(x) = f'(c)(x-p),  which is the mean value theorem")
Lagrange remainder at n = 0 :
  R_0(x) = f'(c) (x-p)**1 / 1!
  1! = 1
  so  R_0(x) = f'(c)(x-p),  which is the mean value theorem
2. 두 형태가 같은 값인가#
정리 83는 \(c\)의 존재만 말하므로 값을 계산할 수 없다. 정리 84은 적분식을 주므로 계산할 수 있다.
적분형이 정말 \(R_n\)과 같은지 확인한다.
# (27.5): the integral form, against R_n = f - T_n computed directly
def integral_form(expr, n, point=0):
    return sp.integrate(
        sp.diff(expr, x, n + 1).subs(x, t) * (x - t) ** n,
        (t, point, x)) / sp.factorial(n)


print(f"{'f':>8} {'n':>3} {'R_n minus integral form':>26}")
print("-" * 40)
for expr, name, n in ((sp.exp(x), "exp", 3),
                      (sp.sin(x), "sin", 4),
                      (sp.cos(x), "cos", 3)):
    direct = sp.simplify(expr - taylor(expr, n))
    theirs = sp.simplify(integral_form(expr, n))
    print(f"{name:>8} {n:>3} {str(sp.simplify(direct - theirs)):>26}")
       f   n    R_n minus integral form
----------------------------------------
     exp   3                          0
     sin   4                          0
     cos   3                          0
세 줄 모두 \(0\)이다. 두 형태가 같은 양을 다르게 적은 것이다.
라그랑주 형태의 \(c\)도 특정한 경우에는 찾을 수 있다. \(f=\exp\), \(p=0\), \(x=1\), \(n=1\)로 두고 (27.2)를 \(c\)에 대해 푼다.
# For a specific case the c of (27.2) can be solved for, though the theorem
# only promises it exists
c = sp.Symbol("c", real=True)
n, point, target = 1, 0, 1

remainder = sp.exp(target) - taylor(sp.exp(x), n).subs(x, target)
equation = sp.Eq(sp.exp(c) / sp.factorial(n + 1) * (target - point) ** (n + 1),
                 remainder)
solutions = [s for s in sp.solve(equation, c) if s.is_real]

print("R_1(1) for exp =", sp.simplify(remainder), "=", float(remainder))
print("solving (27.2) for c :", solutions)
print("c is between 0 and 1 :", [0 < float(s) < 1 for s in solutions])
R_1(1) for exp = -2 + E = 0.7182818284590452
solving (27.2) for c : [log(-4 + 2*E)]
c is between 0 and 1 : [True]
그러나 이것은 답을 이미 아는 경우이다. \(R_1(1)\)을 계산한 뒤에 거꾸로 푼 것이므로, 근사에 쓸 수는 없다.
3. 계산하기 전에 안다#
(27.6)이 오차의 상계를 준다. \(f^{(n+1)}\)의 상계 하나만 있으면 된다.
\(\exp\)를 \([0,0.1]\)에서 본다. 서술 파트가 \(M=1.2\)로 잡았고, 근거는 8회 정리 24가 준 \(\log 1.2 \ge \frac16\)이었다. np.log로 얻은 소수값이 아니다.
아래 셀은 그 부등식을 확인한다. 상합과 하합을 직접 만들어 \(\int_1^{1.2}\frac{dt}{t}\)를 가두고, 하합이 \(\frac16\) 위에 있는지를 본다.
# The bound M = 1.2 rests on log 1.2 >= 1/6, obtained from thm-8-compare
# The constant 5/6 is the lower step function used in the narrative
lo, hi = 1.0, 1.2
steps = 2000
edges = np.linspace(lo, hi, steps + 1)
width = (hi - lo) / steps

# 1/t is decreasing, so the right endpoint gives the lower sum
lower_sum = float(np.sum(1.0 / edges[1:]) * width)
upper_sum = float(np.sum(1.0 / edges[:-1]) * width)
constant_step = (5.0 / 6.0) * (hi - lo)

print(f"lower sum      = {lower_sum:.9f}")
print(f"upper sum      = {upper_sum:.9f}")
print(f"constant 5/6   = {constant_step:.9f}   (this is 1/6)")
print(f"1/6 <= integral : {constant_step <= lower_sum}")
print(f"1/6 > 0.1       : {constant_step > 0.1}")
lower sum      = 0.182313224
upper sum      = 0.182329890
constant 5/6   = 0.166666667   (this is 1/6)
1/6 <= integral : True
1/6 > 0.1       : True
이제 상계를 계산한다. \(e^{0.1}\)의 값을 쓰지 않는다.
# (27.6): the bound needs only M, not the value being approximated
bound_M = 1.2
print(f"{'n':>3} {'bound from (27.6)':>20}")
print("-" * 26)
for n in range(1, 6):
    bound = bound_M * 0.1 ** (n + 1) / factorial(n + 1)
    print(f"{n:>3} {bound:>20.3e}")
  n    bound from (27.6)
--------------------------
  1            6.000e-03
  2            2.000e-04
  3            5.000e-06
  4            1.000e-07
  5            1.667e-09
이 표를 만드는 데 \(e^{0.1}\)이 필요하지 않았다. 26회 실험은 값을 계산한 뒤 뺄셈으로 오차를 얻었는데, 여기서는 곱셈과 나눗셈만 했다.
이제 실제 오차와 견준다.
# The bound sits above the actual error, and in the same decade
target = np.exp(0.1)
print(f"{'n':>3} {'bound':>14} {'actual':>14} {'bound >= actual':>16} {'ratio':>8}")
print("-" * 60)

partial = 1.0
for n in range(1, 6):
    partial += 0.1 ** n / factorial(n)
    actual = abs(target - partial)
    bound = bound_M * 0.1 ** (n + 1) / factorial(n + 1)
    print(f"{n:>3} {bound:>14.3e} {actual:>14.3e} "
          f"{str(bound >= actual):>16} {bound / actual:>8.2f}")
  n          bound         actual  bound >= actual    ratio
------------------------------------------------------------
  1      6.000e-03      5.171e-03             True     1.16
  2      2.000e-04      1.709e-04             True     1.17
  3      5.000e-06      4.251e-06             True     1.18
  4      1.000e-07      8.474e-08             True     1.18
  5      1.667e-09      1.409e-09             True     1.18
넷째 열이 모두 참이다. 그리고 마지막 열이 \(1.2\) 근처이므로 상계가 실제 오차보다 조금만 크다.
서술 파트가 소수 다섯째 자리까지 맞추려면 몇 차가 필요한지 물었다.
# Which n guarantees five correct decimals
for n in range(1, 6):
    bound = bound_M * 0.1 ** (n + 1) / factorial(n + 1)
    print(f"  n = {n} : bound {bound:.3e}   below 5e-6 : {bound < 5e-6}")
  n = 1 : bound 6.000e-03   below 5e-6 : False
  n = 2 : bound 2.000e-04   below 5e-6 : False
  n = 3 : bound 5.000e-06   below 5e-6 : False
  n = 4 : bound 1.000e-07   below 5e-6 : True
  n = 5 : bound 1.667e-09   below 5e-6 : True
\(n=3\)의 상계가 정확히 \(5\times10^{-6}\)이라 아슬아슬하고, \(n=4\)면 확실하다.
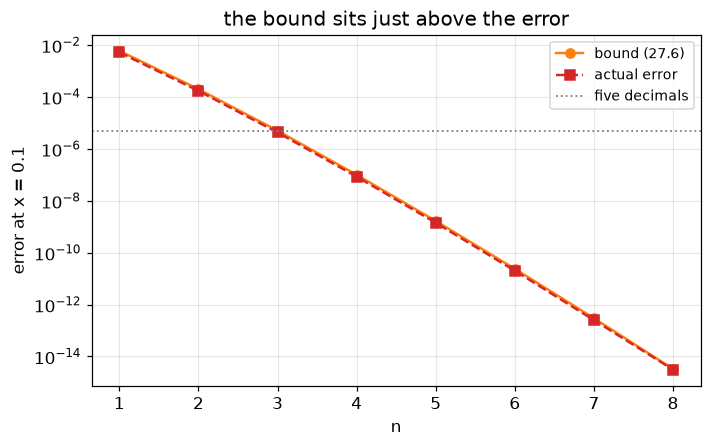
두 선이 나란히 내려간다. 점선 아래로 내려가는 첫 지점이 상계는 \(n=4\)이고 실제 오차는 \(n=3\)이다. 상계가 한 칸 보수적이다.
4. 상계가 커지는 경우#
서술 파트 5절이 결론을 내지 않았다. \((n+1)!\)이 커지지만 \(M\)도 커질 수 있기 때문이다.
\(\exp\)에서는 모든 도함수가 같아 \(M\)이 변하지 않았다. 그렇지 않은 예를 본다.
# For 1/(1-x) the derivatives grow: the n-th is n!/(1-x)**(n+1)
expr = 1 / (1 - x)
print(f"{'k':>3} {'k-th derivative':>26}")
print("-" * 32)
for k in range(4):
    print(f"{k:>3} {str(sp.simplify(sp.diff(expr, x, k))):>26}")
  k            k-th derivative
--------------------------------
  0                 -1/(x - 1)
  1              (x - 1)**(-2)
  2              -2/(x - 1)**3
  3               6/(x - 1)**4
\(f^{(k)}(x) = \dfrac{k!}{(1-x)^{k+1}}\)이다. \([0, 0.5]\)에서 최댓값은 \(x=0.5\)에서 나온다.
# M itself grows with n, and it grows fast
print(f"{'n':>3} {'M = (n+1)!/0.5**(n+2)':>24} {'bound (27.6)':>16}")
print("-" * 46)
for n in range(1, 7):
    bound_m = factorial(n + 1) / 0.5 ** (n + 2)
    bound = bound_m * 0.5 ** (n + 1) / factorial(n + 1)
    print(f"{n:>3} {bound_m:>24.4e} {bound:>16.4f}")
  n    M = (n+1)!/0.5**(n+2)     bound (27.6)
----------------------------------------------
  1               1.6000e+01           2.0000
  2               9.6000e+01           2.0000
  3               7.6800e+02           2.0000
  4               7.6800e+03           2.0000
  5               9.2160e+04           2.0000
  6               1.2902e+06           2.0000
상계가 줄어들지 않는다. \(M\)의 \((n+1)!\)이 분모의 \((n+1)!\)과 정확히 지워지고 \(0.5^{n+1}\)과 \(0.5^{n+2}\)만 남기 때문이다.
그런데 실제 오차는 어떤가.
# The actual error does fall, so the bound is simply loose here
target = 1 / (1 - 0.5)
print(f"{'n':>3} {'T_n(0.5)':>16} {'actual error':>16}")
print("-" * 38)
partial = 0.0
for n in range(7):
    partial += 0.5 ** n
    if n >= 1:
        print(f"{n:>3} {partial:>16.9f} {abs(target - partial):>16.3e}")
  n         T_n(0.5)     actual error
--------------------------------------
  1      1.500000000        5.000e-01
  2      1.750000000        2.500e-01
  3      1.875000000        1.250e-01
  4      1.937500000        6.250e-02
  5      1.968750000        3.125e-02
  6      1.984375000        1.562e-02
실제 오차는 줄어든다. 26회 (26.7)이 이 함수에서만 \(R_n(x)=\frac{x^{n+1}}{1-x}\)을 주었고, \(x=0.5\)에서 그 값이 \(2\cdot0.5^{n+1}\)이다.
마치며#
\(f\)를 정하지 않은 채로 (27.3)을 미분했더니 여섯 가지 \(n\)에서 모두 (27.4)가 나왔다. 상쇄가 특정 함수의 성질이 아니라 곱의 미분과 연쇄법칙에서 오는 구조이다.
적분형과 \(R_n = f-T_n\)이 세 함수에서 모두 같았다. 두 형태가 같은 양을 다르게 적은 것이다.
3절이 이 노트북의 요점이었다. 상계를 계산하는 데 \(e^{0.1}\)의 값이 필요하지 않았고, 그 상계가 실제 오차 위에 있으면서 \(1.2\)배 안쪽이었다. 26회는 값을 계산한 뒤 오차를 알았고 27회는 계산하기 전에 안다.
\(\frac{1}{1-x}\)에서는 \(M\)이 커져 상계가 줄지 않았다. 그런데 실제 오차는 줄었다. 상계가 느슨한 것이지 근사가 나쁜 것이 아니다.
더 해 볼 것#
1절의
auxiliary에서 \(n=12\)를 넣어 보자. 항이 열셋인데 미분 결과에 몇 항이 남는가.3절의 구간을 \([0,1]\)로 바꾸어 \(e^1\)을 근사해 보자. \(M\)을 얼마로 잡아야 하는가. 다섯째 자리까지 맞추려면 \(n\)이 얼마여야 하는가.
2절의 \(c\) 풀이를 \(n=2\), \(n=3\)에서 해 보자. \(c\)가 \(n\)에 따라 달라지는가. 서술 파트의 흔한 오해 상자와 맞는가.
4절의 구간을 \([0, 0.9]\)로 바꾸면 상계와 실제 오차가 어떻게 되는가. \([0,0.1]\)에서는 어떠한가.
짝이 되는 서술