8회 실험 · 리만 조건#
이 실험
짝 서술 |
|
확인하는 것 |
허용오차가 먼저 정해지고 계단함수 쌍은 그다음에 찾는다는 순서 |
서술 파트에서 정리 25을 얻었다. 조건은 “임의의 \(\epsilon > 0\)에 대하여 \(s \le f \le t\)이고 \(\int_a^b (t-s) < \epsilon\)인 계단함수 \(s\), \(t\)가 존재한다”는 형태이다. 3절에서는 이것을 \(n\)등분 분할에 맞추어 \(U_n - L_n < \epsilon\)인 \(n\)이 존재하는지 보는 형태로 바꾸었다.
이 형태는 코드로 옮기기 좋다. \(\epsilon\)은 함수의 인자가 되고 \(n\)은 반환값이 된다. 인자와 반환값의 방향이 곧 양화사의 순서이다. 서술 파트의 “흔한 오해 — \(\epsilon\)과 계단함수의 순서”에서 지적한 것을 함수 서명(signature) 하나로 확인할 수 있다.
여기서는 상합과 하합을 직접 만드는 것부터 시작한다. 7회 6절의 \(f(x)=x^2\)을 쓰고, 계산한 값이 (7.15)와 (7.17)에 맞는지 대조한다. 그다음 \(\epsilon\)을 주고 \(n\)을 찾는 함수를 쓴 뒤, 같은 \(n\)을 sympy로 정확히 풀어 둘을 비교한다. 마지막으로 조건이 성립하지 않는 함수를 하나 만들어 본다.
서술 파트의 내용 |
여기서 확인하는 방법 |
|---|---|
상합과 하합을 손으로 만들어 식과 자릿수까지 대조한다 |
|
정리 25의 양화사 순서 |
|
3절의 \(U_n - L_n < \epsilon\) 형태 |
\(n\)을 늘리며 차이가 허용 범위 띠 안으로 들어가는 지점을 그린다 |
부등호가 엄격하다는 점 |
sympy로 \(1/n < \epsilon\)을 풀고 올림값과 비교한다 |
3절 “충분조건만 준다” |
차이가 줄지 않는 함수를 하나 만들어 본다 |
0. 준비#
이 회차에서 쓸 것만 불러온다. 색은 상수로 고정한다. 바깥쪽(상합)과 안쪽(하합)을 서로 다른 색으로 두어야 겹쳐 그렸을 때 구분이 된다.
1. 상합과 하합을 손으로 만든다#
7회 정의 11의 분할과 정의 13의 계단함수 적분을 그대로 코드로 옮긴다. 분할은 분할점 배열이고, 계단함수의 적분은 높이와 폭을 곱해 더한 것이다.
# Build a partition and the integral of a step function by hand
def partition(a, b, n):
    """Return the n + 1 division points of the equal partition of [a, b]."""
    return np.linspace(a, b, n + 1)


def step_integral(points, heights):
    """Integral of the step function that takes heights[k] on the k-th subinterval."""
    widths = np.diff(points)
    return float(np.sum(np.asarray(heights) * widths))


print("points for n = 4 :", partition(0.0, 1.0, 4))
print("integral of the constant step function 2 on [0, 1] :",
      step_integral(partition(0.0, 1.0, 4), [2.0, 2.0, 2.0, 2.0]))
points for n = 4 : [0.   0.25 0.5  0.75 1.  ]
integral of the constant step function 2 on [0, 1] : 2.0
step_integral이 계산하는 것은 7회 (7.1)의 \(\sum_k s_k (x_k - x_{k-1})\)이다. 상수함수 \(2\)의 적분이 \(2\)로 나오므로 7회 (7.8)의 \(\int_a^b c\,dx = c(b-a)\)와 맞는다.
이제 상합과 하합을 만든다. 각 부분구간에서 \(f\)의 최댓값과 최솟값이 필요한데, 코드에서는 그 구간을 촘촘히 표본추출(sampling)하여 최댓값과 최솟값을 추정한다. 표본 격자에 양 끝점을 포함시키므로, 단조함수라면 이 추정이 실제 최댓값·최솟값과 일치한다.
# Lower and upper sums: sample each subinterval and take its min and max
def lower_upper_sums(f, a, b, n, samples=200):
    """Return (lower, upper) for the equal partition of [a, b] into n pieces.

    f must accept a numpy array. The min and max on each subinterval are
    estimated from a grid of `samples` points that includes both endpoints.
    """
    points = partition(a, b, n)
    left = points[:-1].reshape(n, 1)
    right = points[1:].reshape(n, 1)
    weights = np.linspace(0.0, 1.0, samples).reshape(1, samples)
    grid = left + (right - left) * weights
    values = f(grid)
    return step_integral(points, values.min(axis=1)), step_integral(points, values.max(axis=1))


def f(x):
    return x ** 2


a = 0.0
b = 1.0

lower, upper = lower_upper_sums(f, a, b, 10)
print(f"n = 10 :  L_n = {lower:.6f}   U_n = {upper:.6f}")
n = 10 : L_n = 0.285000 U_n = 0.385000
\(L_{10} = 0.285\), \(U_{10} = 0.385\)이다. 7회 6절 끝에서 (7.15)에 \(b=1\), \(n=10\)을 넣어 얻은 값과 같다.
값 하나가 맞았다고 함수가 맞다고 할 수는 없다. (7.15)를 그대로 코드로 옮겨 여러 \(n\)에서 대조한다.
# Compare the computed sums with formula (7.15) and the gap with formula (7.17)
def lower_formula(b, n):
    return b ** 3 / 3 - b ** 3 / (2 * n) + b ** 3 / (6 * n ** 2)


def upper_formula(b, n):
    return b ** 3 / 3 + b ** 3 / (2 * n) + b ** 3 / (6 * n ** 2)


header = f"{'n':>6} {'L_n':>12} {'(7.15)':>12} {'U_n':>12} {'(7.15)':>12} {'U_n - L_n':>12} {'b**3/n':>12}"
print(header)
print("-" * len(header))
for n in (1, 2, 5, 10, 100, 1000):
    lower, upper = lower_upper_sums(f, a, b, n)
    print(f"{n:>6} {lower:>12.8f} {lower_formula(b, n):>12.8f}"
          f" {upper:>12.8f} {upper_formula(b, n):>12.8f}"
          f" {upper - lower:>12.8f} {b ** 3 / n:>12.8f}")
     n          L_n       (7.15)          U_n       (7.15)    U_n - L_n       b**3/n
------------------------------------------------------------------------------------
     1   0.00000000  -0.00000000   1.00000000   1.00000000   1.00000000   1.00000000
     2   0.12500000   0.12500000   0.62500000   0.62500000   0.50000000   0.50000000
     5   0.24000000   0.24000000   0.44000000   0.44000000   0.20000000   0.20000000
    10   0.28500000   0.28500000   0.38500000   0.38500000   0.10000000   0.10000000
   100   0.32835000   0.32835000   0.33835000   0.33835000   0.01000000   0.01000000
  1000   0.33283350   0.33283350   0.33383350   0.33383350   0.00100000   0.00100000
표본추출로 구한 값과 (7.15)가 소수점 여덟 자리까지 일치한다. 마지막 두 열은 (7.17)의 \(U_n - L_n = b^3/n\)이 성립함을 보여 준다.
\(n=1\) 행에서 (7.15) 열이 -0.00000000으로 찍힌다. 세 항 \(1/3 - 1/2 + 1/6\)이 서로 상쇄되면서 부동소수(floating point) 오차가 남은 것이며 실제 값은 \(0\)이다. 왼쪽 열의 \(L_1 = 0\)과 같은 값이다.
2. \(\epsilon\)이 먼저, \(n\)이 나중#
3절의 형태를 함수로 쓴다. 서명을 보면 eps가 인자이고 n이 반환값이다. \(\epsilon\)을 받아서 \(n\)을 돌려준다. 이 방향이 정리 25의 양화사 순서와 같다.
# The tolerance is the input and the partition count is the output
def required_n(f, a, b, eps, n_max=10 ** 6):
    """Find some n with U_n - L_n < eps by doubling. Not the smallest such n."""
    n = 1
    while n <= n_max:
        lower, upper = lower_upper_sums(f, a, b, n)
        if upper - lower < eps:
            return n, upper - lower
        n *= 2
    return None, None


header = f"{'eps':>10} {'found n':>10} {'U_n - L_n':>14} {'below eps':>12}"
print(header)
print("-" * len(header))
for eps in (0.1, 0.01, 0.001, 0.0001):
    n, gap = required_n(f, a, b, eps)
    print(f"{eps:>10} {n:>10} {gap:>14.10f} {str(gap < eps):>12}")
       eps    found n      U_n - L_n    below eps
-------------------------------------------------
       0.1         16   0.0625000000         True
      0.01        128   0.0078125000         True
     0.001       1024   0.0009765625         True
    0.0001      16384   0.0000610352         True
\(\epsilon\)이 10배 작아질 때마다 찾은 \(n\)이 8배 또는 16배로 커진다. 2의 거듭제곱 중에서만 고르기 때문에 배율이 고르지 않다. 하나의 \(n\)이 모든 \(\epsilon\)에 대하여 통하지 않는다는 것이 이 표가 보여 주는 것이다. 서술 파트에서 \(\exists\, s, t\; \forall \epsilon\)으로 순서를 바꾸면 다른 명제가 된다고 한 것이 이것이다.
required_n이 돌려주는 \(n\)은 조건을 만족하는 아무 \(n\)이지 가장 작은 \(n\)이 아니다. \(1\)에서 시작해 2배씩 늘리므로 조건을 처음 만족하는 2의 거듭제곱에서 멈춘다. 정리 25은 존재만 요구하므로 이것으로 충분하다.
3. 차이가 띠 안으로 들어가는 지점#
\(\epsilon\) 하나를 고정하고 무슨 일이 일어나는지 그려 보자. 왼쪽 그림은 \(n=8\)에서 함수를 위아래로 가둔 계단함수 두 개이다. 바깥쪽(상합)을 먼저 그리고 안쪽(하합)을 그 위에 겹쳐 그린다. 파란 몸통이 하합이고 그 위에 남는 주황 띠가 \(U_n - L_n\)이다.
\(x^2\)은 \([0,1]\)에서 증가하므로 각 부분구간의 최솟값은 왼쪽 끝점, 최댓값은 오른쪽 끝점에서 나온다. 표본추출을 거치지 않고 끝점만 넣어도 같은 값이 나오는지 함께 확인한다.
# One eps, one partition: the outer sum is drawn first and the inner one on top
n = 8
eps = 0.02

points = partition(a, b, n)
left = points[:-1]
right = points[1:]
widths = np.diff(points)
lows = f(left)
highs = f(right)

print("endpoints only    :", step_integral(points, lows), step_integral(points, highs))
print("lower_upper_sums  :", lower_upper_sums(f, a, b, n))

sizes = np.arange(1, 65)
gaps = []
for m in sizes:
    lo, up = lower_upper_sums(f, a, b, int(m))
    gaps.append(up - lo)
gaps = np.array(gaps)
first = int(sizes[np.argmax(gaps < eps)])

fig, axes = plt.subplots(1, 2)

ax = axes[0]
ax.bar(left, highs, width=widths, align="edge",
       color=C_UPPER, alpha=0.55, edgecolor="white", linewidth=0.5, label="upper sum")
ax.bar(left, lows, width=widths, align="edge",
       color=C_LOWER, alpha=0.85, edgecolor="white", linewidth=0.5, label="lower sum")
grid = np.linspace(a, b, 400)
ax.plot(grid, f(grid), color=C_FUNC, linewidth=1.8, label="f(x) = x**2")
gap_here = step_integral(points, highs) - step_integral(points, lows)
ax.set_title(f"n = {n},  U_n - L_n = {gap_here:.4f}")
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.legend(loc="upper left", fontsize=9)

ax = axes[1]
ax.plot(sizes, gaps, color=C_DIFF, marker="o", markersize=3, linewidth=1.2, label="U_n - L_n")
ax.axhspan(0.0, eps, color=C_BAND, alpha=0.25, label=f"below eps = {eps}")
ax.axvline(first, color=C_BAND, linestyle="--", linewidth=1.0)
ax.annotate(f"first n = {first}", xy=(first, eps), xytext=(first - 26, 0.18),
            color=C_DIFF, fontsize=9,
            arrowprops=dict(arrowstyle="->", color=C_BAND, linewidth=0.9))
ax.set_xlabel("n")
ax.set_ylabel("U_n - L_n")
ax.set_title(f"eps = {eps} is fixed first, then n is searched")
ax.set_ylim(0.0, 1.05)
ax.legend(loc="upper right", fontsize=9)

fig.tight_layout()
plt.show()

print(f"first n with U_n - L_n < {eps} : {first}")
endpoints only    : 0.2734375 0.3984375
lower_upper_sums  : (0.2734375, 0.3984375)
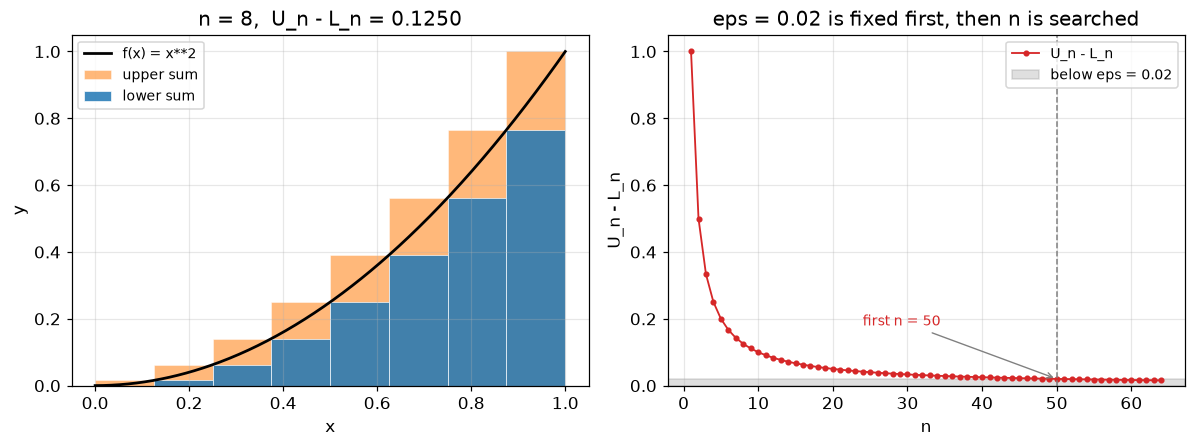
first n with U_n - L_n < 0.02 : 50
끝점만 넣어 만든 값과 lower_upper_sums의 값이 같다. 표본추출이 이 함수에서는 정확한 최댓값·최솟값을 준다는 뜻이다.
오른쪽 그림에서 회색 띠가 허용 범위 \([0, \epsilon)\)이고, 빨간 점이 각 \(n\)에서의 \(U_n - L_n\)이다. 띠는 \(\epsilon\)이 정해질 때 이미 그어져 있고, 점들이 그 안으로 들어가는 \(n\)을 나중에 찾는다. 이 그림에서 순서가 눈에 보인다.
서술 파트 3절에서 \(\epsilon = 0.02\)이면 \(n = 100\)으로 충분하다고 하였다. 여기서는 그보다 훨씬 작은 \(n\)에서 이미 띠 안으로 들어간다. 충분조건이므로 어긋나지 않는다. 다만 코드가 표시한 first n이 정말 최솟값인지는 아직 확인하지 않았다. 다음 절에서 정확히 푼다.
4. 필요한 \(n\)을 식으로 푼다#
수치로 훑는 대신 sympy로 (7.13)의 합을 직접 계산해 보자. 7회에서 4회 정리 12를 써서 손으로 정리한 것을 sympy가 대신한다.
여기서 n, b, eps는 sympy 기호로 다시 묶인다. 앞 절까지 같은 이름이 실수를 가리키고 있었으므로, 이 셀 이후로는 그 값이 남아 있지 않다는 점에 유의한다.
# Redo the sums with sympy. These names now hold symbols, not the earlier floats
k = sp.symbols("k", integer=True)
n = sp.symbols("n", integer=True, positive=True)
b = sp.symbols("b", positive=True)
eps = sp.symbols("eps", positive=True)

lower_sym = sp.expand(sp.simplify(b ** 3 / n ** 3 * sp.summation(k ** 2, (k, 0, n - 1))))
upper_sym = sp.expand(sp.simplify(b ** 3 / n ** 3 * sp.summation(k ** 2, (k, 1, n))))
gap_sym = sp.simplify(upper_sym - lower_sym)

print("L_n       =", lower_sym)
print("U_n       =", upper_sym)
print("U_n - L_n =", gap_sym)
print("matches (7.15) :",
      sp.simplify(lower_sym - (b ** 3 / 3 - b ** 3 / (2 * n) + b ** 3 / (6 * n ** 2))) == 0,
      sp.simplify(upper_sym - (b ** 3 / 3 + b ** 3 / (2 * n) + b ** 3 / (6 * n ** 2))) == 0)
print("matches (7.17) :", sp.simplify(gap_sym - b ** 3 / n) == 0)
L_n       = b**3/3 - b**3/(2*n) + b**3/(6*n**2)
U_n       = b**3/3 + b**3/(2*n) + b**3/(6*n**2)
U_n - L_n = b**3/n
matches (7.15) : True True
matches (7.17) : True
sympy가 (7.15)와 (7.17)을 그대로 재현한다. 이제 \(b=1\)로 두고 조건 \(U_n - L_n < \epsilon\)을 \(n\)에 대하여 푼다.
# Solve the Riemann condition for n on [0, 1]
condition = gap_sym.subs(b, 1) < eps
print("condition :", condition)
print("solution  :", sp.solve(condition, n))
condition : 1/n < eps
solution  : 1/eps < n
해는 \(n > 1/\epsilon\)이다. 부등호가 엄격하므로 \(n = 1/\epsilon\) 자체는 해가 아니다. 따라서 조건을 만족하는 가장 작은 자연수는 \(1/\epsilon\)의 올림값이 아니라
이다. 두 식은 \(1/\epsilon\)이 정수일 때 값이 다르다. 표로 확인한다.
# The inequality is strict, so the boundary value itself fails
header = (f"{'eps':>10} {'floor(1/eps)+1':>16} {'ceil(1/eps)':>13}"
          f" {'strict ok':>11} {'ceil ok':>9} {'doubling n':>12}")
print(header)
print("-" * len(header))
for value in (0.1, 0.01, 0.001, 0.0001):
    exact = sp.Rational(str(value))
    n_min = int(sp.floor(1 / exact) + 1)
    n_ceil = int(sp.ceiling(1 / exact))
    n_found, _ = required_n(f, 0.0, 1.0, value)
    strict_ok = bool(sp.Rational(1, n_min) < exact)
    ceil_ok = bool(sp.Rational(1, n_ceil) < exact)
    print(f"{value:>10} {n_min:>16} {n_ceil:>13} {str(strict_ok):>11} {str(ceil_ok):>9} {n_found:>12}")
       eps   floor(1/eps)+1   ceil(1/eps)   strict ok   ceil ok   doubling n
----------------------------------------------------------------------------
       0.1               11            10        True     False           16
      0.01              101           100        True     False          128
     0.001             1001          1000        True     False         1024
    0.0001            10001         10000        True     False        16384
ceil ok 열이 모두 거짓이다. \(\epsilon = 0.1\)일 때 올림값은 \(10\)이지만 \(1/10 = 0.1\)은 \(0.1\)보다 작지 않다. 부등호 하나가 답을 하나 어긋나게 한다.
마지막 열은 2절의 required_n이 찾은 \(n\)이다. 언제나 \(n_{\min}\)보다 크다. 조건을 만족하는 쌍이 존재하기만 하면 되므로 이것은 문제가 되지 않는다.
이제 3절에서 미룬 것을 확인한다. 그림의 first n은 \(50\)이었는데 위 규칙에 따르면 \(\epsilon = 0.02\)에서 \(n_{\min} = 51\)이어야 한다.
# The scan in the figure said 50, the exact answer says 51
value = 0.02
exact = sp.Rational(str(value))
n_min = int(sp.floor(1 / exact) + 1)
lower, upper = lower_upper_sums(f, 0.0, 1.0, 50)

print("exact smallest n       :", n_min)
print("exact gap at n = 50    :", sp.Rational(1, 50), "=", float(sp.Rational(1, 50)))
print("computed gap at n = 50 :", repr(upper - lower))
print("computed gap < 0.02    :", upper - lower < value)
print("exact gap    < 0.02    :", bool(sp.Rational(1, 50) < exact))
exact smallest n       : 51
exact gap at n = 50    : 1/50 = 0.02
computed gap at n = 50 : 0.019999999999999962
computed gap < 0.02    : True
exact gap    < 0.02    : False
정확한 값으로 \(1/50 = 0.02\)이므로 \(n=50\)은 조건을 만족하지 않는다. 그런데 lower_upper_sums가 계산한 차이는 \(0.019999999999999962\)이다. 곱셈과 덧셈을 50번 반복하는 동안 쌓인 부동소수 오차가 참값보다 \(4\times10^{-17}\)쯤 아래에 값을 떨어뜨렸고, 엄격한 부등호가 그 차이를 그대로 받아들였다.
경계에서는 수치 비교를 믿지 않는다
\(50\)과 \(51\)의 차이는 부등호의 엄격함에서 나오는 것이지 계산의 정확도에서 나오는 것이 아니다. 수치로 얻은 값이 경계에 붙어 있을 때는 어느 쪽으로 떨어질지 부동소수 오차가 정한다.
이 실험에서는 sympy의 Rational로 정확한 값을 따로 구해 두어 판정을 맡겼다. 경계값이 답을 가르는 곳에서는 이렇게 두 방식을 대조해 두는 편이 낫다.
5. 조건이 실패하는 함수#
서술 파트 3절은 \(n\)등분 형태가 충분조건만 준다고 하였다. 조건이 성립하지 않는 함수를 하나 만들어 그 경계를 확인한다.
디리클레 함수(Dirichlet function)를 쓴다. 유리수에서 \(1\), 무리수에서 \(0\)인 함수이다. 이 함수는 유계이므로 정리 25의 전제를 만족한다.
문제는 이 함수를 코드로 표본추출할 수 없다는 데 있다. 부동소수는 모두 유리수이므로, 격자를 아무리 촘촘히 잡아도 표본추출은 상수함수 \(1\)만 본다. 그래서 두 가지를 나란히 계산한다. 하나는 표본추출이 내놓는 답이고, 다른 하나는 손으로 따진 답이다. 임의의 부분구간에는 유리수와 무리수가 모두 들어 있으므로 그 구간에서 최대하계는 \(0\), 최소상계는 \(1\)이다.
# A bounded function that the criterion never accepts
def dirichlet_sampled(x):
    """1 on rationals, 0 on irrationals. Every float is rational, so this is 1."""
    return np.ones_like(np.asarray(x, dtype=float))


def dirichlet_by_hand(a, b, n):
    """Every subinterval holds a rational and an irrational, so inf = 0 and sup = 1."""
    points = partition(a, b, n)
    return step_integral(points, np.zeros(n)), step_integral(points, np.ones(n))


header = f"{'n':>6} {'sampled gap':>14} {'gap by hand':>14}"
print(header)
print("-" * len(header))
for m in (1, 10, 100, 1000):
    lo_s, up_s = lower_upper_sums(dirichlet_sampled, 0.0, 1.0, m)
    lo_h, up_h = dirichlet_by_hand(0.0, 1.0, m)
    print(f"{m:>6} {up_s - lo_s:>14.6f} {up_h - lo_h:>14.6f}")

print()
print("doubling search on the sampled version :", required_n(dirichlet_sampled, 0.0, 1.0, 0.5))
print("the same search on the gap by hand     : never below eps = 0.5")
     n    sampled gap    gap by hand
------------------------------------
     1       0.000000       1.000000
    10       0.000000       1.000000
   100       0.000000       1.000000
  1000       0.000000       1.000000

doubling search on the sampled version : (1, 0.0)
the same search on the gap by hand     : never below eps = 0.5
두 열이 정반대의 답을 준다. 표본추출은 \(n=1\)에서 이미 차이가 \(0\)이라고 하여 적분 가능하다고 말한다. 손으로 따진 값은 모든 \(n\)에서 차이가 \(1\)이다.
손으로 따진 쪽이 옳다. 그리고 이 함수에 대해서는 \(n\)등분에서 실패한 것이 곧 적분 불가능이다. \(s \le f\)인 계단함수는 각 부분구간에서 높이가 그 구간의 최대하계 \(0\) 이하여야 하므로 \(\int_a^b s \le 0\)이고, 같은 이유로 \(f \le t\)인 계단함수는 \(\int_a^b t \ge 1\)이다. 따라서 어떤 계단함수 쌍을 잡아도 \(\int_a^b (t-s) \ge 1\)이며, \(\epsilon = 1\)에 대하여 조건을 만족하는 쌍이 없다.
실패한다고 언제나 적분 불가능인 것은 아니다
위 논증은 디리클레 함수의 성질을 따로 쓴 것이지 \(n\)등분 계산에서 나온 것이 아니다. 서술 파트 3절이 지적한 대로 \(n\)등분 형태는 충분조건만 준다. \(n\)등분으로 차이를 줄이지 못했다는 사실만으로는 적분 불가능이라고 말할 수 없고, 정리 25의 원래 형태로 돌아가 일반적인 계단함수를 따져야 한다.
마치며#
\(\epsilon\)을 인자로 받고 \(n\)을 돌려주는 함수를 썼다. 이 방향이 정리 25의 양화사 순서이며, \(\epsilon\)이 작아질 때마다 다른 \(n\)이 필요하다는 것을 표로 확인하였다. 하나의 \(n\)이 모든 \(\epsilon\)을 감당하지 못한다.
상합과 하합을 손으로 만들어 7회 (7.15), (7.17)과 대조하였고, 같은 식을 sympy로 다시 얻었다. \(1/n < \epsilon\)의 해가 \(n > 1/\epsilon\)이므로 최소 자연수는 \(\lfloor 1/\epsilon \rfloor + 1\)이지 \(1/\epsilon\)의 올림값이 아니다. 경계에서 수치 계산이 이 하나를 어긋나게 하는 것도 보았다.
마지막으로 조건이 실패하는 함수를 보았다. 표본추출이 내놓은 답과 손으로 따진 답이 정반대였고, 손으로 따진 쪽이 옳았다. 한편 required_n이 2배씩 늘려 찾은 \(n\)은 어느 것도 최선이 아니었는데, 정리 25은 존재만 요구하므로 그것으로 충분하다.
서술 파트가 주장한 것과 이 노트북에서 그것을 확인한 코드를 나란히 둔다.
서술 파트의 내용 |
이 노트북의 코드 |
|---|---|
1절 |
|
정리 25의 양화사 순서 |
|
3절의 \(U_n - L_n < \epsilon\) 형태 |
3절 오른쪽 그림의 |
부등호가 엄격하므로 \(n > 1/\epsilon\)이라는 점 |
4절의 |
3절 “\(n\)등분 형태는 충분조건만 준다” |
5절 |
더 해 볼 것#
lower_upper_sums의samples를 \(2\)로 줄여 보자. \([0,1]\)의 \(x^2\)에서는 답이 달라지지 않는다. 그러나 \(f(x) = \sin(4x)\)를 \([0, 2]\)에서 다루면 달라진다. 왜 그런지 생각해 보고, 어떤 함수에서 끝점만으로 충분한지 정리해 보자.required_n을 2배씩 늘리는 대신 \(1\)씩 늘리도록 고쳐 보자. 4절의 \(n_{\min}\)과 값이 같아지는지, \(\epsilon = 0.02\)에서는 어떻게 되는지 확인해 보자.4절의 기호 계산을 \(f(x) = x^3\)으로 바꾸어 보자. \(\sum_{k=1}^{n} k^3\)은 sympy가 계산해 준다. \(U_n - L_n\)이 무엇이 되는지, 주어진 \(\epsilon\)에 필요한 \(n\)이 \(x^2\)일 때보다 큰지 작은지 확인해 보자.
5절의
dirichlet_by_hand를 유리수에서 \(0\), 무리수에서 \(1\)인 함수로 바꾸면 무엇이 달라지는지 생각해 보자. \(U_n - L_n\)은 그대로인가.
짝이 되는 서술