7회 실험 · 적분의 정의#
이 실험
짝 서술 |
|
확인하는 것 |
적분값 \(b^3/3\) 은 하합들의 최소상계이지 어떤 하합의 값이 아니다 |
서술 파트에서 적분을 두 단계로 정의하였다. 먼저 계단함수(step function)의 적분을 직사각형 넓이의 유한합 (7.1)로 정의하고, 그 값이 분할의 선택에 무관함을 정리 20으로 확인하였다. 그다음 일반 함수를 계단함수로 위아래에서 가두고, 하적분과 상적분이 같을 때 그 공통값을 적분으로 정의하였다(정의 15).
여기서 그 정의를 코드로 옮긴다. 옮길 것은 유한합과 부등식뿐이다. 극한을 계산하는 함수는 쓰지 않는다. n 을 아무리 키워도 그것은 여전히 유한한 n 이다.
\(f(x) = x^2\) 을 \([0,1]\) 에서 다룬다. 서술 파트 6절이 \(b=1\), \(n=10\) 에서 \(L_{10} = 0.285\), \(U_{10} = 0.385\) 라 하였으므로 그 수치부터 맞춰 본다. 마지막 두 절에서는 sympy 로 (7.15)의 정확한 식을 세우고, 그 식에서 이 회차의 요점을 읽는다.
서술 파트의 내용 |
여기서 확인하는 방법 |
|---|---|
(7.1) 계단함수의 적분 |
|
정리 20 분할 무관성 |
같은 계단함수를 세 분할로 계산해 값을 비교한다 |
(7.13) \(n\)등분의 \(L_n\), \(U_n\) |
|
(7.17) \(U_n - L_n = b^3/n\) |
표의 마지막 두 열을 나란히 놓는다 |
정의는 \(n\)등분에 대한 것이 아니다 |
무작위 분할로도 \(b^3/3\) 이 갇히는지 본다 |
(7.15) \(L_n\), \(U_n\) 의 정확한 식 |
sympy 의 |
어떤 \(n\) 에서도 \(L_n \ne b^3/3\) |
\(b^3/3 - L_n\) 을 인수분해해 부호를 본다 |
0. 준비#
이 회차에서 쓸 것만 불러온다. 색은 상수로 고정해 둔다. 바깥쪽(상합)은 주황, 안쪽(하합)은 파랑이다.
1. 계단함수의 적분과 분할 무관성#
(7.1)은 다음과 같다.
분할점 배열과 높이 배열을 받아 이 합을 돌려주는 함수를 만든다. np.diff 가 폭 \(x_k - x_{k-1}\) 을 준다.
정리 20이 말하는 것을 확인할 계단함수 \(s\) 를 하나 고른다. \((0, 0.5)\) 에서 \(2\), \((0.5, 1)\) 에서 \(5\) 인 함수이다. 이 함수에 대한 분할은 \(0.5\) 를 포함하기만 하면 된다. 서로를 포함하지 않는 두 분할 \(P_1 = \{0,\, 0.3,\, 0.5,\, 1\}\) 과 \(P_2 = \{0,\, 0.5,\, 0.7,\, 1\}\) 을 잡고, 그 합집합인 공통 세분 \(P_1 \cup P_2\) 까지 셋을 비교한다. 증명에서 쓴 구조가 그대로 여기에 있다.
# formula (7.1) : the integral of a step function is a finite sum of rectangles
def step_integral(points, heights):
    points = np.asarray(points, dtype=float)
    heights = np.asarray(heights, dtype=float)
    return float(np.sum(heights * np.diff(points)))


# the step function s of this section : 2 on (0, 0.5) and 5 on (0.5, 1)
def step_values(t):
    return np.where(np.asarray(t, dtype=float) < 0.5, 2.0, 5.0)


points_1 = np.array([0.0, 0.3, 0.5, 1.0])
points_2 = np.array([0.0, 0.5, 0.7, 1.0])
points_3 = np.union1d(points_1, points_2)

print(f"{'partition':>12} {'subintervals':>14} {'integral':>12}")
for name, points in (("P1", points_1), ("P2", points_2), ("P1 U P2", points_3)):
    mid = 0.5 * (points[:-1] + points[1:])
    heights = step_values(mid)
    print(f"{name:>12} {len(points) - 1:>14} {step_integral(points, heights):>12.8f}")
   partition   subintervals     integral
          P1              3   3.50000000
          P2              3   3.50000000
     P1 U P2              4   3.50000000
세 값이 모두 \(3.5\) 이다. 높이 배열은 각 부분구간의 중점에서 \(s\) 를 읽어 만들었다. 중점을 쓴 것은 정의 12이 열린 부분구간에서의 값만 요구하기 때문이다. 분할점 위에서 \(s\) 가 무엇이든 (7.1)의 값은 변하지 않는다.
같은 것을 그림으로 본다. 세 그림의 검은 선은 같은 함수이고, 아래쪽 빨간 눈금만 서로 다르다.
# the same step function drawn over three different partitions
fig, axes = plt.subplots(1, 3, figsize=(12, 3.4), sharey=True)
for ax, (name, points) in zip(
    axes, (("P1", points_1), ("P2", points_2), ("P1 U P2", points_3))
):
    mid = 0.5 * (points[:-1] + points[1:])
    heights = step_values(mid)
    ax.bar(points[:-1], heights, width=np.diff(points), align="edge",
           color=C_BAND, alpha=0.45, linewidth=0.0)
    for k in range(len(points) - 1):
        ax.hlines(heights[k], points[k], points[k + 1], color=C_FUNC, linewidth=1.8)
    ax.plot(points, np.zeros_like(points), "|", color=C_DIFF,
            markersize=16, markeredgewidth=2.0, clip_on=False)
    ax.set_title(f"{name} : integral = {step_integral(points, heights):.4f}")
    ax.set_xlabel("x")
    ax.set_xlim(0.0, 1.0)
    ax.set_ylim(0.0, 6.0)
axes[0].set_ylabel("s(x)")
fig.tight_layout()
plt.show()
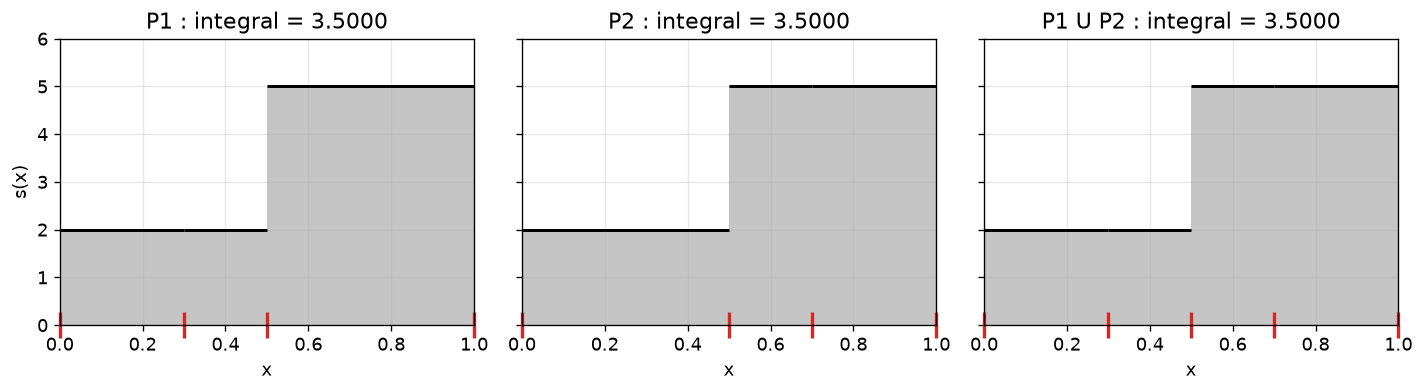
세 그림의 회색 넓이가 같다. 분할을 더 찍는 것은 직사각형 하나를 폭이 더 좁은 여러 개로 쪼개는 일이므로 넓이가 달라질 수 없다. 증명의 첫 단계에서 망원합을 쓴 곳이 이 부분이다.
2. n등분으로 f를 위아래에서 가둔다#
이제 \(f(x) = x^2\) 로 넘어간다. \([a,b]\) 를 \(n\)등분한 분할점은 \(x_k = a + k(b-a)/n\) 이고, np.linspace 가 그대로 준다.
각 부분구간에서 \(f\) 의 최솟값을 높이로 하면 \(f\) 이하인 계단함수, 최댓값을 높이로 하면 \(f\) 이상인 계단함수를 얻는다. 최솟값과 최댓값은 부분구간을 촘촘히 표본으로 훑어 찾는다. \(x^2\) 은 \(x \ge 0\) 에서 증가하므로 표본에서 찾은 값이 실제로 양 끝점의 값과 일치한다.
두 계단함수의 적분이 (7.13)의 \(L_n\) 과 \(U_n\) 이다. 두 값 모두 1절에서 만든 step_integral 로 계산한다. 새로 도입한 것이 없다는 점이 중요하다.
# the n equal parts of [a, b] used in (7.13)
def partition(a, b, n):
    return np.linspace(a, b, n + 1)


# smallest and largest value of f on each subinterval, found by sampling
def step_heights(f, points, kind, samples=200):
    heights = []
    for k in range(len(points) - 1):
        values = f(np.linspace(points[k], points[k + 1], samples))
        heights.append(values.min() if kind == "lower" else values.max())
    return np.array(heights)


# L_n and U_n of (7.13), each one a step integral (7.1)
def lower_upper_sums(f, a, b, n, samples=200):
    points = partition(a, b, n)
    lower = step_integral(points, step_heights(f, points, "lower", samples))
    upper = step_integral(points, step_heights(f, points, "upper", samples))
    return lower, upper


f = lambda t: t**2
a, b = 0.0, 1.0

print(f"{'n':>6} {'lower L_n':>16} {'upper U_n':>16} {'U_n - L_n':>16} {'b^3 / n':>16}")
for n in (2, 5, 10, 50, 200, 1000):
    lower, upper = lower_upper_sums(f, a, b, n)
    print(f"{n:>6} {lower:>16.10f} {upper:>16.10f} {upper - lower:>16.10f} {b**3 / n:>16.10f}")
     n        lower L_n        upper U_n        U_n - L_n          b^3 / n
     2     0.1250000000     0.6250000000     0.5000000000     0.5000000000
     5     0.2400000000     0.4400000000     0.2000000000     0.2000000000
    10     0.2850000000     0.3850000000     0.1000000000     0.1000000000
    50     0.3234000000     0.3434000000     0.0200000000     0.0200000000
   200     0.3308375000     0.3358375000     0.0050000000     0.0050000000
  1000     0.3328335000     0.3338335000     0.0010000000     0.0010000000
\(n=10\) 줄이 \(L_{10} = 0.285\), \(U_{10} = 0.385\) 이다. 서술 파트 6절 끝에 적힌 값과 같고, 1회에서 계산한 값과도 같다.
마지막 두 열이 모든 줄에서 일치한다. (7.17)의 \(U_n - L_n = b^3/n\) 이 수치로 확인된다. 이 등식은 근사가 아니라 (7.15)의 두 식을 빼면 나오는 항등식이다.
서술 파트에서 두 값이 같음을 보인 방식이 (7.20)이었다. \(0 \le \overline{I}(f) - \underline{I}(f) \le b^3/n\) 이 모든 \(n\) 에 대하여 성립하므로 차이가 \(0\) 이라는 논증이며, 여기에 5회 따름정리 4이 쓰였다. 그 따름정리가 주장하는 \(n\) 을 실제로 찾아본다.
# smallest n that makes the gap (7.17) smaller than a given eps
def smallest_n(f, a, b, eps):
    n = 1
    while True:
        lower, upper = lower_upper_sums(f, a, b, n)
        if upper - lower < eps:
            return n
        n += 1


for eps in (0.5, 0.1, 0.02, 0.005):
    n = smallest_n(f, a, b, eps)
    lower, upper = lower_upper_sums(f, a, b, n)
    print(f"eps = {eps:<7} n = {n:>4}   L_n = {lower:.8f}   U_n = {upper:.8f}"
          f"   gap = {upper - lower:.8f}")
eps = 0.5     n =    3   L_n = 0.18518519   U_n = 0.51851852   gap = 0.33333333
eps = 0.1     n =   10   L_n = 0.28500000   U_n = 0.38500000   gap = 0.10000000
eps = 0.02    n =   50   L_n = 0.32340000   U_n = 0.34340000   gap = 0.02000000
eps = 0.005 n = 201 L_n = 0.33084990 U_n = 0.33582502 gap = 0.00497512
어떤 eps 를 주어도 그런 n 이 나온다. eps = 0.005 에서 n = 201 인 것은 \(1/200 = 0.005\) 가 아직 eps 보다 작지 않기 때문이다. 이 탐색이 끝난다는 보장이 5회의 따름정리이며, 그 보장이 없으면 (7.20)의 논증이 서지 않는다.
3. 그림 — 파란 몸통과 주황 띠#
바깥쪽 계단함수를 먼저 그리고 안쪽 계단함수를 그 위에 겹쳐 그린다. 그러면 파란 몸통이 \(L_n\) 이고, 그 위에 남은 주황 띠가 차이 \(U_n - L_n\) 이 된다.
# draw the outer step function first, then the inner one on top of it
fig, axes = plt.subplots(1, 3, figsize=(13, 4.3))
for ax, n in zip(axes, (4, 10, 40)):
    points = partition(a, b, n)
    upper_heights = step_heights(f, points, "upper")
    lower_heights = step_heights(f, points, "lower")
    ax.bar(points[:-1], upper_heights, width=np.diff(points), align="edge",
           color=C_UPPER, alpha=0.55, linewidth=0.0, label="upper sum")
    ax.bar(points[:-1], lower_heights, width=np.diff(points), align="edge",
           color=C_LOWER, alpha=0.85, linewidth=0.0, label="lower sum")
    grid = np.linspace(a, b, 400)
    ax.plot(grid, f(grid), color=C_FUNC, linewidth=1.8, label="f(x) = x^2")
    lower = step_integral(points, lower_heights)
    upper = step_integral(points, upper_heights)
    ax.set_title(f"n = {n}\nlower {lower:.4f} / upper {upper:.4f}")
    ax.set_xlabel("x")
    ax.set_ylabel("y")
    ax.set_xlim(a, b)
    ax.set_ylim(0.0, 1.1)
axes[0].legend(loc="upper left", fontsize=9)
fig.tight_layout()
plt.show()
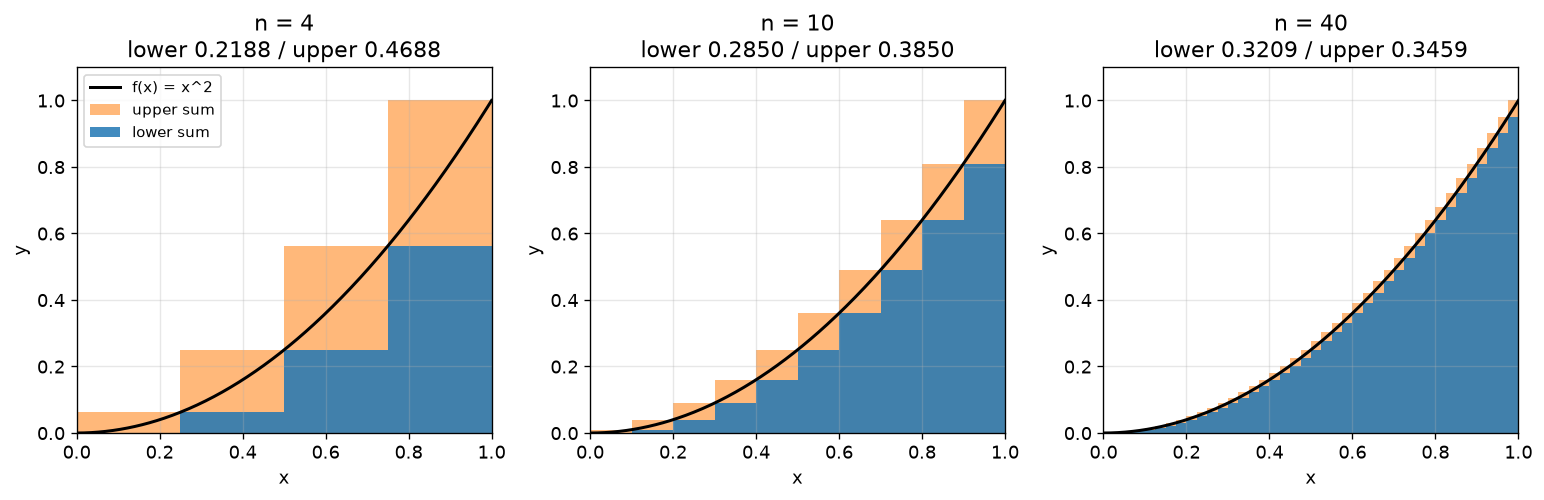
\(n\) 이 커지면 주황 띠가 얇아진다. 띠 전체의 넓이가 \(b^3/n\) 이다. 그런데 얇아진다는 것은 그림에서 읽은 인상일 뿐이고, 정의에서 쓴 것은 인상이 아니라 2절에서 확인한 등식과 부등식이다.
띠가 사라지는 그림은 없다. 어떤 \(n\) 에서도 주황 띠의 넓이는 \(b^3/n > 0\) 이다. 7절에서 이 점을 식으로 다시 본다.
4. n등분이 아닌 분할#
정의 15은 \(n\)등분에 대한 것이 아니다. \(f\) 이하인 모든 계단함수의 적분값을 모은 집합 (7.4)의 최소상계를 말한다. \(n\)등분은 그 집합의 원소를 손으로 만들어 내기 위한 편의일 뿐이다.
분할점을 무작위로 찍어도 \(b^3/3\) 이 하합과 상합 사이에 갇히는지 본다. 1절과 2절에서 만든 함수를 그대로 쓴다. 바뀌는 것은 분할점 배열뿐이다.
# a partition whose interior points are placed at random
def random_partition(a, b, n, seed):
    rng = np.random.default_rng(seed)
    inner = np.sort(rng.uniform(a, b, n - 1))
    return np.concatenate([[a], inner, [b]])


exact = b**3 / 3
print(f"{'seed':>5} {'lower':>13} {'upper':>13} {'gap':>13} {'widest part':>13} {'brackets':>9}")
for seed in (0, 1, 2):
    points = random_partition(a, b, 300, seed)
    lower = step_integral(points, step_heights(f, points, "lower"))
    upper = step_integral(points, step_heights(f, points, "upper"))
    print(f"{seed:>5} {lower:>13.8f} {upper:>13.8f} {upper - lower:>13.8f}"
          f" {np.diff(points).max():>13.8f} {str(lower < exact < upper):>9}")

lower_even, upper_even = lower_upper_sums(f, a, b, 300)
print(f"\nequal parts, n = 300 : gap = {upper_even - lower_even:.8f}")
 seed         lower         upper           gap   widest part  brackets
    0    0.33016211    0.33652890    0.00636679    0.02581300      True
    1    0.33034011    0.33634365    0.00600354    0.01947816      True
    2    0.32996709    0.33672710    0.00676002    0.02664737      True

equal parts, n = 300 : gap = 0.00333333
세 경우 모두 \(b^3/3\) 을 가둔다. 부분구간의 개수가 같은데도 차이는 등분일 때보다 두 배쯤 크다. 마지막에서 두 번째 열이 그 이유를 보여 준다. 가장 넓은 부분구간의 폭이 \(1/300\) 보다 훨씬 크고, 차이의 크기를 좌우하는 것은 개수가 아니라 가장 넓은 부분구간이다.
여기서 두 가지를 구분해 둔다. 무작위 분할이 주는 값도 (7.4)의 집합에 들어간다. 그러나 집합에 원소가 더 들어왔다고 최소상계가 달라지지는 않는다. 하적분은 어느 분할 방식으로 정해지는 값이 아니다.
5. scipy로 대조한다#
정의를 옮긴 계산이 맞는지 바깥에서 한 번 확인한다.
# an independent check with a numerical quadrature routine
from scipy.integrate import quad

value, error = quad(f, a, b)
lower_1000, upper_1000 = lower_upper_sums(f, a, b, 1000)

print(f"quad value            : {value:.12f}")
print(f"quad error bound      : {error:.3e}")
print(f"lower sum (n = 1000)  : {lower_1000:.12f}")
print(f"upper sum (n = 1000)  : {upper_1000:.12f}")
print(f"quad value is between : {lower_1000 < value < upper_1000}")
quad value            : 0.333333333333
quad error bound      : 3.701e-15
lower sum (n = 1000)  : 0.332833500000
upper sum (n = 1000)  : 0.333833500000
quad value is between : True
quad 의 값이 \(L_{1000}\) 과 \(U_{1000}\) 사이에 있다.
quad 는 쓰고 sympy 의 integrate 는 쓰지 않는 이유
scipy.integrate.quad 는 구간을 나누어 함숫값을 표본으로 더한다. 정의 15에서 정의한 것과 같은 계열의 계산이다.
sympy.integrate 는 다른 경로로 답을 낸다. 이 함수는 먼저 도함수가 \(f\) 가 되는 함수를 찾고, 그 함수의 양 끝값의 차를 구한다. 이 강의에서는 아직 도함수를 정의하지 않았으므로 이 경로를 쓰지 않는다.
두 함수가 같은 답을 준다는 것과 같은 경로로 온다는 것은 다른 이야기이다.
6. 정확한 식#
수치는 \(L_{1000} = 0.3328335\) 라고 알려 주지만, 그 값이 \(1/3\) 에서 얼마나 떨어져 있는지를 \(n\) 의 식으로 말해 주지는 않는다. 유한합 (7.13)을 sympy 의 Sum 으로 닫으면 (7.15)의 식이 나온다.
Sum(...).doit() 은 극한이 아니라 유한합의 닫힌 식을 구하는 계산이다. 4회 정리 12를 손으로 대입하는 대신 쓴다. sp.limit 과 sp.integrate 는 쓰지 않는다.
이 절부터 b, n, k, x 는 sympy 기호이다. 앞 절까지 쓰던 수와 이름이 겹치므로, 이 아래에서 수가 필요하면 앞 절의 값을 다시 쓰지 않고 기호에 값을 대입해 얻는다.
# from here on b, n, k, x are sympy symbols, not the numbers used above
x, b = sp.symbols("x b", positive=True)
n, k = sp.symbols("n k", positive=True, integer=True)


def show(label, expr):
    print(f"{label} =")
    sp.pprint(expr)
    print()


expr = x**2
width = b / n
lower_expr = sp.simplify(sp.Sum(expr.subs(x, (k - 1) * width) * width, (k, 1, n)).doit())
upper_expr = sp.simplify(sp.Sum(expr.subs(x, k * width) * width, (k, 1, n)).doit())

show("L_n", sp.expand(lower_expr))
show("U_n", sp.expand(upper_expr))
show("U_n - L_n", sp.simplify(upper_expr - lower_expr))
L_n =
 3    3      3
b    b      b
── - ─── + ────
3    2⋅n      2
           6⋅n

U_n =
 3    3      3
b    b      b
── + ─── + ────
3    2⋅n      2
           6⋅n

U_n - L_n =
 3
b
──
n
두 식이 (7.15)와 글자 그대로 같다.
차이는 \(b^3/n\) 이다. 2절의 표에서 마지막 두 열이 일치한 이유가 이것이다. 표는 여섯 개의 \(n\) 에서 확인한 것이고, 이 식은 모든 \(n\) 에 대한 것이다.
식에 \(b=1\), \(n=1000\) 을 넣어 2절의 수치와 맞춰 본다.
# the closed form and the sampled sum must agree at n = 1000
formula_1000 = float(lower_expr.subs({b: 1, n: 1000}))
print(f"L_1000 from the closed form : {formula_1000:.12f}")
print(f"L_1000 from the sampled sum : {lower_1000:.12f}")
print(f"difference                  : {abs(formula_1000 - lower_1000):.3e}")
L_1000 from the closed form : 0.332833500000
L_1000 from the sampled sum : 0.332833500000
difference                  : 0.000e+00
두 값의 차이가 \(0\) 이다. 부분구간마다 최솟값을 표본으로 찾아 더한 결과와 닫힌 식에 \(b=1\), \(n=1000\) 을 넣은 결과가 같다. 2절의 표가 여섯 개의 \(n\) 에서 보여 준 것을 식이 모든 \(n\) 에 대하여 말한다.
7. 하합이 적분값과 같아지는 n은 없다#
\(b^3/3\) 에서 \(L_n\) 을 빼고 인수분해한다. \(U_n\) 에서 \(b^3/3\) 을 뺀 것도 같이 본다.
# how far the two sums stay from the value of the integral
gap_low = sp.factor(sp.simplify(b**3 / 3 - lower_expr))
gap_high = sp.factor(sp.simplify(upper_expr - b**3 / 3))
show("b^3/3 - L_n", gap_low)
show("U_n - b^3/3", gap_high)

print(f"is b^3/3 - L_n positive for every n : {sp.ask(sp.Q.positive(gap_low))}")
print(f"is U_n - b^3/3 positive for every n : {sp.ask(sp.Q.positive(gap_high))}")
print(f"solutions of b^3/3 - L_n = 0 in n   : {sp.solve(sp.Eq(gap_low, 0), n)}")
b^3/3 - L_n =
 3
b ⋅(3⋅n - 1)
────────────
       2
    6⋅n

U_n - b^3/3 =
 3
b ⋅(3⋅n + 1)
────────────
       2
    6⋅n
is b^3/3 - L_n positive for every n : True
is U_n - b^3/3 positive for every n : True
solutions of b^3/3 - L_n = 0 in n   : []
두 식은 다음과 같다.
분모 \(6n^2\) 이 양수이고 분자의 \(3n-1\) 과 \(3n+1\) 도 자연수 \(n\) 에서 양수이므로 두 값 모두 양수이다. sp.ask 가 두 줄 모두 True 를 돌려준 것이 그 판정이다. 마지막 줄에서 \(b^3/3 - L_n = 0\) 을 만족하는 자연수 \(n\) 을 찾으면 해가 없다.
즉 (7.16)의 \(L_n < b^3/3 < U_n\) 이 모든 자연수 \(n\) 에 대한 엄격한 부등식이다. 어떤 \(n\) 에 대해서도 \(L_n \ne b^3/3\) 이다.
이것이 이 회차의 요점이다. 적분값 \(b^3/3\) 은 하합들의 최소상계로 정의된 값이지 어떤 하합의 값이 아니다. 5회에서 최소상계가 집합에 속하지 않을 수 있다고 한 것이 여기서 실제로 일어난다.
이 구분이 무너지면 적분을 “무한히 잘게 나눈 합”으로 읽게 된다. 정의 15에는 그런 과정이 없다. 3절의 그림에서 주황 띠가 얇아지는 것을 보았지만, 얇아지는 것과 없어지는 것은 다르다.
마치며#
이 실험에서 (7.1)을 step_integral 로 옮기고, 같은 계단함수를 서로를 포함하지 않는 두 분할과 그 공통 세분으로 계산해 값이 하나임을 확인하였다. 정리 20이 필요한 이유가 여기에 있다. 이 확인이 없으면 (7.1)은 정의가 되지 못한다.
그 위에서 \(f(x)=x^2\) 의 \(L_n\) 과 \(U_n\) 을 구했다. 표의 마지막 두 열이 (7.17)을 그대로 보여 주었고, sympy 로 닫은 식이 (7.15)와 일치하였다. 무작위 분할로도 \(b^3/3\) 이 갇혔고, quad 의 값도 \(L_{1000}\) 과 \(U_{1000}\) 사이에 있었다.
마지막으로 \(b^3/3 - L_n = b^3(3n-1)/(6n^2)\) 이 모든 자연수 \(n\) 에서 양수임을 보았다. 코드에 등장한 것은 유한합과 부등식뿐이며, 극한을 구하는 함수는 한 번도 쓰지 않았다. 정의가 그렇게 되어 있기 때문이다.
서술 파트가 주장한 것과 그것을 확인한 코드를 나란히 적어 둔다.
서술 파트의 내용 |
이 노트북의 코드 |
|---|---|
(7.1) 계단함수의 적분은 직사각형 넓이의 유한합이다 |
|
정리 20 값은 분할의 선택에 무관하다 |
1절의 |
정의 15 은 \(n\)등분에 대한 것이 아니다 |
4절의 |
(7.15) \(L_n\), \(U_n\) 의 닫힌 식 |
|
(7.16) 모든 \(n\) 에서 \(L_n < b^3/3\) |
|
더 해 볼 것#
6절의
expr을x**3으로 바꾸어 \(L_n\), \(U_n\), \(U_n - L_n\) 을 다시 구해 보자. 차이가 \(b^3/n\) 대신 무엇이 되는가. 그 식에서 \(b^4/4\) 를 읽을 수 있는가.2절의
step_heights에서samples를3으로 줄이고 표를 다시 만들어 보자. \(f(x)=x^2\) 에서는 값이 그대로인데, \(f(x) = \sin(4x)\) 처럼 부분구간 안에 최댓값이 있는 함수로 바꾸면 어떻게 되는가. 표본으로 최솟값과 최댓값을 찾는 방법의 한계를 확인해 보자.4절의
random_partition에서 부분구간 개수를300으로 두되, 가장 넓은 부분구간의 폭과 차이 \(U-L\) 을 여러seed에 대해 모아 보자. 둘 사이에 어떤 관계가 보이는가.2절의
smallest_n에eps = 1e-6을 넣으면 시간이 오래 걸린다. (7.17)을 써서 탐색 없이n을 바로 계산하는 식을 세우고, 그 값이 탐색 결과와 같은지 작은eps에서 확인해 보자.
짝이 되는 서술