15회 실험 · 하나의 δ#
이 실험
짝 서술 |
|
확인하는 것 |
점마다 다른 \(\delta\)와 구간 전체에 통하는 \(\delta\)를 나란히 계산한다. 최소상계와 최댓값이 갈라지는 자리를 본다. 적분 가능성 증명을 그대로 실행해 \(n\)을 구한다 |
이 회차의 세 정리는 모두 “닫힌구간에서 연속이면”으로 시작한다. 그런데 그 조건이 왜 필요한지는 수식만 보아서는 잘 보이지 않는다. 이 노트북은 조건이 빠진 자리에서 무엇이 실제로 무너지는지를 숫자로 확인한다.
\(1/x\)가 세 번 나온다. 서술 파트 1절에서 유계가 아니었고, 2절에서 최댓값이 없었으며, 3절에서 균등연속이 아니었다. 같은 함수가 세 번 반례가 되는 것은 우연이 아니라 무너지는 자리가 하나이기 때문인데, 그것을 그림 하나로 보인다.
마지막 절이 이 노트북의 요점이다. 정리 46의 증명은 “적분 가능하다”고 말하고 끝나지 않는다. \(\epsilon\)을 주면 \(n\)을 돌려주는 절차가 증명 안에 그대로 들어 있다. 그 절차를 코드로 옮겨 실행하고, 나온 \(n\)으로 상합과 하합을 계산해 차가 정말 \(\epsilon\)보다 작은지 확인한다.
서술 파트의 내용 |
여기서 확인하는 방법 |
|---|---|
\(\delta\)가 \(\epsilon\)과 \(p\)에 의존한다 |
1절이 두 \(\delta\)를 같은 표에 놓는다 |
가장 나쁜 자리가 구간 안에 있다 |
1절이 오른쪽 끝의 \(\delta\)와 구간 전체의 \(\delta\)를 비교한다 |
최소상계와 최댓값의 구별 |
2절이 열린구간에서 상한에 닿지 못하는 것을 출력한다 |
3절이 (15.7)의 두 점을 실제로 만든다 |
|
정리 46의 증명 |
4절이 \(\epsilon \to \epsilon' \to \delta \to n\)을 그대로 실행한다 |
0. 준비#
이 회차에서 쓸 것만 불러온다. 상합과 하합을 다시 그리므로 그쪽 색 상수가 돌아왔다.
1. 점마다 다른 δ와 구간 전체에 통하는 δ#
11회 예제 7는 \(f(x) = x^2\)의 \(p\)에서 \(\epsilon\)을 지키는 \(\delta\)를 구했다. 그 계산을 정확히 하면 \(|x^2 - p^2| < \epsilon\)을 만족하는 \(\delta\) 중 가장 큰 것이 \(\sqrt{p^2+\epsilon} - p\)이다.
이 식에는 \(p\)가 들어 있다. 서술 파트 3절이 다룬 의존성이 이것이다. 반면 \([0,b]\) 전체에 통하는 \(\delta\)는 \(|x^2-y^2| = |x-y|\,|x+y| \le 2b\,|x-y|\)에서 \(\epsilon/(2b)\)로 나왔고, 여기에는 \(p\)가 없다.
두 식을 sympy로 적어 두고 값을 대조한다.
# The point-wise delta from lecture 11 depends on p; the uniform one does not
p, eps, b = sp.symbols("p eps b", positive=True)

delta_point = sp.sqrt(p ** 2 + eps) - p
delta_uniform = eps / (2 * b)

print("point-wise delta at p :", delta_point)
print("uniform delta on [0,b]:", delta_uniform)
point-wise delta at p : -p + sqrt(eps + p**2)
uniform delta on [0,b]: eps/(2*b)
\(\epsilon = 0.01\)로 고정하고 \([0,10]\) 위의 여러 점에서 두 값을 견주어 본다.
# Same epsilon, four different points, on the interval [0, 10]
to_number = sp.lambdify((p, eps), delta_point, "numpy")
uniform_on_0_10 = float(delta_uniform.subs({eps: sp.Rational(1, 100), b: 10}))

print(f"{'p':>6} {'point-wise':>16} {'uniform on [0,10]':>20}")
print("-" * 44)
for p_value in (0.5, 1.0, 3.0, 10.0):
    print(f"{p_value:>6} {float(to_number(p_value, 0.01)):>16.10f}"
          f" {uniform_on_0_10:>20.10f}")
     p       point-wise    uniform on [0,10]
--------------------------------------------
   0.5     0.0099019514         0.0005000000
   1.0     0.0049875621         0.0005000000
   3.0     0.0016662040         0.0005000000
  10.0     0.0004999875         0.0005000000
점마다 필요한 \(\delta\)가 \(p\)가 커질수록 작아진다. \(p = 0.5\)에서는 \(0.0099\)면 되는데 \(p = 10\)에서는 \(0.0005\)가 필요하다. 스무 배 차이이다.
그리고 마지막 줄에서 두 값이 거의 같다. 오른쪽 끝 \(p = 10\)에서 필요한 \(\delta\)가 구간 전체에 통하는 \(\delta\)와 사실상 같은 것이다.
# The right end is the worst place; the uniform delta is essentially its delta
worst = float(to_number(10.0, 0.01))
print(f"delta needed at the right end p = 10 : {worst:.10f}")
print(f"delta that works on all of [0, 10]   : {uniform_on_0_10:.10f}")
print(f"ratio                                : {worst / uniform_on_0_10:.6f}")
delta needed at the right end p = 10 : 0.0004999875
delta that works on all of [0, 10]   : 0.0005000000
ratio                                : 0.999975
이것이 4절 정리의 내용이다. 가장 나쁜 자리가 구간 안에 있으면 거기서 통하는 \(\delta\)가 나머지 전부에서도 통한다. 닫힌구간이 보장하는 것이 바로 “가장 나쁜 자리가 구간 안에 있다”는 것이다.
\([0,10)\)이었다면 \(p\)가 \(10\)에 다가가면서 필요한 \(\delta\)가 계속 작아지되 \(10\)에 도달하지는 않는다. 그래도 \(\epsilon/20\)이 통하므로 이 함수는 여전히 균등연속이다. 닫혀 있다는 조건은 충분조건이지 필요조건이 아니다.
2. 최소상계와 최댓값이 갈라지는 자리#
서술 파트 2절의 흔한 오해 상자가 \(\sup\)과 \(\max\)의 구별을 지적했다. 그 구별을 숫자로 본다.
\(f(x) = x\)를 \((0,1)\)에서 본다. 아무리 촘촘히 표본을 잡아도 함숫값의 최댓값은 \(1\)보다 작다.
# f(x) = x on the open interval (0,1): the supremum is 1 but no point attains it
for count in (10, 1000, 100000):
    xs = np.linspace(0.0, 1.0, count + 2)[1:-1]   # drop both endpoints
    print(f"n = {count:>6} : largest value = {xs.max():.10f}  "
          f"reaches 1 : {bool(np.any(xs >= 1.0))}")
n =     10 : largest value = 0.9090909091  reaches 1 : False
n =   1000 : largest value = 0.9990009990  reaches 1 : False
n = 100000 : largest value = 0.9999900001  reaches 1 : False
표본을 늘릴수록 \(1\)에 가까워지지만 도달하지 않는다. \(\sup f((0,1)) = 1\)인데 \(f(x) = 1\)인 \(x\)가 정의역에 없기 때문이다.
같은 함수를 \([0,1]\)에서 보면 사정이 달라진다.
# The same function on the closed interval: the maximum is attained, at x = 1
xs = np.linspace(0.0, 1.0, 1002)
print(f"largest value on [0,1] : {xs.max():.10f}")
print(f"attained at x          : {xs[xs.argmax()]:.10f}")
largest value on [0,1] : 1.0000000000
attained at x          : 1.0000000000
정리 44가 보장하는 것이 이 차이이다. 최소상계는 완비성 공리가 언제나 주지만, 그것이 함숫값인지는 별개의 물음이고 닫힌구간과 연속이 그 답을 준다.
\(1/x\)는 \((0,1)\)에서 최댓값이 없는 정도가 아니라 아예 유계가 아니다. 예제 9의 논증을 그대로 실행한다.
# For any bound M we can name a point where 1/x exceeds it
print(f"{'M':>8} {'n > M':>8} {'x = 1/n':>14} {'f(x) = n':>10}")
print("-" * 42)
for bound in (10, 1000, 10 ** 6):
    n = bound + 1
    print(f"{bound:>8} {n:>8} {1.0 / n:>14.10f} {n:>10}")
       M    n > M        x = 1/n   f(x) = n
------------------------------------------
      10       11   0.0909090909         11
    1000     1001   0.0009990010       1001
 1000000  1000001   0.0000010000    1000001
상계를 아무리 크게 잡아도 그것을 넘는 함숫값이 있다. 5회 정리 17가 \(n > M\)인 자연수를 주므로 이 표는 끝없이 이어진다.
3. 하나의 δ가 통하지 않는다#
예제 10은 \(\delta\)를 어떻게 잡아도 \(\epsilon_0 = 1\)을 깨는 두 점이 있다고 했다. (15.7)이 그 두 점을 \(x_n = 1/n\)과 \(y_n = 1/(n+1)\)로 지정한다.
\(\delta\)를 셋 잡고 각각에 대해 그 두 점을 실제로 만들어 본다.
# For each delta, build the pair from (15.7) and check both sides of the definition
print(f"{'delta':>9} {'n':>6} {'|x-y|':>12} {'< delta':>9} {'|f(x)-f(y)|':>13}")
print("-" * 53)
for delta in (0.1, 0.01, 0.001):
    n = int(np.ceil(1.0 / delta))
    x, y = 1.0 / n, 1.0 / (n + 1)
    gap, jump = abs(x - y), abs(n - (n + 1))
    print(f"{delta:>9} {n:>6} {gap:>12.3e} {str(gap < delta):>9} {jump:>13}")
    delta      n        |x-y|   < delta   |f(x)-f(y)|
-----------------------------------------------------
      0.1     10    9.091e-03      True             1
     0.01    100    9.901e-05      True             1
    0.001   1000    9.990e-07      True             1
세 줄 모두 마지막 열이 \(1\)이다. 두 점이 \(\delta\)보다 가까운데 함숫값의 차는 줄지 않는다. \(\delta\)를 줄이면 두 점은 더 가까워지지만 함숫값의 차는 그대로 \(1\)이다.
이것을 그림으로 보면 왜 그런지가 드러난다. 같은 크기의 상자를 그래프를 따라 옮겨 본다. 정의 28이 요구하는 것은 어느 자리에 놓아도 곡선이 그 상자의 위아래로 빠져나가지 않는 것이다.
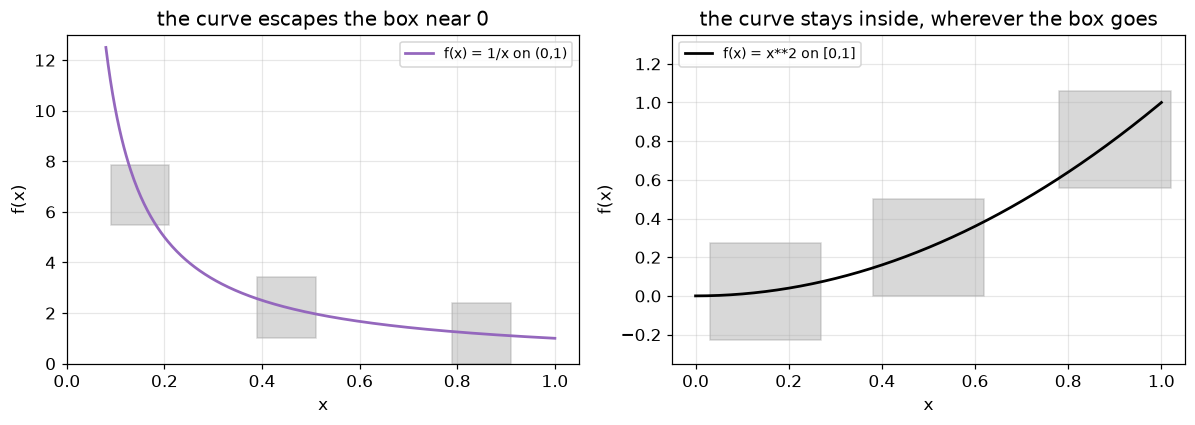
왼쪽에서 상자 세 개는 폭도 높이도 같다. 오른쪽 두 개에서는 곡선이 상자 안에 머무는데 \(0\)에 가까운 첫 상자에서는 위아래로 뚫고 나간다. 상자의 폭이 \(2\delta\)이고 높이가 \(2\epsilon\)이므로, 그 상자를 벗어난다는 것이 (15.6)을 깬다는 뜻이다.
오른쪽에서는 세 자리 어디에 놓아도 곡선이 상자 안에 있다. 상자를 더 왼쪽이나 오른쪽으로 옮겨도 마찬가지이며, 그것이 \([0,1]\)에서 \(x^2\)이 균등연속이라는 것이다.
그림이 증명은 아니다
세 자리에서 상자가 통했다고 모든 자리에서 통하는 것은 아니다. 오른쪽 그림이 보이는 것은 \(\delta = 0.12\)가 세 점 근처에서 \(\epsilon = 0.25\)를 지킨다는 것뿐이다.
모든 자리를 확인하는 것은 정리 45이 하는 일이고, 그 증명은 유한 번의 확인으로 되지 않아 완비성 공리를 쓴다. 그림은 무엇을 증명해야 하는지를 보여 줄 뿐이다.
4. 증명을 실행한다#
정리 46의 증명을 다시 읽으면 순서가 이렇다.
\(\epsilon\)이 주어진다 → \(\epsilon' = \epsilon/(b-a)\)로 나눈다 → 정리 45이 \(\delta\)를 준다 → \(\frac{b-a}{n} < \delta\)인 \(n\)을 고른다 → \(n\)등분한다.
마지막 \(n\)이 구체적인 수이다. 각 단계를 함수 하나로 옮긴다.
# Each step of the proof, in the order the proof performs it
def partition(a, b, n):
    return np.linspace(a, b, n + 1)


def steps_of_the_proof(a, b, epsilon, delta_from_epsilon):
    eps_prime = epsilon / (b - a)               # split the tolerance
    delta = delta_from_epsilon(eps_prime)       # uniform continuity gives delta
    n = int(np.ceil((b - a) / delta))           # corollary 5 gives such an n
    return eps_prime, delta, n
\(\delta\)를 주는 부분만 함수마다 다르다. \(f(x) = x^2\)을 \([0,b]\)에서 보면 1절에서 확인한 대로 \(\delta = \epsilon'/(2b)\)이다.
이제 상합과 하합을 계산한다. 각 부분구간에서 최댓값과 최솟값을 잡아야 하는데, 그 두 값의 존재를 보장하는 것이 정리 44이다. 코드에서는 촘촘한 표본의 최대·최소로 대신한다.
# Upper and lower sums built from the max and min on each subinterval
def upper_and_lower(f, a, b, n, samples=200):
    points = partition(a, b, n)
    left = points[:-1].reshape(n, 1)
    right = points[1:].reshape(n, 1)
    weights = np.linspace(0.0, 1.0, samples).reshape(1, samples)
    values = f(left + (right - left) * weights)
    widths = np.diff(points)
    lower = float(np.sum(values.min(axis=1) * widths))
    upper = float(np.sum(values.max(axis=1) * widths))
    return lower, upper
두 구간에서 절차를 끝까지 돌린다.
# Run the whole recipe and check the conclusion of theorem 8 (Riemann's condition)
square = lambda t: t ** 2

for a, b, epsilon in ((0.0, 1.0, 0.01), (0.0, 2.0, 0.01)):
    eps_prime, delta, n = steps_of_the_proof(
        a, b, epsilon, lambda e: e / (2 * b))
    lower, upper = upper_and_lower(square, a, b, n)
    print(f"[{a:.0f}, {b:.0f}] with epsilon = {epsilon}")
    print(f"    eps' = eps/(b-a) = {eps_prime:.6f}")
    print(f"    delta            = {delta:.6f}")
    print(f"    n                = {n}")
    print(f"    U - L            = {upper - lower:.6f}"
          f"   < epsilon : {upper - lower < epsilon}")
[0, 1] with epsilon = 0.01
    eps' = eps/(b-a) = 0.010000
    delta            = 0.005000
    n                = 200
    U - L            = 0.005000   < epsilon : True
[0, 2] with epsilon = 0.01
    eps' = eps/(b-a) = 0.005000
    delta            = 0.001250
    n                = 1600
    U - L            = 0.005000   < epsilon : True
두 경우 모두 마지막 줄이 참이다. 8회 정리 25이 요구하는 것이 정확히 이것이므로 \(x^2\)은 두 구간에서 적분 가능하다.
\(U - L\)의 값이 두 경우에 똑같이 \(0.005\)인 것은 우연이 아니다. \(x^2\)이 증가하므로 각 부분구간에서 \(M_k - m_k = x_k^2 - x_{k-1}^2\)이고, 이 합은 10회 정리 31의 증명에서와 같이 망원경처럼 접혀 \(b^2 - a^2\)이 된다. 여기에 폭 \(\frac{b-a}{n}\)을 곱한 것이 \(U-L\)이다.
# For an increasing function the oscillations telescope; compare with the numbers above
for a, b in ((0.0, 1.0), (0.0, 2.0)):
    _, _, n = steps_of_the_proof(a, b, 0.01, lambda e: e / (2 * b))
    predicted = (b - a) / n * (b ** 2 - a ** 2)
    lower, upper = upper_and_lower(square, a, b, n)
    print(f"[{a:.0f}, {b:.0f}] n = {n:>5} : "
          f"telescoped = {predicted:.8f}   measured = {upper - lower:.8f}")
[0, 1] n =   200 : telescoped = 0.00500000   measured = 0.00500000
[0, 2] n =  1600 : telescoped = 0.00500000   measured = 0.00500000
예측과 측정이 소수점 아래 여덟 자리까지 같다.
마지막으로 증명이 주는 \(\delta\)가 최선이 아니라는 서술 파트 4절의 지적을 확인한다. \([0,1]\)에서 직접 계산한 \(\delta = \epsilon'/2\)와 증명이 주는 \(\delta = \eta/2\)를 각각 넣어 본다.
# Both deltas work; the one the proof hands over is smaller, so it asks for more pieces
for name, delta in (("direct calculation", 0.005), ("the proof's route", 0.00125)):
    n = int(np.ceil(1.0 / delta))
    lower, upper = upper_and_lower(square, 0.0, 1.0, n)
    print(f"{name:>20} : delta = {delta:<8} n = {n:>4}  "
          f"U - L = {upper - lower:.6f}  < 0.01 : {upper - lower < 0.01}")
  direct calculation : delta = 0.005    n =  200  U - L = 0.005000  < 0.01 : True
   the proof's route : delta = 0.00125  n =  800  U - L = 0.001250  < 0.01 : True
\(n\)이 네 배 차이인데 둘 다 결론에 도달한다. 정의 28은 통하는 \(\delta\)가 하나 있으면 된다고 할 뿐이고, 가장 큰 \(\delta\)를 요구하지 않는다.
\(n = 200\)일 때의 상합과 하합을 그려 둔다. 두 계단이 곡선을 위아래로 감싸고, 그 사이 넓이가 \(0.005\)이다.
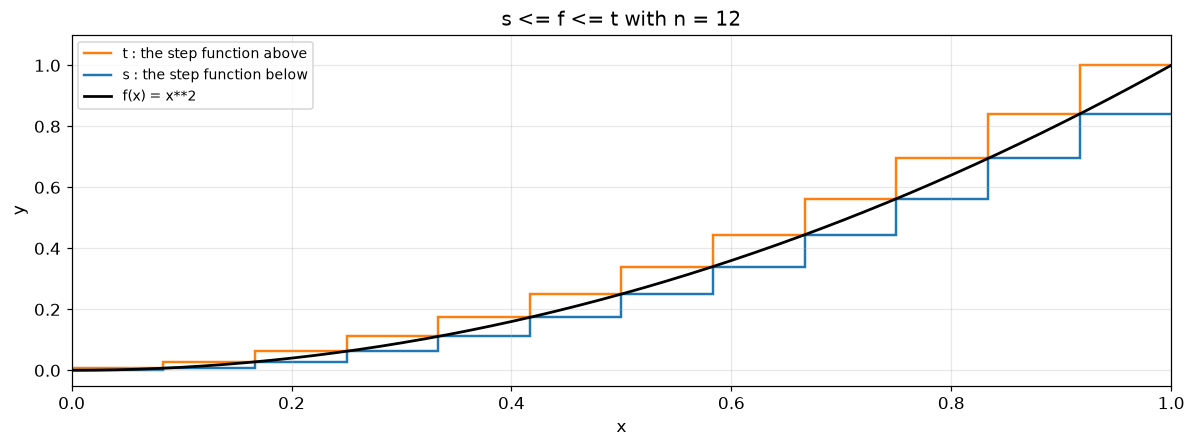
그림은 \(n = 12\)로 그렸다. \(n = 200\)에서는 두 계단이 곡선과 붙어 눈으로 구분되지 않으며, 구분되지 않는다는 것이 \(U-L\)이 작다는 뜻이다.
마치며#
점마다 필요한 \(\delta\)가 \(p = 0.5\)에서 \(0.0099\)이고 \(p = 10\)에서 \(0.0005\)였다. 스무 배 차이이지만 구간이 닫혀 있으므로 가장 나쁜 자리가 그 안에 있고, 거기서 통하는 \(\delta\)가 전부를 감당했다.
\((0,1)\)에서 \(f(x) = x\)의 표본 최댓값은 표본을 십만 개로 늘려도 \(1\)에 도달하지 않았다. 최소상계는 있는데 최댓값이 없다.
\(\delta\)를 \(0.001\)까지 줄여도 \(1/x\)의 두 점은 함숫값의 차 \(1\)을 유지했다. 상자를 옮겨 본 그림에서 \(0\) 근처의 상자만 뚫린다.
그리고 증명을 그대로 실행하여 \(\epsilon = 0.01\)에 대해 \(n = 200\)을 얻었다. \(U - L = 0.005\)로 \(\epsilon\)보다 작았고, 망원경 합의 예측값과 여덟 자리까지 일치했다. 증명이 존재를 말하는 데 그치지 않고 절차를 담고 있었다.
서술 파트의 내용 |
이 노트북의 코드 |
|---|---|
\(\delta\)가 \(p\)에 의존한다 |
1절 |
오른쪽 끝이 가장 나쁜 자리이다 |
1절 |
2절의 \(M\)과 \(n = M+1\) 표 |
|
\(\sup\)과 \(\max\)의 구별 |
2절 열린구간과 닫힌구간의 두 셀 |
(15.7)의 두 점 |
3절 |
정의 28의 상자 |
3절 그림의 |
정리 46의 증명 |
4절 |
정리 44가 쓰이는 자리 |
4절 |
정리 25의 결론 |
4절 |
더 해 볼 것#
1절의 \(\epsilon\)을 \(0.0001\)로 바꾸어 표를 다시 출력해 보자. 점마다의 \(\delta\)와 구간 전체의 \(\delta\)의 비가 달라지는가. \(\epsilon\)을 줄이면 두 값이 더 가까워지는가 멀어지는가.
3절의 상자 그림에서 왼쪽 상자를 \(x = 0.5\) 오른쪽에만 세 개 놓아 보자. 곡선이 상자를 벗어나는가. \((0,1)\) 대신 \([0.5, 1]\)에서 \(1/x\)가 균등연속인 이유를 이 그림으로 설명해 보자.
steps_of_the_proof에 \(f(x) = x^3\)을 \([0,2]\)에서 넣으려면 \(\delta\)를 주는 함수를 어떻게 써야 하는가. \(|x^3-y^3| = |x-y|\,|x^2+xy+y^2|\)을 쓰고, \([0,b]\)에서 둘째 인수의 상계를 구해 보자.4절 마지막 셀의 \(n = 200\)과 \(n = 800\)에서 \(U-L\)의 비는 얼마인가. 망원경 합의 식을 보고 그 비를 미리 예측할 수 있는가.
짝이 되는 서술