2회 실험 · 양화사의 순서#
이 실험
짝 서술 |
|
확인하는 것 |
양화사의 순서를 바꾸면 명제 자체가 달라진다 |
이번 회차의 대상은 논리 규칙이다. 계산할 것도 그릴 것도 많지 않으므로 실험은 두 개이며, 둘 다 서술 2절의 (2.5)와 (2.6)을 다룬다.
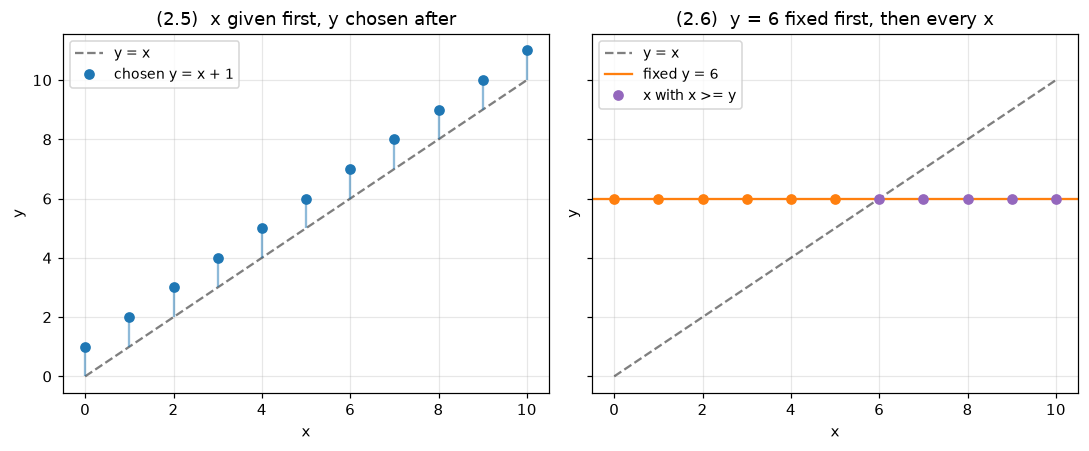
왼쪽이 (2.5)이고 오른쪽이 (2.6)이다. 기호는 같은 것이 같은 개수만큼 쓰였고 순서만 다른데, 서술 쪽에서 확인했듯 왼쪽은 참이고 오른쪽은 거짓이다. 무엇이 먼저 주어지고 무엇을 뒤에 고르는가, 이것 하나가 두 명제를 가른다.
여기서는 그 차이를 두 가지 방법으로 본다. 먼저 유한개의 점을 평면에 찍어 두 명제의 모양이 어떻게 다른지 보고, 그다음 sympy로 조건을 만족하는 값의 집합을 구해 두 집합이 어느 문자에 의존하는지 비교한다.
미리 밝혀 둘 것이 하나 있다. 아래 실험은 어느 것도 (2.5)나 (2.6)의 참·거짓을 판정하지 않는다. 그림은 유한개의 점만 찍고, sympy는 해집합을 돌려줄 뿐 결론을 내려 주지 않는다. 판정은 손으로 한 논증이 하며, 코드는 그 논증이 무엇을 말하는지 보여 줄 뿐이다.
서술 파트의 내용 |
여기서 확인하는 방법 |
|---|---|
(2.5)가 참이다 |
\(x\)마다 \(y = x + 1\)을 골라 찍고, 고른 \(y\)가 \(x\)를 따라 움직이는지 본다 |
(2.6)이 거짓이다 |
\(y\)를 하나 고정하고 \(x \ge y\)인 \(x\)가 남는지 본다 |
고정한 \(y\)마다 \(x = y\)가 (2.6)의 반례가 됨을 확인한다 |
|
부정이 참임을 보이고 원명제가 거짓이라고 결론짓는다 |
|
먼저 고정한 것이 뒤의 조건을 결정한다 |
|
0. 준비#
쓰는 것은 numpy, matplotlib, sympy 세 가지이다. 색은 이 회차에서 실제로 쓰는 네 개만 정한다. C_LOWER는 \(x\)가 주어진 뒤에 고른 \(y\), C_UPPER는 먼저 고정해 둔 \(y\), C_CEX는 반례에 쓴다.
1. 순서를 바꾸면 참·거짓이 달라진다#
두 명제를 한 화면에 나란히 놓는다. 가로축이 \(x\), 세로축이 \(y\)이며, 조건 \(x < y\)가 성립하는 곳은 대각선 \(y = x\)의 위쪽이다.
왼쪽 그림이 (2.5)이다. \(x\)가 먼저 주어지고 \(y\)를 그 뒤에 고르므로 \(y\)는 \(x\)에 의존해도 된다. \(x\)마다 \(y = x + 1\)을 골라 대각선에서 위로 올라가는 선분을 그린다. 선분의 길이는 모두 \(1\)이고, 끝점은 언제나 대각선 위쪽에 있다.
오른쪽 그림이 (2.6)이다. \(y\)를 먼저 하나 고정해야 하므로 \(y\)는 수평선 하나가 된다. 뒤에 오는 모든 \(x\)가 그 수평선 하나에 대하여 \(x < y\)를 만족해야 한다. 수평선보다 오른쪽에 있는 \(x\), 즉 \(x \ge y\)인 \(x\)가 (2.6)의 반례이다.
# Compare the two orders: y chosen after x, versus y fixed before x
x_sample = np.linspace(0, 10, 11)
y_chosen = x_sample + 1.0
y_fixed = 6.0

fig, axes = plt.subplots(1, 2, figsize=(10.0, 4.2), sharex=True, sharey=True)

ax = axes[0]
ax.plot(x_sample, x_sample, "--", color=C_FUNC, alpha=0.5, label="y = x")
ax.vlines(x_sample, x_sample, y_chosen, color=C_LOWER, alpha=0.5)
ax.plot(x_sample, y_chosen, "o", color=C_LOWER, label="chosen y = x + 1")
ax.set_title("(2.5)  x given first, y chosen after")

ax = axes[1]
ax.plot(x_sample, x_sample, "--", color=C_FUNC, alpha=0.5, label="y = x")
ax.axhline(y_fixed, color=C_UPPER, label=f"fixed y = {y_fixed:.0f}")
ok = x_sample[x_sample < y_fixed]
bad = x_sample[x_sample >= y_fixed]
ax.plot(ok, np.full(ok.shape, y_fixed), "o", color=C_UPPER)
ax.plot(bad, np.full(bad.shape, y_fixed), "o", color=C_CEX, label="x with x >= y")
ax.set_title(f"(2.6)  y = {y_fixed:.0f} fixed first, then every x")

for ax in axes:
    ax.set_xlabel("x")
    ax.set_ylabel("y")
    ax.legend(loc="upper left", fontsize=9)

plt.tight_layout()
plt.show()

print("chosen y values (2.5) :", y_chosen)
print("sample x that break x < y (2.6) :", bad)
chosen y values (2.5) : [ 1.  2.  3.  4.  5.  6.  7.  8.  9. 10. 11.]
sample x that break x < y (2.6) : [ 6.  7.  8.  9. 10.]
왼쪽에서 고른 \(y\)는 열한 개이고 모두 다른 값이다. \(x\)가 달라지면 고르는 \(y\)도 달라진다는 것, 그것이 \(\exists y\)가 \(\forall x\) 뒤에 놓였다는 뜻이다. 오른쪽에서 고정한 \(y\)는 하나뿐이고, 그 하나가 모든 \(x\)를 감당해야 한다.
\(y = 6\)을 고른 것에 특별한 이유는 없다. 다른 값으로 고정해도 결과는 같은지 확인해 보자. 아래에서는 표본 안에서 반례의 개수를 세는 것과 함께, (2.7)에서 읽어 낸 (2.6)의 반례 \(x = y\)를 직접 넣어 본다.
# For several fixed y, count sample violations and test the witness x = y from (2.7)
for y_test in (0.0, 3.0, 6.0, 9.0, 12.0):
    broken = x_sample[x_sample >= y_test]
    witness = y_test
    print(f"y = {y_test:5.1f} | violations in the sample: {broken.size:2d}"
          f" | witness x = {witness:5.1f} -> x < y is {witness < y_test}")
y =   0.0 | violations in the sample: 11 | witness x =   0.0 -> x < y is False
y =   3.0 | violations in the sample:  8 | witness x =   3.0 -> x < y is False
y =   6.0 | violations in the sample:  5 | witness x =   6.0 -> x < y is False
y =   9.0 | violations in the sample:  2 | witness x =   9.0 -> x < y is False
y =  12.0 | violations in the sample:  0 | witness x =  12.0 -> x < y is False
\(y\)를 키우면 표본 안의 반례는 줄어들고, \(y = 12\)에서는 하나도 남지 않는다. 표본을 \([0, 10]\)에서만 잡았기 때문이다. 이것을 (2.6)이 참이라는 증거로 읽으면 안 된다. 표본을 넓히면 반례는 다시 나타난다.
오른쪽 열은 표본과 무관하다. 서술 쪽 (2.7)은 (2.6)의 부정이 \(\forall y \in \R,\; \exists x \in \R,\; x \ge y\)라고 말하고, 그 \(x\)를 어떻게 잡는지까지 알려 준다. \(x = y\)로 잡으면 된다. 어느 \(y\)에서도 x < y is False가 나오는 것이 그 확인이다. 부정이 참이므로 정리 2에 의하여 (2.6)은 거짓이다.
여기서 두 열이 하는 일이 다르다는 것을 짚어 두자. 왼쪽 열은 유한한 표본을 세었으므로 표본을 바꾸면 값도 바뀐다. 오른쪽 열은 표본과 무관한 식 \(x = y\)를 다섯 개의 \(y\)에서 시험한 것이다. 다섯 번도 여전히 유한한 확인이지만, 그 식이 모든 \(y\)에서 통한다는 것은 서술 쪽이 이미 손으로 보였으므로 확인할 대상이 식 하나로 줄어 있다. 같은 출력이라도 두 열이 뒷받침하는 범위는 다르다.
2. 해집합으로 두 명제를 구분한다#
sympy는 양화사가 붙은 명제의 참·거짓을 판정해 주지 않는다. “\(\forall x\, \exists y,\ x < y\)”를 넣으면 참을 돌려주는 함수는 없다.
대신 조건을 만족하는 값의 집합은 구해 준다. solveset에 어느 문자를 풀 것인지 지정하면, 나머지 문자는 상수처럼 취급해 답을 그 문자로 표현한다. 이 “어느 문자를 먼저 붙잡아 두는가”가 양화사의 순서와 정확히 대응한다.
# Solve for one letter while the other is held fixed, and compare the two answers
x, y = sp.symbols("x y", real=True)

y_set = sp.solveset(x < y, y, domain=sp.S.Reals)
x_set = sp.solveset(x >= y, x, domain=sp.S.Reals)

print("(2.5) x is fixed first; the y that satisfy x < y :")
sp.pprint(y_set)
print("(2.7) y is fixed first; the x that satisfy x >= y :")
sp.pprint(x_set)
(2.5) x is fixed first; the y that satisfy x < y :
(x, ∞)
(2.7) y is fixed first; the x that satisfy x >= y :
[y, ∞)
두 답의 모양이 다르다. 첫 번째 집합 \((x, \infty)\)는 \(x\)를 담고 있고, 두 번째 집합 \([y, \infty)\)는 \(y\)를 담고 있다. 먼저 고정한 문자가 뒤에 나오는 집합의 모양을 결정한다. 이것이 양화사의 순서가 하는 일이며, 코드에서는 solveset의 두 번째 인자를 무엇으로 주었는지에 해당한다.
두 집합 모두 비어 있지 않다. 첫 번째가 비어 있지 않다는 것은 고정한 \(x\)마다 \(x < y\)를 만족하는 \(y\)가 있다는 뜻이고, 두 번째가 비어 있지 않다는 것은 고정한 \(y\)마다 \(x \ge y\)인 \(x\), 즉 (2.6)의 반례가 있다는 뜻이다. 구체적인 값을 넣어 확인해 보자.
# Substitute concrete values and check that neither solution set is ever empty
for value in (-100, 0, 10 ** 6):
    ys = y_set.subs(x, value)
    xs = x_set.subs(y, value)
    print(f"value = {value:>8} | y-set = {ys}, empty ? {ys.is_empty}"
          f" | x-set = {xs}, empty ? {xs.is_empty}")
value =     -100 | y-set = Interval.open(-100, oo), empty ? False | x-set = Interval(-100, oo), empty ? False
value =        0 | y-set = Interval.open(0, oo), empty ? False | x-set = Interval(0, oo), empty ? False
value =  1000000 | y-set = Interval.open(1000000, oo), empty ? False | x-set = Interval(1000000, oo), empty ? False
값을 아무리 키워도 두 집합은 비지 않는다. 다만 세 개를 넣어 본 것뿐이므로 이것 자체는 증명이 아니다.
(2.6)이 요구하는 것은 더 강하다. 하나의 \(y\)가 모든 \(x\)를 감당해야 한다. 그런 \(y\)의 집합은 \(x\)마다 얻은 구간 \((x, \infty)\)를 전부 교집합한 것이다. \(x\)를 유한개만 모으면 교집합이 어떻게 되는지 보자.
# Intersect the y-intervals over a finite list of x, and watch the left end move right
def y_good_for_all(x_values):
    """Return the set of y satisfying x < y for every x in x_values."""
    pieces = [sp.Interval.open(sp.Integer(v), sp.oo) for v in x_values]
    return sp.Intersection(*pieces)

for bound in (1, 5, 20, 100):
    print(f"x taken from 0..{bound:<4d} -> y must lie in {y_good_for_all(range(bound + 1))}")
x taken from 0..1    -> y must lie in Interval.open(1, oo)
x taken from 0..5    -> y must lie in Interval.open(5, oo)
x taken from 0..20   -> y must lie in Interval.open(20, oo)
x taken from 0..100 -> y must lie in Interval.open(100, oo)
유한개의 \(x\)만 모으는 한 교집합은 언제나 비어 있지 않다. 그러나 왼쪽 끝이 \(1, 5, 20, 100\)으로 계속 오른쪽으로 밀린다. \(x\)를 더 넣으면 왼쪽 끝은 그만큼 더 밀린다.
\(x\)가 \(\R\) 전체를 훑으면 왼쪽 끝은 어느 유한한 값에도 머물지 않는다. 후보로 내놓은 \(y\)가 무엇이든 \(x = y\)에서 \(x < y\)가 깨지므로 그 \(y\)는 교집합에 남지 않는다. 교집합은 공집합이 되고, (2.6)을 참으로 만드는 \(y\)는 없다. 코드가 보여 준 것은 왼쪽 끝이 밀린다는 사실까지이고, 교집합이 공집합이라는 결론은 손으로 한 논증이 낸 것이다.
판정은 자동화되지 않는다
sympy는 해집합을 계산해 줄 뿐이고 “그러므로 명제가 참이다”라는 결론은 내려 주지 않는다. 위 코드에서도 결론 문장은 사람이 미리 적어 둔 것이다.
solveset이 돌려준 집합이 비어 있지 않음을 확인했다고 해서 전칭명제가 증명된 것도 아니다. 실제로 확인한 것은 유한개의 값뿐이다. 논증은 여전히 손으로 해야 한다.
마치며#
두 명제 (2.5)와 (2.6)은 기호가 같고 순서만 다르다. 그림에서는 이 차이가 “점이 대각선을 따라 올라가는가, 수평선 하나에 묶여 있는가”로 나타났고, sympy에서는 “해집합이 \(x\)를 담는가 \(y\)를 담는가”로 나타났다. 어느 쪽에서 보아도 갈라지는 지점은 하나이다. 무엇을 먼저 고정했는가.
(2.6)이 거짓이라는 결론은 반례에서 나왔다. 그 반례는 그림에서 찾은 것이 아니라 (2.7), 즉 (2.6)의 부정을 정리 2으로 적어 놓고 거기서 \(x = y\)를 읽어 낸 것이다. 부정을 정확히 적는 일이 반례를 찾는 일보다 먼저이다.
유한한 확인이 어디까지 갈 수 있는지도 보았다. \(y = 12\)에서 표본 반례가 사라졌지만 그것은 표본의 한계였고, 교집합의 왼쪽 끝은 아무리 밀어도 유한한 곳에 멈춰 있었다. 유한한 계산은 명제가 무엇을 요구하는지 보여 주지만, 그 요구가 충족되는지는 말해 주지 않는다.
서술 파트가 주장한 것과 이 노트북이 그것을 확인한 자리를 나란히 놓는다.
서술 파트의 내용 |
이 노트북의 코드 |
|---|---|
(2.5)가 참이다 — \(x\)마다 \(y = x + 1\)을 고르면 된다 |
|
(2.6)은 하나의 \(y\)가 모든 \(x\)를 감당해야 한다 |
|
1절 둘째 셀의 |
|
먼저 고정한 문자가 뒤에 나오는 집합을 결정한다 |
|
(2.6)을 참으로 만드는 \(y\)는 없다 |
2절의 |
더 해 볼 것#
x_sample의 범위를 \([0, 10]\)에서 \([0, 100]\)으로 넓히고 다시 돌려 보자. \(y = 12\)에서 표본 반례가 몇 개로 늘어나는가. 표본을 넓히는 것으로 (2.6)이 거짓임을 보일 수 있는지 생각해 보자.서술 2절은 \(S = \varnothing\)일 때 \(\forall x \in \varnothing,\, P(x)\)가 참이라고 말한다. 파이썬의
all([])과any([])를 각각 출력해 보고, 두 값이 (2.3)·(2.4)와 어떻게 맞아떨어지는지 적어 보자.예제 4의 \(n^2 + n + 41\)을 확인해 보자. 소수 판정 함수를 직접 정의하고 \(n = 0\)부터 \(n = 40\)까지 돌려서, 마흔 번의 확인이 참을 보증하지 못한다는 것을 눈으로 보자.
\(y = x + 1\) 대신 \(y = x + 0.001\)로 골라도 (2.5)가 참임을 확인해 보자. 그다음 \(y = x\)로 바꾸면 무엇이 깨지는지 그림에서 찾아보자.
짝이 되는 서술