9회 실험 · 최소상계의 성질 검산#
이 실험
짝 서술 |
|
확인하는 것 |
최소상계가 합에 대하여 분배되지 않는다는 것과, 그럼에도 적분에서는 등호가 회복된다는 것 |
서술 파트의 증명은 네 단계를 밟았다. 그중 (ii)와 (iii)은 부등식을 한 방향씩 얻고, (iv)에서 두 부등식을 맞물려 등호를 결론지었다. 왜 한 방향씩만 얻는지가 이 노트북에서 확인할 것이다.
이유는 최소상계가 합에 대하여 분배되지 않는다는 데 있다. 두 함수가 최댓값을 갖는 점이 다르면 \(\sup(f+g)\)는 \(\sup f + \sup g\)보다 작다. 이 사실을 먼저 수치로 보고, 표본추출이 놓칠 수 있으므로 sympy로 정확한 값을 다시 구한다.
그다음 같은 일이 상합과 하합에서 일어나는 것을 본다. (9.10)의 사슬이 \(n\)등분 분할에서 그대로 나타나며, 양 끝의 두 부등식이 실제로 엄격한 부등식이다. 그런데 \(n\)을 키우면 사슬 전체가 한 점으로 조여진다. 그것이 (9.13)의 (iv) 단계이다.
마지막으로 (9.9)의 자리바꿈과 비교 정리를 확인한다.
서술 파트의 내용 |
여기서 확인하는 방법 |
|---|---|
흔한 오해 — 최소상계가 합에 대하여 분배되지 않는다 |
표본으로 한 번, sympy의 정확한 최댓값으로 한 번 |
(9.10)의 부등식 사슬 |
네 값을 한 표에 두고 \(n\)을 키운다 |
(9.10)의 부등호가 진짜 부등호라는 것 |
\(n=1\)부터 \(50\)까지 엄격한 부등식인 횟수를 센다 |
(9.13)의 (iv) 단계 |
사슬의 양 끝이 같은 값으로 조여지는 것을 본다 |
(9.9)의 자리바꿈 |
\(L_n(-f)\)와 \(-U_n(f)\)를 대조하고 두 그림을 나란히 그린다 |
적분값을 가둔 구간끼리 비교한다 |
0. 준비#
이 회차에서 쓸 것만 불러온다. 색은 상수로 고정한다.
1. 최소상계는 합에 대하여 분배되지 않는다#
\([0,1]\)에서 \(f(x) = x - x^2\)과 \(g(x) = x^2 - x\)를 잡는다. 두 함수를 더하면 값이 항상 \(0\)인 함수이다.
먼저 표본으로 최댓값을 구한다. 격자를 촘촘히 잡고 그 위에서 가장 큰 값을 고른다.
# Sample two functions on the same grid and compare the two suprema
grid = np.linspace(0.0, 1.0, 100000)
f_on_grid = grid - grid ** 2
g_on_grid = grid ** 2 - grid

print(f"sup f          = {f_on_grid.max():.12f}   at x = {grid[f_on_grid.argmax()]}")
print(f"sup g          = {g_on_grid.max():.12f}   at x = {grid[g_on_grid.argmax()]}")
print(f"sup f + sup g  = {f_on_grid.max() + g_on_grid.max():.12f}")
print(f"sup (f + g)    = {(f_on_grid + g_on_grid).max():.12f}")
sup f          = 0.249999999975   at x = 0.4999949999499995
sup g          = 0.000000000000   at x = 0.0
sup f + sup g  = 0.249999999975
sup (f + g)    = 0.000000000000
\(\sup f + \sup g\)가 \(1/4\)쯤이고 \(\sup(f+g) = 0\)이다. 두 값이 같지 않다. 부등식은 성립하며 방향은 서술 파트의 흔한 오해 상자가 말한 대로이다.
두 최댓점이 서로 다르다는 것이 원인이다. \(f\)는 \(x = 1/2\)에서, \(g\)는 끝점에서 최댓값을 갖는다. 한 점에서 두 값을 동시에 얻을 수 없으므로 합의 최댓값이 최댓값의 합에 미치지 못한다.
그런데 위 출력에서 \(f\)의 최댓점이 \(1/2\)이 아니라 0.4999949999499995로 찍혔고 최댓값도 \(0.25\)에 조금 못 미친다. 격자에 \(1/2\)이 들어 있지 않기 때문이다. 점을 십만 개 잡으면 간격이 \(1/99999\)이라 \(1/2\)이 격자점이 되지 못한다.
표본으로 얻은 것은 추정값이다. 정확한 값으로 다시 확인한다.
# The same comparison with exact maxima instead of sampled ones
t = sp.Symbol("t", real=True)
domain = sp.Interval(0, 1)

F = t - t ** 2
G = t ** 2 - t

sup_F = sp.maximum(F, t, domain)
sup_G = sp.maximum(G, t, domain)
sup_FG = sp.maximum(F + G, t, domain)

print("sup f         =", sup_F, "  at t =", sp.solveset(sp.Eq(F, sup_F), t, domain))
print("sup g         =", sup_G, "  at t =", sp.solveset(sp.Eq(G, sup_G), t, domain))
print("sup f + sup g =", sup_F + sup_G)
print("sup (f + g)   =", sup_FG)
print("gap           =", sp.simplify(sup_F + sup_G - sup_FG))
sup f         = 1/4   at t = {1/2}
sup g         = 0   at t = {0, 1}
sup f + sup g = 1/4
sup (f + g)   = 0
gap           = 1/4
\(f\)의 최댓점이 정확히 \(1/2\)이고 최댓값이 \(1/4\)이며, \(g\)의 최댓점은 \(\{0,1\}\)로 두 개이다. 차이는 정확히 \(1/4\)이다. 표본이 준 값과 거의 같지만 이번에는 근사가 섞여 있지 않다.
두 함수가 같은 점에서 최댓값을 가지면 등호가 성립한다. \(g\)를 \(f\) 자신으로 바꾸면 \(\sup(f+f) = 1/2 = \sup f + \sup f\)이다. 최댓점이 겹치는지가 등호를 가른다.
2. 상합과 하합에 같은 일이 일어난다#
이제 적분 쪽으로 옮긴다. 분할과 계단함수의 적분, 상합과 하합을 이 파일 안에서 직접 만든다. 7회 정의 11과 정의 13을 그대로 옮긴 것이다.
# Build a partition, the integral of a step function, and the two sums by hand
def partition(a, b, n):
    """Return the n + 1 division points of the equal partition of [a, b]."""
    return np.linspace(a, b, n + 1)


def step_integral(points, heights):
    """Integral of the step function that takes heights[k] on the k-th subinterval."""
    widths = np.diff(points)
    return float(np.sum(np.asarray(heights) * widths))


def lower_upper_sums(f, a, b, n, samples=200):
    """Return (lower, upper) for the equal partition of [a, b] into n pieces.

    f must accept a numpy array. The min and max on each subinterval are
    estimated from a grid of `samples` points that includes both endpoints.
    """
    points = partition(a, b, n)
    left = points[:-1].reshape(n, 1)
    right = points[1:].reshape(n, 1)
    weights = np.linspace(0.0, 1.0, samples).reshape(1, samples)
    cells = left + (right - left) * weights
    values = f(cells)
    return (step_integral(points, values.min(axis=1)),
            step_integral(points, values.max(axis=1)))
이번에는 적분 가능한 두 함수를 쓴다. \(f(x) = x^2\)과 \(g(x) = (1-x)^2\)이다. 7회 (7.22)에서 \(\int_0^1 x^2\,dx = 1/3\)을 얻었고, \(g\)는 \(1 - 2x + x^2\)이므로 정리 22과 7회 (7.8), (7.12), (7.22)를 함께 쓰면 \(1 - 1 + \frac13 = \frac13\)이다. 두 적분의 합은 \(2/3\)이다.
이 두 함수를 고른 이유는 최댓점이 서로 반대쪽에 있기 때문이다. 어느 부분구간에서든 \(f\)의 최댓값은 오른쪽 끝에서, \(g\)의 최댓값은 왼쪽 끝에서 나온다. 1절의 상황이 부분구간마다 되풀이된다.
# The chain of (9.10) at the level of the equal partition
def f(x):
    return x ** 2


def g(x):
    return (1.0 - x) ** 2


def f_plus_g(x):
    return f(x) + g(x)


exact = 2.0 / 3.0
header = (f"{'n':>6} {'L(f)+L(g)':>13} {'L(f+g)':>13} {'2/3':>10}"
          f" {'U(f+g)':>13} {'U(f)+U(g)':>13}")
print(header)
print("-" * len(header))
for n in (1, 2, 5, 10, 100, 1000):
    lower_f, upper_f = lower_upper_sums(f, 0.0, 1.0, n)
    lower_g, upper_g = lower_upper_sums(g, 0.0, 1.0, n)
    lower_s, upper_s = lower_upper_sums(f_plus_g, 0.0, 1.0, n)
    print(f"{n:>6} {lower_f + lower_g:>13.8f} {lower_s:>13.8f} {exact:>10.6f}"
          f" {upper_s:>13.8f} {upper_f + upper_g:>13.8f}")
     n     L(f)+L(g)        L(f+g)        2/3        U(f+g)     U(f)+U(g)
-------------------------------------------------------------------------
     1    0.00000000    0.50001263   0.666667    1.00000000    2.00000000
     2    0.25000000    0.50000000   0.666667    1.00000000    1.25000000
     5    0.48000000    0.58000010   0.666667    0.77600000    0.88000000
    10    0.57000000    0.62000000   0.666667    0.72000000    0.77000000
   100    0.65670000    0.66170000   0.666667    0.67170000    0.67670000
  1000    0.66566700    0.66616700   0.666667    0.66716700    0.66766700
각 행이 왼쪽에서 오른쪽으로 커진다. 이것이 (9.10)의 사슬이다.
가운데 두 부등식은 하합이 적분값 이하이고 상합이 적분값 이상이라는 것이고, 양 끝의 두 부등식이 1절에서 본 현상이다.
\(n=1\) 행의 L(f+g)가 \(0.5\)가 아니라 0.50001263으로 찍혔다. \(f+g = 2x^2-2x+1\)의 최솟값은 \(x=0.5\)에서 \(0.5\)인데, samples=200이 만드는 격자에 \(0.5\)가 들어 있지 않다. 표본추출은 최솟값을 추정할 뿐이다. 추정값은 실제 최솟값보다 크므로 하합이 조금 크게 나오고, 사슬의 방향은 그대로이다.
양 끝의 부등호가 정말 엄격한 부등호인지 확인한다.
# Are the two outer inequalities strict, or do they sometimes collapse?
broken = []
strict_left = 0
strict_right = 0

for n in range(1, 51):
    lower_f, upper_f = lower_upper_sums(f, 0.0, 1.0, n)
    lower_g, upper_g = lower_upper_sums(g, 0.0, 1.0, n)
    lower_s, upper_s = lower_upper_sums(f_plus_g, 0.0, 1.0, n)
    if not (lower_f + lower_g <= lower_s <= upper_s <= upper_f + upper_g):
        broken.append(n)
    if lower_f + lower_g < lower_s:
        strict_left += 1
    if upper_s < upper_f + upper_g:
        strict_right += 1

print("n where the chain breaks       :", broken)
print("n where the left one is strict :", strict_left, "of 50")
print("n where the right one is strict:", strict_right, "of 50")
n where the chain breaks       : []
n where the left one is strict : 50 of 50
n where the right one is strict: 50 of 50
사슬은 한 번도 깨지지 않고, 양 끝의 부등호는 \(50\)번 모두 엄격하다. 등호가 아니다. 서술 파트가 (9.10)에서 등호를 주장하지 않은 이유가 이것이다.
3. 적분 가능하면 등호가 회복된다#
위 표에서 \(n\)이 커질수록 다섯 열이 서로 가까워진다. \(n=1000\)에서 가장 왼쪽과 가장 오른쪽의 차이가 \(0.002\)이다.
정리 22의 증명이 한 일이 이것이다. \(f\)와 \(g\)가 적분 가능하다는 가정에서 (9.13)의 사슬은 양 끝이 같은 값이 되고, 그러면 가운데 값들도 그 값과 같아질 수밖에 없다. 부등식이 사라지는 것이 아니라 양 끝이 붙어서 등호가 되는 것이다.
계수가 붙은 경우도 확인한다. 음수 계수를 하나 넣는다.
# A linear combination with a negative coefficient
c1, c2 = 2.0, -3.0


def combination(x):
    return c1 * f(x) + c2 * g(x)


header = f"{'n':>8} {'L_n':>14} {'U_n':>14} {'U_n - L_n':>14}"
print(header)
print("-" * len(header))
for n in (10, 100, 1000, 10000):
    lower, upper = lower_upper_sums(combination, 0.0, 1.0, n)
    print(f"{n:>8} {lower:>14.8f} {upper:>14.8f} {upper - lower:>14.8f}")

print()
print(f"c1 * (1/3) + c2 * (1/3) = {c1 / 3.0 + c2 / 3.0:.8f}")
       n            L_n            U_n      U_n - L_n
-----------------------------------------------------
      10    -0.58500000    -0.08500000     0.50000000
     100    -0.35835000    -0.30835000     0.05000000
    1000    -0.33583350    -0.33083350     0.00500000
   10000    -0.33358334    -0.33308334     0.00050000

c1 * (1/3) + c2 * (1/3) = -0.33333333
\(L_n\)과 \(U_n\)이 \(-1/3\)을 위아래에서 가둔다. (8.1)이 주는 값 \(2 \cdot \frac13 + (-3)\cdot\frac13 = -\frac13\)과 맞는다.
\(U_n - L_n\)이 \(n\)에 반비례하여 줄어든다. \(n\)을 \(10\)배 하면 차이가 \(10\)분의 \(1\)이 된다. 정리 25의 조건이 이 함수에 대해 성립하는 모습이다.
4. 부호를 바꾸면 상적분과 하적분이 자리를 바꾼다#
정리 28은 \(-f\)의 하적분이 \(f\)의 상적분에 \(-1\)을 곱한 것이라고 말한다. \(n\)등분 분할에서도 같은 일이 일어난다. 각 부분구간에서 \(-f\)의 최솟값은 \(f\)의 최댓값에 \(-1\)을 곱한 것이기 때문이다.
# The lower sum of -f should be minus the upper sum of f
def minus_f(x):
    return -f(x)


header = f"{'n':>6} {'L(-f)':>13} {'-U(f)':>13} {'U(-f)':>13} {'-L(f)':>13}"
print(header)
print("-" * len(header))
for n in (1, 2, 5, 10, 100):
    lower, upper = lower_upper_sums(f, 0.0, 1.0, n)
    lower_neg, upper_neg = lower_upper_sums(minus_f, 0.0, 1.0, n)
    print(f"{n:>6} {lower_neg:>13.8f} {-upper:>13.8f} {upper_neg:>13.8f} {-lower:>13.8f}")
     n         L(-f)         -U(f)         U(-f)         -L(f)
--------------------------------------------------------------
     1   -1.00000000   -1.00000000    0.00000000   -0.00000000
     2   -0.62500000   -0.62500000   -0.12500000   -0.12500000
     5   -0.44000000   -0.44000000   -0.24000000   -0.24000000
    10   -0.38500000   -0.38500000   -0.28500000   -0.28500000
   100   -0.33835000   -0.33835000   -0.32835000   -0.32835000
첫째 열과 둘째 열이 같고, 셋째 열과 넷째 열이 같다. \(n=1\) 행의 마지막 값이 -0.00000000으로 찍힌 것은 \(L_1(f) = 0\)에 \(-1\)을 곱한 부호 있는 영이며 값은 \(0\)이다.
그림으로도 확인한다. 왼쪽은 \(f\)이고 오른쪽은 \(-f\)이다. 색은 79회 내내 같은 뜻으로 쓰므로 파란색이 하합, 주황색이 상합이다. 겹쳐 그릴 때에는 바깥쪽을 먼저 그리고 안쪽을 나중에 그린다.
# The same partition drawn for f and for -f
n = 8
points = partition(0.0, 1.0, n)
left = points[:-1]
widths = np.diff(points)
lows = f(points[:-1])
highs = f(points[1:])
curve = np.linspace(0.0, 1.0, 400)

fig, axes = plt.subplots(1, 2)

ax = axes[0]
ax.bar(left, highs, width=widths, align="edge",
       color=C_UPPER, alpha=0.55, edgecolor="white", linewidth=0.5, label="upper sum")
ax.bar(left, lows, width=widths, align="edge",
       color=C_LOWER, alpha=0.85, edgecolor="white", linewidth=0.5, label="lower sum")
ax.plot(curve, f(curve), color=C_FUNC, linewidth=1.8, label="f(x) = x**2")
ax.set_title(f"f  :  L_{n} = {step_integral(points, lows):.4f},"
             f"  U_{n} = {step_integral(points, highs):.4f}")
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.set_ylim(-1.05, 1.05)
ax.legend(loc="upper left", fontsize=9)

ax = axes[1]
ax.bar(left, -highs, width=widths, align="edge",
       color=C_LOWER, alpha=0.55, edgecolor="white", linewidth=0.5, label="lower sum")
ax.bar(left, -lows, width=widths, align="edge",
       color=C_UPPER, alpha=0.85, edgecolor="white", linewidth=0.5, label="upper sum")
ax.plot(curve, -f(curve), color=C_FUNC, linewidth=1.8, label="-f(x)")
ax.set_title(f"-f  :  L_{n} = {step_integral(points, -highs):.4f},"
             f"  U_{n} = {step_integral(points, -lows):.4f}")
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.set_ylim(-1.05, 1.05)
ax.legend(loc="lower left", fontsize=9)

fig.tight_layout()
plt.show()
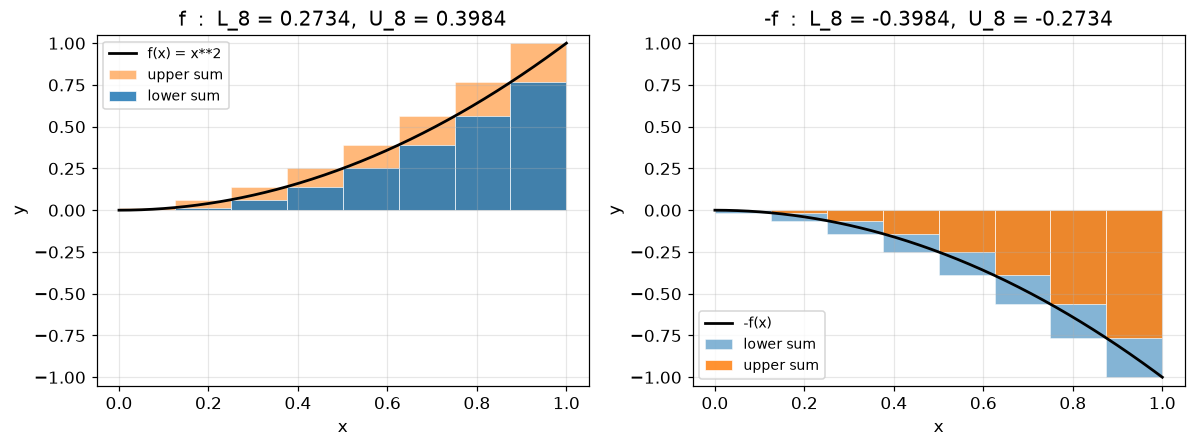
왼쪽 그림에서 파란 몸통이 안쪽이고 주황 띠가 바깥쪽이다. 오른쪽 그림에서는 반대이다. 주황이 안쪽으로 들어가고 파랑이 바깥으로 나갔다. 자리가 바뀌었다는 것이 색의 위치로 보인다.
값도 자리를 바꾸었다. 왼쪽에서 \(L_8 = 0.2734\)이고 \(U_8 = 0.3984\)인데, 오른쪽에서는 \(L_8 = -0.3984\)이고 \(U_8 = -0.2734\)이다.
5. 비교 정리와 적분값의 범위#
정리 24는 \(f \le g\)에서 \(\int f \le \int g\)를 준다. \([0,1]\)에서 \(x^2 \le x\)이므로 적분값도 그 순서여야 한다.
적분값을 직접 구하는 대신 \(L_n\)과 \(U_n\)으로 가둔다. 두 구간이 겹치지 않으면 순서가 확정된다.
# Comparison theorem (8.3) and the bounds of (9.18)
def identity(x):
    return x


n = 20000
lower_sq, upper_sq = lower_upper_sums(f, 0.0, 1.0, n)
lower_id, upper_id = lower_upper_sums(identity, 0.0, 1.0, n)

print(f"x**2 on [0, 1] : between {lower_sq:.8f} and {upper_sq:.8f}")
print(f"x    on [0, 1] : between {lower_id:.8f} and {upper_id:.8f}")
print("the first bracket lies entirely below the second :", upper_sq < lower_id)
print()
print(f"bounds from (9.18) with m = 0, M = 1, b - a = 1 : {0.0:.6f} .. {1.0:.6f}")
x**2 on [0, 1] : between 0.33330833 and 0.33335833
x    on [0, 1] : between 0.49997500 and 0.50002500
the first bracket lies entirely below the second : True

bounds from (9.18) with m = 0, M = 1, b - a = 1 : 0.000000 .. 1.000000
두 구간이 겹치지 않으므로 어느 쪽이 큰지 확정된다. (9.18)의 범위 \([0, 1]\)은 훨씬 헐겁지만 적분을 전혀 계산하지 않고 얻은 것이다.
마지막으로 (8.8)을 확인한다. 부호가 바뀌는 함수를 쓴다.
# The absolute value inequality (8.8) with a function that changes sign
def signed(x):
    return x - 1.0


def absolute(x):
    return np.abs(x - 1.0)


n = 20000
lower_signed, upper_signed = lower_upper_sums(signed, 0.0, 2.0, n)
lower_abs, upper_abs = lower_upper_sums(absolute, 0.0, 2.0, n)

print(f"n = {n}")
print(f"integral of f   is between {lower_signed:.8f} and {upper_signed:.8f}")
print(f"integral of |f| is between {lower_abs:.8f} and {upper_abs:.8f}")
print()
print(f"so |integral of f| is at most   {max(abs(lower_signed), abs(upper_signed)):.8f}")
print(f"and integral of |f| is at least {lower_abs:.8f}")
n = 20000
integral of f   is between -0.00010000 and 0.00010000
integral of |f| is between 0.99990000 and 1.00010000

so |integral of f| is at most   0.00010000
and integral of |f| is at least 0.99990000
\(\int_0^2 (x-1)\,dx = 0\)이고 \(\int_0^2 |x-1|\,dx = 1\)이다. 왼쪽은 \(0\)이고 오른쪽은 \(1\)이므로 (8.8)이 성립하며, 서술 파트 5절에서 든 것과 같은 예이다.
부등호의 차이가 큰 이유는 상쇄이다. \([0,1]\)에서 음수인 부분과 \([1,2]\)에서 양수인 부분이 서로 지우므로 왼쪽이 \(0\)이 된다. 절댓값을 씌우면 지워지지 않는다. 부호가 일정한 함수에서는 상쇄가 없으므로 등호가 된다.
마치며#
최소상계는 합에 대하여 분배되지 않는다. 두 함수의 최댓점이 다르면 \(\sup(f+g) < \sup f + \sup g\)이다. 표본으로 한 번, sympy의 정확한 최댓값으로 한 번 확인하였고, 표본이 최댓점을 정확히 짚지 못하는 것도 보았다.
같은 일이 상합과 하합에서 부분구간마다 되풀이된다. 그래서 (9.10)이 등식이 아니라 부등식의 사슬이다. \(n=1\)부터 \(50\)까지 양 끝의 부등호는 한 번도 등호가 되지 않았다.
그럼에도 적분에서는 등호가 회복된다. \(n\)을 키우면 사슬의 양 끝이 같은 값으로 조여지고, 그러면 가운데 값들도 그 값이 된다. 이것이 (9.13)의 (iv) 단계이며, 적분 가능성이라는 가정이 여기서 쓰인다.
\(-f\)에서는 하합과 상합이 자리를 바꾸었다. 표에서 값이 바뀌었고 그림에서 색의 위치가 바뀌었다. 마지막으로 비교 정리와 (9.18), (8.8)을 적분값을 가둔 구간끼리 비교하여 확인하였다.
서술 파트가 주장한 것과 이 노트북에서 그것을 확인한 코드를 나란히 둔다.
서술 파트의 내용 |
이 노트북의 코드 |
|---|---|
흔한 오해 — 최소상계가 합에 대하여 분배되지 않는다 |
1절 |
최댓점이 다르다는 것이 원인이라는 점 |
1절 |
(9.10)의 부등식 사슬 |
2절의 다섯 열짜리 표 |
(9.10)의 부등호가 진짜 부등호라는 것 |
2절 |
(9.13)의 (iv) 단계 |
3절에서 \(U_n - L_n\)이 \(n\)에 반비례하여 줄어드는 표 |
정리 28의 자리바꿈 |
4절 |
5절 |
|
(8.8)과 상쇄 |
5절 |
더 해 볼 것#
1절에서 \(g\)를 \(g(x) = x - x^2\) 자신으로 바꾸어 보자. 두 함수의 최댓점이 같아지므로 등호가 성립해야 한다.
sp.maximum으로 확인하고, 등호가 성립하는 조건을 문장으로 정리해 보자. 격자를 십만 개에서 십만 한 개로 바꾸면 표본 최댓값이 달라지는가.2절의 \(g\)를 \(g(x) = x^2\)으로 바꾸면 어떻게 되는가. 두 함수가 같은 점에서 최댓값을 가지므로 (9.10)의 양 끝 부등호가 등호가 될 것이다.
strict_left와strict_right가 몇이 되는지 확인해 보자.lower_upper_sums의samples를 \(201\)로 바꾸면 2절 \(n=1\) 행의L(f+g)가 정확히 \(0.5\)가 된다. 왜 그런지 격자점을 직접 찍어 보고, 홀수와 짝수 중 어느 쪽이 이 함수에 유리한지 생각해 보자.4절의 표를 \(c = -3\)으로 바꾸어 \(L_n(cf)\)와 \(c\,U_n(f)\)를 대조해 보자. 정리 27과 정리 28을 이어 붙인 결과와 맞는지 확인해 보자.
짝이 되는 서술