3회 실험 · 유리수의 구멍#
이 실험
짝 서술 |
|
확인하는 것 |
아홉 개의 공리는 유리수에서도 모두 성립하지만, 그 안에 제곱해서 2가 되는 수는 없다 |
서술 파트에서 아홉 개의 공리를 세웠다. 체 공리(field axioms) F1부터 F6까지와 순서 공리(order axioms) O1부터 O3까지이다. 그리고 4절에서 이 아홉 개만으로는 \(\R\)과 \(\Q\)를 구별할 수 없다고 지적하였다.
이번 회차의 대상은 계산이 아니라 공리이므로 방향을 조금 바꾼다. 아홉 개의 조건을 유리수 표본에 대해 실제로 검사해 보고, 그 표본이 아홉 개를 모두 통과하는 것을 확인한 다음, 그럼에도 제곱해서 \(2\)가 되는 수가 그 안에 없다는 것을 확인한다.
계산은 대부분 Fraction으로 한다. 부동소수(floating point)를 쓰면 반올림 때문에 되는 것과 안 되는 것이 섞이기 때문이다. 그 차이 자체는 마지막 절에서 따로 다룬다.
서술 파트의 내용 |
여기서 확인하는 방법 |
|---|---|
체 공리 F1~F6과 순서 공리 O1~O3 (1절, 3절) |
유리수 표본을 만들어 아홉 조건을 |
같은 표본에서 네 정리의 결론을 확인한다 |
|
체 공리는 순서 공리를 함축하지 않는다 (4절 상자) |
원소가 두 개인 체에서 양수 집합 후보 네 개를 모두 시험한다 |
정리 8 (4절) |
분모를 키워 가며 제곱이 \(2\)에 가장 가까운 분수를 정확히 계산한다 |
\(\R\)과 \(\Q\)의 차이 (4절) |
같은 방정식을 두 정의역에서 sympy 로 푼다 |
0. 준비#
이 회차에서 쓸 것만 불러온다. 색은 두 개면 충분하다. 파란색은 우리가 실제로 찍은 유리수이고, 빨간색은 차이 또는 해가 있어야 할 자리이다.
1. 아홉 개의 공리는 유리수에서도 성립한다#
유한한 표본으로 공리를 검사하는 것은 증명이 아니다. 반례가 나오면 공리가 깨지는 것을 알 수 있지만, 반례가 나오지 않는다고 해서 성립이 보장되지는 않는다. 그래도 검사 코드를 직접 써 보면 각 공리가 정확히 무엇을 요구하는지가 분명해진다.
먼저 표본을 만든다. 분모가 \(4\) 이하이고 분자의 크기가 \(4\) 이하인 유리수를 모은다. F1, F2, F3은 세 개를 뽑아 확인해야 하므로 표본을 크게 잡으면 검사 시간이 빠르게 늘어난다.
# Build a finite sample of rationals and test F1-F6 and O1-O3 on it


def rational_sample(limit):
    values = set()
    for q in range(1, limit + 1):
        for p in range(-limit, limit + 1):
            values.add(Fraction(p, q))
    return sorted(values)


ZERO = Fraction(0)
ONE = Fraction(1)


def check_field_axioms(values):
    result = {"F1": True, "F2": True, "F3": True, "F4": ZERO != ONE, "F5": True, "F6": True}
    for x in values:
        result["F4"] &= (x + ZERO == x) and (ONE * x == x)
        minus_x = -x
        result["F5"] &= isinstance(minus_x, Fraction) and (x + minus_x == ZERO)
        if x != ZERO:
            inverse_x = ONE / x
            result["F6"] &= isinstance(inverse_x, Fraction) and (x * inverse_x == ONE)
        for y in values:
            result["F1"] &= (x + y == y + x) and (x * y == y * x)
            for z in values:
                result["F2"] &= (x + (y + z) == (x + y) + z) and (x * (y * z) == (x * y) * z)
                result["F3"] &= x * (y + z) == x * y + x * z
    return result


def check_order_axioms(values):
    result = {"O1": True, "O2": True, "O3": not (ZERO > ZERO)}
    for x in values:
        if x != ZERO:
            result["O2"] &= (x > ZERO) != (-x > ZERO)
        for y in values:
            if x > ZERO and y > ZERO:
                result["O1"] &= (x + y > ZERO) and (x * y > ZERO)
    return result


sample = rational_sample(4)
report = check_field_axioms(sample)
report.update(check_order_axioms(sample))

print(f"sample size : {len(sample)} rationals")
for name in ("F1", "F2", "F3", "F4", "F5", "F6", "O1", "O2", "O3"):
    print(f"  {name} : {'holds' if report[name] else 'FAILS'}")
sample size : 23 rationals
  F1 : holds
  F2 : holds
  F3 : holds
  F4 : holds
  F5 : holds
  F6 : holds
  O1 : holds
  O2 : holds
  O3 : holds
아홉 개가 모두 holds이다.
F5와 F6을 검사한 방식에 유의한다. 표본 안에서 짝이 되는 원소를 찾은 것이 아니라 -x와 1/x를 직접 만들고, 그 결과가 다시 Fraction인지를 확인하였다. 서술 4절이 \(-p/q\)와 \(q/p\)가 다시 유리수라고 말한 대목이 이 두 줄이다. F6에서 x != ZERO로 갈라 놓은 것도 공리의 단서를 그대로 옮긴 것이다.
2절과 3절의 정리도 같은 표본에서 확인한다. 이 정리들은 아홉 개의 공리에서 증명되었으므로, 아홉 개를 만족하는 \(\Q\)에서도 성립해야 한다.
# Test the theorems of the narrative on the same sample


def check_theorems(values):
    result = {
        "a * 0 = 0": True,
        "(-a)b = -(ab)": True,
        "(-a)(-b) = ab": True,
        "ab = 0 implies a = 0 or b = 0": True,
        "a < b and c < 0 implies ac > bc": True,
    }
    for a in values:
        result["a * 0 = 0"] &= a * ZERO == ZERO
        for b in values:
            result["(-a)b = -(ab)"] &= (-a) * b == -(a * b)
            result["(-a)(-b) = ab"] &= (-a) * (-b) == a * b
            if a * b == ZERO:
                result["ab = 0 implies a = 0 or b = 0"] &= (a == ZERO) or (b == ZERO)
            if a < b:
                for c in values:
                    if c < ZERO:
                        result["a < b and c < 0 implies ac > bc"] &= a * c > b * c
    return result


for statement, holds in check_theorems(sample).items():
    print(f"  {statement:34s} : {'holds' if holds else 'FAILS'}")
  a * 0 = 0                          : holds
  (-a)b = -(ab)                      : holds
  (-a)(-b) = ab                      : holds
  ab = 0 implies a = 0 or b = 0      : holds
  a < b and c < 0 implies ac > bc    : holds
정리 3, 정리 4, 정리 5, 그리고 정리 6의 세 번째 항목이 모두 통과한다.
통과하는 것이 당연하다는 점이 요점이다. 네 정리의 증명에 쓰인 것은 아홉 개의 공리뿐이므로, 아홉 개를 만족하는 어떤 체계에서도 결론이 따라 나온다. 여기서 확인한 것은 정리가 참이라는 사실이 아니라 \(\Q\)가 그 논증의 사정거리 안에 있다는 사실이다.
2. 순서를 줄 수 없는 체#
서술 4절의 마지막 상자는 원소가 두 개인 체를 든다. 이 체는 F1부터 F6까지를 모두 만족하지만 순서를 줄 수 없다. 체 공리가 순서 공리를 함축하지 않는다는 것이 그 상자의 주장이다.
양수 집합의 후보는 \(\{0, 1\}\)의 부분집합 네 개뿐이므로 전부 시험할 수 있다.
# The two element field: all six field axioms hold, but no subset can serve as the positives

ELEMENTS = [0, 1]


def add_mod2(x, y):
    return (x + y) % 2


def mul_mod2(x, y):
    return (x * y) % 2


def check_field_axioms_mod2():
    result = {"F1": True, "F2": True, "F3": True, "F4": True, "F5": True, "F6": True}
    for x in ELEMENTS:
        result["F4"] &= (add_mod2(x, 0) == x) and (mul_mod2(1, x) == x)
        result["F5"] &= any(add_mod2(x, y) == 0 for y in ELEMENTS)
        if x != 0:
            result["F6"] &= any(mul_mod2(x, y) == 1 for y in ELEMENTS)
        for y in ELEMENTS:
            result["F1"] &= (add_mod2(x, y) == add_mod2(y, x)) and (mul_mod2(x, y) == mul_mod2(y, x))
            for z in ELEMENTS:
                result["F2"] &= add_mod2(x, add_mod2(y, z)) == add_mod2(add_mod2(x, y), z)
                result["F2"] &= mul_mod2(x, mul_mod2(y, z)) == mul_mod2(mul_mod2(x, y), z)
                result["F3"] &= mul_mod2(x, add_mod2(y, z)) == add_mod2(mul_mod2(x, y), mul_mod2(x, z))
    return result


def negative_mod2(x):
    for y in ELEMENTS:
        if add_mod2(x, y) == 0:
            return y
    raise ValueError("no additive inverse")


def check_order_axioms_mod2(positives):
    o1 = all(
        (add_mod2(x, y) in positives) and (mul_mod2(x, y) in positives)
        for x in positives
        for y in positives
    )
    o2 = all(
        (x in positives) != (negative_mod2(x) in positives)
        for x in ELEMENTS
        if x != 0
    )
    o3 = 0 not in positives
    return o1, o2, o3


print("field axioms on {0, 1} with addition and multiplication modulo 2")
for name, holds in check_field_axioms_mod2().items():
    print(f"  {name} : {'holds' if holds else 'FAILS'}")

print("\nevery candidate set of positives")
for positives in ([], [0], [1], [0, 1]):
    o1, o2, o3 = check_order_axioms_mod2(positives)
    print(f"  P = {str(set(positives)) if positives else '{}':8s} O1 {o1!s:5s} O2 {o2!s:5s} O3 {o3!s:5s}")

print(f"\nnegative of 1 is {negative_mod2(1)}")
field axioms on {0, 1} with addition and multiplication modulo 2
  F1 : holds
  F2 : holds
  F3 : holds
  F4 : holds
  F5 : holds
  F6 : holds

every candidate set of positives
  P = {}       O1 True  O2 False O3 True
  P = {0}      O1 True  O2 False O3 False
  P = {1}      O1 False O2 False O3 True
  P = {0, 1}   O1 True  O2 False O3 False

negative of 1 is 1
F1부터 F6까지는 전부 성립한다. 그런데 네 후보 가운데 O2를 통과하는 것이 하나도 없다.
이 체에서는 \(1 + 1 = 0\)이므로 \(1\)의 덧셈 역원이 \(1\) 자신이다. 즉 \(-1 = 1\)이다. O2는 \(1 \in P\)와 \(-1 \in P\) 중 정확히 하나가 성립할 것을 요구하는데, 두 조건이 같은 조건이므로 둘 다 참이거나 둘 다 거짓이다. 어느 쪽이든 “정확히 하나”가 될 수 없다.
\(P = \{1\}\)은 O1도 통과하지 못한다. \(1 + 1 = 0\)이 \(P\) 밖으로 나가기 때문이다. 순서 공리가 요구하는 것은 부등호 기호가 아니라 덧셈과 곱셈에 대해 닫힌 부분집합의 존재라는 점이 여기서 드러난다.
3. 확대해도 채워지지 않는다#
\(\Q\)는 조밀하다(dense). 어떤 두 유리수 사이에도 또 다른 유리수가 있고, 확대해도 사정은 같다. 그러나 조밀하다는 것과 빈틈이 없다는 것은 다른 말이다.
아래 세 그림은 같은 지점을 세 배율로 확대한 것이다. 배율을 올릴 때 분모도 같은 비율로 키워 유리수를 더 촘촘히 찍는다. 빨간 세로선은 제곱해서 \(2\)가 되는 수가 있어야 할 위치이다.
# Plot rationals near the place where a solution of x*x = 2 would sit, at three zoom levels

center = 2 ** 0.5
radii = [0.5, 0.05, 0.005]

fig, axes = plt.subplots(3, 1, figsize=(9, 6))
for ax, radius in zip(axes, radii):
    denominator = int(20 / radius)
    lo = math.ceil((center - radius) * denominator)
    hi = math.floor((center + radius) * denominator)
    points = np.array([j / denominator for j in range(lo, hi + 1)])
    ax.scatter(points, np.zeros_like(points), s=12, color=C_LOWER, label="rationals")
    ax.axvline(center, color=C_DIFF, label="where x*x = 2 would sit")
    ax.set_xlim(center - radius, center + radius)
    ax.set_ylim(-1.0, 3.0)
    ax.set_yticks([])
    ax.set_xlabel("x")
    ax.set_title(f"half width {radius}, denominator {denominator}, {len(points)} rationals")
axes[0].legend(loc="upper right")

fig.tight_layout()
plt.show()
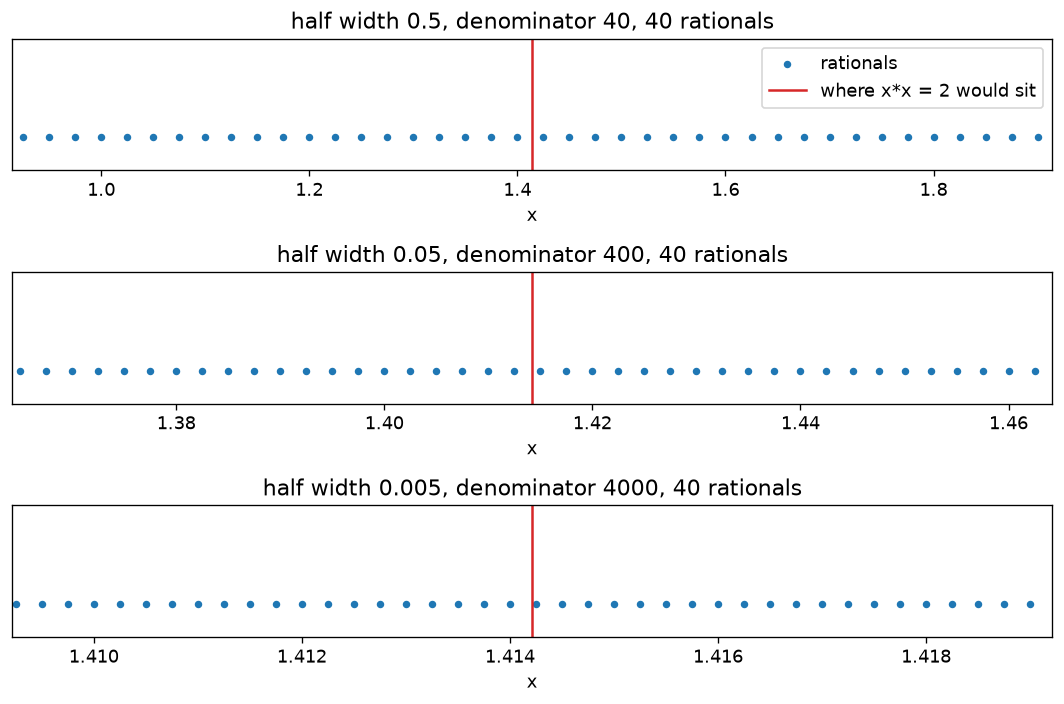
세 그림 모두에서 빨간 선 양옆으로 파란 점이 고르게 늘어선다. 배율은 \(100\)배까지 올라가지만 점의 개수는 세 그림 모두 \(40\)개이다. 확대할 때마다 분모를 같은 비율로 키웠기 때문에 같은 그림이 반복된다. 이것이 조밀성이 뜻하는 바이다.
그리고 어느 그림에서도 파란 점이 빨간 선 위에 놓이지 않는다. 다만 그림은 유한개의 점을 찍을 뿐이므로, 이것만으로는 “아직 찾지 못했다”와 “있을 수 없다”를 구별할 수 없다.
점 대신 수로 확인해 보자. 분모를 하나 고정하고, 제곱이 \(2\)를 넘지 않는 가장 큰 분수를 찾는다. 분자는 \(j^2 \le 2q^2\)을 만족하는 가장 큰 정수이므로 math.isqrt로 한 번에 구할 수 있다.
# For a fixed denominator, find the largest fraction whose square does not exceed 2


def best_numerator(denominator):
    # largest j with j * j <= 2 * denominator ** 2
    return math.isqrt(2 * denominator * denominator)


header = f"{'denominator':>12} {'numerator':>10} {'fraction':>20} {'square - 2 (exact)':>28} {'square == 2':>12}"
print(header)
print("-" * len(header))

for denominator in [10, 100, 1000, 10 ** 4, 10 ** 5]:
    numerator = best_numerator(denominator)
    candidate = Fraction(numerator, denominator)
    gap = candidate ** 2 - 2
    print(f"{denominator:>12} {numerator:>10} {str(candidate):>20} {str(gap):>28} {str(gap == 0):>12}")
 denominator  numerator             fraction           square - 2 (exact)  square == 2
--------------------------------------------------------------------------------------
          10         14                  7/5                        -1/25        False
         100        141              141/100                   -119/10000        False
        1000       1414              707/500                  -151/250000        False
       10000      14142            7071/5000                -959/25000000        False
      100000     141421        141421/100000          -100759/10000000000        False
square - 2 열이 정확한 분수로 나온다. 분모를 \(10^5\)까지 키워도 이 값은 \(0\)이 아니다. 같은 계산을 부동소수로 했다면 반올림 때문에 0.0이 찍혔을 수도 있다.
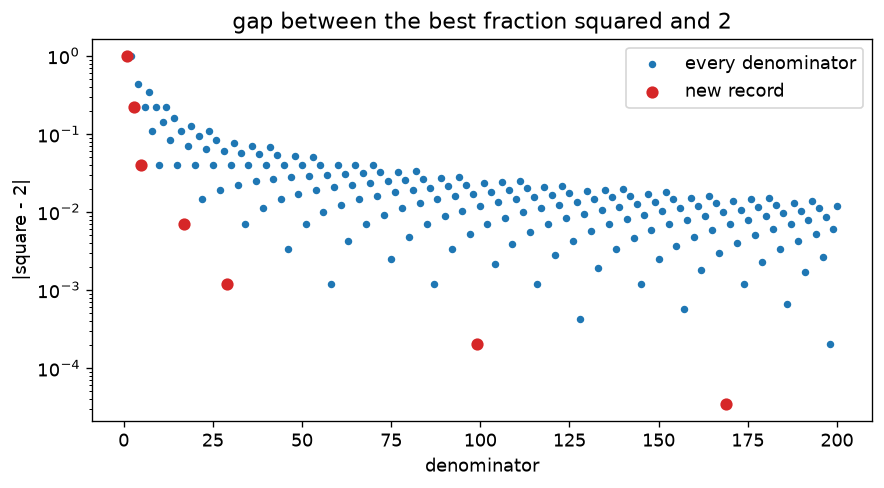
분모를 \(10\)의 거듭제곱으로만 고르는 것은 우리 표기법의 사정일 뿐이다. \(1\)부터 \(200\)까지 모든 분모를 훑고, 그때마다 차이를 정확히 계산해 둔다.
# Sweep every denominator up to a bound and keep the exact gap for each one

BOUND = 200
denominators = list(range(1, BOUND + 1))
gaps = [abs(Fraction(best_numerator(d), d) ** 2 - 2) for d in denominators]

records = []
best_so_far = None
for d, gap in zip(denominators, gaps):
    if best_so_far is None or gap < best_so_far:
        best_so_far = gap
        records.append(d)

fig, ax = plt.subplots(figsize=(7.5, 4.2))
ax.scatter(denominators, [float(g) for g in gaps], s=12, color=C_LOWER, label="every denominator")
ax.scatter(records, [float(gaps[d - 1]) for d in records], s=40, color=C_DIFF, label="new record")
ax.set_yscale("log")
ax.set_xlabel("denominator")
ax.set_ylabel("|square - 2|")
ax.set_title("gap between the best fraction squared and 2")
ax.legend(loc="upper right")

fig.tight_layout()
plt.show()

print(f"{'q':>6} {'p':>6} {'p/q':>12} {'p*p - 2*q*q':>14} {'|square - 2|':>14}")
for q in records:
    p = best_numerator(q)
    print(f"{q:>6} {p:>6} {str(Fraction(p, q)):>12} {p * p - 2 * q * q:>14} {str(gaps[q - 1]):>14}")
print("any gap equal to 0 :", any(g == 0 for g in gaps))
     q      p          p/q    p*p - 2*q*q   |square - 2|
     1      1            1             -1              1
     3      4          4/3             -2            2/9
     5      7          7/5             -1           1/25
    17     24        24/17             -2          2/289
    29     41        41/29             -1          1/841
    99    140       140/99             -2         2/9801
   169    239      239/169             -1        1/28561
any gap equal to 0 : False
세로축이 로그 눈금이라는 데 유의한다. 로그 눈금에는 \(0\)을 그릴 자리가 없다. 모든 분모의 점이 그려졌다는 것 자체가 어떤 분모에서도 차이가 \(0\)이 아니었다는 뜻이다.
빨간 점은 기록을 갱신한 분모이다. 표의 p*p - 2*q*q 열을 보면 값이 언제나 \(-1\) 아니면 \(-2\)이다. 이 값은 정수이고, 정리 8가 말하는 것은 이 정수가 결코 \(0\)이 되지 않는다는 것이다. 정수가 \(0\)이 아니면 크기가 적어도 \(1\)이므로 다음이 성립한다.
분모를 정해 놓으면 그보다 더 가까워질 수 없다는 뜻이다. 서술의 (3.5)는 \(p^2 = 2q^2\), 즉 이 정수가 \(0\)이 되는 경우를 가정한 식이고, 4절의 증명은 그런 \(p\)와 \(q\)를 잡을 수 없음을 보인다.
그림에 여러 갈래의 곡선이 보이는 것도 같은 이유이다. 각 갈래는 \(|p^2 - 2q^2|\)이 같은 값을 갖는 분모들의 모임이고, 갈래마다 \(q^2\)에 반비례해 내려간다.
4. 부동소수는 구멍을 지나친다#
부동소수는 유리수와 무리수를 구별하지 못한다. 어떤 값이든 유한한 자릿수로 잘라 저장하므로, 저장된 값은 언제나 유리수이다.
기호 계산(symbolic computation)은 값을 자르지 않고 식의 형태로 들고 있으므로 구별이 가능하다.
# sympy keeps the form of a number instead of its digits, so it can answer the rationality question

candidates = {
    "sqrt(2)": sp.sqrt(2),
    "sqrt(4)": sp.sqrt(4),
    "22/7": sp.Rational(22, 7),
    "sqrt(2)*sqrt(2)": sp.sqrt(2) * sp.sqrt(2),
    "sqrt(2)+sqrt(2)": sp.sqrt(2) + sp.sqrt(2),
}
for name, value in candidates.items():
    print(f"  {name:16s} simplified {str(sp.simplify(value)):10s} is_rational {value.is_rational}")
  sqrt(2)          simplified sqrt(2)    is_rational False
  sqrt(4)          simplified 2          is_rational True
  22/7             simplified 22/7       is_rational True
  sqrt(2)*sqrt(2)  simplified 2          is_rational True
  sqrt(2)+sqrt(2)  simplified 2*sqrt(2)  is_rational False
sqrt(2)*sqrt(2)가 유리수로 판정되는 데 유의한다. 무리수끼리 연산한 결과가 언제나 무리수인 것은 아니다. 판정의 근거는 소수점 아래 자릿수가 아니라 식을 정리한 결과이다.
같은 수를 두 방식으로 다루면 결과가 갈린다.
# The same number handled as a float and as a symbol

approx = float(sp.sqrt(2))
print("as a float")
print(f"  approx ** 2 == 2 : {approx ** 2 == 2}")
print(f"  approx ** 2 - 2  : {approx ** 2 - 2:.3e}")

print("as a symbol")
print(f"  sqrt(2) ** 2 - 2  : {sp.simplify(sp.sqrt(2) ** 2 - 2)}")
print(f"  sqrt(2) ** 2 == 2 : {sp.simplify(sp.sqrt(2) ** 2 - 2) == 0}")
as a float
  approx ** 2 == 2 : False
  approx ** 2 - 2  : 4.441e-16
as a symbol
  sqrt(2) ** 2 - 2  : 0
  sqrt(2) ** 2 == 2 : True
부동소수 쪽이 틀린 것이 아니다. float(sp.sqrt(2))는 애초에 \(\sqrt{2}\)가 아니라 그것에 가까운 유리수이고, 그 유리수의 제곱은 정말로 \(2\)가 아니다. 3절의 표가 보여 준 것과 같은 사정이며, 차이의 크기 \(4.441 \times 10^{-16}\)은 그 유리수의 분모가 얼마나 큰지를 말해 준다.
이제 방정식 \(x^2 = 2\)를 두 정의역에서 각각 풀어 본다.
# Solve the same equation over the reals and over the rationals

x = sp.Symbol("x", real=True)
equation = sp.Eq(x ** 2, 2)

print(f"  solutions in R : {sp.solveset(equation, x, domain=sp.S.Reals)}")
print(f"  solutions in Q : {sp.solveset(equation, x, domain=sp.S.Rationals)}")
print(f"  exact positive solution : {sp.sqrt(2)}, decimal {sp.N(sp.sqrt(2), 20)}")
  solutions in R : {-sqrt(2), sqrt(2)}
  solutions in Q : EmptySet
  exact positive solution : sqrt(2), decimal 1.4142135623730950488
실수 범위에서는 해가 두 개이고 유리수 범위에서는 EmptySet이다. 방정식도 같고 물음도 같은데 정의역만 바뀌었다. 이것이 서술 4절이 지적한 \(\R\)과 \(\Q\)의 차이이며, 정리 8가 증명한 내용이다.
어느 것도 증명이 아니다
1절의 검사는 표본을 훑은 결과이다. 표본 밖에서 공리가 깨질 가능성을 배제하지 못한다. 유한 검사는 반례를 찾을 수는 있어도 성립을 보일 수는 없다.
3절의 그림과 표도 정황이다. 분모 \(200\)까지 또는 \(10^5\)까지 훑었을 뿐이므로, 훑지 않은 어딘가에 해가 있을 가능성을 배제하지 못한다. 3절의 마지막 부등식만이 그 한계를 넘는데, 그 부등식이 기대고 있는 것은 계산 결과가 아니라 정리 8이다.
4절의 EmptySet은 알고리즘의 결과이다. sympy 가 내부에서 어떤 판정 절차를 돌린 결과이며, 그 절차가 옳다는 것은 별도의 문제이다.
증명이 하는 일은 “찾지 못했다”가 아니라 “있을 수 없다”를 보이는 것이며, 이것은 유한 번의 확인으로는 도달할 수 없다.
마치며#
아홉 개의 공리를 유리수 표본에 대해 검사하였고 아홉 개가 모두 통과하였다. 2절과 3절의 정리도 같은 표본에서 성립하였다. 아홉 개의 공리에서 증명된 것은 아홉 개를 만족하는 어떤 체계에서도 성립하므로 이는 예상된 결과이다. 원소가 두 개인 체에서는 순서를 줄 수 없었고, 이는 세 묶음을 각각 따로 요구해야 하는 이유를 보여 준다.
그러면서도 제곱해서 \(2\)가 되는 유리수는 나오지 않았다. 분모를 키우면 제곱값이 \(2\)에 가까워지지만 차이는 \(0\)이 되지 않았고, 정확한 분수로 계산했기 때문에 이 사실이 반올림에 가려지지 않았다. 차이의 분자 \(p^2 - 2q^2\)이 \(0\)이 아닌 정수라는 것이 그 이유이며, 그 자리에서 \(1/q^2\)이라는 하한이 나온다.
아홉 개의 공리를 만족하면서 이 구멍을 갖는 체계가 실제로 존재한다. \(\Q\)가 그것이다. 따라서 구멍이 없다는 것은 아홉 개에서 따라 나오는 결론이 아니라 따로 요구해야 하는 조건이다. 그 조건이 완비성 공리이며, 이를 서술하기 위한 준비를 다음 회차에서 한다.
서술 파트가 주장한 것과 이 노트북에서 그것을 확인한 코드를 나란히 둔다.
서술 파트의 내용 |
이 노트북의 코드 |
|---|---|
체 공리 F1~F6과 순서 공리 O1~O3은 \(\Q\)에서도 성립한다 |
|
|
|
체 공리는 순서 공리를 함축하지 않는다 |
2절에서 후보 네 개에 돌린 |
|
|
\(\R\)과 \(\Q\)에서 \(x^2 = 2\)의 답이 갈린다 |
|
더 해 볼 것#
rational_sample의limit을 \(5\)나 \(6\)으로 키워 보자. 검사 시간이 어떻게 변하는가. F4, F5, F6보다 F2와 F3의 비용이 훨씬 빠르게 늘어나는 이유를 표본 크기와 연결해 설명해 보자.1절의 검사에서
Fraction(p, q)를p / q로 바꾸어 부동소수로 같은 검사를 돌려 보자. 아홉 개 중 어떤 것이FAILS로 바뀌는가. 그것이 유리수의 성질 때문인지 저장 방식 때문인지 판단해 보자.3절의 기록 갱신 분모는 \(1, 3, 5, 17, 29, 99, 169\)이다. 한 칸씩 건너뛰어 \(1, 5, 29, 169\)과 \(3, 17, 99\)를 따로 보면 각각 \(q_{k+1} = 6q_k - q_{k-1}\)을 만족한다. 확인해 보자. 그리고 \(1/1\)에서 시작해 \(p/q\)를 \((p+2q)/(p+q)\)로 바꾸는 규칙을 반복하면 어떤 분수가 나오는지 기록표와 비교해 보자.
3절과 4절에서 \(2\)를 \(3\)으로 바꾸어 다시 돌려 보자. 그림과
solveset의 결과가 어떻게 바뀌는가. \(2\)를 \(4\)로 바꾸면 어떻게 되는가. 세 경우의 차이가 어디에서 오는지 말해 보자.