1회 실험 · 아르키메데스의 구적법#
이 실험
짝 서술 |
|
확인하는 것 |
유한한 \(n\)에 대한 두 부등식 \(S_n - s_n = b^3/n\)과 \(s_n < b^3/3 < S_n\) |
서술 파트 3절에서 아르키메데스의 구적법(method of exhaustion)을 영역 \(\Omega_b\)에 적용하였다. 구간 \([0, b]\)를 \(n\)등분하여 안쪽 도형의 넓이 \(s_n\)과 바깥쪽 도형의 넓이 \(S_n\)을 만들었다. 그리고 (1.9)에서 두 넓이의 차이가 정확히 \(b^3/n\)이고, (1.10)에서 \(b^3/3\)이 언제나 두 값 사이에 있다는 것을 손으로 확인하였다. 정리 1는 이 두 사실만으로 넓이가 \(b^3/3\)이라는 결론을 얻었다.
여기서는 그 계산을 코드로 다시 쓴다. 확인할 것은 세 가지이다. 첫째, 손으로 얻은 (1.6)~(1.9)의 수치가 정의를 그대로 옮긴 계산과 일치하는가. 둘째, “증가함수이므로 왼쪽 끝값이 최솟값”이라는 3절의 주장이 실제로 그런가. 셋째, 정리 1의 증명이 말하는 “후보를 배제하는 \(n\)”을 실제로 찾을 수 있는가.
한 가지를 미리 정해 둔다. 이 실험에서 쓰는 함수는 모두 이 회차 안에서 직접 정의한다. 분할점을 만드는 함수도, 계단함수(step function)의 적분을 계산하는 함수도, 그림을 그리는 함수도 여기서 몇 줄로 적는다. 준비된 도구를 불러 쓰면 계산이 맞는지는 알 수 있지만 정의가 무엇을 요구하는지는 보이지 않는다.
또 한 가지. 이 실험에는 극한이 없다. 등장하는 \(n\)은 모두 4, 10, 40처럼 구체적인 자연수이며, for 문의 반복 횟수도 유한하다. 서술 파트의 경고 상자가 말한 것과 같다.
서술 파트의 내용 |
여기서 확인하는 방법 |
|---|---|
분할점 (1.2) |
|
계단함수의 적분으로 두 합을 계산하고 그림에 겹쳐 그린다 |
|
\(x \ge 0\)에서 \(x^2\)이 증가하므로 최솟값이 왼쪽 끝값이라는 주장 |
각 부분구간을 여러 점으로 훑어 최솟값·최댓값을 직접 찾아 끝값과 비교한다 |
세 개의 \(n\)에 대해 수치로 확인한다 |
|
sympy 의 합으로 \(n\)에 대한 식을 얻어 손 계산과 맞춰 본다 |
|
정리 1의 증명 |
후보 \(A\)를 하나 주면 그것을 배제하는 \(n\)을 실제로 찾는다 |
0. 준비#
이 회차에서 쓸 것만 불러온다. 색은 이후 회차에서도 같은 뜻으로 쓴다. 검정은 함수 그래프, 파랑은 안쪽 근사, 주황은 바깥쪽 근사, 회색은 허용 범위 띠, 초록은 기호 계산(symbolic computation)이 준 정확한 값이다.
1. 분할과 계단함수의 적분#
서술 파트 (1.2)는 분할점을 \(x_k = kb/n\)으로 정했다. 등분이므로 부분구간의 폭은 모두 \(b/n\)이다.
\(s_n\)과 \(S_n\)은 둘 다 “부분구간마다 높이가 하나로 정해진 도형”의 넓이이다. 이런 도형의 넓이는 직사각형의 넓이를 더한 것이므로, 분할점과 높이 목록만 있으면 계산된다. 두 함수를 만들어 둔다.
# Partition of [a, b] into n equal parts, and the area of a step figure
def partition(a, b, n):
    return np.linspace(a, b, n + 1)


def step_integral(points, heights):
    widths = np.diff(points)
    return float(np.sum(np.asarray(heights, dtype=float) * widths))


points = partition(0.0, 1.0, 4)
print("partition points :", points)
print("widths           :", np.diff(points))
print("area of height 1 :", step_integral(points, np.ones(4)))
partition points : [0.   0.25 0.5  0.75 1.  ]
widths           : [0.25 0.25 0.25 0.25]
area of height 1 : 1.0
폭이 네 번 모두 \(0.25\)로 같다. 높이를 전부 \(1\)로 두면 넓이가 \(1\)이 되므로, step_integral 은 밑변이 \([0, 1]\)이고 높이가 \(1\)인 직사각형의 넓이를 옳게 준다.
2. 안쪽과 바깥쪽#
\(f(x) = x^2\)과 \(b = 1\)을 고정한다. 부분구간 \([x_{k-1}, x_k]\)에서 왼쪽 끝값 \(x_{k-1}^2\)을 높이로 쓰면 (1.3)의 \(s_n\)이 되고, 오른쪽 끝값 \(x_k^2\)을 높이로 쓰면 (1.4)의 \(S_n\)이 된다.
그림은 바깥쪽을 먼저 그리고 안쪽을 그 위에 겹쳐 그린다. 그러면 파란 몸통이 \(s_n\)이고 그 위에 남는 주황 띠가 차이 \(S_n - s_n\)이다.
# Inner and outer step figures for the region under y = x^2 on [0, b]
def f(x):
    return x**2


a = 0.0
b = 1.0


def endpoint_sums(f, a, b, n):
    points = partition(a, b, n)
    lower = step_integral(points, f(points[:-1]))
    upper = step_integral(points, f(points[1:]))
    return lower, upper


def draw_bars(ax, points, heights, color, alpha):
    width = points[1] - points[0]
    ax.bar(points[:-1], heights, width=width, align="edge",
           color=color, alpha=alpha, edgecolor=color, linewidth=0.6)


grid = np.linspace(a, b, 400)
fig, axes = plt.subplots(1, 3, figsize=(9.6, 3.4))
for ax, n in zip(axes, (4, 10, 40)):
    edges = partition(a, b, n)
    draw_bars(ax, edges, f(edges[1:]), C_UPPER, 0.55)    # outer first
    draw_bars(ax, edges, f(edges[:-1]), C_LOWER, 0.85)   # inner on top
    ax.plot(grid, f(grid), color=C_FUNC, linewidth=1.4)
    ax.set_title(f"n = {n}")
    ax.set_xlabel("x")
    ax.set_xlim(a, b)
    ax.set_ylim(0.0, 1.1)

handles = [plt.Rectangle((0, 0), 1, 1, color=C_LOWER, alpha=0.85),
           plt.Rectangle((0, 0), 1, 1, color=C_UPPER, alpha=0.55)]
axes[0].set_ylabel("y")
axes[0].legend(handles, ["lower sum", "upper sum"], loc="upper left", fontsize=8)
fig.tight_layout()
plt.show()
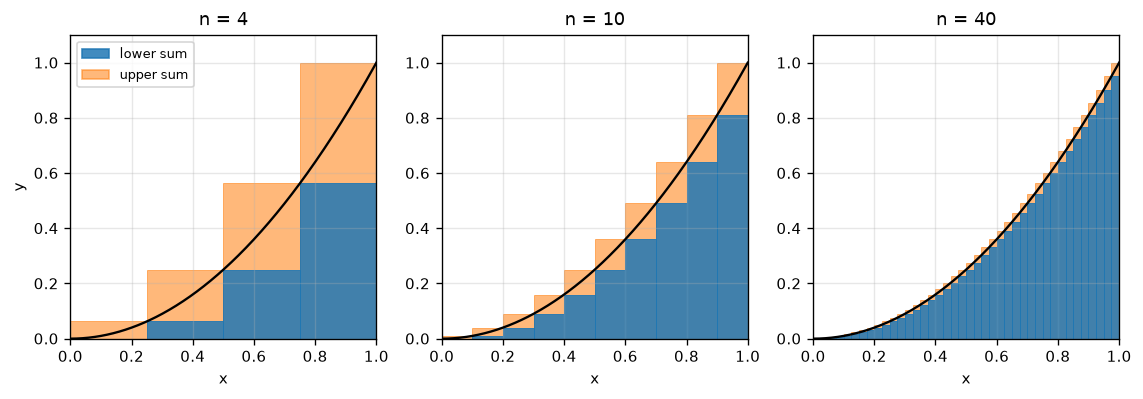
파란 도형은 곡선 아래에 들어가고, 주황 띠까지 합한 도형은 곡선을 덮는다. \(n\)이 커지면 주황 띠가 가늘어진다. 다만 가늘어진다는 것만으로는 아무것도 결론지을 수 없다. 얼마나 가늘어지는지를 수로 적어야 한다.
# Numerical check of (1.9) and (1.10) for three values of n
header = (f"{'n':>4}  {'lower s_n':>12}  {'upper S_n':>12}"
          f"  {'S_n - s_n':>12}  {'b^3 / n':>12}  {'between':>8}")
print(header)
print("-" * len(header))
for n in (4, 10, 40):
    lower, upper = endpoint_sums(f, a, b, n)
    between = lower < b**3 / 3 < upper
    print(f"{n:>4}  {lower:>12.7f}  {upper:>12.7f}"
          f"  {upper - lower:>12.7f}  {b**3 / n:>12.7f}  {str(between):>8}")
   n     lower s_n     upper S_n     S_n - s_n       b^3 / n   between
----------------------------------------------------------------------
   4     0.2187500     0.4687500     0.2500000     0.2500000      True
  10     0.2850000     0.3850000     0.1000000     0.1000000      True
  40     0.3209375     0.3459375     0.0250000     0.0250000      True
세 줄 모두 서술 파트 3절의 표와 같은 값이다. S_n - s_n 열과 b^3 / n 열이 소수점 일곱째 자리까지 같으므로 (1.9)는 근사가 아니라 등식으로 보인다. 그리고 세 줄 모두 between 이 참이므로 (1.10)이 성립한다.
여기서 확인한 것은 세 개의 \(n\)에 대한 것뿐이다. 모든 \(n\)에 대해 성립한다는 것은 4절에서 식으로 확인한다.
3. 최솟값과 최댓값을 직접 찾는다#
2절의 endpoint_sums 는 “왼쪽 끝값이 최솟값”이라는 것을 이미 알고 있다고 두고 계산한다. 서술 파트 3절은 \(x \ge 0\)에서 \(x^2\)이 증가한다는 사실로 이것을 정당화하였다.
그 사실을 쓰지 않고 계산하면 어떻게 되는지 보자. 각 부분구간을 여러 점으로 훑어 함숫값의 최솟값과 최댓값을 직접 찾는다. 이렇게 얻은 두 값이 끝값과 같아야 3절의 주장이 맞다.
# Do not assume where the minimum sits: scan each subinterval
def lower_upper_sums(f, a, b, n, samples=200):
    points = partition(a, b, n)
    lows = []
    highs = []
    for k in range(n):
        piece = np.linspace(points[k], points[k + 1], samples)
        values = f(piece)
        lows.append(values.min())
        highs.append(values.max())
    return step_integral(points, lows), step_integral(points, highs)


for n in (4, 10, 40):
    scan_low, scan_high = lower_upper_sums(f, a, b, n)
    end_low, end_high = endpoint_sums(f, a, b, n)
    same = (abs(scan_low - end_low) < 1e-12 and abs(scan_high - end_high) < 1e-12)
    print(f"n = {n:>3}   scan = ({scan_low:.7f}, {scan_high:.7f})"
          f"   endpoint = ({end_low:.7f}, {end_high:.7f})   same = {same}")
n =   4   scan = (0.2187500, 0.4687500)   endpoint = (0.2187500, 0.4687500)   same = True
n =  10   scan = (0.2850000, 0.3850000)   endpoint = (0.2850000, 0.3850000)   same = True
n =  40   scan = (0.3209375, 0.3459375)   endpoint = (0.3209375, 0.3459375)   same = True
세 경우 모두 일치한다. 훑어서 찾은 최솟값이 왼쪽 끝값이고 최댓값이 오른쪽 끝값이라는 뜻이다.
증가한다는 조건이 빠지면 어떻게 되는지도 한 번 보아 두자. \(g(x) = (x - 1/2)^2\)은 \([0, 1]\)에서 증가하지 않는다.
# The endpoint rule needs an increasing function: a counterexample
def g(x):
    return (x - 0.5)**2


scan_low, scan_high = lower_upper_sums(g, 0.0, 1.0, 4)
end_low, end_high = endpoint_sums(g, 0.0, 1.0, 4)
print("g(x) = (x - 0.5)^2 on [0, 1], n = 4")
print(f"scan     : lower = {scan_low:.7f}   upper = {scan_high:.7f}")
print(f"endpoint : lower = {end_low:.7f}   upper = {end_high:.7f}")
print("endpoint lower sits above the true lower sum :", end_low > scan_low)
print("endpoint lower equals endpoint upper         :", end_low == end_high)
g(x) = (x - 0.5)^2 on [0, 1], n = 4
scan     : lower = 0.0312500   upper = 0.1562500
endpoint : lower = 0.0937500   upper = 0.0937500
endpoint lower sits above the true lower sum : True
endpoint lower equals endpoint upper         : True
\(g\)에 대해서는 왼쪽 끝값을 모은 합이 안쪽 도형의 넓이가 아니다. 실제 최솟값을 훑어 얻은 값보다 크기 때문이다. 게다가 왼쪽 끝값 합과 오른쪽 끝값 합이 같아서 두 값 사이에 참값을 가둘 수도 없다.
즉 2절의 계산이 통했던 것은 \(x^2\)이 \([0, b]\)에서 증가하기 때문이다. 서술 파트가 그 문장을 따로 적어 둔 이유가 여기에 있다.
4. 정확한 식#
2절은 부동소수(floating point) 값을 준다. \(n = 40\)일 때 \(s_n\)이 \(0.3209375\)라는 것은 알 수 있지만, 그 값이 \(1/3\)에서 정확히 얼마나 떨어져 있는지는 수치만으로 확정할 수 없다.
기호로 계산하면 \(n\)에 대한 식이 나온다. (1.3)과 (1.4)를 그대로 옮겨 합을 구한다.
# Exact formulas for the inner and outer areas as functions of n
k = sp.symbols("k", integer=True)
n = sp.symbols("n", integer=True, positive=True)
b = sp.symbols("b", positive=True)

width = b / n
x_k = k * b / n

lower_expr = sp.factor(sp.simplify(sp.summation(x_k**2 * width, (k, 0, n - 1))))
upper_expr = sp.factor(sp.simplify(sp.summation(x_k**2 * width, (k, 1, n))))


def show_expr(label, expr):
    print(label)
    sp.pprint(expr)
    print()


show_expr("lower sum s_n =", lower_expr)
show_expr("upper sum S_n =", upper_expr)
show_expr("S_n - s_n =", sp.simplify(upper_expr - lower_expr))
lower sum s_n =
 3
b ⋅(n - 1)⋅(2⋅n - 1)
────────────────────
           2
        6⋅n

upper sum S_n =
 3
b ⋅(n + 1)⋅(2⋅n + 1)
────────────────────
           2
        6⋅n

S_n - s_n =
 3
b
──
n
앞의 두 식이 서술 파트 (1.6)과 (1.7)이다. 세 번째 식은 \(b^3/n\)이며 (1.9)와 같다. 근사가 아니라 정확한 등식이다.
같은 식을 항별로 펼치면 (1.8)의 모양이 나온다. 그리고 \(b^3/3\)과의 거리도 식으로 얻을 수 있다.
# Expanded form (1.8) and the distances to b^3 / 3
show_expr("s_n expanded =", sp.expand(lower_expr))
show_expr("S_n expanded =", sp.expand(upper_expr))
show_expr("b**3 / 3 - s_n =", sp.factor(sp.simplify(b**3 / 3 - lower_expr)))
show_expr("S_n - b**3 / 3 =", sp.factor(sp.simplify(upper_expr - b**3 / 3)))
s_n expanded =
 3    3      3
b    b      b
── - ─── + ────
3    2⋅n      2
           6⋅n

S_n expanded =
 3    3      3
b    b      b
── + ─── + ────
3    2⋅n      2
           6⋅n

b**3 / 3 - s_n =
 3
b ⋅(3⋅n - 1)
────────────
       2
    6⋅n

S_n - b**3 / 3 =
 3
b ⋅(3⋅n + 1)
────────────
       2
    6⋅n
펼친 두 식은 \(b^3/3\)을 가운데 두고 \(\pm b^3/(2n)\)이 붙고 \(+b^3/(6n^2)\)이 공통으로 붙은 모양이다. (1.8)과 같다.
거리 쪽을 보자. 첫 식의 분자는 \(b^3(3n-1)\)이고 분모는 \(6n^2\)이다. \(n \ge 1\)이면 \(3n - 1 \ge 2 > 0\)이고 \(b > 0\)이므로 이 값은 양수이다. 서술 파트 (1.11)에서 손으로 확인한 것과 같다. 둘째 식의 분자는 \(b^3(3n+1)\)이므로 마찬가지로 양수이다.
두 식이 양수라는 것은 세 개의 \(n\)에 대한 확인이 아니라 모든 자연수 \(n\)에 대한 확인이다. 분자와 분모의 부호만 보면 되기 때문이다.
이제 2절의 수치와 대조한다. 두 계산은 서로 독립이다. 하나는 부동소수 덧셈이고 다른 하나는 기호 합이다. 일치해야 정의를 옳게 옮긴 것이다.
# Compare the floating point sums of section 2 with the exact formula
header = (f"{'n':>4}  {'s_n numeric':>14}  {'s_n exact':>14}"
          f"  {'S_n numeric':>14}  {'S_n exact':>14}  {'match':>6}")
print(header)
print("-" * len(header))
for n_value in (4, 10, 40):
    num_low, num_high = endpoint_sums(f, 0.0, 1.0, n_value)
    sym_low = float(lower_expr.subs({b: 1, n: n_value}))
    sym_high = float(upper_expr.subs({b: 1, n: n_value}))
    match = abs(num_low - sym_low) < 1e-12 and abs(num_high - sym_high) < 1e-12
    print(f"{n_value:>4}  {num_low:>14.9f}  {sym_low:>14.9f}"
          f"  {num_high:>14.9f}  {sym_high:>14.9f}  {str(match):>6}")
   n     s_n numeric       s_n exact     S_n numeric       S_n exact   match
----------------------------------------------------------------------------
   4     0.218750000     0.218750000     0.468750000     0.468750000    True
  10     0.285000000     0.285000000     0.385000000     0.385000000    True
  40     0.320937500     0.320937500     0.345937500     0.345937500    True
5. 후보를 배제하는 n 을 찾는다#
정리 1의 증명은 이렇게 진행되었다. \(A \ne b^3/3\)이라고 하면 \(d = |A - b^3/3| > 0\)이다. \(b^3/n < d\)가 되는 \(n\)을 하나 고르면, 그 \(n\) 하나에서 (1.12)가 깨진다.
이 절차를 코드로 옮긴다. 후보 \(A\)를 하나 주면 증명이 지시하는 \(n\)을 계산하고, 그 \(n\)에서 실제로 \(s_n \le A \le S_n\)이 깨지는지 확인한다. 함께 가장 작은 배제 \(n\)도 찾아 둔다. 두 값이 다를 수 있다. 증명은 배제하는 \(n\)이 있다는 것만 보이면 되고 가장 작은 것을 찾을 필요가 없다.
4절에서 확인한 (1.8)을 쓰면 큰 \(n\)에 대해서도 곧바로 값이 나온다.
# Given a candidate area, find an n that contradicts s_n <= A <= S_n
def bounds_from_formula(b_value, n_value):
    center = b_value**3 / 3
    gap = b_value**3 / (2 * n_value)
    tail = b_value**3 / (6 * n_value**2)
    return center - gap + tail, center + gap + tail


def n_from_proof(candidate, b_value=1.0):
    d = abs(b_value**3 / 3 - candidate)
    if d == 0.0:
        return None
    return int(b_value**3 / d) + 1        # this makes b^3 / n < d


def smallest_excluding_n(candidate, b_value=1.0, n_max=200000):
    for n_value in range(1, n_max + 1):
        low, high = bounds_from_formula(b_value, n_value)
        if not (low <= candidate <= high):
            return n_value
    return None


header = (f"{'candidate':>12}  {'n from proof':>13}  {'breaks there':>13}"
          f"  {'smallest n':>11}")
print(header)
print("-" * len(header))
for candidate in (0.30, 0.333, 1.0 / 3.0, 0.34, 0.40):
    n_proof = n_from_proof(candidate)
    if n_proof is None:
        breaks = None
    else:
        low, high = bounds_from_formula(1.0, n_proof)
        breaks = not (low <= candidate <= high)
    n_small = smallest_excluding_n(candidate)
    print(f"{candidate:>12.7f}  {str(n_proof):>13}  {str(breaks):>13}"
          f"  {str(n_small):>11}")
   candidate   n from proof   breaks there   smallest n
-------------------------------------------------------
   0.3000000             31           True           15
   0.3330000           3001           True         1500
   0.3333333           None           None         None
   0.3400000            150           True           76
   0.4000000             15           True            8
\(1/3\)이 아닌 네 후보는 모두 배제되었다. 증명이 지시한 \(n\)에서 실제로 부등식이 깨지고, 그보다 작은 \(n\)으로도 배제되는 경우가 있다. 후보가 \(1/3\)에 가까울수록 필요한 \(n\)이 커진다. \(0.333\)은 \(1/3\)과 \(0.000333\ldots\) 만큼 떨어져 있고, 배제에 필요한 \(n\)은 천 단위이다.
\(1/3\) 자신은 어떤 \(n\)으로도 배제되지 않았다. n_from_proof 는 \(d = 0\)이므로 값을 주지 않고, \(n\)을 \(200000\)까지 훑어도 부등식이 깨지지 않는다. 물론 이것은 \(200000\)개의 \(n\)을 확인한 것이며, 모든 \(n\)에 대한 증명은 4절의 부호 논증이 한다.
마지막으로 각 \(n\)이 주는 구간을 그려 둔다. 회색 막대 하나가 하나의 \(n\)에 대한 \([s_n, S_n]\)이고, 초록 선이 \(b^3/3\)이다.
# Each n gives one interval; a candidate outside that interval is excluded by it
ns = np.arange(1, 13)
lows = np.array([bounds_from_formula(1.0, int(m))[0] for m in ns])
highs = np.array([bounds_from_formula(1.0, int(m))[1] for m in ns])

fig, ax = plt.subplots(figsize=(6.4, 3.6))
ax.vlines(ns, lows, highs, color=C_BAND, linewidth=7, alpha=0.5,
          label="interval [s_n, S_n]")
ax.plot(ns, lows, "o", color=C_LOWER, markersize=4, label="lower sum")
ax.plot(ns, highs, "o", color=C_UPPER, markersize=4, label="upper sum")
ax.axhline(1.0 / 3.0, color=C_SYM, linewidth=1.2, label="b^3 / 3")
ax.set_xlabel("n")
ax.set_ylabel("area")
ax.set_title("each n allows only the candidates inside its bar")
ax.legend(fontsize=8, loc="upper right")
fig.tight_layout()
plt.show()
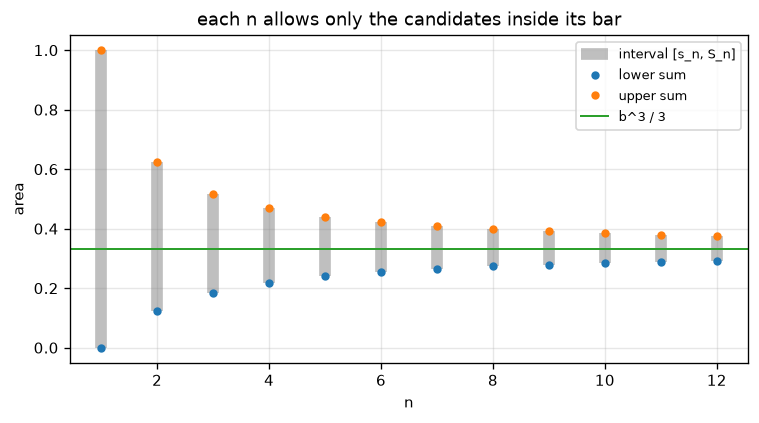
그림에 있는 것은 열두 개의 유한한 구간이다. 각 구간은 그 밖에 있는 수를 배제한다. 예를 들어 \(0.40\)은 \(n = 8\)의 막대 위로 벗어나 있으므로 \(n = 8\) 하나로 배제된다. 앞의 표에서 \(0.40\)의 가장 작은 배제 \(n\)이 \(8\)이었던 것이 이것이다. 초록 선은 열두 막대를 모두 지나므로 어떤 막대도 그것을 배제하지 못한다.
\(n\)을 무한히 키우는 일은 하지 않았다. 후보 하나마다 그것을 배제하는 \(n\) 하나를 찾은 것이 전부이다.
마치며#
정의를 그대로 옮긴 계산과 손으로 얻은 식이 일치하는 것을 확인하였다. 2절의 수치는 서술 파트 3절의 표와 같았고, 4절의 기호 계산은 (1.6)부터 (1.11)까지를 그대로 재현하였다. 두 계산은 서로 독립이므로 일치는 우연이 아니다.
3절에서 확인한 것이 하나 더 있다. “왼쪽 끝값이 최솟값”이라는 문장은 \(x^2\)이 증가한다는 조건에서 나온 것이며, 조건이 빠지면 성립하지 않는다. \(g(x) = (x - 1/2)^2\)에서는 왼쪽 끝값 합이 안쪽 넓이가 아니었고, 왼쪽 합과 오른쪽 합이 같아서 참값을 가두지도 못했다. 다음 파트에서 상합과 하합을 정의할 때 끝값이 아니라 최댓값과 최솟값으로 정의하는 이유가 여기에 있다.
5절은 정리 1의 증명이 하는 일을 그대로 실행하였다. 후보를 하나 가져오면 그것을 배제하는 \(n\)을 계산해서 실제로 부등식이 깨지는 것을 보였다. 배제하지 못한 후보는 \(b^3/3\) 하나였다. 이것이 구적법의 구조이며, 여기에 극한은 없다.
서술 파트가 주장한 것과 이 노트북에서 그것을 확인한 코드를 짝지어 둔다.
서술 파트의 내용 |
이 노트북의 코드 |
|---|---|
분할점 \(x_k = kb/n\) (1.2) |
|
|
|
\(x \ge 0\)에서 \(x^2\)이 증가하므로 최솟값이 왼쪽 끝값이라는 주장 |
3절의 |
4절의 |
|
정리 1의 증명이 고르는 \(n\) |
|
더 해 볼 것#
b를 \(1\) 대신 \(2\)나 \(0.5\)로 바꾸어 2절의 수치를 다시 얻어 보자.S_n - s_n이 여전히b^3 / n과 일치하는가. 그리고between열을 만들 때 비교하는 값b**3 / 3도 함께 바뀌는지 확인하자.4절의
x_k**2를x_k**3으로 바꾸어 보자.lower_expr과upper_expr은 어떤 식이 되는가. 펼친 식의 상수항에서 \(b^4/4\)를 읽을 수 있는가. 차이S_n - s_n은 이번에도 \(b^3/n\) 처럼 간단한 모양인가.5절의 후보 목록에 \(0.333333\) 을 넣어 보자.
n_from_proof가 주는 값이 얼마이고,smallest_excluding_n은 무엇을 출력하는가. 두 열의 결과가 갈리는 이유를n_max와 견주어 설명해 보자. 그리고smallest_excluding_n이None을 주었을 때 그것을 “배제할 수 없다”로 읽어도 되는지 생각해 보자.
짝이 되는 서술