
테마
8회 · 추론의 기초 · 노트
0 들어가며
여는 질문. 1629년부터 1710년까지 82년 동안, 런던에서는 해마다 남자아이가 여자아이보다 많이 세례를 받았다. 한 해도 빠짐없이. 이것은 우연인가, 아니면 무언가가 그렇게 만드는가? 그리고 “우연이라기엔 너무 드물다”는 말을 어떻게 숫자로 할 것인가?
John Arbuthnot은 1710년 이 기록을 왕립학회에 보고하면서 이렇게 논증했다. 남녀가 반반의 확률로 태어난다면 어느 해에 남아가 더 많을 확률은 이고, 82년이 모두 그럴 확률은 이다. 이렇게 작은 확률의 일이 일어났으니 “우연”이라는 가설은 버려야 한다. 그는 그 대신 신의 섭리를 결론지었다. 결론은 지금 보면 성급하지만, 논증의 형태는 오늘의 유의성 검정과 같다. 가설을 세우고, 그 가설 아래에서 관측의 확률을 계산하고, 그 확률이 너무 작으면 가설을 버린다.
이 형태가 엄밀한 이론이 되기까지 200년이 걸렸다. Pearson(1900)은 Weldon의 주사위로 적합도 검정을 만들었고, Fisher(1922, 1925)는 자유도를 바로잡고 “5%”라는 관행을 세웠으며, Neyman(1937)은 신뢰구간을 정의했다. 이 노트는 그 언어를 정리한다. 자료의 함수인 통계량과 그 분포(1절), 모수를 덮는 신뢰구간(2절), 가설을 판정하는 검정과 그 오류(3절), -값의 정체(4절), 그리고 Pearson의 검정(5절)이다. 6절은 네 원자료에 검정을 쓰고, 7절은 원하는 결과가 나올 때까지 검정하면 무엇이 무너지는지, 8절은 같은 생각이 기계학습의 보정과 등각 예측(conformal prediction)에서 어떻게 쓰이는지 본다.
학습 목표
- 1.
순서통계량의 결합밀도를 유도하고, 표본분위수의 점근정규성을 증명한다. 독일 전차 문제의 불편추정량을 만든다.
- 2.
축량과 대표본 근사로 신뢰구간을 만들고, 분포에 의존하지 않는 중앙값의 구간을 증명한다.
- 3.
검정의 크기·검정력·표본 크기를 계산하고, 구간과 검정이 서로를 정한다는 쌍대성을 증명한다.
- 4.
귀무가설 아래에서 -값이 균등분포를 따름을 증명하고, 그 해석의 한계를 말한다.
- 5.
Pearson의 통계량이 로 분포수렴함을 증명하고, 적합도와 독립성 검정에 쓴다.
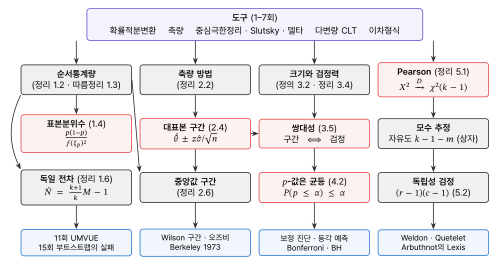
0.1 1–7회에서 가져오는 것
0.2 표기
자료 의 분포는 모수 로 정해지고, 확률과 기댓값을 그 모수 아래에서 계산할 때 , 로 쓴다. , , , 는 각 분포의 위쪽 분위수다. 순서통계량은 이다.