Skip to content

8회 · 추론의 기초 · 노트

4 pp-값 — Fisher의 5% (1925) ​

역사 Fisher는 1925년 Statistical Methods for Research Workers에 이렇게 썼다. “P=0.05P=0.05, 곧 20분의 1에 해당하는 값은 1.96, 거의 2다. 편차가 유의한지 판단하는 기준으로 이 점을 잡는 것이 편리하다.” 이 한 문장이 이후 한 세기 동안 과학 논문의 관행이 되었다. Fisher에게 pp-값은 증거의 강도를 재는 연속적인 척도였고, Neyman–Pearson에게 검정은 미리 정한 α\alpha로 기각 여부를 결정하는 규칙이었다. 오늘의 관행은 둘을 섞어 쓴다.

4.1 정의 ​

정의 4.1 (pp-값) TT가 클수록 H0H_0에 불리한 검정통계량이고 관측값이 tt이면

p(t)=sup⁡θ∈Ω0Pθ(T(X)≥t)p(t)=\sup_{\theta\in\Omega_0}P_\theta\bigl(T(\X)\ge t\bigr)

를 pp-값이라 한다. “H0H_0 아래에서 관측한 것만큼, 또는 그보다 더 극단적인 결과가 나올 확률”이다.

크기 α\alpha의 검정 {T≥cα}\{T\ge c_\alpha\}들이 있으면 p(t)≤α  ⟺  t≥cαp(t)\le\alpha\iff t\ge c_\alpha이다. 곧 pp-값은 그 자료로 H0H_0를 기각하게 되는 가장 작은 α\alpha다. α\alpha를 미리 정하지 않고 증거의 크기를 보고하는 방법이다.

4.2 귀무가설 아래에서 pp-값은 균등하다 ​

정리 4.2 (pp-값의 분포) H0H_0가 단순가설(Ω0={θ0}\Omega_0=\{\theta_0\})이고 TT의 H0H_0 아래 분포함수 FF가 연속이면 p(T)∼U(0,1)p(T)\sim\mathrm U(0,1)이다. TT가 이산이면 모든 α\alpha에서 Pθ0(p(T)≤α)≤αP_{\theta_0}\bigl(p(T)\le\alpha\bigr)\le\alpha이다.

증명 전략 pp-값을 G(t)=Pθ0(T≥t)G(t)=P_{\theta_0}(T\ge t)로 쓰고 G(T)G(T)의 분포를 본다. 연속이면 확률적분변환이 그대로 답이다. 일반적으로는 {G(T)≤α}\{G(T)\le\alpha\}가 TT의 위쪽 꼬리 사건이라는 것을 쓴다.

(a) FF가 연속일 때

  1. p(t)=G(t)=1−P(T<t)=1−F(t−)=1−F(t)p(t)=G(t)=1-P(T<t)=1-F(t-)=1-F(t)이다.1회 정리 6.3(d), FF 연속

  2. F(T)∼U(0,1)F(T)\sim\mathrm U(0,1)이다.확률적분변환, 2회 정리 4.7

  3. U∼U(0,1)U\sim\mathrm U(0,1)이면 P(1−U≤u)=P(U≥1−u)=uP(1-U\le u)=P(U\ge1-u)=u이므로 p(T)=1−F(T)∼U(0,1)p(T)=1-F(T)\sim\mathrm U(0,1)이다.1 2

(b) 일반적인 TT

  1. GG는 비증가이므로 Sα={t:G(t)≤α}S_\alpha=\{t:G(t)\le\alpha\}는 tα=inf⁡Sαt_\alpha=\inf S_\alpha에 대해 [tα,∞)[t_\alpha,\infty) 또는 (tα,∞)(t_\alpha,\infty)이다. 따라서 {G(T)≤α}={T∈Sα}\{G(T)\le\alpha\}=\{T\in S_\alpha\}는 {T≥tα}\{T\ge t_\alpha\} 또는 {T>tα}\{T>t_\alpha\}이다.단조성, 하한 [T5]

  2. Sα=[tα,∞)S_\alpha=[t_\alpha,\infty)이면 P(G(T)≤α)=P(T≥tα)=G(tα)≤αP(G(T)\le\alpha)=P(T\ge t_\alpha)=G(t_\alpha)\le\alpha이다.tα∈Sαt_\alpha\in S_\alpha

  3. Sα=(tα,∞)S_\alpha=(t_\alpha,\infty)이면 {T≥tα+1n}↑{T>tα}\{T\ge t_\alpha+\tfrac1n\}\uparrow\{T>t_\alpha\}이므로 P(T>tα)=lim⁡nG(tα+1n)≤αP(T>t_\alpha)=\lim_nG(t_\alpha+\tfrac1n)\le\alpha이다.1회 정리 4.7(a)

(b)의 증명은 TT가 이산이라는 것을 쓰지 않는다. 어느 분포에서나 P(p(T)≤α)≤αP(p(T)\le\alpha)\le\alpha이고, 연속일 때만 등호가 모든 α\alpha에서 성립한다.

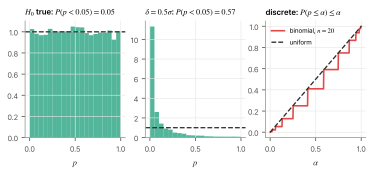
정리의 내용은 단순하지만 결과는 크다. 귀무가설이 참인 실험을 많이 하면 그 pp-값들은 [0,1][0,1]에 고르게 흩어진다. p<0.05p<0.05는 그 가운데 5%에서 우연히 일어난다(7절). 그리고 H1H_1이 참이면 pp-값은 0 쪽으로 몰린다. 몰리는 정도가 검정력이다(그림 4.1).

그림 4.1. t 검정 1만 번의 p-값 히스토그램(n=20). 왼쪽: H_0가 참이면 균등분포. 가운데: 효과 δ=0.5σ이면 0 근처로 몰리고 P(p<0.05)가 검정력 0.56이다. 오른쪽: 이산 검정(이항, n=20)의 p-값은 계단이고 P(p≤α)≤α(보수적).
그림 4.1 tt 검정 1만 번의 pp-값 히스토그램(n=20n=20). 왼쪽: H0H_0가 참이면 균등분포. 가운데: 효과 δ=0.5σ\delta=0.5\sigma이면 0 근처로 몰리고 P(p<0.05)P(p<0.05)가 검정력 0.56이다. 오른쪽: 이산 검정(이항, n=20n=20)의 pp-값은 계단이고 P(p≤α)≤αP(p\le\alpha)\le\alpha(보수적).

4.3 pp-값이 말하지 않는 것 ​

가정 주의 (1) pp-값은 H0H_0가 참일 확률이 아니다. P(자료∣H0)P(\text{자료}\mid H_0)를 P(H0∣자료)P(H_0\mid\text{자료})로 읽는 것은 1회의 조건부확률을 뒤집는 실수다. 후자를 말하려면 사전확률이 필요하다(16회). (2) pp-값은 효과의 크기가 아니다. 표본이 크면 의미 없는 작은 차이도 아주 작은 pp를 낸다. Arbuthnot의 82년 출생 93만 건에서 남아 비율 0.5160.516과 0.50.5의 차이에 대한 zz는 31.5, pp는 10−21810^{-218}이다. 이 pp는 “차이가 있다”는 것을 압도적으로 말하지만 차이가 1.6%포인트라는 것은 말하지 않는다. 구간 [0.5153, 0.5173][0.5153,\ 0.5173]이 둘을 함께 말한다. (3) p>0.05p>0.05는 H0H_0의 증거가 아니다. 검정력이 낮았을 수 있다(예제 3.3). 미국통계학회(2016)는 이 세 가지를 공식 성명으로 냈다.

연습문제

연습 4.1 (양쪽 pp-값 ★) Z∼N(0,1)Z\sim\N(0,1) 아래에서 ∣Z∣|Z|로 검정하면 p=2(1−Φ(∣z∣))p=2(1-\Phi(|z|))임을 보이고, 이것도 H0H_0 아래 균등함을 보여라.

풀이

p=P(∣Z∣≥∣z∣)=2(1−Φ(∣z∣))p=P(|Z|\ge|z|)=2(1-\Phi(|z|)). H0H_0 아래 ∣Z∣|Z|의 분포함수 G(t)=2Φ(t)−1G(t)=2\Phi(t)-1은 연속이므로 정리 4.2로 p=1−G(∣Z∣)p=1-G(|Z|)는 균등하다.

연습 4.2 (이산 pp-값 ★★) K∼b(20,12)K\sim\mathrm b(20,\tfrac12)의 한쪽 pp-값 P(K≥k)P(K\ge k)가 가질 수 있는 값을 나열하고, P(p(K)≤0.05)P(p(K)\le0.05)를 구하라. 정확히 0.05가 아닌 이유는?

풀이

p(k)=P(K≥k)p(k)=P(K\ge k)는 k=0,…,20k=0,\dots,20에서 1, 0.99999,…,0.0577 (k=14), 0.0207 (k=15), 0.0059,…1,\allowbreak \ 0.99999,\allowbreak \dots,\allowbreak 0.0577\ (k=14),\allowbreak \ 0.0207\ (k=15),\allowbreak \ 0.0059,\allowbreak \dots의 21개 값만 가진다. p≤0.05p\le0.05는 K≥15K\ge15와 같으므로 P(p≤0.05)=0.0207P(p\le0.05)=0.0207. 0.05와 0.0207 사이의 값이 없기 때문에 정확히 0.05가 될 수 없다.

연습 4.3 (pp-값의 분포와 검정력 ★★) 정리 3.4의 zz 검정에서 μ=μ0+δ\mu=\mu_0+\delta일 때 pp-값의 분포함수가 P(p≤u)=Φ(nδσ−zu)P(p\le u)=\Phi\bigl(\tfrac{\sqrt n\delta}\sigma-z_u\bigr)임을 보여라. u=αu=\alpha를 넣으면 검정력이다.

풀이

p=1−Φ(Zobs)p=1-\Phi(Z_{\mathrm{obs}}), Zobs=n(Xˉ−μ0)σ∼N(nδσ,1)Z_{\mathrm{obs}}=\tfrac{\sqrt n(\bar X-\mu_0)}\sigma\sim\N(\tfrac{\sqrt n\delta}\sigma,\allowbreak 1)이다. p≤u  ⟺  Zobs≥zup\le u\iff Z_{\mathrm{obs}}\ge z_u이므로 P(p≤u)=P(N(0,1)≥zu−nδσ)=Φ(nδσ−zu)P(p\le u)=P\bigl(\N(0,\allowbreak 1)\ge z_u-\tfrac{\sqrt n\delta}\sigma\bigr)=\Phi\bigl(\tfrac{\sqrt n\delta}\sigma-z_u\bigr).

연습 4.4 (pp-값을 합치기 ★★) 독립인 연구 kk개의 pp-값 p1,…,pkp_1,\dots,p_k가 모두 H0H_0 아래 균등하면 −2∑log⁡pi∼χ2(2k)-2\sum\log p_i\sim\chi^2(2k)임을 보여라(Fisher, 1932). (힌트: −2log⁡U∼Exp-2\log U\sim\mathrm{Exp}, 평균 2.)

풀이

pi∼U(0,1)p_i\sim\mathrm U(0,1)이면 P(−2log⁡pi>x)=P(pi<e−x/2)=e−x/2P(-2\log p_i>x)=P(p_i<e^{-x/2})=e^{-x/2}이므로 −2log⁡pi∼Exp-2\log p_i\sim\mathrm{Exp}(평균 2)=χ2(2)=\chi^2(2). 독립인 χ2(2)\chi^2(2) kk개의 합은 χ2(2k)\chi^2(2k)(4회 정리 3.7).

이 회차에서 읽은 절 0개 · 회차 차례