
테마
노트북 · 8회 · 추론의 기초
추론의 기초 신뢰구간과 유의성 검정
| 강의노트 | 08_inference_notes.pdf — 같은 절 번호, 같은 정리 번호. 증명은 노트에, 확인은 여기에 |
| 워크북 | 08_inference_workbook.pdf — 손으로 푸는 35문항. 다 푼 뒤 맨 끝 10절의 check()로 검산 |
| 원자료 | Arbuthnot(1710)의 세례 기록 (HistData Arbuthnot) · Weldon의 주사위 (vcd WeldonDice) · Quetelet의 가슴둘레 (HistData ChestSizes) · Berkeley 1973 (datasets UCBAdmissions) |
| 선수 지식 | 1–7회 (6회 축량과 -구간, 7회 중심극한정리·Slutsky·다변량 CLT) |
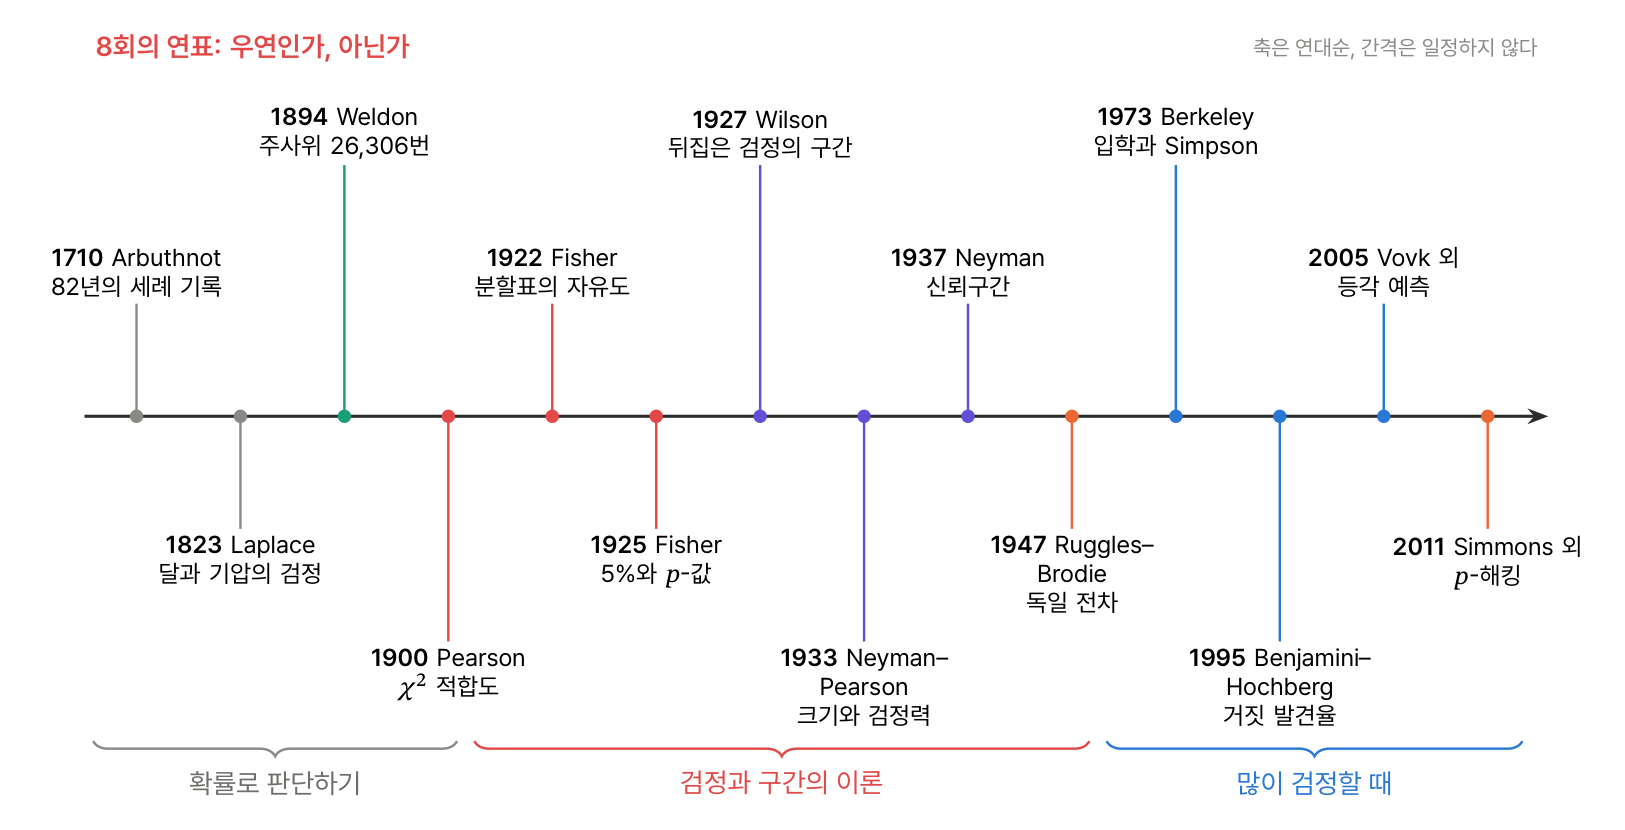
여는 질문. 1629년부터 1710년까지 82년 동안 런던에서는 해마다 남자아이가 여자아이보다 많이 세례를 받았다. 이것은 우연인가? 그리고 "우연이라기엔 너무 드물다"는 말을 어떻게 숫자로 할 것인가?
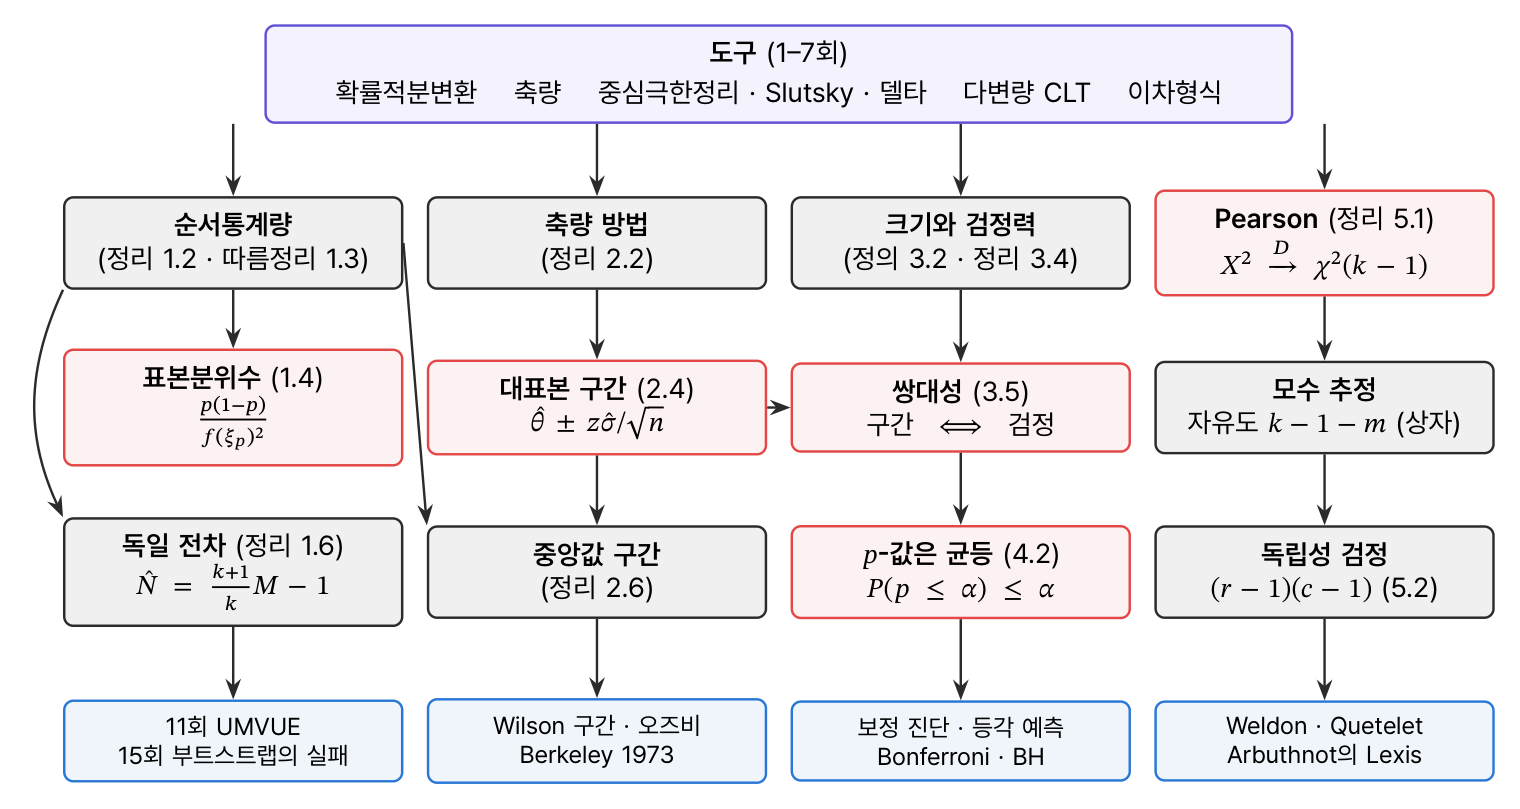
이번 회차의 지도
학습 목표
- 순서통계량의 밀도를 구현하고, 표본중앙값의 점근분산과 독일 전차 문제의 추정량을 시뮬레이션으로 확인한다.
- 축량·대표본·순서통계량으로 신뢰구간을 만들고 포함확률을 잰다.
- 검정의 크기와 검정력을 계산하고, 검정을 뒤집어 구간(Wilson)을 만든다.
- -값이 귀무가설 아래 균등함을 확인하고, Pearson의 와 Fisher의 자유도를 시뮬레이션으로 판정한다.
- 네 원자료에 검정을 쓰고, -해킹·선택적 멈춤·등각 예측·다중검정을 구현한다.
정리 지도
검정의 네 가지 결과
0. 설정
python
%matplotlib inline
import math
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import integrate, special, stats

SEED = 2026
N_SIM = 200_000
rng = np.random.default_rng(SEED)

C = dict(data="#1a9e78", stat="#2a78d6", key="#e34948", assume="#eb6834",
         theta="#6250d6", ink="#2b2b2b", hist="#8a8a86", grid="#e6e6e3")
SERIES = [C["stat"], C["data"], C["key"], C["theta"]]
THEORY = dict(color=C["ink"], ls="--", lw=1.6)
plt.rcParams.update({
    "figure.dpi": 110, "figure.figsize": (8, 4.2), "mathtext.fontset": "stix",
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.grid": True, "grid.color": C["grid"], "grid.linewidth": 0.8,
    "axes.edgecolor": "#9a9a96", "axes.labelcolor": C["ink"],
    "xtick.color": "#52514e", "ytick.color": "#52514e",
    "axes.titleweight": "bold", "axes.titlesize": 11, "axes.titlelocation": "left",
    "legend.frameon": False, "lines.linewidth": 2,
})

RDATASETS = "https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/master/csv/{}/{}.csv"
DATA_DIR = Path("../../data") if Path("../../.git").exists() else Path("data")

def load_rdata(item, package="HistData"):
    path = DATA_DIR / (f"{item}.csv" if package == "HistData" else f"{package}_{item}.csv")
    if not path.exists():
        DATA_DIR.mkdir(parents=True, exist_ok=True)
        pd.read_csv(RDATASETS.format(package, item)).drop(columns="rownames").to_csv(path, index=False)
    return pd.read_csv(path)

def report(checks):
    for name, ok in checks.items():
        print(f"  {'✓' if ok else '✗'}  {name}")
    assert all(checks.values()), "대조 실패"

def within(est, truth, se, k=4):
    return abs(est - truth) <= k * se
1. 통계량과 순서통계량 — 독일 전차 문제
정리 1.2 결합밀도 · 따름정리 1.3 · 정리 1.4 · 정리 1.6 독일 전차: .
python
def order_pdf(x, k, n, dist):
    """따름정리 1.3 — scipy 의 연속분포 dist 에 대한 k 번째 순서통계량의 밀도 (로그로 계산)"""
    logc = special.gammaln(n + 1) - special.gammaln(k) - special.gammaln(n - k + 1)
    return np.exp(logc + (k - 1) * dist.logcdf(x) + (n - k) * dist.logsf(x) + dist.logpdf(x))

checks = {}
for dist, name in [(stats.norm(), "normal"), (stats.expon(), "exponential")]:
    n = 7
    X = np.sort(dist.rvs(size=(N_SIM, n), random_state=rng), axis=1)
    lo, hi = dist.support()
    for k in (1, 4, 7):
        total = integrate.quad(lambda t: order_pdf(t, k, n, dist), lo, hi)[0]
        mean_formula = integrate.quad(lambda t: t * order_pdf(t, k, n, dist), lo, hi)[0]
        checks[f"따름정리 1.3 ({name}, k={k}): ∫f = 1, 평균이 시뮬레이션과 같다"] = abs(total - 1) < 1e-8 and within(X[:, k - 1].mean(), mean_formula, X[:, k - 1].std() / math.sqrt(N_SIM))
# 4회 예제 4.4: 균등 순서통계량은 베타
U = np.sort(rng.random((N_SIM, 9)), axis=1)
checks["4회 예제 4.4: U_(3) ~ Beta(3, 7) (KS 유의확률 > 0.01)"] = stats.kstest(U[:20_000, 2], stats.beta(3, 7).cdf).pvalue > 0.01
# 연습 1.1: 균등 범위 ~ Beta(n−1, 2)
checks["연습 1.1: 범위 X_(n) − X_(1) ~ Beta(8, 2) (KS > 0.01)"] = stats.kstest((U[:, -1] - U[:, 0])[:20_000], stats.beta(8, 2).cdf).pvalue > 0.01
# 연습 1.2: 지수 간격 (n−i+1) D_i 가 iid Exp(1)
E = np.sort(rng.exponential(1, (N_SIM, 6)), axis=1)
D = np.diff(np.hstack([np.zeros((N_SIM, 1)), E]), axis=1) * np.arange(6, 0, -1)
checks["연습 1.2: (n−i+1)D_i 의 평균 ≈ 1, 서로 무상관"] = np.allclose(D.mean(axis=0), 1, atol=0.01) and np.abs(np.corrcoef(D.T)[np.triu_indices(6, 1)]).max() < 0.01
report(checks)
text
  ✓  따름정리 1.3 (normal, k=1): ∫f = 1, 평균이 시뮬레이션과 같다
  ✓  따름정리 1.3 (normal, k=4): ∫f = 1, 평균이 시뮬레이션과 같다
  ✓  따름정리 1.3 (normal, k=7): ∫f = 1, 평균이 시뮬레이션과 같다
  ✓  따름정리 1.3 (exponential, k=1): ∫f = 1, 평균이 시뮬레이션과 같다
  ✓  따름정리 1.3 (exponential, k=4): ∫f = 1, 평균이 시뮬레이션과 같다
  ✓  따름정리 1.3 (exponential, k=7): ∫f = 1, 평균이 시뮬레이션과 같다
  ✓  4회 예제 4.4: U_(3) ~ Beta(3, 7) (KS 유의확률 > 0.01)
  ✓  연습 1.1: 범위 X_(n) − X_(1) ~ Beta(8, 2) (KS > 0.01)
  ✓  연습 1.2: (n−i+1)D_i 의 평균 ≈ 1, 서로 무상관
python
# 정리 1.4 · 예제 1.5 · 연습 1.5: 표본중앙값의 점근분산 1/(4 n f(m)²)
rows = []
for name, gen, f_m, var_mean in [("normal", lambda sz: rng.standard_normal(sz), 1 / math.sqrt(2 * math.pi), 1.0),
                                 ("Laplace(b=1)", lambda sz: rng.laplace(0, 1, sz), 0.5, 2.0),
                                 ("t(3)", lambda sz: rng.standard_t(3, sz), stats.t.pdf(0, 3), 3.0),
                                 ("Cauchy", lambda sz: rng.standard_cauchy(sz), 1 / math.pi, np.inf)]:
    n = 201
    med = np.median(gen((20_000, n)), axis=1)
    rows.append(dict(population=name, n_var_median=n * med.var(), theory=1 / (4 * f_m**2), n_var_mean=var_mean,
                     efficiency=var_mean * 4 * f_m**2))
med_tab = pd.DataFrame(rows).set_index("population")
print(med_tab.round(3).to_string())
smooth = ["normal", "t(3)", "Cauchy"]
report({"정리 1.4: n Var(중앙값) ≈ 1/(4f(m)²) — 밀도가 매끈한 셋은 5% 안": np.allclose(med_tab.loc[smooth, "n_var_median"], med_tab.loc[smooth, "theory"], rtol=0.05),
        "정리 1.4: Laplace 는 중앙값에서 밀도가 뾰족해 수렴이 느리다 (n=201 에서 15% 안)": abs(med_tab.loc["Laplace(b=1)", "n_var_median"] - 1) < 0.15,
        "예제 1.5: 정규에서 평균이 1.57배, Laplace 에서 중앙값이 2배, t(3) 에서 1.62배 효율적":
            abs(1 / med_tab.loc["normal", "efficiency"] - math.pi / 2) < 1e-9 and abs(med_tab.loc["Laplace(b=1)", "efficiency"] - 2) < 1e-9
            and abs(med_tab.loc["t(3)", "efficiency"] - 1.62) < 0.01})
text
              n_var_median  theory  n_var_mean  efficiency
population
normal               1.546   1.571         1.0       0.637
Laplace(b=1)         1.138   1.000         2.0       2.000
t(3)                 1.824   1.851         3.0       1.621
Cauchy               2.474   2.467         inf         inf
  ✓  정리 1.4: n Var(중앙값) ≈ 1/(4f(m)²) — 밀도가 매끈한 셋은 5% 안
  ✓  정리 1.4: Laplace 는 중앙값에서 밀도가 뾰족해 수렴이 느리다 (n=201 에서 15% 안)
  ✓  예제 1.5: 정규에서 평균이 1.57배, Laplace 에서 중앙값이 2배, t(3) 에서 1.62배 효율적
python
class TankEstimator:
    """정리 1.6: {1, …, N} 에서 비복원으로 k 개를 뽑았을 때 N 의 두 불편추정량"""
    @staticmethod
    def umvue(serials):
        k, M = len(serials), max(serials)
        return (k + 1) / k * M - 1

    @staticmethod
    def moments(serials):
        return 2 * np.mean(serials) - 1

N_true, k = 300, 5
S = np.array([rng.choice(N_true, k, replace=False) + 1 for _ in range(100_000)])
m = S.max(axis=1)
est_max = (k + 1) / k * m - 1
est_mom = 2 * S.mean(axis=1) - 1
var_max = (N_true + 1) * (N_true - k) / (k * (k + 2))
var_mom = (N_true + 1) * (N_true - k) / (3 * k)
# 정리 1.6: P(M = m) = C(m−1, k−1)/C(N, k)
pm = np.array([math.comb(mm - 1, k - 1) for mm in range(k, N_true + 1)]) / math.comb(N_true, k)
print(f"E M: 공식 {k * (N_true + 1) / (k + 1):.2f}, 분포로 {np.sum(np.arange(k, N_true + 1) * pm):.2f}, 시뮬레이션 {m.mean():.2f}")
one = sorted(S[0])
print(f"한 번의 노획: 일련번호 {one} → 최댓값 추정 {TankEstimator.umvue(one):.0f}, 적률법 {TankEstimator.moments(one):.0f}")
print(f"최댓값 추정량: 평균 {est_max.mean():.1f}, sd {est_max.std():.1f} (이론 {math.sqrt(var_max):.1f});  적률법: 평균 {est_mom.mean():.1f}, sd {est_mom.std():.1f} (이론 {math.sqrt(var_mom):.1f})")
# 연습 1.3: 하키스틱
hockey = all(sum(math.comb(mm, kk) for mm in range(kk, NN + 1)) == math.comb(NN + 1, kk + 1) for NN in range(1, 30) for kk in range(0, NN + 1))
report({"정리 1.6: P(M=m) 의 합 = 1, E M = k(N+1)/(k+1)": abs(pm.sum() - 1) < 1e-12 and abs(np.sum(np.arange(k, N_true + 1) * pm) - k * (N_true + 1) / (k + 1)) < 1e-9,
        "정리 1.6: 두 추정량 모두 불편 (4 se 안)": within(est_max.mean(), N_true, est_max.std() / math.sqrt(len(m))) and within(est_mom.mean(), N_true, est_mom.std() / math.sqrt(len(m))),
        "연습 1.4: 분산 공식 (3% 안), 비 (k+2)/3": abs(est_max.var() / var_max - 1) < 0.03 and abs(est_mom.var() / var_mom - 1) < 0.03 and abs(var_mom / var_max - (k + 2) / 3) < 1e-12,
        "연습 1.3: 하키스틱 항등식 (N < 30 의 모든 경우)": hockey})

fig, ax = plt.subplots(figsize=(9, 3.4))
bins = np.linspace(0, 700, 71)
ax.hist(est_max, bins=bins, density=True, histtype="step", lw=2, color=C["key"], label=f"(k+1)/k·M − 1  (sd {est_max.std():.0f})")
ax.hist(est_mom, bins=bins, density=True, histtype="step", lw=2, color=C["stat"], label=f"2x̄ − 1  (sd {est_mom.std():.0f})")
ax.axvline(N_true, **THEORY, label="true N = 300")
ax.set_xlabel("estimate of N from k = 5 serial numbers"); ax.legend(); ax.set_title("German tank problem: the maximum carries the information")
plt.tight_layout(); plt.show()
text
E M: 공식 250.83, 분포로 250.83, 시뮬레이션 250.86
한 번의 노획: 일련번호 [np.int64(23), np.int64(40), np.int64(58), np.int64(203), np.int64(237)] → 최댓값 추정 283, 적률법 223
최댓값 추정량: 평균 300.0, sd 50.2 (이론 50.4);  적률법: 평균 300.4, sd 76.9 (이론 76.9)
  ✓  정리 1.6: P(M=m) 의 합 = 1, E M = k(N+1)/(k+1)
  ✓  정리 1.6: 두 추정량 모두 불편 (4 se 안)
  ✓  연습 1.4: 분산 공식 (3% 안), 비 (k+2)/3
  ✓  연습 1.3: 하키스틱 항등식 (N < 30 의 모든 경우)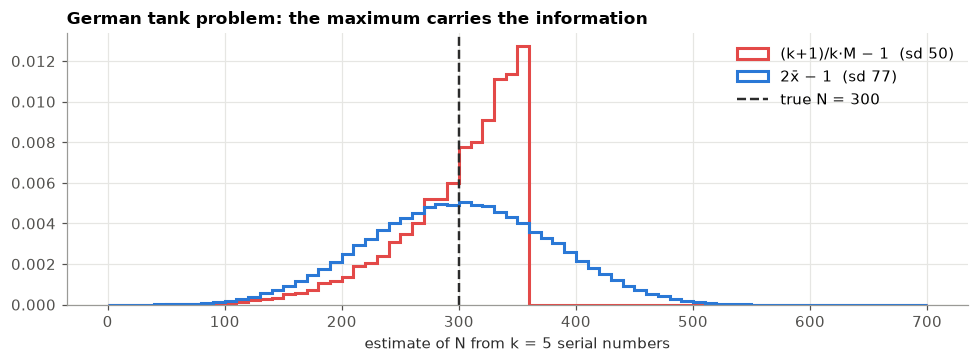
그림 읽기. 두 추정량 모두 300을 중심으로 하지만, 최댓값 추정량(빨강)은 위로는 거의 넘지 않고 좁다. 적률법(파랑)은 표본 다섯 개의 평균에 기대므로 넓게 흩어지고, 관측한 최댓값보다 작은 값을 내놓는 "불가능한" 추정도 한다. 11회에서 최댓값이 에 대한 정보를 모두 담는 "충분통계량"임을 본다.
📝 연습 1.1–1.5 (강의노트): 최솟값과 범위, 지수 표본의 간격, 하키스틱 항등식, 전차 추정량의 분산, Laplace에서 중앙값.
2. 신뢰구간 — Neyman (1937)
정의 2.1 모든 에서 · 정리 2.2 축량 방법 · 예제 2.3 지수 평균의 정확한 구간 · 정리 2.4 대표본(Wald) 구간 · 예제 2.5 오즈비 · 정리 2.6 순서통계량으로 만든 중앙값의 구간.
구간 하나를 만드는 함수와, 그 함수의 포함확률을 시뮬레이션으로 재는 함수를 따로 둔다.
python
def coverage(make_interval, sampler, theta, reps=20_000):
    """make_interval(표본) → (L, U) 의 포함확률을 시뮬레이션으로 잰다"""
    hits = 0
    for _ in range(reps):
        L, U = make_interval(sampler())
        hits += (L <= theta <= U)
    return hits / reps

def exp_mean_ci(x, conf=0.95):
    """예제 2.3: 2Σx/θ ~ χ²(2n) 을 축량으로"""
    n, a = len(x), 1 - conf
    return 2 * x.sum() / stats.chi2.ppf(1 - a / 2, 2 * n), 2 * x.sum() / stats.chi2.ppf(a / 2, 2 * n)

def median_ci(x, i):
    """정리 2.6: [X_(i), X_(n+1−i)] 와 그 신뢰계수"""
    xs = np.sort(x); n = len(x)
    coef = stats.binom.cdf(n - i, n, 0.5) - stats.binom.cdf(i - 1, n, 0.5)
    return xs[i - 1], xs[n - i], coef

lo, hi = exp_mean_ci(np.full(10, 820.0))
print(f"예제 2.3: x̄ = 820, n = 10 → [{lo:.0f}, {hi:.0f}]")
cov_exp = coverage(exp_mean_ci, lambda: rng.exponential(820, 10), 820)
coefs = {i: median_ci(np.zeros(20), i)[2] for i in (5, 6, 7)}
print("정리 2.6 / 연습 2.4: n = 20 의 신뢰계수", {f"[X({i}), X({21 - i})]": round(float(c), 4) for i, c in coefs.items()})
cov_med_cauchy = coverage(lambda x: median_ci(x, 6)[:2], lambda: rng.standard_cauchy(20), 0.0)
cov_med_exp = coverage(lambda x: median_ci(x, 6)[:2], lambda: rng.exponential(1, 20), math.log(2))
# 연습 2.2: 균등분포의 상한
cov_unif = coverage(lambda x: (x.max(), x.max() * 0.05 ** (-1 / len(x))), lambda: rng.uniform(0, 7, 8), 7.0)
report({"예제 2.3: [480, 1710]": abs(lo - 480) < 1 and abs(hi - 1710) < 1,
        "정리 2.2: 지수 평균의 구간은 정확히 0.95 (4 se 안)": within(cov_exp, 0.95, math.sqrt(0.0475 / 20_000)),
        "정리 2.6: 신뢰계수 0.988, 0.959, 0.885": np.allclose(list(coefs.values()), [0.9882, 0.9586, 0.8847], atol=1e-4),
        "정리 2.6: 분포와 상관없다 — Cauchy, 지수에서 모두 0.959 (4 se 안)": within(cov_med_cauchy, coefs[6], 0.0014) and within(cov_med_exp, coefs[6], 0.0014),
        "연습 2.2: [M, M·α^(−1/n)] 의 포함확률 0.95": within(cov_unif, 0.95, math.sqrt(0.0475 / 20_000))})
text
예제 2.3: x̄ = 820, n = 10 → [480, 1710]text
정리 2.6 / 연습 2.4: n = 20 의 신뢰계수 {'[X(5), X(16)]': 0.9882, '[X(6), X(15)]': 0.9586, '[X(7), X(14)]': 0.8847}text
  ✓  예제 2.3: [480, 1710]
  ✓  정리 2.2: 지수 평균의 구간은 정확히 0.95 (4 se 안)
  ✓  정리 2.6: 신뢰계수 0.988, 0.959, 0.885
  ✓  정리 2.6: 분포와 상관없다 — Cauchy, 지수에서 모두 0.959 (4 se 안)
  ✓  연습 2.2: [M, M·α^(−1/n)] 의 포함확률 0.95
python
# 그림 2.1 의 실험: 신뢰구간 100개 — t-구간과 순서통계량 구간
n = 10
X = rng.standard_normal((100, n))
tq = stats.t.ppf(0.975, n - 1)
L1, U1 = X.mean(1) - tq * X.std(1, ddof=1) / math.sqrt(n), X.mean(1) + tq * X.std(1, ddof=1) / math.sqrt(n)
Xs = np.sort(X, axis=1); L2, U2 = Xs[:, 1], Xs[:, 8]
fig, axes = plt.subplots(1, 2, figsize=(12, 5), sharey=True)
for ax, (L, U, title) in zip(axes, [(L1, U1, "95% t-intervals"), (L2, U2, "[X(2), X(9)], coefficient 0.979")]):
    miss = (L > 0) | (U < 0)
    for i in range(100):
        ax.plot([L[i], U[i]], [i, i], color=C["key"] if miss[i] else C["stat"], lw=1.6 if miss[i] else 1)
    ax.axvline(0, **THEORY); ax.set_title(f"{title}: {miss.sum()} miss"); ax.set_xlabel("μ")
axes[0].set_yticks([])
plt.tight_layout(); plt.show()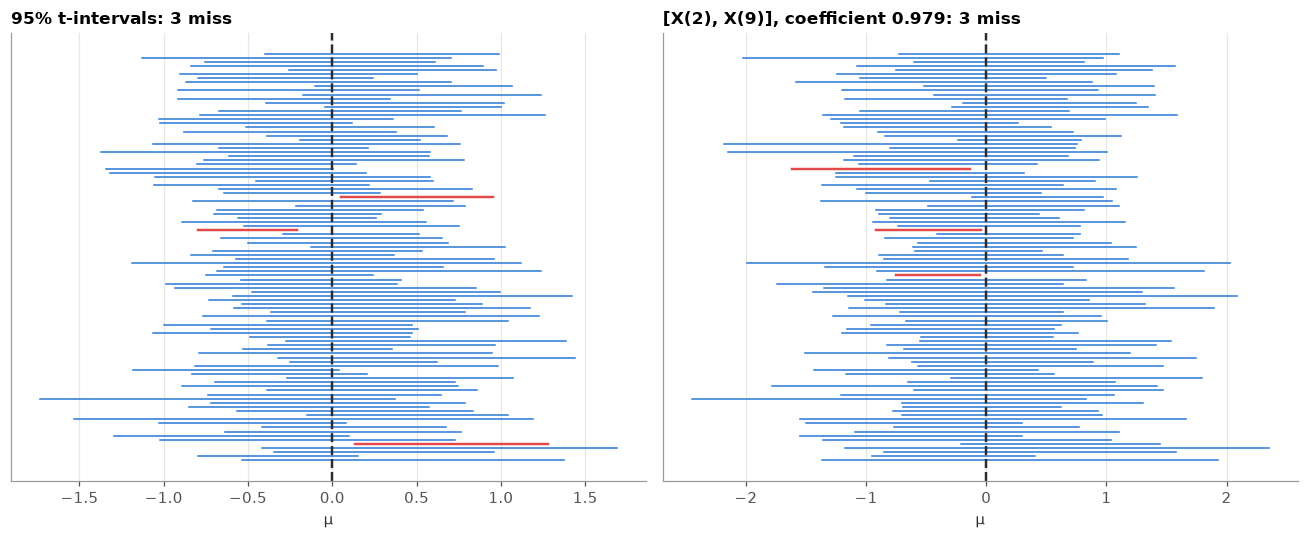
python
# 정리 2.4 · 예제 2.5 · 연습 2.3: Berkeley 1973 — 오즈비와 두 비율의 차이
ucb = load_rdata("UCBAdmissions", "datasets")
tab = ucb.pivot_table(index="Gender", columns="Admit", values="Freq", aggfunc="sum").loc[["Male", "Female"], ["Admitted", "Rejected"]]
a, b = tab.loc["Male"]; c, d = tab.loc["Female"]
def odds_ratio_ci(a, b, c, d, conf=0.95):
    z = stats.norm.ppf(0.5 + conf / 2)
    lor, se = math.log(a * d / (b * c)), math.sqrt(1 / a + 1 / b + 1 / c + 1 / d)
    return math.exp(lor), math.exp(lor - z * se), math.exp(lor + z * se)
OR, ORlo, ORhi = odds_ratio_ci(a, b, c, d)
p1, p2 = a / (a + b), c / (c + d)
se_diff = math.sqrt(p1 * (1 - p1) / (a + b) + p2 * (1 - p2) / (c + d))
print(tab.to_string())
print(f"합격률: 남 {p1:.3f}, 여 {p2:.3f};  오즈비 {OR:.2f} [{ORlo:.2f}, {ORhi:.2f}];  차이 {p1 - p2:.3f} ± {1.96 * se_diff:.3f}")
# 오즈비 구간의 포함확률 (같은 표본 크기, 참 확률 = 관측 비율)
def or_cover(reps=20_000):
    A = rng.binomial(a + b, p1, reps); Cc = rng.binomial(c + d, p2, reps)
    lor = np.log(A * (c + d - Cc) / ((a + b - A) * Cc)); se = np.sqrt(1 / A + 1 / (a + b - A) + 1 / Cc + 1 / (c + d - Cc))
    true = math.log(p1 * (1 - p2) / ((1 - p1) * p2))
    return np.mean(np.abs(lor - true) <= 1.96 * se)
report({"예제 2.5: 오즈비 1.84 [1.62, 2.09]": abs(OR - 1.841) < 1e-3 and abs(ORlo - 1.624) < 1e-3 and abs(ORhi - 2.087) < 1e-3,
        "연습 2.3: 차이 0.142, 95% 구간 [0.114, 0.170]": abs(p1 - p2 - 0.1417) < 1e-3 and abs(p1 - p2 - 1.96 * se_diff - 0.114) < 1e-3,
        "정리 2.4: 이 크기에서 로그 오즈비 구간의 포함확률 ≈ 0.95": abs(or_cover() - 0.95) < 0.006})
text
Admit   Admitted  Rejected
Gender
Male        1198      1493
Female       557      1278
합격률: 남 0.445, 여 0.304;  오즈비 1.84 [1.62, 2.09];  차이 0.142 ± 0.028
  ✓  예제 2.5: 오즈비 1.84 [1.62, 2.09]
  ✓  연습 2.3: 차이 0.142, 95% 구간 [0.114, 0.170]
  ✓  정리 2.4: 이 크기에서 로그 오즈비 구간의 포함확률 ≈ 0.95
📝 연습 2.1–2.4 (강의노트): 포함확률의 해석, 균등분포의 상한, 두 비율의 차이, 중앙값 구간.
3. 검정의 언어 — 크기와 검정력
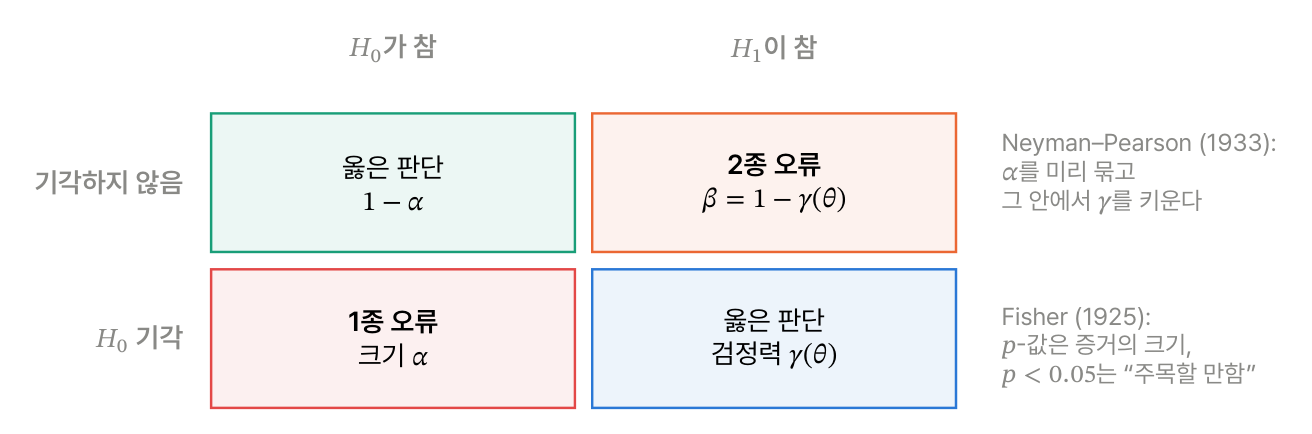
정의 3.1–3.2 기각역, 1종·2종 오류, 크기, 검정력 함수 · 예제 3.3 이항 검정 · 정리 3.4 , 표본 크기 · 정리 3.5 쌍대성 · 예제 3.6 Wilson 구간.
python
def binom_test_region(n, alpha=0.05, p0=0.5):
    """H0: p = p0 대 p > p0 — 크기가 α 이하인 가장 작은 기준값 c (기각역 K ≥ c)"""
    return min(k for k in range(n + 1) if stats.binom.sf(k - 1, n, p0) <= alpha)

c100 = binom_test_region(100)
power = {p: stats.binom.sf(c100 - 1, 100, p) for p in (0.55, 0.6, 0.65, 0.7)}
sim_power = np.mean(rng.binomial(100, 0.6, N_SIM) >= c100)
print(f"예제 3.3: 기각역 K ≥ {c100}, 크기 {stats.binom.sf(c100 - 1, 100, 0.5):.4f};  검정력", {k: round(float(v), 3) for k, v in power.items()})
# 연습 3.1: Arbuthnot 의 부호 검정
c82 = binom_test_region(82)
# 정리 3.4: z 검정의 검정력과 표본 크기
def z_power(delta_over_sigma, n, alpha=0.05, two_sided=False):
    za = stats.norm.ppf(1 - alpha / 2) if two_sided else stats.norm.ppf(1 - alpha)
    return stats.norm.cdf(math.sqrt(n) * delta_over_sigma - za)
def sample_size(delta_over_sigma, alpha=0.05, power=0.8, two_sided=True, groups=1):
    za = stats.norm.ppf(1 - alpha / 2) if two_sided else stats.norm.ppf(1 - alpha)
    return groups * ((za + stats.norm.ppf(power)) / delta_over_sigma) ** 2
n_z = 25
Xz = rng.normal(0.4, 1, (N_SIM, n_z))
sim_z = np.mean(Xz.mean(1) >= stats.norm.ppf(0.95) / math.sqrt(n_z))
print(f"정리 3.4: δ = 0.4σ, n = 25 의 검정력 — 공식 {z_power(0.4, 25):.4f}, 시뮬레이션 {sim_z:.4f}")
print(f"표본 크기: 한 집단 δ = 0.5σ → {sample_size(0.5):.1f};  두 집단 δ = 0.3σ, 검정력 0.9 → 집단당 {sample_size(0.3, power=0.9, groups=2):.1f} (연습 3.3)")
report({"예제 3.3: 기각역 K ≥ 59, 크기 0.044": c100 == 59 and abs(stats.binom.sf(58, 100, 0.5) - 0.0443) < 1e-4,
        "예제 3.3: 검정력 0.24, 0.62, 0.91, 0.99, 시뮬레이션과 같다": np.allclose(list(power.values()), [0.241, 0.623, 0.912, 0.993], atol=2e-3) and within(sim_power, power[0.6], math.sqrt(0.24 / N_SIM)),
        "연습 3.1: Arbuthnot 의 기각역 K ≥ 49 (82 년)": c82 == 49,
        "정리 3.4: 검정력 공식 == 시뮬레이션 (4 se 안)": within(sim_z, z_power(0.4, 25), math.sqrt(0.25 / N_SIM)),
        "정리 3.4 · 연습 3.3: n = 31.4, 집단당 233.5": abs(sample_size(0.5) - 31.40) < 0.01 and abs(sample_size(0.3, power=0.9, groups=2) - 233.5) < 0.1})
text
예제 3.3: 기각역 K ≥ 59, 크기 0.0443;  검정력 {0.55: 0.241, 0.6: 0.623, 0.65: 0.912, 0.7: 0.993}
정리 3.4: δ = 0.4σ, n = 25 의 검정력 — 공식 0.6388, 시뮬레이션 0.6410
표본 크기: 한 집단 δ = 0.5σ → 31.4;  두 집단 δ = 0.3σ, 검정력 0.9 → 집단당 233.5 (연습 3.3)
  ✓  예제 3.3: 기각역 K ≥ 59, 크기 0.044
  ✓  예제 3.3: 검정력 0.24, 0.62, 0.91, 0.99, 시뮬레이션과 같다
  ✓  연습 3.1: Arbuthnot 의 기각역 K ≥ 49 (82 년)
  ✓  정리 3.4: 검정력 공식 == 시뮬레이션 (4 se 안)
  ✓  정리 3.4 · 연습 3.3: n = 31.4, 집단당 233.5
python
# 정리 3.5 · 예제 3.6 · 연습 3.4: 검정을 뒤집어 구간 만들기 — Wilson 구간
def wilson(k, n, conf=0.95):
    z = stats.norm.ppf(0.5 + conf / 2); ph = k / n
    center = (ph + z * z / (2 * n)) / (1 + z * z / n)
    half = z / (1 + z * z / n) * math.sqrt(ph * (1 - ph) / n + z * z / (4 * n * n))
    return center - half, center + half

def invert_score_test(k, n, conf=0.95, grid=200_001):
    """정리 3.5(a): H0: p = p0 를 기각하지 않는 p0 들을 모은다"""
    z = stats.norm.ppf(0.5 + conf / 2)
    p0 = np.linspace(1e-9, 1 - 1e-9, grid)
    accept = np.abs(k / n - p0) <= z * np.sqrt(p0 * (1 - p0) / n)
    return p0[accept].min(), p0[accept].max()

checks = {}
for k, n in [(0, 20), (3, 20), (37, 50), (500, 1000)]:
    w, inv = wilson(k, n), invert_score_test(k, n)
    checks[f"정리 3.5: (k, n) = ({k}, {n}) 에서 뒤집은 검정 == Wilson 공식"] = np.allclose(w, inv, atol=2e-5)
print("연습 3.4: n = 20, p̂ = 0 → Wald [0, 0], Wilson", tuple(round(float(v), 4) for v in wilson(0, 20)))
checks["연습 3.4: Wilson [0, 0.161]"] = abs(wilson(0, 20)[1] - 0.1611) < 1e-3
report(checks)
text
연습 3.4: n = 20, p̂ = 0 → Wald [0, 0], Wilsontext
 (0.0, 0.1611)
  ✓  정리 3.5: (k, n) = (0, 20) 에서 뒤집은 검정 == Wilson 공식
  ✓  정리 3.5: (k, n) = (3, 20) 에서 뒤집은 검정 == Wilson 공식
  ✓  정리 3.5: (k, n) = (37, 50) 에서 뒤집은 검정 == Wilson 공식
  ✓  정리 3.5: (k, n) = (500, 1000) 에서 뒤집은 검정 == Wilson 공식
  ✓  연습 3.4: Wilson [0, 0.161]
📝 연습 3.1–3.5 (강의노트): Arbuthnot의 숫자, 검정력 함수, 표본 크기, Wilson 구간, 한쪽 구간과 한쪽 검정.
4. -값 — Fisher의 5% (1925)
정의 4.1 · 정리 4.2 단순 와 연속 이면 , 이산이면 .
python
# 정리 4.2: H0 아래의 p-값 — 연속 (t 검정) 과 이산 (이항 검정)
n = 20
X0 = rng.normal(0, 1, (N_SIM, n))
t0 = X0.mean(1) / (X0.std(1, ddof=1) / math.sqrt(n))
p_t = 2 * stats.t.sf(np.abs(t0), n - 1)
X1 = rng.normal(0.5, 1, (N_SIM, n))
t1 = X1.mean(1) / (X1.std(1, ddof=1) / math.sqrt(n))
p_t1 = 2 * stats.t.sf(np.abs(t1), n - 1)
power_exact = 1 - stats.nct.cdf(stats.t.ppf(0.975, n - 1), n - 1, 0.5 * math.sqrt(n)) + stats.nct.cdf(-stats.t.ppf(0.975, n - 1), n - 1, 0.5 * math.sqrt(n))
K = rng.binomial(20, 0.5, N_SIM)
p_b = stats.binom.sf(K - 1, 20, 0.5)
alphas = np.array([0.01, 0.05, 0.1, 0.2])
disc = np.array([np.mean(p_b <= a) for a in alphas])
print("연습 4.2: 이항(20, ½) 의 한쪽 p-값 — P(p ≤ α) =", dict(zip(alphas.tolist(), disc.round(4).tolist())))
# 연습 4.3: p-값의 분포함수와 z 검정의 검정력
n_z, d = 16, 0.5
Z = math.sqrt(n_z) * rng.normal(d, 1, (N_SIM, n_z)).mean(1)
p_z = stats.norm.sf(Z)
u = np.array([0.01, 0.05, 0.2])
# 연습 4.4: Fisher 의 결합 — 독립 p-값 5개, −2Σlog p ~ χ²(10)
F = -2 * np.log(rng.random((N_SIM, 5))).sum(1)
report({"정리 4.2: H0 의 t 검정 p-값과 U(0,1) 의 KS 유의확률 > 0.01": stats.kstest(p_t[:20_000], "uniform").pvalue > 0.01,
        "그림 4.1: δ = 0.5σ, n = 20 의 P(p < 0.05) ≈ 검정력 0.56": within(np.mean(p_t1 < 0.05), power_exact, math.sqrt(0.25 / N_SIM)) and abs(power_exact - 0.5645) < 1e-3,
        "정리 4.2 · 연습 4.2: 이산이면 P(p ≤ α) ≤ α, 특히 P(p ≤ 0.05) = 0.0207": np.all(disc <= alphas + 0.002) and abs(stats.binom.sf(14, 20, 0.5) - 0.0207) < 1e-4,
        "연습 4.3: P(p ≤ u) = Φ(√n δ − z_u) (4 se 안)": all(within(np.mean(p_z <= uu), stats.norm.cdf(math.sqrt(n_z) * d - stats.norm.ppf(1 - uu)), 0.0012) for uu in u),
        "연습 4.4: −2Σ log p 와 χ²(10) 의 KS 유의확률 > 0.01": stats.kstest(F[:20_000], stats.chi2(10).cdf).pvalue > 0.01})

fig, axes = plt.subplots(1, 3, figsize=(14, 3.4))
for ax, pv, title in [(axes[0], p_t, "H0 true"), (axes[1], p_t1, "δ = 0.5σ")]:
    ax.hist(pv, bins=np.linspace(0, 1, 21), density=True, color=C["data"], alpha=0.75)
    ax.axhline(1, **THEORY); ax.set_title(f"{title}: P(p < 0.05) = {np.mean(pv < 0.05):.3f}"); ax.set_xlabel("p")
uu = np.linspace(0, 1, 401)
axes[2].plot(uu, [np.mean(p_b <= a) for a in uu], color=C["key"], label="binomial(20, ½)")
axes[2].plot(uu, uu, **THEORY, label="uniform"); axes[2].legend(); axes[2].set_title("discrete p-values are conservative")
plt.tight_layout(); plt.show()
text
연습 4.2: 이항(20, ½) 의 한쪽 p-값 — P(p ≤ α) =text
{0.01: 0.0059, 0.05: 0.0209, 0.1: 0.0578, 0.2: 0.132}text
  ✓  정리 4.2: H0 의 t 검정 p-값과 U(0,1) 의 KS 유의확률 > 0.01
  ✓  그림 4.1: δ = 0.5σ, n = 20 의 P(p < 0.05) ≈ 검정력 0.56
  ✓  정리 4.2 · 연습 4.2: 이산이면 P(p ≤ α) ≤ α, 특히 P(p ≤ 0.05) = 0.0207
  ✓  연습 4.3: P(p ≤ u) = Φ(√n δ − z_u) (4 se 안)
  ✓  연습 4.4: −2Σ log p 와 χ²(10) 의 KS 유의확률 > 0.01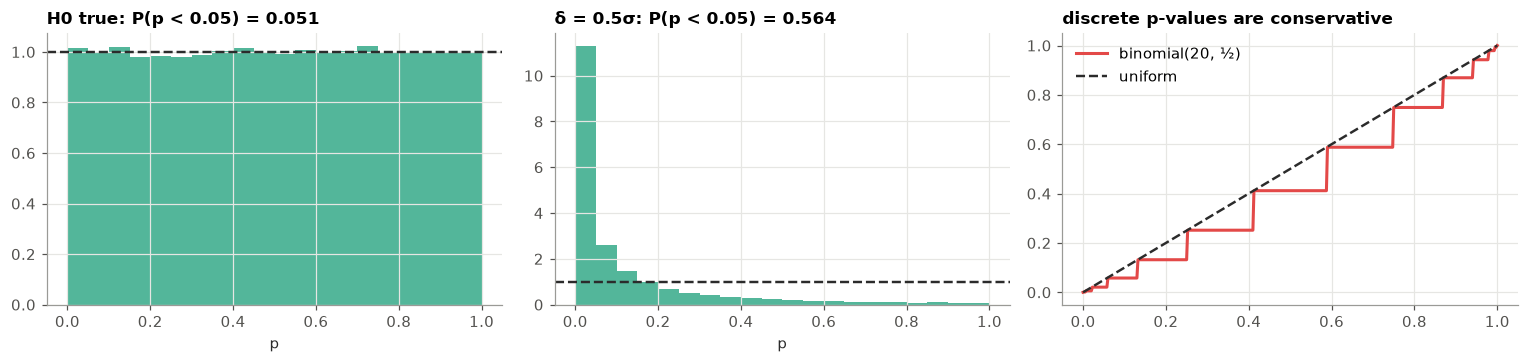
그림 읽기. 왼쪽은 평평하다. 귀무가설이 참이면 -값은 어디에나 같은 빈도로 떨어지고, 는 정확히 5%의 실험에서 우연히 일어난다. 가운데는 0 쪽으로 몰린다. 몰린 정도가 검정력이다. 오른쪽의 계단은 언제나 대각선 아래에 있다. 이산 검정의 실제 크기는 명목 보다 작다.
📝 연습 4.1–4.4 (강의노트): 양쪽 -값, 이산 -값, -값의 분포와 검정력, -값을 합치기.
5. 검정 — Pearson (1900)과 Fisher (1922)
정리 5.1 · 5.2절의 상자: 모수 개를 추정하면 · 따름정리 5.2 독립성 검정 .
두 통계량을 직접 구현하고 scipy.stats.chisquare, chi2_contingency와 대조한다.
python
def pearson_gof(observed, probs, n_estimated=0):
    """정리 5.1: 적합도 X², 자유도 k − 1 − m, p-값"""
    observed = np.asarray(observed, float); expected = observed.sum() * np.asarray(probs, float)
    X2 = ((observed - expected) ** 2 / expected).sum()
    df = len(observed) - 1 - n_estimated
    return X2, df, stats.chi2.sf(X2, df)

def pearson_independence(table):
    """따름정리 5.2: 분할표의 독립성 X², 자유도 (r−1)(c−1)"""
    table = np.asarray(table, float)
    E = table.sum(1, keepdims=True) * table.sum(0, keepdims=True) / table.sum()
    X2 = ((table - E) ** 2 / E).sum()
    df = (table.shape[0] - 1) * (table.shape[1] - 1)
    return X2, df, stats.chi2.sf(X2, df)

obs = rng.multinomial(120, [0.1, 0.2, 0.3, 0.4])
tbl = rng.multinomial(300, np.full(12, 1 / 12)).reshape(3, 4)
mine1, ref1 = pearson_gof(obs, [0.1, 0.2, 0.3, 0.4]), stats.chisquare(obs, 120 * np.array([0.1, 0.2, 0.3, 0.4]))
mine2, ref2 = pearson_independence(tbl), stats.chi2_contingency(tbl, correction=False)
# 연습 5.1: 두 범주이면 X² = Z²
k1, n2 = 37, 100
X2_two = pearson_gof([k1, n2 - k1], [0.3, 0.7])[0]
Zp = (k1 / n2 - 0.3) / math.sqrt(0.3 * 0.7 / n2)
# 연습 5.3: 2×2 의 닫힌 꼴
a_, b_, c_, d_ = 1198, 1493, 557, 1278
closed = (a_ + b_ + c_ + d_) * (a_ * d_ - b_ * c_) ** 2 / ((a_ + b_) * (c_ + d_) * (a_ + c_) * (b_ + d_))
report({"정리 5.1: pearson_gof == scipy.stats.chisquare": np.allclose(mine1[::2], [ref1.statistic, ref1.pvalue]),
        "따름정리 5.2: pearson_independence == chi2_contingency (자유도 6)": np.allclose([mine2[0], mine2[2]], [ref2[0], ref2[1]]) and mine2[1] == ref2[2] == 6,
        "연습 5.1: k = 2 이면 X² = Z²": abs(X2_two - Zp**2) < 1e-10,
        "연습 5.3: 2×2 의 닫힌 꼴 == 92.2": abs(closed - pearson_independence([[a_, b_], [c_, d_]])[0]) < 1e-8 and abs(closed - 92.21) < 0.01})
text
  ✓  정리 5.1: pearson_gof == scipy.stats.chisquare
  ✓  따름정리 5.2: pearson_independence == chi2_contingency (자유도 6)
  ✓  연습 5.1: k = 2 이면 X² = Z²
  ✓  연습 5.3: 2×2 의 닫힌 꼴 == 92.2
python
# 정리 5.1 증명의 2–3단계: 사영행렬 P = I − uu' (연습 5.2) 와 극한분포
p0 = np.array([0.1, 0.2, 0.3, 0.4]); uvec = np.sqrt(p0)
P = np.eye(4) - np.outer(uvec, uvec)
eig = np.sort(np.linalg.eigvalsh(P))
# 그림 5.1 의 실험: Fisher 의 자유도 vs Pearson 의 자유도 — 독립인 3×3 표, 주변확률 추정
pr_, pc_ = np.array([0.5, 0.3, 0.2]), np.array([0.2, 0.3, 0.5])
T = rng.multinomial(300, np.outer(pr_, pc_).ravel(), 20_000).reshape(-1, 3, 3)
E = T.sum(2)[:, :, None] * T.sum(1)[:, None, :] / 300
X2i = ((T - E) ** 2 / E).sum((1, 2))
size_fisher, size_pearson = np.mean(X2i > stats.chi2.ppf(0.95, 4)), np.mean(X2i > stats.chi2.ppf(0.95, 8))
# 공평한 주사위 60번 (모수 추정 없음)
D6 = rng.multinomial(60, np.full(6, 1 / 6), 20_000)
X2d = ((D6 - 10) ** 2 / 10).sum(1)
print(f"독립인 3×3 표: X² 의 평균 {X2i.mean():.2f} (Fisher 4, Pearson 8);  5% 검정의 실제 크기 — Fisher {size_fisher:.4f}, Pearson {size_pearson:.4f}")
print(f"연습 5.5: X² = 3.84 의 p-값 — 자유도 1: {stats.chi2.sf(3.84, 1):.3f}, 3: {stats.chi2.sf(3.84, 3):.3f}, 4: {stats.chi2.sf(3.84, 4):.3f}, 8: {stats.chi2.sf(3.84, 8):.3f}")
report({"연습 5.2: P 는 대칭, 멱등, 고윳값 {0, 1, 1, 1}": np.allclose(P, P.T) and np.allclose(P @ P, P) and np.allclose(eig, [0, 1, 1, 1]),
        "정리 5.1: 공평한 주사위 60번의 X² — 평균 ≈ k−1 = 5, 5% 검정의 크기 ≈ 0.05": abs(X2d.mean() - 5) < 0.05 and abs(np.mean(X2d > stats.chi2.ppf(0.95, 5)) - 0.05) < 0.006,
        "따름정리 5.2: 독립성 X² 의 평균 ≈ (r−1)(c−1) = 4, 크기 ≈ 0.05 (Fisher 가 옳다)": abs(X2i.mean() - 4) < 0.06 and abs(size_fisher - 0.05) < 0.006 and size_pearson < 0.005})

fig, axes = plt.subplots(1, 2, figsize=(12, 3.6))
xx = np.linspace(0.01, 25, 300)
axes[0].hist(X2i, bins=50, density=True, color=C["data"], alpha=0.6)
axes[0].plot(xx, stats.chi2.pdf(xx, 4), color=C["key"], label="χ²(4) — Fisher")
axes[0].plot(xx, stats.chi2.pdf(xx, 8), **THEORY, label="χ²(8) — Pearson")
axes[0].legend(); axes[0].set_title("independent 3×3 tables, margins estimated")
axes[1].hist(stats.chi2.sf(X2i, 4), bins=np.linspace(0, 1, 21), density=True, histtype="step", lw=2, color=C["key"], label="p with df 4")
axes[1].hist(stats.chi2.sf(X2i, 8), bins=np.linspace(0, 1, 21), density=True, histtype="step", lw=2, color=C["ink"], ls="--", label="p with df 8")
axes[1].legend(); axes[1].set_title("only Fisher's df gives uniform p-values")
plt.tight_layout(); plt.show()
text
독립인 3×3 표: X² 의 평균 4.01 (Fisher 4, Pearson 8);  5% 검정의 실제 크기 — Fisher 0.0505, Pearson 0.0046
연습 5.5: X² = 3.84 의 p-값 — 자유도 1: 0.050, 3: 0.279, 4: 0.428, 8: 0.871
  ✓  연습 5.2: P 는 대칭, 멱등, 고윳값 {0, 1, 1, 1}
  ✓  정리 5.1: 공평한 주사위 60번의 X² — 평균 ≈ k−1 = 5, 5% 검정의 크기 ≈ 0.05
  ✓  따름정리 5.2: 독립성 X² 의 평균 ≈ (r−1)(c−1) = 4, 크기 ≈ 0.05 (Fisher 가 옳다)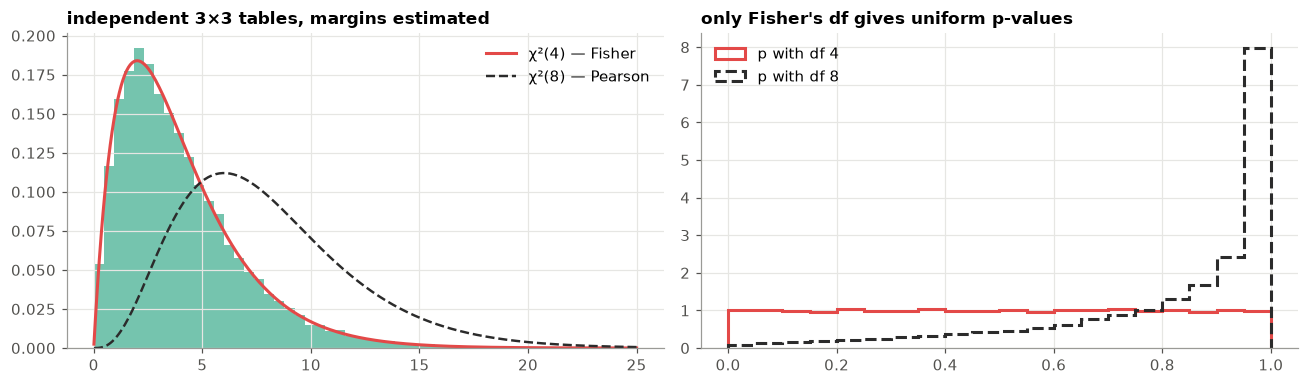
python
# 연습 5.4: Poisson 분산 검정 — 4회의 14개 군단의 20년 합계
vb = load_rdata("VonBort", "vcd")
tot = vb.groupby("corps").deaths.sum()
disp = ((tot - tot.mean()) ** 2 / tot.mean()).sum()
# Poisson 이 참일 때 분산 검정의 크기 (같은 평균)
sims = rng.poisson(tot.mean(), (20_000, len(tot)))
disp_sim = ((sims - sims.mean(1, keepdims=True)) ** 2 / sims.mean(1, keepdims=True)).sum(1)
print(f"연습 5.4: Σ(X_i − X̄)²/X̄ = {disp:.1f}, 자유도 {len(tot) - 1}, p = {stats.chi2.sf(disp, len(tot) - 1):.4f}")
report({"연습 5.4: 27.3, p = 0.011 (4회 예제 6.2)": abs(disp - 27.29) < 0.01 and abs(stats.chi2.sf(disp, 13) - 0.0114) < 2e-4,
        "연습 5.4: Poisson 이 참이면 분산 통계량 ~ χ²(13) (크기 ≈ 0.05)": abs(np.mean(disp_sim > stats.chi2.ppf(0.95, 13)) - 0.05) < 0.006})
text
연습 5.4: Σ(X_i − X̄)²/X̄ = 27.3, 자유도 13, p = 0.0114
  ✓  연습 5.4: 27.3, p = 0.011 (4회 예제 6.2)
  ✓  연습 5.4: Poisson 이 참이면 분산 통계량 ~ χ²(13) (크기 ≈ 0.05)
📝 연습 5.1–5.5 (강의노트): 두 범주이면, 사영행렬, 표의 , Poisson 분산 검정, Pearson의 자유도.
6. 데이터로 — 네 가지 검정
예제 6.1 Arbuthnot의 82년 · 예제 6.2 Weldon의 주사위 (단순가설과 복합가설) · 6.3절 Quetelet의 가슴둘레 · 예제 6.3 Berkeley 1973과 Simpson의 역설.
python
ar = load_rdata("Arbuthnot")
K = int((ar.Males > ar.Females).sum()); n_years = len(ar)
M, Fm = ar.Males.sum(), ar.Females.sum(); n_births = M + Fm
p_hat = M / n_births
z = (p_hat - 0.5) / math.sqrt(0.25 / n_births)
log10_p = stats.norm.logsf(z) / math.log(10)
ci = (p_hat - 1.96 * math.sqrt(p_hat * (1 - p_hat) / n_births), p_hat + 1.96 * math.sqrt(p_hat * (1 - p_hat) / n_births))
lexis = pearson_independence(ar[["Males", "Females"]].to_numpy())
print(f"(a) 부호 검정: {K}/{n_years} 년, p = 2^-82 = {2.0**-82:.2e}")
print(f"(b) 비율: p̂ = {p_hat:.4f}, z = {z:.1f}, log10 p ≈ {log10_p:.0f}, 95% 구간 [{ci[0]:.4f}, {ci[1]:.4f}], 남녀비 {M / Fm:.3f}")
print(f"(c) 82×2 독립성 (연습 6.1): X² = {lexis[0]:.1f}, 자유도 {lexis[1]}, p = {lexis[2]:.1e}, X²/81 = {lexis[0] / lexis[1]:.2f}")
report({"예제 6.1(a): 82년 모두, 2^-82 = 2.1e-25": K == 82 and abs(2.0**-82 / 2.07e-25 - 1) < 0.01,
        "예제 6.1(b): p̂ = 0.5163, z = 31.5, 구간 [0.5153, 0.5173]": abs(p_hat - 0.5163) < 1e-4 and abs(z - 31.53) < 0.01 and abs(ci[0] - 0.5153) < 1e-4,
        "예제 6.1(c) · 연습 6.1: X² = 169.7, 자유도 81": abs(lexis[0] - 169.69) < 0.01 and lexis[1] == 81})
text
(a) 부호 검정: 82/82 년, p = 2^-82 = 2.07e-25
(b) 비율: p̂ = 0.5163, z = 31.5, log10 p ≈ -218, 95% 구간 [0.5153, 0.5173], 남녀비 1.067
(c) 82×2 독립성 (연습 6.1): X² = 169.7, 자유도 81, p = 3.1e-08, X²/81 = 2.09
  ✓  예제 6.1(a): 82년 모두, 2^-82 = 2.1e-25
  ✓  예제 6.1(b): p̂ = 0.5163, z = 31.5, 구간 [0.5153, 0.5173]
  ✓  예제 6.1(c) · 연습 6.1: X² = 169.7, 자유도 81
python
wd = load_rdata("WeldonDice", "vcd")
kk = wd.n56.to_numpy(); obs = wd.Freq.to_numpy(); N = obs.sum()
def binom_probs(p):
    pr = stats.binom.pmf(kk, 12, p); pr[-1] = stats.binom.sf(9, 12, p)   # 마지막 칸은 "10개 이상"
    return pr
simple = pearson_gof(obs, binom_probs(1 / 3))
p_w = (kk * obs).sum() / (12 * N)
composite = pearson_gof(obs, binom_probs(p_w), n_estimated=1)
ci_w = p_w + np.array([-1, 1]) * 1.96 * math.sqrt(p_w * (1 - p_w) / (12 * N))
print(f"예제 6.2(a) 공평한 주사위: X² = {simple[0]:.1f}, 자유도 {simple[1]}, p = {simple[2]:.4f}  (가장 작은 기대도수 {N * binom_probs(1 / 3).min():.1f})")
print(f"예제 6.2(b) p 추정: p̂ = {p_w:.4f}, X² = {composite[0]:.2f}, 자유도 {composite[1]}, p = {composite[2]:.2f};  p̂ 의 95% 구간 [{ci_w[0]:.4f}, {ci_w[1]:.4f}] (연습 6.2)")
report({"예제 6.2(a): X² = 35.5, 자유도 10, p = 0.0001": abs(simple[0] - 35.49) < 0.01 and simple[1] == 10 and abs(simple[2] - 1.03e-4) < 1e-5,
        "예제 6.2(b): p̂ = 0.3377, X² = 8.18, 자유도 9, p = 0.52": abs(p_w - 0.33769) < 1e-5 and abs(composite[0] - 8.18) < 0.01 and composite[1] == 9 and abs(composite[2] - 0.516) < 0.002,
        "연습 6.2: 구간 [0.3360, 0.3393] 에 1/3 이 없다": ci_w[0] > 1 / 3})
text
예제 6.2(a) 공평한 주사위: X² = 35.5, 자유도 10, p = 0.0001  (가장 작은 기대도수 14.3)
예제 6.2(b) p 추정: p̂ = 0.3377, X² = 8.18, 자유도 9, p = 0.52;  p̂ 의 95% 구간 [0.3360, 0.3393] (연습 6.2)
  ✓  예제 6.2(a): X² = 35.5, 자유도 10, p = 0.0001
  ✓  예제 6.2(b): p̂ = 0.3377, X² = 8.18, 자유도 9, p = 0.52
  ✓  연습 6.2: 구간 [0.3360, 0.3393] 에 1/3 이 없다
python
cs = load_rdata("ChestSizes")
xc, fc = cs.chest.to_numpy(float), cs["count"].to_numpy(float); Nc = fc.sum()

def quetelet_x2(counts, drop=None):
    """5회 예제 1.6 의 정규 적합도: 칸으로 묶은 자료에서 평균·분산을 추정하고 기대도수 < 5 인 양 끝을 합친다"""
    m = (xc * counts).sum() / Nc; s = math.sqrt(((xc - m) ** 2 * counts).sum() / Nc)
    e = list(Nc * (stats.norm.cdf(xc + 0.5, m, s) - stats.norm.cdf(xc - 0.5, m, s))); o = list(counts)
    while e[0] < 5:
        o[1] += o[0]; e[1] += e[0]; del o[0], e[0]
    while e[-1] < 5:
        o[-2] += o[-1]; e[-2] += e[-1]; del o[-1], e[-1]
    o, e = np.array(o), np.array(e)
    contrib = (o - e) ** 2 / e
    return contrib.sum(), len(o), (o - e) / np.sqrt(e)

X2q, cells, resid = quetelet_x2(fc)
print(f"6.3절: X² = {X2q:.1f}, 칸 {cells}, 자유도 {cells - 3}, p = {stats.chi2.sf(X2q, cells - 3):.5f} (Pearson 의 자유도 {cells - 1}: p = {stats.chi2.sf(X2q, cells - 1):.4f})")
print("칸별 (O−E)/√E:", resid.round(2), " → 44인치 칸의 기여", round(float(resid.min() ** 2), 1))
pooled = np.repeat(xc, fc.astype(int))
print(f"자료의 왜도 {stats.skew(pooled):.3f}, 초과첨도 {stats.kurtosis(pooled):.3f}")

# 연습 6.3: 같은 N, 같은 칸으로 — 정규와 약간 치우친 분포에서 기각 확률
mu_q, sd_q = (xc * fc).sum() / Nc, math.sqrt(((xc - (xc * fc).sum() / Nc) ** 2 * fc).sum() / Nc)
def reject_rate(skew, reps=400):
    hits = 0
    for _ in range(reps):
        if skew == 0:
            y = rng.normal(mu_q, sd_q, int(Nc))
        else:
            a_ = (2 / skew) ** 2; sc = sd_q / math.sqrt(a_); y = rng.gamma(a_, sc, int(Nc)) + mu_q - a_ * sc
        y = np.clip(np.round(y), xc.min(), xc.max())
        cnt = np.array([(y == v).sum() for v in xc], float)
        s_, k_, _ = quetelet_x2(cnt)
        hits += stats.chi2.sf(s_, k_ - 3) < 0.05
    return hits / reps
rates = {sk: reject_rate(sk) for sk in (0.0, 0.1, 0.2)}
print("연습 6.3: 기각 확률", rates)
without44 = X2q - resid.min() ** 2
report({"6.3절: X² = 35.0, 칸 13, 자유도 10, p = 0.0001 (5회의 수정된 값)": abs(X2q - 34.97) < 0.01 and cells == 13 and abs(stats.chi2.sf(X2q, 10) - 1.26e-4) < 1e-5,
        "6.3절: 44인치 칸의 표준화 잔차 −4.4, 기여 19.7": abs(resid.min() + 4.44) < 0.01 and abs(resid.min() ** 2 - 19.7) < 0.1,
        "6.3절: 왜도 0.03, 초과첨도 0.06 — 모양은 정규에 가깝다": abs(stats.skew(pooled)) < 0.05 and abs(stats.kurtosis(pooled)) < 0.1,
        "연습 6.3: 정규이면 ≈ 0.05, 왜도 0.1 이면 ≈ 0.42, 0.2 이면 ≈ 0.99 (시뮬레이션 오차 안)": abs(rates[0.0] - 0.05) < 0.035 and abs(rates[0.1] - 0.42) < 0.08 and rates[0.2] > 0.95,
        "연습 6.3: 44인치 칸을 빼면 X² ≈ 15.3, 자유도 9, p ≈ 0.08": abs(without44 - 15.3) < 0.1 and abs(stats.chi2.sf(without44, 9) - 0.083) < 0.005})
text
6.3절: X² = 35.0, 칸 13, 자유도 10, p = 0.00013 (Pearson 의 자유도 12: p = 0.0005)
칸별 (O−E)/√E: [-0.91  1.   -1.01 -0.66  0.05  1.65 -0.7  -0.3   0.75  1.47 -4.44  0.15
  2.43]  → 44인치 칸의 기여 19.7
자료의 왜도 0.033, 초과첨도 0.060
text
연습 6.3: 기각 확률 {0.0: np.float64(0.0675), 0.1: np.float64(0.41), 0.2: np.float64(0.9875)}
  ✓  6.3절: X² = 35.0, 칸 13, 자유도 10, p = 0.0001 (5회의 수정된 값)
  ✓  6.3절: 44인치 칸의 표준화 잔차 −4.4, 기여 19.7
  ✓  6.3절: 왜도 0.03, 초과첨도 0.06 — 모양은 정규에 가깝다
  ✓  연습 6.3: 정규이면 ≈ 0.05, 왜도 0.1 이면 ≈ 0.42, 0.2 이면 ≈ 0.99 (시뮬레이션 오차 안)
  ✓  연습 6.3: 44인치 칸을 빼면 X² ≈ 15.3, 자유도 9, p ≈ 0.08
python
# 예제 6.3 · 연습 6.4: Berkeley — 전체 표와 학과별 표, Mantel–Haenszel
by = ucb.pivot_table(index=["Dept", "Gender"], columns="Admit", values="Freq", aggfunc="sum")
by["rate"] = by.Admitted / (by.Admitted + by.Rejected)
rates_tab = by.rate.unstack()
print(rates_tab.round(3).to_string())
num = den = 0.0
for dept, g in ucb.groupby("Dept"):
    t = g.pivot_table(index="Gender", columns="Admit", values="Freq", aggfunc="sum")
    a_, b_, c_, d_ = t.loc["Male", "Admitted"], t.loc["Male", "Rejected"], t.loc["Female", "Admitted"], t.loc["Female", "Rejected"]
    nn = a_ + b_ + c_ + d_
    num += a_ * d_ / nn; den += b_ * c_ / nn
gd = ucb.pivot_table(index="Gender", columns="Dept", values="Freq", aggfunc="sum")
overall = pearson_independence(tab.to_numpy())
gender_dept = pearson_independence(gd.to_numpy())
print(f"전체: X² = {overall[0]:.1f} (자유도 {overall[1]}), 학과별로 여자가 높은 곳 {int((rates_tab.Female > rates_tab.Male).sum())}/6, MH 오즈비 {num / den:.2f};  성별 × 학과 X² = {gender_dept[0]:.0f} (자유도 {gender_dept[1]})")
report({"예제 6.3: 전체 X² = 92.2, p ≈ 1e-21": abs(overall[0] - 92.21) < 0.01 and overall[2] < 1e-20,
        "예제 6.3: 여섯 학과 중 넷에서 여자 합격률이 더 높다": int((rates_tab.Female > rates_tab.Male).sum()) == 4,
        "연습 6.4: Mantel–Haenszel 오즈비 0.90": abs(num / den - 0.905) < 0.002,
        "예제 6.3: 성별 × 학과 X² = 1068 (자유도 5)": abs(gender_dept[0] - 1068.4) < 0.5 and gender_dept[1] == 5})
text
Gender  Female   Male
Dept
A        0.824  0.621
B        0.680  0.630
C        0.341  0.369
D        0.349  0.331
E        0.239  0.277
F        0.070  0.059
전체: X² = 92.2 (자유도 1), 학과별로 여자가 높은 곳 4/6, MH 오즈비 0.90;  성별 × 학과 X² = 1068 (자유도 5)
  ✓  예제 6.3: 전체 X² = 92.2, p ≈ 1e-21
  ✓  예제 6.3: 여섯 학과 중 넷에서 여자 합격률이 더 높다
  ✓  연습 6.4: Mantel–Haenszel 오즈비 0.90
  ✓  예제 6.3: 성별 × 학과 X² = 1068 (자유도 5)
표 읽기. 전체 표의 는 "성별과 합격은 독립이 아니다"를 압도적으로 말한다. 학과로 나누면 연관이 거의 사라지거나 뒤집히고(오즈비 0.90), 대신 성별과 학과 사이의 연관()이 드러난다. 검정은 질문에 정확히 답하지만, 어떤 질문을 해야 하는지는 말해 주지 않는다.
📝 연습 6.1–6.4 (강의노트): Lexis의 검정, 주사위의 효과 크기, Quetelet의 검정력, Mantel–Haenszel.
7. 부숴보기 — 원하는 결과가 나올 때까지
7.1절 스무 번의 검정 · 예제 7.1 선택적 멈춤 · 예제 7.2 Wald 구간의 포함확률 · 7.4절 작은 기대도수와 Monte Carlo 검정.
python
# 7.1절 · 연습 7.1: 귀무가설이 모두 참인 독립 검정 20개
P20 = rng.random((N_SIM, 20))
any_sig = np.mean((P20 < 0.05).any(axis=1))
sidak = 1 - 0.95 ** (1 / 20)
# 예제 7.1 · 연습 7.2: 10개마다 들여다보며 |z| > 1.96 이면 멈춘다
def optional_stopping(n_max, reps):
    X = rng.standard_normal((reps, n_max))
    cs_ = np.cumsum(X, axis=1); ns = np.arange(10, n_max + 1, 10)
    zz = cs_[:, ns - 1] / np.sqrt(ns)
    return np.mean((np.abs(zz) > 1.96).any(axis=1))
stop = {nm: optional_stopping(nm, 20_000 if nm < 10_000 else 3_000) for nm in (100, 1000, 10_000)}
print(f"하나라도 유의: {any_sig:.3f} (이론 {1 - 0.95**20:.3f});  Šidák α = {sidak:.5f}")
print("선택적 멈춤의 거짓 양성 확률:", {k: round(float(v), 3) for k, v in stop.items()})
report({"7.1절: 1 − 0.95^20 = 0.64": within(any_sig, 1 - 0.95**20, math.sqrt(0.23 / N_SIM)),
        "연습 7.1: Šidák α = 0.00256": abs(sidak - 0.002561) < 1e-6,
        "예제 7.1 · 연습 7.2: 0.19, 0.37, 0.53 으로 자란다": abs(stop[100] - 0.19) < 0.012 and abs(stop[1000] - 0.374) < 0.012 and abs(stop[10_000] - 0.525) < 0.03})
text
하나라도 유의: 0.643 (이론 0.642);  Šidák α = 0.00256
선택적 멈춤의 거짓 양성 확률: {100: 0.195, 1000: 0.37, 10000: 0.538}
  ✓  7.1절: 1 − 0.95^20 = 0.64
  ✓  연습 7.1: Šidák α = 0.00256
  ✓  예제 7.1 · 연습 7.2: 0.19, 0.37, 0.53 으로 자란다
python
def exact_coverage(make_ci, n, p):
    """예제 7.2: 이항의 모든 k 에 대해 구간을 만들고 확률로 가중해 더한다"""
    kk_ = np.arange(n + 1)
    inside = np.array([lo_ <= p <= hi_ for lo_, hi_ in (make_ci(k_, n) for k_ in kk_)])
    return float((stats.binom.pmf(kk_, n, p) * inside).sum())

def wald(k, n, z=1.96):
    ph = k / n; h = z * math.sqrt(ph * (1 - ph) / n)
    return ph - h, ph + h

cov_tab = pd.DataFrame({p: {"Wald": exact_coverage(wald, 50, p), "Wilson": exact_coverage(wilson, 50, p)} for p in (0.005, 0.01, 0.05, 0.1, 0.2, 0.5)}).T
print(cov_tab.round(3).to_string())
w592 = exact_coverage(wald, 592, 0.005)
print(f"n = 592, p = 0.005: Wald {w592:.3f}")
# 7.4절: 작은 기대도수 — 크기 / Monte Carlo 검정 (연습 7.4)
sparse = rng.multinomial(30, [0.02] * 5 + [0.9], 100_000)
E_sp = 30 * np.array([0.02] * 5 + [0.9])
X2_sp = ((sparse - E_sp) ** 2 / E_sp).sum(1)
size_sparse = np.mean(X2_sp > stats.chi2.ppf(0.95, 5))
def mc_pvalue(observed, probs, B=999):
    n_ = int(np.sum(observed)); E_ = n_ * np.asarray(probs)
    t0 = ((observed - E_) ** 2 / E_).sum()
    sims = rng.multinomial(n_, probs, B)
    tb = ((sims - E_) ** 2 / E_).sum(1)
    return (1 + np.sum(tb >= t0)) / (B + 1)
mcp = np.array([mc_pvalue(sparse[i], [0.02] * 5 + [0.9]) for i in range(1500)])
report({"예제 7.2: Wald 0.22, 0.39 (p = 0.005, 0.01), Wilson 은 0.91 이상": abs(cov_tab.loc[0.005, "Wald"] - 0.222) < 1e-3 and abs(cov_tab.loc[0.01, "Wald"] - 0.395) < 1e-3 and (cov_tab.Wilson > 0.9).all(),
        "예제 7.2: n = 592, p = 0.005 에서도 Wald 0.79": abs(w592 - 0.792) < 1e-3,
        "연습 7.3: 작은 p 에서 Wald ≈ 1 − (1−p)^n": abs(cov_tab.loc[0.005, "Wald"] - (1 - 0.995**50)) < 1e-3,
        "7.4절: 기대도수 0.6 인 칸이 다섯이면 χ² 근사의 크기 ≈ 0.11": abs(size_sparse - 0.112) < 0.005,
        "연습 7.4: Monte Carlo p-값의 크기 ≤ 0.05 (+ 3 se)": np.mean(mcp <= 0.05) <= 0.05 + 3 * math.sqrt(0.0475 / 1500)})

fig, ax = plt.subplots(figsize=(10, 3.4))
ps = np.linspace(0.002, 0.998, 499)
ax.plot(ps, [exact_coverage(wald, 50, p) for p in ps], color=C["stat"], lw=1, label="Wald")
ax.plot(ps, [exact_coverage(wilson, 50, p) for p in ps], color=C["key"], lw=1, label="Wilson")
ax.axhline(0.95, **THEORY); ax.set_ylim(0.75, 1.0); ax.set_xlabel("p"); ax.set_ylabel("exact coverage"); ax.legend()
ax.set_title("nominal 95% intervals for a proportion, n = 50")
plt.tight_layout(); plt.show()
text
        Wald  Wilson
0.005  0.222   0.974
0.010  0.395   0.911
0.050  0.920   0.962
0.100  0.879   0.970
0.200  0.938   0.951
0.500  0.935   0.935
n = 592, p = 0.005: Wald 0.792
text
  ✓  예제 7.2: Wald 0.22, 0.39 (p = 0.005, 0.01), Wilson 은 0.91 이상
  ✓  예제 7.2: n = 592, p = 0.005 에서도 Wald 0.79
  ✓  연습 7.3: 작은 p 에서 Wald ≈ 1 − (1−p)^n
  ✓  7.4절: 기대도수 0.6 인 칸이 다섯이면 χ² 근사의 크기 ≈ 0.11
  ✓  연습 7.4: Monte Carlo p-값의 크기 ≤ 0.05 (+ 3 se)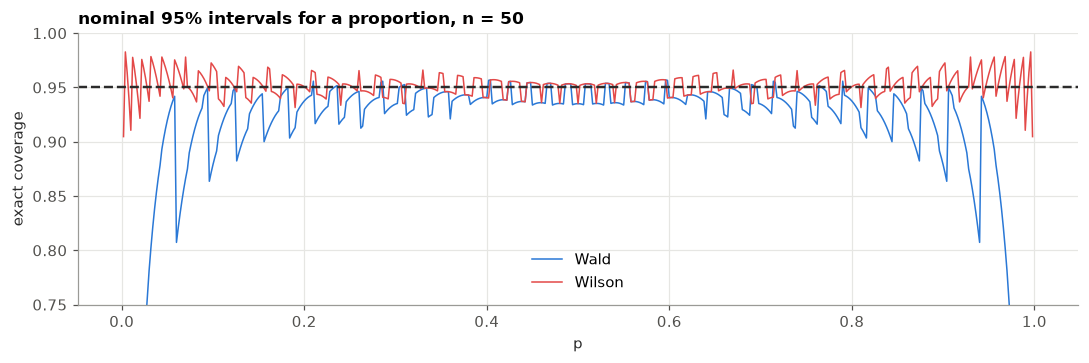
📝 연습 7.1–7.4 (강의노트): 스무 번의 검정, 선택적 멈춤, 정확한 포함확률, Monte Carlo 검정.
8. Beautiful insights — 균등성과 순위
8.1절 균등성으로 보정 점검 · 보조정리 8.1 교환가능한 순위는 균등 · 정리 8.2 분할 등각 예측 · 명제 8.3 Bonferroni · 8.3절의 상자: Benjamini–Hochberg.
python
# 8.1절 · 연습 8.1: 예측분포의 보정 — PIT 값 F(y)
y = rng.standard_normal(50_000)
pit = {"맞는 예측 N(0,1)": stats.norm.cdf(y), "너무 좁은 N(0,0.5²)": stats.norm.cdf(y / 0.5), "너무 넓은 N(0,2²)": stats.norm.cdf(y / 2)}
ends = {k: np.mean((v < 0.1) | (v > 0.9)) for k, v in pit.items()}
print("PIT 가 양 끝 10% 에 떨어지는 비율 (맞으면 0.2):", {k: round(float(v), 3) for k, v in ends.items()})
# 연습 8.5: simulation-based calibration — θ ~ N(0,1), X|θ ~ N(θ,1), 사후 N(X/2, 1/2)
def sbc_ranks(post_var, reps=20_000, L=19):
    th = rng.standard_normal(reps); X_ = th + rng.standard_normal(reps)
    draws = X_[:, None] / 2 + math.sqrt(post_var) * rng.standard_normal((reps, L))
    return (draws < th[:, None]).sum(1)          # 0, …, L
r_ok, r_bad = sbc_ranks(0.5), sbc_ranks(0.25)
chi_ok = pearson_gof(np.bincount(r_ok, minlength=20), np.full(20, 1 / 20))
chi_bad = pearson_gof(np.bincount(r_bad, minlength=20), np.full(20, 1 / 20))
print(f"연습 8.5: 순위의 균등성 X² — 맞는 사후분포 p = {chi_ok[2]:.3f}, 분산을 줄인 사후분포 p = {chi_bad[2]:.1e}")
report({"8.1절: 맞으면 양 끝 비율 ≈ 0.2, 좁으면 커지고(U자) 넓으면 작아진다": abs(ends["맞는 예측 N(0,1)"] - 0.2) < 0.01 and ends["너무 좁은 N(0,0.5²)"] > 0.4 and ends["너무 넓은 N(0,2²)"] < 0.1,
        "연습 8.5: 올바른 사후분포의 순위는 균등 (p > 0.001), 틀리면 강하게 기각": chi_ok[2] > 0.001 and chi_bad[2] < 1e-10})
text
PIT 가 양 끝 10% 에 떨어지는 비율 (맞으면 0.2): {'맞는 예측 N(0,1)': 0.2, '너무 좁은 N(0,0.5²)': 0.522, '너무 넓은 N(0,2²)': 0.011}
연습 8.5: 순위의 균등성 X² — 맞는 사후분포 p = 0.142, 분산을 줄인 사후분포 p = 0.0e+00
  ✓  8.1절: 맞으면 양 끝 비율 ≈ 0.2, 좁으면 커지고(U자) 넓으면 작아진다
  ✓  연습 8.5: 올바른 사후분포의 순위는 균등 (p > 0.001), 틀리면 강하게 기각
python
class SplitConformal:
    """정리 8.2: 아무 예측모형 위에 분포 가정 없는 예측구간을 씌운다"""
    def __init__(self, fit, alpha=0.1):
        self.fit, self.alpha = fit, alpha

    def calibrate(self, x_train, y_train, x_cal, y_cal):
        self.predict = self.fit(x_train, y_train)
        scores = np.sort(np.abs(y_cal - self.predict(x_cal)))
        n = len(scores); k = math.ceil((n + 1) * (1 - self.alpha))
        self.q = scores[k - 1] if k <= n else np.inf
        return self

    def interval(self, x):
        m = self.predict(x)
        return m - self.q, m + self.q

def poly_fit(x, y, deg=3):
    coef = np.polyfit(x, y, deg)
    return lambda t: np.polyval(coef, t)

def make_data(n):
    x = rng.uniform(-3, 3, n)
    return x, np.sin(x) + 0.3 * x + rng.standard_t(3, n) * 0.5     # 꼬리가 두꺼운 잡음, 모형은 틀린 3차식

hits = []
for _ in range(2000):
    xt, yt = make_data(100); xc_, yc_ = make_data(19); xn, yn = make_data(1)
    cp = SplitConformal(poly_fit, alpha=0.1).calibrate(xt, yt, xc_, yc_)
    lo_, hi_ = cp.interval(xn)
    hits.append(lo_[0] <= yn[0] <= hi_[0])
cov_conf = np.mean(hits)
print(f"정리 8.2 · 연습 8.2: n = 19, α = 0.1 — 포함확률 {cov_conf:.3f} (이론 정확히 0.90)")
report({"정리 8.2: 틀린 모형, 두꺼운 꼬리에서도 포함확률 ≈ 0.90 (4 se 안)": within(cov_conf, 0.9, math.sqrt(0.09 / 2000))})
text
정리 8.2 · 연습 8.2: n = 19, α = 0.1 — 포함확률 0.894 (이론 정확히 0.90)
  ✓  정리 8.2: 틀린 모형, 두꺼운 꼬리에서도 포함확률 ≈ 0.90 (4 se 안)
python
# 명제 8.3 · 8.3절의 상자 · 연습 8.3–8.4: Bonferroni 와 Benjamini–Hochberg
def bonferroni(p, alpha):
    return np.asarray(p) <= alpha / len(p)

def benjamini_hochberg(p, q):
    p = np.asarray(p); m = len(p); order = np.argsort(p)
    passed = np.nonzero(p[order] <= np.arange(1, m + 1) / m * q)[0]
    reject = np.zeros(m, bool)
    if len(passed):
        reject[order[: passed.max() + 1]] = True
    return reject

p10 = np.array([0.001, 0.004, 0.009, 0.02, 0.03, 0.04, 0.2, 0.4, 0.6, 0.9])
# 1,000개의 검정 중 100개에 효과 (z 의 평균 3) — 반복해서 평균 발견 수와 거짓 발견율
g = np.random.default_rng(1995)
res = []
for _ in range(200):
    zz = np.concatenate([g.standard_normal(900), g.normal(3, 1, 100)])
    pv = stats.norm.sf(zz); truth = np.r_[np.zeros(900, bool), np.ones(100, bool)]
    bh, bf = benjamini_hochberg(pv, 0.1), bonferroni(pv, 0.1)
    res.append(dict(bh=bh.sum(), bf=bf.sum(), fdr_bh=(bh & ~truth).sum() / max(bh.sum(), 1), fwer_bf=(bf & ~truth).any()))
res = pd.DataFrame(res)
print(f"평균 발견: BH {res.bh.mean():.1f}, Bonferroni {res.bf.mean():.1f};  BH 의 거짓 발견율 {res.fdr_bh.mean():.3f} (상한 q·m0/m = 0.09);  Bonferroni 의 가족별 오류율 {res.fwer_bf.mean():.3f}")
report({"연습 8.4: BH 는 4개, Bonferroni 는 2개를 기각": benjamini_hochberg(p10, 0.05).sum() == 4 and bonferroni(p10, 0.05).sum() == 2,
        "연습 8.3: 독립이면 1 − (1 − 0.05/20)^20 = 0.0488": abs(1 - (1 - 0.05 / 20) ** 20 - 0.0488) < 1e-4,
        "8.3절: BH 가 Bonferroni 보다 훨씬 많이 찾는다 (평균 79 vs 24)": abs(res.bh.mean() - 79) < 2 and abs(res.bf.mean() - 24) < 2,
        "8.3절의 상자: BH 의 거짓 발견율 ≤ 0.09 (+ 오차), Bonferroni 의 가족별 오류율 ≤ 0.1": res.fdr_bh.mean() < 0.09 + 0.01 and res.fwer_bf.mean() <= 0.1 + 0.03})
text
평균 발견: BH 79.3, Bonferroni 23.5;  BH 의 거짓 발견율 0.092 (상한 q·m0/m = 0.09);  Bonferroni 의 가족별 오류율 0.070
  ✓  연습 8.4: BH 는 4개, Bonferroni 는 2개를 기각
  ✓  연습 8.3: 독립이면 1 − (1 − 0.05/20)^20 = 0.0488
  ✓  8.3절: BH 가 Bonferroni 보다 훨씬 많이 찾는다 (평균 79 vs 24)
  ✓  8.3절의 상자: BH 의 거짓 발견율 ≤ 0.09 (+ 오차), Bonferroni 의 가족별 오류율 ≤ 0.1
📝 연습 8.1–8.5 (강의노트): PIT 히스토그램, 등각 구간의 위쪽 한계, Bonferroni와 독립, BH를 손으로, 순위의 균등성.
9. 정리 · 연습문제 지도 · 다음 회
| 내용 | 확인한 셀 | |
|---|---|---|
| 순서통계량 (1.2–1.6) | order_pdf, 표본중앙값의 점근분산, TankEstimator |
1절 |
| 신뢰구간 (2.2–2.6) | 지수 평균의 축량, 오즈비, 분포에 무관한 중앙값 구간, 100개의 구간 | 2절 |
| 검정 (3.3–3.6) | 이항 검정의 검정력, 검정의 표본 크기, 검정을 뒤집은 Wilson 구간 | 3절 |
| -값 (4.2) | 연속·이산에서의 균등성, 검정력과 -값의 분포, Fisher의 결합 | 4절 |
| (5.1–5.2) | pearson_gof, pearson_independence, Fisher의 자유도 판정, Poisson 분산 검정 |
5절 |
| 데이터 (6.1–6.3) | Arbuthnot, Weldon(단순·복합), Quetelet(44인치 칸), Berkeley(Simpson) | 6절 |
| 부숴보기 (7) | 20번의 검정, 선택적 멈춤, Wald의 실패, Monte Carlo 검정 | 7절 |
| 오늘 (8.1–8.3) | PIT·SBC, SplitConformal, Bonferroni와 BH |
8절 |
연습문제 지도 (강의노트, ★ 계산 · ★★ 증명 · ★★★ 도전, 풀이는 부록 A)
| 절 | 연습 | 이 노트북에서 확인하는 셀 |
|---|---|---|
| 1 순서통계량 | 1.1 ★ · 1.2 간격 ★★ · 1.3 ★ · 1.4 전차의 분산 ★★★ · 1.5 ★★ · 1.6 번째 순서통계량의 밀도 ★★ (유도형) | 1절 |
| 2 신뢰구간 | 2.1 해석 ★ · 2.2 ★★ · 2.3 ★ · 2.4 ★★ · 2.5 축량 방법 ★ · 2.6 대표본 구간 ★★ · 2.7 중앙값 구간 ★ (유도형) | 2절 |
| 3 검정 | 3.1 ★ · 3.2 ★ · 3.3 ★ · 3.4 Wilson ★★ · 3.5 ★★ · 3.6 검정의 검정력 ★ (유도형) | 3절 |
| 4 -값 | 4.1 ★ · 4.2 ★★ · 4.3 ★★ · 4.4 Fisher ★★ | 4절 |
| 5 | 5.1 ★ · 5.2 ★ · 5.3 ★★ · 5.4 분산 검정 ★★ · 5.5 ★ | 5절 |
| 6 데이터 | 6.1 Lexis ★★ · 6.2 ★ · 6.3 Quetelet ★★ · 6.4 MH ★★ | 6절 |
| 7 부숴보기 | 7.1 ★ · 7.2 ★★ · 7.3 ★★ · 7.4 Monte Carlo 검정 ★★ | 7절 |
| 8 오늘 | 8.1 ★ · 8.2 등각 ★★★ · 8.3 ★ · 8.4 BH ★★ · 8.5 SBC ★★ · 8.6 교환가능한 순위 ★★ (유도형) | 8절 |
다음 회 (9회) — 최대가능도의 긴 이야기 (1778 → 1951). 이번 회차는 추정량을 그때그때 골랐다(최댓값, 중앙값, 표본비율). 5절의 Fisher의 자유도에도 "최대가능도로 추정하면"이라는 조건이 붙어 있었다. 9회는 Daniel Bernoulli(1778)의 질문에서 출발해 가능도함수, 최대가능도 추정량, Fisher 정보와 Cramér–Rao 한계, 그리고 가능도비 검정(Wilks)을 증명한다. 7회의 델타 방법과 중심극한정리가 최대가능도 추정량의 점근정규성이 된다.
10. 워크북 검산
워크북(08_inference_workbook.pdf)의 문제는 손으로 먼저 푼다. 이 절은 다 푼 뒤에 쓴다.
check("A1a", "1/3")— 문항 번호와 손으로 구한 답을 넣으면 맞는지만 알려 준다. 정답은 보여 주지 않는다. 답은 수(3/8,0.375)나 식의 문자열("(n-1)/(n+1)")로 넣는다. 소문항은"A1a"처럼 번호 뒤에 붙인다. 분위수를 표에서 읽어 소수로 넣으면 상대오차 0.1%까지 맞다고 본다.- 시뮬레이션으로 한 번 더 — 확률이 답인 문항은 아래에 시뮬레이션 함수를 정의해 두었다. 손으로 구한 값이 Monte Carlo 구간 안에 드는지 본다. 함수는 정의만 해 두었고 부르지 않았다. 답을 구하기 전에 부르면 답이 보인다.
증명 문제(B, C의 대부분)는 check()가 없다. 풀이판의 증명과 단계별로 맞춰 본다.
답 열쇠 셀 (내려받은 노트북에서 실행된다)
답 열쇠를 압축해 넣은 check() 정의 셀이다. 웹에서는 이 회차의 답 확인 페이지를 쓴다.
python
check()                 # 확인할 수 있는 문항 번호
check("A1a")            # 답을 넣지 않으면 쓰는 법을 알려 준다
text
확인할 수 있는 문항: A1a A1b A2a A2b A3a A3b A4a A4b A5a A5b A6 A7a A7b A8 A9a A9b A10 A11 A12a A12b A13a A13b A14a A14b A15 C1d C2d C5d C8b C9d C9e D1d D2a D2b D2c D3b D3c D3d D3e D4a D4b D4c D4d
A1a: 아직 답을 넣지 않았다. 예: check('A1a', '3/8')
10.1 내 답을 모아 확인하기
푼 문항의 답을 아래 사전에 채우고 실행한다. None인 문항은 건너뛴다.
python
mine = {
    "A1a": None, "A1b": None, "A2a": None, "A2b": None, "A3a": None, "A3b": None,
    "A4a": None, "A4b": None, "A5a": None, "A5b": None, "A6": None, "A7a": None, "A7b": None,
    "A8": None, "A9a": None, "A9b": None, "A10": None, "A11": None, "A12a": None, "A12b": None,
    "A13a": None, "A13b": None, "A14a": None, "A14b": None, "A15": None,
    "C1d": None, "C2d": None, "C5d": None, "C8b": None, "C9d": None, "C9e": None,
    "D1d": None, "D2a": None, "D2b": None, "D2c": None,
    "D3b": None, "D3c": None, "D3d": None, "D3e": None,
    "D4a": None, "D4b": None, "D4c": None, "D4d": None,
}
check_all(mine)
text
0/0 맞음10.2 시뮬레이션 함수
각 함수는 (추정값, 표준오차)를 돌려준다. 손으로 구한 값이 추정값 ± 3 × 표준오차 안에 들면 계산이 맞을 가능성이 높다. 정확한 검산은 check()가 한다.
| 함수 | 문항 | 시뮬레이션 |
|---|---|---|
sim_A1b() |
A1(b) 둘째 순서통계량 | 균등 표본 5개 |
sim_A4b() |
A4(b) 전차의 최댓값 | 1–100에서 비복원 4개 |
sim_A8() |
A8 중앙값 구간 | 정규 표본 15개 |
sim_A9b() |
A9(b) 이항 검정의 검정력 | |
sim_A11() |
A11 검정의 검정력 | 정규 표본 25개 |
sim_C2d() |
C2(d) 최댓값의 꼬리 | 균등 표본 50개 |
sim_C5d() |
C5(d) 양쪽 검정의 검정력 | 정규 표본 25개 |
sim_D2b() |
D2(d) 지수 검정의 검정력 | 지수 표본 10개 |
sim_D3e() |
D3(e) 중앙값 구간의 신뢰계수 | 지수 표본 100개 |
python
def _mc(hits):
    """불리언 배열 → (상대도수, 표준오차)"""
    hits = np.asarray(hits, dtype=bool)
    p = hits.mean()
    return p, math.sqrt(p * (1 - p) / hits.size)


def sim_A1b(n_rep=N_SIM):
    U = np.sort(rng.random((n_rep, 5)), axis=1)
    return _mc(U[:, 1] <= 0.5)


def sim_A4b(n_rep=N_SIM):
    """1–100에서 비복원 4개: 복원으로 뽑고 같은 번호가 나온 행은 버린다"""
    draws = rng.integers(1, 101, size=(int(n_rep * 1.1), 4))
    s = np.sort(draws, axis=1)
    distinct = (np.diff(s, axis=1) > 0).all(axis=1)
    return _mc(s[distinct][:n_rep, -1] <= 50)


def sim_A8(n_rep=N_SIM):
    X = np.sort(rng.standard_normal((n_rep, 15)), axis=1)
    return _mc((X[:, 3] < 0) & (0 < X[:, 11]))


def sim_A9b(n_rep=N_SIM):
    return _mc(rng.binomial(20, 0.7, size=n_rep) >= 15)


def sim_A11(n_rep=N_SIM):
    xbar = rng.normal(105, 10 / 5, size=n_rep)
    return _mc(xbar >= 100 + stats.norm.isf(0.05) * 10 / 5)


def sim_C2d(n_rep=N_SIM):
    M = rng.random((n_rep, 50)).max(axis=1)
    return _mc(50 * (1 - M) > 1)


def sim_C5d(n_rep=N_SIM):
    xbar = rng.normal(5, 10 / 5, size=n_rep)          # μ − μ₀ = 5, σ/√n = 2
    return _mc(np.abs(xbar) >= stats.norm.isf(0.025) * 2)


def sim_D2b(n_rep=N_SIM):
    S = rng.exponential(500, size=(n_rep, 10)).sum(axis=1)
    return _mc(2 * S / 1000 <= stats.chi2.ppf(0.05, 20))


def sim_D3e(n_rep=40_000):
    X = np.sort(rng.exponential(1.0, size=(n_rep, 100)), axis=1)
    m = math.log(2)
    return _mc((X[:, 39] < m) & (m < X[:, 60]))
python
# 자체 검사 (출력 없음): 시뮬레이션이 답 열쇠와 맞는지, check()가 답 열쇠의 값과 그 소수를 맞다고 하는지 확인한다.
def _close(sim, key, z=4.0, **pt):
    est, se = sim
    return abs(est - _value(key, **pt)) <= z * se + 1e-12

assert _close(sim_A1b(), "A1b")
assert _close(sim_A4b(), "A4b")
assert _close(sim_A8(), "A8")
assert _close(sim_A9b(), "A9b")
assert _close(sim_A11(), "A11")
assert _close(sim_C2d(), "C2d")
assert _close(sim_C5d(), "C5d")
assert _close(sim_D2b(), "D2b")
assert _close(sim_D3e(), "D3e")
for _k, _e in _WB.items():
    assert _same(_e, _e["value"])
    if not _e.get("vars") and "points" not in _e:
        assert _same(_e, float(sp.sympify(_e["value"])))