
테마
8회 · 추론의 기초 · 노트
7 부숴보기 — 원하는 결과가 나올 때까지
정리 4.2는 미리 정한 하나의 검정에 대한 정리다. 검정을 여러 번 하거나, 결과를 보면서 언제 멈출지 정하거나, 근사가 맞지 않는 곳에서 쓰면 “5%”는 5%가 아니다.
7.1 스무 번 검정하면
귀무가설이 모두 참인 독립 검정 20개를 각각 5%로 하면, 하나라도 유의할 확률은 이다. 연구자가 그 하나만 보고하면 독자는 “5%”의 증거를 본다. 결과 변수를 바꿔 보기, 이상값을 빼 보기, 공변량을 넣어 보기 같은 흔한 선택들을 합친 시뮬레이션에서 거짓 양성의 비율은 60%를 넘었다(Simmons, Nelson, Simonsohn 2011). 이것을 -해킹이라 한다. 검정 하나하나는 옳지만, 검정을 고르는 과정이 정리의 가정(“미리 정한”)을 깬다.
7.2 결과를 보며 멈추기
예제 7.1 (선택적 멈춤) (가 참)을 10개씩 모으며 매번 을 보고, 이면 “유의”로 멈춘다. 최대 1,000개까지 모으면 거짓 양성의 확률은 0.37이다(노트북). 멈출 기회가 무한하면 그 확률은 1이다.
증명 없이 쓰는 사실 (반복 로그의 법칙) iid, 평균 0, 분산 1이면 확률 1로 다음이 성립한다(Khinchin 1924, Kolmogorov 1929).
은 아주 느리지만 끝없이 자라므로 은 언젠가 반드시 1.96을 넘는다.
7회의 Lazzarini(1901)가 이 함정의 고전적인 예다. “355/113이 나오면 멈춘다”는 규칙 아래에서 보고된 값의 오차를 미리 정한 의 표준오차로 말하는 것은 틀렸다(7회 연습 4.4). 결과를 보면서 멈추려면 처음부터 그것을 허용하도록 만든 순차 검정(Wald 1945)이나 기준을 쓴다.
7.3 비율의 Wald 구간
예제 7.2 (명목 95%가 22%) 의 실제 포함확률은 이항분포의 합으로 정확히 계산된다(). 이면 에서 , 에서 , 에서 이다. 가 작으면 이 자주 나오고, 그때 구간은 폭이 0인 이 되어 참값을 놓친다. 더 놀라운 것은 가 크지 않아도 에 따라 들쭉날쭉하다는 것이다. 에서 이면 0.79다(Brown, Cai, DasGupta 2001). 같은 자료로 만든 Wilson 구간(예제 3.6)은 대부분의 에서 0.95 근처다.
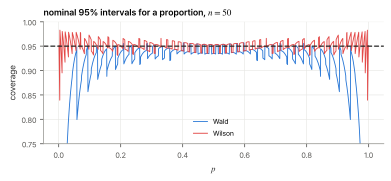
대표본 정리(정리 2.4)는 에서의 말이다. 은 큰가? 가 작으면 아니다. 정리가 말해 주지 않는 것은 얼마나 커야 하는가이고, 그것은 계산해 보아야 안다.
7.4 기대도수가 작은
칸 10개에 확률이 같고 (기대도수 모두 2)이면 5% 검정의 실제 크기는 0.051로 근사가 놀라울 만큼 잘 맞는다. 그러나 칸 6개 중 다섯이 기대도수 0.6이고 하나가 27이면 크기가 0.11로 두 배다. 작은 기대도수로 나누는 항이 드물게 크게 튀기 때문이다. 이럴 때는 칸을 합치거나, 귀무가설 아래에서 자료를 시뮬레이션해 의 분포를 직접 만든다(Monte Carlo 검정). 시뮬레이션한 개의 통계량 가운데 관측값 이상인 것의 수를 이라 하면 은 정확히 타당한 -값이다(연습 7.4, 8.2절의 순위 논증).
연습문제
연습 7.1 (스무 번의 검정 ★) 독립 검정 개를 각각 로 할 때 하나라도 거짓 양성이 나올 확률을 구하고, 이것을 0.05 이하로 하려면 각 검정의 를 얼마로 해야 하는가? ()
풀이
. 에서 이하로 하려면 (Šidák). Bonferroni의 와 거의 같다.
연습 7.2 (선택적 멈춤 ★★) 예제 7.1을 노트북에서 최대 표본 크기 100, 1,000, 10,000으로 되풀이하라. 거짓 양성의 확률은 어떻게 자라는가?
풀이
10개마다 들여다보며 최대 100, 1,000, 10,000개까지 모으면 거짓 양성의 확률은 0.19, 0.37, 0.53이다. 들여다보는 횟수의 로그에 대략 비례해 자라고, 반복 로그의 법칙으로 결국 1이 된다.
연습 7.3 (정확한 포함확률 ★★) Wald 구간의 포함확률을 이항 확률의 합으로 쓰고, 가 작으면 포함확률이 거의 임을 설명하라. (이면 구간이 이어서 놓치고, 이면 작은 를 대개 포함한다.) , 에서 계산해 0.22와 비교하라.
풀이
포함확률은 이다. 가 작으면 는 대개 0, 1, 2다. 이면 구간이 이어서 놓치고, 이면 구간의 위쪽 끝 이 작은 보다 크고 아래쪽 끝은 0 근처이므로 대개 포함한다. 그래서 포함확률은 근처다. , 이면 로 정확한 값 0.22와 같다.
연습 7.4 (Monte Carlo 검정 ★★) 아래에서 관측 통계량 와 시뮬레이션한 가 iid이고 연속이면, 의 순위가 위에서 균등함을 보이고 를 결론지어라.
풀이
가 iid 연속이면 교환가능하므로 보조정리 8.1로 의 위에서부터의 순위 ( = 보다 큰 의 수)은 에서 균등하다. .