Skip to content

7회 · 극한의 언어 · 노트

4 Slutsky의 정리와 델타 방법 ​

중심극한정리의 ZnZ_n에는 모르는 σ\sigma가 들어 있다. 실제로 쓰는 것은 σ\sigma 대신 SS를 넣은 것이고, 관심 있는 양도 Xˉ\bar X 자체보다 그 함수(비율의 로그, π\pi의 추정값)인 경우가 많다. 이 절의 두 정리가 그 간격을 메운다.

4.1 Slutsky의 정리 (1925) ​

보조정리 4.1 (확률적으로 무시할 수 있는 항) Yn→DYY_n\xrightarrow{D}Y이고 Rn→P0R_n\xrightarrow{P}0이면 Yn+Rn→DYY_n+R_n\xrightarrow{D}Y.

증명 전략 정리 2.3(a)의 증명과 같은 끼우기다. ∣Rn∣<ε|R_n|<\varepsilon인 사건 위에서 Yn+RnY_n+R_n을 Yn±εY_n\pm\varepsilon 사이에 둔다. 다른 점은 x±εx\pm\varepsilon이 YY의 연속점이 되게 ε\varepsilon을 골라야 한다는 것이다. 단계별 증명은 연습 4.7(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

정리 4.2 (Slutsky의 정리) Xn→DXX_n\xrightarrow{D}X, An→PaA_n\xrightarrow{P}a, Bn→PbB_n\xrightarrow{P}b (a,ba,b는 상수)이면

An+BnXn →D a+bX.A_n+B_nX_n\ \xrightarrow{D}\ a+bX .

증명 전략 확률변수인 계수 AnA_n, BnB_n을 극한의 상수 aa, bb로 바꾸고, 바꾸면서 생긴 차이 RnR_n이 확률적으로 0임을 보인다. 그러면 남는 것은 상수 계수의 아핀변환 a+bXna+bX_n이다.

  1. An+BnXn=(a+bXn)+RnA_n+B_nX_n=(a+bX_n)+R_n, Rn=(An−a)+(Bn−b)XnR_n=(A_n-a)+(B_n-b)X_n으로 쓴다.더하고 빼기 [T4]

  2. Xn→DXX_n\xrightarrow{D}X이므로 {Xn}\{X_n\}은 확률적으로 유계이고, Bn−b→P0B_n-b\xrightarrow{P}0이므로 (Bn−b)Xn→P0(B_n-b)X_n\xrightarrow{P}0이다.정리 2.5

  3. An−a→P0A_n-a\xrightarrow{P}0과 2를 더하면 Rn→P0R_n\xrightarrow{P}0이다.따름정리 1.4

  4. b>0b>0이면 P(a+bXn≤x)=Fn(x−ab)P(a+bX_n\le x)=F_n\bigl(\tfrac{x-a}b\bigr)이고, xx가 a+bXa+bX의 연속점인 것과 x−ab\tfrac{x-a}b가 XX의 연속점인 것이 같으므로 a+bXn→Da+bXa+bX_n\xrightarrow{D}a+bX이다.정의 2.1

  5. b<0b<0이면 P(a+bXn≤x)=1−P(Xn<y)P(a+bX_n\le x)=1-P(X_n<y), y=x−aby=\tfrac{x-a}b이다. yy가 연속점이면 P(Xn<y)P(X_n<y)를 Fn(y−δ)F_n(y-\delta)와 Fn(y)F_n(y) 사이에 끼워 F(y)F(y)로 보내므로 같은 결론이 나온다. b=0b=0이면 a+bXn=aa+bX_n=a는 상수다.연습 2.4의 끼우기

  6. 3 4 5에 보조정리 4.1을 쓰면 An+BnXn→Da+bXA_n+B_nX_n\xrightarrow{D}a+bX이다.보조정리 4.1

Slutsky 러시아의 경제학자이자 통계학자 Evgeny Slutsky는 1925년 Metron에 실은 논문에서 확률변수의 극한을 체계적으로 다뤘다. 2년 뒤(1927) 그는 무작위 충격의 이동평균이 경기순환처럼 보이는 주기를 만든다는 논문도 썼다(Slutsky 효과). 그의 정리는 Cramér의 교과서(1946)를 통해 통계학의 기본 도구가 되었다.

따름정리 4.3 (스튜던트화한 평균) X1,X2,…X_1,X_2,\dots가 iid이고 0<σ2<∞0<\sigma^2<\infty이면

Xˉn−μSn/n →D N(0,1).\frac{\bar X_n-\mu}{S_n/\sqrt n}\ \xrightarrow{D}\ \N(0,1).

따라서 Xˉn±zα/2Sn/n\bar X_n\pm z_{\alpha/2}S_n/\sqrt n과 tt-구간 Xˉn±tn−1,α/2Sn/n\bar X_n\pm t_{n-1,\alpha/2}S_n/\sqrt n은 모집단의 분포와 상관없이 포함확률이 1−α1-\alpha로 간다.

증명 Xˉn−μSn/n=σSn⋅Zn\tfrac{\bar X_n-\mu}{S_n/\sqrt n}=\tfrac\sigma{S_n}\cdot Z_n이다. 중심극한정리(3.3절의 상자 (1))로 Zn→DN(0,1)Z_n\xrightarrow{D}\N(0,1)이고, 따름정리 1.7와 정리 1.3로 σ/Sn→P1\sigma/S_n\xrightarrow{P}1. Slutsky(a=0a=0, Bn=σ/SnB_n=\sigma/S_n). tt-구간은 tn−1,α/2→zα/2t_{n-1,\alpha/2}\to z_{\alpha/2}(6회 정리 3.3(d))를 더한다.

19세기의 천문학자들이 σ\sigma 자리에 ss를 넣고 정규분포를 쓴 관행(6회 1절)이 이것으로 정당화된다. 단, “n→∞n\to\infty에서”다. 지수 모집단이면 1.96을 쓴 구간의 포함확률이 n=30n=30에서 0.919, 200200에서 0.945, 10001000에서 0.948이다. 6회는 작은 nn의 정확한 답을, 이 따름정리는 큰 nn의 근사적 답을 준다.

4.2 델타 방법 ​

정리 4.4 (델타 방법) n(Yn−θ)→DN(0,σ2)\sqrt n(Y_n-\theta)\xrightarrow{D}\N(0,\allowbreak \sigma^2)이고 gg가 θ\theta에서 미분가능하면

n(g(Yn)−g(θ)) →D N(0, g′(θ)2σ2).\sqrt n\bigl(g(Y_n)-g(\theta)\bigr)\ \xrightarrow{D}\ \N\bigl(0,\ g'(\theta)^2\sigma^2\bigr).

증명 전략 차분몫 h(y)=g(y)−g(θ)y−θh(y)=\tfrac{g(y)-g(\theta)}{y-\theta}을 확률변수 계수로 보면 n(g(Yn)−g(θ))\sqrt n(g(Y_n)-g(\theta))는 h(Yn)⋅n(Yn−θ)h(Y_n)\cdot\sqrt n(Y_n-\theta)이다. 계수가 g′(θ)g'(\theta)로 확률수렴함을 보이고 Slutsky를 쓴다.

  1. h(y)=g(y)−g(θ)y−θh(y)=\tfrac{g(y)-g(\theta)}{y-\theta} (y≠θy\ne\theta), h(θ)=g′(θ)h(\theta)=g'(\theta)로 두면 hh는 θ\theta에서 연속이다.미분의 정의 [T5]

  2. n(Yn−θ)\sqrt n(Y_n-\theta)는 확률적으로 유계이고 1n→0\tfrac1{\sqrt n}\to0이므로 Yn−θ=1n⋅n(Yn−θ)→P0Y_n-\theta=\tfrac1{\sqrt n}\cdot\sqrt n(Y_n-\theta)\xrightarrow{P}0이다.정리 2.5

  3. h(Yn)→Ph(θ)=g′(θ)h(Y_n)\xrightarrow{P}h(\theta)=g'(\theta)이다.1 2, 정리 1.3(a)

  4. 모든 yy에서 g(y)−g(θ)=h(y)(y−θ)g(y)-g(\theta)=h(y)(y-\theta)이므로(양변이 y=θy=\theta에서 0)

    n(g(Yn)−g(θ))=h(Yn)⋅n(Yn−θ).\sqrt n\bigl(g(Y_n)-g(\theta)\bigr)=h(Y_n)\cdot\sqrt n(Y_n-\theta) .
    1
  5. An=0A_n=0, Bn=h(Yn)B_n=h(Y_n), b=g′(θ)b=g'(\theta)로 Slutsky를 쓰면 극한은 g′(θ)⋅N(0,σ2)=N(0,g′(θ)2σ2)g'(\theta)\cdot\N(0,\allowbreak \sigma^2)=\N(0,\allowbreak g'(\theta)^2\sigma^2)이다.정리 4.2, 5회 정리 3.8

이름은 g(Yn)−g(θ)≈g′(θ)(Yn−θ)g(Y_n)-g(\theta)\approx g'(\theta)(Y_n-\theta), 곧 작은 변화 Δ\Delta의 선형 근사에서 왔다. 표준오차의 언어로 쓰면 se(g(Y))≈∣g′(θ)∣ se(Y)\mathrm{se}\bigl(g(Y)\bigr)\approx|g'(\theta)|\,\mathrm{se}(Y)이다. g′(θ)=0g'(\theta)=0이면 극한이 0으로 퇴화하고 한 단계 더 전개해야 한다(연습 4.2).

예제 4.5 (로그 오즈) 성공 비율 p^\hat p에 대해 n(p^−p)→DN(0,pq)\sqrt n(\hat p-p)\xrightarrow{D}\N(0,\allowbreak pq)이고 g(p)=log⁡p1−pg(p)=\log\tfrac p{1-p}이면 g′(p)=1pqg'(p)=\tfrac1{pq}이므로

n(log⁡p^1−p^−log⁡p1−p)→DN(0,1pq).\sqrt n\Bigl(\log\frac{\hat p}{1-\hat p}-\log\frac p{1-p}\Bigr)\xrightarrow{D}\N\Bigl(0,\frac1{pq}\Bigr).

p=0.2p=0.2, n=50n=50이면 근사 분산은 1npq=0.125\tfrac1{npq}=0.125이고 시뮬레이션은 0.143이다(p^=0\hat p=0인 경우는 1.4×10−51.4\times10^{-5}로 무시했다). 로그 오즈는 (−∞,∞)(-\infty,\infty)에서 움직이므로 [0,1][0,1]에 갇힌 p^\hat p보다 정규근사가 자연스럽고, 로지스틱 회귀(13회)와 오즈비의 구간(8회)이 이 척도를 쓴다.

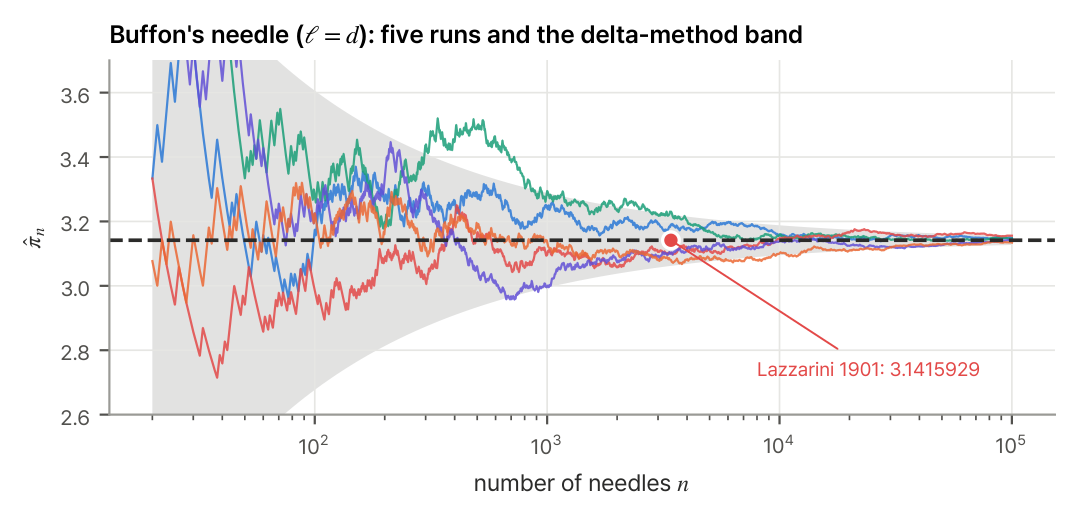
예제 4.6 (Buffon의 π\pi는 얼마나 정확한가) ℓ=d\ell=d이면 p=2πp=\tfrac2\pi, π^n=g(p^n)\hat\pi_n=g(\hat p_n), g(x)=2xg(x)=\tfrac2x이다. g′(p)=−2p2g'(p)=-\tfrac2{p^2}이므로

n(π^n−π)→DN(0, 4p4 p(1−p)),sd(π^n)≈2.37n.\sqrt n(\hat\pi_n-\pi)\xrightarrow{D}\N\Bigl(0,\ \frac4{p^4}\,p(1-p)\Bigr),\qquad\mathrm{sd}(\hat\pi_n)\approx\frac{2.37}{\sqrt n}.

n=1000n=1000이면 0.075(시뮬레이션 0.075)다. 소수 셋째 자리까지 맞히려면(sd≈0.0005\mathrm{sd}\approx0.0005) n≈(2.37/0.0005)2≈2.2×107n\approx(2.37/0.0005)^2\approx2.2\times10^7번을 던져야 한다. 1/n1/\sqrt n의 정확도는 느리다.

그림 4.1. 바늘 던지기 다섯 번의 실행에서 hatπ_n의 경로(색 선)와 델타 방법의 π±1.96·2.37/√n 띠(회색). 경로는 띠 안에서 1/√n의 속도로 좁아진다. 빨간 점은 Lazzarini(1901)가 보고한 n=3408의 값으로, 띠의 폭에 비해 믿을 수 없을 만큼 π에 가깝다.
그림 4.1 바늘 던지기 다섯 번의 실행에서 π^n\hat\pi_n의 경로(색 선)와 델타 방법의 π±1.96⋅2.37/n\pi\pm1.96\cdot2.37/\sqrt n 띠(회색). 경로는 띠 안에서 1/n1/\sqrt n의 속도로 좁아진다. 빨간 점은 Lazzarini(1901)가 보고한 n=3408n=3408의 값으로, 띠의 폭에 비해 믿을 수 없을 만큼 π\pi에 가깝다.

가정 주의 이탈리아의 Lazzarini는 1901년 길이 2.5cm의 바늘을 3cm 간격의 선 위에 3,408번 던져 1,808번 걸쳤다고 보고했다. ℓ/d=56\ell/d=\tfrac56이므로 π^=2⋅(5/6)⋅34081808=3.1415929\hat\pi=\tfrac{2\cdot(5/6)\cdot3408}{1808}=3.1415929, 오차 2.7×10−72.7\times10^{-7}이다. 그런데 델타 방법의 표준편차는 0.051이다. 오차가 표준편차의 19만분의 1이다. 더 이상한 점이 있다. 355113=3.1415929\tfrac{355}{113}=3.1415929는 유명한 근삿값이고, n=3408=16⋅213n=3408=16\cdot213, K=1808=16⋅113K=1808=16\cdot113일 때만 정확히 나온다. 이 nn에서 기대 교차 수는 1808.01808.0이고 P(K=1808)=0.014P(K=1808)=0.014다. 이 노트의 연습 4.4은 “355/113이 나올 때까지 던지고 멈춘다”면 무슨 일이 생기는지 묻는다. Gridgeman(1960)과 Badger(1994)는 이 실험이 원하는 답에 맞춰 멈췄거나 꾸며졌다고 결론지었다. 좋은 추정은 오차의 크기와 함께 보고되고, 오차보다 지나치게 좋은 결과는 의심해야 한다.

예제 4.7 (분산 안정화) p^\hat p의 분산 pqn\tfrac{pq}n은 pp에 의존한다. gg를 g′(p)2pqg'(p)^2pq가 상수가 되게 고르면 g(p^)g(\hat p)의 분산은 pp와 상관없다. g′(p)=12pqg'(p)=\tfrac1{2\sqrt{pq}}를 적분하면 g(p)=arcsin⁡pg(p)=\arcsin\sqrt p이고, Var⁡arcsin⁡p^≈14n\Var\arcsin\sqrt{\hat p}\approx\tfrac1{4n}이다. n=100n=100에서 4nVar⁡4n\Var를 시뮬레이션하면 p=0.05, 0.2, 0.5p=0.05,\,0.2,\,0.5에서 1.14, 1.02, 1.01이다. 같은 방법으로 Poisson은 X\sqrt X의 분산이 14\tfrac14로 안정된다(λ=2,10,100\lambda=2,10,100에서 0.39, 0.26, 0.25). 분산이 평균에 따라 변하는 자료를 회귀(13회)나 분산분석(14회)에 넣기 전의 표준적인 변환이다.

연습문제

연습 4.1 (로그 평균 ★) Xi∼iidExp(1)X_i\iid\mathrm{Exp}(1)이면 nlog⁡Xˉn→DN(0,1)\sqrt n\log\bar X_n\xrightarrow{D}\N(0,\allowbreak 1)임을 보여라.

풀이

n(Xˉn−1)→DN(0,1)\sqrt n(\bar X_n-1)\xrightarrow{D}\N(0,\allowbreak 1)이고 g=log⁡g=\log, g′(1)=1g'(1)=1. n(log⁡Xˉn−log⁡1)→DN(0,1)\sqrt n(\log\bar X_n-\log1)\xrightarrow{D}\N(0,\allowbreak 1).

연습 4.2 (2차 델타 방법 ★★) n(Yn−θ)→DN(0,σ2)\sqrt n(Y_n-\theta)\xrightarrow{D}\N(0,\allowbreak \sigma^2)이고 g′(θ)=0g'(\theta)=0, g′′g''가 θ\theta 근처에서 연속이면 n(g(Yn)−g(θ))→D12g′′(θ)σ2χ2(1)n\bigl(g(Y_n)-g(\theta)\bigr)\xrightarrow{D}\tfrac12g''(\theta)\sigma^2\chi^2(1)임을 보여라(연습 2.4 사용). 예: μ=0\mu=0이면 nXˉn2→Dσ2χ2(1)n\bar X_n^2\xrightarrow{D}\sigma^2\chi^2(1).

풀이

테일러 정리로 g(Yn)−g(θ)=12g′′(ξn)(Yn−θ)2g(Y_n)-g(\theta)=\tfrac12g''(\xi_n)(Y_n-\theta)^2 (ξn\xi_n은 YnY_n과 θ\theta 사이). ξn→Pθ\xi_n\xrightarrow{P}\theta이고 g′′g''가 연속이므로 g′′(ξn)→Pg′′(θ)g''(\xi_n)\xrightarrow{P}g''(\theta). n(Yn−θ)2=(n(Yn−θ))2→Dσ2χ2(1)n(Y_n-\theta)^2=\bigl(\sqrt n(Y_n-\theta)\bigr)^2\xrightarrow{D}\sigma^2\chi^2(1)(연습 2.4을 n(Yn−θ)/σ\sqrt n(Y_n-\theta)/\sigma에). Slutsky로 n(g(Yn)−g(θ))→D12g′′(θ)σ2χ2(1)n(g(Y_n)-g(\theta))\xrightarrow{D}\tfrac12g''(\theta)\sigma^2\chi^2(1). g(x)=x2g(x)=x^2, θ=0\theta=0이면 12⋅2=1\tfrac12\cdot2=1.

연습 4.3 (가장 좋은 바늘 ★★) ℓ≤d\ell\le d에서 r=ℓ/dr=\ell/d, p=2rπp=\tfrac{2r}\pi이면 π^n=2rp^n\hat\pi_n=\tfrac{2r}{\hat p_n}의 점근분산이 4r2(1−p)p3=π2(1−p)p\tfrac{4r^2(1-p)}{p^3}=\tfrac{\pi^2(1-p)}{p}임을 보이고, r=1r=1에서 가장 작음을 보여라. Lazzarini의 r=56r=\tfrac56은 r=1r=1보다 표준편차가 몇 배인가?

풀이

g(x)=2rxg(x)=\tfrac{2r}x, g′(p)=−2rp2g'(p)=-\tfrac{2r}{p^2}이므로 점근분산은 4r2p4p(1−p)=4r2(1−p)p3\tfrac{4r^2}{p^4}p(1-p)=\tfrac{4r^2(1-p)}{p^3}. 2r=πp2r=\pi p를 넣으면 π2(1−p)p\tfrac{\pi^2(1-p)}p로, pp에 대해 감소하고 p=2rπp=\tfrac{2r}\pi는 rr에 대해 증가하므로 r=1r=1이 최선이다. r=1r=1: π2⋅0.36340.6366=5.63\pi^2\cdot\tfrac{0.3634}{0.6366}=5.63 (표준편차 2.37/n2.37/\sqrt n), r=56r=\tfrac56: π2⋅0.46950.5305=8.74\pi^2\cdot\tfrac{0.4695}{0.5305}=8.74 (2.96/n2.96/\sqrt n), 1.25배다.

연습 4.4 (원하는 답이 나올 때 멈추기 ★★) r=56r=\tfrac56으로 한 번씩 던지며 nn이 213의 배수이고 Kn/n=113213K_n/n=\tfrac{113}{213}인 순간 멈춘다고 하자. 노트북으로 n≤5000n\le5000 안에 멈출 확률을 시뮬레이션하라. 보고된 π^\hat\pi는 언제나 355/113355/113이다. 이 실험의 오차를 0.0510.051이라고 보고하는 것은 왜 틀렸나?

풀이

시뮬레이션(2만 번)에서 n≤5000n\le5000 안에 멈출 확률은 약 0.34, 멈춘 시점의 중앙값은 n≈1300n\approx1300이다. 세 사람 가운데 한 명은 이 방법으로 소수 여섯째 자리까지 맞는 π\pi를 “얻는다”. 보고된 값은 멈춘 규칙 때문에 언제나 355/113355/113이므로, 그 값의 분포는 고정된 nn의 π^n\hat\pi_n의 분포와 전혀 다르다. 표준오차 0.051은 “미리 정한 nn번 던진다”는 실험의 성질이지 이 실험의 성질이 아니다. 자료를 보면서 멈출 때를 정하면 오차의 계산이 무효가 된다. 8회의 p-해킹과 같은 문제다.

연습 4.5 (두 변환 ★★) (a) g(p)=arcsin⁡pg(p)=\arcsin\sqrt p이면 g′(p)2pq=14g'(p)^2pq=\tfrac14임을 보여라. (b) Xλ∼Poi(λ)X_\lambda\sim\mathrm{Poi}(\lambda)이면 λ⋅Xλ−λλ\sqrt\lambda\cdot\tfrac{X_\lambda-\lambda}\lambda의 극한과 델타 방법으로 2(Xλ−λ)→DN(0,1)2(\sqrt{X_\lambda}-\sqrt\lambda)\xrightarrow{D}\N(0,\allowbreak 1)임을 보여라.

풀이

(a) g′(p)=12p⋅11−pg'(p)=\tfrac1{2\sqrt p}\cdot\tfrac1{\sqrt{1-p}}이므로 g′(p)2pq=14g'(p)^2pq=\tfrac14. (b) 따름정리 3.2(b)로 Xλ−λλ→DN(0,1)\tfrac{X_\lambda-\lambda}{\sqrt\lambda}\xrightarrow{D}\N(0,\allowbreak 1). Xλ−λ=Xλ−λXλ+λ\sqrt{X_\lambda}-\sqrt\lambda=\tfrac{X_\lambda-\lambda}{\sqrt{X_\lambda}+\sqrt\lambda}이고 Xλ+λ2λ→P1\tfrac{\sqrt{X_\lambda}+\sqrt\lambda}{2\sqrt\lambda}\xrightarrow{P}1(같은 따름정리로 Xλ/λ→P1X_\lambda/\lambda\xrightarrow{P}1)이므로 Slutsky로 2(Xλ−λ)→DN(0,1)2(\sqrt{X_\lambda}-\sqrt\lambda)\xrightarrow{D}\N(0,\allowbreak 1).

연습 4.6 (Slutsky의 함정 ★) Xn→DN(0,1)X_n\xrightarrow{D}\N(0,1), Bn→D1B_n\xrightarrow{D}1이면 BnXn→DN(0,1)B_nX_n\xrightarrow{D}\N(0,1)인가? BnB_n이 상수로 분포수렴하면 확률수렴이기도 함(정리 2.3(b))을 써서 답하라.

풀이

그렇다. 상수로의 분포수렴은 확률수렴이므로(정리 2.3(b)) Bn→P1B_n\xrightarrow{P}1이고 Slutsky를 쓸 수 있다. BnB_n의 극한이 상수가 아닌 확률변수이면 결론은 거짓일 수 있다(연습 2.5).

연습 4.7 (무시할 수 있는 항 증명 ★★ 유도형) 보조정리 4.1을 다음 순서로 증명하라. FYF_Y를 YY의 분포함수, xx를 그 연속점이라 하자.

  1. (a)

    {Yn+Rn≤x}⊂{Yn≤x+ε}∪{∣Rn∣≥ε}\{Y_n+R_n\le x\}\subset\{Y_n\le x+\varepsilon\}\cup\{|R_n|\ge\varepsilon\}와 {Yn≤x−ε}⊂{Yn+Rn≤x}∪{∣Rn∣≥ε}\{Y_n\le x-\varepsilon\}\subset\{Y_n+R_n\le x\}\cup\{|R_n|\ge\varepsilon\}를 원소 추적으로 보여라.

  2. (b)

    FYF_Y의 불연속점은 셀 수 있게 많으므로 x±εx\pm\varepsilon이 모두 연속점인 ε\varepsilon을 얼마든지 작게 고를 수 있음을 설명하라.

  3. (c)

    (a)(b)로 FY(x−ε)≤lim inf⁡nP(Yn+Rn≤x)≤lim sup⁡nP(Yn+Rn≤x)≤FY(x+ε)F_Y(x-\varepsilon)\le\liminf_nP(Y_n+R_n\le x)\le\limsup_nP(Y_n+R_n\le x)\le F_Y(x+\varepsilon)을 보여라.

  4. (d)

    ε↓0\varepsilon\downarrow0으로 결론을 내라. 정리 2.3(a)의 증명과 무엇이 같고 무엇이 다른가?

풀이

(a) Yn+Rn≤xY_n+R_n\le x이고 ∣Rn∣<ε|R_n|<\varepsilon이면 Yn≤x−Rn<x+εY_n\le x-R_n<x+\varepsilon이다. 따라서 Yn+Rn≤xY_n+R_n\le x이면 Yn≤x+εY_n\le x+\varepsilon이거나 ∣Rn∣≥ε|R_n|\ge\varepsilon이다. 마찬가지로 Yn≤x−εY_n\le x-\varepsilon이고 ∣Rn∣<ε|R_n|<\varepsilon이면 Yn+Rn<xY_n+R_n<x이다. (b) 불연속점의 집합 DD는 셀 수 있으므로 {ε>0:x+ε∈D 또는 x−ε∈D}\{\varepsilon>0: x+\varepsilon\in D\text{ 또는 }x-\varepsilon\in D\}도 셀 수 있다. 어떤 구간 (0,δ)(0,\delta)도 셀 수 없이 많은 점을 가지므로 그 안에 이 집합에 속하지 않는 ε\varepsilon이 있다. (c) (a)와 Boole 부등식으로 P(Yn≤x−ε)−P(∣Rn∣≥ε)≤P(Yn+Rn≤x)≤P(Yn≤x+ε)+P(∣Rn∣≥ε)P(Y_n\le x-\varepsilon)-P(|R_n|\ge\varepsilon)\le P(Y_n+R_n\le x)\le P(Y_n\le x+\varepsilon)+P(|R_n|\ge\varepsilon)이다. x±εx\pm\varepsilon이 연속점이므로 P(Yn≤x±ε)→FY(x±ε)P(Y_n\le x\pm\varepsilon)\to F_Y(x\pm\varepsilon)이고 P(∣Rn∣≥ε)→0P(|R_n|\ge\varepsilon)\to0이다. (d) xx가 연속점이므로 (b)의 ε\varepsilon을 0으로 보내면 양 끝이 FY(x)F_Y(x)로 간다. 끼우는 방식은 정리 2.3(a)와 같다. 다른 점은 거기서는 극한 F(x±ε)F(x\pm\varepsilon)이 정확한 값이어서 ε\varepsilon을 아무렇게나 골라도 되었지만, 여기서는 P(Yn≤x±ε)P(Y_n\le x\pm\varepsilon)의 극한을 쓰므로 x±εx\pm\varepsilon이 연속점이어야 한다는 것이다.

이 회차에서 읽은 절 0개 · 회차 차례