Skip to content

7회 · 극한의 언어 · 노트

7 부숴보기 — 분산이 무한하고, 꼬리를 물을 때 ​

중심극한정리의 가정은 단 하나, 유한한 분산이다. 이 가정을 깨면 무엇이 남고 무엇이 무너지는가? 그리고 가정이 성립해도 정리가 답하지 않는 질문은 무엇인가?

7.1 평균은 있지만 분산이 없을 때 ​

밀도가 f(x)=αx−(α+1)f(x)=\alpha x^{-(\alpha+1)} (x≥1x\ge1)인 Pareto 분포는 α>k\alpha>k일 때만 kk차 적률이 있다(연습 7.1). α=1.5\alpha=1.5이면 평균 μ=αα−1=3\mu=\tfrac\alpha{\alpha-1}=3은 있고 분산은 무한하다. 소득, 도시의 인구, 파일 크기, 보험 손해처럼 “소수가 전체의 큰 몫을 차지하는” 양이 이런 꼬리를 갖는다.

예제 7.1 (Pareto 표본의 평균) 정리 1.6으로 Xˉn→P3\bar X_n\xrightarrow{P}3이다. 그러나 수렴은 느리고 기묘하다.

P(∣Xˉn−3∣<0.1)P(|\bar X_n-3|<0.1)P(Xˉn<3)P(\bar X_n<3)tt-구간의 포함확률
n=100n=1000.100.710.71
n=1,000n=1{,}000——0.76
n=10,000n=10{,}0000.460.68—

표본평균은 대개 참값보다 작다. 평균의 상당 부분을 드물게 나오는 아주 큰 값이 실어 나르는데, 대부분의 표본에는 그런 값이 없기 때문이다. 그리고 드물게 큰 값이 들어오면 평균이 크게 뛴다. 95% tt-구간은 n=1000n=1000에서도 76%만 맞고, 놓친 구간은 거의 모두 참값보다 아래에 있다.

무엇이 잘못되었나? n(Xˉn−μ)\sqrt n(\bar X_n-\mu)의 “척도”가 맞지 않는다. 분산이 무한하면 합의 흩어짐은 n\sqrt n보다 빨리 자란다.

증명 없이 쓰는 사실 (일반화된 중심극한정리 — 안정분포) 꼬리가 P(∣X∣>x)≈cx−αP(|X|>x)\approx cx^{-\alpha} (0<α<20<\alpha<2)이면 적당한 상수 bnb_n에 대해 ∑i≤nXi−bnn1/α\dfrac{\sum_{i\le n}X_i-b_n}{n^{1/\alpha}}이 정규가 아닌 α\alpha-안정분포로 분포수렴한다(Lévy 1925, Gnedenko–Kolmogorov 1949). α=2\alpha=2의 경계가 정규, α=1\alpha=1의 대칭인 경우가 Cauchy다. 안정분포는 “같은 분포 둘을 더해 척도를 바꾸면 다시 같은 분포”가 되는 분포이고, 정규와 Cauchy 말고는 밀도가 닫힌 꼴이 아니다.

α=1.5\alpha=1.5이면 합은 n2/3n^{2/3}의 척도로 흩어지므로 평균의 오차는 n2/3/n=n−1/3n^{2/3}/n=n^{-1/3}의 속도로만 준다. 정확도를 한 자리 높이려면 nn을 100배가 아니라 1,000배 해야 한다. 그리고 극한분포는 오른쪽으로 크게 치우친 안정분포다(그림 7.1).
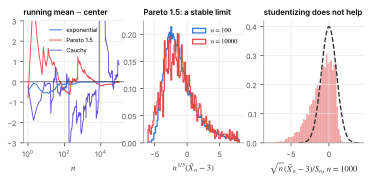
그림 7.1. 왼쪽: 누적 평균의 경로. 지수(분산 유한)는 1/√n으로 안정되고, Pareto α=1.5는 드문 큰 값마다 뛰며 천천히 내려앉고, Cauchy는 영원히 뛴다. 가운데: Pareto 표본의 n^1/3(X̄_n-3) (n=100, 10,000)은 같은 치우친 모양으로 모인다. 오른쪽: 같은 자료를 √n(X̄_n-3)/S_
그림 7.1 왼쪽: 누적 평균의 경로. 지수(분산 유한)는 1/n1/\sqrt n으로 안정되고, Pareto α=1.5\alpha=1.5는 드문 큰 값마다 뛰며 천천히 내려앉고, Cauchy는 영원히 뛴다. 가운데: Pareto 표본의 n1/3(Xˉn−3)n^{1/3}(\bar X_n-3) (n=100n=100, 10,00010{,}000)은 같은 치우친 모양으로 모인다. 오른쪽: 같은 자료를 n(Xˉn−3)/Sn\sqrt n(\bar X_n-3)/S_n으로 표준화한 값은 표준정규(점선)와 거리가 멀다.

7.2 평균도 없을 때 ​

Cauchy 분포는 평균이 없다. 예제 3.5처럼 Xˉn\bar X_n은 모든 nn에서 관측 하나와 같은 분포이므로 대수의 법칙조차 없다. 누적 평균의 경로는 수렴하지 않고 몇천 번째 관측에서도 크게 뛴다(그림 7.1 왼쪽). 그러나 중심을 추정할 방법이 없는 것은 아니다. 표본 중앙값은 Cauchy에서도 n\sqrt n의 속도로 중심에 모이고, 점근분산은 π24n\tfrac{\pi^2}{4n}이다(n=101n=101의 시뮬레이션에서 nVar⁡=2.52n\Var=2.52, 이론 2.47). 평균이 실패하는 곳에서 순위에 기반한 통계량이 살아남는다. 15회의 주제다.

7.3 가정이 성립해도 — 꼬리의 상대오차 ​

중심극한정리는 분포함수의 절대 오차가 0으로 간다고 말한다. 꼬리의 아주 작은 확률은 절대오차가 작아도 상대오차가 클 수 있다.

예제 7.2 (지수 30개의 꼬리) Exp(1)\mathrm{Exp}(1) 30개의 합 S∼Γ(30,1)S\sim\Gamma(30,1)에서

P(S>30+330)=0.0042,P(S<30−330)=0.00008P\bigl(S>30+3\sqrt{30}\bigr)=0.0042,\qquad P\bigl(S<30-3\sqrt{30}\bigr)=0.00008

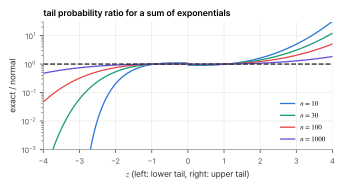
인데 정규근사는 둘 다 0.001350.00135다. 오른쪽 꼬리는 3.1배 얕잡고 왼쪽은 17배 과장한다. 분포함수의 오차는 기껏 0.024였다(예제 3.4). 꼬리의 확률을 물을 때는 Chernoff 한계(2회 정리 8.1)나 정확한 분포가 필요하다. 유전체 연구에서 p<5×10⁻⁸p<5\times10^{-8} 같은 문턱을 정규근사로 계산하면 이 차이가 결론을 바꾼다.

그림 7.2. Exp(1) n개의 표준화한 합에서 정확한 꼬리 확률과 정규근사의 비(오른쪽 z>0: P(Z_n>z)/(1-Φ(z)), 왼쪽 z<0: P(Z_n<z)/Φ(z)). 정규근사는 오른쪽 꼬리를 얕잡고(비 >1) 왼쪽 꼬리를 과장한다(비 <1). n이 커지면 1로 가지만 꼬리가 깊을수록 느리다. 중심극한정리는 분포의 가운데에 대
그림 7.2 Exp(1)\mathrm{Exp}(1) nn개의 표준화한 합에서 정확한 꼬리 확률과 정규근사의 비(오른쪽 z>0z>0: P(Zn>z)/(1−Φ(z))P(Z_n>z)/(1-\Phi(z)), 왼쪽 z<0z<0: P(Zn<z)/Φ(z)P(Z_n<z)/\Phi(z)). 정규근사는 오른쪽 꼬리를 얕잡고(비 >1>1) 왼쪽 꼬리를 과장한다(비 <1<1). nn이 커지면 1로 가지만 꼬리가 깊을수록 느리다. 중심극한정리는 분포의 가운데에 대한 정리다.

7.4 기울기가 0이면 ​

델타 방법은 g′(θ)≠0g'(\theta)\ne0일 때 n\sqrt n의 속도로 정규 극한을 준다. g′(θ)=0g'(\theta)=0이면 1차 항이 사라져 극한이 0으로 퇴화한다. 예를 들어 μ=0\mu=0일 때 Xˉn2\bar X_n^2은 n\sqrt n이 아니라 nn의 속도로 0에 가고, nXˉn2→Dσ2χ2(1)n\bar X_n^2\xrightarrow{D}\sigma^2\chi^2(1)이다(연습 4.2). 지수 표본에서 중심화한 nXˉ2n\bar X^2의 평균은 1.00, P(nXˉ2>3.84)=0.050P(n\bar X^2>3.84)=0.050로 χ2(1)\chi^2(1)과 맞는다. 귀무가설 위에서 기울기가 0이 되는 이런 상황이 9회의 가능도비 검정(Wilks 정리)이 χ2\chi^2 분포를 갖는 이유다.

연습문제

연습 7.1 (Pareto의 적률 ★) f(x)=αx−(α+1)f(x)=\alpha x^{-(\alpha+1)} (x≥1x\ge1)이면 EXk<∞  ⟺  k<αEX^k<\infty\iff k<\alpha임을 보이고, α>1\alpha>1이면 EX=αα−1EX=\tfrac\alpha{\alpha-1}임을 보여라. 역함수 표집으로 X=U−1/αX=U^{-1/\alpha}임을 보여라.

풀이

EXk=∫1∞αxk−α−1dxEX^k=\int_1^\infty\alpha x^{k-\alpha-1}dx는 k−α−1<−1k-\alpha-1<-1, 곧 k<αk<\alpha일 때만 유한하고 그때 αα−k\tfrac\alpha{\alpha-k}이다. k=1k=1이면 αα−1\tfrac\alpha{\alpha-1}. F(x)=1−x−αF(x)=1-x^{-\alpha}이므로 F−1(u)=(1−u)−1/αF^{-1}(u)=(1-u)^{-1/\alpha}이고 1−U∼U1-U\sim U이므로 X=U−1/αX=U^{-1/\alpha}.

연습 7.2 (중앙값은 왜 대개 작은가 ★★) Pareto α=1.5\alpha=1.5의 중앙값은 21/α=1.592^{1/\alpha}=1.59로 평균 3보다 훨씬 작다. 이것과 “표본평균이 대개 참값보다 작다”는 관찰을 연결해 설명하라.

풀이

분포의 절반이 1.59 아래에 있고 평균 3은 드문 큰 값이 끌어올린 것이다. 표본 nn개의 평균은 그 큰 값을 충분한 빈도로 담아야 3 근처가 되는데, 큰 값일수록 드물어 대부분의 표본은 덜 담는다. 그래서 표본평균의 분포는 중앙값이 3보다 작고 오른쪽 꼬리가 긴 모양이며, 평균이 3이 되는 것은 그 긴 꼬리 덕분이다.

연습 7.3 (Cauchy의 중앙값 ★★) 연속 밀도 ff의 중앙값 mm에서 f(m)>0f(m)>0이면 표본중앙값의 점근분산이 14nf(m)2\tfrac1{4nf(m)^2}임을 받아들이자(8회). Cauchy에서 π24n\tfrac{\pi^2}{4n}, 정규에서 πσ22n\tfrac{\pi\sigma^2}{2n}임을 보이고, 정규에서 평균에 대한 중앙값의 효율 2π=0.64\tfrac2\pi=0.64를 구하라.

풀이

Cauchy는 f(0)=1πf(0)=\tfrac1\pi이므로 14n/π2=π24n\tfrac1{4n/\pi^2}=\tfrac{\pi^2}{4n}. 정규는 f(μ)=1σ2πf(\mu)=\tfrac1{\sigma\sqrt{2\pi}}이므로 2πσ24n=πσ22n\tfrac{2\pi\sigma^2}{4n}=\tfrac{\pi\sigma^2}{2n}. 평균의 분산 σ2n\tfrac{\sigma^2}n과의 비가 2π=0.64\tfrac2\pi=0.64이다. 정규에서는 중앙값이 평균만큼 정확하려면 관측이 약 1.57배 필요하다.

연습 7.4 (꼬리의 비 ★) 노트북으로 Γ(n,1)\Gamma(n,1)의 정확한 꼬리 확률과 정규근사의 비를 z=3z=3에서 구하라(n=30,300,3000n=30,300,3000). 비가 1에 가까워지는 속도는?

풀이

z=3z=3에서 오른쪽 꼬리의 비는 n=30,300,3000n=30,300,3000에서 3.08, 1.56, 1.17이고 왼쪽은 0.06, 0.56, 0.85다. 로그 비가 대략 κ3z36n\tfrac{\kappa_3z^3}{6\sqrt n}에 비례하므로(연습 3.1) nn을 10배 하면 로그 비가 10\sqrt{10}분의 1로 준다. 꼬리가 깊을수록(zz가 클수록) 더 느리다.

이 회차에서 읽은 절 0개 · 회차 차례