Skip to content

7회 · 극한의 언어 · 노트

5 다변량으로 — 선형결합 하나면 된다 ​

평균 하나가 아니라 여러 개를 함께 추정할 때가 많다. 다항분포의 범주별 비율, (Xˉ,1n∑Xi2)(\bar X,\tfrac1n\sum X_i^2), 회귀계수의 벡터(13회). 벡터의 극한도 5회의 Cramér–Wold와 같은 생각, 곧 “모든 선형결합을 보면 된다”로 해결된다.

5.1 벡터의 수렴과 다변량 중심극한정리 ​

정의 5.1 (벡터의 수렴) Rk\R^k의 확률벡터 Xn\X_n이 모든 성분에서 X\X의 성분으로 확률수렴하면 Xn→PX\X_n\xrightarrow{P}\X라 쓴다. 결합분포함수가 X\X의 결합분포함수의 모든 연속점에서 수렴하면 Xn→DX\X_n\xrightarrow{D}\X라 쓴다.

정리 1.3와 Slutsky의 정리는 벡터에서도 같은 증명으로 성립한다. 2.3절의 상자도 벡터의 mgf MX(t)=Eet′XM_{\X}(\bt)=Ee^{\bt\T\X}에 대해 성립한다.

정리 5.2 (다변량 중심극한정리) X1,X2,…\X_1,\X_2,\dots가 Rk\R^k의 iid 확률벡터이고 mgf가 0\mathbf 0의 근방에서 존재하며, 평균 μ\bmu, 공분산행렬 Σ\Sigma이면

n (Xˉn−μ) →D Nk(0,Σ).\sqrt n\,(\bar\X_n-\bmu)\ \xrightarrow{D}\ \N_k(\mathbf 0,\Sigma).

증명 전략 방향 t\bt를 하나 고정하면 벡터의 mgf는 1차원 변수 Yi=t′(Xi−μ)Y_i=\bt\T(\X_i-\bmu)의 합의 mgf다. 정리 3.1의 증명 4 5를 t=1t=1에서 그대로 하고, 모든 t\bt에서 극한이 Nk(0,Σ)\N_k(\mathbf 0,\Sigma)의 mgf임을 확인한다. 단계별 증명은 연습 5.5(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

증명은 1차원의 중심극한정리를 모든 방향 t\bt에 한 번씩 쓴 것이다. 벡터의 극한이 결합정규인 것은 5회 정리 3.10에서처럼 모든 선형결합이 정규이기 때문이다.

예제 5.3 (다항분포의 정규 극한) nn번의 독립 시행에서 결과가 범주 jj일 확률이 pjp_j (j=1,…,kj=1,\dots,k)이면, 시행 ii의 결과를 원핫 벡터 Xi\X_i(범주 jj이면 jj번째 성분만 1)로 쓸 수 있다. EXi=pE\X_i=\mathbf p이고, XijXil=0X_{ij}X_{il}=0 (j≠lj\ne l), Xij2=XijX_{ij}^2=X_{ij}이므로

Cov⁡(Xi)=diag(p)−pp′=:Σp.\Cov(\X_i)=\mathrm{diag}(\mathbf p)-\mathbf p\mathbf p\T=:\Sigma_{\mathbf p}.

범주별 개수 N=∑Xi\mathbf N=\sum\X_i는 다항분포이고(4회 정리 1.8의 공분산 −npjpl-np_jp_l과 같다) 정리 5.2로

n (p^−p)→DNk(0, Σp).\sqrt n\,(\hat{\mathbf p}-\mathbf p)\xrightarrow{D}\N_k(\mathbf 0,\ \Sigma_{\mathbf p}).

Σp1=p−p=0\Sigma_{\mathbf p}\mathbf 1=\mathbf p-\mathbf p=\mathbf 0이므로 극한은 특이 정규분포다(5회 명제 5.6). 비율의 합이 언제나 1이라는 제약 하나가 차원 하나를 없앤다(그림 5.1).
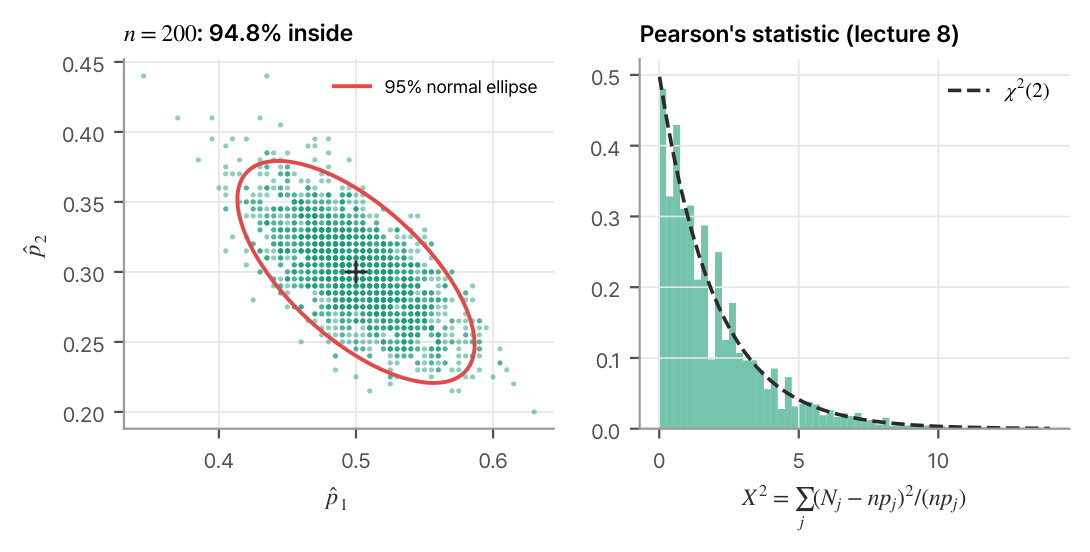
그림 5.1. 왼쪽: 세 범주(p=(0.5,0.3,0.2), n=200)의 (p̂_1,p̂_2) 2,000개와 정규 극한의 95% 타원. 오른쪽: Pearson 통계량 Σ_jfrac(N_j-np_j)²np_j의 히스토그램과 χ²(2) 밀도. 8회에서 증명한다.
그림 5.1 왼쪽: 세 범주(p=(0.5,0.3,0.2)\mathbf p=(0.5,0.3,0.2), n=200n=200)의 (p^1,p^2)(\hat p_1,\hat p_2) 2,000개와 정규 극한의 95% 타원. 오른쪽: Pearson 통계량 ∑j(Nj−npj)2npj\sum_j\frac{(N_j-np_j)^2}{np_j}의 히스토그램과 χ2(2)\chi^2(2) 밀도. 8회에서 증명한다.

이 예제가 8회의 출발점이다. Pearson(1900)의 적합도 통계량 X2=∑j(Nj−npj)2npjX^2=\sum_j\tfrac{(N_j-np_j)^2}{np_j}은 n(p^−p)\sqrt n(\hat{\mathbf p}-\mathbf p)의 이차형식이고, 5회 정리 3.17(이차형식은 χ2\chi^2)과 정리 5.2를 합치면 X2→Dχ2(k−1)X^2\xrightarrow{D}\chi^2(k-1)이 나온다. 자유도 k−1k-1은 위의 제약 하나 때문이다.

5.2 다변량 델타 방법 ​

정리 5.4 (다변량 델타 방법) n(Yn−θ)→DNk(0,Σ)\sqrt n(\Y_n-\boldsymbol\theta)\xrightarrow{D}\N_k(\mathbf 0,\allowbreak \Sigma)이고 g:Rk→Rg:\R^k\to\R가 θ\boldsymbol\theta에서 미분가능하며 기울기가 ∇g\nabla g이면

n(g(Yn)−g(θ))→DN(0, ∇g′ Σ ∇g).\sqrt n\bigl(g(\Y_n)-g(\boldsymbol\theta)\bigr)\xrightarrow{D}\N\bigl(0,\ \nabla g\T\,\Sigma\,\nabla g\bigr).

증명 전략 미분가능성을 “1차 근사 + 나머지”로 쓴다. 1차 항은 정규벡터의 선형결합이고, 나머지는 확률적으로 유계인 양과 확률적으로 0인 양의 곱이다. 보조정리 4.1로 합친다. 단계별 증명은 연습 5.6(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

예제 5.5 (표본분산의 점근분포) Yn=(Xˉn, 1n∑Xi2)\Y_n=\bigl(\bar X_n,\allowbreak \ \tfrac1n\sum X_i^2\bigr), g(a,b)=b−a2g(a,b)=b-a^2이면 g(Yn)=n−1nSn2g(\Y_n)=\tfrac{n-1}nS_n^2이다. μ=0\mu=0으로 두어도 되고(위치를 옮겨도 S2S^2는 그대로), 그러면 θ=(0,σ2)\boldsymbol\theta=(0,\allowbreak \sigma^2), ∇g=(−2a,1)=(0,1)\nabla g=(-2a,1)=(0,1)이므로 둘째 성분의 분산만 남는다:

n (Sn2−σ2)→DN(0, Var⁡X2)=N(0, μ4−σ4).\sqrt n\,(S_n^2-\sigma^2)\xrightarrow{D}\N\bigl(0,\ \Var X^2\bigr)=\N\bigl(0,\ \mu_4-\sigma^4\bigr).

(n−1n\tfrac{n-1}n과의 차이는 Slutsky로 사라진다.) 정규이면 μ4−σ4=2σ4\mu_4-\sigma^4=2\sigma^4으로 6회 따름정리 2.3과 맞고, 지수이면 9−1=89-1=8이다(시뮬레이션 7.98). 6회 7.4절에서 분산의 FF 검정이 첨도에 민감했던 이유가 이 분산의 μ4\mu_4다.

연습문제

연습 5.1 (원핫 벡터의 공분산 ★) 예제 5.3의 Cov⁡(Xi)=diag(p)−pp′\Cov(\X_i)=\mathrm{diag}(\mathbf p)-\mathbf p\mathbf p\T를 성분별로 확인하고, Σp\Sigma_{\mathbf p}의 계수가 k−1k-1임을 보여라. (힌트: 1\mathbf 1에 수직인 벡터 v\mathbf v에 대해 v′Σpv=∑pjvj2−(∑pjvj)2\mathbf v\T\Sigma_{\mathbf p}\mathbf v=\sum p_jv_j^2-(\sum p_jv_j)^2.)

풀이

EXijXil=P(범주 j이고 l)=0E X_{ij}X_{il}=P(\text{범주 }j\text{이고 }l)=0 (j≠lj\ne l)이므로 Cov⁡=−pjpl\Cov=-p_jp_l, Var⁡Xij=pj−pj2\Var X_{ij}=p_j-p_j^2. 계수: Σp1=0\Sigma_{\mathbf p}\mathbf 1=\mathbf0이므로 계수는 k−1k-1 이하다. v⊥1\mathbf v\perp\mathbf 1이고 v≠0\mathbf v\ne\mathbf 0이면 v′Σpv=∑pjvj2−(∑pjvj)2\mathbf v\T\Sigma_{\mathbf p}\mathbf v=\sum p_jv_j^2-(\sum p_jv_j)^2은 확률 pjp_j로 값 vjv_j를 갖는 변수의 분산이다. vjv_j가 모두 같으면 ∑vj=0\sum v_j=0에서 v=0\mathbf v=\mathbf0이므로, 그렇지 않은 한 분산이 양수다(pj>0p_j>0). 따라서 1⊥\mathbf 1^\perp 위에서 양의 정부호이고 계수는 k−1k-1.

연습 5.2 (비율 추정량 ★★) (Xi,Yi)(X_i,Y_i)가 iid이고 μX≠0\mu_X\ne0이면 R=μY/μXR=\mu_Y/\mu_X의 추정량 R^=Yˉ/Xˉ\hat R=\bar Y/\bar X에 대해 n(R^−R)→DN(0, σY2−2RσXY+R2σX2μX2)\sqrt n(\hat R-R)\xrightarrow{D}\N\Bigl(0,\allowbreak \ \dfrac{\sigma_Y^2-2R\sigma_{XY}+R^2\sigma_X^2}{\mu_X^2}\Bigr)임을 보여라.

풀이

Yn=(Xˉ,Yˉ)\Y_n=(\bar X,\bar Y), g(a,b)=b/ag(a,b)=b/a, ∇g=(−b/a2, 1/a)=1μX(−R, 1)\nabla g=(-b/a^2,\allowbreak \ 1/a)=\tfrac1{\mu_X}(-R,\allowbreak \ 1). 정리 5.4로 분산은 1μX2(R2σX2−2RσXY+σY2)\tfrac1{\mu_X^2}(R^2\sigma_X^2-2R\sigma_{XY}+\sigma_Y^2). 노트북의 예(μX=2\mu_X=2, μY=3\mu_Y=3, σX=1\sigma_X=1, σY=1.5\sigma_Y=1.5, ρ=0.6\rho=0.6)에서 이론 0.4500.450, 시뮬레이션 0.4500.450.

연습 5.3 (Fisher의 zz ★) 이변량 정규 표본의 상관계수 rr이 n(r−ρ)→DN(0,(1−ρ2)2)\sqrt n(r-\rho)\xrightarrow{D}\N\bigl(0,\allowbreak (1-\rho^2)^2\bigr)을 만족함을 받아들이자(13회). z=12log⁡1+r1−rz=\tfrac12\log\tfrac{1+r}{1-r}의 점근분산이 ρ\rho와 상관없이 1임을 보여라(Fisher, 1921). 분산 안정화 변환이다.

풀이

g(r)=12log⁡1+r1−rg(r)=\tfrac12\log\tfrac{1+r}{1-r}, g′(r)=11−r2g'(r)=\tfrac1{1-r^2}이므로 점근분산은 (1−ρ2)2(1−ρ2)2=1\tfrac{(1-\rho^2)^2}{(1-\rho^2)^2}=1.

연습 5.4 (변동계수 ★★) μ>0\mu>0이고 EX4<∞E X^4<\infty인 iid 표본의 변동계수 Sn/XˉnS_n/\bar X_n의 점근분산을 다변량 델타 방법으로 구하라. 정규 모집단이면 c22+c4\tfrac{c^2}2+c^4 (c=σ/μc=\sigma/\mu)임을 보여라.

풀이

Yn=(Xˉ,1n∑Xi2)\Y_n=(\bar X,\allowbreak \tfrac1n\sum X_i^2), θ=(μ,μ2+σ2)\boldsymbol\theta=(\mu,\allowbreak \mu^2+\sigma^2), g(a,b)=b−a2/ag(a,b)=\sqrt{b-a^2}/a. 정규이면 더 쉽게 (Xˉ,S)(\bar X,S)로 쓴다: 둘은 독립이고(6회 정리 2.2) n(S−σ)→DN(0,σ2/2)\sqrt n(S-\sigma)\xrightarrow{D}\N(0,\allowbreak \sigma^2/2)(예제 5.5에 ⋅\sqrt{\cdot}의 델타 방법, 2σ4(2σ)2=σ22\tfrac{2\sigma^4}{(2\sigma)^2}=\tfrac{\sigma^2}2). g(m,s)=s/mg(m,s)=s/m, ∇g=(−s/m2,1/m)\nabla g=(-s/m^2,1/m)이므로 분산은 σ2μ4σ2+1μ2σ22=c4+c22\tfrac{\sigma^2}{\mu^4}\sigma^2+\tfrac1{\mu^2}\tfrac{\sigma^2}2=c^4+\tfrac{c^2}2.

연습 5.5 (다변량 중심극한정리 증명 ★★ 유도형) 정리 5.2를 다음 순서로 증명하라.

  1. (a)

    t\bt를 고정하고 Yi=t′(Xi−μ)Y_i=\bt\T(\X_i-\bmu)로 두면 YiY_i는 iid, 평균 0, 분산 t′Σt\bt\T\Sigma\bt임을 보여라(5회 보조정리 3.1).

  2. (b)

    Mn(Xˉn−μ)(t)=[MY(1/n)]nM_{\sqrt n(\bar\X_n-\bmu)}(\bt)=\bigl[M_Y(1/\sqrt n)\bigr]^n임을 보여라.

  3. (c)

    t′Σt>0\bt\T\Sigma\bt>0이면 정리 3.1의 증명 4 5를 t=1t=1에서 따라 (b)의 로그가 12t′Σt\tfrac12\bt\T\Sigma\bt로 감을 보여라. t′Σt=0\bt\T\Sigma\bt=0이면 왜 처음부터 성립하는가?

  4. (d)

    극한이 Nk(0,Σ)\N_k(\mathbf 0,\Sigma)의 mgf(5회 정의 3.4)임을 확인하고, 2.3절의 상자(벡터의 mgf)로 결론을 내라.

풀이

(a) YiY_i는 iid 벡터 Xi\X_i의 같은 함수이므로 iid이다. EYi=t′(EXi−μ)=0EY_i=\bt\T(E\X_i-\bmu)=0이고 Var⁡Yi=t′Σt\Var Y_i=\bt\T\Sigma\bt이다(5회 보조정리 3.1). (b) t′n(Xˉn−μ)=1n∑iYi\bt\T\sqrt n(\bar\X_n-\bmu)=\tfrac1{\sqrt n}\sum_iY_i이므로 Mn(Xˉn−μ)(t)=Eexp⁡(1n∑Yi)=∏iEeYi/n=[MY(1/n)]nM_{\sqrt n(\bar\X_n-\bmu)}(\bt)=E\exp\bigl(\tfrac1{\sqrt n}\sum Y_i\bigr)=\prod_iEe^{Y_i/\sqrt n}=\bigl[M_Y(1/\sqrt n)\bigr]^n이다. 둘째 등호에서 독립(3회 정리 3.4)을 썼다. t\bt가 0\mathbf0 근방에 있으면 MY(s)=e−st′μMX(st)M_Y(s)=e^{-s\bt\T\bmu}M_{\X}(s\bt)가 ∣s∣≤1|s|\le1에서 존재한다. (c) t′Σt>0\bt\T\Sigma\bt>0이면 Yi/t′ΣtY_i/\sqrt{\bt\T\Sigma\bt}는 평균 0, 분산 1이고, 정리 3.1의 증명 4 5를 t=t′Σtt=\sqrt{\bt\T\Sigma\bt}에서 쓰면 nlog⁡MY(1/n)→12t′Σtn\log M_Y(1/\sqrt n)\to\tfrac12\bt\T\Sigma\bt이다. t′Σt=0\bt\T\Sigma\bt=0이면 Var⁡Yi=0\Var Y_i=0이므로 Yi=0Y_i=0이고(2회 따름정리 5.6) mgf는 모든 nn에서 1=e01=e^0이다. (d) 극한 exp⁡(12t′Σt)\exp(\tfrac12\bt\T\Sigma\bt)은 0\mathbf0 근방의 모든 t\bt에서 Nk(0,Σ)\N_k(\mathbf0,\Sigma)의 mgf(5회 정의 3.4)와 같다. 2.3절의 상자는 벡터의 mgf에도 성립하므로 n(Xˉn−μ)→DNk(0,Σ)\sqrt n(\bar\X_n-\bmu)\xrightarrow{D}\N_k(\mathbf0,\allowbreak \Sigma)이다.

연습 5.6 (다변량 델타 방법 증명 ★★ 유도형) 정리 5.4를 다음 순서로 증명하라.

  1. (a)

    gg가 θ\boldsymbol\theta에서 미분가능하다는 것을 g(y)−g(θ)=∇g′(y−θ)+∥y−θ∥ r(y)g(\mathbf y)-g(\boldsymbol\theta)=\nabla g\T(\mathbf y-\boldsymbol\theta)+\|\mathbf y-\boldsymbol\theta\|\,r(\mathbf y), r(θ)=0r(\boldsymbol\theta)=0, rr은 θ\boldsymbol\theta에서 연속인 꼴로 써라.

  2. (b)

    ∇g′n(Yn−θ)→DN(0,∇g′Σ∇g)\nabla g\T\sqrt n(\Y_n-\boldsymbol\theta)\xrightarrow{D}\N(0,\allowbreak \nabla g\T\Sigma\nabla g)임을 2.3절의 연속사상 상자(선형함수는 연속)와 5회 정리 3.8로 보여라.

  3. (c)

    n∥Yn−θ∥\sqrt n\|\Y_n-\boldsymbol\theta\|가 확률적으로 유계이고 r(Yn)→P0r(\Y_n)\xrightarrow{P}0임을 보여 둘째 항이 →P0\xrightarrow{P}0임을 보여라.

  4. (d)

    보조정리 4.1로 결론을 내라.

풀이

(a) 미분가능성의 정의는 g(y)−g(θ)−∇g′(y−θ)∥y−θ∥→0\tfrac{g(\mathbf y)-g(\boldsymbol\theta)-\nabla g\T(\mathbf y-\boldsymbol\theta)}{\|\mathbf y-\boldsymbol\theta\|}\to0 (y→θ\mathbf y\to\boldsymbol\theta)이다. 이 몫을 r(y)r(\mathbf y) (y≠θ\mathbf y\ne\boldsymbol\theta), r(θ)=0r(\boldsymbol\theta)=0으로 두면 식이 성립하고 rr은 θ\boldsymbol\theta에서 연속이다. (b) Vn=n(Yn−θ)→DV∼Nk(0,Σ)\mathbf V_n=\sqrt n(\Y_n-\boldsymbol\theta)\xrightarrow{D}\mathbf V\sim\N_k(\mathbf0,\allowbreak \Sigma)이다. v↦∇g′v\mathbf v\mapsto\nabla g\T\mathbf v는 연속이므로 2.3절의 연속사상 상자로 ∇g′Vn→D∇g′V\nabla g\T\mathbf V_n\xrightarrow{D}\nabla g\T\mathbf V이고, 5회 정리 3.8로 ∇g′V∼N(0,∇g′Σ∇g)\nabla g\T\mathbf V\sim\N(0,\allowbreak \nabla g\T\Sigma\nabla g)이다. (c) ∥Vn∥\|\mathbf V_n\|은 같은 상자로 ∥V∥\|\mathbf V\|로 분포수렴하므로 확률적으로 유계다(정리 2.5). 그러면 Yn−θ=Vn/n→P0\Y_n-\boldsymbol\theta=\mathbf V_n/\sqrt n\xrightarrow{P}\mathbf0이고, rr이 θ\boldsymbol\theta에서 연속이므로 r(Yn)→P0r(\Y_n)\xrightarrow{P}0이다(정리 1.3의 벡터 판). 정리 2.5의 둘째 주장으로 ∥Vn∥ r(Yn)→P0\|\mathbf V_n\|\,r(\Y_n)\xrightarrow{P}0이다. (d) n(g(Yn)−g(θ))=∇g′Vn+∥Vn∥ r(Yn)\sqrt n(g(\Y_n)-g(\boldsymbol\theta))=\nabla g\T\mathbf V_n+\|\mathbf V_n\|\,r(\Y_n)이고, (b)(c)와 보조정리 4.1로 결론이 나온다.

이 회차에서 읽은 절 0개 · 회차 차례