
테마
6회 · Student의 t · 노트
7 부숴보기 — 정규가 아니고, 독립이 아니면
정리 5.2의 “정확히 ”는 세 가정 위에 서 있다. 관측이 정규이고, 독립이고, (두 표본이면) 분산이 같다. 이 절은 가정을 하나씩 깨고 실제 포함확률을 잰다. 결론을 먼저 쓰면, 평균에 대한 는 대칭인 비정규에는 강하고, 비대칭에는 작은 에서 약하며, 의존에는 이 커져도 약하다. 그리고 분산에 대한 는 비정규에 아주 약하다.
7.1 비대칭 모집단
| 모집단 | 성질 | ||||
|---|---|---|---|---|---|
| 균등 | 0.934 | 0.946 | 0.949 | 0.948 | 대칭, 꼬리 짧음 |
| 0.962 | 0.960 | 0.956 | 0.952 | 대칭, 꼬리 두꺼움 | |
| 지수 | 0.884 | 0.899 | 0.927 | 0.941 | 오른쪽으로 치우침 |
| 로그정규 | 0.822 | 0.837 | 0.882 | 0.918 | 크게 치우침 |
명목 95% -구간의 실제 포함확률이다(각 5만 번 시뮬레이션). 대칭인 분포에서는 에서도 거의 맞고, 처럼 꼬리가 두꺼우면 오히려 보수적이다. 치우친 분포에서는 에서도 모자라다. 원인은 평균과 표준편차의 상관이다.
명제 7.1 (평균과 표본분산의 공분산) 이 독립이고 같은 분포이며 이 유한하면
증명 전략 으로 놓고 에 를 곱해 기댓값을 취한다. 독립이고 평균이 0이면, 한 첨자가 혼자 남는 곱의 기댓값은 0이다. 단계별 증명은 연습 7.5(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.
정규면 이고, 이것은 와 어긋나지 않는다. 오른쪽으로 치우친 분포()에서는 가 작을 때 도 작다. 지수 표본 에서 와 의 상관은 0.76이다. 그래서 구간이 아래로 밀렸을 때 하필 짧아진다. 놓치는 방향이 한쪽으로 몰린다.
예제 7.2 (한쪽으로 놓친다) 지수 표본 의 95% -구간은 90.1%를 포함한다. 놓친 9.9% 가운데 9.5%는 구간 전체가 아래에 있는 경우이고, 위에 있는 경우는 0.4%뿐이다. 양쪽 2.5%씩이 되어야 할 오류가 9.5%와 0.4%로 갈린다. 그래서 의 위쪽 한계로 을 쓰면 97.5%가 아니라 90.5%만 맞는다. 로그정규에서는 15.9%와 0.1%로 더 심하다. 로그를 취해 대칭으로 만든 뒤 구간을 만들면(로그정규의 경우 정확히 정규가 되어) 포함확률은 95%로 돌아온다. 그러나 그것은 가 아니라 중앙값 의 구간이다.
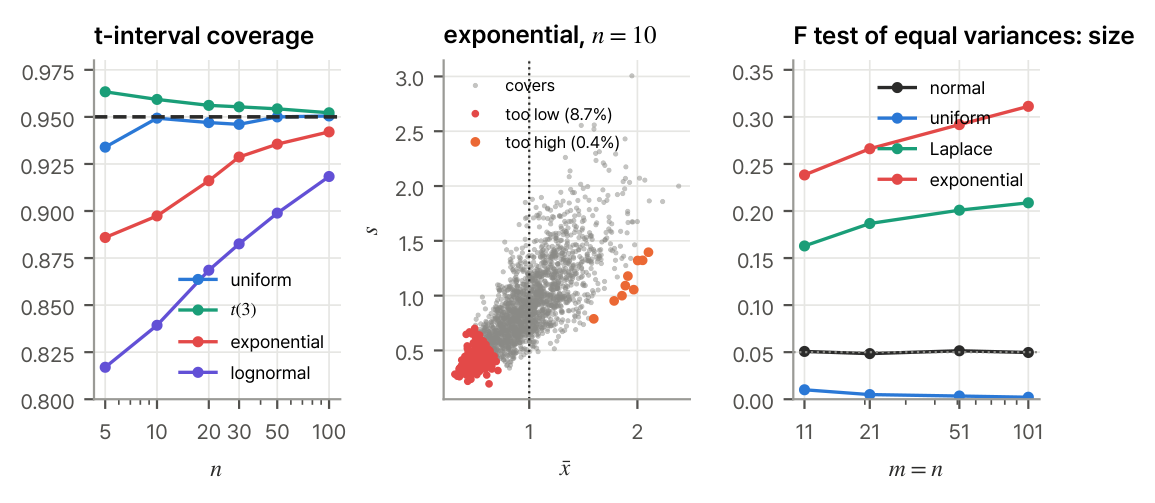
이 커지면 7회의 중심극한정리로 가 정규에 가까워지고 이므로 -구간은 결국 맞는다(그림 7.1 왼쪽). 그러나 수렴의 속도가 왜도 에 달려 있다. 한쪽으로 놓치는 확률의 어긋남은 대략 에 비례해서 줄어든다. 지수 표본에서 구간이 아래에 있을 확률(이론값 2.5%)은 에서 9.5%, 에서 4.5%다. 양쪽 구간에서는 두 쪽의 어긋남이 일부 상쇄되어 더 빨리 줄지만, 한쪽 한계는 느리다. “이면 정규”라는 경험칙은 왜도가 작을 때만의 이야기다. 15회의 부트스트랩-가 이 왜도를 자료에서 어림해 보정한다.
7.2 이상값 하나
명제 7.3 (이상값은 를 1로 끌고 간다) 을 고정하고 이면 .
증명 전략 와 를 의 거듭제곱으로 전개해 가장 큰 차수의 항만 비교한다 [T8]. 단계별 증명은 연습 7.6(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.
큰 이상값은 평균을 끌어올리지만 표준편차를 더 크게 키워서, 을 검정하는 가 오히려 작아진다. 평균이 1 근처인 10개의 값에서 이었는데, 첫 값을 으로 바꾸면 , 으로 바꾸면 다. 한 개의 큰 값이 “효과가 있다”는 결론을 지운다. 는 분포의 모양에 대해서는 의외로 튼튼하지만(위 표의 대칭 분포), 소수의 거친 오차에는 무력하다. 15회의 순위 검정과 로버스트 추정이 이 문제에서 출발한다.
7.3 의존하는 관측
관측이 서로 닮으면, 예를 들어 같은 날의 측정이나 시계열처럼 (AR(1), )이면 3회 정리 4.2(공분산의 쌍선형성)로
이다(연습 7.2). 는 여전히 근처이므로 -구간은 배 너무 짧다. 이면 그 배수가 이고 포함확률은 에서 로 이 커져도 나아지지 않는다. 극한은 다. 비정규성은 표본이 크면 사라지지만 의존은 사라지지 않는다. Student 자신도 1927년의 논문에서 실험실의 일상 분석은 같은 날의 측정끼리 닮아서 오차가 이론보다 크다고 경고했다.
7.4 분산의 비교는 정규성에 민감하다
정리 4.3의 검정을 비정규 자료에 쓰면 결과가 크게 틀린다. 두 집단이 같은 분포이고 일 때 명목 5% 검정의 실제 기각률은 균등 1.0%, Laplace 16%, 지수 24%이고, 에서는 0.3%, 21%, 31%로 오히려 나빠진다. 이유는 연습 1.2에 있다. 에서 은 초과첨도이고, 정규 이론은 을 가정한다. 이 커져도 이 비율 는 그대로 남는다. 반면 같은 자료에서 평균의 검정은 지수를 빼면 4.3–5.2%로 거의 정확하다. Box(1953)는 이 대조를 보이며 “로버스트”(robust)라는 말을 통계학에 들였다. 평균의 비교는 로버스트하고, 분산의 비교는 그렇지 않다.
연습문제
연습 7.2 (AR(1)의 분산 ★★) , 이면 본문의 식이 성립함을 보이고, 에서 괄호가 로 감을 보여라. 음의 상관()이면 -구간은 어떻게 되나?
풀이
연습 7.3 ( 검정의 점근 수준 ★★★) 연습 1.2의 와 7회의 델타 방법을 미리 빌려 의 분산을 로 어림하라. 정규 이론의 5% 검정이 실제로는 로 기각함을 보이고, Laplace()와 지수()에서 계산해 본문의 시뮬레이션과 비교하라.
풀이
델타 방법: 이므로 . 두 독립 표본의 차 의 분산은 이다. 정규 이론의 검정은 이 분산을 으로 보고 이면 기각하므로 실제 기각률은 . Laplace는 , 지수는 이고, 시뮬레이션의 값 과 에 가깝다. 균등()이면 로 거의 기각하지 못한다.
연습 7.4 (대칭이면 보수적 ★★) 모집단에서 -구간이 95%보다 많이 포함하는 이유를 의 분포로 설명하라. (힌트: 큰 관측 하나가 보다 를 더 키운다. 명제 7.3.)
풀이
꼬리가 두꺼우면 가끔 아주 큰 관측이 나온다. 그 관측은 를 만큼, 를 만큼 움직이므로 는 1 근처로 끌려간다(명제 7.3). 정규 이론에서 가 큰 경우는 “가 우연히 멀고 가 우연히 작은” 경우인데, 두꺼운 꼬리에서는 가 멀 때 대개 도 크다. 그래서 인 경우가 줄어든다. 대칭이므로 7.1절의 한쪽 쏠림도 없다.
연습 7.5 (평균과 분산의 공분산 증명 ★★ 유도형) 명제 7.1를 다음 순서로 증명하라.
- (a)
를 로 바꿔도 가 변하지 않음을 보여, 으로 놓아도 됨을 밝혀라. 그때 이다.
- (b)
이면 는 일 때 , 아니면 0이고, 는 일 때 , 아니면 0임을 독립으로 보여라.
- (c)
(b)로 , 을 보여라.
- (d)
를 써서 결론을 내려라. 기댓값이 모두 유한한 이유도 밝혀라.
풀이
(a) 를 로 바꾸면 편차 는 그대로이므로 는 변하지 않고, 는 상수 만큼 움직인다. 공분산은 상수를 더해도 변하지 않으므로 으로 놓아도 된다. 그때 이므로 이다. (b) 이면 이므로 이고, 이면 이다. 에서 세 첨자 가운데 한 번만 나오는 첨자가 있으면, 그 변수는 나머지와 독립이고 평균이 0이므로 기댓값은 0이다. 세 첨자가 모두 같을 때만 그런 첨자가 없고, 그때 값은 이다. (c) 이고, 이다. (d) 이므로 이다. 기댓값이 유한한 것은 AM–GM [T4]로 이고 이기 때문이다.