Skip to content

6회 · Student의 t · 노트

1 문제 — σ\sigma를 모를 때 ​

1.1 큰 표본의 관행과 작은 표본의 함정 ​

역사 Gosset은 1899년 옥스퍼드에서 화학과 수학을 공부하고 Guinness에 들어갔다. 회사는 원료와 공정을 과학적으로 관리하려고 젊은 대학 졸업자들을 뽑고 있었다. 보리 품종을 비교하는 밭 실험, 맥아의 수분, 홉의 수지 함량 같은 측정은 비싸고 느려서 한 조건에 몇 번밖에 잴 수 없었다. 당시의 표준적인 방법은 평균 xˉ\bar x에 “확률오차” 0.6745 s/n0.6745\,s/\sqrt n을 붙이는 것이었다. 이것은 σ\sigma를 아는 정규 이론에서 나온 수이고, 관측이 많을 때만 정당했다.

X1,…,XnX_1,\dots,X_n이 N(μ,σ2)\N(\mu,\sigma^2)에서 나온 독립 표본이면 Xˉ∼N(μ,σ2/n)\bar X\sim\N(\mu,\sigma^2/n)이므로(5회 정리 1.8(iv))

P(∣Xˉ−μ∣≤1.96 σn)=0.95.P\Bigl(|\bar X-\mu|\le1.96\,\frac\sigma{\sqrt n}\Bigr)=0.95 .

σ\sigma를 모르면 자연스럽게 SS를 넣는다. 그러면 무엇이 달라지나? 이 노트의 결론(정리 3.4)을 미리 쓰면

P(∣Xˉ−μ∣≤1.96 Sn)=P(∣Tn−1∣≤1.96)={0.700,n=2,0.855,n=4,0.918,n=10,0.940,n=30.P\Bigl(|\bar X-\mu|\le1.96\,\frac S{\sqrt n}\Bigr)=P\bigl(|T_{n-1}|\le1.96\bigr)=\begin{cases}0.700,&n=2,\\0.855,&n=4,\\0.918,&n=10,\\0.940,&n=30.\end{cases}

네 개로 만든 “95% 구간”은 실제로는 85.5%만 맞는다. 작은 SS가 우연히 나오면 구간이 너무 좁아지기 때문이다. σ\sigma를 모른다는 불확실성이 하나 더 있는데, 정규 이론은 그것을 무시한다. Student의 기여는 그 불확실성까지 넣은 정확한 분포를 준 것이다(그림 1.1).
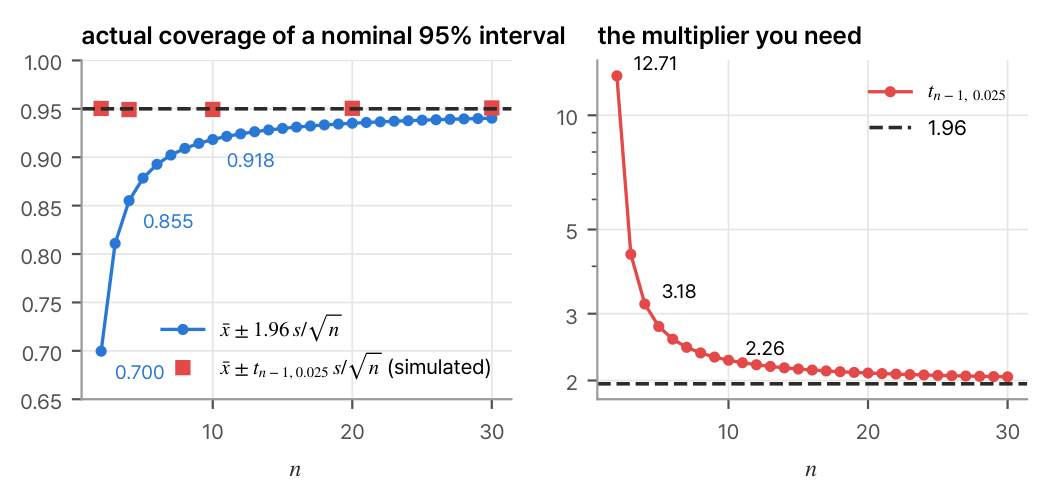
그림 1.1. 왼쪽: x̄±1.96s/√n의 실제 포함확률(파랑)은 95%에 미치지 못한다. t 분위수를 쓰면(빨강) 모든 n에서 정확히 95%다. 오른쪽: 필요한 분위수 t_n-1,0.025는 n이 작을수록 1.96보다 크다.
그림 1.1 왼쪽: xˉ±1.96 s/n\bar x\pm1.96\,s/\sqrt n의 실제 포함확률(파랑)은 95%에 미치지 못한다. tt 분위수를 쓰면(빨강) 모든 nn에서 정확히 95%다. 오른쪽: 필요한 분위수 tn−1, 0.025t_{n-1,\,0.025}는 nn이 작을수록 1.96보다 크다.

1.2 표본분산은 왜 n−1n-1로 나누나 ​

정리 1.1 (표본분산의 기댓값) X1,…,XnX_1,\dots,X_n이 독립이고 평균 μ\mu, 분산 σ2\sigma^2이면 (분포에 상관없이)

E∑i=1n(Xi−Xˉ)2=(n−1)σ2,따라서ES2=σ2.E\sum_{i=1}^n(X_i-\bar X)^2=(n-1)\sigma^2,\qquad\text{따라서}\quad ES^2=\sigma^2 .

증명 전략 참평균 μ\mu에서 잰 편차와 Xˉ\bar X에서 잰 편차의 차이를 정확히 계산한다. μ\mu를 빼고 Xˉ\bar X를 더하고 빼는 것이다.

  1. Xi−μ=(Xi−Xˉ)+(Xˉ−μ)X_i-\mu=(X_i-\bar X)+(\bar X-\mu)로 쪼갠다.더하고 빼기 [T4]

  2. 제곱해 ii에 대해 더한다.

    ∑i(Xi−μ)2=∑i(Xi−Xˉ)2+2(Xˉ−μ)∑i(Xi−Xˉ)+n(Xˉ−μ)2.\sum_i(X_i-\mu)^2=\sum_i(X_i-\bar X)^2+2(\bar X-\mu)\sum_i(X_i-\bar X)+n(\bar X-\mu)^2 .
  3. 가운데 항은 0이다. ∑i(Xi−Xˉ)=∑iXi−nXˉ=0\sum_i(X_i-\bar X)=\sum_iX_i-n\bar X=0이기 때문이다.Xˉ\bar X의 정의

  4. 따라서 ∑i(Xi−Xˉ)2=∑i(Xi−μ)2−n(Xˉ−μ)2\sum_i(X_i-\bar X)^2=\sum_i(X_i-\mu)^2-n(\bar X-\mu)^2이다. 2회 정리 2.2(c)를 표본에 쓴 것과 같다.2 3

  5. 기댓값을 취한다.

    E∑i(Xi−Xˉ)2=∑iE(Xi−μ)2−n E(Xˉ−μ)2=nσ2−n⋅σ2n=(n−1)σ2.\begin{align*} E\sum_i(X_i-\bar X)^2&=\sum_iE(X_i-\mu)^2-n\,E(\bar X-\mu)^2 \tag*{\htmlClass{reason}{\text{기댓값의 선형성}}}\\ &=n\sigma^2-n\cdot\frac{\sigma^2}n \tag*{\htmlClass{reason}{\text{$\Var\bar X=\sigma^2/n$, 3회 정리 6.3}}}\\ &=(n-1)\sigma^2 . \end{align*}

조건 확인 분산이 유한하므로 5의 기댓값은 모두 유한하다. 정규성은 쓰지 않았다. 독립은 Var⁡Xˉ=σ2/n\Var\bar X=\sigma^2/n에서만 쓰였고, 그 자리에는 서로 무상관이면 충분하다.

nn으로 나누면 평균적으로 n−1nσ2\tfrac{n-1}n\sigma^2, 곧 작게 나온다. 참평균 μ\mu 대신 자료에 가장 가깝게 맞춘 Xˉ\bar X에서 편차를 쟀기 때문이다. Xˉ\bar X는 편차제곱합을 가장 작게 하는 점이므로(2회 정리 2.2(c)) ∑(Xi−Xˉ)2≤∑(Xi−μ)2\sum(X_i-\bar X)^2\le\sum(X_i-\mu)^2이 언제나 성립한다. 그 차이가 평균 σ2\sigma^2, 정확히 “관측 하나만큼”이다.

정의 1.2 (자유도) 편차 X1−Xˉ,…,Xn−XˉX_1-\bar X,\dots,X_n-\bar X는 합이 언제나 0이라는 한 개의 선형 제약을 받는다. 그래서 nn개 가운데 n−1n-1개만 자유롭게 움직인다. 편차제곱합이 가진 이 독립적인 방향의 수 n−1n-1을 자유도라 한다.

정의는 아직 직관이다. 2절에서 정규 표본의 경우 이것이 정확한 뜻을 얻는다. 편차벡터는 n−1n-1차원 부분공간에 놓이고, 편차제곱합은 독립인 정규 n−1n-1개의 제곱합, 곧 χ2(n−1)\chi^2(n-1)이다. 13회에서는 회귀계수를 pp개 맞추면 자유도가 n−pn-p가 된다.

예제 1.3 (SS는 σ\sigma를 작게 어림한다) ES2=σ2ES^2=\sigma^2이지만 ES<σES<\sigma이다. Jensen 부등식(2회 정리 5.9, ⋅\sqrt{\cdot}는 오목)으로 ES=ES2≤ES2=σES=E\sqrt{S^2}\le\sqrt{ES^2}=\sigma이고, SS가 상수가 아니므로 등호가 아니다. 정규 표본이면 연습 2.4에서 ES=c4(n)σES=c_4(n)\sigma, c4(4)≈0.921c_4(4)\approx0.921, c4(10)≈0.973c_4(10)\approx0.973을 구한다. 네 개로는 σ\sigma를 평균 8% 작게 어림한다. 그리고 작게 어림할 때 구간은 짧아지고 틀리기 쉽다.

연습문제

연습 1.1 (표본분산의 다른 꼴 ★) ∑(Xi−Xˉ)2=∑Xi2−nXˉ2=12n∑i,j(Xi−Xj)2\sum(X_i-\bar X)^2=\sum X_i^2-n\bar X^2=\tfrac1{2n}\sum_{i,j}(X_i-X_j)^2임을 보여라. 마지막 식으로 ES2=σ2ES^2=\sigma^2을 다시 보여라(2회 연습 2.8).

풀이

∑(Xi−Xˉ)2=∑Xi2−2Xˉ∑Xi+nXˉ2=∑Xi2−nXˉ2\sum(X_i-\bar X)^2=\sum X_i^2-2\bar X\sum X_i+n\bar X^2=\sum X_i^2-n\bar X^2. 또

∑i,j(Xi−Xj)2=∑i,j(Xi2+Xj2−2XiXj)=2n∑iXi2−2(∑iXi)2=2n(∑Xi2−nXˉ2).\sum_{i,j}(X_i-X_j)^2=\sum_{i,j}\bigl(X_i^2+X_j^2-2X_iX_j\bigr)=2n\sum_iX_i^2-2\Bigl(\sum_iX_i\Bigr)^2=2n\Bigl(\sum X_i^2-n\bar X^2\Bigr).

i≠ji\ne j이면 E(Xi−Xj)2=Var⁡(Xi−Xj)=2σ2E(X_i-X_j)^2=\Var(X_i-X_j)=2\sigma^2이고 i=ji=j인 항은 0이므로 E∑i,j(Xi−Xj)2=n(n−1)⋅2σ2E\sum_{i,j}(X_i-X_j)^2=n(n-1)\cdot2\sigma^2. 2n2n으로 나누면 (n−1)σ2(n-1)\sigma^2이다. 이 식은 μ\mu를 전혀 쓰지 않는다. S2S^2는 “두 관측의 차이의 제곱의 절반”의 평균이다.

연습 1.2 (표본분산의 분산 ★★★) μ4=E(X−μ)4\mu_4=E(X-\mu)^4이 유한하면 Var⁡S2=1n(μ4−n−3n−1σ4)\Var S^2=\tfrac1n\bigl(\mu_4-\tfrac{n-3}{n-1}\sigma^4\bigr)임을 보여라. 정규이면 μ4=3σ4\mu_4=3\sigma^4이므로 2σ4n−1\tfrac{2\sigma^4}{n-1}이다. 꼬리가 무거운 분포(큰 μ4\mu_4)에서 S2S^2가 크게 흔들리는 이유다.

풀이

μ=0\mu=0으로 놓는다. 앞 연습으로 S2=1N∑i<jhijS^2=\tfrac1N\sum_{i<j}h_{ij}, hij=12(Xi−Xj)2h_{ij}=\tfrac12(X_i-X_j)^2, N=(n2)N=\tbinom n2이다. 쌍 (i,j)(i,j)와 (k,l)(k,l)이 겹치지 않으면 hijh_{ij}와 hklh_{kl}은 독립이다. 한 첨자만 겹치면(예: hijh_{ij}와 hikh_{ik}) XiX_i가 주어질 때 둘은 독립이고, g(Xi)=E(hij∣Xi)=Xi2+σ22g(X_i)=E(h_{ij}\mid X_i)=\tfrac{X_i^2+\sigma^2}2이다. 반복기댓값(3회 정리 2.5)으로 E(hijhik)=E g(Xi)2E(h_{ij}h_{ik})=E\,g(X_i)^2, Ehij=E g(Xi)Eh_{ij}=E\,g(X_i)이므로

Cov⁡(hij,hik)=Var⁡g(Xi)=14Var⁡Xi2=μ4−σ44=:ζ1.\Cov(h_{ij},h_{ik})=\Var g(X_i)=\tfrac14\Var X_i^2=\tfrac{\mu_4-\sigma^4}4=:\zeta_1 .

같은 쌍이면 Var⁡hij=14(E(Xi−Xj)4−4σ4)=14(2μ4+6σ4−4σ4)=μ4+σ42=:ζ2\Var h_{ij}=\tfrac14\bigl(E(X_i-X_j)^4-4\sigma^4\bigr)=\tfrac14(2\mu_4+6\sigma^4-4\sigma^4)=\tfrac{\mu_4+\sigma^4}2=:\zeta_2. 쌍 하나마다 한 첨자만 겹치는 쌍이 2(n−2)2(n-2)개이므로

Var⁡S2=1N2⋅N(ζ2+2(n−2)ζ1)=(μ4+σ4)+(n−2)(μ4−σ4)n(n−1)=1n(μ4−n−3n−1σ4).\Var S^2=\frac1{N^2}\cdot N\bigl(\zeta_2+2(n-2)\zeta_1\bigr)=\frac{(\mu_4+\sigma^4)+(n-2)(\mu_4-\sigma^4)}{n(n-1)}=\frac1n\Bigl(\mu_4-\frac{n-3}{n-1}\sigma^4\Bigr).

연습 1.3 (두 관측의 분산 ★) n=2n=2이면 S2=12(X1−X2)2S^2=\tfrac12(X_1-X_2)^2임을 보여라. X1−X2∼N(0,2σ2)X_1-X_2\sim\N(0,2\sigma^2)을 써서 S2/σ2∼χ2(1)S^2/\sigma^2\sim\chi^2(1)을 직접 확인하라.

풀이

Xˉ=X1+X22\bar X=\tfrac{X_1+X_2}2이므로 X1−Xˉ=X1−X22=−(X2−Xˉ)X_1-\bar X=\tfrac{X_1-X_2}2=-(X_2-\bar X)이고 S2=11⋅2⋅(X1−X2)24=(X1−X2)22S^2=\tfrac11\cdot2\cdot\tfrac{(X_1-X_2)^2}4=\tfrac{(X_1-X_2)^2}2. X1−X2∼N(0,2σ2)X_1-X_2\sim\N(0,2\sigma^2)이므로 X1−X22σ∼N(0,1)\tfrac{X_1-X_2}{\sqrt2\sigma}\sim\N(0,\allowbreak 1)이고 S2/σ2S^2/\sigma^2는 그 제곱, 곧 χ2(1)\chi^2(1)(4회 정리 3.9).

연습 1.4 (nn으로 나눈 추정량 ★★) 정규 표본에서 σ^c2=c∑(Xi−Xˉ)2\hat\sigma^2_c=c\sum(X_i-\bar X)^2의 평균제곱오차 E(σ^c2−σ2)2E(\hat\sigma_c^2-\sigma^2)^2을 가장 작게 하는 cc는 1n+1\tfrac1{n+1}임을 보여라(Var⁡S2=2σ4n−1\Var S^2=\tfrac{2\sigma^4}{n-1}을 쓴다). 불편성과 평균제곱오차는 다른 기준이다(9회, 16회).

풀이

Q=∑(Xi−Xˉ)2Q=\sum(X_i-\bar X)^2이면 EQ=(n−1)σ2EQ=(n-1)\sigma^2, Var⁡Q=2(n−1)σ4\Var Q=2(n-1)\sigma^4(따름정리 2.3). 평균제곱오차는 분산 더하기 편의의 제곱이므로

MSE(c)=c2⋅2(n−1)σ4+(c(n−1)−1)2σ4.\mathrm{MSE}(c)=c^2\cdot2(n-1)\sigma^4+\bigl(c(n-1)-1\bigr)^2\sigma^4 .

cc로 미분해 0으로 놓으면 4c(n−1)+2(n−1)(c(n−1)−1)=04c(n-1)+2(n-1)\bigl(c(n-1)-1\bigr)=0, 곧 c(n+1)=1c(n+1)=1. 그때 MSE=2σ4n+1\mathrm{MSE}=\tfrac{2\sigma^4}{n+1}이고, c=1n−1c=\tfrac1{n-1}이면 2σ4n−1\tfrac{2\sigma^4}{n-1}, c=1nc=\tfrac1n이면 (2n−1)σ4n2\tfrac{(2n-1)\sigma^4}{n^2}이다. 불편인 S2S^2가 평균제곱오차로는 가장 나쁘다. 조금 작게 어림하는 대신 흔들림을 줄이는 쪽이 이득이다.

이 회차에서 읽은 절 0개 · 회차 차례