
테마
6회 · Student의 t · 노트
6 데이터로 — Student의 카드 실험 (1908)
역사 Student는 자기가 유도한 분포를 실험으로 확인했다. 재료는 W. R. Macdonell이 1902년 Biometrika에 발표한 잉글랜드와 웨일스의 성인 남자 수감자 3,000명의 키와 왼손 가운뎃손가락 길이였다. 그는 3,000장의 카드에 측정값을 적어 잘 섞은 뒤 넷씩 뽑아 750개의 표본을 만들었다. 표본마다 평균과 표준편차를 손으로 계산하고, 그 분포를 자기 곡선과 비교했다. 오늘 말로 하면 통계학 최초의 체계적인 Monte Carlo 실험이다. 결과는 곡선과 잘 맞았고, Student는 논문의 한 절을 이 “실제 시험”에 썼다.
6.1 모집단
Macdonell의 자료는 R 패키지 HistData에 MacdonellDF로 남아 있다. 키는 1인치 간격의 계급으로 기록되어 서로 다른 값이 20개뿐이다. 3,000명을 하나의 모집단으로 보면 평균은 인치, 표준편차는 인치이고, 왜도 와 초과첨도 로 정규에 가깝다(그림 6.1 왼쪽). Student가 아는 것은 이 와 였으므로, 표본마다 계산한 가 이론 분포를 따르는지 바로 확인할 수 있었다.
6.2 재현
카드를 섞는 일은 무작위 순열 하나다. 3,000개의 값을 섞어 배열로 바꾸면 Student의 750개 표본이 된다(노트북, 난수 씨앗 1907).
알고리즘 6.1 (Student의 카드 실험)
- 1.
모집단 의 평균 를 계산한다.
- 2.
무작위 순열 로 을 넷씩 끊어 표본 을 만든다.
- 3.
표본마다 를 계산한다(인 표본은 뺀다).
- 4.
의 분포를 과 에 비교한다.
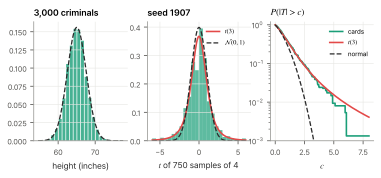
예제 6.2 (750개의 ) 씨앗 1907의 재현에서 네 값이 모두 같은 계급에 들어 인 표본이 1개 나왔다(계급으로 묶인 자료의 흔적이다. 기대 개수는 ). 나머지 749개 가운데
| 재현 (씨앗 1907) | 섞기 400번의 평균 | 이론 | |
|---|---|---|---|
| 14.2% | 14.3% | 14.5% | |
| 4.5% | 5.0% | 5.0% | |
| 0.8% | 0.9% | 1.0% |
를 아는 것처럼 1.96을 쓰면 “5%”가 실제로는 14%다. 은 실험과 맞는다. 경험 분포함수와 이론 분포함수의 최대 거리로 비교하는 Kolmogorov–Smirnov 검정에서 과의 차이는 우연으로 설명되고(유의확률 0.30), 표준정규와의 차이는 그렇지 않다(0.005).
손가락 길이로 같은 실험을 하면 결과는 더 좋다(연습 6.1). 계급이 0.1cm로 더 촘촘하기 때문이다. 키에서 의 분포가 과 조금 어긋나는 것(유의확률 0.03)도 계급의 효과다. Student도 이것을 알아채고 계급 폭을 보정(Sheppard의 수정)한 뒤 비교했다.
실험의 뜻 Student는 증명하지 못한 가정() 위에 분포를 세웠고, 그 결과를 계산 실험으로 확인했다. 정리가 맞는지 모를 때 시뮬레이션으로 점검하는 습관은 오늘의 통계학과 기계학습의 기본 도구다. Student는 750묶음을 손으로 계산했고, 노트북은 400번의 반복을 몇 초 안에 한다. 7회에서 Monte Carlo의 오차 자체를 정리로 다룬다.
6.3 유한 모집단
카드 실험은 되돌려 넣지 않는 뽑기다. 3,000장 가운데 4장을 뽑으면 이고(4회의 초기하 분산과 같은 이유), 이므로 차이는 무시할 만하다. 그리고 750개의 표본은 서로 겹치지 않으므로 표본들끼리도 약하게 의존한다. 모두 이 작으면 사라지는 효과다.
연습문제
연습 6.1 (손가락으로 ★) 노트북의 실험을 손가락 길이로 되풀이하라. 의 비율과 의 분포를 키의 경우와 비교하라.
풀이
씨앗 1907에서 손가락 길이의 비율은 6.3%(섞기 400번의 평균 4.7%), 과의 Kolmogorov–Smirnov 유의확률은 0.94다. 와 의 비교에서 유의확률은 0.31로, 키의 0.03보다 훨씬 잘 맞는다. 400번 평균으로도 키 0.08, 손가락 0.48이다. 계급이 촘촘할수록(손가락 0.1cm, 키 1인치) 연속 분포의 이론과 잘 맞는다. 인 표본도 손가락에서는 거의 나오지 않는다(평균 0.12개).
연습 6.2 (Student의 ★★) Student는 , 를 썼다. 임을 보이고, 의 밀도가 에 비례함을 정리 3.2에서 유도하라.
풀이
이므로 . 로 두면 2회 예제 4.5(척도)로 .
연습 6.3 (같은 계급에 넷 ★★) 계급 의 비율이 이면 되돌려 넣는 뽑기에서 네 값이 모두 같은 계급일 확률은 이다. 키 자료에서 이 값을 계산하고, 750개 가운데 인 표본의 기대 개수를 구하라. 되돌려 넣지 않는 뽑기에서는 식이 어떻게 바뀌나?
풀이
키 자료의 20개 계급 비율로 이고, 750개 가운데 기대 개수는 이다. 되돌려 넣지 않으면 계급 의 개수를 라 할 때 로 거의 같다. 실제로 섞기 400번에서 인 표본은 평균 1.50개였다.
연습 6.4 (섞기의 변동 ★★) 카드를 400번 섞어 매번 의 비율을 기록하라. 그 비율들의 표준편차를 이항 근사 와 비교하라. 씨앗 1908로 섞으면 이 비율이 3.2%다. 드문 결과인가?
풀이
400번의 비율들의 표준편차는 로 이항 근사 과 거의 같다. 750개의 표본이 거의 독립인 시행처럼 행동한다. 씨앗 1908의 3.2%는 평균 5.0%보다 표준편차의 2.3배 아래이고, 400번 가운데 이만큼 낮은 것은 1번(0.25%)뿐이었다. 드물지만 일어난다. 한 번의 Monte Carlo 실험은 그 자체가 오차를 가진 표본이다. Student의 실험도 마찬가지였고, 7회에서 이 오차를 정리로 다룬다.