Skip to content

6회 · Student의 t · 노트

5 축량과 tt-구간 ​

5.1 축량 ​

정의 5.1 (축량) 자료 X\X와 모수 θ\theta의 함수 Q(X,θ)Q(\X,\theta)의 분포가 θ\theta(와 다른 모르는 모수)에 의존하지 않으면 QQ를 축량(pivot)이라 한다.

정리 3.4의 T=Xˉ−μS/nT=\tfrac{\bar X-\mu}{S/\sqrt n}는 μ\mu와 σ\sigma가 무엇이든 t(n−1)t(n-1)을 따르므로 축량이다. 축량이 있으면 분포의 분위수로 확률 문장을 쓰고, 그 문장을 θ\theta에 대해 풀어 구간을 얻는다.

정리 5.2 (tt-구간) X1,…,Xn∼iidN(μ,σ2)X_1,\allowbreak \dots,\allowbreak X_n\iid\N(\mu,\allowbreak \sigma^2)이고 c=tn−1, α/2c=t_{n-1,\,\alpha/2}이면, 모든 μ\mu와 σ\sigma에서

P(Xˉ−c Sn≤μ≤Xˉ+c Sn)=1−α.P\Bigl(\bar X-c\,\frac S{\sqrt n}\le\mu\le\bar X+c\,\frac S{\sqrt n}\Bigr)=1-\alpha .

증명 전략 축량 TT에 대한 확률 문장을 μ\mu에 대해 푼다. 확률은 TT의 분포만으로 정해지므로 μ\mu와 σ\sigma에 의존하지 않는다.

  1. S>0S>0이면 Xˉ−cSn≤μ≤Xˉ+cSn\bar X-c\frac S{\sqrt n}\le\mu\le\bar X+c\frac S{\sqrt n}은 −c≤Xˉ−μS/n≤c-c\le\frac{\bar X-\mu}{S/\sqrt n}\le c, 곧 ∣T∣≤c|T|\le c와 같은 사건이다.부등식에 n/S>0\sqrt n/S>0을 곱한다

  2. T∼t(n−1)T\sim t(n-1)이고 tt 분포는 연속이므로 P(∣T∣≤c)=Fn−1(c)−Fn−1(−c)P(|T|\le c)=F_{n-1}(c)-F_{n-1}(-c)이다.정리 3.4

  3. 대칭으로 Fn−1(−c)=1−Fn−1(c)=α2F_{n-1}(-c)=1-F_{n-1}(c)=\tfrac\alpha2이고, cc의 정의로 Fn−1(c)=1−α2F_{n-1}(c)=1-\tfrac\alpha2이다.정리 3.3(a)

  4. 따라서 확률은 1−α2−α2=1−α1-\tfrac\alpha2-\tfrac\alpha2=1-\alpha이다. 이 값에는 μ\mu도 σ\sigma도 들어 있지 않다.2 3

조건 확인 1은 S>0S>0을 쓴다. n≥2n\ge2이면 {S=0}={X1=⋯=Xn}\{S=0\}=\{X_1=\cdots=X_n\}이고, 연속분포에서 P(X2=X1)=0P(X_2=X_1)=0이므로 이 사건의 확률은 0이다.

확률 문장의 주어는 무작위인 구간이지 고정된 μ\mu가 아니다. “같은 방법으로 구간을 100번 만들면 약 95번 μ\mu를 포함한다”가 정확한 읽기다. Neyman(1937)이 이 해석에 “신뢰구간”이라는 이름을 붙였고, 8회에서 신뢰구간 일반을 다룬다. 구간의 길이 2c S/n2c\,S/\sqrt n은 무작위다. 평균 길이는 2c c4(n)σ/n2c\,c_4(n)\sigma/\sqrt n(연습 2.4)이고, σ\sigma를 알 때의 2⋅1.96 σ/n2\cdot1.96\,\sigma/\sqrt n과 비교하면 n=4n=4에서 3.182⋅0.9211.96≈1.50\tfrac{3.182\cdot0.921}{1.96}\approx1.50배 길다. 모르는 것 하나의 값이다.

5.2 대응 비교 — Cushny와 Peebles의 수면제 (1905) ​

역사 약리학자 Cushny와 Peebles는 1905년 정신병원 환자 11명에게 hyoscine과 hyoscyamine 계열의 약을 밤을 바꿔 가며 주고, 약을 주지 않은 밤과 수면 시간을 비교했다. Student(1908)는 이 자료로 작은 표본의 비교를 보였고, Fisher(1925)도 같은 자료를 썼다. 두 사람 모두 약의 이름을 잘못 옮겨 적었다는 것이 나중에 밝혀졌다(Senn과 Richardson, 1994). R의 sleep 자료는 처음 10명에 대해 L-hyoscyamine과 L-hyoscine이 대조 밤보다 늘린 수면 시간이다.

같은 환자에게 두 처리를 주면 환자마다의 차이 Di=Xi−YiD_i=X_i-Y_i를 본다. 환자 사이의 큰 차이(어떤 사람은 원래 잘 잔다)가 빼기에서 사라지므로 비교가 정밀해진다. Di∼iidN(μD,σD2)D_i\iid\N(\mu_D,\sigma_D^2)로 놓으면 정리 5.2을 DD에 그대로 쓴다.

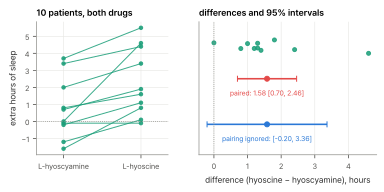
예제 5.3 (수면제의 대응 tt) sleep 자료의 두 약의 차이(L-hyoscine −- L-hyoscyamine) 10개는 평균 dˉ=1.58\bar d=1.58시간, 표준편차 sd=1.23s_d=1.23이다.

t=1.581.23/10=4.06,P(∣T9∣≥4.06)=0.0028,95% 구간:  1.58±2.262⋅1.2310=[0.70, 2.46].\begin{gather*} t=\frac{1.58}{1.23/\sqrt{10}}=4.06,\qquad P(|T_9|\ge4.06)=0.0028,\\ 95\%\text{ 구간: }\ 1.58\pm2.262\cdot\frac{1.23}{\sqrt{10}}=[0.70,\ 2.46] . \end{gather*}

L-hyoscine이 L-hyoscyamine보다 수면을 0.7–2.5시간 더 늘린다. 같은 20개의 수를 대응을 무시하고 두 독립 표본으로 비교하면(아래 정리 5.4) t=1.86t=1.86, p=0.079p=0.079로 약해진다. 환자 사이의 변동이 차이를 가렸기 때문이다. 대조 밤과 비교하면 L-hyoscyamine의 효과는 0.750.75시간(t=1.33t=1.33, p=0.22p=0.22)으로 불분명하고, L-hyoscine은 2.332.33시간(t=3.68t=3.68, p=0.005p=0.005)이다.

그림 5.1. 왼쪽: 환자 10명의 두 약에 대한 수면 증가(선으로 이은 쌍). 거의 모든 선이 오른쪽으로 올라간다. 오른쪽: 차이 10개와 평균의 95% t-구간.
그림 5.1 왼쪽: 환자 10명의 두 약에 대한 수면 증가(선으로 이은 쌍). 거의 모든 선이 오른쪽으로 올라간다. 오른쪽: 차이 10개와 평균의 95% tt-구간.

대응이 도움이 되는 이유는 3회의 공분산이다. Var⁡(X−Y)=σX2+σY2−2ρσXσY\Var(X-Y)=\sigma_X^2+\sigma_Y^2-2\rho\sigma_X\sigma_Y이고, 같은 환자의 두 측정은 ρ\rho가 커서 차이의 분산이 작다. sleep에서 두 약의 상관은 0.800.80이다.

5.3 두 독립 표본 ​

정리 5.4 (두 표본 tt (등분산)) X1,…,Xm∼iidN(μ1,σ2)X_1,\allowbreak \dots,\allowbreak X_m\iid\N(\mu_1,\allowbreak \sigma^2)과 Y1,…,Yn∼iidN(μ2,σ2)Y_1,\allowbreak \dots,\allowbreak Y_n\iid\N(\mu_2,\allowbreak \sigma^2)가 독립이고 분산이 같으면, 합동분산 Sp2=(m−1)SX2+(n−1)SY2m+n−2S_p^2=\dfrac{(m-1)S_X^2+(n-1)S_Y^2}{m+n-2}에 대해

T=(Xˉ−Yˉ)−(μ1−μ2)Sp1m+1n ∼ t(m+n−2).T=\frac{(\bar X-\bar Y)-(\mu_1-\mu_2)}{S_p\sqrt{\frac1m+\frac1n}}\ \sim\ t(m+n-2) .

증명 전략 정리 3.4처럼 표준정규를, 그와 독립인 χ2\chi^2를 자유도로 나눈 것의 제곱근으로 나눈 꼴을 만든다. 두 표본에 Student의 정리를 따로 쓰고 독립을 합친다.

  1. Xˉ−Yˉ∼N(μ1−μ2, σ2(1m+1n))\bar X-\bar Y\sim\N\bigl(\mu_1-\mu_2,\allowbreak \ \sigma^2(\tfrac1m+\tfrac1n)\bigr)이므로 Z=(Xˉ−Yˉ)−(μ1−μ2)σ1/m+1/n∼N(0,1)Z=\tfrac{(\bar X-\bar Y)-(\mu_1-\mu_2)}{\sigma\sqrt{1/m+1/n}}\sim\N(0,\allowbreak 1)이다.정리 2.2(a), 5회 정리 1.8(iv)

  2. (m−1)SX2σ2∼χ2(m−1)\tfrac{(m-1)S_X^2}{\sigma^2}\sim\chi^2(m-1), (n−1)SY2σ2∼χ2(n−1)\tfrac{(n-1)S_Y^2}{\sigma^2}\sim\chi^2(n-1)이고, 두 표본이 독립이므로 둘도 독립이다.정리 2.2(c)

  3. V=(m+n−2)Sp2σ2V=\tfrac{(m+n-2)S_p^2}{\sigma^2}는 2의 두 변수의 합이므로 χ2(m+n−2)\chi^2(m+n-2)이다.4회 정리 3.7

  4. Xˉ⊥SX2\bar X\perp S_X^2, Yˉ⊥SY2\bar Y\perp S_Y^2이고 두 표본이 독립이므로 Xˉ,SX2,Yˉ,SY2\bar X,S_X^2,\bar Y,S_Y^2는 상호 독립이다. ZZ는 (Xˉ,Yˉ)(\bar X,\bar Y)의, VV는 (SX2,SY2)(S_X^2,S_Y^2)의 함수이므로 Z⊥VZ\perp V이다.정리 2.2(b), 3회 3.2절의 상자

  5. T=ZV/(m+n−2)T=\tfrac Z{\sqrt{V/(m+n-2)}}이다. 분자와 분모의 σ\sigma가 소거된다. 정의 3.1로 T∼t(m+n−2)T\sim t(m+n-2)이다.대수, 정의 3.1

조건 확인 등분산은 3에서 쓰인다. 두 χ2\chi^2를 같은 σ2\sigma^2로 나눠야 합이 다시 χ2\chi^2가 된다. σ1≠σ2\sigma_1\ne\sigma_2이면 Sp2S_p^2는 σ2\sigma^2 하나의 추정량이 아니고, 아래 주의의 문제가 생긴다.

가정 주의 등분산 가정이 틀리고 표본 크기도 다르면 정리 5.4의 구간은 크게 틀린다. 작은 표본 쪽의 분산이 크면 실제 포함확률이 95%보다 훨씬 낮다(연습 5.4). 두 분산이 다를 때의 정확한 축량은 없다(Behrens–Fisher 문제). 실무에서는 분모를 SX2/m+SY2/n\sqrt{S_X^2/m+S_Y^2/n}으로 두고 자유도를 어림하는 Welch(1947)의 근사를 쓴다.

연습문제

연습 5.1 (구간의 평균 길이 ★) n=4,10,30n=4,10,30에서 tt-구간의 평균 길이와 σ\sigma를 알 때의 구간 길이의 비 tn−1,0.025 c4(n)1.96\tfrac{t_{n-1,0.025}\,c_4(n)}{1.96}을 구하라.

풀이

비 tn−1,0.025c4(n)/1.96t_{n-1,0.025}c_4(n)/1.96은 n=4n=4에서 3.182×0.921/1.96=1.503.182\times0.921/1.96=1.50, n=10n=10에서 2.262×0.973/1.96=1.122.262\times0.973/1.96=1.12, n=30n=30에서 1.0351.035다. σ\sigma를 모르는 값은 n=4n=4에서 구간 길이의 50%, n=30n=30에서 3.5%다.

연습 5.2 (몇 개를 재야 하나 ★★) 평균의 95% 구간의 반폭을 σ/2\sigma/2 이하로 평균적으로 만들려면 nn이 얼마여야 하나? tn−1,0.025 c4(n)/n≤12t_{n-1,0.025}\,c_4(n)/\sqrt n\le\tfrac12을 만족하는 가장 작은 nn을 노트북으로 찾고, σ\sigma를 알 때의 n=16n=16과 비교하라.

풀이

tn−1,0.025c4(n)/nt_{n-1,0.025}c_4(n)/\sqrt n은 n=17n=17에서 0.5060.506, n=18n=18에서 0.4900.490이므로 n=18n=18. σ\sigma를 알면 1.96/n≤121.96/\sqrt n\le\tfrac12에서 n=16n=16이다. σ\sigma를 모르는 값은 관측 두 개다.

연습 5.3 (대응의 이득 ★) sleep에서 두 약의 표본분산과 상관계수로 sd2=sX2+sY2−2rsXsYs_d^2=s_X^2+s_Y^2-2r s_Xs_Y를 확인하라. 대응하지 않은 두 표본 tt의 분모와 비교해 대응이 분산을 몇 배 줄였는지 말하라.

풀이

sX2=3.201s_X^2=3.201, sY2=4.009s_Y^2=4.009, r=0.795r=0.795이므로 sX2+sY2−2rsXsY=3.201+4.009−2(0.795)(1.789)(2.002)=1.513=sd2s_X^2+s_Y^2-2rs_Xs_Y=3.201+4.009-2(0.795)(1.789)(2.002)=1.513=s_d^2. 대응하지 않으면 차이의 분산을 sX2+sY2=7.21s_X^2+s_Y^2=7.21로 어림하므로, 대응이 분산을 7.21/1.513=4.87.21/1.513=4.8배 줄였다. 표준오차로는 0.8490.849에서 0.3890.389로 2.2배다.

연습 5.4 (등분산이 아닐 때 ★★) m=5m=5, σ1=3\sigma_1=3과 n=20n=20, σ2=1\sigma_2=1에서 정리 5.4의 95% 구간의 실제 포함확률을 시뮬레이션으로 구하라. Welch 구간(scipy.stats.ttest_ind(..., equal_var=False)의 방식)은 어떤가?

풀이

5만 번 이상의 시뮬레이션에서 합동 tt의 포함확률은 약 0.730.73, Welch 구간은 0.950.95다. 합동분산은 큰 표본(분산 1)에 무게를 두어 Sp2≈4⋅9+19⋅123=2.4S_p^2\approx\tfrac{4\cdot9+19\cdot1}{23}=2.4가 되고, 이것으로 어림한 Var⁡(Xˉ−Yˉ)\Var(\bar X-\bar Y)는 2.4(15+120)=0.602.4(\tfrac15+\tfrac1{20})=0.60이지만 참값은 95+120=1.85\tfrac95+\tfrac1{20}=1.85다. 구간이 1.85/0.60≈1.76\sqrt{1.85/0.60}\approx1.76배 너무 짧다. 거꾸로 큰 표본 쪽의 분산이 크면 포함확률이 0.9980.998로 지나치게 보수적이다.

연습 5.5 (한쪽 구간 ★) μ\mu의 95% 한쪽 구간 (−∞, Xˉ+tn−1,0.05S/n]\bigl(-\infty,\allowbreak \ \bar X+t_{n-1,0.05}S/\sqrt n\bigr]의 포함확률이 0.95임을 보이고, sleep의 차이로 계산하라.

풀이

P(μ≤Xˉ+tn−1,0.05S/n)=P(T≥−tn−1,0.05)=1−0.05P\bigl(\mu\le\bar X+t_{n-1,0.05}S/\sqrt n\bigr)=P(T\ge-t_{n-1,0.05})=1-0.05 (tt의 대칭). sleep의 차이에서 t9,0.05=1.833t_{9,0.05}=1.833이므로 위쪽 한계는 1.58+1.833⋅1.23/10=2.291.58+1.833\cdot1.23/\sqrt{10}=2.29, 같은 방법의 아래쪽 한계는 0.870.87이다. “L-hyoscine은 수면을 적어도 0.87시간 더 늘린다”가 95% 한쪽 문장이다.

이 회차에서 읽은 절 0개 · 회차 차례