Skip to content

6회 · Student의 t · 노트

8 Beautiful insights — 작은 표본의 분포, 오늘의 문제 ​

8.1 예측구간 — 다음 한 사람 ​

tt-구간은 평균 μ\mu의 구간이다. 다음 환자 한 사람의 수면 증가를 묻는다면 다른 구간이 필요하다.

정리 8.1 (예측구간) X1,…,Xn,Xnew∼iidN(μ,σ2)X_1,\allowbreak \dots,\allowbreak X_n,\allowbreak X_{\mathrm{new}}\iid\N(\mu,\allowbreak \sigma^2)이면

Xnew−XˉS1+1n ∼ t(n−1),\frac{X_{\mathrm{new}}-\bar X}{S\sqrt{1+\frac1n}}\ \sim\ t(n-1),

따라서 Xˉ±tn−1,α/2 S1+1n\bar X\pm t_{n-1,\alpha/2}\,S\sqrt{1+\tfrac1n}은 XnewX_{\mathrm{new}}를 확률 1−α1-\alpha로 포함한다.

증명 전략 Xnew−XˉX_{\mathrm{new}}-\bar X가 정규이고 S2S^2와 독립임을 보이면, 정리 3.4의 증명과 같은 꼴이 된다. 단계별 증명은 연습 8.6(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

sleep에서 다음 환자의 차이에 대한 95% 예측구간은 1.58±2.262⋅1.231.1=[−1.34, 4.50]1.58\pm2.262\cdot1.23\sqrt{1.1}=[-1.34,\allowbreak \ 4.50]이다. 평균의 구간 [0.70, 2.46][0.70,\ 2.46]보다 훨씬 넓고, 0을 포함한다. 평균적으로는 L-hyoscine이 낫다는 것이 분명해도 다음 환자 한 사람에게는 그렇지 않을 수 있다. n→∞n\to\infty이면 평균의 구간은 한 점으로 줄지만 예측구간은 μ±1.96σ\mu\pm1.96\sigma로 남는다. 모델의 “불확실성”을 말할 때 이 둘(추정의 불확실성과 관측 자체의 흩어짐)을 구별해야 한다.

8.2 작은 배치의 BatchNorm ​

신경망의 배치 정규화(Ioffe와 Szegedy, 2015)는 미니배치 x1,…,xBx_1,\dots,x_B의 각 값을 배치 평균과 배치 표준편차로 표준화한다.

x^i=xi−xˉBσ^B,σ^B2=1B∑j=1B(xj−xˉB)2.\hat x_i=\frac{x_i-\bar x_B}{\hat\sigma_B},\qquad \hat\sigma_B^2=\frac1B\sum_{j=1}^B(x_j-\bar x_B)^2 .

(실제로는 σ^B2\hat\sigma_B^2에 작은 ε\varepsilon을 더하고, 뒤에 학습되는 척도와 위치를 곱하고 더한다.) 이것은 이 노트의 표준화와 같은 연산이고, BB가 작으면 이 노트의 모든 현상이 일어난다.

명제 8.2 (배치 안의 값은 유계다) ∣x^i∣≤B−1|\hat x_i|\le\sqrt{B-1}이다. 특히 B=2B=2이면 x^1=−x^2=±1\hat x_1=-\hat x_2=\pm1이다.

증명 전략 편차의 합이 0이라는 제약으로 did_i를 나머지 편차의 합으로 쓰고 Cauchy–Schwarz 부등식을 쓴다 [T4]. 단계별 증명은 연습 8.7(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

B=2B=2이면 BatchNorm의 출력은 “두 값 가운데 어느 쪽이 큰가”라는 부호 하나뿐이다. 크기의 정보가 모두 사라진다. B=4B=4이면 출력은 [−3,3][-\sqrt3,\sqrt3] 안에 갇힌다. 그런데 학습이 끝난 뒤 추론할 때는 배치 통계량 대신 학습 중에 모은 이동평균, 곧 모집단의 μ\mu와 σ\sigma에 가까운 값으로 표준화하므로 출력은 유계가 아니다. 학습 때 본 분포와 추론 때 받는 분포가 다르다. 그리고 그 이동평균 자체가 흔들린다. 배치 4개의 분산은 따름정리 2.3로 표준편차가 σ22/3\sigma^2\sqrt{2/3}이고, 운동량 0.1의 이동평균으로 다듬어도 σ2\sigma^2의 약 19%가 남는다(노트북). 작은 배치에서 BatchNorm의 성능이 급격히 떨어지는 이유의 하나이고, 배치 통계량에 의존하지 않는 Layer Norm·Group Norm(Wu와 He, 2018)이나 Batch Renormalization(Ioffe, 2017)이 그 대안으로 나왔다.

반대로 새 값 하나를 작은 배치의 통계량으로 표준화하면 정리 8.1의 tt가 나온다. 정규 활성값에서 xnew−xˉBσ^B\tfrac{x_{\mathrm{new}}-\bar x_B}{\hat\sigma_B}의 분산은 B+1B−3\tfrac{B+1}{B-3}이고(연습 8.2), B=4B=4이면 5, B=32B=32이면 1.14다. 배치의 표준편차가 우연히 작으면 값이 크게 튀는 것은 Student가 1908년에 본 바로 그 현상이다.
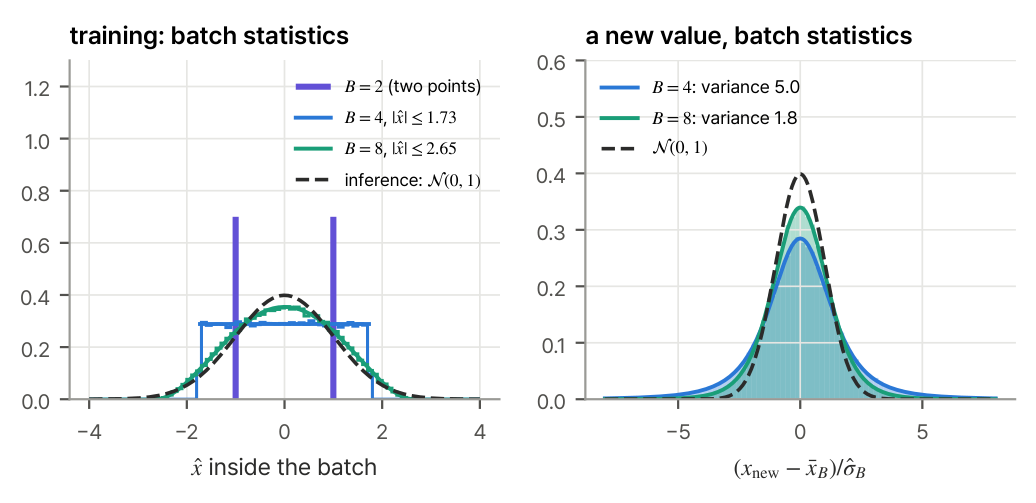
그림 8.1. 왼쪽: 배치 안에서 표준화한 값의 분포(B=2,4,8). B=2이면 ±1 두 점, B=4이면 [-√3,√3]의 균등분포다(연습 8.3). 점선은 추론 때의 N(0,1). 오른쪽: 새 값을 배치의 통계량으로 표준화하면 꼬리가 두꺼운 t 꼴이다(실선: 이론 밀도, 히스토그램: 시뮬레이션).
그림 8.1 왼쪽: 배치 안에서 표준화한 값의 분포(B=2,4,8B=2,4,8). B=2B=2이면 ±1\pm1 두 점, B=4B=4이면 [−3,3][-\sqrt3,\sqrt3]의 균등분포다(연습 8.3). 점선은 추론 때의 N(0,1)\N(0,1). 오른쪽: 새 값을 배치의 통계량으로 표준화하면 꼬리가 두꺼운 tt 꼴이다(실선: 이론 밀도, 히스토그램: 시뮬레이션).

8.3 t-SNE — 지도를 그릴 때 꼬리가 필요하다 ​

t-SNE(van der Maaten과 Hinton, 2008)는 고차원의 점들을 2차원 지도에 그린다. 고차원에서는 점 ii와 jj의 유사도를 정규 커널 exp⁡(−∥xi−xj∥2/2σi2)\exp(-\|x_i-x_j\|^2/2\sigma_i^2)로 재고, 지도에서는 자유도 1인 tt 커널

qij∝(1+∥yi−yj∥2)−1q_{ij}\propto\bigl(1+\|y_i-y_j\|^2\bigr)^{-1}

로 잰다. 두 유사도 분포가 같아지도록 지도의 점 yiy_i를 옮긴다. 왜 지도 쪽만 tt인가? 고차원에서는 한 점 주위에 “적당히 먼” 이웃이 아주 많을 수 있는데, 2차원에는 그들을 모두 같은 거리에 놓을 자리가 없다(군집 문제, crowding problem). 꼬리가 두꺼운 커널은 적당히 먼 점들을 지도에서 훨씬 멀리 놓아도 유사도가 크게 줄지 않게 해 준다. 최댓값의 1%의 유사도가 정규 커널에서는 거리 3.03.0, t(1)t(1) 커널에서는 거리 9.99.9에서 나온다(그림 8.2). 그래서 t-SNE의 지도는 군집 사이가 시원하게 벌어진다. 그 대신 지도의 군집 사이 거리는 원래 거리의 척도를 보존하지 않는다.
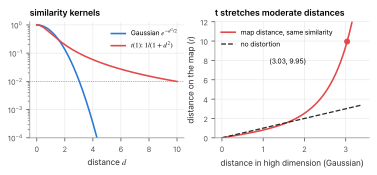
그림 8.2. 왼쪽: 정규 커널과 t(1) 커널의 유사도(로그 눈금). 오른쪽: 같은 유사도를 주는 거리의 대응. 고차원에서 거리 3인 이웃은 지도에서 거리 9.9에 놓여도 된다.
그림 8.2 왼쪽: 정규 커널과 t(1)t(1) 커널의 유사도(로그 눈금). 오른쪽: 같은 유사도를 주는 거리의 대응. 고차원에서 거리 3인 이웃은 지도에서 거리 9.9에 놓여도 된다.

8.4 꼬리가 두꺼운 가능도 — 로버스트 회귀 ​

오차를 정규 대신 t(ν)t(\nu)로 놓으면, 잔차 rr의 음의 로그밀도는 ν+12log⁡(1+r2ν)\tfrac{\nu+1}2\log\bigl(1+\tfrac{r^2}\nu\bigr)이다. 정규의 r22\tfrac{r^2}2와 달리 큰 rr에서 로그로만 자란다. 최대가능도(9회)의 방정식을 쓰면 각 관측이 가중치 w=ν+1ν+r2w=\tfrac{\nu+1}{\nu+r^2}를 받는 가중 최소제곱이 되고, ν=4\nu=4이면 잔차 3인 관측의 가중치는 0.380.38, 잔차 10이면 0.050.05다. 명제 7.3에서 본 이상값의 지배가 저절로 줄어든다. 이 가중치는 연습 3.2의 “정규의 분산 혼합”에서 숨은 정밀도 WW의 조건부 기댓값이고, 10회의 EM 알고리즘이 그것을 반복 계산한다(Lange, Little, Taylor, 1989).

8.5 같은 구간, 다른 해석 ​

Lüroth (1876) 독일의 수학자 Jacob Lüroth는 Student보다 32년 먼저 tt 분포를 유도했다. 그는 오차론의 논문에서 정규 관측의 평균에 대한 베이즈 구간을 계산하다가, 모르는 정밀도를 적분해 없앤 μ\mu의 사후분포로 tt 꼴의 밀도를 얻었다. 이 결과는 측지학 문헌에 묻혀 잊혔다가 Pfanzagl과 Sheynin(1996)이 다시 찾았다.

사전분포를 π(μ,σ)∝1/σ\pi(\mu,\allowbreak \sigma)\propto1/\sigma로 두면 μ\mu의 사후분포는 정확히

μ−xˉs/n ∣ 자료 ∼ t(n−1)\frac{\mu-\bar x}{s/\sqrt n}\ \Big|\ \text{자료}\ \sim\ t(n-1)

이다(연습 8.5). 그러면 95% 사후 구간은 tt-구간과 숫자까지 같다. sleep에서 사후분포를 시뮬레이션하면 [0.70, 2.46][0.70,\ 2.46]이 나온다. 숫자는 같지만 문장은 다르다. 빈도론의 구간은 “이 방법은 95%의 경우에 μ\mu를 잡는다”이고, 베이즈의 구간은 “자료를 본 지금 μ\mu가 이 안에 있을 확률이 95%”다. 16회에서 이 둘이 언제 일치하고 언제 갈라지는지 본다.

연습문제

연습 8.1 (예측구간의 폭 ★) n=4,10,100n=4,10,100에서 95% 예측구간의 반폭 tn−1,0.0251+1/nt_{n-1,0.025}\sqrt{1+1/n}을 계산하고 n→∞n\to\infty의 극한 1.96과 비교하라.

풀이

n=4n=4: 3.1821.25=3.563.182\sqrt{1.25}=3.56, n=10n=10: 2.2621.1=2.372.262\sqrt{1.1}=2.37, n=100n=100: 1.9841.01=1.991.984\sqrt{1.01}=1.99. 극한은 1.961.96이다. 평균의 구간은 0으로 줄지만 예측구간의 반폭은 1.96σ1.96\sigma 아래로 내려가지 않는다.

연습 8.2 (새 값의 분산 ★★) 정규 활성값에서 xnew−xˉBσ^B\tfrac{x_{\mathrm{new}}-\bar x_B}{\hat\sigma_B}의 분산이 B+1B−3\tfrac{B+1}{B-3}임을 보여라(B>3B>3). (힌트: σ^B=S(B−1)/B\hat\sigma_B=S\sqrt{(B-1)/B}로 정리 8.1의 TT로 쓰고, 정리 3.3(b).)

풀이

σ^B=S(B−1)/B\hat\sigma_B=S\sqrt{(B-1)/B}이고 T=xnew−xˉBS1+1/B∼t(B−1)T=\tfrac{x_{\mathrm{new}}-\bar x_B}{S\sqrt{1+1/B}}\sim t(B-1)이므로

xnew−xˉBσ^B=T1+1BBB−1=TB+1B−1.\frac{x_{\mathrm{new}}-\bar x_B}{\hat\sigma_B}=T\sqrt{1+\tfrac1B}\sqrt{\tfrac B{B-1}}=T\sqrt{\tfrac{B+1}{B-1}} .

정리 3.3(b)로 Var⁡T=B−1B−3\Var T=\tfrac{B-1}{B-3}이므로 분산은 B+1B−3\tfrac{B+1}{B-3}.

연습 8.3 (배치 안의 값의 분포 ★★★) 정규 표본에서 x^12B−1∼Beta(12,B−22)\tfrac{\hat x_1^2}{B-1}\sim\mathrm{Beta}\bigl(\tfrac12,\allowbreak \tfrac{B-2}2\bigr)임을 보여라. (힌트: 정리 2.2의 증명처럼 잔차벡터를 Y2,…,YBY_2,\dots,Y_B로 쓰면 x1−xˉx_1-\bar x는 그 가운데 한 방향의 성분이다. 첫 행이 그 방향인 직교행렬로 다시 돌리고 4회 정리 4.2.) B=4B=4이면 x^1\hat x_1이 [−3,3][-\sqrt3,\sqrt3]의 균등분포임을 보여라(그림 8.1의 평평한 선).

풀이

잔차벡터 R=(x1−xˉ,…,xB−xˉ)\mathbf R=(x_1-\bar x,\allowbreak \dots,\allowbreak x_B-\bar x)는 1\mathbf 1에 수직인 (B−1)(B-1)차원 공간 LL에 있다. e1e_1을 LL에 사영한 벡터 e1−1B1e_1-\tfrac1B\mathbf 1의 길이는 (B−1)/B\sqrt{(B-1)/B}이고, 그 방향의 단위벡터 uu를 첫째로 하는 LL의 정규직교기저를 잡으면(Helmert와 같은 방식) 그 좌표 W1,…,WB−1W_1,\dots,W_{B-1}은 정리 2.2의 증명처럼 독립인 N(0,σ2)\N(0,\sigma^2)이다. 그러면 x1−xˉ=⟨R,e1⟩=(B−1)/B W1x_1-\bar x=\langle\mathbf R,\allowbreak e_1\rangle=\sqrt{(B-1)/B}\,W_1이고 Bσ^B2=∥R∥2=∑kWk2B\hat\sigma_B^2=\|\mathbf R\|^2=\sum_kW_k^2이므로

x^12B−1=W12W12+∑k≥2Wk2.\frac{\hat x_1^2}{B-1}=\frac{W_1^2}{W_1^2+\sum_{k\ge2}W_k^2}.

W12/2σ2∼Γ(12,1)W_1^2/2\sigma^2\sim\Gamma(\tfrac12,\allowbreak 1)과 ∑k≥2Wk2/2σ2∼Γ(B−22,1)\sum_{k\ge2}W_k^2/2\sigma^2\sim\Gamma(\tfrac{B-2}2,\allowbreak 1)이 독립이므로 4회 정리 4.2로 Beta(12,B−22)\mathrm{Beta}(\tfrac12,\allowbreak \tfrac{B-2}2). B=2B=2이면 분모의 둘째 항이 없어 값이 1, 곧 x^1=±1\hat x_1=\pm1이다. B=4B=4이면 U=x^12/3∼Beta(12,1)U=\hat x_1^2/3\sim\mathrm{Beta}(\tfrac12,\allowbreak 1), 곧 P(U≤u)=uP(U\le u)=\sqrt u이므로 P(∣x^1∣≤z)=P(U≤z2/3)=z/3P(|\hat x_1|\le z)=P(U\le z^2/3)=z/\sqrt3 (0≤z≤30\le z\le\sqrt3). 대칭과 합치면 x^1∼U(−3,3)\hat x_1\sim U(-\sqrt3,\allowbreak \sqrt3)이다. 네 개로 정규화한 값은 종 모양이 아니라 평평하다.

연습 8.4 (t-SNE의 거리 ★) 유사도가 최댓값의 cc배가 되는 거리를 정규 커널(σ=1\sigma=1)과 t(1)t(1) 커널에서 각각 구하라. c=0.1c=0.1과 0.010.01에서 계산하라.

풀이

정규 커널 e−d2/2=ce^{-d^2/2}=c에서 d=−2log⁡cd=\sqrt{-2\log c}: c=0.1c=0.1이면 2.152.15, c=0.01c=0.01이면 3.033.03. t(1)t(1) 커널 11+d2=c\tfrac1{1+d^2}=c에서 d=1/c−1d=\sqrt{1/c-1}: 3.03.0과 9.959.95. 유사도가 작을수록 t(1)t(1)의 거리가 훨씬 빨리 커진다.

연습 8.5 (Lüroth의 사후분포 ★★★) x1,…,xn∼iidN(μ,σ2)x_1,\allowbreak \dots,\allowbreak x_n\iid\N(\mu,\allowbreak \sigma^2)이고 π(μ,σ)∝1/σ\pi(\mu,\allowbreak \sigma)\propto1/\sigma이면, 결합 사후밀도는 σ−(n+1)exp⁡(−(n−1)s2+n(μ−xˉ)22σ2)\sigma^{-(n+1)}\exp\bigl(-\tfrac{(n-1)s^2+n(\mu-\bar x)^2}{2\sigma^2}\bigr)에 비례한다. σ\sigma로 적분해 μ\mu의 사후밀도가 (1+n(μ−xˉ)2(n−1)s2)−n/2\bigl(1+\tfrac{n(\mu-\bar x)^2}{(n-1)s^2}\bigr)^{-n/2}에 비례함을 보이고 결론을 내려라. (힌트: u=1/σ2u=1/\sigma^2로 치환하면 감마 적분.)

풀이

가능도와 사전분포의 곱은 σ−1⋅σ−nexp⁡(−∑(xi−μ)22σ2)\sigma^{-1}\cdot\sigma^{-n}\exp\bigl(-\tfrac{\sum(x_i-\mu)^2}{2\sigma^2}\bigr)이고 ∑(xi−μ)2=(n−1)s2+n(μ−xˉ)2=:A\sum(x_i-\mu)^2=(n-1)s^2+n(\mu-\bar x)^2=:A이다. u=1/σ2u=1/\sigma^2로 치환하면 dσ=−12u−3/2dud\sigma=-\tfrac12u^{-3/2}du이므로

∫0∞σ−(n+1)e−A/(2σ2) dσ=12∫0∞un/2−1e−Au/2 du=12Γ(n2)(2A)n/2∝A−n/2.\int_0^\infty\sigma^{-(n+1)}e^{-A/(2\sigma^2)}\,d\sigma=\frac12\int_0^\infty u^{n/2-1}e^{-Au/2}\,du=\frac12\Gamma\Bigl(\frac n2\Bigr)\Bigl(\frac2A\Bigr)^{n/2}\propto A^{-n/2}.

따라서 π(μ∣x)∝(1+n(μ−xˉ)2(n−1)s2)−n/2\pi(\mu\mid\x)\propto\bigl(1+\tfrac{n(\mu-\bar x)^2}{(n-1)s^2}\bigr)^{-n/2}이고, t=μ−xˉs/nt=\tfrac{\mu-\bar x}{s/\sqrt n}로 쓰면 (1+t2n−1)−n/2\bigl(1+\tfrac{t^2}{n-1}\bigr)^{-n/2}, 곧 t(n−1)t(n-1)의 밀도 꼴이다.

연습 8.6 (예측구간 증명 ★★ 유도형) 정리 8.1를 다음 순서로 증명하라.

  1. (a)

    XnewX_{\mathrm{new}}, Xˉ\bar X, S2S^2가 상호 독립임을 보여라. 어느 독립을 어디서 가져오는지 밝혀라.

  2. (b)

    Xnew−Xˉ∼N(0,σ2(1+1n))X_{\mathrm{new}}-\bar X\sim\N\bigl(0,\allowbreak \sigma^2(1+\tfrac1n)\bigr)임을 보이고, 이것이 S2S^2와 독립인 이유를 말하라.

  3. (c)

    T=Xnew−XˉS1+1/nT=\tfrac{X_{\mathrm{new}}-\bar X}{S\sqrt{1+1/n}}를 정의 3.1의 꼴 Z/V/(n−1)Z/\sqrt{V/(n-1)}로 써라.

  4. (d)

    정리 5.2의 증명처럼 확률 문장을 XnewX_{\mathrm{new}}에 대해 풀어 예측구간을 얻어라. 이 문장의 무작위인 양은 무엇인가?

풀이

(a) XnewX_{\mathrm{new}}는 표본 (X1,…,Xn)(X_1,\dots,X_n)과 독립이므로 그 함수인 (Xˉ,S2)(\bar X,S^2)와 독립이다(3회 3.2절의 상자). 정리 2.2(b)로 Xˉ⊥S2\bar X\perp S^2이다. 따라서 P(Xnew∈A,Xˉ∈B,S2∈C)=P(Xnew∈A)P(Xˉ∈B)P(S2∈C)P(X_{\mathrm{new}}\in A,\allowbreak \bar X\in B,\allowbreak S^2\in C)=P(X_{\mathrm{new}}\in A)P(\bar X\in B)P(S^2\in C)이고, 셋은 상호 독립이다. (b) Xnew∼N(μ,σ2)X_{\mathrm{new}}\sim\N(\mu,\allowbreak \sigma^2)과 Xˉ∼N(μ,σ2/n)\bar X\sim\N(\mu,\sigma^2/n)이 독립이므로 5회 정리 1.8(iv)로 Xnew−Xˉ∼N(0,σ2(1+1n))X_{\mathrm{new}}-\bar X\sim\N\bigl(0,\allowbreak \sigma^2(1+\tfrac1n)\bigr)이다. 이것은 (Xnew,Xˉ)(X_{\mathrm{new}},\bar X)의 함수이고 (a)로 S2S^2와 독립이다. (c) Z=Xnew−Xˉσ1+1/n∼N(0,1)Z=\tfrac{X_{\mathrm{new}}-\bar X}{\sigma\sqrt{1+1/n}}\sim\N(0,\allowbreak 1), V=(n−1)S2σ2∼χ2(n−1)V=\tfrac{(n-1)S^2}{\sigma^2}\sim\chi^2(n-1), Z⊥VZ\perp V이고 T=Z/V/(n−1)T=Z/\sqrt{V/(n-1)}이다. σ\sigma가 소거되므로 T∼t(n−1)T\sim t(n-1)이다. (d) c=tn−1,α/2c=t_{n-1,\alpha/2}이면 P(∣T∣≤c)=1−αP(|T|\le c)=1-\alpha이고, ∣T∣≤c|T|\le c는 Xˉ−cS1+1/n≤Xnew≤Xˉ+cS1+1/n\bar X-cS\sqrt{1+1/n}\le X_{\mathrm{new}}\le\bar X+cS\sqrt{1+1/n}과 같다. 신뢰구간에서는 μ\mu가 고정되고 구간만 무작위였지만, 여기서는 구간의 양 끝과 XnewX_{\mathrm{new}}가 모두 무작위다.

연습 8.7 (배치 안의 값의 상계 증명 ★★ 유도형) dj=xj−xˉBd_j=x_j-\bar x_B로 둔다. 명제 8.2를 다음 순서로 증명하라 [T4].

  1. (a)

    ∑jdj=0\sum_jd_j=0에서 di=−∑j≠idjd_i=-\sum_{j\ne i}d_j를 얻어라.

  2. (b)

    Cauchy–Schwarz 부등식(3회 정리 4.4)으로 di2≤(B−1)∑j≠idj2d_i^2\le(B-1)\sum_{j\ne i}d_j^2를 보여라.

  3. (c)

    ∑j≠idj2=Bσ^B2−di2\sum_{j\ne i}d_j^2=B\hat\sigma_B^2-d_i^2를 넣어 ∣x^i∣≤B−1|\hat x_i|\le\sqrt{B-1}을 얻어라.

  4. (d)

    등호는 언제 성립하는가? B=2B=2이면 x^1=−x^2=±1\hat x_1=-\hat x_2=\pm1임을 확인하라.

풀이

(a) ∑jdj=∑jxj−BxˉB=0\sum_jd_j=\sum_jx_j-B\bar x_B=0이므로 di=−∑j≠idjd_i=-\sum_{j\ne i}d_j이다. (b) Cauchy–Schwarz로 (∑j≠i1⋅dj)2≤(B−1)∑j≠idj2\bigl(\sum_{j\ne i}1\cdot d_j\bigr)^2\le(B-1)\sum_{j\ne i}d_j^2이다. (c) ∑jdj2=Bσ^B2\sum_jd_j^2=B\hat\sigma_B^2이므로 di2≤(B−1)(Bσ^B2−di2)d_i^2\le(B-1)(B\hat\sigma_B^2-d_i^2), 곧 Bdi2≤B(B−1)σ^B2Bd_i^2\le B(B-1)\hat\sigma_B^2이다. 양변을 Bσ^B2B\hat\sigma_B^2로 나누면 x^i2≤B−1\hat x_i^2\le B-1이다. (d) Cauchy–Schwarz의 등호는 (dj)j≠i(d_j)_{j\ne i}가 (1,…,1)(1,\dots,1)에 비례할 때, 곧 xix_i를 뺀 나머지 값이 모두 같을 때 성립한다. B=2B=2이면 나머지가 하나뿐이므로 항상 등호다. d1=−d2d_1=-d_2이고 σ^B2=d12+d222=d12\hat\sigma_B^2=\tfrac{d_1^2+d_2^2}2=d_1^2이므로 x^1=d1/∣d1∣=±1\hat x_1=d_1/|d_1|=\pm1, x^2=−x^1\hat x_2=-\hat x_1이다.

이 회차에서 읽은 절 0개 · 회차 차례