Skip to content

3회 · 왜 평균을 내는가 · 노트

4 공분산과 상관 ​

독립이 아닌 두 변수가 “얼마나, 어느 방향으로” 함께 움직이는지를 하나의 수로 재고 싶다. 2회 정리 2.8의 증명에 나온 교차항 E(DiDj)E(D_iD_j)가 그 수다. 이 절은 그것에 이름을 붙이고, Cauchy–Schwarz 부등식으로 그 크기에 한계를 준다.

4.1 공분산 ​

정의 4.1 (공분산과 상관계수) EX2,EY2<∞EX^2,EY^2<\infty, μX=EX\mu_X=EX, μY=EY\mu_Y=EY일 때

Cov⁡(X,Y)=E[(X−μX)(Y−μY)]\Cov(X,Y)=E\bigl[(X-\mu_X)(Y-\mu_Y)\bigr]

을 공분산, 두 분산이 양수일 때

ρ=Corr⁡(X,Y)=Cov⁡(X,Y)σXσY\rho=\Corr(X,Y)=\frac{\Cov(X,Y)}{\sigma_X\sigma_Y}

를 상관계수라 한다. Cov⁡(X,Y)=0\Cov(X,Y)=0이면 상관이 없다고 한다.

정리 4.2 (공분산의 계산 규칙) 

  1. (a)

    Cov⁡(X,Y)=E(XY)−μXμY\Cov(X,Y)=E(XY)-\mu_X\mu_Y, Cov⁡(X,X)=Var⁡X\Cov(X,X)=\Var X, Cov⁡(X,Y)=Cov⁡(Y,X)\Cov(X,Y)=\Cov(Y,X).

  2. (b)

    (쌍선형) Cov⁡(aX+b, cY+d)=ac Cov⁡(X,Y)\Cov(aX+b,\allowbreak \ cY+d)=ac\,\Cov(X,\allowbreak Y), Cov⁡(X1+X2,Y)=Cov⁡(X1,Y)+Cov⁡(X2,Y)\Cov(X_1+X_2,\allowbreak Y)=\Cov(X_1,\allowbreak Y)+\Cov(X_2,\allowbreak Y).

  3. (c)

    Var⁡(∑iaiXi)=∑iai2Var⁡Xi+2∑i<jaiajCov⁡(Xi,Xj)\Var\bigl(\sum_ia_iX_i\bigr)=\sum_ia_i^2\Var X_i+2\sum_{i<j}a_ia_j\Cov(X_i,\allowbreak X_j).

  4. (d)

    독립이면 상관이 없다.

증명 전략 모든 규칙을 공분산의 정의와 기댓값의 선형성(따름정리 1.9)으로 옮긴다. (c)는 분산을 자기 자신과의 공분산으로 보고 (b)로 전개한다. 단계별 증명은 연습 4.7(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

예제 4.3 (두 주사위의 합과 최댓값의 공분산) 예제 1.4에서 S=D1+D2S=D_1+D_2, M=max⁡(D1,D2)M=\max(D_1,D_2)이다. 쌍선형으로 Cov⁡(S,M)=Cov⁡(D1,M)+Cov⁡(D2,M)=2Cov⁡(D1,M)\Cov(S,\allowbreak M)=\Cov(D_1,\allowbreak M)+\Cov(D_2,\allowbreak M)=2\Cov(D_1,\allowbreak M)이고, 대칭으로 계산하면 Cov⁡(S,M)=3512≈2.917\Cov(S,\allowbreak M)=\tfrac{35}{12}\approx2.917, Var⁡M=25551296≈1.971\Var M=\tfrac{2555}{1296}\approx1.971이다(연습 4.1). 따라서

ρ(S,M)=35/1235/6 2555/1296≈0.86.\rho(S,M)=\frac{35/12}{\sqrt{35/6}\,\sqrt{2555/1296}}\approx0.86 .

4.2 Cauchy–Schwarz와 상관의 한계 ​

정리 4.4 (Cauchy–Schwarz 부등식) EX2,EY2<∞EX^2,EY^2<\infty이면

(E(XY))2≤EX2 EY2.\bigl(E(XY)\bigr)^2\le EX^2\,EY^2 .

등호는 어떤 상수 cc에 대해 P(Y=cX)=1P(Y=cX)=1이거나 P(X=0)=1P(X=0)=1일 때뿐이다.

증명 전략 모든 실수 tt에서 E(Y−tX)2≥0E(Y-tX)^2\ge0이다. 이것을 tt의 이차식으로 쓰면, 음이 아닌 이차식의 판별식은 0 이하라는 것이 곧 부등식이다 [T4].

  1. 2∣XY∣≤X2+Y22|XY|\le X^2+Y^2이므로 E∣XY∣<∞E|XY|<\infty이고 E(XY)E(XY)가 정의된다.[T4]

  2. EX2=0EX^2=0이면 P(X=0)=1P(X=0)=1이고 양변이 0이다.2회 따름정리 5.6

  3. EX2>0EX^2>0이면 모든 실수 tt에 대해

    0≤E(Y−tX)2=EY2−2t E(XY)+t2EX2.0\le E(Y-tX)^2=EY^2-2t\,E(XY)+t^2EX^2 .
    따름정리 1.9
  4. 음이 아닌 이차식의 판별식은 0 이하이므로 4(E(XY))2−4 EX2 EY2≤04\bigl(E(XY)\bigr)^2-4\,EX^2\,EY^2\le0이다.이차식의 판별식 [T4]

  5. 등호이면 판별식이 0이고, 이차식이 0이 되는 t=c=E(XY)/EX2t=c=E(XY)/EX^2가 있다. 그러면 E(Y−cX)2=0E(Y-cX)^2=0이므로 P(Y=cX)=1P(Y=cX)=1이다.2회 따름정리 5.6

  6. 거꾸로 P(Y=cX)=1P(Y=cX)=1이면 양변이 모두 c2(EX2)2c^2(EX^2)^2이다.

따름정리 4.5 (상관계수의 범위) −1≤ρ≤1-1\le\rho\le1이고, ∣ρ∣=1|\rho|=1일 필요충분조건은 P(Y=a+bX)=1P(Y=a+bX)=1인 상수 aa와 b≠0b\ne0이 있는 것이다. 이때 ρ\rho의 부호는 bb의 부호다.

증명 정리 4.4를 X−μXX-\mu_X와 Y−μYY-\mu_Y에 쓰면 Cov⁡(X,Y)2≤σX2σY2\Cov(X,\allowbreak Y)^2\le\sigma_X^2\sigma_Y^2. 등호 조건은 Y−μY=c(X−μX)Y-\mu_Y=c(X-\mu_X)이다.

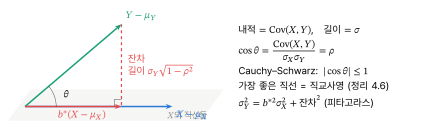
그림 4.1. 상관계수는 각의 코사인이다. 평균을 뺀 확률변수를 벡터로 보면 공분산이 내적, 표준편차가 길이다. Cauchy–Schwarz는 “코사인은 -1과 1 사이”라는 말이다.
그림 4.1 상관계수는 각의 코사인이다. 평균을 뺀 확률변수를 벡터로 보면 공분산이 내적, 표준편차가 길이다. Cauchy–Schwarz는 “코사인은 −1-1과 11 사이”라는 말이다.

그림 4.1의 기하는 비유가 아니다. 평균이 0이고 분산이 유한한 확률변수들은 내적 ⟨X,Y⟩=E(XY)\langle X,Y\rangle=E(XY)를 갖는 벡터공간을 이룬다. 길이는 표준편차, 각의 코사인은 상관계수, 직교는 상관없음이다. 이 그림으로 보면 정리 2.8의 조건부기댓값은 YY를 “XX의 함수들의 공간”에 직교사영한 것이고, 전분산 공식은 피타고라스 정리다. 5회와 13회는 이 기하를 계속 쓴다.

4.3 가장 좋은 직선과 상관의 함정 ​

정리 4.6 (가장 좋은 선형 예측) E(Y−a−bX)2E(Y-a-bX)^2을 가장 작게 하는 (a,b)(a,b)는

b∗=Cov⁡(X,Y)Var⁡X=ρσYσX,a∗=μY−b∗μXb^*=\frac{\Cov(X,Y)}{\Var X}=\rho\frac{\sigma_Y}{\sigma_X},\qquad a^*=\mu_Y-b^*\mu_X

이고, 그때의 최솟값은 σY2(1−ρ2)\sigma_Y^2(1-\rho^2)이다.

증명 전략 bb를 고정하고 aa에 대해 먼저 최소화한다. 그러면 남은 값은 bb의 이차식이고, 그것을 최소화한다. 단계별 증명은 연습 4.8(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

ρ2\rho^2은 XX의 직선이 설명하는 YY의 분산의 비율이다. 직선 y=a∗+b∗xy=a^*+b^*x를 XX에 대한 YY의 회귀직선이라 한다. 기울기에 ρ\rho가 곱해져 있으므로 ∣ρ∣<1|\rho|<1이면 표준단위로 잰 예측은 평균 쪽으로 “되돌아간다”. Galton이 regression이라 부른 현상이다(5회).

예제 4.7 (상관이 없어도 독립이 아니다) X∼U(−1,1)X\sim\mathrm U(-1,1), Y=X2Y=X^2이면 YY는 XX로 완전히 정해진다. 그런데 Cov⁡(X,Y)=EX3−EX EX2=0\Cov(X,Y)=EX^3-EX\,EX^2=0이다(대칭). 상관계수는 직선 관계만 잰다. 정리 4.2(d)의 역은 거짓이다.

예제 4.8 (상관은 인과가 아니다 — 공통 원인) ZZ가 공통 원인이고 X=Z+E1X=Z+E_1, Y=Z+E2Y=Z+E_2 (Z,E1,E2Z,E_1,E_2 독립, 분산 σZ2,σ2,σ2\sigma_Z^2,\sigma^2,\sigma^2)이면 Cov⁡(X,Y)=Var⁡Z\Cov(X,Y)=\Var Z이고 ρ=σZ2σZ2+σ2\rho=\tfrac{\sigma_Z^2}{\sigma_Z^2+\sigma^2}이다. XX는 YY에 아무 영향도 주지 않지만 둘은 상관되어 있다. 1회 연습 5.9의 Simpson 역설에서 결석의 크기가 이런 공통 원인이었다.

연습문제

연습 4.1 (합과 최댓값 ★★) E(D1M)E(D_1M)을 직접 세어 Cov⁡(D1,M)\Cov(D_1,M)을 구하고, 예제 4.3에서 쓴 Cov⁡(S,M)\Cov(S,M)이 3512\tfrac{35}{12}임을 확인하라. (힌트: M=D1M=D_1인 경우와 M=D2>D1M=D_2>D_1인 경우로 나눈다.)

풀이

M=D1M=D_1인 결과(D1≥D2D_1\ge D_2, 21가지)에서 D1M=D12D_1M=D_1^2, 나머지 15가지에서 D1M=D1D2D_1M=D_1D_2이다. 세면 ∑D1M=∑d=16d2⋅d+∑a<bab=441+175=616\sum D_1M=\sum_{d=1}^6d^2\cdot d+\sum_{a<b}ab=441+175=616이므로 E(D1M)=61636E(D_1M)=\tfrac{616}{36}. Cov⁡(D1,M)=61636−3.5⋅16136=3524\Cov(D_1,\allowbreak M)=\tfrac{616}{36}-3.5\cdot\tfrac{161}{36}=\tfrac{35}{24}이고 Cov⁡(S,M)=2⋅3524=3512\Cov(S,\allowbreak M)=2\cdot\tfrac{35}{24}=\tfrac{35}{12}. (∑a<bab=12((∑a)2−∑a2)=441−912=175\sum_{a<b}ab=\tfrac12\bigl((\sum a)^2-\sum a^2\bigr)=\tfrac{441-91}2=175.)

연습 4.2 (합과 차 ★) X,YX,Y의 분산이 같으면 X+YX+Y와 X−YX-Y는 상관이 없음을 보여라. 두 주사위의 합과 차는 독립인가?

풀이

Cov⁡(X+Y,X−Y)=Var⁡X−Var⁡Y=0\Cov(X+Y,X-Y)=\Var X-\Var Y=0. 두 주사위의 합과 차는 상관이 없지만 독립이 아니다. S=2S=2이면 차는 반드시 0이다.

연습 4.3 (포트폴리오 ★★) 수익률 X,YX,Y의 표준편차가 σX=0.2\sigma_X=0.2, σY=0.3\sigma_Y=0.3, 상관계수가 ρ\rho이다. wX+(1−w)YwX+(1-w)Y의 분산을 가장 작게 하는 ww를 ρ\rho의 식으로 구하고, ρ=−1,0,0.5\rho=-1,0,0.5일 때 최소 분산을 구하라. ρ=−1\rho=-1이면 위험을 완전히 없앨 수 있다.

풀이

V(w)=w2σX2+(1−w)2σY2+2w(1−w)ρσXσYV(w)=w^2\sigma_X^2+(1-w)^2\sigma_Y^2+2w(1-w)\rho\sigma_X\sigma_Y를 미분하면

w∗=σY2−ρσXσYσX2+σY2−2ρσXσY.w^*=\frac{\sigma_Y^2-\rho\sigma_X\sigma_Y}{\sigma_X^2+\sigma_Y^2-2\rho\sigma_X\sigma_Y} .

ρ=−1\rho=-1: w∗=0.6w^*=0.6, V=0V=0. ρ=0\rho=0: w∗≈0.692w^*\approx0.692, V≈0.0277V\approx0.0277 (표준편차 0.166). ρ=0.5\rho=0.5: w∗≈0.857w^*\approx0.857, V≈0.0386V\approx0.0386 (표준편차 0.196). 상관이 낮을수록 섞어서 얻는 이득이 크다.

연습 4.4 (상관계수의 불변성 ★) a,c>0a,c>0이면 Corr⁡(aX+b, cY+d)=Corr⁡(X,Y)\Corr(aX+b,\ cY+d)=\Corr(X,Y)임을 보여라. a<0a<0이면?

풀이

Cov⁡(aX+b,cY+d)=acCov⁡(X,Y)\Cov(aX+b,cY+d)=ac\Cov(X,Y), σaX+b=∣a∣σX\sigma_{aX+b}=|a|\sigma_X이므로 상관계수는 ac∣a∣∣c∣ρ\tfrac{ac}{|a||c|}\rho. a,c>0a,c>0이면 ρ\rho, a<0<ca<0<c이면 −ρ-\rho.

연습 4.5 (부등식의 사촌들 ★★) Cauchy–Schwarz로 (a) E∣X∣≤EX2E|X|\le\sqrt{EX^2}, (b) σX+Y≤σX+σY\sigma_{X+Y}\le\sigma_X+\sigma_Y를 보여라. (b)는 표준편차의 삼각부등식이다.

풀이

(a) Cauchy–Schwarz를 ∣X∣|X|와 11에 쓰면 (E∣X∣)2≤EX2(E|X|)^2\le EX^2. (b) Var⁡(X+Y)=σX2+σY2+2Cov⁡(X,Y)≤σX2+σY2+2σXσY=(σX+σY)2\Var(X+Y)=\sigma_X^2+\sigma_Y^2+2\Cov(X,\allowbreak Y)\le\sigma_X^2+\sigma_Y^2+2\sigma_X\sigma_Y=(\sigma_X+\sigma_Y)^2.

연습 4.6 (원판의 상관 ★) 예제 1.7의 (X,Y)(X,Y)는 상관이 없음을 보여라. 3.1절의 주의 상자에 따르면 둘은 독립이 아니다. 독립이 아님을 확률로 보여라: P(X>0.8, Y>0.8)P(X>0.8,\ Y>0.8)과 P(X>0.8)P(Y>0.8)P(X>0.8)P(Y>0.8)을 비교한다.

풀이

(x,y)↦(x,−y)(x,y)\mapsto(x,-y)로 밀도가 변하지 않으므로 E(XY)=0E(XY)=0, EX=EY=0EX=EY=0이고 상관이 없다. 0.82+0.82>10.8^2+0.8^2>1이므로 P(X>0.8, Y>0.8)=0P(X>0.8,\,Y>0.8)=0이지만 P(X>0.8)=2π∫0.811−x2dx≈0.052P(X>0.8)=\tfrac2\pi\int_{0.8}^1\sqrt{1-x^2}dx\approx0.052이어서 곱은 약 0.0027>00.0027>0이다. 독립이 아니다.

연습 4.7 (공분산의 계산 규칙 증명 ★ 유도형) EXi2<∞EX_i^2<\infty라 하자. 정리 4.2를 다음 순서로 증명하라.

  1. (a)

    2∣xy∣≤x2+y22|xy|\le x^2+y^2로 E∣XY∣<∞E|XY|<\infty임을 보여 공분산이 정의됨을 확인하라.

  2. (b)

    (X−μX)(Y−μY)=XY−μYX−μXY+μXμY(X-\mu_X)(Y-\mu_Y)=XY-\mu_YX-\mu_XY+\mu_X\mu_Y에 선형성을 써서 (a)의 첫 식을 얻어라.

  3. (c)

    정의에 aX+baX+b와 cY+dcY+d를 넣어 쌍선형을 보여라. 상수 b,db,d는 어디서 사라지는가?

  4. (d)

    Var⁡(∑iaiXi)=Cov⁡(∑iaiXi,∑jajXj)=∑i∑jaiajCov⁡(Xi,Xj)\Var(\sum_ia_iX_i)=\Cov(\sum_ia_iX_i,\allowbreak \sum_ja_jX_j)=\sum_i\sum_ja_ia_j\Cov(X_i,\allowbreak X_j)를 보이고, i=ji=j인 항과 i≠ji\ne j인 항으로 나눠 (c)를 얻어라. i≠ji\ne j인 순서쌍이 i<ji<j인 쌍의 두 배인 이유를 말하라.

  5. (e)

    정리 3.4(b)로 (d)를 보여라.

풀이

(a) 2∣XY∣≤X2+Y22|XY|\le X^2+Y^2이므로 E∣XY∣≤12(EX2+EY2)<∞E|XY|\le\tfrac12(EX^2+EY^2)<\infty이고, E∣X∣≤12(1+EX2)<∞E|X|\le\tfrac12(1+EX^2)<\infty도 같은 방법으로 나온다. 따라서 (X−μX)(Y−μY)(X-\mu_X)(Y-\mu_Y)의 기댓값이 정의된다. (b) 선형성으로 E(XY−μYX−μXY+μXμY)=E(XY)−μXμY−μXμY+μXμY=E(XY)−μXμYE(XY-\mu_YX-\mu_XY+\mu_X\mu_Y)=E(XY)-\mu_X\mu_Y-\mu_X\mu_Y+\mu_X\mu_Y=E(XY)-\mu_X\mu_Y이다. Y=XY=X이면 Var⁡X\Var X이고, 정의가 XX와 YY에 대칭이므로 Cov⁡(X,Y)=Cov⁡(Y,X)\Cov(X,Y)=\Cov(Y,X)이다. (c) aX+b−E(aX+b)=a(X−μX)aX+b-E(aX+b)=a(X-\mu_X)이고 cY+d−E(cY+d)=c(Y−μY)cY+d-E(cY+d)=c(Y-\mu_Y)이므로 Cov⁡(aX+b,cY+d)=E[ac(X−μX)(Y−μY)]=acCov⁡(X,Y)\Cov(aX+b,\allowbreak cY+d)=E[ac(X-\mu_X)(Y-\mu_Y)]=ac\Cov(X,\allowbreak Y)이다. 상수 b,db,d는 평균을 뺄 때 사라진다. 합에 대해서는 X1+X2−E(X1+X2)=(X1−μ1)+(X2−μ2)X_1+X_2-E(X_1+X_2)=(X_1-\mu_1)+(X_2-\mu_2)를 정의에 넣고 선형성을 쓴다. (d) (c)를 되풀이하면 Cov⁡(∑iaiXi,∑jajXj)=∑i∑jaiajCov⁡(Xi,Xj)\Cov(\sum_ia_iX_i,\allowbreak \sum_ja_jX_j)=\sum_i\sum_ja_ia_j\Cov(X_i,\allowbreak X_j)이다. i=ji=j인 항은 ai2Var⁡Xia_i^2\Var X_i이고, i≠ji\ne j인 순서쌍은 (i,j)(i,j)와 (j,i)(j,i)가 같은 값 aiajCov⁡(Xi,Xj)a_ia_j\Cov(X_i,X_j)를 주므로 i<ji<j인 쌍마다 두 번 나온다. (e) 정리 3.4(b)를 g(x)=xg(x)=x, h(y)=yh(y)=y에 쓰면 E(XY)=EX EYE(XY)=EX\,EY이고, (b)로 Cov⁡(X,Y)=0\Cov(X,Y)=0이다.

연습 4.8 (가장 좋은 선형 예측 증명 ★★ 유도형) 정리 4.6를 다음 순서로 증명하라.

  1. (a)

    bb를 고정하면 E(Y−bX−a)2E(Y-bX-a)^2을 가장 작게 하는 aa는 E(Y−bX)E(Y-bX)이고 그때의 값은 Var⁡(Y−bX)\Var(Y-bX)임을 2회 정리 2.2(c)로 보여라.

  2. (b)

    Var⁡(Y−bX)=σY2−2bCov⁡(X,Y)+b2σX2\Var(Y-bX)=\sigma_Y^2-2b\Cov(X,\allowbreak Y)+b^2\sigma_X^2임을 정리 4.2로 보여라.

  3. (c)

    (b)의 이차식을 최소로 하는 b∗b^*를 구하고, 최솟값이 σY2(1−ρ2)\sigma_Y^2(1-\rho^2)임을 보여라.

  4. (d)

    잔차 Y−a∗−b∗XY-a^*-b^*X가 XX와 상관이 없음을 보여라.

풀이

(a) W=Y−bXW=Y-bX로 두면 E(W−a)2E(W-a)^2을 가장 작게 하는 상수는 a=EWa=EW이고 그 값은 Var⁡W\Var W이다(2회 정리 2.2(c)). (b) 정리 4.2(c)를 a1=1a_1=1, a2=−ba_2=-b에 쓴다. (c) (b)를 bb로 미분해 0으로 두면 −2Cov⁡(X,Y)+2bσX2=0-2\Cov(X,Y)+2b\sigma_X^2=0, 곧 b∗=Cov⁡(X,Y)/σX2=ρσY/σXb^*=\Cov(X,\allowbreak Y)/\sigma_X^2=\rho\sigma_Y/\sigma_X이다. 이차항의 계수 σX2>0\sigma_X^2>0이므로 최소다. 넣으면 σY2−2Cov⁡2/σX2+Cov⁡2/σX2=σY2−Cov⁡2/σX2=σY2(1−ρ2)\sigma_Y^2-2\Cov^2/\sigma_X^2+\Cov^2/\sigma_X^2=\sigma_Y^2-\Cov^2/\sigma_X^2=\sigma_Y^2(1-\rho^2)이다. 이때 a∗=E(Y−b∗X)=μY−b∗μXa^*=E(Y-b^*X)=\mu_Y-b^*\mu_X이다. (d) Cov⁡(X, Y−a∗−b∗X)=Cov⁡(X,Y)−b∗σX2=0\Cov(X,\allowbreak \,Y-a^*-b^*X)=\Cov(X,\allowbreak Y)-b^*\sigma_X^2=0이다.

이 회차에서 읽은 절 0개 · 회차 차례