
테마
노트북 · 3회 · 왜 평균을 내는가
왜 평균을 내는가 여러 확률변수와
| 강의노트 | 03_averaging_notes.pdf — 같은 절 번호, 같은 정리 번호. 증명은 노트에, 확인은 여기에 |
| 워크북 | 03_averaging_workbook.pdf — 손으로 푸는 34문항. 다 푼 뒤 맨 끝 10절의 check()로 검산 |
| 원자료 | 1848년 Pyx 재판의 금화 10,000개 · Michelson(1879)의 빛의 속도 · Cavendish(1798)의 지구 밀도 (R 패키지 HistData) |
| 선수 지식 | 1–2회 전체, 이중적분·편미분·행렬식 |
여는 질문. 천문학자가 같은 별의 위치를 여섯 번 쟀다. 여섯 값의 평균을 쓰는 것이 가장 조심스럽게 잰 한 번의 값을 쓰는 것보다 정말 나은가? 낫다면 얼마나 나은가?
Simpson(1755)이 처음으로 계산했다. 답은 이다. 그러나 런던 조폐국은 수백 년 동안 그것을 으로 알았다(6.4절).
이번 회차의 지도
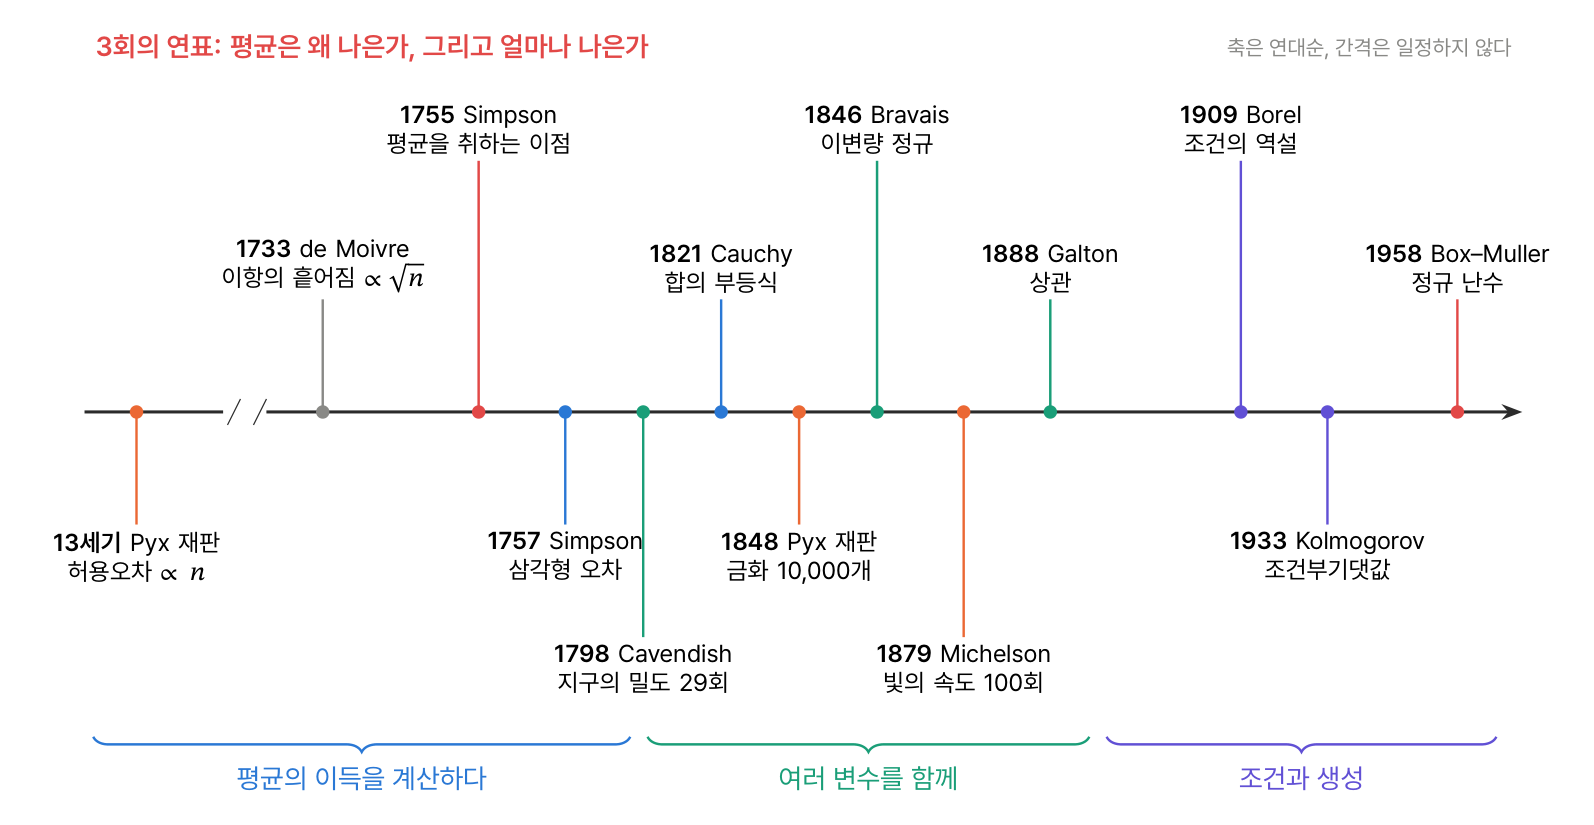
학습 목표
- 결합분포에서 주변분포·조건부분포를 구하고, 함수의 기댓값을 이중합·이중적분으로 계산한다.
- 반복기댓값과 전분산 공식을 시뮬레이션으로 확인하고, 조건부기댓값이 가장 좋은 예측임을 본다.
- 독립을 인수분해로 판정하고, 공분산·상관계수를 직접 구현해 numpy와 대조한다.
- 야코비안으로 유도한 Box–Muller, 합성곱, 정규의 비 = Cauchy를 코드로 확인한다.
- Simpson의 계산과 1848년 Pyx 재판의 자료로 법칙을 보고, 상관·편향 앞에서 그것이 무너지는 것을 본다.
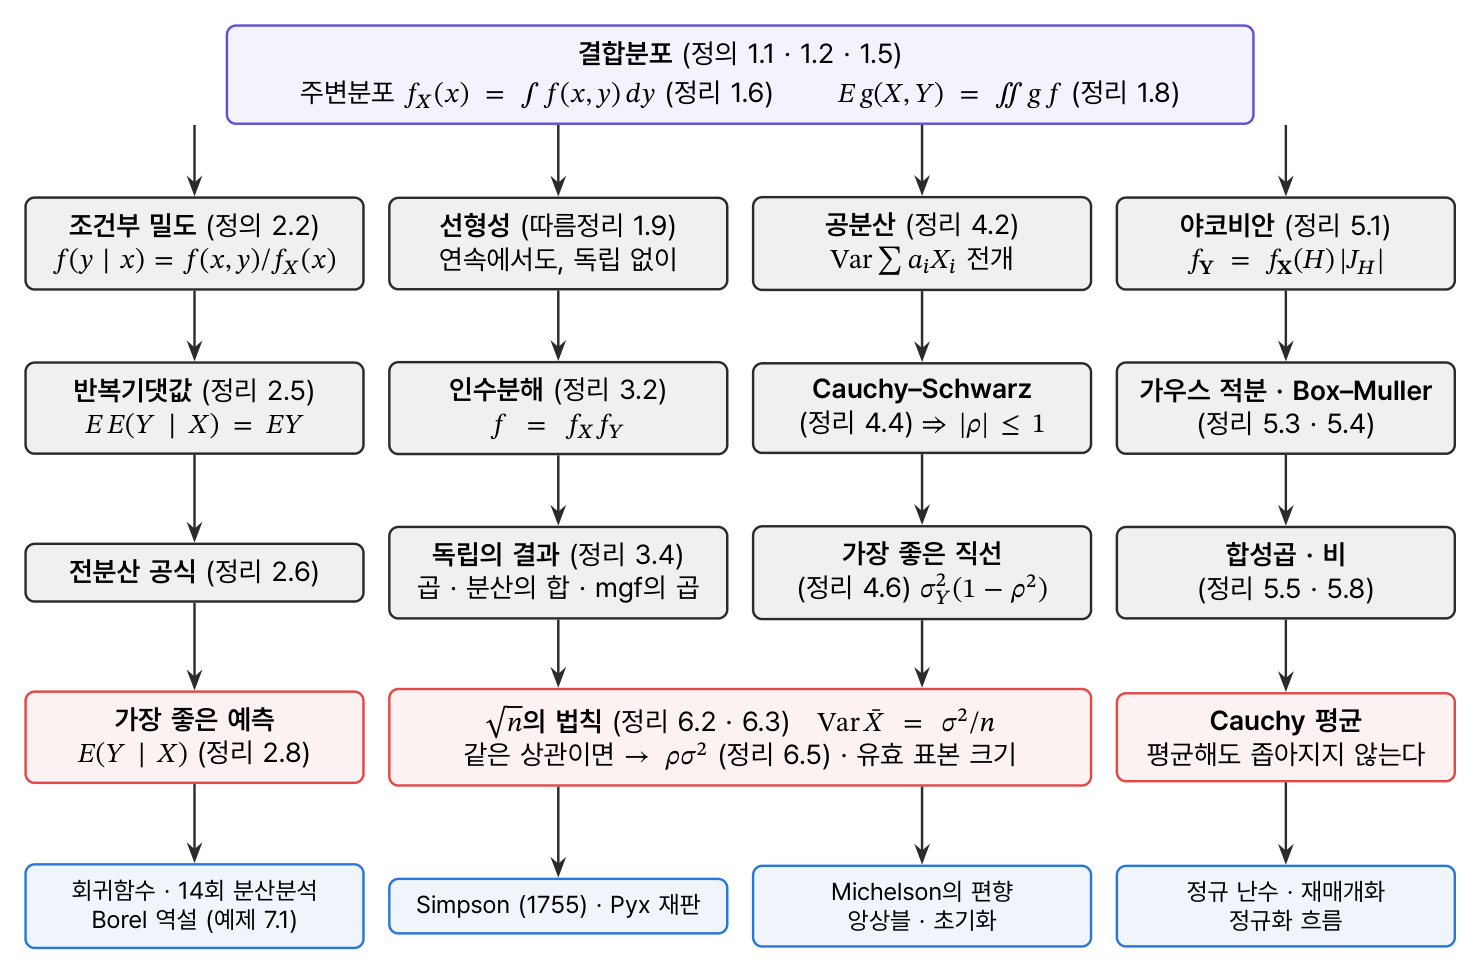
정리 지도 — 화살표는 "증명에 쓰인다"는 뜻이다.
0. 설정
python
%matplotlib inline
import itertools
import math
from fractions import Fraction
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import integrate, optimize, stats

SEED = 2026
N_SIM = 200_000
rng = np.random.default_rng(SEED)

C = dict(data="#1a9e78", stat="#2a78d6", key="#e34948", assume="#eb6834",
         theta="#6250d6", ink="#2b2b2b", hist="#8a8a86", grid="#e6e6e3")
SERIES = [C["stat"], C["data"], C["key"], C["theta"]]
THEORY = dict(color=C["ink"], ls="--", lw=1.6)
plt.rcParams.update({
    "figure.dpi": 110, "figure.figsize": (8, 4.2), "mathtext.fontset": "stix",
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.grid": True, "grid.color": C["grid"], "grid.linewidth": 0.8,
    "axes.edgecolor": "#9a9a96", "axes.labelcolor": C["ink"],
    "xtick.color": "#52514e", "ytick.color": "#52514e",
    "axes.titleweight": "bold", "axes.titlesize": 11, "axes.titlelocation": "left",
    "legend.frameon": False, "lines.linewidth": 2,
})

RDATASETS = "https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/master/csv/{}/{}.csv"
DATA_DIR = Path("../../data") if Path("../../.git").exists() else Path("data")

def load_rdata(item, package="HistData"):
    path = DATA_DIR / (f"{item}.csv" if package == "HistData" else f"{package}_{item}.csv")
    if not path.exists():
        DATA_DIR.mkdir(parents=True, exist_ok=True)
        pd.read_csv(RDATASETS.format(package, item)).drop(columns="rownames").to_csv(path, index=False)
    return pd.read_csv(path)

def report(checks):
    for name, ok in checks.items():
        print(f"  {'✓' if ok else '✗'}  {name}")
    assert all(checks.values()), "대조 실패"
1. 결합분포 — 두 확률변수를 함께
정의 1.2 결합 pmf · 정리 1.3 주변 pmf · 예제 1.4 두 주사위의 합 와 최댓값 .
36가지 결과를 모두 늘어놓고 pd.crosstab으로 결합분포 표를 만든다. 표의 가장자리(margin)가 주변분포다.
python
outcomes = pd.DataFrame(list(itertools.product(range(1, 7), repeat=2)), columns=["D1", "D2"])
outcomes["S"] = outcomes.D1 + outcomes.D2
outcomes["M"] = outcomes[["D1", "D2"]].max(axis=1)
outcomes["L"] = outcomes[["D1", "D2"]].min(axis=1)
joint = pd.crosstab(outcomes.M, outcomes.S, margins=True, margins_name="합")       # 개수 (÷36 이 확률)
print(joint.to_string())

pM = outcomes.M.value_counts().sort_index() / 36
report({"예제 1.4: p_M(m) == (2m-1)/36": np.allclose(pM.values, [(2 * m - 1) / 36 for m in range(1, 7)]),
        "예제 1.4: p_S,M 의 값은 0, 1/36, 2/36 뿐": set(np.unique(pd.crosstab(outcomes.M, outcomes.S).values)) <= {0, 1, 2},
        "연습 1.3: E M + E L == 7 (선형성)": math.isclose(outcomes.M.mean() + outcomes.L.mean(), 7),
        "연습 1.3: p_L(l) == (13-2l)/36": np.allclose(outcomes.L.value_counts().sort_index().values / 36, [(13 - 2 * l) / 36 for l in range(1, 7)])})
text
S  2  3  4  5  6  7  8  9  10  11  12   합
M
1  1  0  0  0  0  0  0  0   0   0   0   1
2  0  2  1  0  0  0  0  0   0   0   0   3
3  0  0  2  2  1  0  0  0   0   0   0   5
4  0  0  0  2  2  2  1  0   0   0   0   7
5  0  0  0  0  2  2  2  2   1   0   0   9
6  0  0  0  0  0  2  2  2   2   2   1  11
합  1  2  3  4  5  6  5  4   3   2   1  36
  ✓  예제 1.4: p_M(m) == (2m-1)/36
  ✓  예제 1.4: p_S,M 의 값은 0, 1/36, 2/36 뿐
  ✓  연습 1.3: E M + E L == 7 (선형성)
  ✓  연습 1.3: p_L(l) == (13-2l)/36
1.3 연속 결합분포 — 원판 위의 균등분포 (예제 1.7)
정리 1.6 · 예제 1.7 원판 위에서 균등하면 .
원판 위의 균등한 점은 기각 표집으로 만들 수 있다. 정사각형 에서 고르게 뽑고, 원 밖의 점을 버린다. 남는 비율은 이다.
python
sq = rng.uniform(-1, 1, (int(N_SIM / 0.78), 2))
disk = sq[(sq**2).sum(axis=1) <= 1]
X, Y = disk[:, 0], disk[:, 1]
print(f"남긴 비율 {len(disk) / len(sq):.4f}  (π/4 = {math.pi / 4:.4f})")

fig, axes = plt.subplots(1, 2, figsize=(12, 3.8))
axes[0].plot(X[:3000], Y[:3000], ".", ms=2, color=C["data"], alpha=0.6); axes[0].set_aspect("equal"); axes[0].set_title("uniform on the disk")
xx = np.linspace(-1, 1, 300)
axes[1].hist(X, bins=60, density=True, color=C["data"], alpha=0.75)
axes[1].plot(xx, 2 / np.pi * np.sqrt(1 - xx**2), **THEORY, label=r"$\frac{2}{\pi}\sqrt{1-x^2}$")
axes[1].legend(); axes[1].set_title("marginal of X is not uniform")
plt.tight_layout(); plt.show()

R = np.sqrt(X**2 + Y**2)
report({"정리 1.6: 주변 밀도 (KS 검정 p > 0.001)": stats.kstest(X, lambda x: 0.5 + (x * np.sqrt(1 - x**2) + np.arcsin(x)) / np.pi).pvalue > 1e-3,
        "∫ f_X = 1 (적분)": math.isclose(integrate.quad(lambda x: 2 / np.pi * np.sqrt(1 - x**2), -1, 1)[0], 1),
        "연습 1.4: E R = 2/3, E|X| = 4/(3π) (±0.005)": abs(R.mean() - 2 / 3) < 0.005 and abs(np.abs(X).mean() - 4 / (3 * np.pi)) < 0.005})
text
남긴 비율 0.7859 (π/4 = 0.7854)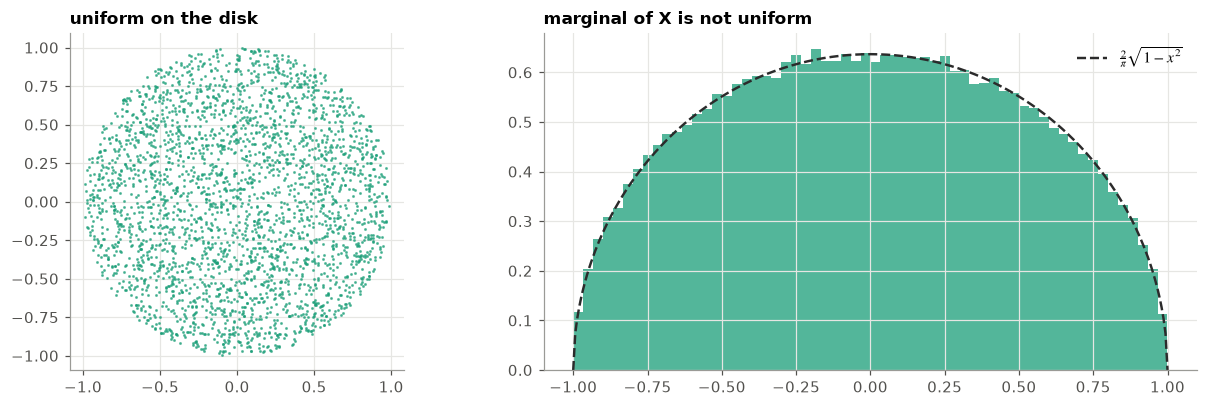
text
  ✓  정리 1.6: 주변 밀도 (KS 검정 p > 0.001)
  ✓  ∫ f_X = 1 (적분)
  ✓  연습 1.4: E R = 2/3, E|X| = 4/(3π) (±0.005)
1.4 함수의 기댓값과 선형성
정리 1.8 · 따름정리 1.9 — 연속에서도, 독립 없이.
원판의 와 는 독립이 아니다(3.1절의 주의 상자). 그래도 이다. 이중적분과 시뮬레이션으로 확인한다. 연습 1.2의 삼각형 밀도도 함께 계산한다.
python
dbl =integrate.dblquad(lambda y, x: (abs(x) + abs(y)) / np.pi, -1, 1, lambda x: -math.sqrt(1 - x * x), lambda x: math.sqrt(1 - x * x))[0]
report({"따름정리 1.9: E(|X|+|Y|) (이중적분) == E|X| + E|Y| = 8/(3π)": math.isclose(dbl, 8 / (3 * np.pi), rel_tol=1e-6),
        "시뮬레이션도 같다 (±0.005)": abs(np.mean(np.abs(X) + np.abs(Y)) - 8 / (3 * np.pi)) < 0.005})

# 연습 1.2: f = c (0 < x < y < 1)
c = 1 / integrate.dblquad(lambda y, x: 1.0, 0, 1, lambda x: x, lambda x: 1)[0]
p = integrate.dblquad(lambda y, x: c, 0, 0.5, lambda x: x, lambda x: 1 - x)[0]
report({"연습 1.2: c = 2,  P(X+Y<1) = 1/2": math.isclose(c, 2) and math.isclose(p, 0.5)})
text
  ✓  따름정리 1.9: E(|X|+|Y|) (이중적분) == E|X| + E|Y| = 8/(3π)
  ✓  시뮬레이션도 같다 (±0.005)
  ✓  연습 1.2: c = 2,  P(X+Y<1) = 1/2
📝 연습 1.1–1.5 (강의노트): 사각형의 확률, 삼각형 위의 밀도, 최댓값과 최솟값, 원판의 거리, 결합분포는 주변분포보다 많은 것을 담는다.
2. 조건부분포와 조건부기댓값
정의 2.2 — 결합밀도의 단면 · 정리 2.5 · 정리 2.6 .
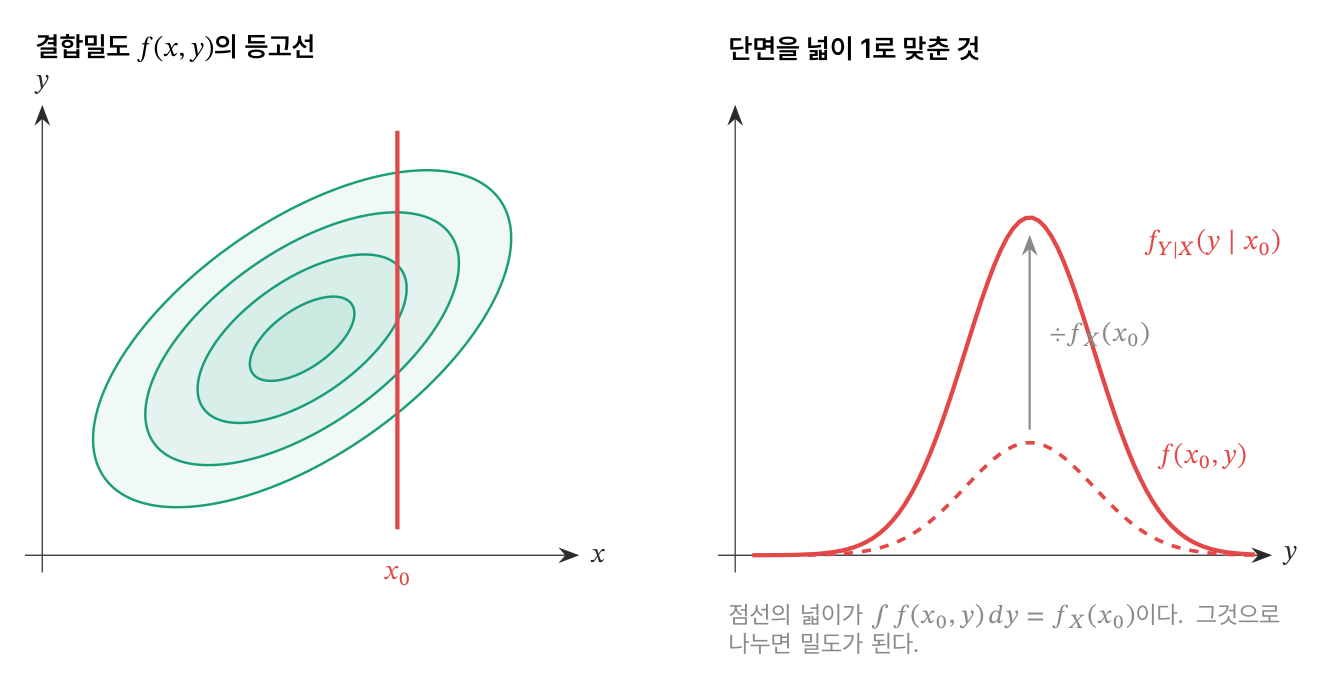
먼저 두 주사위에서 을 직접 계산해 연습 2.1의 공식 과 맞추고, 반복기댓값으로 을 되찾는다.
python
cond_mean = outcomes.groupby("M").S.mean()
formula = pd.Series({m: m * (3 * m - 1) / (2 * m - 1) for m in range(1, 7)})
print(pd.DataFrame({"E(S|M=m)": cond_mean, "m(3m-1)/(2m-1)": formula, "p_M(m)": pM}).round(4).to_string())
report({"연습 2.1: E(S|M=m) 공식": np.allclose(cond_mean, formula),
        "정리 2.5: Σ_m E(S|M=m) p_M(m) == E S = 7": math.isclose((cond_mean * pM).sum(), 7)})

# 예제 2.3: 원판의 단면은 균등 — X 가 0.6 근처인 점들의 Y
band = np.abs(X - 0.6) < 0.01
half = math.sqrt(1 - 0.36)
print(f"X ≈ 0.6 일 때 Y 의 범위 ±{half:.2f}:  표본 사분위 {np.percentile(Y[band], [25, 50, 75]).round(3)}  (균등이면 {-half / 2:.2f}, 0, {half / 2:.2f})")
text
   E(S|M=m)  m(3m-1)/(2m-1)  p_M(m)
1    2.0000          2.0000  0.0278
2    3.3333          3.3333  0.0833
3    4.8000          4.8000  0.1389
4    6.2857          6.2857  0.1944
5    7.7778          7.7778  0.2500
6    9.2727          9.2727  0.3056
  ✓  연습 2.1: E(S|M=m) 공식
  ✓  정리 2.5: Σ_m E(S|M=m) p_M(m) == E S = 7
X ≈ 0.6 일 때 Y 의 범위 ±0.80:  표본 사분위 [-0.369  0.017  0.419]  (균등이면 -0.40, 0, 0.40)
2.2 반복기댓값과 전분산 공식 — 주사위를 던지고 그 수만큼 동전을 (예제 2.7)
정확한 계산(의 여섯 값에 대해 이항분포를 섞는다)과 시뮬레이션, 그리고 공식 , 을 나란히 놓는다.
python
# 정확한 분포: P(K=k) = Σ_n P(N=n) P(K=k | N=n)
k = np.arange(7)
pK = sum(stats.binom.pmf(k, n, 0.5) / 6 for n in range(1, 7))
EK = (k * pK).sum(); VK = (k**2 * pK).sum() - EK**2
N = rng.integers(1, 7, N_SIM)
K = rng.binomial(N, 0.5)
within = np.mean(N / 4); between = np.var(N / 2)
report({"정리 2.5: E K = E[N/2] = 1.75 (정확)": math.isclose(EK, 1.75),
        "정리 2.6: Var K = E Var(K|N) + Var E(K|N) = 77/48 (정확)": math.isclose(VK, 77 / 48),
        "시뮬레이션: 평균·분산 (±0.01)": abs(K.mean() - 1.75) < 0.01 and abs(K.var() - 77 / 48) < 0.02})
print(f"Var K = {VK:.4f} = E Var(K|N) {3.5 / 4:.4f} + Var E(K|N) {35 / 48:.4f}   → N 이 설명하는 비율 {35 / 77:.3f} (연습 2.6)")

# 연습 2.3: 무작위 합 (Wald) — N ~ 주사위, X_i ~ Exp(평균 2)
Nw = rng.integers(1, 7, 100_000)
Sw = np.array([rng.exponential(2.0, n).sum() for n in Nw])
report({"연습 2.3: E S = μ E N = 7": abs(Sw.mean() - 7) < 0.05,
        "연습 2.3: Var S = σ² E N + μ² Var N = 4·3.5 + 4·35/12": abs(Sw.var() / (4 * 3.5 + 4 * 35 / 12) - 1) < 0.02})
text
  ✓  정리 2.5: E K = E[N/2] = 1.75 (정확)
  ✓  정리 2.6: Var K = E Var(K|N) + Var E(K|N) = 77/48 (정확)
  ✓  시뮬레이션: 평균·분산 (±0.01)
Var K = 1.6042 = E Var(K|N) 0.8750 + Var E(K|N) 0.7292   → N 이 설명하는 비율 0.455 (연습 2.6)
  ✓  연습 2.3: E S = μ E N = 7
  ✓  연습 2.3: Var S = σ² E N + μ² Var N = 4·3.5 + 4·35/12
2.3 가장 좋은 예측 (정리 2.8)
처럼 관계가 직선이 아니면, 가장 좋은 직선(4.3절)보다 조건부 평균 가 낫다. 평균제곱오차를 세 예측으로 비교한다. 상수(평균) · 직선 · 조건부 평균. 정리 2.8의 피타고라스 식 도 숫자로 확인한다.
python
Xp = rng.uniform(-2, 2, N_SIM)
m_true = np.sin(2 * Xp)
Yp = m_true + rng.normal(0, 0.3, N_SIM)
b = np.cov(Xp, Yp)[0, 1] / Xp.var(); a = Yp.mean() - b * Xp.mean()
mse = {"constant E Y": np.mean((Yp - Yp.mean()) ** 2),
       "best line a + bX": np.mean((Yp - a - b * Xp) ** 2),
       "E(Y|X) = sin 2X": np.mean((Yp - m_true) ** 2)}
for name, v in mse.items():
    print(f"  {name:<18} MSE = {v:.4f}")
lhs = np.mean((Yp - (a + b * Xp)) ** 2)
rhs = np.mean((Yp - m_true) ** 2) + np.mean((m_true - (a + b * Xp)) ** 2)
report({"정리 2.8: E(Y-g)² == E(Y-m)² + E(m-g)²  (g = 직선, ±0.002)": abs(lhs - rhs) < 2e-3,
        "조건부 평균의 MSE ≈ 잡음 분산 0.09": abs(mse["E(Y|X) = sin 2X"] - 0.09) < 0.002})

fig, ax = plt.subplots(figsize=(8, 3.6))
ax.plot(Xp[:2000], Yp[:2000], ".", ms=2, color=C["hist"], alpha=0.5)
xs_ = np.linspace(-2, 2, 200)
ax.plot(xs_, np.sin(2 * xs_), color=C["key"], label="E(Y|X) — regression function")
ax.plot(xs_, a + b * xs_, color=C["stat"], label="best straight line")
ax.legend(); ax.set_title("the best predictor is the conditional mean (Theorem 2.8)")
plt.tight_layout(); plt.show()
text
  constant E Y       MSE = 0.5280
  best line a + bX   MSE = 0.4879
  E(Y|X) = sin 2X    MSE = 0.0899
  ✓  정리 2.8: E(Y-g)² == E(Y-m)² + E(m-g)²  (g = 직선, ±0.002)
  ✓  조건부 평균의 MSE ≈ 잡음 분산 0.09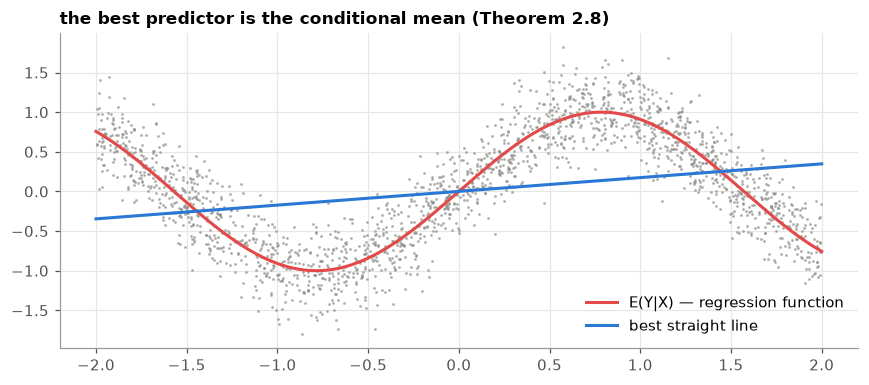
📝 연습 2.1–2.6 (강의노트): 조건부 확률질량함수, 삼각형의 조건부, 무작위 합, 두 단계의 균등, 조건부기댓값의 성질, 예측의 개선.
3. 독립
정리 3.2 (인수분해) 이고 영역이 곱의 꼴이면 독립 · 정리 3.4 독립이면 , 분산이 더해지고, mgf가 곱해진다 · 예제 3.5 .
원판은 상관이 없는데도 독립이 아니다. 확률로 보면 바로 드러난다.
python
pj = np.mean((X > 0.8) & (Y > 0.8))
pm = np.mean(X > 0.8) * np.mean(Y > 0.8)
print(f"원판: P(X>0.8, Y>0.8) = {pj:.4f}   P(X>0.8)P(Y>0.8) = {pm:.4f}   상관계수 {np.corrcoef(X, Y)[0, 1]:+.4f}")

# 예제 3.5: iid 최댓값 F^n, 최솟값 Exp(nλ)
U3 = rng.random((N_SIM, 3))
E3 = rng.exponential(1 / 2, (N_SIM, 5))        # λ = 2
report({"예제 3.5: max of 3 U(0,1) — E = 3/4": abs(U3.max(axis=1).mean() - 0.75) < 0.003,
        "예제 3.5: max 의 분포함수 x^3 (KS)": stats.kstest(U3.max(axis=1), lambda x: x**3).pvalue > 1e-3,
        "예제 3.5: min of 5 Exp(2) ~ Exp(10) (KS)": stats.kstest(E3.min(axis=1), stats.expon(scale=1 / 10).cdf).pvalue > 1e-3})

# 연습 3.4: 경쟁하는 지수분포 P(X<Y) = λ/(λ+μ)
lam, mu_ = 2.0, 3.0
race = np.mean(rng.exponential(1 / lam, N_SIM) < rng.exponential(1 / mu_, N_SIM))
report({"연습 3.4: P(X<Y) == λ/(λ+μ) = 0.4 (±0.005)": abs(race - 0.4) < 0.005})

# 정리 3.4(d): 독립합의 mgf 는 곱 — 연속 확률변수 (Exp(1) + U(0,1))
t = 0.3
Ze = rng.exponential(1.0, N_SIM) + rng.random(N_SIM)
report({"정리 3.4(d): E e^(t(X+Y)) == M_X(t) M_Y(t) (±1%)": abs(np.mean(np.exp(t * Ze)) / ((1 / (1 - t)) * (np.exp(t) - 1) / t) - 1) < 0.01})
text
원판: P(X>0.8, Y>0.8) = 0.0000   P(X>0.8)P(Y>0.8) = 0.0027   상관계수 -0.0005
  ✓  예제 3.5: max of 3 U(0,1) — E = 3/4
  ✓  예제 3.5: max 의 분포함수 x^3 (KS)
  ✓  예제 3.5: min of 5 Exp(2) ~ Exp(10) (KS)
  ✓  연습 3.4: P(X<Y) == λ/(λ+μ) = 0.4 (±0.005)
  ✓  정리 3.4(d): E e^(t(X+Y)) == M_X(t) M_Y(t) (±1%)
📝 연습 3.1–3.5 (강의노트): 이산에서 두 정의는 같다, 독립 판정, 최댓값의 기댓값, 경쟁하는 지수분포, 쌍별 독립의 한계.
4. 공분산과 상관
정의 4.1 , · 정리 4.4 (Cauchy–Schwarz) · 정리 4.6 가장 좋은 직선 .
공분산과 상관계수를 정의 그대로 구현하고 np.cov·np.corrcoef와 맞춘다. 두 주사위의 합과 최댓값(예제 4.3)은 36가지 결과로 정확히 계산한다.
python
def cov(x, y):                      # 정의 4.1 (모집단 공분산 — 분모 n)
    x, y = np.asarray(x, float), np.asarray(y, float)
    return np.mean((x - x.mean()) * (y - y.mean()))

def corr(x, y):
    return cov(x, y) / math.sqrt(cov(x, x) * cov(y, y))

S_, M_, D1 = outcomes.S.to_numpy(), outcomes.M.to_numpy(), outcomes.D1.to_numpy()
report({"예제 4.3: Cov(S,M) == 35/12 (36가지 열거)": math.isclose(cov(S_, M_), 35 / 12),
        "연습 4.1: Cov(D1,M) == 35/24": math.isclose(cov(D1, M_), 35 / 24),
        "예제 4.3: ρ(S,M) ≈ 0.86": abs(corr(S_, M_) - 0.86) < 0.001,
        "직접 구현 == np.cov(bias=True), np.corrcoef": math.isclose(cov(S_, M_), np.cov(S_, M_, bias=True)[0, 1])
        and math.isclose(corr(S_, M_), np.corrcoef(S_, M_)[0, 1])})

# 정리 4.2(c): Var(Σ a_i X_i) 전개 — 무작위 공분산 구조에서
Z = rng.standard_normal((N_SIM, 3)) @ rng.standard_normal((3, 3))
a = np.array([1.0, -2.0, 0.5])
lhs = np.var(Z @ a)
rhs = sum(a[i] ** 2 * cov(Z[:, i], Z[:, i]) for i in range(3)) + 2 * sum(a[i] * a[j] * cov(Z[:, i], Z[:, j]) for i in range(3) for j in range(i + 1, 3))
report({"정리 4.2(c): Var(a'X) == Σ a_i² Var X_i + 2 Σ_{i<j} a_i a_j Cov": math.isclose(lhs, rhs, rel_tol=1e-9)})
text
  ✓  예제 4.3: Cov(S,M) == 35/12 (36가지 열거)
  ✓  연습 4.1: Cov(D1,M) == 35/24
  ✓  예제 4.3: ρ(S,M) ≈ 0.86
  ✓  직접 구현 == np.cov(bias=True), np.corrcoef
  ✓  정리 4.2(c): Var(a'X) == Σ a_i² Var X_i + 2 Σ_{i<j} a_i a_j Cov
python
# 예제 4.7: 상관이 없어도 독립이 아니다 / 예제 4.8: 공통 원인
Xu = rng.uniform(-1, 1, N_SIM)
Zc = rng.standard_normal(N_SIM)
Xc, Yc = Zc + rng.standard_normal(N_SIM), Zc + rng.standard_normal(N_SIM)
print(f"X ~ U(-1,1), Y = X²:  ρ = {corr(Xu, Xu**2):+.4f}   (Y 는 X 로 완전히 정해지는데도)")
print(f"공통 원인 Z:          ρ(X,Y) = {corr(Xc, Yc):.4f}   (σ_Z²/(σ_Z²+σ²) = 0.5)")

# 연습 4.3: 포트폴리오 — 최소 분산
sx, sy = 0.2, 0.3
w = np.linspace(-0.2, 1.4, 400)
fig, ax = plt.subplots(figsize=(8, 3.6))
for rho, col in zip([-1, 0, 0.5, 0.9], SERIES):
    v = w**2 * sx**2 + (1 - w) ** 2 * sy**2 + 2 * w * (1 - w) * rho * sx * sy
    ax.plot(w, np.sqrt(np.maximum(v, 0)), color=col, label=fr"$\rho={rho}$")
    ws = (sy**2 - rho * sx * sy) / (sx**2 + sy**2 - 2 * rho * sx * sy)
    vs = ws**2 * sx**2 + (1 - ws) ** 2 * sy**2 + 2 * ws * (1 - ws) * rho * sx * sy
    ax.plot(ws, math.sqrt(max(vs, 0)), "o", color=col)
    print(f"ρ = {rho:+.1f}: w* = {ws:.3f},  최소 표준편차 {math.sqrt(max(vs, 0)):.4f}")
ax.set_xlabel("weight w on X"); ax.set_ylabel("sd of wX + (1-w)Y"); ax.legend(); ax.set_title("diversification works best when correlation is low")
plt.tight_layout(); plt.show()
text
X ~ U(-1,1), Y = X²:  ρ = +0.0006   (Y 는 X 로 완전히 정해지는데도)
공통 원인 Z:          ρ(X,Y) = 0.4985   (σ_Z²/(σ_Z²+σ²) = 0.5)
ρ = -1.0: w* = 0.600,  최소 표준편차 0.0000
ρ = +0.0: w* = 0.692,  최소 표준편차 0.1664
ρ = +0.5: w* = 0.857,  최소 표준편차 0.1964
ρ = +0.9: w* = 1.636,  최소 표준편차 0.1763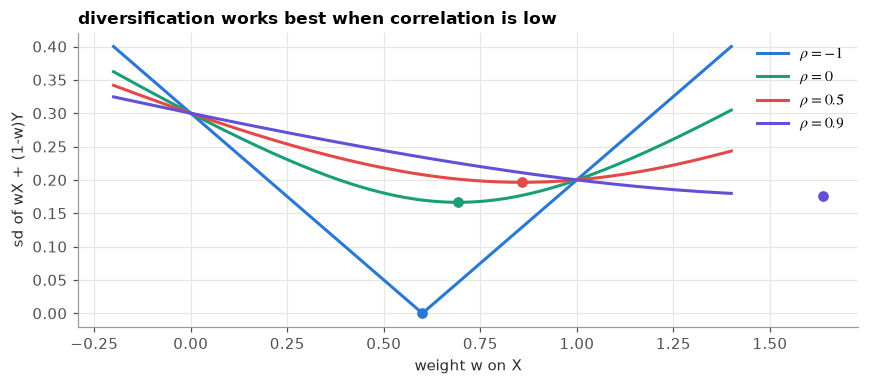
📝 연습 4.1–4.6 (강의노트): 합과 최댓값, 합과 차, 포트폴리오, 상관계수의 불변성, 부등식의 사촌들, 원판의 상관.
5. 여러 변수의 변수변환 — 야코비안
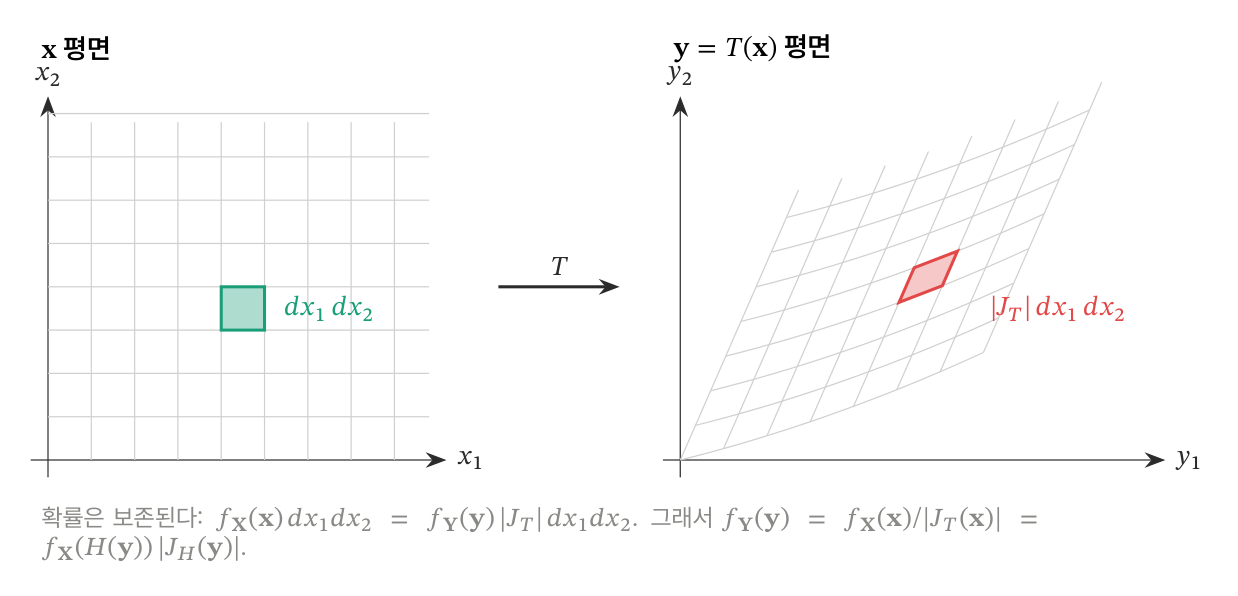
정리 5.1 · 정리 5.3 · 정리 5.4 (Box–Muller) · 정리 5.5 합성곱 · 정리 5.8 정규/정규 = Cauchy.
5.2 가우스 적분과 Box–Muller
극좌표의 이중적분으로 가우스 적분을 확인하고, Box–Muller를 직접 구현해 세 가지를 본다. (1) 각 좌표가 (KS 검정), (2) 두 좌표가 상관이 없고 이 평균 2인 지수분포(연습 5.6), (3) numpy의 정규 난수와 같은 분포.
python
I1 = integrate.quad(lambda x: math.exp(-x * x / 2), -np.inf, np.inf)[0]
I2 = integrate.dblquad(lambda r, th: math.exp(-r * r / 2) * r, 0, 2 * math.pi, 0, np.inf)[0]
report({"정리 5.3: ∫ e^(-x²/2) dx == √(2π)": math.isclose(I1, math.sqrt(2 * math.pi)),
        "정리 5.3 의 증명: 극좌표 이중적분 == 2π": math.isclose(I2, 2 * math.pi)})

def box_muller(n, rng=rng):
    """정리 5.4: 균등 난수 두 개 → 독립인 표준정규 두 개"""
    u1, u2 = rng.random(n), rng.random(n)
    r = np.sqrt(-2 * np.log(u1))
    return r * np.cos(2 * np.pi * u2), r * np.sin(2 * np.pi * u2)

Z1, Z2 = box_muller(N_SIM)
report({"Z1 ~ N(0,1) (KS)": stats.kstest(Z1, "norm").pvalue > 1e-3,
        "Z2 ~ N(0,1) (KS)": stats.kstest(Z2, "norm").pvalue > 1e-3,
        "Z1, Z2 상관 없음 (|ρ| < 0.01)": abs(np.corrcoef(Z1, Z2)[0, 1]) < 0.01,
        "연습 5.6: Z1²+Z2² ~ Exp(평균 2) (KS)": stats.kstest(Z1**2 + Z2**2, stats.expon(scale=2).cdf).pvalue > 1e-3,
        "numpy 정규 난수와 같은 분포 (두 표본 KS)": stats.ks_2samp(Z1, rng.standard_normal(N_SIM)).pvalue > 1e-3})
text
  ✓  정리 5.3: ∫ e^(-x²/2) dx == √(2π)
  ✓  정리 5.3 의 증명: 극좌표 이중적분 == 2π
text
  ✓  Z1 ~ N(0,1) (KS)
  ✓  Z2 ~ N(0,1) (KS)
  ✓  Z1, Z2 상관 없음 (|ρ| < 0.01)
  ✓  연습 5.6: Z1²+Z2² ~ Exp(평균 2) (KS)
  ✓  numpy 정규 난수와 같은 분포 (두 표본 KS)
5.3 합성곱 — 균등분포의 합, 지수분포의 합
정리 5.5를 격자 위의 수치 합성곱(np.convolve)으로 구현해, 예제 5.6의 삼각형과 연습 5.5의 2차 조각 다항식, 예제 5.7의 감마 밀도에 맞춘다.
python
h = 1e-3
grid = np.arange(0, 1, h) + h / 2
f1 = np.ones_like(grid)                           # U(0,1) 의 밀도
f2 = np.convolve(f1, f1) * h                      # 정리 5.5 (격자 근사)
f3 = np.convolve(f2, f1) * h
z2 = (np.arange(len(f2)) + 1) * h
z3 = (np.arange(len(f3)) + 1.5) * h
tri = np.where(z2 <= 1, z2, 2 - z2)
cub = np.where(z3 < 1, z3**2 / 2, np.where(z3 < 2, (-2 * z3**2 + 6 * z3 - 3) / 2, (3 - z3) ** 2 / 2))
report({"예제 5.6: U+U 의 밀도 == 삼각형 (격자 오차 < 0.005)": np.max(np.abs(f2 - tri)) < 5e-3,
        "연습 5.5: U+U+U 의 밀도 == 2차 조각 다항식": np.max(np.abs(f3 - cub)) < 5e-3})

lam = 1.5
Esum = rng.exponential(1 / lam, (N_SIM, 4)).sum(axis=1)
report({"예제 5.7·연습 5.3: Exp(λ) 4개의 합 ~ 감마(4, λ) (KS)": stats.kstest(Esum, stats.gamma(4, scale=1 / lam).cdf).pvalue > 1e-3})

fig, ax = plt.subplots(figsize=(8, 3.4))
ax.plot(z2, f2, color=C["stat"], label="U+U (numerical convolution)")
ax.plot(z3, f3, color=C["data"], label="U+U+U")
ax.plot(z2, tri, **THEORY); ax.plot(z3, cub, **THEORY)
ax.hist(rng.random((N_SIM, 3)).sum(axis=1), bins=80, density=True, histtype="step", color=C["key"], label="simulated U+U+U")
ax.legend(); ax.set_title("convolution: Simpson's triangle and its successor")
plt.tight_layout(); plt.show()
text
  ✓  예제 5.6: U+U 의 밀도 == 삼각형 (격자 오차 < 0.005)
  ✓  연습 5.5: U+U+U 의 밀도 == 2차 조각 다항식
  ✓  예제 5.7·연습 5.3: Exp(λ) 4개의 합 ~ 감마(4, λ) (KS)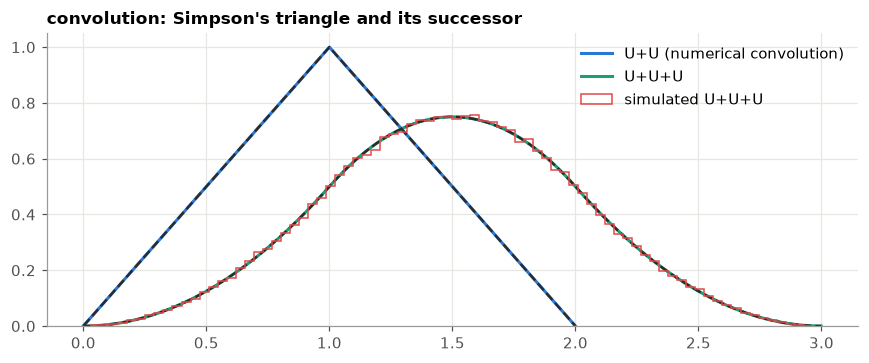
5.4 정규의 비는 Cauchy (정리 5.8), 그리고 Cauchy의 평균 (연습 5.4)
python
Cr = Z1 / Z2
report({"정리 5.8: Z1/Z2 ~ Cauchy (KS)": stats.kstest(Cr, "cauchy").pvalue > 1e-3})

# 연습 5.4: f_{C1+C2}(z) = 2/(π(4+z²)) — 합성곱 적분을 수치로
fC = lambda x: 1 / (np.pi * (1 + x**2))
conv = lambda z: integrate.quad(lambda x: fC(x) * fC(z - x), -np.inf, np.inf)[0]
zs = [0.0, 0.7, 2.0, 5.0]
report({"연습 5.4: (C1+C2) 의 밀도 == 2/(π(4+z²))": all(math.isclose(conv(z), 2 / (np.pi * (4 + z * z)), rel_tol=1e-6) for z in zs)})
C2 = (rng.standard_cauchy(N_SIM) + rng.standard_cauchy(N_SIM)) / 2
report({"(C1+C2)/2 ~ 표준 Cauchy (KS)": stats.kstest(C2, "cauchy").pvalue > 1e-3})
text
  ✓  정리 5.8: Z1/Z2 ~ Cauchy (KS)
  ✓  연습 5.4: (C1+C2) 의 밀도 == 2/(π(4+z²))
  ✓  (C1+C2)/2 ~ 표준 Cauchy (KS)
📝 연습 5.1–5.6 (강의노트): 극좌표의 반대 방향, 곱과 몫, 감마의 합, Cauchy의 평균, 균등 셋의 합, 극좌표에서 거리.
6. 평균의 정확도 — 의 법칙
정리 6.2 · 정리 6.3 상관이 없으면 · 정리 6.5 같은 상관 이면 .
python
# 정리 6.2: 연습 6.1 의 Y = (X1+X2, X2+X3)
A = np.array([[1, 1, 0], [0, 1, 1]])
X3 = rng.standard_normal((N_SIM, 3))
Ysim = X3 @ A.T
report({"정리 6.2: 표본 공분산행렬 ≈ A Σ A' = [[2,1],[1,2]] (±0.02)": np.allclose(np.cov(Ysim.T), A @ A.T, atol=0.02)})

# 정리 6.3: sd(X̄) ∝ 1/√n — 지수분포 관측
for n in [1, 4, 16, 64, 256]:
    means = rng.exponential(1.0, (20_000, n)).mean(axis=1)
    print(f"n = {n:>3}: sd(X̄) = {means.std():.4f}   σ/√n = {1 / math.sqrt(n):.4f}")
text
  ✓  정리 6.2: 표본 공분산행렬 ≈ A Σ A' = [[2,1],[1,2]] (±0.02)
n =   1: sd(X̄) = 0.9978   σ/√n = 1.0000
n =   4: sd(X̄) = 0.5033   σ/√n = 0.5000
n =  16: sd(X̄) = 0.2484   σ/√n = 0.2500
n =  64: sd(X̄) = 0.1254   σ/√n = 0.1250
n = 256: sd(X̄) = 0.0625   σ/√n = 0.0625
6.3 Simpson의 계산 (1755, 1757)
오차 분포를 합성곱 다섯 번으로 여섯 번의 합의 분포로 만든다. 1757년의 삼각형 모형(예제 6.4)과 1755년의 균등 모형(연습 6.3)을 모두 계산한다.
python
def mean_error_pmf(weights, n=6):
    """오차 -5..5 의 pmf → n 번 평균의 pmf (합의 값 -5n..5n)"""
    s = weights.copy()
    for _ in range(n - 1):
        s = np.convolve(s, weights)
    return np.arange(-5 * n, 5 * n + 1), s

vals = np.arange(-5, 6)
models = {"1757 triangle": (6 - np.abs(vals)) / 36, "1755 uniform": np.ones(11) / 11}
rows = []
for name, wgt in models.items():
    sums, ps = mean_error_pmf(wgt)
    rows.append(dict(model=name,
                     one_within_1=wgt[np.abs(vals) <= 1].sum(), mean6_within_1=ps[np.abs(sums) <= 6].sum(),
                     one_within_2=wgt[np.abs(vals) <= 2].sum(), mean6_within_2=ps[np.abs(sums) <= 12].sum(),
                     sd_one=math.sqrt((vals**2 * wgt).sum()), sd_mean6=math.sqrt((vals**2 * wgt).sum() / 6)))
simpson = pd.DataFrame(rows).set_index("model").round(3)
print(simpson.to_string())
report({"예제 6.4: 삼각형 — 한 번 0.444, 평균 0.725": tuple(simpson.loc["1757 triangle", ["one_within_1", "mean6_within_1"]]) == (0.444, 0.725),
        "연습 6.3: 균등 — 한 번 0.273, 평균 0.589": tuple(simpson.loc["1755 uniform", ["one_within_1", "mean6_within_1"]]) == (0.273, 0.589)})

fig, axes = plt.subplots(1, 2, figsize=(12, 3.4))
for ax, (name, wgt) in zip(axes, models.items()):
    sums, ps = mean_error_pmf(wgt)
    ax.bar(vals, wgt, width=0.8, color=C["hist"], alpha=0.6, label="one observation")
    ax.bar(sums / 6, ps * 6, width=0.14, color=C["key"], alpha=0.85, label="mean of six (density ×6)")
    ax.set_title(f"Simpson, {name}"); ax.set_xlabel("error (seconds)"); ax.legend(fontsize=8)
plt.tight_layout(); plt.show()
text
               one_within_1  mean6_within_1  one_within_2  mean6_within_2  sd_one  sd_mean6
model
1757 triangle         0.444           0.725         0.667           0.967   2.415     0.986
1755 uniform          0.273           0.589         0.455           0.892   3.162     1.291
  ✓  예제 6.4: 삼각형 — 한 번 0.444, 평균 0.725
  ✓  연습 6.3: 균등 — 한 번 0.273, 평균 0.589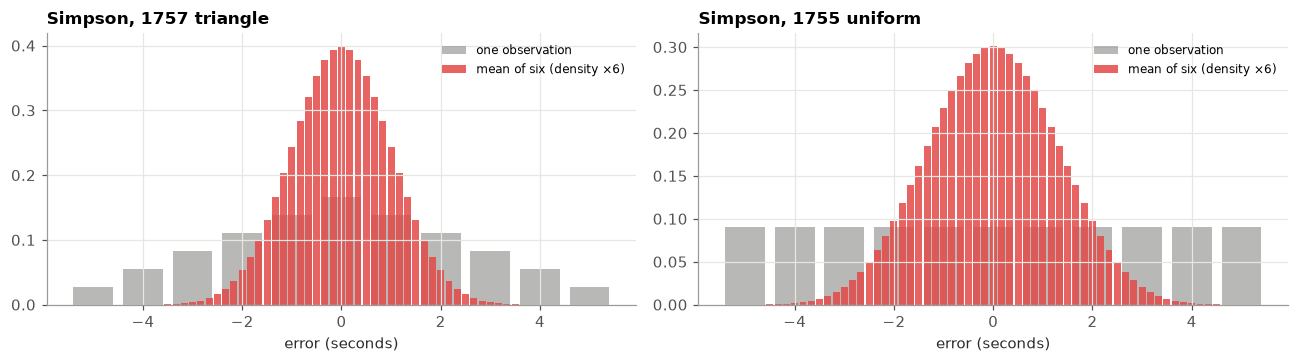
6.4 Pyx 재판 — 과 (1848년의 금화 10,000개)
구간으로 기록된 편차에 정규분포를 맞춰(구간 확률의 가능도를 최대로 — 9회의 최대가능도를 미리 쓴다) 동전 하나의 표준편차 를 추정한다. 그다음 조폐국장이 동전마다 씩 가볍게 만들 때 개 총무게가 검사를 통과할 확률을 두 허용오차(과 )에서 시뮬레이션한다.
python
pyx = load_rdata("Pyx")
R = 0.25625
edges = {"Below -R": (-np.inf, -R), "(-R to -.2)": (-R, -0.2), "(-.2 to -.l)": (-0.2, -0.1), "(-.1 to 0)": (-0.1, 0),
         "(0 to .l)": (0, 0.1), "(.1 to .2)": (0.1, 0.2), "(.2 to R)": (0.2, R), "Above R": (R, np.inf)}   # 원자료의 '1' 이 'l' 로 적혀 있다
cnt = pyx.groupby("Deviation")["count"].sum()
print(cnt.reindex(list(edges)).to_string(), "\n")

def nll(par):
    mu, log_s = par
    s = math.exp(log_s)
    return -sum(c * math.log(stats.norm.cdf(edges[k][1], mu, s) - stats.norm.cdf(edges[k][0], mu, s)) for k, c in cnt.items())

fit = optimize.minimize(nll, [0.0, math.log(0.1)], method="Nelder-Mead")
mu_hat, sigma = fit.x[0], math.exp(fit.x[1])
outside = cnt[["Below -R", "Above R"]].sum() / cnt.sum()
print(f"구간 자료의 정규 적합: μ = {mu_hat:+.4f}, σ = {sigma:.4f} 그레인   (R = {R}, R/σ = {R / sigma:.2f})   ±R 밖: {outside:.3%}")
report({"σ ≈ 0.13, R ≈ 2σ": abs(sigma - 0.13) < 0.005 and abs(R / sigma - 2) < 0.1})
text
Deviation
Below -R         209
(-R to -.2)      362
(-.2 to -.l)    1261
(-.1 to 0)      3023
(0 to .l)       2631
(.1 to .2)      1733
(.2 to R)        536
Above R          245

구간 자료의 정규 적합: μ = +0.0104, σ = 0.1298 그레인   (R = 0.25625, R/σ = 1.97)   ±R 밖: 4.540%
  ✓  σ ≈ 0.13, R ≈ 2σ
python
n = 1000
deltas = np.array([0.0, 0.005, 0.012, 0.05, 0.15, 0.24, 0.25])
reps = 20_000
rows = []
for d in deltas:
    total_dev = rng.normal(-d, sigma, (reps, n)).sum(axis=1) if d in (0.0, 0.24) else rng.normal(-n * d, sigma * math.sqrt(n), reps)
    rows.append(dict(delta=d, pass_nR=np.mean(np.abs(total_dev) <= n * R),
                     pass_3sigma_sqrt_n=np.mean(np.abs(total_dev) <= 3 * sigma * math.sqrt(n))))
print(pd.DataFrame(rows).round(3).to_string(index=False))

dd = np.linspace(0, 0.3, 300)
s_tot = sigma * math.sqrt(n)
fig, ax = plt.subplots(figsize=(8, 3.4))
ax.plot(dd, stats.norm.cdf((n * R - n * dd) / s_tot) - stats.norm.cdf((-n * R - n * dd) / s_tot), color=C["stat"], label="tolerance nR (the Mint)")
ax.plot(dd, stats.norm.cdf(3 - math.sqrt(n) * dd / sigma) - stats.norm.cdf(-3 - math.sqrt(n) * dd / sigma), color=C["key"], label=r"tolerance $3\sigma\sqrt{n}$")
ax.axvline(R, color=C["hist"], ls=":", lw=1); ax.text(R, 0.5, " R", color=C["hist"])
ax.set_xlabel("shaving per coin δ (grains)"); ax.set_ylabel("P(pass), n = 1000"); ax.legend(loc="center left", bbox_to_anchor=(0.15, 0.4))
ax.set_title("the Trial of the Pyx: n vs √n")
plt.tight_layout(); plt.show()
d_max = R - stats.norm.ppf(0.99) * sigma / math.sqrt(n)
print(f"\n연습 6.4: 허용오차 nR 에서 통과 확률 0.99 를 지키는 최대 δ = {d_max:.4f} 그레인"
      f"  → 금화 100만 개면 {d_max * 1e6:,.0f} 그레인 ≈ {d_max * 1e6 / 5760:.0f} 트로이 파운드")
text
 delta  pass_nR  pass_3sigma_sqrt_n
 0.000    1.000               0.998
 0.005    1.000               0.963
 0.012    1.000               0.528
 0.050    1.000               0.000
 0.150    1.000               0.000
 0.240    1.000               0.000
 0.250    0.936               0.000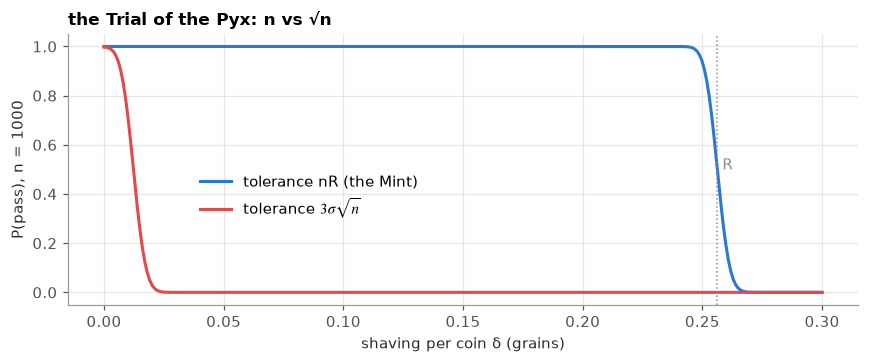
text
연습 6.4: 허용오차 nR 에서 통과 확률 0.99 를 지키는 최대 δ = 0.2467 그레인 → 금화 100만 개면 246,701 그레인 ≈ 43 트로이 파운드표 읽기. 허용오차가 이면 동전마다 그레인(허용오차의 94%)을 깎아도 거의 언제나 통과한다. 허용오차를 으로 잡으면 그레인만 깎아도 통과 확률이 절반으로 떨어진다. 무작위 오차는 으로 쌓이고, 체계적인 깎기는 으로 쌓인다. 은 둘을 구별하지 못한다.
6.5 상관된 관측 — 유효 표본 크기
공통 요인 하나()로 같은 상관 를 갖는 관측을 만든다. 그리고 AR(1)의 분산 배율 (예제 6.6)와 대조변량법(연습 6.6)을 본다.
python
rows = []
for rho in [0.0, 0.01, 0.1]:
    for n in [10, 100, 1000]:
        F = rng.standard_normal(4000)
        Xe = math.sqrt(rho) * F[:, None] + math.sqrt(1 - rho) * rng.standard_normal((4000, n))
        rows.append(dict(rho=rho, n=n, var_mean=Xe.mean(axis=1).var(), theory=rho + (1 - rho) / n, n_eff=n / (1 + (n - 1) * rho)))
eq = pd.DataFrame(rows)
print(eq.round(4).to_string(index=False))
report({"정리 6.5: 시뮬레이션 분산 ≈ ρ + (1-ρ)/n (상대오차 < 10%)": np.all(np.abs(eq.var_mean / eq.theory - 1) < 0.1)})

# 예제 6.6: AR(1) 의 정확한 분산 배율 (연습 6.5)
def ar1_factor(n, rho):
    k = np.arange(1, n)
    return 1 + 2 * np.sum((n - k) * rho**k) / n
for rho in [0.5, 0.9]:
    print(f"AR(1) ρ = {rho}: n Var(X̄)/σ² = {ar1_factor(1000, rho):.3f}   (1+ρ)/(1-ρ) = {(1 + rho) / (1 - rho):.3f}")

# 연습 6.6: 대조변량법 — g = e^x
U = rng.random(N_SIM)
plain = np.exp(rng.random((N_SIM, 2))).mean(axis=1)
anti = (np.exp(U) + np.exp(1 - U)) / 2
print(f"독립 두 개의 평균: 분산 {plain.var():.4f}   대조변량: 분산 {anti.var():.4f}   (약 {plain.var() / anti.var():.0f}배 작다)")
text
 rho    n  var_mean  theory     n_eff
0.00   10    0.1025  0.1000   10.0000
0.00  100    0.0096  0.0100  100.0000
0.00 1000    0.0010  0.0010 1000.0000
0.01   10    0.1030  0.1090    9.1743
0.01  100    0.0192  0.0199   50.2513
0.01 1000    0.0111  0.0110   90.9918
0.10   10    0.1880  0.1900    5.2632
0.10  100    0.1090  0.1090    9.1743
0.10 1000    0.0995  0.1009    9.9108
  ✓  정리 6.5: 시뮬레이션 분산 ≈ ρ + (1-ρ)/n (상대오차 < 10%)
AR(1) ρ = 0.5: n Var(X̄)/σ² = 2.996   (1+ρ)/(1-ρ) = 3.000
AR(1) ρ = 0.9: n Var(X̄)/σ² = 18.820   (1+ρ)/(1-ρ) = 19.000
독립 두 개의 평균: 분산 0.1211   대조변량: 분산 0.0039   (약 31배 작다)
📝 연습 6.1–6.6 (강의노트): 공분산행렬, 양의 준정부호, Simpson의 1755년 모형, Pyx 재판의 이득, AR(1)의 분산, 음의 상관.
7. 부숴보기 — 평균이 통하지 않을 때
7.1 Borel의 역설
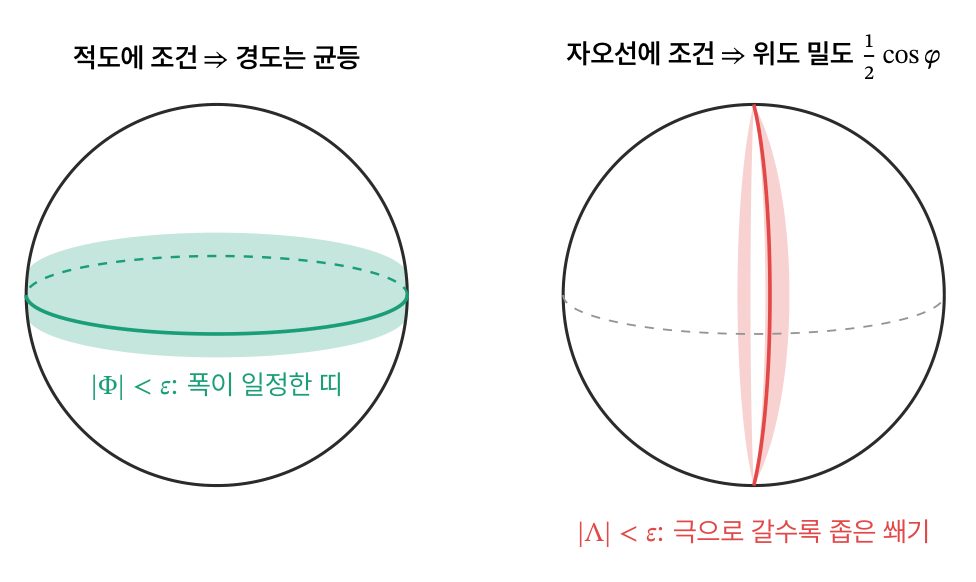
구면 위의 균등한 점에서 (a) 적도 근처의 띠 에 든 점의 경도, (b) 자오선 근처의 쐐기 에 든 점의 위도를 본다. 같은 종류의 대원인데 (a)는 균등하고 (b)는 다. 이어서 연습 7.2의 평면판(같은 직선 , 두 가지 조건)을 본다.
python
v = rng.standard_normal((2_000_000, 3)); v /= np.linalg.norm(v, axis=1, keepdims=True)
lat, lon = np.arcsin(v[:, 2]), np.arctan2(v[:, 1], v[:, 0])
eps = 0.01
lon_eq = lon[np.abs(lat) < eps]
lat_mer = lat[(np.abs(lon) < eps) | (np.abs(np.abs(lon) - np.pi) < eps)]

Xb, Yb = rng.standard_normal(4_000_000), rng.standard_normal(4_000_000)
by_diff = Xb[np.abs(Xb - Yb) < 0.01]
by_ratio = Xb[np.abs(Yb / Xb - 1) < 0.01]

fig, axes = plt.subplots(1, 3, figsize=(13, 3.4))
axes[0].hist(lon_eq, bins=36, density=True, color=C["data"], alpha=0.8); axes[0].axhline(1 / (2 * np.pi), **THEORY)
axes[0].set_title("equator: longitude is uniform")
pp = np.linspace(-np.pi / 2, np.pi / 2, 200)
axes[1].hist(lat_mer, bins=36, density=True, color=C["key"], alpha=0.7); axes[1].plot(pp, np.cos(pp) / 2, **THEORY)
axes[1].set_title(r"meridian: latitude density $\frac{1}{2}\cos\varphi$")
xx = np.linspace(-3, 3, 300)
axes[2].hist(by_diff, bins=60, density=True, histtype="step", color=C["stat"], lw=2, label=r"via $X-Y=0$: N(0, 1/2)")
axes[2].hist(by_ratio, bins=60, density=True, histtype="step", color=C["key"], lw=2, label=r"via $Y/X=1$: $|x|e^{-x^2}$")
axes[2].plot(xx, stats.norm.pdf(xx, 0, math.sqrt(0.5)), **THEORY); axes[2].plot(xx, np.abs(xx) * np.exp(-xx**2), **THEORY)
axes[2].legend(fontsize=8); axes[2].set_title("same line {X = Y}, two answers (Ex. 7.2)")
plt.tight_layout(); plt.show()
report({"적도: 경도 균등 (KS)": stats.kstest(lon_eq, stats.uniform(-np.pi, 2 * np.pi).cdf).pvalue > 1e-3,
        "자오선: 위도 cdf (1+sin φ)/2 (KS)": stats.kstest(lat_mer, lambda p: (1 + np.sin(p)) / 2).pvalue > 1e-3})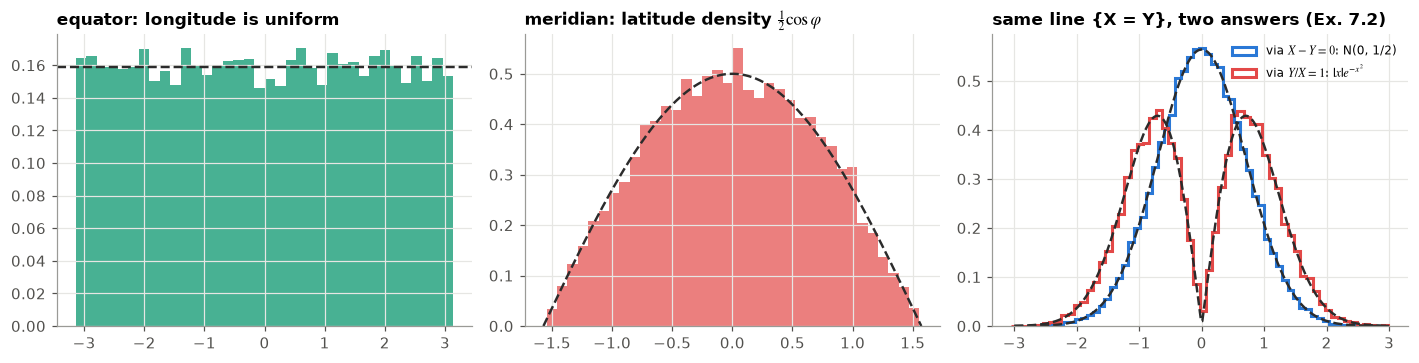
text
  ✓  적도: 경도 균등 (KS)
  ✓  자오선: 위도 cdf (1+sin φ)/2 (KS)
7.3 평균으로 줄지 않는 오차 — Michelson(1879)과 Cavendish(1798)
은 흩어짐을 줄이지만 편향은 줄이지 않는다. Michelson의 100개 측정의 평균은 오늘의 값(같은 척도로 734.5)에서 표준오차의 15배 떨어져 있다. Stigler(1977)가 나눈 다섯 묶음의 평균도 본다(연습 7.4).
python
mi = load_rdata("Michelson").velocity
ms = load_rdata("MichelsonSets")
cv = load_rdata("Cavendish").density2
for name, x, truth in [("Michelson 1879", mi, 734.5), ("Cavendish 1798", cv, 5.513)]:
    se = x.std(ddof=1) / math.sqrt(len(x))
    print(f"{name}: n = {len(x)}, 평균 {x.mean():.4g}, 표준오차 {se:.3g},  (평균 - 참값)/표준오차 = {(x.mean() - truth) / se:+.1f}")
print(f"\nMichelson 다섯 묶음의 평균 {ms.mean().round(1).tolist()}")
print(f"묶음 평균의 표준편차 {ms.mean().std(ddof=1):.1f}   독립이면 기대되는 σ/√20 = {mi.std(ddof=1) / math.sqrt(20):.1f}")
b = mi.mean() - 734.5
print(f"연습 7.3: 편향² = {b**2:,.0f},  분산 σ²/n = {mi.var(ddof=1) / 100:,.0f}  → 평균제곱오차의 {b**2 / (b**2 + mi.var(ddof=1) / 100):.1%} 가 편향")

fig, axes = plt.subplots(1, 2, figsize=(12, 3.4))
for ax, (name, x, truth) in zip(axes, [("Michelson 1879 (km/s - 299,000)", mi, 734.5), ("Cavendish 1798 (g/cm³)", cv, 5.513)]):
    k = np.arange(1, len(x) + 1)
    run = np.cumsum(x) / k
    se = x.std(ddof=1) / np.sqrt(k)
    ax.plot(k, x, ".", color=C["hist"], ms=4)
    ax.plot(k, run, color=C["stat"], label="running mean")
    ax.fill_between(k[1:], (run - 2 * se)[1:], (run + 2 * se)[1:], color=C["stat"], alpha=0.15, lw=0)
    ax.axhline(truth, color=C["key"], ls="--", label="today's value")
    ax.set_title(name); ax.set_xlabel("number of measurements"); ax.legend(fontsize=8)
plt.tight_layout(); plt.show()
text
Michelson 1879: n = 100, 평균 852.4, 표준오차 7.9,  (평균 - 참값)/표준오차 = +14.9
Cavendish 1798: n = 29, 평균 5.482, 표준오차 0.0384,  (평균 - 참값)/표준오차 = -0.8

Michelson 다섯 묶음의 평균 [852.5, 854.5, 858.5, 857.0, 839.5]
묶음 평균의 표준편차 7.6   독립이면 기대되는 σ/√20 = 17.7
연습 7.3: 편향² = 13,900,  분산 σ²/n = 62  → 평균제곱오차의 99.6% 가 편향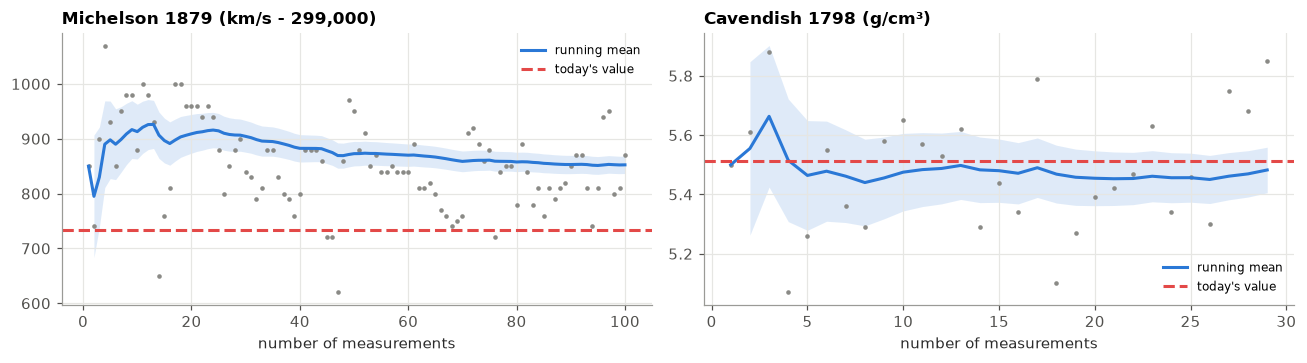
📝 연습 7.1–7.4 (강의노트): 위도의 분포, 같은 직선 다른 조건, 편향과 분산, Michelson의 다섯 묶음.
8. Beautiful insights — 같은 계산, 오늘의 문제
8.1 신경망의 초기화
폭 256인 층을 30개 쌓고 무작위 입력을 통과시킨다. 층마다 출력의 분산이 배(ReLU이면 그 절반)가 되므로, 를 잘못 고르면 분산이 폭발하거나 사라진다. LeCun 은 선형 층을, He 은 ReLU 층을 지킨다.
python
def forward_variance(scale, act, width=256, depth=30, batch=512):
    h = rng.standard_normal((batch, width))
    out = []
    for _ in range(depth):
        W = rng.standard_normal((width, width)) * math.sqrt(scale / width)
        h = h @ W
        if act == "relu":
            h = np.maximum(h, 0)
        out.append(h.var())
    return np.array(out)

fig, ax = plt.subplots(figsize=(8, 3.8))
for (scale, act, lab), col in zip([(1, "linear", r"linear, $\sigma_w^2=1/n$"), (1, "relu", r"ReLU, $\sigma_w^2=1/n$"),
                                   (2, "relu", r"ReLU, $\sigma_w^2=2/n$ (He)"), (3, "relu", r"ReLU, $\sigma_w^2=3/n$")], SERIES):
    ax.semilogy(np.arange(1, 31), forward_variance(scale, act), "o-", ms=3, color=col, label=lab)
ax.set_xlabel("layer"); ax.set_ylabel("variance of activations"); ax.legend(); ax.set_title("keeping the variance: Var s = n σ_w² v")
plt.tight_layout(); plt.show()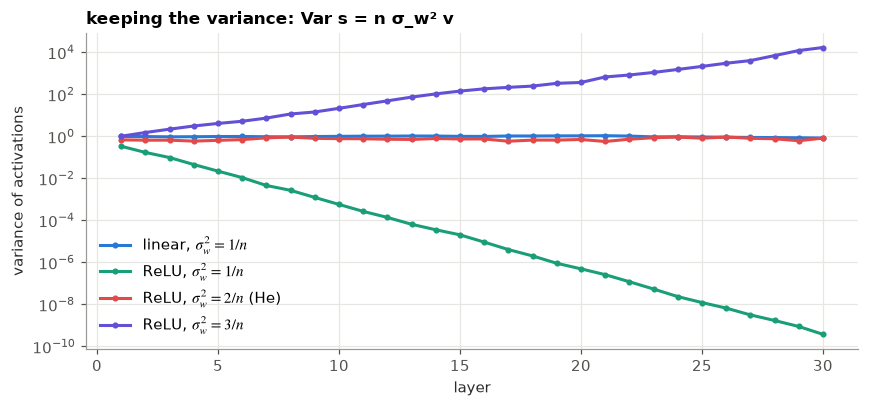
8.2 재매개화와 8.3 앙상블
연습 8.2의 재매개화 기울기 추정량의 분산 을 확인하고, 앙상블에서 상관 가 바닥을 정하는 것(정리 6.5)을 시뮬레이션한다(연습 8.3).
python
mu0, n = 1.0, 50
grads = np.array([np.mean(2 * (mu0 + rng.standard_normal(n) - 3)) for _ in range(20_000)])
report({"연습 8.2: 재매개화 기울기의 평균 == L'(μ) = 2(μ-3)": abs(grads.mean() - 2 * (mu0 - 3)) < 0.01,
        "연습 8.2: 분산 == 4/n": abs(grads.var() / (4 / n) - 1) < 0.03})

def ensemble_var(B, rho, sigma2=1.0, reps=20_000):
    F = rng.standard_normal(reps)
    preds = math.sqrt(sigma2) * (math.sqrt(rho) * F[:, None] + math.sqrt(1 - rho) * rng.standard_normal((reps, B)))
    return preds.mean(axis=1).var()
print(f"연습 8.3: ρ=0.3, σ²=1, B=100 → {ensemble_var(100, 0.3):.3f} (이론 0.307)    ρ=0.1, σ²=1.5 → {ensemble_var(100, 0.1, 1.5):.3f} (이론 0.164)")
text
  ✓  연습 8.2: 재매개화 기울기의 평균 == L'(μ) = 2(μ-3)
  ✓  연습 8.2: 분산 == 4/n
연습 8.3: ρ=0.3, σ²=1, B=100 → 0.313 (이론 0.307)    ρ=0.1, σ²=1.5 → 0.165 (이론 0.164)
9. 정리 · 연습문제 지도 · 다음 회
| 내용 | 확인한 셀 | |
|---|---|---|
| 결합·주변 (1.3, 1.6) | 두 주사위 표, 원판의 반원 밀도 | 1절 |
| 선형성 (1.9) | 독립이 아닌 에서도 | 1.4 |
| 반복기댓값 · 전분산 (2.5, 2.6) | , 주사위–동전, Wald | 2.1, 2.2 |
| 가장 좋은 예측 (2.8) | 조건부 평균 vs 직선 vs 상수, 피타고라스 | 2.3 |
| 독립 (3.2, 3.4) | 원판은 독립 아님, 최댓값 , 경쟁, mgf의 곱 | 3절 |
| 공분산 (4.2–4.6) | , 공통 원인, 포트폴리오 | 4절 |
| 야코비안 (5.1–5.8) | 가우스 적분, Box–Muller, 합성곱, 정규/정규 = Cauchy | 5절 |
| (6.2–6.5) | Simpson, Pyx 1848, 유효 표본 크기, AR(1), 대조변량 | 6절 |
| 부숴보기 (7.1, 7.2) | Borel 역설, Michelson의 편향 | 7절 |
| 오늘의 문제 (8절) | 초기화, 재매개화, 앙상블 | 8절 |
연습문제 지도 (강의노트, ★ 계산 · ★★ 증명 · ★★★ 도전, 풀이는 부록 A)
| 절 | 연습 | 이 노트북에서 확인하는 셀 |
|---|---|---|
| 1 결합분포 | 1.1 ★ · 1.2 삼각형 ★ · 1.3 최대·최소 ★ · 1.4 원판의 거리 ★★ · 1.5 ★ · 1.6 주변 밀도 증명 ★★ · 1.7 선형성 증명 ★★ (유도형) | 1절 |
| 2 조건부 | 2.1 ★ · 2.2 ★ · 2.3 Wald ★★ · 2.4 두 단계 ★★ · 2.5 ★★ · 2.6 ★ | 2절 |
| 3 독립 | 3.1 ★★ · 3.2 ★ · 3.3 최댓값 ★ · 3.4 경쟁 ★★ · 3.5 ★★ · 3.6 독립의 결과들 증명 ★★ (유도형) | 3절 |
| 4 공분산 | 4.1 ★★ · 4.2 ★ · 4.3 포트폴리오 ★★ · 4.4 ★ · 4.5 ★★ · 4.6 ★ · 4.7 계산 규칙 증명 ★ · 4.8 선형 예측 증명 ★★ (유도형) | 4절 |
| 5 야코비안 | 5.1 ★ · 5.2 ★★ · 5.3 감마 ★★ · 5.4 Cauchy의 평균 ★★★ · 5.5 ★★ · 5.6 ★ · 5.7 정규의 비 증명 ★★ (유도형) | 5절 |
| 6 √n | 6.1 ★ · 6.2 ★★ · 6.3 Simpson 1755 ★ · 6.4 Pyx ★★ · 6.5 AR(1) ★★ · 6.6 대조변량 ★★ · 6.7 선형변환 증명 ★ (유도형) | 6절 |
| 7 · 8 | 7.1 ★ · 7.2 ★★ · 7.3 ★ · 7.4 ★★ · 8.1 ★ · 8.2 ★★ · 8.3 ★ | 7절, 8절 |
다음 회 (4회) — 셈하는 분포와 섞인 분포 (1711 → 1898). 이번 회차의 지수분포의 합(감마)과 무작위 횟수의 동전(혼합)을 분포의 가족으로 정리한다. 이항의 극한인 Poisson, 그 대기시간인 감마, Bayes의 당구대에서 나온 베타, 여러 집단이 섞인 혼합분포. 역사의 질문은 Bortkiewicz(1898)의 것이다. 프로이센 기병대에서 말에 차여 죽은 병사의 수는 어떤 분포를 따르는가?
10. 워크북 검산
워크북(03_averaging_workbook.pdf)의 문제는 손으로 먼저 푼다. 이 절은 다 푼 뒤에 쓴다.
check("A1a", "2/5")— 문항 번호와 손으로 구한 답을 넣으면 맞는지만 알려 준다. 정답은 보여 주지 않는다. 답은 수(2/5,0.4)나 식의 문자열("x + 1","1 - abs(v)")로 넣는다. 소문항은"A1a"처럼 번호 뒤에 붙인다. 소수로 넣으면 상대오차 0.1%까지 맞다고 본다.- 시뮬레이션으로 한 번 더 — 확률이나 기댓값이 답인 문항은 아래에 시뮬레이션 함수를 정의해 두었다. 손으로 구한 값이 Monte Carlo 구간 안에 드는지 본다. 함수는 정의만 해 두었고 부르지 않았다. 답을 구하기 전에 부르면 답이 보인다.
증명 문제(B, C의 대부분)는 check()가 없다. 풀이판의 증명과 단계별로 맞춰 본다.
답 열쇠 셀 (내려받은 노트북에서 실행된다)
답 열쇠를 압축해 넣은 check() 정의 셀이다. 웹에서는 이 회차의 답 확인 페이지를 쓴다.
python
check()                 # 확인할 수 있는 문항 번호
check("A1a")            # 답을 넣지 않으면 쓰는 법을 알려 준다
text
확인할 수 있는 문항: A1a A1b A1c A1d A2a A2b A2c A2d A3a A3b A3c A4a A4b A5a A5b A6a A6b A6c A7a A7b A7c A7d A8a A8b A8c A9a A9b A10a A10b A11a A11b A11c A12a A12b A13a A13b A14a A14b A14c C3c C6c C8c D1b D1c D1d D2c D2d D3b D3c D3d D4c
A1a: 아직 답을 넣지 않았다. 예: check('A1a', '3/8')
10.1 내 답을 모아 확인하기
푼 문항의 답을 아래 사전에 채우고 실행한다. None인 문항은 건너뛴다.
python
mine = {
    "A1a": None, "A1b": None, "A1c": None, "A1d": None, "A2a": None, "A2b": None, "A2c": None, "A2d": None,
    "A3a": None, "A3b": None, "A3c": None, "A4a": None, "A4b": None, "A5a": None, "A5b": None,
    "A6a": None, "A6b": None, "A6c": None, "A7a": None, "A7b": None, "A7c": None, "A7d": None,
    "A8a": None, "A8b": None, "A8c": None, "A9a": None, "A9b": None, "A10a": None, "A10b": None,
    "A11a": None, "A11b": None, "A11c": None, "A12a": None, "A12b": None, "A13a": None, "A13b": None,
    "A14a": None, "A14b": None, "A14c": None,
    "C3c": None, "C6c": None, "C8c": None,
    "D1b": None, "D1c": None, "D1d": None, "D2c": None, "D2d": None, "D3b": None, "D3c": None, "D3d": None, "D4c": None,
}
check_all(mine)
text
0/0 맞음10.2 시뮬레이션 함수
각 함수는 (추정값, 표준오차)를 돌려준다. 손으로 구한 값이 추정값 ± 3 × 표준오차 안에 들면 계산이 맞을 가능성이 높다. 정확한 검산은 check()가 한다.
| 함수 | 문항 | 시뮬레이션 |
|---|---|---|
sim_A9() |
A9(b) 두 균등 난수의 거리 | |
sim_A10() |
A10(a) 지수분포의 최솟값 | |
sim_A12() |
A12(b) 성공률이 균등한 두 번 | |
sim_A13() |
A13(a) 정규 두 개 | |
sim_A14() |
A14(c) 균등분포의 합 | |
sim_C3() |
C3(c) 공통 성공률 | |
sim_C8(lam) |
C8(c) 지수분포의 비율 | |
sim_D1() |
D1(b)(d) 막대 세 조각 | 삼각형 확률, 가장 긴 조각의 평균 |
sim_D2(rho) |
D2(c) 두 정규가 함께 양수 | |
sim_D3(n) |
D3(d) 최솟값과 최댓값 |
python
def _prop(hits):
    """불리언 배열 → (비율, 표준오차)"""
    hits = np.asarray(hits, dtype=bool)
    p = hits.mean()
    return p, np.sqrt(p * (1 - p) / hits.size)


def _mean(values):
    """표본 → (평균, 표준오차)"""
    values = np.asarray(values, dtype=float)
    return values.mean(), values.std(ddof=1) / np.sqrt(values.size)


def _corr(a, b):
    """표본 상관계수와 근사 표준오차 (1 - r^2)/sqrt(n)"""
    r = np.corrcoef(a, b)[0, 1]
    return r, (1 - r * r) / np.sqrt(len(a))


def sim_A9(n=N_SIM):
    x, y = rng.random(n), rng.random(n)
    return _prop(np.abs(x - y) > 0.5)


def sim_A10(n=N_SIM):
    x, y = rng.exponential(1.0, n), rng.exponential(0.5, n)      # 척도 = 1/λ
    return _mean(np.minimum(x, y))


def sim_A12(n=N_SIM):
    x = rng.random(n)
    y = rng.binomial(2, x)
    return _prop(x[y == 2] > 0.5)


def sim_A13(n=N_SIM):
    x, y = rng.standard_normal(n), rng.standard_normal(n)
    return _prop(x * x + y * y <= 1)


def sim_A14(n=N_SIM):
    return _prop(rng.uniform(0, 1, n) + rng.uniform(0, 2, n) <= 1)


def sim_C3(n=N_SIM):
    z = rng.random(n)
    x, y = rng.random(n) < z, rng.random(n) < z
    x, y = x.astype(float), y.astype(float)
    return _mean((x - x.mean()) * (y - y.mean()))


def sim_C8(lam=1.0, n=N_SIM):
    x, y = rng.exponential(1 / lam, n), rng.exponential(1 / lam, n)
    return _prop(x > 2 * y)


def sim_D1(n=N_SIM):
    """(삼각형을 만들 확률, 가장 긴 조각의 평균) 각각 (추정값, 표준오차)"""
    u = np.sort(rng.random((n, 2)), axis=1)
    pieces = np.column_stack([u[:, 0], u[:, 1] - u[:, 0], 1 - u[:, 1]])
    longest = pieces.max(axis=1)
    return _prop(longest < 0.5), _mean(longest)


def sim_D2(rho, n=N_SIM):
    z1, z2 = rng.standard_normal(n), rng.standard_normal(n)
    x, y = z1, rho * z1 + np.sqrt(1 - rho * rho) * z2
    return _prop((x > 0) & (y > 0))


def sim_D3(size, n=N_SIM):
    u = rng.random((n, size))
    return _corr(u.min(axis=1), u.max(axis=1))
python
# 자체 검사 (출력 없음): 시뮬레이션이 답 열쇠와 맞는지, check()가 답 열쇠의 값과 그 소수를 맞다고 하는지 확인한다.
def _close(sim, key, z=4.0, **pt):
    est, se = sim
    return abs(est - _value(key, **pt)) <= z * se + 1e-12

assert _close(sim_A9(), "A9b")
assert _close(sim_A10(), "A10a")
assert _close(sim_A12(), "A12b")
assert _close(sim_A13(), "A13a")
assert _close(sim_A14(), "A14c")
assert _close(sim_C3(), "C3c")
assert _close(sim_C8(1.7), "C8c")
_tri, _long = sim_D1()
assert _close(_tri, "D1b") and _close(_long, "D1d")
assert _close(sim_D2(0.5), "D2c", rho=0.5) and _close(sim_D2(-0.3), "D2c", rho=-0.3)
assert _close(sim_D3(3), "D3d")
for _k, _e in _WB.items():
    assert _same(_e, _e["value"])
    if not _e.get("vars") and "points" not in _e:
        assert _same(_e, float(sp.sympify(_e["value"])))