Skip to content

3회 · 왜 평균을 내는가 · 노트

8 Beautiful insights — 같은 계산, 오늘의 문제 ​

8.1 신경망의 초기화 — 분산을 지키기 ​

신경망의 한 층은 입력 x1,…,xnx_1,\dots,x_n에 가중치를 곱해 더한다: s=∑j=1nwjxjs=\sum_{j=1}^nw_jx_j. 처음에 가중치를 무작위로 뽑는다. wjw_j들이 서로 독립이고 입력과도 독립이며 평균 0, 분산 σw2\sigma_w^2이고, 입력이 평균 0, 분산 vv라 하자. 그러면 정리 3.4와 E(wjxj)=0E(w_jx_j)=0으로

Var⁡s=∑j=1nVar⁡(wjxj)=∑j=1nEwj2 Exj2=n σw2 v.\Var s=\sum_{j=1}^n\Var(w_jx_j)=\sum_{j=1}^nE w_j^2\,E x_j^2=n\,\sigma_w^2\,v .

층을 지날 때마다 분산이 nσw2n\sigma_w^2배가 된다. 층이 50개이면 (nσw2)50(n\sigma_w^2)^{50}배다. 1보다 조금만 커도 폭발하고 조금만 작아도 사라진다. 그래서 σw2=1n\sigma_w^2=\tfrac1n으로 놓는다(LeCun 1998, Glorot–Bengio 2010). 활성화 함수가 ReLU max⁡(0,s)\max(0,s)이면 대칭인 ss에 대해 Emax⁡(0,s)2=12Es2E\max(0,s)^2=\tfrac12Es^2이므로 절반을 잃는다. 그것을 메우는 σw2=2n\sigma_w^2=\tfrac2n이 He 초기화(2015)다. 2회의 선형성과 3회의 독립합의 분산만으로 얻은 처방이다.

8.2 재매개화 — Box–Muller의 생각 ​

정리 5.4의 핵심은 “복잡한 분포의 난수를 고정된 단순한 난수의 함수로 쓴다”는 것이다. 정규분포 N(μ,σ2)\N(\mu,\sigma^2)의 난수는 μ+σZ\mu+\sigma Z, Z∼N(0,1)Z\sim\N(0,1)이다(2회 예제 4.5). 변분 오토인코더(VAE, Kingma–Welling 2014)는 이것을 재매개화 기법이라 부른다. EX∼N(μ,σ2)[g(X)]=EZ[g(μ+σZ)]E_{X\sim\N(\mu,\sigma^2)}[g(X)]=E_Z[g(\mu+\sigma Z)]이므로, 모수 μ,σ\mu,\sigma에 대한 기울기를 기댓값 안으로 넣어 ZZ의 표본으로 추정할 수 있다. 분포가 모수에 달려 있던 문제가, 함수가 모수에 달린 문제로 바뀐다.

같은 생각을 끝까지 밀면 정규화 흐름(normalizing flow)이 된다. 단순한 Z\Z에 학습 가능한 일대일 변환 TθT_\theta를 여러 번 걸어 X=Tθ(Z)\X=T_\theta(\Z)를 만들면, 정리 5.1으로

log⁡fX(x)=log⁡fZ(Tθ−1(x))+log⁡∣det⁡JTθ−1(x)∣.\log f_{\X}(\x)=\log f_{\Z}\bigl(T_\theta^{-1}(\x)\bigr)+\log\bigl|\det J_{T_\theta^{-1}}(\x)\bigr| .

변환을 야코비안 행렬식이 쉽게 계산되는 꼴(삼각행렬 등)로 설계하면, 데이터의 정확한 가능도를 계산하며 학습할 수 있다(9회).

8.3 앙상블 — 상관을 줄이는 것이 이득이다 ​

BB개의 모형의 예측을 평균한다. 각 예측의 분산이 σ2\sigma^2이고 두 모형의 예측 사이의 상관이 ρ\rho이면 정리 6.5로

Var⁡(1B∑b=1Bf^b)=ρσ2+1−ρBσ2.\Var\Bigl(\frac1B\sum_{b=1}^B\hat f_b\Bigr)=\rho\sigma^2+\frac{1-\rho}B\sigma^2 .

모형을 늘리면 둘째 항은 사라지지만 첫째 항 ρσ2\rho\sigma^2는 남는다. 같은 자료로 학습한 모형들은 서로 닮아서 ρ\rho가 크다. Breiman의 랜덤 포레스트(2001)는 나무마다 부트스트랩 표본(15회)을 쓰고 분기마다 변수의 일부만 보게 해서 나무들 사이의 상관 ρ\rho를 낮춘다. 나무 하나는 조금 나빠지지만(σ²가 커진다), 평균의 분산은 줄어든다. Simpson이 관측을 평균하며 기대한 이득과, 유효 표본 크기가 말한 한계가 같은 식 안에 있다.
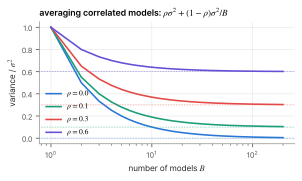
그림 8.1. B개 예측의 평균의 분산(단위 σ²). 상관 ρ가 바닥을 정한다. 앙상블의 기술은 B를 늘리는 것보다 ρ를 줄이는 것이다.
그림 8.1 BB개 예측의 평균의 분산(단위 σ2\sigma^2). 상관 ρ\rho가 바닥을 정한다. 앙상블의 기술은 BB를 늘리는 것보다 ρ\rho를 줄이는 것이다.

8.4 조건부기댓값으로서의 학습 ​

정리 2.8는 제곱손실을 쓰는 모든 회귀 모형이 결국 E(Y∣X=x)E(Y\mid X=x)를 추정한다는 말이다. 분류에서 YY가 0과 1이면 E(Y∣X=x)=P(Y=1∣X=x)E(Y\mid X=x)=P(Y=1\mid X=x)이므로, 제곱손실이든 교차 엔트로피(2회 8.2절)든 잘 학습된 분류기의 출력은 조건부확률이어야 한다. 2회 4.3절의 보정(calibration) 검사가 묻는 것이 바로 이것이다. 그리고 전분산 공식은 “모형이 아무리 좋아도 줄일 수 없는 오차” E Var⁡(Y∣X)E\,\Var(Y\mid X)의 존재를 말한다. 기계학습에서 이것을 “줄일 수 없는 오차”(irreducible error)라 부른다.

연습문제

연습 8.1 (ReLU의 절반 ★) ss의 분포가 0에 대해 대칭이고 Es2<∞Es^2<\infty이면 Emax⁡(0,s)2=12Es2E\max(0,s)^2=\tfrac12Es^2임을 보여라. He 초기화의 2는 여기서 온다.

풀이

max⁡(0,s)2=s21{s>0}\max(0,\allowbreak s)^2=s^2\mathbf 1\{s>0\}이고, 대칭이므로 Es21{s>0}=Es21{s<0}E s^2\mathbf 1\{s>0\}=Es^2\mathbf 1\{s<0\}이며 s=0s=0에서는 s2=0s^2=0이다. 두 값의 합이 Es2Es^2이므로 각각 12Es2\tfrac12Es^2.

연습 8.2 (재매개화의 기울기 ★★) L(μ)=E[(X−3)2]L(\mu)=E\bigl[(X-3)^2\bigr], X∼N(μ,1)X\sim\N(\mu,1)이다. (a) L(μ)=(μ−3)2+1L(\mu)=(\mu-3)^2+1임을 보이고 L′(μ)L'(\mu)를 구하라. (b) X=μ+ZX=\mu+Z로 쓰면 L′(μ)=E[2(μ+Z−3)]L'(\mu)=E[2(\mu+Z-3)]이다. 표본 Z1,…,ZnZ_1,\dots,Z_n으로 이 기울기를 추정하는 식을 쓰고, 그 분산이 4n\tfrac4n임을 보여라.

풀이

(a) X−3=(μ−3)+ZX-3=(\mu-3)+Z이므로 L=(μ−3)2+1L=(\mu-3)^2+1, L′=2(μ−3)L'=2(\mu-3). (b) g^=1n∑i2(μ+Zi−3)\hat g=\tfrac1n\sum_i2(\mu+Z_i-3)이고 기댓값이 L′(μ)L'(\mu), 분산은 4Var⁡Zˉ=4n4\Var\bar Z=\tfrac4n.

연습 8.3 (앙상블의 한계 ★) 나무 하나의 예측 분산이 σ2=1\sigma^2=1, 나무 사이의 상관이 ρ=0.3\rho=0.3이다. 나무 100개 평균의 분산은? 상관을 0.10.1로 낮추는 대신 나무 하나의 분산이 1.51.5로 커진다면 어느 쪽이 나은가?

풀이

0.3+0.7100=0.3070.3+\tfrac{0.7}{100}=0.307. 다른 쪽은 1.5(0.1+0.9100)=0.16351.5(0.1+\tfrac{0.9}{100})=0.1635로 절반 가까이 작다. 상관을 낮추는 쪽이 낫다.

이 회차에서 읽은 절 0개 · 회차 차례