
테마
2회 · 기댓값·부등식·대수의 법칙 · 노트
8 Beautiful insights — 같은 도구, 오늘의 문제
8.1 지수적 집중: Chernoff와 Hoeffding
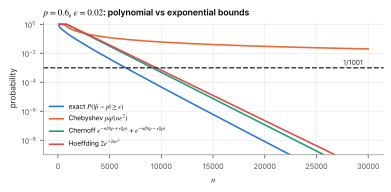
Chebyshev 한계는 으로 준다. 실제 꼬리 확률은 지수적으로 준다. Bernoulli가 “확실성을 10배 높이는 데 5,708번이면 된다”고 쓴 것이 그 흔적이다. 따름정리 5.2의 Chernoff 한계를 이항분포에 쓰면 이 지수적 감소를 증명할 수 있다.
정리 8.1 (이항분포의 Chernoff 한계) , , 이면
는 Bernoulli()와 Bernoulli() 사이의 Kullback–Leibler 발산이다(8.2절). 꼬리 확률의 지수가 정보 이론의 양으로 나온다. 이 지수를 다루기 쉬운 이차식으로 누르면 다음을 얻는다.
정리 8.2 (Hoeffding 부등식 (Bernoulli 시행)) 이면
증명 ()이 음이 아님을 보이면 정리 8.1로 이다. 직접 미분하면 , 이고
이기 때문이다. 은 증가하고 이므로 , 따라서 는 증가하고 이다. 왼쪽 꼬리는 대신 에 같은 논증을 쓰고, 두 꼬리를 Boole 부등식으로 더한다.
Bernoulli의 질문에 쓰면 , 곧
Chebyshev의 600,600보다 60배 작다. 정리 8.1를 그대로 쓰면 9,121이다. 결정적인 차이는 이 로 들어간다는 것이다. Chebyshev에서는 로 들어갔다. 확실성을 10배 높이는 비용이 Chebyshev로는 시행 수의 10배이지만, Hoeffding으로는 번을 더하는 것이다. 정확한 계산에서는 약 2,600번이고, Bernoulli의 공식은 5,708번이었다. 그의 어림은 상수가 두 배쯤 컸을 뿐 모양은 옳았다. 일반적인 Hoeffding 부등식(1963)은 안의 값을 갖는 임의의 독립 확률변수의 평균에 대해 같은 한계를 준다.
학습 이론의 첫 정리 분류기 의 시험 오류율 를 개의 독립 표본에서 잰 오류율 로 추정한다. 가 정해져 있으면 오류 지시변수들의 평균이므로 Hoeffding으로 이다. 그런데 학습은 개의 후보 가운데 이 가장 작은 것을 고른다. 그러면 하나가 아니라 모든 후보가 동시에 맞아야 하고, Boole 부등식(1회 정리 4.3)으로
오른쪽이 이하가 되는 이 PAC 학습의 표본 크기다. 후보가 100만 개여도 만큼 늘 뿐이다. Bernoulli의 질문에 Boole 부등식 하나를 더한 것이 일반화 이론의 출발점이다.
8.2 Jensen과 정보
정리 8.3 (Gibbs 부등식) 과 이 확률질량함수이고 이면 이라 하자. 그러면
이고, 등호는 일 때뿐이다.
증명 가 값 를 확률 로 갖는다고 하자(인 만). 는 오목이므로 Jensen으로
는 순오목이므로 등호는 가 상수일 때, 곧 가 일정해 일 때뿐이다.
이것이 기계학습의 교차 엔트로피 손실이 작동하는 이유다. 참 분포 와 모형 의 교차 엔트로피는 이고, 는 모형과 상관없으므로, 교차 엔트로피를 줄이는 것은 를 줄이는 것이다. Gibbs 부등식으로 최솟값은 에서 얻는다. 9회에서 최대가능도 추정이 바로 이 원리임을 본다.
변분 추론과 VAE의 ELBO도 Jensen 한 줄이다. 관측 와 숨은 변수 의 모형 와 아무 분포 에 대해
계산할 수 없는 왼쪽 대신 오른쪽을 키운다. 10회의 EM 알고리즘도 같은 부등식에서 나온다.
8.3 기댓값으로서의 손실, 그리고 Kelly
모형을 훈련할 때 줄이는 “훈련 손실” 는 손실의 표본평균이고, 우리가 정말 줄이고 싶은 것은 그 기댓값 다. 정해진 에서 둘을 잇는 것이 대수의 법칙이고, 고른 에서 둘을 잇는 것이 앞의 학습 이론이다. 미니배치 확률적 경사하강법은 기울기의 기댓값을 작은 표본평균으로 추정하고, 그 오차가 배치 크기의 로 준다는 것을 이용한다.
Daniel Bernoulli의 로그 효용은 1956년 Bell 연구소의 John Kelly에게서 다시 태어났다. 이길 확률이 인 같은 배당의 내기를 되풀이할 때 가진 돈의 비율 를 건다면, 판 뒤의 돈은 이고
이다(, 대수의 법칙). 장기 성장률 를 최대로 하는 비율은 이다(연습 8.3). 기댓값 을 최대로 하려면 전부를 걸어야 하지만(), 그러면 한 번만 져도 파산한다. 기댓값을 최대로 하는 것과 거의 확실하게 잘 되는 것은 다르다. St. Petersburg 역설과 같은 교훈이다.
연습문제
연습 8.1 (Hoeffding의 여론조사 ★) 연습 6.1의 여론조사(포인트, 틀릴 확률 5%)에 필요한 을 Hoeffding 부등식으로 구하고, Chebyshev(5,556명)·정규근사(1,068명)와 비교하라.
풀이
에서 명. Chebyshev의 5,556명보다 훨씬 작고 정규근사의 1,068명의 두 배쯤이다. Hoeffding은 정규근사처럼 “이 크면”이라는 근사 없이 모든 에서 참이다.
연습 8.2 (두 주사위의 KL ★) 공평한 주사위 와, Weldon의 자료에서 추정한 주사위 (면 1–4에 , 면 5·6에 , , 예제 2.11) 사이의 와 를 구하라. 대칭인가?
풀이
노트북의 계산으로 , 이다. 거의 같지만 같지 않다. KL 발산은 일반적으로 대칭이 아니다. 아주 작은 값이라는 것은 주사위 한 번으로는 두 분포를 거의 구별할 수 없다는 뜻이다. Weldon의 주사위 개 굴림에서는 가 되어 구별할 수 있다. 가능도비로는 배다(9회).
연습 8.3 (Kelly 비율 ★★) 를 최대로 하는 를 구하고, 일 때 를 계산하라. 이면 는 어떻게 되나?
풀이
에서 , . 이므로 최대다. 이면 , . 판마다 약 2%씩 복리로 자라 약 34판에 돈이 두 배가 된다. 이면 이다. 판마다 유리한 내기인데도 너무 많이 걸면 돈은 확률 1에 가깝게 0으로 간다.
연습 8.4 (후보가 많을 때 ★) 개의 분류기 가운데 하나를 고를 때, 모든 후보의 오류율을 동시에 안으로 99% 확신하려면 이 얼마면 되나? 일 때와 비교하라.
풀이
. 이면 . 후보가 100만 배 늘어도 표본은 3.6배만 늘어난다.