Skip to content

2회 · 기댓값·부등식·대수의 법칙 · 노트

6 대수의 법칙 — Bernoulli의 황금정리 ​

이제 여는 질문으로 돌아간다. 필요한 도구는 모두 갖추었다. 관측 비율의 평균과 분산(따름정리 2.5), 그리고 분산으로 꼬리를 누르는 Chebyshev 부등식(정리 5.3)이다.

6.1 Ars Conjectandi ​

역사 Jacob Bernoulli(1654–1705)는 바젤 대학의 수학 교수였다. 그는 Ars Conjectandi의 4부에서 확률을 도박 밖으로 끌어내려 했다. 질병, 날씨, 사람의 수명처럼 “같은 정도로 일어나는 경우”를 셀 수 없는 문제에서는 확률을 사전에 알 수 없다. 그는 이렇게 썼다. “사전에 얻을 수 없는 것을 적어도 사후에, 곧 비슷한 많은 예에서 관측한 결과로부터 얻을 수 있다.” 이것이 정당하려면 관측을 늘릴수록 관측한 비율이 참 비율에 다가간다는 것을 증명해야 했다. 그는 이 정리를 “황금정리”라 불렀고, 이 문제를 20년 동안 붙들고 있었다고 책에 썼다. “대수의 법칙”(la loi des grands nombres)이라는 이름은 1837년 Poisson이 붙였다.

Bernoulli가 원한 것은 “도덕적 확실성”이었다. 1,000 대 1 이상으로 확실하면, 곧 확률이 10001001\tfrac{1000}{1001} 이상이면 사람은 그것을 확실한 것으로 여기고 행동한다는 것이다. 그의 질문은 이것이다. 흰 돌의 참 비율이 p=35p=\tfrac35일 때, 몇 번 꺼내면

P(2950≤p^n≤3150) ≥ 10001001P\Bigl(\frac{29}{50}\le\hat p_n\le\frac{31}{50}\Bigr)\ \ge\ \frac{1000}{1001}

인가? 오차의 폭은 ε=150=0.02\varepsilon=\tfrac1{50}=0.02이다.

6.2 확률수렴과 Bernoulli의 정리 ​

정의 6.1 (확률수렴) 확률변수의 수열 Y1,Y2,…Y_1,Y_2,\dots와 상수 cc가 모든 ε>0\varepsilon>0에 대해

lim⁡n→∞P(∣Yn−c∣≥ε)=0\lim_{n\to\infty}P\bigl(|Y_n-c|\ge\varepsilon\bigr)=0

을 만족하면 YnY_n이 cc로 확률수렴한다고 하고 Yn→PcY_n\xrightarrow{P}c로 쓴다.

YnY_n이 확률변수이므로 “Yn→cY_n\to c”를 수열의 극한으로 말할 수 없다. 대신 cc에서 ε\varepsilon 이상 떨어질 확률이 0으로 간다고 말한다. 7회에서 다른 수렴들과 비교한다.

정리 6.2 (Bernoulli의 대수의 법칙) p^n\hat p_n이 성공 확률 pp인 독립 시행 nn번의 성공 비율이면 모든 ε>0\varepsilon>0에 대해

P(∣p^n−p∣≥ε)≤pqnε2≤14nε2.P\bigl(|\hat p_n-p|\ge\varepsilon\bigr)\le\frac{pq}{n\varepsilon^2}\le\frac1{4n\varepsilon^2}.

따라서 p^n→Pp\hat p_n\xrightarrow{P}p이다.

증명 따름정리 2.5로 Ep^n=pE\hat p_n=p, Var⁡p^n=pqn\Var\hat p_n=\tfrac{pq}n이다. Chebyshev 부등식에 c=εc=\varepsilon을 넣고, pq≤14pq\le\tfrac14(예제 2.3)를 쓴다.

두 줄이다. Bernoulli가 20년을 들인 정리가 분산이라는 개념 하나로 두 줄이 되었다. 그러나 이 짧은 증명이 주는 시행 횟수는 Bernoulli의 것보다 나쁘다. Chebyshev 한계로 오른쪽이 11001\tfrac1{1001} 이하가 되려면

n ≥ pqε2⋅1001=0.240.0004⋅1001=600,600.n\ \ge\ \frac{pq}{\varepsilon^2}\cdot1001=\frac{0.24}{0.0004}\cdot1001=600{,}600 .

6.3 Bernoulli의 계산 ​

Bernoulli는 분산을 몰랐다. 그는 이항분포의 항 Tk=(Nk)pkqN−kT_k=\tbinom Nkp^kq^{N-k}를 직접 다뤘다. 핵심은 이웃한 두 항의 비

Tk+1Tk=N−kk+1⋅pq\frac{T_{k+1}}{T_k}=\frac{N-k}{k+1}\cdot\frac pq

가 kk에 대해 감소한다는 것이다. 따라서 항들은 최빈값 근처에서 가장 크고, 거기서 멀어지면 등비급수보다 빨리 줄어든다. 그는 중심에서 εN\varepsilon N 이상 떨어진 꼬리의 합을 중심 근처 항들의 합과 비교해, 그 비를 등비급수로 눌렀다. 연습 6.7에서 이 생각으로 정리 6.2의 결론을 Chebyshev 없이 증명한다.

p=rtp=\tfrac rt, r=30r=30, s=20s=20, t=r+s=50t=r+s=50, ε=1t\varepsilon=\tfrac1t로 놓은 그의 결론은 다음 꼴이다. 한쪽 꼬리에 대해

m1≥log⁡(c(s−1))log⁡(r+1)−log⁡r,N1=m1t+m1st−str+1,m_1\ge\frac{\log\bigl(c(s-1)\bigr)}{\log(r+1)-\log r},\qquad N_1=m_1t+\frac{m_1st-st}{r+1},

다른 쪽 꼬리에 대해 rr과 ss를 바꾼 m2m_2, N2N_2를 구하면, N≥max⁡(N1,N2)N\ge\max(N_1,N_2)번 시행에서 관측 비율이 r−1t\tfrac{r-1}t와 r+1t\tfrac{r+1}t 사이에 들 확률이 밖에 들 확률의 cc배를 넘는다. c=1000c=1000이면

m1=301,  N1=24,728;m2=211,  N2=25,550.m_1=301,\ \ N_1=24{,}728;\qquad m_2=211,\ \ N_2=25{,}550 .

이것이 25,550이다. 그는 이어서 c=104c=10^4이면 31,258번, c=105c=10^5이면 36,966번이라고 쓰고, cc가 10배 될 때마다 5,708번씩 더하면 된다고 덧붙였다. 확실성을 높이는 비용은 로그로만 늘어난다. 이 관찰은 옳았고, 8절의 지수적 한계가 그 이유를 말해 준다.

6.4 같은 질문의 다섯 답 ​
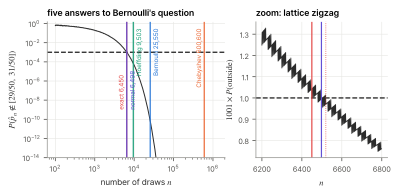
그림 6.1. 여는 질문의 정확한 답. 곡선은 Pbigl(tfrac2950lep̂_n≤tfrac3150bigr)을 이항분포로 정확히 계산한 것이다. n이 바뀌면 구간에 드는 정수의 개수가 달라져서 곡선이 톱니 모양이다. 점선은 tfrac10001001, 세로선은 다섯 가지 답이다.
그림 6.1 여는 질문의 정확한 답. 곡선은 P(2950≤p^n≤3150)P\bigl(\tfrac{29}{50}\le\hat p_n\le\tfrac{31}{50}\bigr)을 이항분포로 정확히 계산한 것이다. nn이 바뀌면 구간에 드는 정수의 개수가 달라져서 곡선이 톱니 모양이다. 점선은 10001001\tfrac{1000}{1001}, 세로선은 다섯 가지 답이다.
방법시행 수쓰는 정보
Chebyshev (1867)600,600평균과 분산 (정리 6.2)
Bernoulli (1713)25,550이항분포의 항의 비
Hoeffding (1963)9,503값이 [0,1][0,1] 안에 있다는 것 (8절, 정리 8.2)
정규근사6,498중심극한정리 (7회): n=z2pq/ε2n=z^2pq/\varepsilon^2, z=3.29z=3.29
정확한 계산6,450이항분포의 합. 6,520 이상이면 언제나 성립

표는 이 과정 전체의 지도이기도 하다. 위로 갈수록 가정이 적고 한계가 느슨하다. Chebyshev는 분포에 대해 평균과 분산만 알면 되고, 그래서 가장 나쁜 분포(예제 5.4)까지 견뎌야 한다. 아래로 갈수록 분포를 더 많이 쓰고 답이 정확해진다. 정확한 계산은 분포를 완전히 알아야 하고, 정규근사는 “nn이 크다”는 근사를 받아들인다. 정확한 계산이 주는 6,450은 Bernoulli의 답의 약 4분의 1이다.

6.5 일반적인 대수의 법칙 ​

정리 6.3 (약한 대수의 법칙) X1,X2,…X_1,X_2,\dots가 독립이고 평균이 모두 μ\mu, 분산이 모두 σ2<∞\sigma^2<\infty이면, 표본평균 Xˉn=1n∑i=1nXi\bar X_n=\tfrac1n\sum_{i=1}^nX_i에 대해

P(∣Xˉn−μ∣≥ε)≤σ2nε2 ⟶ 0,곧Xˉn→Pμ.P\bigl(|\bar X_n-\mu|\ge\varepsilon\bigr)\le\frac{\sigma^2}{n\varepsilon^2}\ \longrightarrow\ 0,\qquad\text{곧}\qquad\bar X_n\xrightarrow{P}\mu .

증명 전략 표본평균의 평균과 분산을 구하고 Chebyshev 부등식에 넣는다. 오른쪽이 nn에 반비례하므로 0으로 간다.

  1. EXˉn=1n∑iEXi=μE\bar X_n=\tfrac1n\sum_iEX_i=\mu이다.선형성, 정리 1.11

  2. Var⁡Xˉn=σ2n\Var\bar X_n=\tfrac{\sigma^2}n이다.정리 2.8

  3. P(∣Xˉn−μ∣≥ε)≤Var⁡Xˉnε2=σ2nε2P\bigl(|\bar X_n-\mu|\ge\varepsilon\bigr)\le\dfrac{\Var\bar X_n}{\varepsilon^2}=\dfrac{\sigma^2}{n\varepsilon^2}이다.정리 5.3, 1 2

  4. ε\varepsilon을 고정하고 n→∞n\to\infty이면 오른쪽은 0으로 가므로 Xˉn→Pμ\bar X_n\xrightarrow{P}\mu이다.정의 6.1 [T5]

증명은 독립합의 분산 공식(정리 2.8)만 쓴다. 이 노트에서 그 공식은 이산 확률변수에서 증명했고, 연속 확률변수에서는 3회에서 증명한다. 그러면 이 정리와 증명이 그대로 연속 확률변수에도 성립한다. 아래 예제의 연속 확률변수는 그 결과를 미리 쓴다. 분산이 없어도 평균만 있으면 결론이 성립한다는 것(Khinchin, 1929)은 7회에서 증명한다.

예제 6.4 (Monte Carlo 적분) ∫01g(x) dx\int_0^1g(x)\,dx를 구하고 싶다. U∼U(0,1)U\sim\mathrm U(0,1)이면 정리 1.9로 E g(U)=∫01gE\,g(U)=\int_0^1g이므로, 독립인 균등 난수 U1,…,UnU_1,\dots,U_n으로

I^n=1n∑i=1ng(Ui) →P ∫01g(x) dx\hat I_n=\frac1n\sum_{i=1}^ng(U_i)\ \xrightarrow{P}\ \int_0^1g(x)\,dx

이고, 오차의 표준편차는 σg/n\sigma_g/\sqrt n, σg2=Var⁡g(U)\sigma_g^2=\Var g(U)이다. 차원이 높아져도 오차의 차수 1/n1/\sqrt n은 그대로다. 격자 위의 수치적분은 차원이 높아지면 격자점이 기하급수적으로 늘지만, Monte Carlo는 그렇지 않다. 1940년대 Los Alamos에서 이 방법에 Monte Carlo라는 이름이 붙었다(7회).

예로 g(x)=ex2g(x)=e^{x^2}이면 ∫01g≈1.4627\int_0^1g\approx1.4627이고 σg2≈0.225\sigma_g^2\approx0.225이다. 오차가 0.010.01 이상일 확률을 1% 이하로 하려면 Chebyshev로 n≥0.2250.012⋅0.01≈2.3×10⁵n\ge\tfrac{0.225}{0.01^2\cdot0.01}\approx2.3\times10^5이면 충분하다.

6.6 상대도수와 확률 — 다시 데이터로 ​

1회 2절에서 Halley의 생명표의 상대도수를 확률로 읽었다. 대수의 법칙이 그 근거다. 사건 AA에 대해 독립인 반복에서 1A\mathbf 1_A의 표본평균이 상대도수이고, 그 평균이 P(A)P(A)이므로 상대도수는 P(A)P(A)로 확률수렴한다. 그러나 이 법칙에는 가정이 있다. 독립이고 같은 확률이라는 가정이다. 실제 자료가 이 가정을 따르는지는 따로 확인해야 한다.

예제 6.5 (Arbuthnot의 남아 출생 비율) John Arbuthnot은 1710년 런던의 1629–1710년 82년간 세례 기록에서 해마다 남자아이가 여자아이보다 많다는 것을 보였다(그는 이것을 신의 섭리의 증거로 읽었다. 8회에서 그의 논증이 최초의 유의성 검정이었음을 본다). 82년 전체의 남아 비율은 p^=484,382/938,223=0.5163\hat p=484{,}382/938{,}223=0.5163이다.

해마다 약 11,400명이 태어났으므로, 출생마다 독립이고 남아 확률이 해마다 같다면 한 해의 남아 비율의 표준편차는 따름정리 2.5로 p^(1−p^)/11,400≈0.0048\sqrt{\hat p(1-\hat p)/11{,}400}\approx0.0048이어야 한다. 실제로 82개 연도 비율의 표준편차는 0.00720.0072로 1.5배 크다. 1879년 Wilhelm Lexis는 이 비를 분산비(Lexis ratio)라 부르고, 1보다 크면 확률이 해마다 일정하지 않다는 증거로 읽었다. 대수의 법칙은 평균이 어디로 가는지를 말하고, 분산은 그 모형이 맞는지를 시험하게 해 준다.
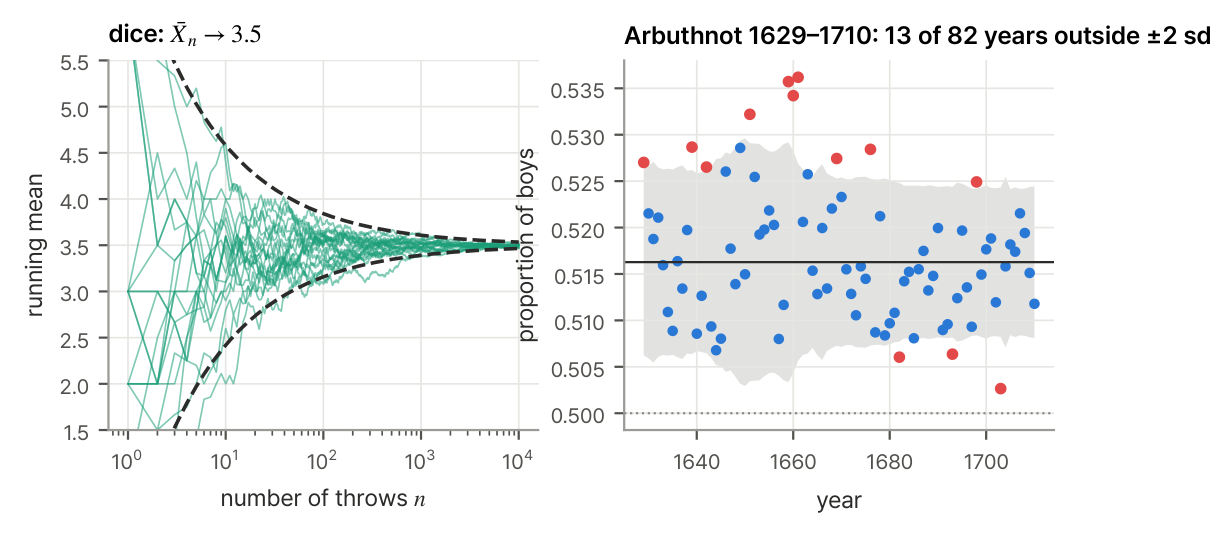
그림 6.2. 왼쪽: 주사위를 던진 누적 평균 20개 경로와 3.5±2σ/√n (점선). 오른쪽: Arbuthnot 자료의 해마다 남아 비율. 회색 띠는 출생이 독립이고 확률이 일정하다는 모형 아래 ±2 표준편차다. 띠를 벗어나는 해가 모형이 예측하는 5%보다 훨씬 많다.
그림 6.2 왼쪽: 주사위를 던진 누적 평균 20개 경로와 3.5±2σ/n3.5\pm2\sigma/\sqrt n (점선). 오른쪽: Arbuthnot 자료의 해마다 남아 비율. 회색 띠는 출생이 독립이고 확률이 일정하다는 모형 아래 ±2\pm2 표준편차다. 띠를 벗어나는 해가 모형이 예측하는 5%보다 훨씬 많다.
연습문제

연습 6.1 (여론조사의 표본 크기 ★) 지지율을 ±3%\pm3\%포인트 안으로, 틀릴 확률 5% 이하로 알고 싶다. 정리 6.2의 한계 14nε2\tfrac1{4n\varepsilon^2}로 필요한 nn을 구하라. (정규근사로는 1,068명이다.)

풀이

14n(0.03)2≤0.05\tfrac1{4n(0.03)^2}\le0.05에서 n≥14⋅0.0009⋅0.05≈5,556n\ge\tfrac1{4\cdot0.0009\cdot0.05}\approx5{,}556명. 정규근사의 1,068명보다 5배 많다.

연습 6.2 (Bernoulli의 공식 ★) 본문의 공식으로 c=10,000c=10{,}000일 때 m1,N1,m2,N2m_1,N_1,m_2,N_2를 계산하고 Bernoulli의 31,258과 비교하라. cc가 10배 될 때 m2m_2는 얼마씩 늘어나는가?

풀이

m1=⌈log⁡(19⋅104)/log⁡3130⌉=⌈370.7⌉=371m_1=\lceil\log(19\cdot10^4)/\log\tfrac{31}{30}\rceil=\lceil370.7\rceil=371, N1=371⋅50+371⋅1000−100031≈30,486N_1=371\cdot50+\tfrac{371\cdot1000-1000}{31}\approx30{,}486. m2=⌈log⁡(29⋅104)/log⁡2120⌉=⌈257.8⌉=258m_2=\lceil\log(29\cdot10^4)/\log\tfrac{21}{20}\rceil=\lceil257.8\rceil=258, N2=258⋅50+258⋅1500−150021≈31,257.1N_2=258\cdot50+\tfrac{258\cdot1500-1500}{21}\approx31{,}257.1이므로 31,258번. cc가 10배 되면 m2m_2의 하한은 log⁡10/log⁡1.05≈47.2\log10/\log1.05\approx47.2만큼 늘고, Bernoulli는 47을 더해 N2N_2가 47⋅(50+150021)≈5,70847\cdot\bigl(50+\tfrac{1500}{21}\bigr)\approx5{,}708씩 는다고 썼다.

연습 6.3 (주사위 평균 ★) 주사위를 nn번 던진 평균이 3.53.5에서 0.10.1 이상 벗어날 확률을 5%5\% 이하로 하려면 Chebyshev로 nn이 얼마면 충분한가?

풀이

σ2=3512\sigma^2=\tfrac{35}{12}이므로 35/12n(0.1)2≤0.05\tfrac{35/12}{n(0.1)^2}\le0.05에서 n≥5,834n\ge5{,}834번.

연습 6.4 (쌍별 독립이면 충분하다 ★★) 정리 6.3에서 “독립”을 “쌍별 독립”으로 바꿔도 결론이 성립함을 보여라. 증명의 어느 줄을 바꿔야 하나?

풀이

정리 6.3의 증명이 쓰는 것은 Var⁡Xˉn=σ2/n\Var\bar X_n=\sigma^2/n뿐이고, 이것은 정리 2.8에서 왔다. 그 증명에서 독립을 쓴 곳은 i≠ji\ne j인 각 쌍에서 E(DiDj)=EDi EDjE(D_iD_j)=ED_i\,ED_j를 쓴 한 줄이고, 이것은 정리 2.7를 두 변수 Di,DjD_i,D_j에 쓴 것이다. 쌍별 독립이면 그대로 성립한다. 바꿀 줄은 없다.

연습 6.5 (Poisson의 대수의 법칙 ★★) 독립 시행의 성공 확률이 시행마다 다르다(ii번째는 pip_i). 성공 수 KnK_n에 대해 1n(Kn−∑i≤npi)→P0\tfrac1n\bigl(K_n-\sum_{i\le n}p_i\bigr)\xrightarrow{P}0임을 보여라. Poisson(1837)이 “대수의 법칙”이라는 이름으로 부른 것은 이 형태였다.

풀이

Kn=∑i≤n1iK_n=\sum_{i\le n}\mathbf 1_i, 1i\mathbf 1_i들은 독립이고 E1i=piE\mathbf 1_i=p_i, Var⁡1i=piqi≤14\Var\mathbf 1_i=p_iq_i\le\tfrac14. 정리 2.8으로 Var⁡Kn≤n4\Var K_n\le\tfrac n4이고 Chebyshev로

P(∣Kn−∑pin∣≥ε)≤n/4n2ε2=14nε2→0.P\Bigl(\Bigl|\frac{K_n-\sum p_i}n\Bigr|\ge\varepsilon\Bigr)\le\frac{n/4}{n^2\varepsilon^2}=\frac1{4n\varepsilon^2}\to0 .

연습 6.6 (Lexis의 분산비 ★) 노트북에서 Arbuthnot 자료의 해마다 남아 비율 p^t\hat p_t와 출생 수 ntn_t로 Q2=181∑t(p^t−p^)2p^(1−p^)/ntQ^2=\tfrac1{81}\sum_t\tfrac{(\hat p_t-\hat p)^2}{\hat p(1-\hat p)/n_t}를 계산하라. 모형이 맞으면 Q2Q^2은 1 근처여야 한다. 값은? 어떤 이유들로 1보다 클 수 있나?

풀이

노트북의 계산으로 Q2≈2.09Q^2\approx2.09 (Q≈1.45Q\approx1.45)이다. 해마다 남아 비율이 이항 모형이 허용하는 것보다 두 배 가까운 분산으로 흔들린다. 가능한 이유는 여럿이다. 남아 출생 확률 자체가 해마다(지역, 계층 구성에 따라) 달랐을 수 있고, 자료가 출생이 아니라 국교회의 세례 기록이어서 기록 관행(내전과 공화정 시기 1640–1660년대의 혼란, 비국교도의 누락)이 해마다 달랐을 수 있다. 쌍둥이처럼 독립이 아닌 출생도 있다. 대수의 법칙은 82년 평균 0.5160.516을 믿게 하지만, 이 평균이 “하나의 고정된 pp”라는 해석은 분산이 거부한다.

연습 6.7 (Bernoulli식 증명 ★★★) K∼b(N,p)K\sim\mathrm b(N,p), Tk=P(K=k)T_k=P(K=k), 0<ε<q0<\varepsilon<q이다. 분산을 쓰지 않고 P(p^N≥p+ε)→0P(\hat p_N\ge p+\varepsilon)\to0을 보인다. (a) Tk+1Tk=(N−k)p(k+1)q\tfrac{T_{k+1}}{T_k}=\tfrac{(N-k)p}{(k+1)q}임을 보이고, k≥Npk\ge Np이면 이 비가 1보다 작음을 보여라. 따라서 TkT_k는 k≥Npk\ge Np에서 감소한다. (b) j=⌈N(p+ε)⌉j=\lceil N(p+\varepsilon)\rceil이면 k≥jk\ge j에서 Tk+1Tk≤ρ:=(q−ε)p(p+ε)q<1\tfrac{T_{k+1}}{T_k}\le\rho:=\tfrac{(q-\varepsilon)p}{(p+\varepsilon)q}<1임을 보이고, P(K≥j)≤Tj1−ρP(K\ge j)\le\tfrac{T_j}{1-\rho}를 결론지어라. (c) Np≤k≤jNp\le k\le j인 정수 kk는 적어도 Nε−1N\varepsilon-1개이고 그 TkT_k는 모두 TjT_j 이상이다. ∑kTk≤1\sum_kT_k\le1에서 Tj≤1Nε−1T_j\le\tfrac1{N\varepsilon-1}을 얻고 결론을 내려라. (힌트: (b)에서 k+1>N(p+ε)k+1>N(p+\varepsilon)와 N−k≤N(q−ε)N-k\le N(q-\varepsilon)을 쓴다.)

풀이

(a) 이항계수의 정의로

Tk+1Tk=(Nk+1)(Nk)⋅pq=N−kk+1⋅pq.\frac{T_{k+1}}{T_k}=\frac{\binom N{k+1}}{\binom Nk}\cdot\frac pq=\frac{N-k}{k+1}\cdot\frac pq .

k≥Npk\ge Np이면 (N−k)p≤(N−Np)p=Npq<(k+1)q(N-k)p\le(N-Np)p=Npq<(k+1)q이므로 비는 1보다 작다. (b) k≥j≥N(p+ε)k\ge j\ge N(p+\varepsilon)이면 N−k≤N(q−ε)N-k\le N(q-\varepsilon), k+1>N(p+ε)k+1>N(p+\varepsilon)이므로 비 ≤N(q−ε)pN(p+ε)q=ρ\le\tfrac{N(q-\varepsilon)p}{N(p+\varepsilon)q}=\rho. (q−ε)p<(p+ε)q(q-\varepsilon)p<(p+\varepsilon)q이므로 ρ<1\rho<1. 그러면 Tj+i≤ρiTjT_{j+i}\le\rho^iT_j이고 P(K≥j)≤Tj∑iρi=Tj1−ρP(K\ge j)\le T_j\sum_i\rho^i=\tfrac{T_j}{1-\rho}. (c) ⌈Np⌉≤k≤j\lceil Np\rceil\le k\le j인 정수는 j−⌈Np⌉+1≥N(p+ε)−(Np+1)+1=Nεj-\lceil Np\rceil+1\ge N(p+\varepsilon)-(Np+1)+1=N\varepsilon개 이상이고, (a)로 TkT_k는 이 범위에서 감소하므로 모두 TjT_j 이상이다. 확률의 합은 1 이하이므로 Nε Tj≤1N\varepsilon\,T_j\le1. 따라서 P(p^N≥p+ε)≤1Nε(1−ρ)→0P(\hat p_N\ge p+\varepsilon)\le\tfrac1{N\varepsilon(1-\rho)}\to0. 아래쪽 꼬리는 성공과 실패를 바꿔 같은 논증을 쓴다. 분산은 한 번도 쓰지 않았다.

이 회차에서 읽은 절 0개 · 회차 차례