Skip to content

2회 · 기댓값·부등식·대수의 법칙 · 노트

2 분산과 적률 — 흩어짐을 재는 수 ​

기댓값은 분포의 위치를 하나의 수로 말한다. Bernoulli의 질문에 답하려면 한 가지가 더 필요하다. 관측한 비율이 참값 둘레에 얼마나 흩어지는가다. 이 절은 흩어짐의 표준 척도인 분산을 정의하고, 이항분포의 분산 npqnpq와 독립합의 분산 공식을 증명한다. 6절의 대수의 법칙은 이 두 결과와 5절의 Chebyshev 부등식을 합친 것이다.

이름의 역사 흩어짐을 재는 일은 천문학의 관측오차에서 시작했다. Gauss(1809, 1821)는 오차 제곱의 평균을 기준으로 삼았고, Karl Pearson(1894)이 그 제곱근에 standard deviation이라는 이름을 붙였다. variance라는 말은 Fisher(1918)가 처음 썼다. 개념은 이름보다 150년 앞섰다. de Moivre(1733)는 이항분포의 흩어짐이 n\sqrt n에 비례한다는 것을 이미 알고 있었다(5회).

2.1 분산 ​

정의 2.1 (분산과 표준편차) EX2<∞EX^2<\infty인 확률변수 XX의 평균을 μ\mu라 할 때

Var⁡X=E(X−μ)2\Var X=E(X-\mu)^2

을 분산이라 하고, σ=Var⁡X\sigma=\sqrt{\Var X}를 표준편차라 한다. σ2\sigma^2, σX2\sigma_X^2로도 쓴다.

EX2<∞EX^2<\infty이면 ∣x∣≤1+x2|x|\le1+x^2이므로 E∣X∣<∞E|X|<\infty이고, (x−μ)2≤2x2+2μ2(x-\mu)^2\le2x^2+2\mu^2이므로 분산도 유한하다. 분산은 무게중심 둘레의 “관성 모멘트”다. 평균에서 멀리 떨어진 질량이 제곱으로 무겁게 센다.

정리 2.2 (분산의 계산) EX2<∞EX^2<\infty이고 μ=EX\mu=EX일 때

  1. (a)

    Var⁡X=EX2−μ2\Var X=EX^2-\mu^2.

  2. (b)

    Var⁡(aX+b)=a2Var⁡X\Var(aX+b)=a^2\Var X. 따라서 σaX+b=∣a∣ σX\sigma_{aX+b}=|a|\,\sigma_X.

  3. (c)

    모든 실수 cc에 대해 E(X−c)2=Var⁡X+(μ−c)2E(X-c)^2=\Var X+(\mu-c)^2. 따라서 E(X−c)2E(X-c)^2은 c=μc=\mu에서 가장 작다.

증명 전략 (c)를 먼저 보인다. X−c=(X−μ)+(μ−c)X-c=(X-\mu)+(\mu-c)를 제곱하고 선형성을 쓰면 가운데 항이 사라진다. (a)와 (b)는 (c)와 정의에서 바로 나온다. 단계별 증명은 연습 2.10(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

(c)는 한 줄이지만 깊다. XX를 상수 하나로 예측해야 하고 손실이 제곱오차이면, 가장 좋은 예측은 평균이고 그때의 손실이 분산이다. 13회의 최소제곱법은 이 사실을 여러 변수로 넓힌 것이다. 손실이 절대오차 E∣X−c∣E|X-c|이면 가장 좋은 예측은 중앙값이 된다(연습 2.2).

예제 2.3 (기본적인 분산들) 

Bernoulli. X=1AX=\mathbf 1_A, P(A)=pP(A)=p이면 X2=XX^2=X이므로 Var⁡X=p−p2=pq\Var X=p-p^2=pq. 이 값은 p=12p=\tfrac12에서 가장 크고, 언제나 pq≤14pq\le\tfrac14이다.

주사위. EX2=16(1+4+⋯+36)=916EX^2=\tfrac16(1+4+\cdots+36)=\tfrac{91}6이므로 Var⁡X=916−494=3512≈2.92\Var X=\tfrac{91}6-\tfrac{49}4=\tfrac{35}{12}\approx2.92.

균등분포. X∼U(a,b)X\sim\mathrm U(a,b)이면 X=a+(b−a)UX=a+(b-a)U, U∼U(0,1)U\sim\mathrm U(0,1)이고 Var⁡U=13−14=112\Var U=\tfrac13-\tfrac14=\tfrac1{12}이므로 정리 2.2(b)로 Var⁡X=(b−a)212\Var X=\tfrac{(b-a)^2}{12}.

지수분포. 부분적분을 두 번 하면 EX2=2λ2EX^2=\tfrac2{\lambda^2}이므로 Var⁡X=1λ2\Var X=\tfrac1{\lambda^2}. 표준편차가 평균과 같다.

2.2 이항분포의 평균과 분산 ​

정리 2.4 (이항분포) KK가 성공 확률 pp인 독립 시행 nn번의 성공 수이면, 곧

P(K=k)=(nk)pkqn−k,k=0,1,…,nP(K=k)=\binom nk p^kq^{n-k},\qquad k=0,1,\dots,n

이면 (K∼b(n,p)K\sim\mathrm b(n,p)로 쓴다)

EK=np,Var⁡K=npq.EK=np,\qquad \Var K=npq .

증명 전략 pmf의 합이 1이라는 것은 이항정리(1회 정리 1.6)다. 같은 정리를 한 번 더 쓴다. k(nk)=n(n−1k−1)k\binom nk=n\binom{n-1}{k-1}로 kk를 계수 안으로 흡수하고, 분산은 E K(K−1)E\,K(K-1)을 같은 방법으로 구해 얻는다. 단계별 증명은 연습 2.11(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

따름정리 2.5 (관측 비율의 평균과 분산) p^=K/n\hat p=K/n이면

Ep^=p,Var⁡p^=pqn≤14n,σp^=pqn.E\hat p=p,\qquad \Var\hat p=\frac{pq}{n}\le\frac1{4n},\qquad \sigma_{\hat p}=\sqrt{\frac{pq}n} .

증명 정리 2.4과 정리 2.2(b)에 a=1na=\tfrac1n을 쓴다.

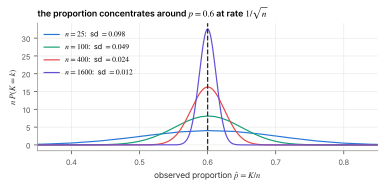
관측 비율은 평균적으로 참값이고, 흩어짐의 표준편차는 1/n1/\sqrt n에 비례해 준다. 시행을 4배로 늘려야 흩어짐이 절반이 된다(그림 2.1). 이것이 1회 8.1절에서 시뮬레이션으로 본 1/n1/\sqrt n이고, Bernoulli의 정리의 씨앗이다.

그림 2.1. p=0.6일 때 관측 비율 p̂=K/n의 분포. n이 4배가 될 때마다 폭이 절반이 된다. 세로축은 nP(K=k)로 맞춰 모양을 비교할 수 있게 했다.
그림 2.1 p=0.6p=0.6일 때 관측 비율 p^=K/n\hat p=K/n의 분포. nn이 4배가 될 때마다 폭이 절반이 된다. 세로축은 n P(K=k)n\,P(K=k)로 맞춰 모양을 비교할 수 있게 했다.

2.3 독립인 이산 확률변수 ​

이항분포의 분산은 “nn번 시행의 분산이 한 번의 분산의 nn배”라는 것을 말해 준다. 이것은 독립이면 언제나 참이다.

정의 2.6 (독립인 이산 확률변수) 이산 확률변수 X1,…,XnX_1,\dots,X_n이 모든 값 x1,…,xnx_1,\dots,x_n에 대해

P(X1=x1,…,Xn=xn)=P(X1=x1)⋯P(Xn=xn)P(X_1=x_1,\dots,X_n=x_n)=P(X_1=x_1)\cdots P(X_n=x_n)

을 만족하면 독립이라 한다.

이 정의는 1회 정의 5.9의 사건의 상호 독립과 같은 말이다. 모든 값의 조합에서 사건 {X1=x1},…,{Xn=xn}\{X_1=x_1\},\dots,\{X_n=x_n\}이 상호 독립이라는 것이다. 정의에는 nn개를 모두 곱하는 식만 있지만, 일부만 고른 식은 나머지 변수의 값에 대해 더하면 나온다(연습 2.6). 같은 이유로 독립인 XiX_i들의 함수 gi(Xi)g_i(X_i)도 독립이다.

정리 2.7 (독립이면 곱의 기댓값은 기댓값의 곱) X,YX,Y가 독립인 이산 확률변수이고 E∣X∣,E∣Y∣<∞E|X|,E|Y|<\infty이면 E∣XY∣<∞E|XY|<\infty이고

E(XY)=EX⋅EY.E(XY)=EX\cdot EY .

증명 전략 (X,Y)(X,Y)를 하나의 이산 확률변수로 보고 정리 1.9(a)를 쓴다. 독립이면 이중합이 두 합의 곱으로 갈라진다. 먼저 절댓값으로 합이 유한함을 보이고, 그다음 절댓값 없이 계산한다 [T5]. 단계별 증명은 연습 2.12(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

정리 2.8 (독립합의 분산) X1,…,XnX_1,\dots,X_n이 독립인 이산 확률변수이고 분산이 유한하면

Var⁡(∑i=1nXi)=∑i=1nVar⁡Xi.\Var\Bigl(\sum_{i=1}^nX_i\Bigr)=\sum_{i=1}^n\Var X_i .

특히 모두 분산이 σ2\sigma^2이면 표본평균 Xˉ=1n∑Xi\bar X=\tfrac1n\sum X_i에 대해 Var⁡Xˉ=σ2/n\Var\bar X=\sigma^2/n.

증명 전략 중심을 뺀 Di=Xi−μiD_i=X_i-\mu_i로 분산을 “합의 제곱의 기댓값”으로 쓴다. 제곱을 전개하면 교차항이 생기고, 독립이 교차항을 0으로 만든다.

  1. μi=EXi\mu_i=EX_i, Di=Xi−μiD_i=X_i-\mu_i로 두면 E∑iXi=∑iμiE\sum_iX_i=\sum_i\mu_i이고 ∑iXi−∑iμi=∑iDi\sum_iX_i-\sum_i\mu_i=\sum_iD_i이다.정리 1.11

  2. 분산의 정의에 넣고 제곱을 전개한다.

    Var⁡(∑iXi)=E(∑iDi)2=∑iE Di2+∑i≠jE(DiDj)\begin{align*} \Var\Bigl(\sum_iX_i\Bigr)&=E\Bigl(\sum_iD_i\Bigr)^2 \tag*{\htmlClass{reason}{\text{정의~\href{/read/02/2#def-var}{2.1}, \htmlClass{sref}{\text{1}}}}}\\ &=\sum_iE\,D_i^2+\sum_{i\ne j}E(D_iD_j) \tag*{\htmlClass{reason}{\text{전개, 정리~\href{/read/02/1#thm-linear2}{1.11}}}} \end{align*}
  3. E∣DiDj∣<∞E|D_iD_j|<\infty이다. 2∣DiDj∣≤Di2+Dj22|D_iD_j|\le D_i^2+D_j^2이고 오른쪽의 기댓값이 유한하기 때문이다.2∣ab∣≤a2+b22|ab|\le a^2+b^2 [T4]

  4. i≠ji\ne j이면 DiD_i와 DjD_j는 독립이다.독립인 변수의 함수 (2.3절)

  5. E(DiDj)=EDi⋅EDj=0⋅0=0E(D_iD_j)=ED_i\cdot ED_j=0\cdot0=0이다.3 4, 정리 2.7

  6. 남는 것은 ∑iE Di2=∑iVar⁡Xi\sum_iE\,D_i^2=\sum_i\Var X_i이다.정의 2.1

  7. 모두 분산이 σ2\sigma^2이면 Var⁡Xˉ=1n2⋅nσ2=σ2n\Var\bar X=\tfrac1{n^2}\cdot n\sigma^2=\tfrac{\sigma^2}n이다.정리 2.2(b), a=1na=\tfrac1n

조건 확인 전개한 합의 기댓값을 항마다 나눠 쓰려면(선형성) 각 항의 기댓값이 존재해야 한다. 제곱항은 분산이 유한하다는 가정으로, 교차항은 3으로 확인했다.

증명에서 쓴 것은 i≠ji\ne j인 쌍마다 E(DiDj)=0E(D_iD_j)=0이라는 것뿐이다. 그러니 쌍별 독립이면 충분하다(연습 2.5). 연속 확률변수에 대한 같은 정리는 3회에서 증명하고, 그때 E(DiDj)E(D_iD_j)에 공분산이라는 이름을 붙인다.

예제 2.9 (지시변수로 다시 — 이항과 Montmort) 

이항. K=∑i1iK=\sum_i\mathbf 1_i에서 1i\mathbf 1_i들이 독립이고 각각 분산이 pqpq이므로 Var⁡K=npq\Var K=npq. 정리 2.4의 계산 없이 얻었다.

Montmort. 예제 1.12의 일치 수 N=∑1AiN=\sum\mathbf 1_{A_i}은 독립이 아니어서 정리 2.8을 쓸 수 없다. 대신 증명의 첫 줄로 돌아가 교차항을 직접 계산한다. i≠ji\ne j이면 P(AiAj)=(n−2)!n!=1n(n−1)P(A_iA_j)=\tfrac{(n-2)!}{n!}=\tfrac1{n(n-1)}이므로 E N(N−1)=∑i≠jP(AiAj)=1E\,N(N-1)=\sum_{i\ne j}P(A_iA_j)=1이고, n≥2n\ge2이면

Var⁡N=E N(N−1)+EN−(EN)2=1+1−1=1.\Var N=E\,N(N-1)+EN-(EN)^2=1+1-1=1 .

평균도 1, 분산도 1이다. 1회 연습 4.7에서 NN의 분포가 평균 1인 Poisson 분포에 다가간다는 것을 보았다. 4회에서 Poisson 분포의 평균과 분산이 같다는 것을 증명한다.

2.4 적률 ​

정의 2.10 (적률 · 왜도 · 첨도) E∣X∣k<∞E|X|^k<\infty일 때 EXkEX^k를 XX의 kk차 적률, E(X−μ)kE(X-\mu)^k를 kk차 중심적률이라 한다. 분산이 σ2>0\sigma^2>0이면

γ1=E(X−μ)3σ3  (왜도),γ2=E(X−μ)4σ4−3  (초과첨도)\gamma_1=\frac{E(X-\mu)^3}{\sigma^3}\ \ (\text{왜도}),\qquad \gamma_2=\frac{E(X-\mu)^4}{\sigma^4}-3\ \ (\text{초과첨도})

로 정의한다.

kk차 적률이 있으면 그보다 낮은 차수의 적률도 모두 있다. j<kj<k이면 ∣x∣j≤1+∣x∣k|x|^j\le1+|x|^k이기 때문이다. 왜도와 첨도는 aX+baX+b (a>0a>0)로 바꿔도 변하지 않는 모양의 수다. 왜도는 오른쪽 꼬리가 길면 양수다. 초과첨도의 −3-3은 5회의 정규분포에서 0이 되도록 맞춘 것이다. 지수분포는 γ1=2\gamma_1=2, γ2=6\gamma_2=6이고, 균등분포는 γ1=0\gamma_1=0, γ2=−65\gamma_2=-\tfrac65이다(연습 2.7).

역사 동물학자 W. F. R. Weldon은 1894년 주사위 12개를 한꺼번에 굴려 5나 6이 나온 주사위의 수를 세는 일을 26,306번 되풀이하고, 그 기록을 Galton과 Karl Pearson에게 보냈다. Pearson은 1900년 이 자료로 χ2\chi^2 적합도 검정을 처음 보였다(8회).

예제 2.11 (Weldon의 주사위 (1894)) 공평한 주사위라면 한 번 굴릴 때 5·6이 나온 수 KK는 b(12,13)\mathrm b(12,\tfrac13)이므로 EK=4EK=4, Var⁡K=12⋅13⋅23=83≈2.667\Var K=12\cdot\tfrac13\cdot\tfrac23=\tfrac83\approx2.667이다. Weldon의 기록에서 계산한 평균과 분산은 다음과 같다(자료는 vcd::WeldonDice, 10개 이상은 10으로 묶여 있다).

kˉ=126306∑jkjnj=4.0522,126306∑j(kj−kˉ)2nj=2.696.\bar k=\frac1{26306}\sum_jk_jn_j=4.0522,\qquad \frac1{26306}\sum_j(k_j-\bar k)^2n_j=2.696 .

평균이 4보다 0.0520.052 크다. 이 차이가 우연인지는 평균의 흩어짐에 달려 있다. 굴림들이 독립이면 정리 2.8으로 Kˉ\bar K의 표준편차는 (8/3)/26306≈0.0101\sqrt{(8/3)/26306}\approx0.0101이므로, 차이는 표준편차의 5배다. 5절의 Chebyshev 부등식이 이것을 확률의 말로 바꾼다(예제 5.5).

연습문제

연습 2.1 (두 주사위의 합 ★) 두 주사위 눈의 합 SS의 평균과 분산을 (a) pmf로 직접, (b) 정리 2.8으로 구하라.

풀이

(a) P(S=s)=6−∣s−7∣36P(S=s)=\tfrac{6-|s-7|}{36} (s=2,…,12s=2,\dots,12)에서 ES=7ES=7, ES2=197436ES^2=\tfrac{1974}{36}, Var⁡S=197436−49=356≈5.83\Var S=\tfrac{1974}{36}-49=\tfrac{35}6\approx5.83. (b) 두 눈이 독립이므로 Var⁡S=2⋅3512=356\Var S=2\cdot\tfrac{35}{12}=\tfrac{35}6.

연습 2.2 (중앙값은 절대오차를 최소로 한다 ★★) XX가 연속이고 E∣X∣<∞E|X|<\infty이며 중앙값 mm(F(m)=12F(m)=\tfrac12)이 있다. c>mc>m일 때 E∣X−c∣−E∣X−m∣=∫mc(2F(x)−1)dx≥0E|X-c|-E|X-m|=\int_m^c\bigl(2F(x)-1\bigr)dx\ge0임을 보이고, E∣X−c∣E|X-c|가 c=mc=m에서 가장 작음을 결론지어라. (힌트: ∣x−c∣−∣x−m∣|x-c|-|x-m|을 x≤mx\le m, m<x<cm<x<c, x≥cx\ge c로 나눈다.)

풀이

m<cm<c이면 t∈(m,c)t\in(m,c)에 대해 ddt∣x−t∣=sgn⁡(t−x)\tfrac{d}{dt}|x-t|=\operatorname{sgn}(t-x) (t≠xt\ne x)이므로 ∣x−c∣−∣x−m∣=∫mcsgn⁡(t−x) dt|x-c|-|x-m|=\int_m^c\operatorname{sgn}(t-x)\,dt이다. 기댓값을 취하고 (유계인 함수의 유한 구간 적분이므로) 순서를 바꾸면, XX가 연속이어서 Esgn⁡(t−X)=P(X<t)−P(X>t)=2F(t)−1E\operatorname{sgn}(t-X)=P(X<t)-P(X>t)=2F(t)-1이므로

E∣X−c∣−E∣X−m∣=∫mc(2F(t)−1)dt ≥ 0,E|X-c|-E|X-m|=\int_m^c\bigl(2F(t)-1\bigr)dt\ \ge\ 0,

t≥mt\ge m이면 F(t)≥F(m)=12F(t)\ge F(m)=\tfrac12이기 때문이다. c<mc<m도 같다. 따라서 E∣X−c∣E|X-c|는 c=mc=m에서 가장 작다.

연습 2.3 (기하분포의 분산 ★★) 기하분포에서 Var⁡X=qp2\Var X=\tfrac q{p^2}임을 보여라(연습 1.6을 써도 좋다). 6이 나올 때까지 던지는 횟수의 표준편차는?

풀이

연습 1.6로 EX2=2−pp2EX^2=\tfrac{2-p}{p^2}이므로 Var⁡X=2−pp2−1p2=1−pp2=qp2\Var X=\tfrac{2-p}{p^2}-\tfrac1{p^2}=\tfrac{1-p}{p^2}=\tfrac q{p^2}. p=16p=\tfrac16이면 Var⁡X=30\Var X=30, 표준편차 30≈5.48\sqrt{30}\approx5.48번. 평균 6번에 표준편차 5.5번이니 기다리는 시간은 크게 흔들린다.

연습 2.4 (포커의 에이스 ★★) 52장에서 5장을 뽑을 때 에이스의 수 KK의 평균과 분산을 지시변수로 구하라. 이항분포 b(5,113)\mathrm b(5,\tfrac1{13})의 분산과 비교하고, 왜 더 작은지 설명하라.

풀이

K=∑i=151iK=\sum_{i=1}^5\mathbf 1_i, 1i={i\mathbf 1_i=\{i번째 카드가 에이스}\}, P=452=113P=\tfrac4{52}=\tfrac1{13}이므로 EK=513≈0.385EK=\tfrac5{13}\approx0.385. i≠ji\ne j이면 P(둘 다 에이스)=4⋅352⋅51P(\text{둘 다 에이스})=\tfrac{4\cdot3}{52\cdot51}이고 순서쌍 (i,j)(i,j)가 20개이므로 E K(K−1)=20⋅122652≈0.0905E\,K(K-1)=20\cdot\tfrac{12}{2652}\approx0.0905. 따라서

Var⁡K=0.0905+0.3846−0.38462≈0.327.\Var K=0.0905+0.3846-0.3846^2\approx0.327 .

b(5,113)\mathrm b(5,\tfrac1{13})의 분산은 5⋅113⋅1213≈0.3555\cdot\tfrac1{13}\cdot\tfrac{12}{13}\approx0.355로 더 크다. 되돌려 넣지 않으므로 에이스 하나가 나오면 다음 에이스가 나올 확률이 줄어든다(122652<1169\tfrac{12}{2652}<\tfrac1{169}). 교차항이 음수가 되어 분산이 줄어든다.

연습 2.5 (쌍별 독립이면 충분하다 ★★) 1회 예제 5.10의 Bernstein 정사면체에서 R,G,BR,G,B를 각 색이 바닥에 있는 사건의 지시변수라 하자. 셋은 쌍별 독립이지만 상호 독립이 아니다. Var⁡(R+G+B)\Var(R+G+B)를 직접 계산해 Var⁡R+Var⁡G+Var⁡B\Var R+\Var G+\Var B와 같음을 확인하라.

풀이

각 지시변수는 P=12P=\tfrac12이므로 분산 14\tfrac14이고 합은 34\tfrac34. 직접 계산: 면 R, G, B에서 R+G+B=1R+G+B=1, 면 RGB에서 3이므로 R+G+BR+G+B는 확률 34\tfrac34로 1, 14\tfrac14로 3이다. 평균 32\tfrac32, E(⋅)2=34+94=3E(\cdot)^2=\tfrac34+\tfrac94=3, 분산 3−94=343-\tfrac94=\tfrac34. 같다.

연습 2.6 (독립의 정의에서 일부만 ★) 정의 2.6가 성립하면 P(X1=x1,X2=x2)=P(X1=x1)P(X2=x2)P(X_1=x_1,\allowbreak X_2=x_2)=P(X_1=x_1)P(X_2=x_2)임을 보여라. (힌트: x3,…,xnx_3,\dots,x_n의 모든 값에 대해 더한다.)

풀이

(x3,…,xn)(x_3,\dots,x_n)의 모든 값에 걸친 사건 {X1=x1,X2=x2,X3=x3,…,Xn=xn}\{X_1=x_1,\allowbreak X_2=x_2,\allowbreak X_3=x_3,\allowbreak \dots,\allowbreak X_n=x_n\}들은 서로소이고 합집합이 {X1=x1,X2=x2}\{X_1=x_1,X_2=x_2\}이므로 (P3)으로 좌변의 합은 P(X1=x1,X2=x2)P(X_1=x_1,X_2=x_2)이다. 우변의 합은 P(X1=x1)P(X2=x2)∏i≥3∑xiP(Xi=xi)=P(X1=x1)P(X2=x2)P(X_1=x_1)P(X_2=x_2)\prod_{i\ge3}\sum_{x_i}P(X_i=x_i)=P(X_1=x_1)P(X_2=x_2).

연습 2.7 (모양의 수 ★) U(0,1)\mathrm U(0,1)의 왜도와 초과첨도가 00, −65-\tfrac65임을 보이고, Exp(1)\mathrm{Exp}(1)에서 EXk=k!EX^k=k!를 써서 γ1=2\gamma_1=2, γ2=6\gamma_2=6을 확인하라. Bernoulli(pp)의 왜도는 1−2ppq\tfrac{1-2p}{\sqrt{pq}}임을 보여라.

풀이

U(0,1)\mathrm U(0,1): 대칭이므로 3차 중심적률은 0. E(U−12)4=∫−1/21/2x4dx=180E(U-\tfrac12)^4=\int_{-1/2}^{1/2}x^4dx=\tfrac1{80}, σ4=1144\sigma^4=\tfrac1{144}이므로 γ2=14480−3=−65\gamma_2=\tfrac{144}{80}-3=-\tfrac65. Exp(1)\mathrm{Exp}(1): μ=σ=1\mu=\sigma=1. E(X−1)3=EX3−3EX2+3EX−1=6−6+3−1=2E(X-1)^3=EX^3-3EX^2+3EX-1=6-6+3-1=2, E(X−1)4=24−24+12−4+1=9E(X-1)^4=24-24+12-4+1=9이므로 γ1=2\gamma_1=2, γ2=6\gamma_2=6. Bernoulli: E(X−p)3=pq3−qp3=pq(q−p)E(X-p)^3=pq^3-qp^3=pq(q-p)이므로 γ1=pq(q−p)(pq)3/2=1−2ppq\gamma_1=\tfrac{pq(q-p)}{(pq)^{3/2}}=\tfrac{1-2p}{\sqrt{pq}}.

연습 2.8 (두 독립 복사본 ★★) XX와 X′X'이 독립이고 분포가 같은 이산 확률변수이면 Var⁡X=12E(X−X′)2\Var X=\tfrac12E(X-X')^2임을 보여라. 분산은 “무작위로 뽑은 두 값의 차이”로도 정의할 수 있다.

풀이

E(X−X′)2=EX2−2E(XX′)+EX′2=2EX2−2(EX)2=2Var⁡XE(X-X')^2=EX^2-2E(XX')+EX'^2=2EX^2-2(EX)^2=2\Var X. 둘째 등호에서 독립이므로 E(XX′)=EX⋅EX′E(XX')=EX\cdot EX'(정리 2.7)이고 분포가 같다.

연습 2.9 (Weldon의 분산 ★) Weldon의 자료에서 주사위 하나가 5·6을 낼 확률을 p^=kˉ/12\hat p=\bar k/12로 추정하면 이항분포의 분산 12p^(1−p^)12\hat p(1-\hat p)은 얼마인가? 관측한 분산 2.696과 비교하라.

풀이

p^=4.0522/12=0.3377\hat p=4.0522/12=0.3377이므로 12p^(1−p^)=2.68412\hat p(1-\hat p)=2.684. 관측한 분산 2.696과 매우 가깝다. 공평하지 않을 뿐, 주사위마다 5·6이 나올 확률이 약 0.3380.338인 이항 모형은 자료의 흩어짐을 잘 설명한다.

연습 2.10 (분산의 계산: 증명 ★ 유도형) EX2<∞EX^2<\infty, μ=EX\mu=EX이다. 정리 2.2를 다음 순서로 증명하라.

  1. (a)

    (X−c)2=(X−μ)2+2(μ−c)(X−μ)+(μ−c)2(X-c)^2=(X-\mu)^2+2(\mu-c)(X-\mu)+(\mu-c)^2을 확인하고, 세 항의 기댓값이 모두 존재함을 보여라.

  2. (b)

    선형성(정리 1.10)으로 가운데 항의 기댓값이 0임을 보이고 (c)를 얻어라.

  3. (c)

    (c)에 c=0c=0을 넣어 (a)를 얻어라.

  4. (d)

    aX+baX+b의 평균이 aμ+ba\mu+b임을 쓰고 (b)를 얻어라.

풀이

(a) 전개는 a=X−μa=X-\mu, b=μ−cb=\mu-c에 대한 (a+b)2=a2+2ab+b2(a+b)^2=a^2+2ab+b^2이다. E(X−μ)2=Var⁡X<∞E(X-\mu)^2=\Var X<\infty, E∣X−μ∣≤E∣X∣+∣μ∣<∞E|X-\mu|\le E|X|+|\mu|<\infty, 상수의 기댓값은 그 상수이므로 세 항의 기댓값이 모두 존재한다. (b) 선형성(정리 1.10(a))으로 E(X−c)2=E(X−μ)2+2(μ−c)E(X−μ)+(μ−c)2E(X-c)^2=E(X-\mu)^2+2(\mu-c)E(X-\mu)+(\mu-c)^2이고, E(X−μ)=EX−μ=0E(X-\mu)=EX-\mu=0이므로 E(X−c)2=Var⁡X+(μ−c)2E(X-c)^2=\Var X+(\mu-c)^2이다. 오른쪽 둘째 항이 c=μc=\mu에서만 0이므로 c=μc=\mu에서 가장 작다. (c) c=0c=0이면 EX2=Var⁡X+μ2EX^2=\Var X+\mu^2이다. (d) 선형성으로 E(aX+b)=aμ+bE(aX+b)=a\mu+b이므로 Var⁡(aX+b)=E(aX+b−(aμ+b))2=E a2(X−μ)2=a2Var⁡X\Var(aX+b)=E\bigl(aX+b-(a\mu+b)\bigr)^2=E\,a^2(X-\mu)^2=a^2\Var X이다. 제곱근을 취하면 σaX+b=∣a∣σX\sigma_{aX+b}=|a|\sigma_X이다.

연습 2.11 (이항분포의 평균과 분산: 증명 ★★ 유도형) 정리 2.4을 다음 순서로 증명하라.

  1. (a)

    이항정리로 ∑kP(K=k)=1\sum_kP(K=k)=1을 확인하라.

  2. (b)

    k≥1k\ge1이면 k(nk)=n(n−1k−1)k\binom nk=n\binom{n-1}{k-1}임을 계승으로 보여라.

  3. (c)

    (b)를 EKEK의 합에 넣고 첨자를 j=k−1j=k-1로 바꿔 EK=np(p+q)n−1=npEK=np(p+q)^{n-1}=np를 얻어라.

  4. (d)

    같은 방법으로 k(k−1)(nk)=n(n−1)(n−2k−2)k(k-1)\binom nk=n(n-1)\binom{n-2}{k-2}와 E K(K−1)=n(n−1)p2E\,K(K-1)=n(n-1)p^2을 보여라.

  5. (e)

    Var⁡K=E K(K−1)+EK−(EK)2\Var K=E\,K(K-1)+EK-(EK)^2을 쓰고 npqnpq를 얻어라. 왜 EK2EK^2 대신 E K(K−1)E\,K(K-1)을 먼저 구하는가?

풀이

(a) 이항정리(1회 정리 1.6)로 ∑k(nk)pkqn−k=(p+q)n=1\sum_k\tbinom nkp^kq^{n-k}=(p+q)^n=1이다. (b) k(nk)=k⋅n!k! (n−k)!=n!(k−1)! (n−k)!=n⋅(n−1)!(k−1)! ((n−1)−(k−1))!=n(n−1k−1)k\binom nk=k\cdot\frac{n!}{k!\,(n-k)!}=\frac{n!}{(k-1)!\,(n-k)!}=n\cdot\frac{(n-1)!}{(k-1)!\,\bigl((n-1)-(k-1)\bigr)!}=n\binom{n-1}{k-1}. (c) k=0k=0인 항은 0이므로

EK=∑k=1nn(n−1k−1)pkqn−k=np∑j=0n−1(n−1j)pjqn−1−j=np (p+q)n−1=np.EK=\sum_{k=1}^nn\binom{n-1}{k-1}p^kq^{n-k}=np\sum_{j=0}^{n-1}\binom{n-1}{j}p^jq^{n-1-j}=np\,(p+q)^{n-1}=np .

(d) (b)를 두 번 쓰면 k(k−1)(nk)=n(k−1)(n−1k−1)=n(n−1)(n−2k−2)k(k-1)\tbinom nk=n(k-1)\tbinom{n-1}{k-1}=n(n-1)\tbinom{n-2}{k-2}이고, 같은 계산으로 E K(K−1)=n(n−1)p2(p+q)n−2=n(n−1)p2E\,K(K-1)=n(n-1)p^2(p+q)^{n-2}=n(n-1)p^2이다. (e) K2=K(K−1)+KK^2=K(K-1)+K이므로 Var⁡K=E K(K−1)+EK−(EK)2=n(n−1)p2+np−n2p2=np(1−p)\Var K=E\,K(K-1)+EK-(EK)^2=n(n-1)p^2+np-n^2p^2=np(1-p)이다. k2(nk)k^2\tbinom nk는 (n−2k−2)\tbinom{n-2}{k-2} 하나로 줄지 않지만 k(k−1)(nk)k(k-1)\tbinom nk는 줄기 때문에 E K(K−1)E\,K(K-1)을 먼저 구한다.

연습 2.12 (곱의 기댓값: 증명 ★★ 유도형) 정리 2.7를 다음 순서로 증명하라.

  1. (a)

    (X,Y)(X,Y)를 값 (x,y)(x,y)를 갖는 이산 확률변수로 보고 정리 1.9(a)를 g(x,y)=xyg(x,y)=xy에 써라. 어떤 합이 유한해야 하는가?

  2. (b)

    독립(정의 2.6)과 음이 아닌 이중급수의 순서 바꾸기로 ∑x,y∣xy∣P(X=x,Y=y)=E∣X∣ E∣Y∣\sum_{x,y}|xy|P(X=x,\allowbreak Y=y)=E|X|\,E|Y|를 보여라.

  3. (c)

    같은 계산을 절댓값 없이 해서 E(XY)=EX⋅EYE(XY)=EX\cdot EY를 얻어라. 절댓값 없는 이중급수의 순서를 바꿀 수 있는 근거는 무엇인가?

풀이

(a) (X,Y)(X,Y)는 셀 수 있는 값 (x,y)(x,y)들을 갖는 이산 확률변수이고, 정리 1.9(a)를 g(x,y)=xyg(x,y)=xy에 쓰면 ∑x,y∣xy∣P(X=x,Y=y)<∞\sum_{x,y}|xy|P(X=x,\allowbreak Y=y)<\infty일 때 E(XY)=∑x,yxy P(X=x,Y=y)E(XY)=\sum_{x,y}xy\,P(X=x,\allowbreak Y=y)이다. (b) 독립이므로 P(X=x,Y=y)=P(X=x)P(Y=y)P(X=x,Y=y)=P(X=x)P(Y=y)이고, 음이 아닌 이중급수는 xx에 대해 먼저 더해도 되므로

∑x,y∣x∣∣y∣P(X=x)P(Y=y)=∑x∣x∣P(X=x)∑y∣y∣P(Y=y)=E∣X∣ E∣Y∣<∞.\sum_{x,y}|x||y|P(X=x)P(Y=y)=\sum_x|x|P(X=x)\sum_y|y|P(Y=y)=E|X|\,E|Y|<\infty .

(c) (b)로 이중급수가 절대수렴하므로 보조정리 0.1로 어떤 순서로 더해도 같다. xx에 대해 먼저 더하면 ∑x,yxy P(X=x)P(Y=y)=EX⋅EY\sum_{x,y}xy\,P(X=x)P(Y=y)=EX\cdot EY이다.

이 회차에서 읽은 절 0개 · 회차 차례