
테마
1회 · 확률이란 무엇인가 · 노트
8 Beautiful insights — 1회의 수학은 어디에 있나
8.1 시뮬레이션은 상대도수 해석이다
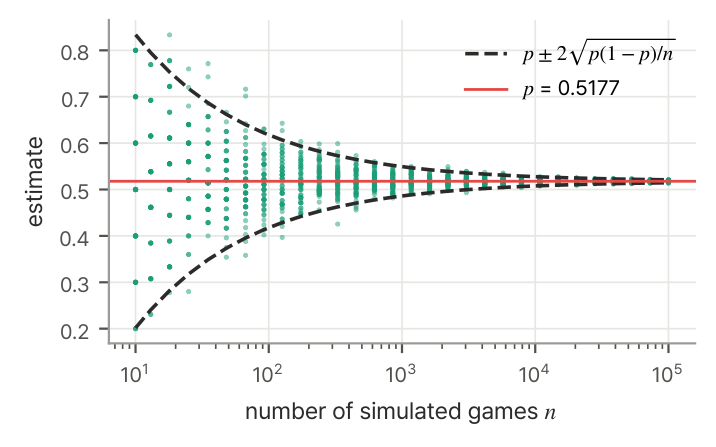
노트북은 거의 모든 확률을 정확한 값과 시뮬레이션으로 두 번 구한다. 시뮬레이션은 2절의 상대도수 해석을 컴퓨터로 옮긴 것이다. 같은 실험을 독립적으로 번 되풀이해 사건이 일어난 비율 를 확률 의 추정으로 쓴다.
얼마나 정확한가? 2회에서 Chebyshev 부등식으로, 7회에서 중심극한정리로 증명하겠지만, 는 대략 안에 떨어진다. 오차는 의 속도로만 준다. 소수 셋째 자리까지 믿으려면(표준오차 ) de Méré의 내기 1에서 번이 필요하다. 시뮬레이션은 정확한 계산을 대신하는 것이 아니라 확인하는 도구다.
8.2 기저율 오류는 분류기의 precision이다
예제 5.6의 진단검사는 이진 분류기와 같다. 민감도 는 기계학습의 재현율(recall), 는 정밀도(precision)다. 베이즈 정리가 말하는 것은 정밀도가 분류기만의 성질이 아니라 양성 비율(기저율)에 의존한다는 것이다. 같은 모델이라도 양성이 인 데이터에서는 정밀도가 , 인 데이터에서는 가 될 수 있다(그림 5.1). 불균형 데이터에서 정확도나 정밀도를 서로 다른 데이터셋끼리 비교할 때 이 점을 잊으면 안 된다.
8.3 베이즈 정리와 naive Bayes 분류기
스팸 필터의 고전적인 형태는 베이즈 정리에 “클래스가 주어지면 단어들이 독립”이라는 가정(조건부 독립)을 더한 것이다. 메일의 단어가 이면
5.2절의 오즈 공식을 단어마다 되풀이한 것이다. 예를 들어 사전 스팸 비율이 이고 “무료”가 스팸의 , 정상 메일의 에 나오면 “무료”가 든 메일의 스팸 확률은 이다. 같은 메일에 정상 메일에 흔한 “회의”(스팸 , 정상 )도 있으면 가능도비 이 곱해져 로 내려간다(연습 8.2). “naive”는 조건부 독립이 대개 사실이 아니라는 뜻이지만, 분류에는 놀랄 만큼 잘 작동한다.
8.4 생일 문제와 해시 충돌
비트 해시 함수의 출력이 개의 값에 고르게 퍼진다면, 서로 다른 입력 개 가운데 출력이 같은 쌍이 생길 확률은 생일 문제와 같은 계산으로 대략 이다. 이것이 이 되는 은 이다. 64비트 해시라도 약 50억 개면 충돌이 반반이다. 암호에서는 이것을 생일 공격이라 하고, 그래서 충돌을 막아야 하는 해시는 원하는 안전 비트의 두 배 길이로 만든다.
연습문제
연습 8.1 (몇 번 시뮬레이션해야 하나 ★) 내기 2()가 불리하다는 것을 시뮬레이션으로 보이려면, 의 두 표준오차가 와 의 차이보다 작아야 한다. 대략 몇 번이 필요한가?
풀이
이다. 을 풀면 이다. de Méré가 경험으로 차이를 알아챘다면 수천 판 이상을 기억에 담았다는 뜻이다.
연습 8.2 (naive Bayes 계산 ★) 본문의 수(사전 스팸 비율 , “무료” , “회의” )로 두 확률 과 를 직접 계산하라.
풀이
“무료”만 있을 때 사후 오즈는 이므로 확률은 . “회의”가 더해지면 가능도비 이 곱해져 오즈가 1, 확률이 가 된다.