
테마
노트북 · 1회 · 확률이란 무엇인가
확률이란 무엇인가 도박장에서 공리까지
| 강의노트 | 01_probability_notes.pdf — 같은 절 번호, 같은 정리 번호. 증명은 노트에, 확인은 여기에 |
| 워크북 | 01_probability_workbook.pdf — 손으로 푸는 34문항. 다 푼 뒤 맨 끝 10절의 check()로 검산 |
| 원자료 | Halley(1693)의 Breslau 생명표 (R 패키지 HistData) |
| 선수 지식 | 집합, 수열과 급수의 극한, 정적분 |
여는 질문. 두 사람이 먼저 여섯 판을 이기는 쪽이 판돈을 모두 갖기로 하고 내기를 하다가, A가 5판, B가 3판을 이긴 상태에서 그만두어야 했다. 판돈을 어떻게 나눠야 공평한가?
Pacioli(1494)는 이라고 답했다. 틀렸다. 바른 답 에 이르는 데 160년이 걸렸고, "확률이란 무엇인가"에 답하는 데 다시 280년이 걸렸다.
이번 회차의 지도
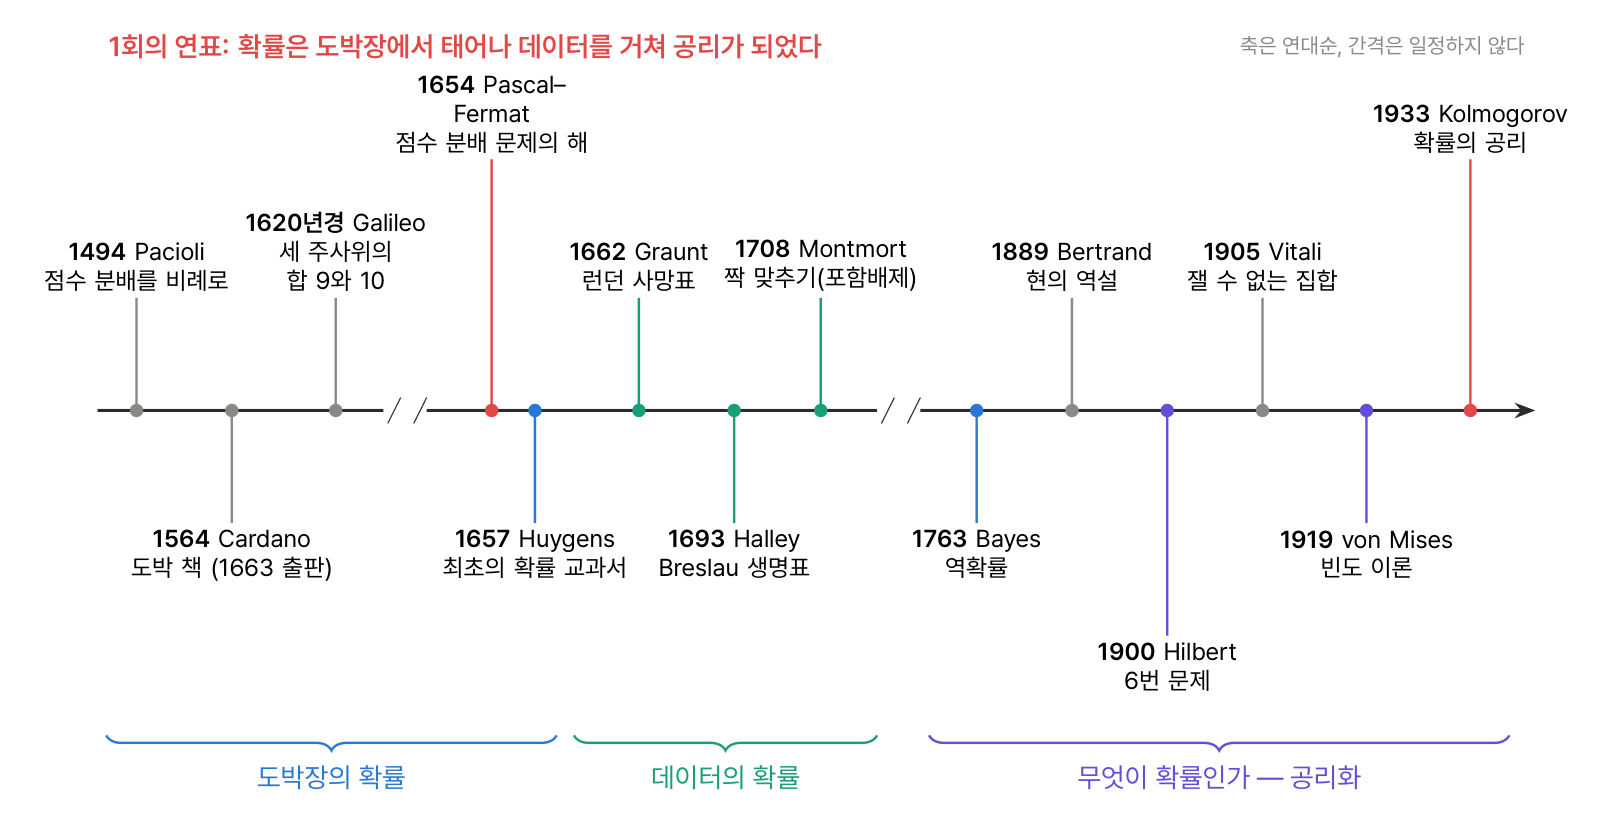
학습 목표
- 셈의 원리(곱의 법칙·순열·조합·이항정리)를 코드로 확인하고 고전적 확률 계산에 쓴다.
- 점수 분배 문제를 Fermat의 열거, Pascal의 재귀, 시뮬레이션 세 가지로 풀어 같은 답이 나오는 것을 본다.
- 공리에서 나온 성질(포함배제, 연속성)을 수치로 확인한다.
- 조건부확률·베이즈 정리·독립을 시뮬레이션으로 확인하고, 쌍별 독립과 상호 독립의 차이를 본다.
- 확률변수를 "결과에 수를 붙이는 함수"로 구현하고, 분포함수를 경험분포함수와 비교한다.
- 공리의 가정을 빼면 무엇이 무너지는지 본다.
정리 지도 — 화살표는 "증명에 쓰인다"는 뜻이다.
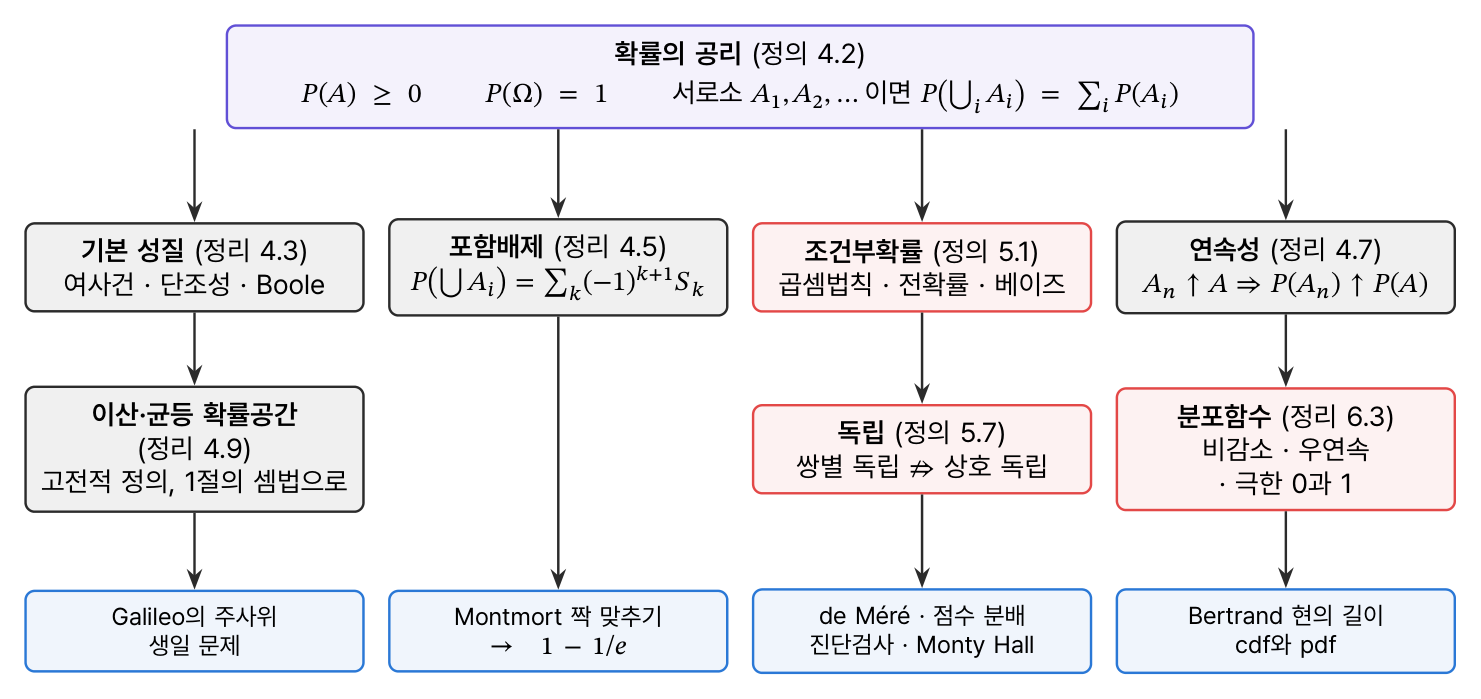
읽는 법. 각 절은 역사 → 정리 → 코드로 확인 → 📝 연습 순서다. 증명은 강의노트에 있고, 여기서는 정리가 말하는 것을 숫자와 시뮬레이션으로 확인한다. 📝 표시의 번호는 강의노트의 연습문제 번호다.
0. 설정과 집합의 언어
0.0 설정
맨 위에 대문자 설정을 모은다. 원자료는 Rdatasets 미러에서 받아 data/에 캐시한다. mc_prob()는 이번 회차 전체에서 쓰는 시뮬레이션 하네스다. 사건이 일어났는지 판정하는 함수를 주면, 상대도수와 그 표준오차를 돌려준다(8.1절).
python
%matplotlib inline
import itertools
import math
from fractions import Fraction
from functools import lru_cache
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats

SEED = 2026          # 재현성
N_SIM = 200_000      # Monte Carlo 반복 수
rng = np.random.default_rng(SEED)

# 과목 색 범례 — 그림에서 이론(참) 곡선은 검정 점선
C = dict(data="#1a9e78", stat="#2a78d6", key="#e34948", assume="#eb6834",
         theta="#6250d6", ink="#2b2b2b", hist="#8a8a86", grid="#e6e6e3")
THEORY = dict(color=C["ink"], ls="--", lw=1.6)
plt.rcParams.update({
    "figure.dpi": 110, "figure.figsize": (8, 4.2), "mathtext.fontset": "stix",
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.grid": True, "grid.color": C["grid"], "grid.linewidth": 0.8,
    "axes.edgecolor": "#9a9a96", "axes.labelcolor": C["ink"],
    "xtick.color": "#52514e", "ytick.color": "#52514e",
    "axes.titleweight": "bold", "axes.titlesize": 11, "axes.titlelocation": "left",
    "legend.frameon": False, "lines.linewidth": 2,
})

RDATASETS = "https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/master/csv/{}/{}.csv"
DATA_DIR = Path("../../data") if Path("../../.git").exists() else Path("data")   # 레포 안이면 공용 data/

def load_rdata(item, package="HistData"):
    """Rdatasets 원자료: 로컬 캐시 → 없으면 받아서 캐시"""
    path = DATA_DIR / (f"{item}.csv" if package == "HistData" else f"{package}_{item}.csv")
    if not path.exists():
        DATA_DIR.mkdir(parents=True, exist_ok=True)
        pd.read_csv(RDATASETS.format(package, item)).drop(columns="rownames").to_csv(path, index=False)
    return pd.read_csv(path)

def report(checks):
    """대조 결과 표 — torchinfo.summary 자리"""
    for name, ok in checks.items():
        print(f"  {'✓' if ok else '✗'}  {name}")
    assert all(checks.values()), "대조 실패"

def mc_prob(event, n=N_SIM):
    """event(n) 이 길이 n의 불리언 배열을 돌려주면, 상대도수와 표준오차 √(p̂(1-p̂)/n)"""
    hits = np.asarray(event(n), dtype=bool)
    p = hits.mean()
    return p, np.sqrt(p * (1 - p) / n)
0.1 집합의 언어
파이썬의 set은 유한집합이다. De Morgan의 법칙(보조정리 0.1)을 표본공간 위의 무작위 사건들로 확인한다.
보조정리 0.1 (De Morgan). , .
python
Omega = set(range(1, 21))
events = [set(rng.choice(20, size=rng.integers(3, 12), replace=False) + 1) for _ in range(4)]
comp = lambda A: Omega - A
union, inter = set().union(*events), set(Omega).intersection(*events)
report({
    "(∪A_i)^c == ∩A_i^c": comp(union) == set(Omega).intersection(*[comp(A) for A in events]),
    "(∩A_i)^c == ∪A_i^c": comp(inter) == set().union(*[comp(A) for A in events]),
})
text
  ✓  (∪A_i)^c == ∩A_i^c
  ✓  (∩A_i)^c == ∪A_i^c
1. 도박장에서 태어난 확률
1.1 점수 분배 문제와 Pacioli의 답
상태 = A가 이기려면 판, B가 이기려면 판을 더 이겨야 하는 상태. 판마다 A가 이길 확률은 . 공평함의 기준(Pascal–Fermat): 판돈을 계속했다면 각자가 이겼을 확률에 비례해 나눈다. 여는 질문은 이다.
Tartaglia(1556)의 반론: 먼저 6판을 이기는 내기에서 1:0이면 Pacioli의 규칙 는 판돈 전부를 A에게 준다.
1.2 셈의 원리
정리 1.1 (곱의 법칙) · 정리 1.2 (순열) · 정리 1.4 (조합) · 정리 1.5 (Pascal 항등식) · 정리 1.6 (이항정리) · 따름정리 1.7 , .
공식을 itertools의 직접 열거와 대조한다.
python
n, k = 7, 3
items = range(n)
report({
    "정리 1.2: 순열 수 == n!/(n-k)!": sum(1 for _ in itertools.permutations(items, k)) == math.factorial(n) // math.factorial(n - k),
    "정리 1.4: 조합 수 == n!/(k!(n-k)!)": sum(1 for _ in itertools.combinations(items, k)) == math.comb(n, k),
    "정리 1.5: Pascal 항등식 (n<=30 전부)": all(math.comb(m, j) == math.comb(m - 1, j - 1) + math.comb(m - 1, j)
                                          for m in range(1, 31) for j in range(1, m + 1)),
    "따름정리 1.7: Σ C(n,k) = 2^n": all(sum(math.comb(m, j) for j in range(m + 1)) == 2**m for m in range(31)),
    "따름정리 1.7: Σ (-1)^k C(n,k) = 0": all(sum((-1)**j * math.comb(m, j) for j in range(m + 1)) == 0 for m in range(1, 31)),
})

# 정리 1.6 (이항정리): (x+y)^n 을 2^n 개의 곱으로 전개해 x^k y^(n-k) 항을 센다
n = 6
counts = np.zeros(n + 1, int)
for choice in itertools.product("xy", repeat=n):
    counts[choice.count("x")] += 1
print("x^k 항의 개수:", counts, "  C(6,k):", [math.comb(6, j) for j in range(7)])
text
  ✓  정리 1.2: 순열 수 == n!/(n-k)!
  ✓  정리 1.4: 조합 수 == n!/(k!(n-k)!)
  ✓  정리 1.5: Pascal 항등식 (n<=30 전부)
  ✓  따름정리 1.7: Σ C(n,k) = 2^n
  ✓  따름정리 1.7: Σ (-1)^k C(n,k) = 0
x^k 항의 개수: [ 1  6 15 20 15  6  1]   C(6,k): [1, 6, 15, 20, 15, 6, 1]
예제 1.8 (Galileo의 세 주사위, 1620년 무렵). 합이 9인 조합과 10인 조합은 모두 6가지다. 그런데 10이 더 자주 나온다. 같은 확률로 일어나는 것은 조합이 아니라 순서까지 구별한 가지 결과다.
python
outcomes = list(itertools.product(range(1, 7), repeat=3))           # 216개의 같은 확률의 결과
sums = np.array([sum(o) for o in outcomes])
for s in (9, 10):
    combos = sorted({tuple(sorted(o)) for o in outcomes if sum(o) == s})
    print(f"합 {s:2d}: 조합 {len(combos)}가지 {combos}")
    print(f"        순서쌍 {np.sum(sums == s)}가지 → 확률 {np.sum(sums == s)}/216 = {np.mean(sums == s):.4f}")

fig, ax = plt.subplots(figsize=(7, 3))
vals, cnt = np.unique(sums, return_counts=True)
ax.bar(vals, cnt, color=[C["key"] if v == 10 else C["stat"] if v == 9 else C["data"] for v in vals])
ax.set_xticks(vals); ax.set_xlabel("sum of three dice"); ax.set_ylabel("ways out of 216")
ax.set_title("Example 1.8: 25 ways to make 9, 27 ways to make 10")
plt.tight_layout(); plt.show()
text
합  9: 조합 6가지 [(1, 2, 6), (1, 3, 5), (1, 4, 4), (2, 2, 5), (2, 3, 4), (3, 3, 3)]
        순서쌍 25가지 → 확률 25/216 = 0.1157
합 10: 조합 6가지 [(1, 3, 6), (1, 4, 5), (2, 2, 6), (2, 3, 5), (2, 4, 4), (3, 3, 4)]
        순서쌍 27가지 → 확률 27/216 = 0.1250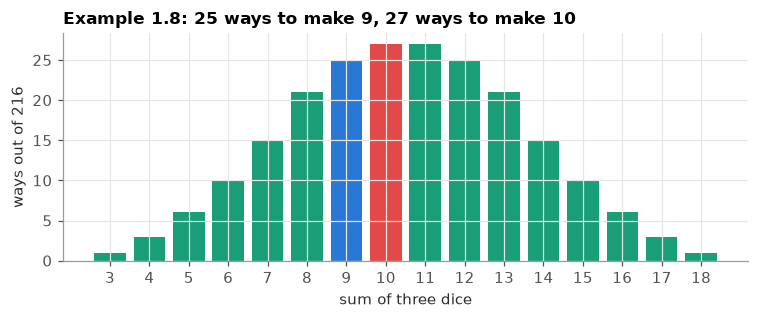
1.3 de Méré의 두 내기
예제 1.9. 내기 1: 주사위 하나를 4번 던져 6이 적어도 한 번. 내기 2: 주사위 두 개를 24번 던져 (6,6)이 적어도 한 번.
정확한 값은 Fraction으로, 근사는 mc_prob으로 구한다.
python
exact1 = 1 - Fraction(5, 6) ** 4
exact2 = 1 - Fraction(35, 36) ** 24
sim1, se1 = mc_prob(lambda n: (rng.integers(1, 7, (n, 4)) == 6).any(axis=1))
sim2, se2 = mc_prob(lambda n: ((rng.integers(1, 7, (n, 24)) == 6) & (rng.integers(1, 7, (n, 24)) == 6)).any(axis=1))
print(f"내기 1: 정확 {exact1} = {float(exact1):.4f}   시뮬레이션 {sim1:.4f} ± {2*se1:.4f}")
print(f"내기 2: 정확 {float(exact2):.4f}            시뮬레이션 {sim2:.4f} ± {2*se2:.4f}")

# 비례 규칙 n ≈ 0.693/p 와 정확한 기준 n ≥ log 2 / (-log(1-p))
for p, name in [(1/6, "한 개 (p=1/6)"), (1/36, "두 개 (p=1/36)")]:
    print(f"{name}: 정확한 기준 {math.log(2)/-math.log(1-p):.2f}번,  비례 근사 0.693/p = {math.log(2)/p:.2f}번")
text
내기 1: 정확 671/1296 = 0.5177   시뮬레이션 0.5153 ± 0.0022
내기 2: 정확 0.4914            시뮬레이션 0.4901 ± 0.0022
한 개 (p=1/6): 정확한 기준 3.80번,  비례 근사 0.693/p = 4.16번
두 개 (p=1/36): 정확한 기준 24.61번,  비례 근사 0.693/p = 24.95번
1.4 Pascal과 Fermat의 해 (1654)
정리 1.10 (Fermat의 공식). 판을 끝까지 했다고 치면 "A가 이긴다" = "판 중 A가 판 이상"이므로
정리 5.13 (Pascal의 재귀). , , . (증명은 5.5절의 전확률 공식)
세 가지 방법을 모두 구현해 맞춰 본다. (1) Fermat: 개의 수열을 직접 열거, (2) Pascal: 재귀, (3) 닫힌형, (4) 실제로 승부가 날 때까지 하는 시뮬레이션.
python
def fermat_enumerate(a, b, p=Fraction(1, 2)):
    """m = a+b-1 판의 모든 결과 수열을 열거해 A가 a판 이상 이긴 수열의 확률을 더한다"""
    m, q, total = a + b - 1, 1 - p, Fraction(0)
    for seq in itertools.product("AB", repeat=m):
        k = seq.count("A")
        if k >= a:
            total += p**k * q**(m - k)
    return total

@lru_cache(maxsize=None)
def pascal(a, b, p=Fraction(1, 2)):
    """Pascal의 재귀 (정리 5.13)"""
    if a == 0:
        return Fraction(1)
    if b == 0:
        return Fraction(0)
    return p * pascal(a - 1, b, p) + (1 - p) * pascal(a, b - 1, p)

def fermat_formula(a, b, p=0.5):
    m = a + b - 1
    return sum(math.comb(m, k) * p**k * (1 - p) ** (m - k) for k in range(a, m + 1))

def simulate_match(a, b, p=0.5, n=50_000):
    """승부가 실제로 날 때까지 판을 이어서 한다"""
    wins = 0
    for _ in range(n):
        need_a, need_b = a, b
        while need_a > 0 and need_b > 0:
            if rng.random() < p:
                need_a -= 1
            else:
                need_b -= 1
        wins += need_a == 0
    return wins / n

states = [(1, 2), (1, 3), (2, 3), (3, 3), (2, 5)]
report({f"(a,b)={s}: 열거 == 재귀 == 닫힌형": fermat_enumerate(*s) == pascal(*s) and math.isclose(float(pascal(*s)), fermat_formula(*s))
        for s in states})
print()
for a, b in [(1, 2), (1, 3), (2, 3)]:
    f = pascal(a, b)
    print(f"Pascal의 편지: 상태 ({a},{b}) → A 몫 {f} → 판돈 64 중 {64*f}   (시뮬레이션 {simulate_match(a, b):.3f})")
print(f"\n여는 질문 (1,3): Pacioli 5/8 = {5/8:.3f}  vs  공평한 몫 {pascal(1, 3)} = {float(pascal(1, 3)):.3f}  →  7:1")
text
  ✓  (a,b)=(1, 2): 열거 == 재귀 == 닫힌형
  ✓  (a,b)=(1, 3): 열거 == 재귀 == 닫힌형
  ✓  (a,b)=(2, 3): 열거 == 재귀 == 닫힌형
  ✓  (a,b)=(3, 3): 열거 == 재귀 == 닫힌형
  ✓  (a,b)=(2, 5): 열거 == 재귀 == 닫힌형

Pascal의 편지: 상태 (1,2) → A 몫 3/4 → 판돈 64 중 48   (시뮬레이션 0.749)
Pascal의 편지: 상태 (1,3) → A 몫 7/8 → 판돈 64 중 56   (시뮬레이션 0.876)
text
Pascal의 편지: 상태 (2,3) → A 몫 11/16 → 판돈 64 중 44 (시뮬레이션 0.686)text
여는 질문 (1,3): Pacioli 5/8 = 0.625 vs 공평한 몫 7/8 = 0.875 → 7:1python
# Pacioli vs Pascal: 먼저 6판을 이기는 내기의 모든 중간 점수 (i, j)
T = 6
rows = []
for i in range(T):
    for j in range(T):
        if i + j:
            rows.append(dict(A_score=i, B_score=j, pacioli=i / (i + j), fair=float(pascal(T - i, T - j))))
tab = pd.DataFrame(rows)

fig, ax = plt.subplots(figsize=(5.2, 5))
ax.scatter(tab.pacioli, tab.fair, s=30, c=np.where(tab.A_score >= tab.B_score, C["stat"], C["data"]))
ax.plot([0, 1], [0, 1], color=C["hist"], ls=":", lw=1)
pt = tab.query("A_score == 5 and B_score == 3").iloc[0]
ax.plot(pt.pacioli, pt.fair, "o", ms=11, mfc="none", mec=C["key"], mew=2)
ax.annotate("5:3  Pacioli 5/8, fair 7/8", (pt.pacioli, pt.fair), xytext=(0.05, 0.9), fontsize=9,
            arrowprops=dict(arrowstyle="->", color=C["key"]))
ax.set_xlabel("Pacioli's share i/(i+j)"); ax.set_ylabel("fair share P(A wins)"); ax.set_aspect("equal")
ax.set_title("Pacioli (1494) vs Pascal (1654)")
plt.tight_layout(); plt.show()
t10 = tab.query("A_score == 1 and B_score == 0").iloc[0]          # Tartaglia의 반례
print(f"Tartaglia의 반례 1:0 → Pacioli {t10.pacioli:.2f} (판돈 전부)   공평한 몫 {t10.fair:.4f}")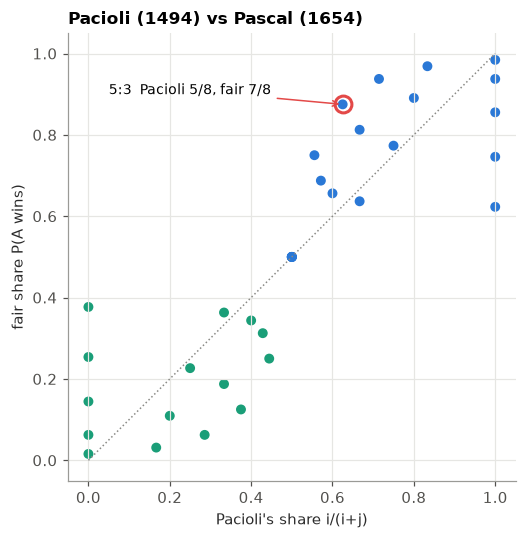
text
Tartaglia의 반례 1:0 → Pacioli 1.00 (판돈 전부) 공평한 몫 0.62301.5 Huygens (1657): 기대 몫
"를 얻을 기회가 번, 를 얻을 기회가 번이면 그 내기의 값어치는 ." 점수 분배의 공평한 몫 = 판돈 × 이길 확률 = 기대 몫. 2회의 기댓값이 여기서 나온다.
📝 연습 1.1–1.7 (강의노트): 풀하우스, 로또, Vandermonde, Galileo의 11과 12, 한 개짜리 내기의 기준, Fermat의 공식이 Pascal의 재귀를 만족함, 실력이 다른 두 사람( → 아래에서 확인).
python
print("연습 1.1 풀하우스:", 13 * 4 * 12 * 6, "/", math.comb(52, 5), "=", round(13 * 4 * 12 * 6 / math.comb(52, 5), 5))
print("연습 1.7 p=0.6, (2,3):", float(pascal(2, 3, Fraction(3, 5))), " 시뮬레이션", simulate_match(2, 3, 0.6))
text
연습 1.1 풀하우스: 3744 / 2598960 = 0.00144
연습 1.7 p=0.6, (2,3): 0.8208  시뮬레이션 0.8226
2. 데이터에서 온 확률
Graunt(1662)와 Halley(1693)는 같은 경우를 세는 대신 실제로 일어난 일의 상대도수를 확률로 읽었다. 이 해석이 수학적으로 정당하다는 것은 2회의 대수의 법칙이 증명한다.
2.2 Halley의 Breslau 생명표 (1693)
Halley의 표는 나이 마다 1세 1,000명 가운데의 생존자 수 를 준다.
예제 2.1. 이미 20세인 사람이 40세까지 살 비율 . 이므로 이것은 , 곧 조건부확률(정의 5.1)이다. 그리고 — 곱셈법칙(정리 5.3)이 생명표에서는 이렇게 보인다.
python
halley = load_rdata("HalleyLifeTable")
ell = dict(zip(halley.age, halley.number))
print(halley.head(), "\n")

P = lambda x: ell[x] / 1000                     # 1세 아이가 x세까지 살 확률 (상대도수)
cond = lambda y, x: P(y) / P(x)                 # 이미 x세인 사람이 y세까지 (x < y 이므로 {y} ⊂ {x})
print(f"P(reach 40 | at 20) = {ell[40]}/{ell[20]} = {cond(40, 20):.3f}")
print(f"P(reach 60 | at 20) = {cond(60, 20):.3f}")
print(f"P(reach 60 | at 40) = {cond(60, 40):.3f}")
report({"곱셈법칙: P(60|20) == P(40|20)·P(60|40)": math.isclose(cond(60, 20), cond(40, 20) * cond(60, 40))})

fig, axes = plt.subplots(1, 2, figsize=(12, 3.8))
ax = axes[0]
ax.step(halley.age, halley.number, where="post", color=C["data"])
for a_, col in [(20, C["stat"]), (40, C["key"])]:
    ax.plot(a_, ell[a_], "o", color=col); ax.annotate(f"age {a_}: {ell[a_]}", (a_, ell[a_]), xytext=(6, 4), textcoords="offset points")
ax.set_xlabel("age"); ax.set_ylabel("survivors of 1000 at age 1"); ax.set_title("Halley 1693, Breslau")
ax = axes[1]
xs = [a_ for a_ in halley.age if a_ <= 60]
ax.plot(xs, [cond(60, a_) for a_ in xs], color=C["key"], label="P(reach 60 | alive at x)")
ax.plot([a_ for a_ in xs if a_ <= 40], [cond(40, a_) for a_ in xs if a_ <= 40], color=C["stat"], label="P(reach 40 | alive at x)")
ax.set_xlabel("current age x"); ax.set_ylim(0, 1.02); ax.legend(loc="upper left"); ax.set_title("conditional survival")
plt.tight_layout(); plt.show()

print(f"연습 2.1: 30세 → 40세 전에 죽을 비율 = ({ell[30]}-{ell[40]})/{ell[30]} = {(ell[30]-ell[40])/ell[30]:.3f}")
print(f"연습 2.2: 처음으로 절반 이하가 남는 나이 = {next(a_ for a_ in halley.age if ell[a_] <= 500)}세")
text
   age  deaths  number     ratio
0    1     238    1000  0.855000
1    2     145     855  0.933333
2    3      57     798  0.952381
3    4      38     760  0.963158
4    5      28     732  0.969945

P(reach 40 | at 20) = 445/598 = 0.744
P(reach 60 | at 20) = 0.405
P(reach 60 | at 40) = 0.544
  ✓  곱셈법칙: P(60|20) == P(40|20)·P(60|40)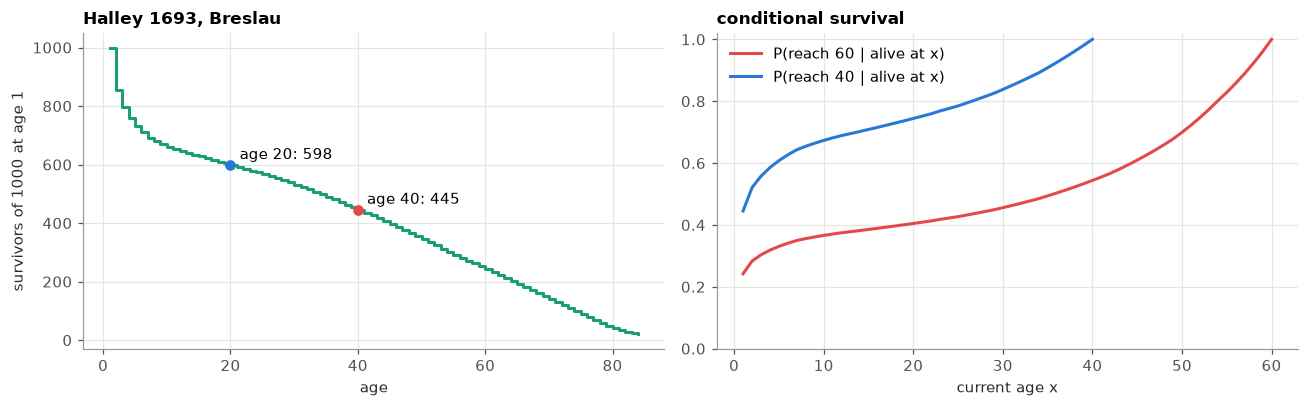
text
연습 2.1: 30세 → 40세 전에 죽을 비율 = (531-445)/531 = 0.162
연습 2.2: 처음으로 절반 이하가 남는 나이 = 34세
그림 읽기. 오른쪽 그림에서 60세까지 살 확률은 나이를 먹을수록 오른다. 이미 살아남았다는 정보가 쌓이기 때문이다. 조건부확률은 "정보가 주어지면 확률을 다시 매긴다"는 것이고, 그 정보는 대개 확률을 바꾼다.
📝 연습 2.1–2.3 (강의노트): 30대에 죽을 비율, 생존의 중앙값, 생명표의 곱셈법칙.
3. "무작위로"의 위기
3.1 Bertrand의 현 역설 (1889)
원에 현을 무작위로 하나 그을 때 내접 정삼각형의 변보다 길 확률은?
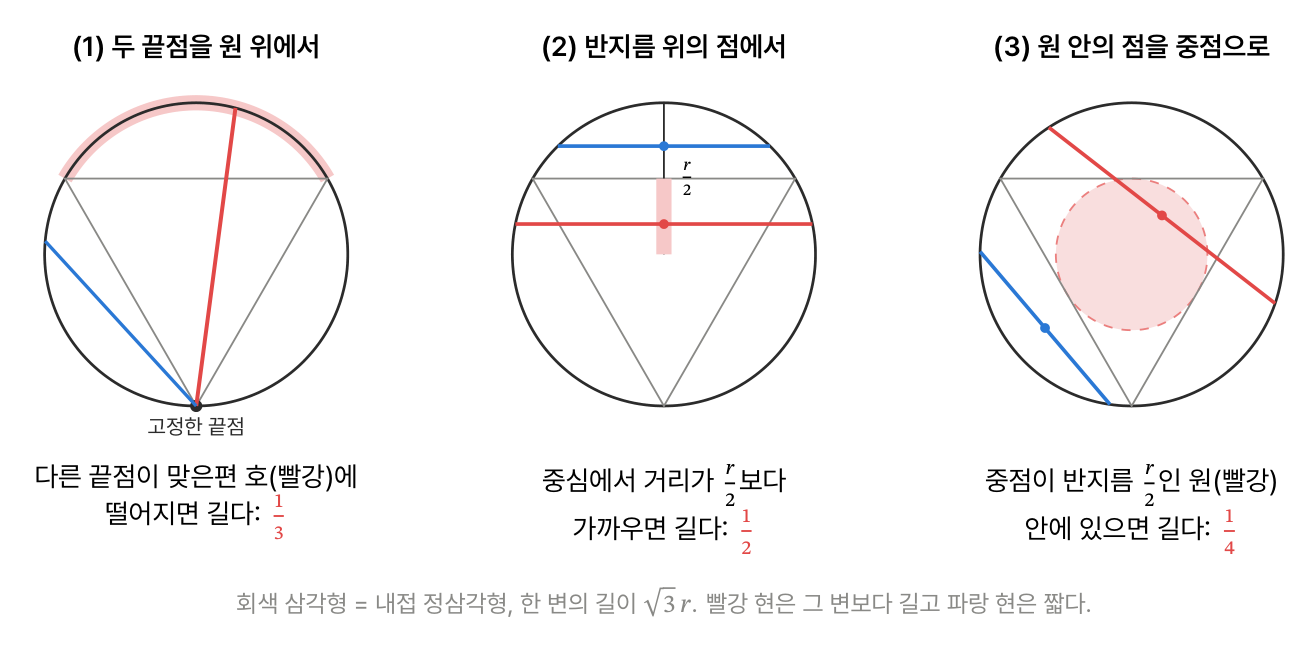
예제 3.1. (1) 두 끝점을 원둘레에서 고르게 → . (2) 반지름 위의 점을 고르게 → . (3) 원판 안의 중점을 넓이에 고르게 → .
세 방법을 그대로 구현한다. 반지름은 이다.
python
def chords(method, n):
    """현의 두 끝점 (x1, y1, x2, y2) 을 반환. method = 1, 2, 3"""
    if method == 1:                                   # 두 끝점을 원둘레 위에서 고르게
        t1, t2 = rng.uniform(0, 2 * np.pi, n), rng.uniform(0, 2 * np.pi, n)
        return np.c_[np.cos(t1), np.sin(t1), np.cos(t2), np.sin(t2)]
    if method == 2:                                   # 방향을 고르고, 그 반지름 위의 거리 d를 고르게
        th, d = rng.uniform(0, 2 * np.pi, n), rng.uniform(0, 1, n)
    else:                                             # 중점을 원판 넓이에 고르게: 거리 = sqrt(U)
        th, d = rng.uniform(0, 2 * np.pi, n), np.sqrt(rng.uniform(0, 1, n))
    h = np.sqrt(1 - d**2)                             # 반현의 길이
    mx, my = d * np.cos(th), d * np.sin(th)           # 중점
    ux, uy = -np.sin(th), np.cos(th)                  # 현의 방향
    return np.c_[mx - h * ux, my - h * uy, mx + h * ux, my + h * uy]

length = lambda c: np.hypot(c[:, 0] - c[:, 2], c[:, 1] - c[:, 3])

fig, axes = plt.subplots(1, 3, figsize=(12, 4.2))
tt = np.linspace(0, 2 * np.pi, 300)
for ax, m, exact in zip(axes, [1, 2, 3], ["1/3", "1/2", "1/4"]):
    c = chords(m, 400)
    long_ = length(c) > np.sqrt(3)
    for row, lg in zip(c, long_):
        ax.plot(row[[0, 2]], row[[1, 3]], color=C["key"] if lg else C["stat"], lw=0.5, alpha=0.45)
    ax.plot(np.cos(tt), np.sin(tt), color=C["ink"], lw=1.2)
    p_hat = np.mean(length(chords(m, N_SIM)) > np.sqrt(3))
    ax.set_title(f"method ({m}): P(L > √3) ≈ {p_hat:.3f}  (exact {exact})", fontsize=10)
    ax.set_aspect("equal"); ax.axis("off")
plt.tight_layout(); plt.show()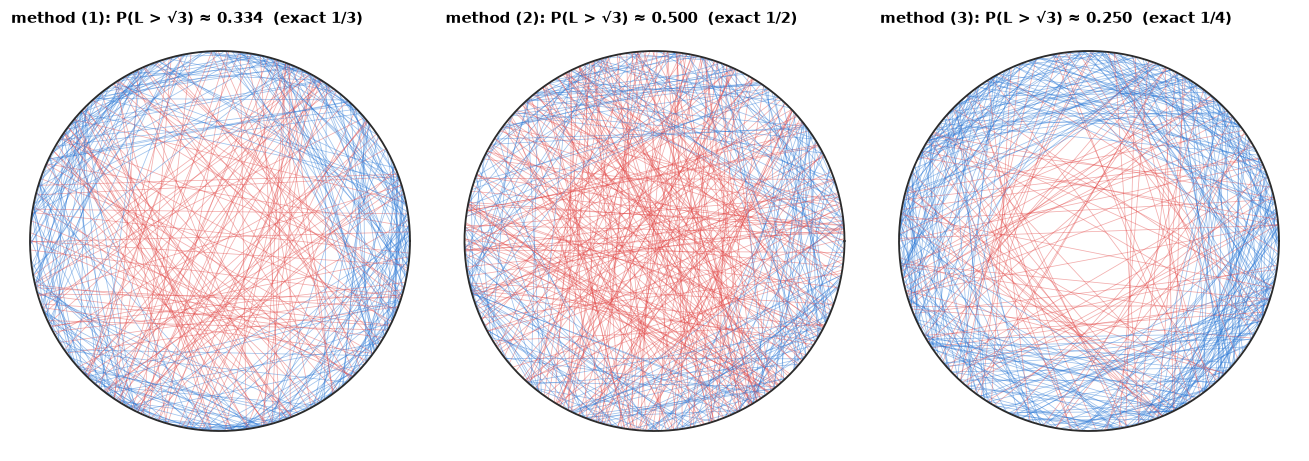
그림 읽기. 빨강은 긴 현, 파랑은 짧은 현이다. 세 그림은 "무작위 현"의 서로 다른 세 모집단이다. (1)은 짧은 현이 원둘레 가까이에 많고, (3)은 중점이 넓이에 고르게 퍼져 원 가장자리 근처의 짧은 현이 가장 많다. 질문이 무엇에 대해 균등한가를 정하지 않으면 확률은 정해지지 않는다. 4.6절에서 이것은 서로 다른 세 확률공간 라는 말이 된다.
3.2 Bertrand의 상자 역설 — 5.3절에서 시뮬레이션으로 확인한다.
3.3 Hilbert의 6번 문제 (1900)
Bertrand가 알려 준 것: 확률을 말하려면 (1) 가능한 결과의 집합, (2) 확률을 줄 사건의 모임, (3) 확률이 따를 규칙을 먼저 정해야 한다. 4절이 이 일을 한다.
📝 연습 3.1–3.3 (강의노트): 반지름보다 긴 현, 정사각형 안의 점과 , 구 위의 "무작위 점". 마지막 문제를 시뮬레이션으로 본다.
python
N = N_SIM
# (a) 위도·경도를 각각 고르게
lat_a = rng.uniform(-90, 90, N)
# (b) 구면의 넓이에 고르게: 3차원 표준정규 벡터를 정규화하면 구면 위에 고르다 (회전대칭: 직교행렬 Q에 대해 QZ도 표준정규, 5회 정리 3.8)
v = rng.standard_normal((N, 3)); v /= np.linalg.norm(v, axis=1, keepdims=True)
lat_b = np.degrees(np.arcsin(v[:, 2]))
print(f"P(위도 ≥ 60°): (a) 위도 균등 {np.mean(lat_a >= 60):.4f} (정확 1/6 = {1/6:.4f})   "
      f"(b) 넓이 균등 {np.mean(lat_b >= 60):.4f} (정확 {(1-np.sqrt(3)/2)/2:.4f})")

pts = rng.uniform(0, 1, (N, 2))
print(f"연습 3.2: 4 × P(x²+y² ≤ 1) = {4*np.mean((pts**2).sum(1) <= 1):.4f}   (π = {np.pi:.4f})")
text
P(위도 ≥ 60°): (a) 위도 균등 0.1673 (정확 1/6 = 0.1667)   (b) 넓이 균등 0.0670 (정확 0.0670)
연습 3.2: 4 × P(x²+y² ≤ 1) = 3.1412   (π = 3.1416)
4. Kolmogorov의 공리 (1933)
정의 4.1 (σ-대수). (i) (ii) (iii) .
정의 4.2 (확률의 공리). (P1) (P2) (P3) 쌍마다 서로소이면 .
정리 4.3 (기본 성질). , 유한가법성, , 단조성, , Boole 부등식.
유한 확률공간에서는 공리가 그대로 코드가 된다. 위의 확률질량 p를 정하면 P(A) = p[A].sum()이다(정리 4.9). 무작위로 만든 확률공간에서 정리 4.3의 성질을 모두 확인한다.
python
class FiniteSpace:
    """유한 확률공간 (Ω = {0..N-1}, 모든 부분집합이 사건) — 정리 4.9"""
    def __init__(self, p):
        p = np.asarray(p, float)
        assert (p >= 0).all() and np.isclose(p.sum(), 1), "p 는 확률질량이어야 한다"
        self.p, self.N = p, len(p)

    def P(self, A):                       # A: 원소 번호의 집합 (set)
        return float(self.p[list(A)].sum()) if A else 0.0

    def random_event(self, rng):
        return set(np.flatnonzero(rng.random(self.N) < rng.uniform(0.2, 0.7)))

S = FiniteSpace(rng.dirichlet(np.ones(30)))
Om = set(range(S.N))
A, B = S.random_event(rng), S.random_event(rng)
evs = [S.random_event(rng) for _ in range(6)]
report({
    "(a) P(∅) = 0": S.P(set()) == 0,
    "(c) P(A^c) = 1 - P(A)": math.isclose(S.P(Om - A), 1 - S.P(A)),
    "(d) A∩B ⊂ B → P(B \\ AB) = P(B) - P(AB)": math.isclose(S.P(B - (A & B)), S.P(B) - S.P(A & B)),
    "(f) P(A∪B) = P(A) + P(B) - P(AB)": math.isclose(S.P(A | B), S.P(A) + S.P(B) - S.P(A & B)),
    "(g) Boole: P(∪A_i) ≤ Σ P(A_i)": S.P(set().union(*evs)) <= sum(S.P(E) for E in evs) + 1e-12,
})
print("예제 4.4 적어도 한 장의 에이스:", round(1 - math.comb(48, 5) / math.comb(52, 5), 4))
text
  ✓  (a) P(∅) = 0
  ✓  (c) P(A^c) = 1 - P(A)
  ✓  (d) A∩B ⊂ B → P(B \ AB) = P(B) - P(AB)
  ✓  (f) P(A∪B) = P(A) + P(B) - P(AB)
  ✓  (g) Boole: P(∪A_i) ≤ Σ P(A_i)
예제 4.4 적어도 한 장의 에이스: 0.3412
4.4 포함배제의 원리
정리 4.5. , .
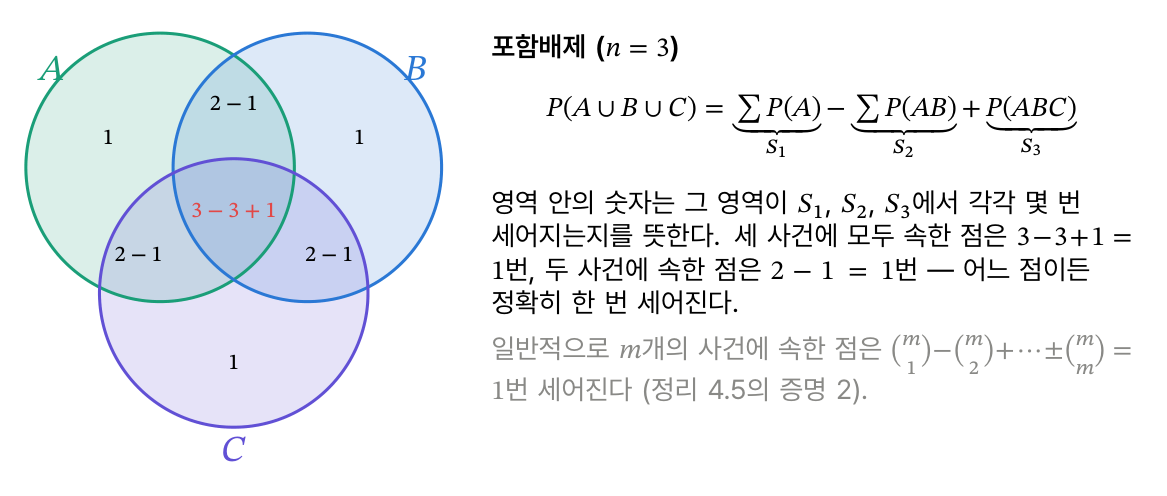
를 itertools.combinations로 그대로 계산해, 합집합의 확률과 맞춰 본다. 앞에서 몇 항만 쓰면 위·아래로 번갈아 어긋난다(Bonferroni 부등식, 연습 4.5).
python
def S_k(space, events, k):
    return sum(space.P(set.intersection(*c)) for c in itertools.combinations(events, k))

n = len(evs)
S = FiniteSpace(rng.dirichlet(np.ones(30)))
evs = [S.random_event(rng) for _ in range(n)]
truth = S.P(set().union(*evs))
partial = np.cumsum([(-1) ** (k + 1) * S_k(S, evs, k) for k in range(1, n + 1)])
report({"정리 4.5: Σ(-1)^(k+1) S_k == P(∪A_i)": math.isclose(partial[-1], truth)})
for k, v in enumerate(partial, 1):
    side = "≥" if v >= truth - 1e-12 else "≤"
    print(f"  처음 {k}항까지의 부분합: {v:.4f}  ({side} 참값 {truth:.4f})")
text
  ✓  정리 4.5: Σ(-1)^(k+1) S_k == P(∪A_i)
  처음 1항까지의 부분합: 2.9355  (≥ 참값 0.9956)
  처음 2항까지의 부분합: -0.3458  (≤ 참값 0.9956)
  처음 3항까지의 부분합: 1.3709  (≥ 참값 0.9956)
  처음 4항까지의 부분합: 0.9859  (≤ 참값 0.9956)
  처음 5항까지의 부분합: 0.9956  (≥ 참값 0.9956)
  처음 6항까지의 부분합: 0.9956  (≥ 참값 0.9956)
예제 4.6 (Montmort의 짝 맞추기, 1708). 장의 카드를 섞어 센 수와 카드가 적어도 한 번 일치할 확률은 이므로
공식, 모든 순열의 직접 열거(), 시뮬레이션을 맞춘다.
python
def montmort(n):
    return sum(Fraction((-1) ** (k + 1), math.factorial(k)) for k in range(1, n + 1))

def brute(n):
    perms = itertools.permutations(range(n))
    return Fraction(sum(any(p_[i] == i for i in range(n)) for p_ in perms), math.factorial(n))

report({f"n={n}: 포함배제 공식 == 순열 {math.factorial(n)}개 직접 열거": montmort(n) == brute(n) for n in range(1, 9)})
for n in [4, 13, 52]:
    sim = np.mean([(rng.permutation(n) == np.arange(n)).any() for _ in range(20_000)])
    err = abs(float(montmort(n)) - (1 - math.exp(-1)))
    print(f"n={n:2d}: p_n = {float(montmort(n)):.10f}  시뮬레이션 {sim:.4f}  |p_n-(1-1/e)| = {err:.1e} ≤ 1/(n+1)! = {1/math.factorial(n+1):.1e}")
print("연습 4.6: 카드 4장의 완전 순열(하나도 안 맞음):",
      ["".join(str(x + 1) for x in p_) for p_ in itertools.permutations(range(4)) if all(p_[i] != i for i in range(4))])

ns = np.arange(1, 11)
fig, axes = plt.subplots(1, 2, figsize=(12, 3.8))
ax = axes[0]
ax.plot(ns, [float(montmort(n)) for n in ns], "o-", color=C["stat"], label="$p_n$ (inclusion–exclusion)")
ax.plot(ns, [np.mean([(rng.permutation(n) == np.arange(n)).any() for _ in range(4000)]) for n in ns],
        "s", color=C["data"], mfc="none", ms=8, label="simulation")
ax.axhline(1 - math.exp(-1), **THEORY, label="$1-1/e$")
ax.set_xlabel("number of cards n"); ax.set_ylabel("P(at least one match)"); ax.legend(); ax.set_title("Montmort 1708")
ax = axes[1]                                           # 일치 개수의 분포 → Poisson(1) (연습 4.7)
matches = np.array([(rng.permutation(52) == np.arange(52)).sum() for _ in range(40_000)])
kk = np.arange(7)
ax.bar(kk - 0.18, [np.mean(matches == k) for k in kk], width=0.36, color=C["data"], label="52 cards, simulated")
ax.bar(kk + 0.18, stats.poisson.pmf(kk, 1), width=0.36, color="none", edgecolor=C["ink"], ls="--", label="$e^{-1}/k!$")
ax.set_xlabel("number of matches k"); ax.set_ylabel("probability"); ax.legend(); ax.set_title("exactly k matches (Exercise 4.7)")
plt.tight_layout(); plt.show()
text
  ✓  n=1: 포함배제 공식 == 순열 1개 직접 열거
  ✓  n=2: 포함배제 공식 == 순열 2개 직접 열거
  ✓  n=3: 포함배제 공식 == 순열 6개 직접 열거
  ✓  n=4: 포함배제 공식 == 순열 24개 직접 열거
  ✓  n=5: 포함배제 공식 == 순열 120개 직접 열거
  ✓  n=6: 포함배제 공식 == 순열 720개 직접 열거
  ✓  n=7: 포함배제 공식 == 순열 5040개 직접 열거
  ✓  n=8: 포함배제 공식 == 순열 40320개 직접 열거
n= 4: p_n = 0.6250000000  시뮬레이션 0.6239  |p_n-(1-1/e)| = 7.1e-03 ≤ 1/(n+1)! = 8.3e-03
n=13: p_n = 0.6321205588  시뮬레이션 0.6287  |p_n-(1-1/e)| = 1.1e-11 ≤ 1/(n+1)! = 1.1e-11
n=52: p_n = 0.6321205588  시뮬레이션 0.6373  |p_n-(1-1/e)| = 0.0e+00 ≤ 1/(n+1)! = 2.3e-70
연습 4.6: 카드 4장의 완전 순열(하나도 안 맞음): ['2143', '2341', '2413', '3142', '3412', '3421', '4123', '4312', '4321']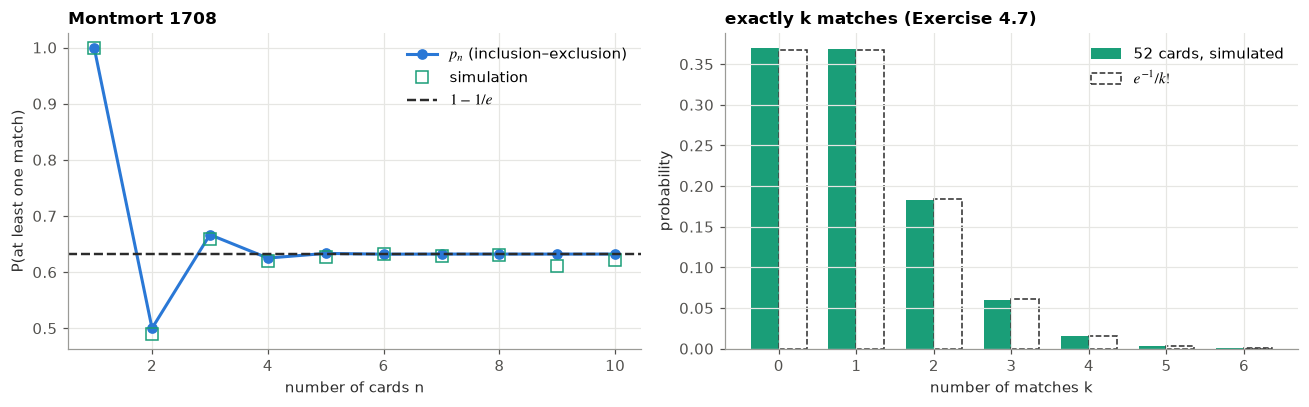
그림 읽기. 왼쪽: 근처에서 이미 와 구별되지 않는다. 오차가 로, 어떤 거듭제곱보다 빨리 준다. 오른쪽: 정확히 개가 맞을 확률은 이다(연습 4.7). Poisson 분포가 "드물고 거의 독립인 많은 사건의 개수"로 처음 등장하는 자리다. 4회에서 이항분포의 극한으로 다시 만난다.
4.5 확률의 연속성
정리 4.7. , .
예제 4.8. 처음 번이 모두 뒷면한 번도 앞면이 없음이므로 .
무한히 던질 수는 없으니, 길이 60의 수열을 많이 뽑아 이 을 따라 0으로 가는 것을 본다.
python
flips = rng.integers(0, 2, (N_SIM, 60))                  # 0 = 뒷면
first_head = np.where(flips.any(1), flips.argmax(1) + 1, 61)   # 처음 앞면이 나온 차례
for n in [1, 2, 5, 10, 15]:
    print(f"P(T_{n:<2d}) = P(처음 {n:2d}번 모두 뒷면):  시뮬레이션 {np.mean(first_head > n):.5f}   2^-n = {2.0**-n:.5f}")
text
P(T_1 ) = P(처음  1번 모두 뒷면):  시뮬레이션 0.49841   2^-n = 0.50000
P(T_2 ) = P(처음  2번 모두 뒷면):  시뮬레이션 0.25063   2^-n = 0.25000
P(T_5 ) = P(처음  5번 모두 뒷면):  시뮬레이션 0.03176   2^-n = 0.03125
P(T_10) = P(처음 10번 모두 뒷면):  시뮬레이션 0.00097   2^-n = 0.00098
P(T_15) = P(처음 15번 모두 뒷면):  시뮬레이션 0.00001   2^-n = 0.00003
4.6 이산 확률공간과 고전적 정의
정리 4.9 · 따름정리 4.10. 셀 수 있는 와 , 이면 는 확률이다. 균등하면 .
예제 4.11 (생일 문제). .
python
def birthday(n):
    return 1 - np.prod(1 - np.arange(n) / 365)

sim = lambda n: np.mean([len(set(b)) < n for b in rng.integers(0, 365, (20_000, n))])
for n in [10, 23, 50, 57]:
    print(f"n={n:2d}: 정확 {birthday(n):.4f}   하한 1-exp(-n(n-1)/730) = {1-np.exp(-n*(n-1)/730):.4f}   시뮬레이션 {sim(n):.4f}")
print("0.5를 넘는 첫 n:", next(n for n in range(1, 100) if birthday(n) > 0.5),
      "  0.99를 넘는 첫 n (연습 4.8):", next(n for n in range(1, 100) if birthday(n) > 0.99))

ns = np.arange(1, 81)
fig, ax = plt.subplots(figsize=(8, 3.8))
ax.plot(ns, [birthday(n) for n in ns], color=C["stat"], lw=2, label=r"exact $1-\prod_{i<n}(1-i/365)$")
ax.plot(ns, 1 - np.exp(-ns * (ns - 1) / 730), **THEORY, label=r"lower bound $1-e^{-n(n-1)/730}$")
ax.plot(ns[::6], [sim(n) for n in ns[::6]], "o", color=C["data"], ms=7, mfc="none", mew=1.5, label="simulation")
for n_, txt in [(23, "23 → 0.507"), (57, "57 → 0.990")]:
    ax.plot(n_, birthday(n_), "o", color=C["key"], ms=8)
    ax.annotate(txt, (n_, birthday(n_)), xytext=(10, -14), textcoords="offset points", fontsize=9)
ax.set_xlabel("number of people n"); ax.set_ylabel("P(shared birthday)"); ax.legend(loc="lower right")
ax.set_title("birthday problem: pairs grow like n²/2")
plt.tight_layout(); plt.show()
text
n=10: 정확 0.1169   하한 1-exp(-n(n-1)/730) = 0.1160   시뮬레이션 0.1162
n=23: 정확 0.5073   하한 1-exp(-n(n-1)/730) = 0.5000   시뮬레이션 0.5089
n=50: 정확 0.9704   하한 1-exp(-n(n-1)/730) = 0.9651   시뮬레이션 0.9687
n=57: 정확 0.9901   하한 1-exp(-n(n-1)/730) = 0.9874   시뮬레이션 0.9896
0.5를 넘는 첫 n: 23   0.99를 넘는 첫 n (연습 4.8): 57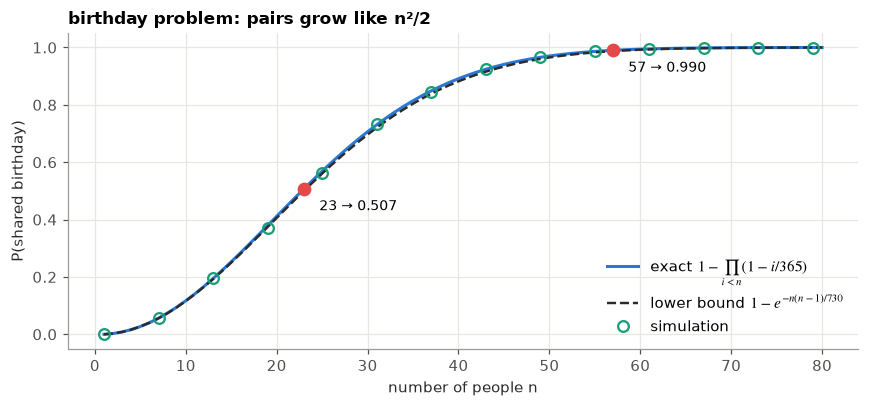
그림 읽기. 23명이면 쌍은 개다. 한 쌍이 같을 확률 에 253을 곱하면 이고, 쌍들이 "거의 독립"이라고 보면 이 된다. 직관이 틀리는 것은 사람 수 을 세기 때문이다. 확률을 움직이는 것은 쌍의 수 이다. 8.4절의 해시 충돌이 같은 계산이다.
📝 연습 4.1–4.11 (강의노트): De Morgan, σ-대수의 성질, 두 사건의 계산, 하트, Bonferroni 부등식(위의 부분합 표), 네 장의 짝 맞추기, 정확히 개(→ Poisson), 99%, 확률 1인 사건들, 합집합의 극한, 연속성 ⇒ 가산가법성.
5. 조건부확률과 독립
정의 5.1 · 정리 5.3 (곱셈법칙) · 정리 5.4 (전확률 공식) · 정리 5.5 (베이즈) .
오즈로 쓰면: 사후 오즈 = 가능도비 × 사전 오즈.
5.3 베이즈 정리로 푸는 두 문제
예제 5.6 (1) 진단검사. 유병률 1%, 민감도 0.9, 위양성률 0.09이면 . 다시 독립적으로 양성이면 .
python
def posterior(prior, sens=0.9, fpr=0.09):
    return prior * sens / (prior * sens + (1 - prior) * fpr)

n = 1_000_000
D = rng.random(n) < 0.01
test1 = np.where(D, rng.random(n) < 0.9, rng.random(n) < 0.09)
test2 = np.where(D, rng.random(n) < 0.9, rng.random(n) < 0.09)      # 같은 사람에게 독립적으로 한 번 더
report({
    "베이즈 공식 P(D|+) == 시뮬레이션 (오차 0.003)": abs(posterior(0.01) - D[test1].mean()) < 0.003,
    "두 번 양성: 사전확률을 갱신한 공식 == 시뮬레이션": abs(posterior(posterior(0.01)) - D[test1 & test2].mean()) < 0.01,
})
print(f"P(D|+) = {posterior(0.01):.4f} (sim {D[test1].mean():.4f}),  P(D|++) = {posterior(posterior(0.01)):.4f} (sim {D[test1 & test2].mean():.4f})")

# 연습 5.5: 유병률 0.1%에서 몇 번 연속 양성이어야 1/2을 넘나 — 오즈 × 10 씩
prior, k = 0.001, 0
while prior <= 0.5:
    prior, k = posterior(prior), k + 1
    print(f"  양성 {k}번 뒤: {prior:.4f}")

prev = np.logspace(-4, 0, 300)
fig, ax = plt.subplots(figsize=(8, 3.8))
for fpr_, col in [(0.09, C["key"]), (0.01, C["stat"]), (0.001, C["data"])]:
    ax.plot(prev, posterior(prev, fpr=fpr_), color=col, lw=2, label=f"sensitivity 0.9, false-positive rate {fpr_}")
ax.plot(0.01, posterior(0.01), "o", color=C["key"], ms=8)
ax.annotate("prevalence 1% → P(D|+) = 0.092", (0.01, posterior(0.01)), xytext=(12, -4), textcoords="offset points", fontsize=9)
ax.set_xscale("log"); ax.set_xlabel("prior P(D)  (prevalence)"); ax.set_ylabel("posterior P(D | +)")
ax.legend(fontsize=8, loc="upper left"); ax.set_title("the same test, different populations")
plt.tight_layout(); plt.show()
text
  ✓  베이즈 공식 P(D|+) == 시뮬레이션 (오차 0.003)
  ✓  두 번 양성: 사전확률을 갱신한 공식 == 시뮬레이션
P(D|+) = 0.0917 (sim 0.0920),  P(D|++) = 0.5025 (sim 0.4994)
  양성 1번 뒤: 0.0099
  양성 2번 뒤: 0.0910
  양성 3번 뒤: 0.5003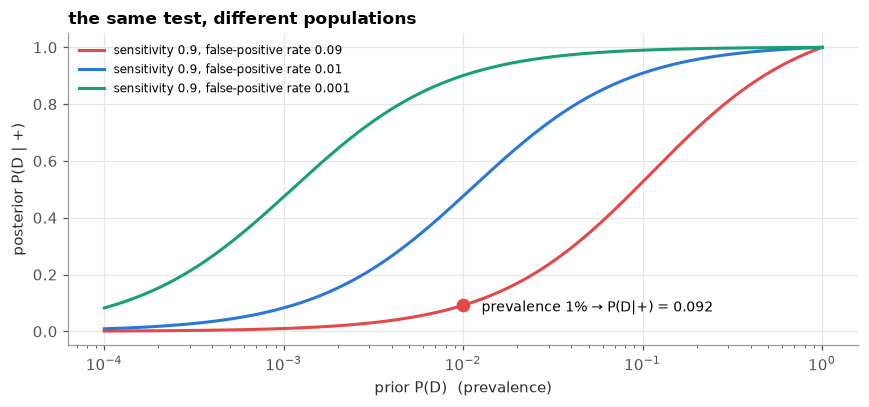
그림 읽기. 검사의 성능(민감도·위양성률)이 같아도 사후확률은 사전확률에 따라 0에서 1까지 움직인다. 오즈로 쓰면 이 곡선들은 로그-오즈 축에서 평행이동일 뿐이다. 양성 한 번이 오즈에 가능도비 을 곱하기 때문이다. 연습 5.5의 "양성 3번"은 근처의 사전 오즈를 배 해서 1 근처로 올리는 일이다.
예제 5.6 (2) Bertrand의 세 상자. 금화가 나왔을 때 다른 동전도 금화일 확률 .
연습 5.2 (Monty Hall, Selvin 1975). 사회자가 자동차 위치를 알고 염소 문을 열면 바꾸는 쪽이 . 사회자가 모르고 아무 문이나 열었는데 우연히 염소였다면 . 정보가 어떻게 만들어졌는가(가능도)가 답을 바꾼다.
python
n = N_SIM
# 세 상자: 0 = 금금, 1 = 은은, 2 = 금은
box = rng.integers(0, 3, n)
first_gold = np.where(box == 0, True, np.where(box == 1, False, rng.random(n) < 0.5))
print(f"세 상자: P(금금 | 금화) = {np.mean(box[first_gold] == 0):.4f}   (정확 2/3)")

# Monty Hall
car = rng.integers(0, 3, n)
pick = np.zeros(n, int)                                      # 참가자는 늘 0번 문
# (a) 아는 사회자: 0번이 아니고 자동차도 아닌 문을 연다 (둘이면 무작위)
opts = [[d for d in range(1, 3) if d != c] for c in car]
opened = np.array([o[rng.integers(len(o))] for o in opts])
switch = 3 - pick - opened
print(f"아는 사회자:  고수 {np.mean(car == pick):.4f}   바꿈 {np.mean(car == switch):.4f}")
# (b) 모르는 사회자: 1·2번 중 아무 문을 열고, 우연히 염소인 경우만 본다
opened_b = rng.integers(1, 3, n)
goat = opened_b != car
switch_b = 3 - opened_b
print(f"모르는 사회자 (염소가 나온 경우만): 고수 {np.mean(car[goat] == 0):.4f}   바꿈 {np.mean(car[goat] == switch_b[goat]):.4f}")
text
세 상자: P(금금 | 금화) = 0.6653 (정확 2/3)text
아는 사회자:  고수 0.3331   바꿈 0.6669
모르는 사회자 (염소가 나온 경우만): 고수 0.4996   바꿈 0.5004
5.4 독립
정의 5.7 · 정의 5.9 (상호 독립) 모든 부분 모임에서 곱 · 정리 5.11 상호 독립이면 여사건으로 바꿔도 상호 독립, .
예제 5.10 (Bernstein의 정사면체). 쌍마다 독립이지만 셋은 독립이 아니다.
python
faces = [{"R"}, {"G"}, {"B"}, {"R", "G", "B"}]            # 네 면, 같은 확률 1/4
Pr = lambda cond: Fraction(sum(cond(f) for f in faces), 4)
R, G, B_ = (lambda c: (lambda f: c in f))("R"), (lambda c: (lambda f: c in f))("G"), (lambda c: (lambda f: c in f))("B")
both = lambda *cs: (lambda f: all(c(f) for c in cs))
report({
    "P(RG) == P(R)P(G)": Pr(both(R, G)) == Pr(R) * Pr(G),
    "P(RB) == P(R)P(B)": Pr(both(R, B_)) == Pr(R) * Pr(B_),
    "P(GB) == P(G)P(B)": Pr(both(G, B_)) == Pr(G) * Pr(B_),
    "그러나 P(RGB) != P(R)P(G)P(B)": Pr(both(R, G, B_)) != Pr(R) * Pr(G) * Pr(B_),
})
print(f"P(RGB) = {Pr(both(R, G, B_))},  P(R)P(G)P(B) = {Pr(R) * Pr(G) * Pr(B_)}")

# 예제 5.12: 주사위 4번의 '6' 사건 A_1..A_4 가 상호 독립인지 216×6 = 1296 개 결과로 확인
Om4 = list(itertools.product(range(1, 7), repeat=4))
PA = lambda idx: Fraction(sum(all(o[i] == 6 for i in idx) for o in Om4), len(Om4))
report({f"P(A_{'A_'.join(str(i+1) for i in idx)}) == (1/6)^{len(idx)}": PA(idx) == Fraction(1, 6) ** len(idx)
        for k in range(2, 5) for idx in itertools.combinations(range(4), k)})
text
  ✓  P(RG) == P(R)P(G)
  ✓  P(RB) == P(R)P(B)
  ✓  P(GB) == P(G)P(B)
  ✓  그러나 P(RGB) != P(R)P(G)P(B)
P(RGB) = 1/4,  P(R)P(G)P(B) = 1/8
  ✓  P(A_1A_2) == (1/6)^2
  ✓  P(A_1A_3) == (1/6)^2
  ✓  P(A_1A_4) == (1/6)^2
  ✓  P(A_2A_3) == (1/6)^2
  ✓  P(A_2A_4) == (1/6)^2
  ✓  P(A_3A_4) == (1/6)^2
  ✓  P(A_1A_2A_3) == (1/6)^3
  ✓  P(A_1A_2A_4) == (1/6)^3
  ✓  P(A_1A_3A_4) == (1/6)^3
  ✓  P(A_2A_3A_4) == (1/6)^3
  ✓  P(A_1A_2A_3A_4) == (1/6)^4
5.5 점수 분배, 다시: Pascal의 재귀
정리 5.13. 전확률 공식을 "다음 판"으로 나눈 분할 에 쓰면 . 재귀와 경계조건이 를 하나로 정하고, Fermat의 공식도 같은 재귀를 만족하므로(연습 1.6) 두 답은 같다.
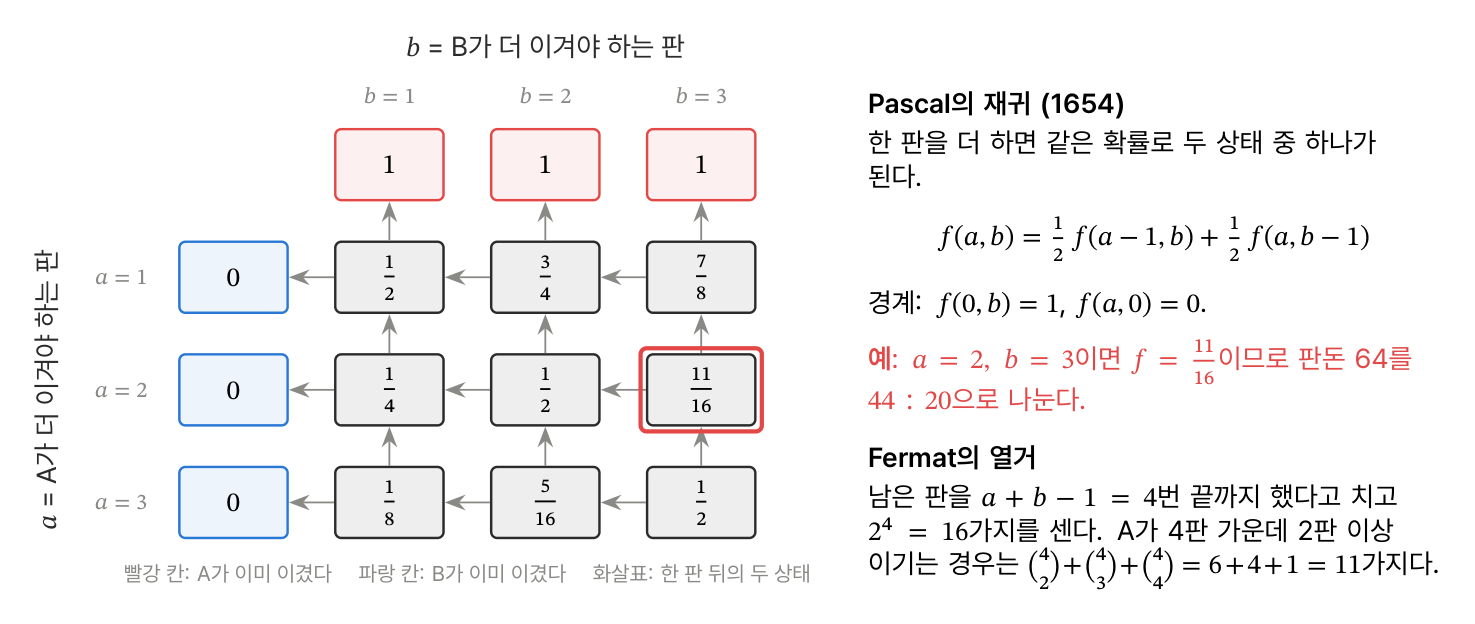
1.4절에서 열거·재귀·닫힌형이 같다는 것을 이미 확인했다. 여기서는 에서도 같은지, 그리고 그림의 표가 재귀로 채워지는지 본다.
python
p = Fraction(3, 5)
report({f"p=3/5, (a,b)={ab}: Pascal 재귀 == Fermat 열거": pascal(*ab, p) == fermat_enumerate(*ab, p)
        for ab in [(1, 1), (2, 3), (3, 2), (4, 4)]})
grid = pd.DataFrame([[str(pascal(a, b)) for b in range(1, 4)] for a in range(1, 4)],
                    index=[f"a={a}" for a in range(1, 4)], columns=[f"b={b}" for b in range(1, 4)])
grid
text
  ✓  p=3/5, (a,b)=(1, 1): Pascal 재귀 == Fermat 열거
  ✓  p=3/5, (a,b)=(2, 3): Pascal 재귀 == Fermat 열거
  ✓  p=3/5, (a,b)=(3, 2): Pascal 재귀 == Fermat 열거
✓ p=3/5, (a,b)=(4, 4): Pascal 재귀 == Fermat 열거| b=1 | b=2 | b=3 | |
|---|---|---|---|
| a=1 | 1/2 | 3/4 | 7/8 |
| a=2 | 1/4 | 1/2 | 11/16 |
| a=3 | 1/8 | 5/16 | 1/2 |
📝 연습 5.1–5.9 (강의노트): 두 아이, Monty Hall, 세 상자에서 은화, 양의 연관은 대칭, 몇 번 양성이어야 하나, 합집합과의 독립, 확률 0과 1, 독립 시행 모형, Simpson의 역설(아래).
python
kidney = pd.DataFrame({"treatment": ["A", "A", "B", "B"], "stone": ["small", "large", "small", "large"],
                       "success": [81, 192, 234, 55], "n": [87, 263, 270, 80]})
kidney["rate"] = (kidney.success / kidney.n).round(3)
print(kidney.to_string(index=False))
tot = kidney.groupby("treatment")[["success", "n"]].sum()
print("\n전체:", (tot.success / tot.n).round(3).to_dict(), " ← 크기마다 A가 낫지만 전체로는 B가 낫다")
share = kidney.pivot(index="treatment", columns="stone", values="n")
share = share.div(share.sum(axis=1), axis=0)
print("결석 크기의 비중 P(stone | treatment):\n", share.round(2))
rate = kidney.pivot(index="treatment", columns="stone", values="rate")
report({f"전확률 공식: 전체 성공률({t}) == Σ P(성공|크기,{t}) P(크기|{t})":
        math.isclose((rate.loc[t] * share.loc[t]).sum(), tot.success[t] / tot.n[t], abs_tol=2e-3) for t in "AB"})

# Baker–Kramer 그림: 전체 성공률 = 두 크기의 성공률을 '큰 결석의 비중'으로 내분한 점
fig, ax = plt.subplots(figsize=(8, 4))
w = np.linspace(0, 1, 2)
for t, col in [("A", C["stat"]), ("B", C["data"])]:
    ax.plot(w, rate.loc[t, "small"] * (1 - w) + rate.loc[t, "large"] * w, color=col, lw=2, label=f"treatment {t}")
    ax.plot(share.loc[t, "large"], tot.success[t] / tot.n[t], "o", color=col, ms=10, mec="white", mew=2)
    ax.annotate(f"{t}: overall {tot.success[t] / tot.n[t]:.3f}", (share.loc[t, "large"], tot.success[t] / tot.n[t]),
                xytext=(8, 8), textcoords="offset points", fontsize=9)
ax.set_xlabel("share of large stones  P(large | treatment)"); ax.set_ylabel("success rate")
ax.set_title("Simpson's paradox: A's line is above B's, but A treats mostly large stones")
ax.legend(); plt.tight_layout(); plt.show()
text
treatment stone  success   n  rate
        A small       81  87 0.931
        A large      192 263 0.730
        B small      234 270 0.867
        B large       55  80 0.688

전체: {'A': 0.78, 'B': 0.826}  ← 크기마다 A가 낫지만 전체로는 B가 낫다
결석 크기의 비중 P(stone | treatment):
 stone      large  small
treatment
A           0.75   0.25
B           0.23   0.77
  ✓  전확률 공식: 전체 성공률(A) == Σ P(성공|크기,A) P(크기|A)
  ✓  전확률 공식: 전체 성공률(B) == Σ P(성공|크기,B) P(크기|B)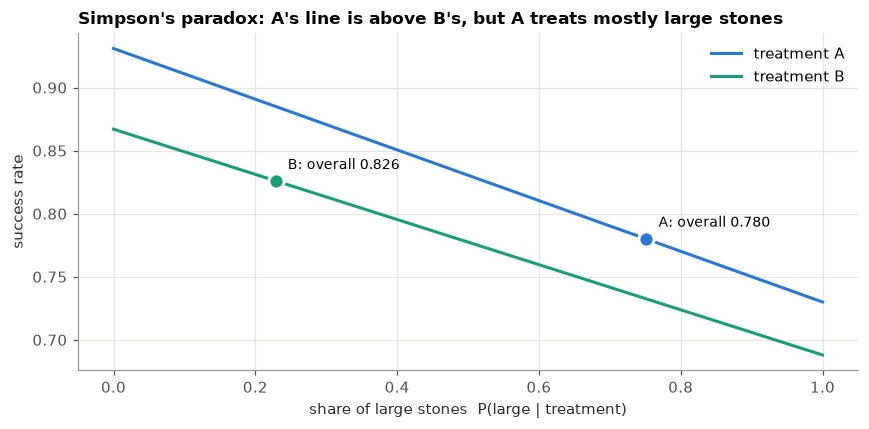
그림 읽기. 전확률 공식(정리 5.4) 때문에 각 처치의 전체 성공률은 자기 직선 위의 한 점이다. 그 점의 가로 위치는 "큰 결석의 비중"이다. A의 직선은 어디서나 B보다 위에 있다. 그런데 A는 오른쪽(큰 결석이 75%), B는 왼쪽(23%)에서 평가되므로 점의 높이가 뒤집힌다. 역설은 산수의 오류가 아니다. 비교하는 두 집단의 분할 비중이 다르다는 사실이 드러난 것이다. 이 문제는 14회 실험설계의 무작위 배정에서 다시 다룬다.
6. 확률변수와 분포함수
정의 6.1. 확률변수는 인 함수 다. 정의 6.2 .
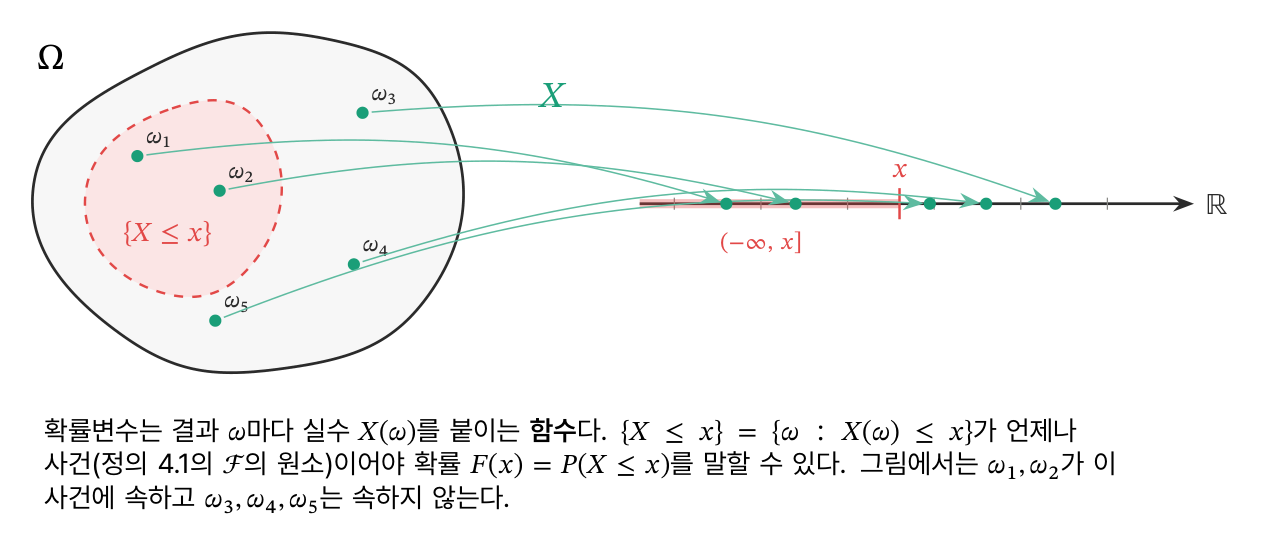
코드에서도 확률변수는 함수다. 결과 (여기서는 주사위 4번의 결과)를 받아 수를 돌려준다. 무작위성은 를 뽑는 쪽에 있다.
python
def K(omega):                       # 확률변수: 결과 → 6의 개수
    return int(np.sum(np.asarray(omega) == 6))

Om4 = list(itertools.product(range(1, 7), repeat=4))          # 균등한 1296개의 결과
pmf_exact = {k: Fraction(sum(K(o) == k for o in Om4), len(Om4)) for k in range(5)}
pmf_formula = {k: Fraction(math.comb(4, k) * 5 ** (4 - k), 6**4) for k in range(5)}
report({"예제 6.5: 열거한 pmf == C(4,k)(1/6)^k(5/6)^(4-k)": pmf_exact == pmf_formula,
        "Σ p(k) = 1": sum(pmf_exact.values()) == 1,
        "P(K ≥ 1) == de Méré 내기 1": 1 - pmf_exact[0] == 1 - Fraction(5, 6) ** 4})
print({k: round(float(v), 4) for k, v in pmf_exact.items()})
text
  ✓  예제 6.5: 열거한 pmf == C(4,k)(1/6)^k(5/6)^(4-k)
  ✓  Σ p(k) = 1
  ✓  P(K ≥ 1) == de Méré 내기 1
{0: 0.4823, 1: 0.3858, 2: 0.1157, 3: 0.0154, 4: 0.0008}
정리 6.3 (분포함수의 성질). (a) 비감소 (b) , (c) 오른쪽 연속 (d) , .
이산 확률변수의 분포함수는 계단이고, 계단의 높이가 그 점의 확률이다. 오른쪽 연속은 ""로 정의했기 때문이다. 아래에서 와 의 차이가 pmf와 같은지 본다.
python
xs_ = np.arange(5)
F = lambda x: sum(float(v) for k, v in pmf_exact.items() if k <= x)
eps = 1e-9
report({"정리 6.3(d): F(k) - F(k-) == P(K=k)": all(math.isclose(F(k) - F(k - eps), float(pmf_exact[k])) for k in xs_),
        "정리 6.3(c): F(k+ε) == F(k)": all(math.isclose(F(k + eps), F(k)) for k in xs_)})
text
  ✓  정리 6.3(d): F(k) - F(k-) == P(K=k)
  ✓  정리 6.3(c): F(k+ε) == F(k)
정의 6.6 · 정리 6.7. 연속 확률변수: . 그러면 , , 연속점에서 .
예제 6.8 (Bertrand 현의 길이, ).
3.1절의 chords()로 만든 현의 길이로 경험분포함수 를 그리고, 유도한 와 겹쳐 본다. Kolmogorov–Smirnov 거리 는 표본이 클수록 작아진다(7회).
python
Fs = {1: lambda l: 2 / np.pi * np.arcsin(l / 2),
      2: lambda l: 1 - np.sqrt(1 - l**2 / 4),
      3: lambda l: l**2 / 4}
fig, axes = plt.subplots(1, 2, figsize=(12, 3.8))
ll = np.linspace(0, 2, 400)
for m, col in zip([1, 2, 3], [C["stat"], C["data"], C["key"]]):
    L = np.sort(length(chords(m, 50_000)))
    ecdf = np.arange(1, L.size + 1) / L.size
    axes[0].step(L[::200], ecdf[::200], where="post", color=col, lw=3, alpha=0.6, label=f"method ({m}) empirical")
    axes[0].plot(ll, Fs[m](ll), **{**THEORY, "lw": 1.0})
    ks = stats.kstest(L, Fs[m])
    print(f"method ({m}): KS distance {ks.statistic:.4f}, p-value {ks.pvalue:.2f},  P(L>√3) = 1 - F(√3) = {1 - Fs[m](np.sqrt(3)):.4f}")
    axes[1].hist(L, bins=np.linspace(0, 2, 41), density=True, histtype="step", lw=1.6, color=col, label=f"method ({m})")
axes[0].set_xlabel("chord length ℓ"); axes[0].set_ylabel("F(ℓ)"); axes[0].legend(fontsize=8, loc="upper left")
axes[0].set_title("empirical cdf vs Example 6.8 (dashed)")
for f_ in [lambda l: 2 / (np.pi * np.sqrt(4 - l**2)), lambda l: l / (2 * np.sqrt(4 - l**2)), lambda l: l / 2]:
    axes[1].plot(ll[1:-1], f_(ll[1:-1]), **THEORY)
axes[1].set_ylim(0, 2.2); axes[1].set_xlabel("chord length ℓ"); axes[1].set_title("densities"); axes[1].legend(fontsize=8)
plt.tight_layout(); plt.show()
text
method (1): KS distance 0.0029, p-value 0.80, P(L>√3) = 1 - F(√3) = 0.3333text
method (2): KS distance 0.0025, p-value 0.92,  P(L>√3) = 1 - F(√3) = 0.5000
method (3): KS distance 0.0032, p-value 0.69,  P(L>√3) = 1 - F(√3) = 0.2500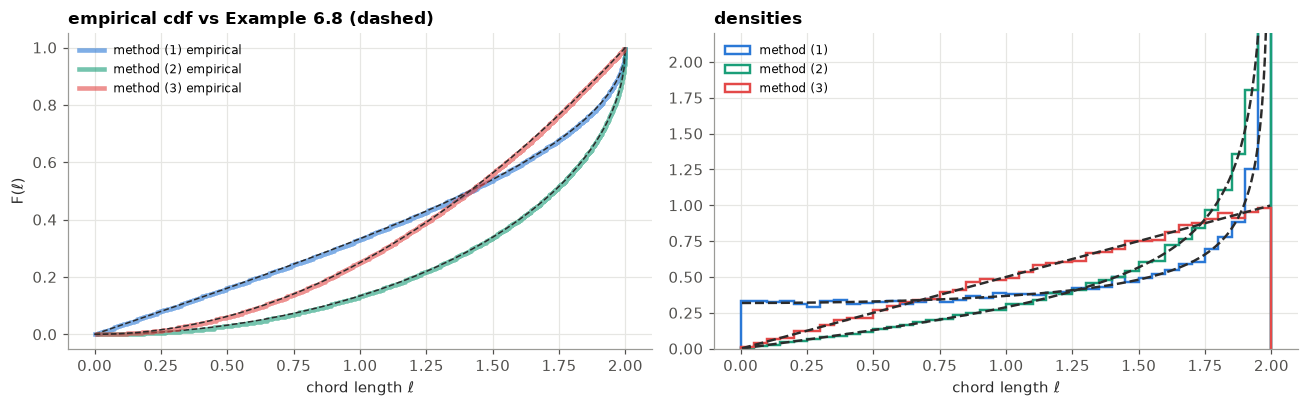
혼합형. 확률 으로 0, 나머지는 밀도 . 이산도 연속도 아니고, 분포함수가 0에서 만큼 뛴다(연습 6.3).
python
n = N_SIM
Xm = np.where(rng.random(n) < 0.3, 0.0, rng.exponential(1.0, n))
print(f"P(X=0) = {np.mean(Xm == 0):.4f} (0.3)   P(X≤1) = {np.mean(Xm <= 1):.4f} ({0.3+0.7*(1-np.exp(-1)):.4f})   "
      f"P(0<X≤1) = {np.mean((Xm > 0) & (Xm <= 1)):.4f} ({0.7*(1-np.exp(-1)):.4f})")
U = rng.random(n)
print(f"연습 6.7: X~U(0,1), Y=X²에서 P(Y ≤ 0.25) = {np.mean(U**2 <= 0.25):.4f}  (F_Y(y) = √y → 0.5)")
text
P(X=0) = 0.3005 (0.3)   P(X≤1) = 0.7417 (0.7425)   P(0<X≤1) = 0.4411 (0.4425)
연습 6.7: X~U(0,1), Y=X²에서 P(Y ≤ 0.25) = 0.4981  (F_Y(y) = √y → 0.5)
📝 연습 6.1–6.7 (강의노트): 분포함수에서 확률 읽기, 뛰는 점은 셀 수 있다, 혼합형, 죽는 나이, 세 방법의 중앙값, , 제곱의 분포.
7. 부숴보기 — 공리의 가정을 빼면
7.1 자연수 위에는 "균등한" 확률이 없다 (정리 7.1)
위의 균등 확률에서 로 보내면, 짝수의 확률은 로 가지만 한 점의 확률은 0으로 간다. 극한에 남는 것은 확률이 아니다. 한 점마다 0인데 모두 더하면 1이어야 하기 때문이다(가산가법성 위반). 극한으로 남는 "자연 밀도"는 유한가법성만 만족한다.
python
for N in [10, 1_000, 10**6]:
    print(f"N = {N:>8,}:  P({{1}}) = {1/N:.1e}   P(짝수) = {(N // 2)/N:.4f}   P(3의 배수) = {(N // 3)/N:.4f}   "
          f"Σ_k P({{k}}) over k ≤ N = 1   (극한에서는 Σ 0 = 0 ≠ 1)")
text
N =       10:  P({1}) = 1.0e-01   P(짝수) = 0.5000   P(3의 배수) = 0.3000   Σ_k P({k}) over k ≤ N = 1   (극한에서는 Σ 0 = 0 ≠ 1)
N =    1,000:  P({1}) = 1.0e-03   P(짝수) = 0.5000   P(3의 배수) = 0.3330   Σ_k P({k}) over k ≤ N = 1   (극한에서는 Σ 0 = 0 ≠ 1)
N = 1,000,000:  P({1}) = 1.0e-06   P(짝수) = 0.5000   P(3의 배수) = 0.3333   Σ_k P({k}) over k ≤ N = 1   (극한에서는 Σ 0 = 0 ≠ 1)
7.2 모든 부분집합에 확률을 줄 수는 없다 (Vitali, 1905)
정리 7.2. 의 모든 부분집합에 정의되고 회전에 불변인 확률은 없다. 증명은 선택공리로 만든 집합 의 유리수 회전 복사본 들이 을 셀 수 있게 분할한다는 데 있다. 는 컴퓨터로 만들 수 없는 집합이다(선택공리 없이는 존재조차 보일 수 없다). 그래서 이 절은 코드 대신 강의노트의 증명으로 본다. 결론: 원이나 구간 위에서는 사건의 모임을 Borel 집합으로 제한한다. 정의 4.1에서 를 따로 둔 이유다.
7.3 확률 0인 사건에 조건을 걸면
연속 확률변수에서 이므로 "일 때"는 정의 5.1로 말할 수 없다. 3회의 조건부 밀도가 이 문제를 다룬다.
📝 연습 7.1–7.2 (강의노트): 정수와 반직선, 자연 밀도.
8. Beautiful insights
8.1 시뮬레이션은 상대도수 해석이다
추정 는 대략 안에 떨어진다(2회 Chebyshev, 7회 CLT). 오차는 으로만 준다.
python
p4 = 1 - (5 / 6) ** 4
sizes = np.unique(np.logspace(1, 5, 25).astype(int))
inside = []
fig, ax = plt.subplots(figsize=(8, 3.8))
for nn in sizes:
    est = rng.binomial(nn, p4, 200) / nn
    inside.append(np.mean(np.abs(est - p4) <= 2 * np.sqrt(p4 * (1 - p4) / nn)))
    ax.plot(np.full(60, nn), est[:60], ".", color=C["data"], ms=2, alpha=0.5)
ax.plot(sizes, p4 + 2 * np.sqrt(p4 * (1 - p4) / sizes), **THEORY, label="p ± 2√(p(1-p)/n)")
ax.plot(sizes, p4 - 2 * np.sqrt(p4 * (1 - p4) / sizes), **THEORY)
ax.axhline(p4, color=C["key"], lw=1, label=f"p = {p4:.4f}")
ax.set_xscale("log"); ax.set_xlabel("number of simulated games n"); ax.set_ylabel("estimate"); ax.legend()
ax.set_title("Monte Carlo error shrinks like 1/√n")
plt.tight_layout(); plt.show()
print(f"띠 안에 든 비율 (크기별 200번): 평균 {np.mean(inside):.3f}   ← 7회에서 이 수가 약 0.95인 이유를 증명한다")
print(f"연습 8.1: 내기 2가 불리함을 보이려면 n ≈ {4*(1-(35/36)**24)*(35/36)**24/(0.5-(1-(35/36)**24))**2:,.0f} 번")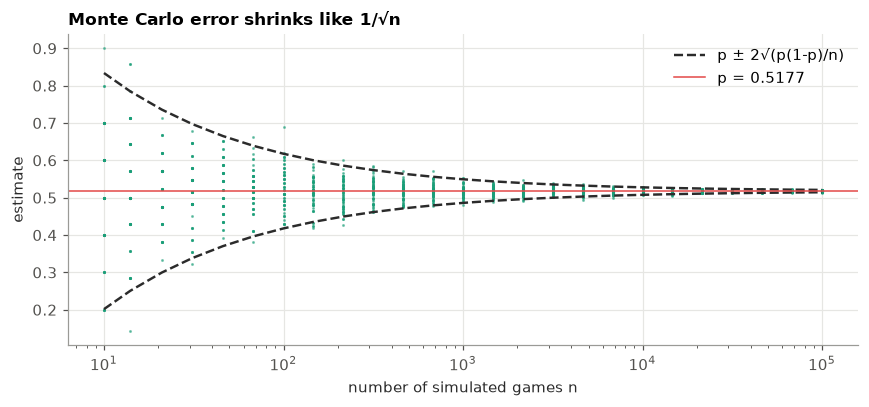
text
띠 안에 든 비율 (크기별 200번): 평균 0.960   ← 7회에서 이 수가 약 0.95인 이유를 증명한다
연습 8.1: 내기 2가 불리함을 보이려면 n ≈ 13,529 번
8.2 기저율 오류는 분류기의 precision이다
민감도 = 재현율(recall), = 정밀도(precision). 정밀도는 분류기만의 성질이 아니라 양성 비율에 의존한다. 같은 분류기를 양성 비율이 다른 데이터에 적용해 본다.
python
sens, fpr = 0.9, 0.09
for prev in [0.01, 0.1, 0.3]:
    n = 200_000
    y = rng.random(n) < prev
    yhat = np.where(y, rng.random(n) < sens, rng.random(n) < fpr)
    tp, fp = np.sum(y & yhat), np.sum(~y & yhat)
    print(f"양성 비율 {prev:4.0%}:  recall {np.sum(y & yhat)/y.sum():.3f}   precision {tp/(tp+fp):.3f}   (베이즈 정리 {posterior(prev):.3f})")
text
양성 비율   1%:  recall 0.916   precision 0.092   (베이즈 정리 0.092)
양성 비율  10%:  recall 0.901   precision 0.526   (베이즈 정리 0.526)
양성 비율  30%:  recall 0.901   precision 0.811   (베이즈 정리 0.811)
8.3 naive Bayes = 베이즈 정리 + 조건부 독립
python
prior_spam = 0.4
lik = {"무료": (0.30, 0.02), "회의": (0.01, 0.10)}       # (P(w|스팸), P(w|정상))
def p_spam(words):
    odds = prior_spam / (1 - prior_spam)
    for w in words:
        odds *= lik[w][0] / lik[w][1]
    return odds / (1 + odds)
print(f"'무료' → {p_spam(['무료']):.3f}    '무료' + '회의' → {p_spam(['무료', '회의']):.3f}   (연습 8.2)")
text
'무료' → 0.909 '무료' + '회의' → 0.500 (연습 8.2)8.4 생일 문제와 해시 충돌
비트 해시의 충돌 확률이 이 되는 입력 수는 이다. 20비트짜리 작은 "해시"(무작위 정수)로 확인한다.
python
k = 20
N_hash = 2**k
predicted = np.sqrt(2 * np.log(2)) * 2 ** (k / 2)
trials = []
for _ in range(2000):                           # 충돌이 처음 생길 때까지 넣은 개수
    seen, n = set(), 0
    while True:
        h = int(rng.integers(N_hash)); n += 1
        if h in seen:
            break
        seen.add(h)
    trials.append(n)
print(f"{k}비트: 충돌까지의 입력 수 중앙값 {np.median(trials):.0f}   예측 1.18·2^(k/2) = {predicted:.0f}")
print(f"64비트에서는 약 {np.sqrt(2*np.log(2))*2**32:,.0f}개면 충돌 확률이 1/2이다")
text
20비트: 충돌까지의 입력 수 중앙값 1186   예측 1.18·2^(k/2) = 1206
64비트에서는 약 5,056,937,541개면 충돌 확률이 1/2이다
9. 정리 · 연습문제 지도 · 다음 회
| 내용 | 확인한 셀 | |
|---|---|---|
| 셈의 원리 (1.1–1.7) | 순열·조합·Pascal·이항정리 | 1.2 열거 대조 |
| 점수 분배 (1.10, 5.13) | Fermat = Pascal = 닫힌형 = 시뮬레이션 | 1.4, 5.5 |
| 공리와 기본 성질 (4.2, 4.3) | 유한 확률공간 FiniteSpace |
4절 첫 셀 |
| 포함배제 (4.5) · Montmort (4.6) | 부분합, | 4.4 |
| 연속성 (4.7) | 4.5 | |
| 생일 문제 (4.11) | 정확 · 하한 · 시뮬레이션 | 4.6 |
| 베이즈 (5.5) | 진단검사 · 세 상자 · Monty Hall | 5.3 |
| 독립 (5.7–5.12) | Bernstein 정사면체 · 주사위 4번 | 5.4 |
| 분포함수 (6.3, 6.7) | 계단의 높이 = pmf, 현의 길이 ECDF | 6절 |
| 부숴보기 (7.1) | 위의 균등 확률 없음 | 7.1 |
연습문제 지도 (강의노트, ★ 계산 · ★★ 증명 · ★★★ 도전, 풀이는 부록 A)
| 절 | 연습 | 이 노트북에서 확인하는 셀 |
|---|---|---|
| 0 집합 | 0.1 De Morgan 증명 ★ (유도형) | 0.1 |
| 1 도박장 | 1.1 풀하우스 ★ · 1.2 로또 ★ · 1.3 Vandermonde ★★ · 1.4 Galileo 11·12 ★ · 1.5 한 개짜리 기준 ★ · 1.6 Fermat ⇒ Pascal ★★ · 1.7 ★ · 1.8 Pascal 항등식 증명 ★ · 1.9 이항정리 증명 ★★ (유도형) | 1.2, 1.3, 1.5 |
| 2 데이터 | 2.1 30대 ★ · 2.2 중앙값 ★ · 2.3 곱셈법칙 ★★ | 2.2 |
| 3 위기 | 3.1 반지름보다 긴 현 ★ · 3.2 ★ · 3.3 구 위의 점 ★★ | 3.3 |
| 4 공리 | 4.1–4.4 ★ · 4.5 Bonferroni ★★ · 4.6 네 장 ★ · 4.7 정확히 개 ★★ · 4.8 99% ★ · 4.9–4.10 ★★ · 4.11 연속성 ⇒ 가산가법성 ★★★ · 4.12 기본 성질 증명 ★★ (유도형) | 4.4, 4.6 |
| 5 조건부 | 5.1 두 아이 ★ · 5.2 Monty Hall ★★ · 5.3 ★ · 5.4 ★★ · 5.5 반복 검사 ★★ · 5.6 ★★ · 5.7 ★ · 5.8 독립 시행 ★★ · 5.9 Simpson ★★ · 5.10 조건부확률은 확률 ★ · 5.11 곱셈법칙 ★★ (유도형) | 5.3, 5.5 |
| 6 확률변수 | 6.1 ★ · 6.2 ★★ · 6.3 혼합형 ★ · 6.4 ★ · 6.5 ★★ · 6.6 ★★ · 6.7 제곱 ★★ · 6.8 밀도의 성질 증명 ★★ (유도형) | 6절 |
| 7 · 8 | 7.1 ★ · 7.2 ★★ · 8.1 ★ · 8.2 ★ | 7.1, 8.1, 8.3 |
다음 회 (2회) — 기댓값·부등식·대수의 법칙 (1657 → 1867). Huygens의 "기대 몫"을 확률변수의 기댓값으로 정의하고 분산과 적률생성함수를 세운다. 그리고 Jacob Bernoulli의 "황금정리": 동전을 몇 번 던지면 앞면의 비율을 "거의 확실하게" 알 수 있는가? 8.1절의 이 어디서 오는지가 그 답 안에 있다.
10. 워크북 검산
워크북(01_probability_workbook.pdf)의 문제는 손으로 먼저 푼다. 이 절은 다 푼 뒤에 쓴다.
check("A3", "1/2")— 문항 번호와 손으로 구한 답을 넣으면 맞는지만 알려 준다. 정답은 보여 주지 않는다. 답은 수(3/8,0.375)나 식의 문자열("(1-p)/(2-p)")로 넣는다. 소문항은"A11c"처럼 번호 뒤에 붙인다. 소수로 넣으면 상대오차 0.1%까지 맞다고 본다.- 시뮬레이션으로 한 번 더 — 확률이 답인 문항은 아래에 시뮬레이션 함수를 정의해 두었다. 손으로 구한 값이 Monte Carlo 구간 안에 드는지 본다. 함수는 정의만 해 두었고 부르지 않았다. 답을 구하기 전에 부르면 답이 보인다.
증명 문제(B, C의 대부분)는 check()가 없다. 풀이판의 증명과 단계별로 맞춰 본다.
답 열쇠 셀 (내려받은 노트북에서 실행된다)
답 열쇠를 압축해 넣은 check() 정의 셀이다. 웹에서는 이 회차의 답 확인 페이지를 쓴다.
python
check()                 # 확인할 수 있는 문항 번호
check("A3")             # 답을 넣지 않으면 쓰는 법을 알려 준다
text
확인할 수 있는 문항: A1 A2 A3 A4 A5a A5b A6 A7a A7b A8 A9a A9b A9c A10 A11a A11b A11c A11d A12a A12b A12c A13a A13b A14 C2c C5b C5c D1a D1c D2c D2d D3a D3b D3d D4b D4c
A3: 아직 답을 넣지 않았다. 예: check('A3', '3/8')
10.1 내 답을 모아 확인하기
푼 문항의 답을 아래 사전에 채우고 실행한다. None인 문항은 건너뛴다.
python
mine = {
    "A1": None, "A2": None, "A3": None, "A4": None, "A5a": None, "A5b": None,
    "A6": None, "A7a": None, "A7b": None, "A8": None, "A9a": None, "A9b": None, "A9c": None,
    "A10": None, "A11a": None, "A11b": None, "A11c": None, "A11d": None,
    "A12a": None, "A12b": None, "A12c": None, "A13a": None, "A13b": None, "A14": None,
    "C2c": None, "C5b": None, "C5c": None,
    "D1a": None, "D1c": None, "D2c": None, "D2d": None, "D3a": None, "D3b": None, "D3d": None, "D4b": None, "D4c": None,
}
check_all(mine)
text
0/0 맞음10.2 시뮬레이션 함수
각 함수는 (추정값, 표준오차)를 돌려준다. 손으로 구한 값이 추정값 ± 3 × 표준오차 안에 들면 계산이 맞을 가능성이 높다. 정확한 검산은 check()가 한다.
| 함수 | 문항 | 시뮬레이션 |
|---|---|---|
sim_A3() |
A3 세 주사위의 합 | 주사위 3개 |
sim_A5(n) |
A5 모든 눈이 나올 확률 | 주사위 번 |
sim_A13(p) |
A13 처음 앞면이 짝수 번째 | 기하분포 |
sim_C5() |
C5 조건부 독립 | 동전 고르기 → 두 번 던지기 |
sim_D1(N, k) |
D1 Banach의 성냥갑 | 주머니 고르기 |
sim_D2(p, i, N) |
D2 도박꾼의 파산 | 무작위 걸음 |
sim_D4() |
D4 크랩스 | 게임 전체 |
python
def sim_A3(n=N_SIM):
    return mc_prob(lambda n: rng.integers(1, 7, size=(n, 3)).sum(axis=1) <= 10, n)


def sim_A5(throws, n=N_SIM):
    def event(n):
        faces = rng.integers(1, 7, size=(n, throws))
        return np.all([(faces == f).any(axis=1) for f in range(1, 7)], axis=0)
    return mc_prob(event, n)


def sim_A13(p, n=N_SIM):
    return mc_prob(lambda n: rng.geometric(p, size=n) % 2 == 0, n)


def sim_C5(n=N_SIM):
    """(P(H1H2), P(H2 | H1))의 추정. 두 번째 값의 표준오차는 조건부 표본 수로 계산한다"""
    pc = np.where(rng.random(n) < 0.5, 0.9, 0.1)
    h1, h2 = rng.random(n) < pc, rng.random(n) < pc
    both = (h1 & h2).mean()
    cond = h2[h1].mean()
    return (both, np.sqrt(both * (1 - both) / n)), (cond, np.sqrt(cond * (1 - cond) / h1.sum()))


def sim_D1(N, k, n=N_SIM):
    """빈 갑을 발견할 때 다른 갑에 k개가 남을 확률"""
    def event(n):
        picks = rng.random((n, 2 * N + 1)) < 0.5          # True = 왼쪽
        left = np.cumsum(picks, axis=1)
        right = np.cumsum(~picks, axis=1)
        # 왼쪽(또는 오른쪽)을 N+1번째로 고르는 순간이 발견이다
        tL = np.argmax(left == N + 1, axis=1).astype(float)
        tL[left[:, -1] < N + 1] = np.inf
        tR = np.argmax(right == N + 1, axis=1).astype(float)
        tR[right[:, -1] < N + 1] = np.inf
        firstL = tL < tR
        t = np.where(firstL, tL, tR).astype(int)
        rows = np.arange(n)
        remain = np.where(firstL, N - right[rows, t], N - left[rows, t])
        return remain == k
    return mc_prob(event, n)


def sim_D2(p, i, N, n=40_000):
    """N원에 먼저 닿을 확률. 걸음을 한꺼번에 벡터로 진행한다"""
    x = np.full(n, i)
    alive = np.ones(n, dtype=bool)
    while alive.any():
        step = np.where(rng.random(alive.sum()) < p, 1, -1)
        x[alive] += step
        alive &= (x > 0) & (x < N)
    return mc_prob(lambda m: x == N, n)


def sim_D4(n=N_SIM):
    def roll(m):
        return rng.integers(1, 7, size=m) + rng.integers(1, 7, size=m)
    def event(n):
        first = roll(n)
        win = np.isin(first, [7, 11])
        point = ~np.isin(first, [2, 3, 7, 11, 12])
        pending = point.copy()
        while pending.any():
            r = roll(pending.sum())
            idx = np.flatnonzero(pending)
            win[idx[r == first[idx]]] = True
            pending[idx[(r == first[idx]) | (r == 7)]] = False
        return win
    return mc_prob(event, n)
python
# 자체 검사 (출력 없음): 시뮬레이션이 답 열쇠와 맞는지, check()가 답 열쇠의 값과 그 소수를 맞다고 하는지 확인한다.
def _close(sim, key, z=4.0, **pt):
    est, se = sim
    return abs(est - _value(key, **pt)) <= z * se + 1e-12

assert _close(sim_A3(), "A3")
assert _close(sim_A5(10), "A5b")
assert _close(sim_A13(0.3), "A13a", p=0.3)
(both, se1), (cond, se2) = sim_C5()
assert abs(both - _value("C5b")) <= 4 * se1 and abs(cond - _value("C5c")) <= 4 * se2
assert _close(sim_D1(5, 0), "D1c")
assert _close(sim_D2(0.4, 5, 10), "D2d")
assert _close(sim_D4(), "D4c")
for _k, _e in _WB.items():
    assert _same(_e, _e["value"])
    if not _e.get("vars") and "points" not in _e:
        assert _same(_e, float(sp.sympify(_e["value"])))