
테마
노트북 · 2회 · 기댓값·부등식·대수의 법칙
기댓값과 대수의 법칙 몇 번 던져야 아는가
| 강의노트 | 02_expectation_notes.pdf — 같은 절 번호, 같은 정리 번호. 증명은 노트에, 확인은 여기에 |
| 워크북 | 02_expectation_workbook.pdf — 손으로 푸는 34문항. 다 푼 뒤 맨 끝 10절의 check()로 검산 |
| 원자료 | Weldon(1894)의 주사위 26,306번 (R 패키지 vcd) · Arbuthnot(1710)의 런던 세례 기록 82년 · Halley(1693)의 생명표 (HistData) |
| 선수 지식 | 1회 전체 (확률의 공리, 독립, 확률변수와 분포함수), 급수와 이상적분 |
여는 질문. 항아리에 흰 돌 3,000개와 검은 돌 2,000개가 들어 있다. 돌을 하나 꺼내 색을 보고 다시 넣기를 되풀이한다. 몇 번 꺼내면 "흰 돌의 비율이 과 사이에 든다"는 쪽에 1,000 대 1로 걸 수 있는가?
Jacob Bernoulli(1713)의 답은 25,550번이었다. 정확한 답은 약 6,500번이다. 6절에서 다섯 가지 방법으로 답하고, 차이가 어디서 오는지 본다.
이번 회차의 지도
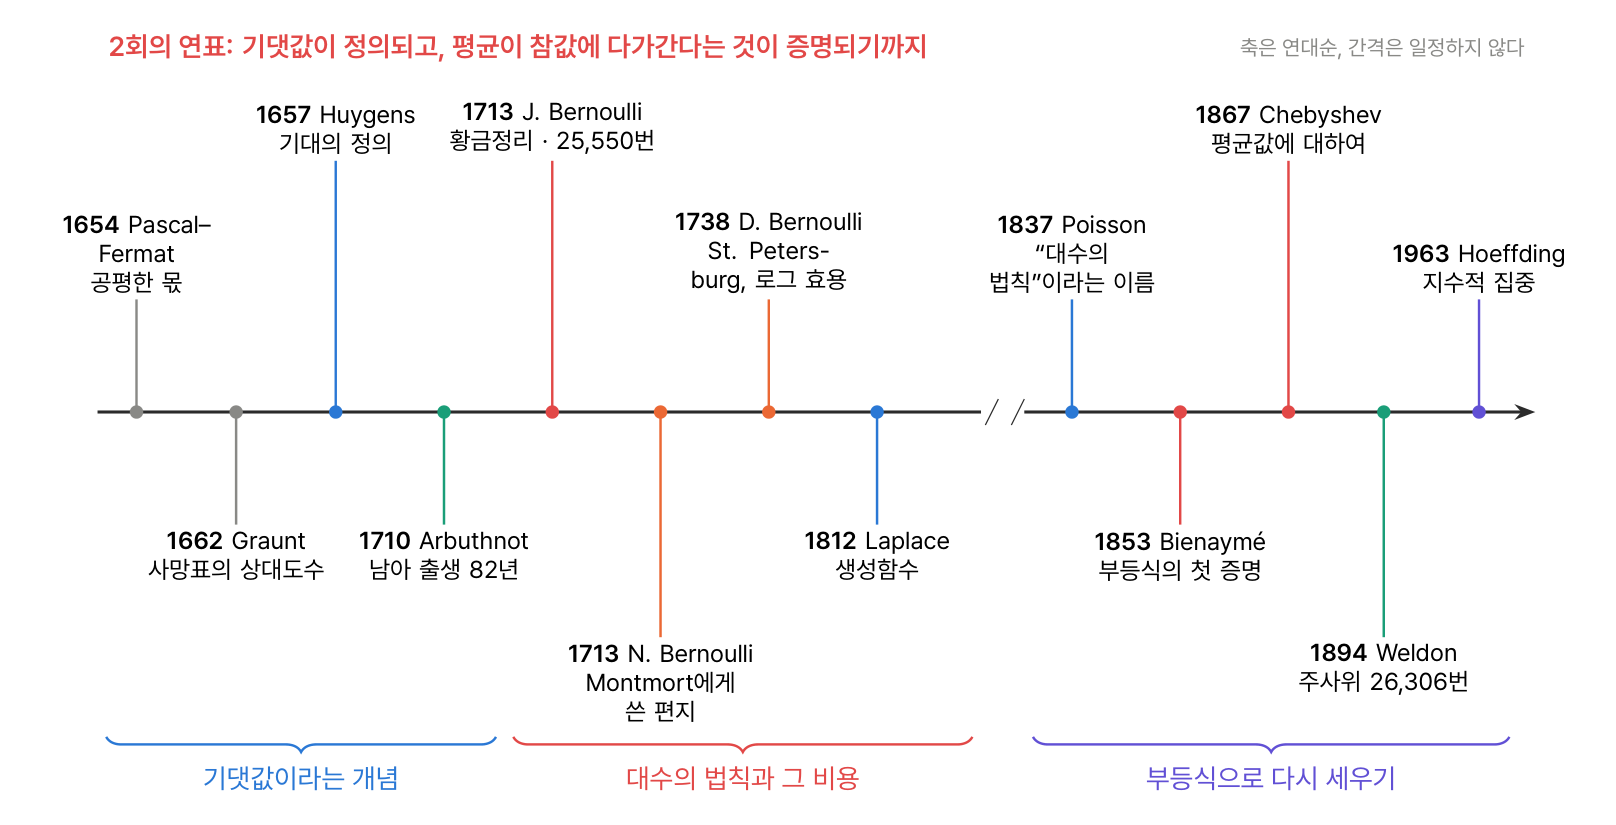
학습 목표
- 기댓값을 합과 적분으로 계산하고, 절대수렴하지 않으면 왜 기댓값이 없는지 수치로 본다.
- 함수의 기댓값·선형성·꼬리 공식을 지시변수와 시뮬레이션으로 확인한다.
- 분산·적률·mgf를 직접 구현해 scipy와 대조하고, 독립합의 분산과 mgf의 곱셈을 확인한다.
- 역변환 표집을 구현해 균등 난수 하나로 여러 분포를 만든다.
- Markov·Chebyshev·Jensen 부등식이 실제 확률과 얼마나 차이 나는지 본다.
- Bernoulli의 질문에 다섯 가지로 답하고, Weldon과 Arbuthnot의 자료에 대수의 법칙을 쓴다.
정리 지도 — 화살표는 "증명에 쓰인다"는 뜻이다.
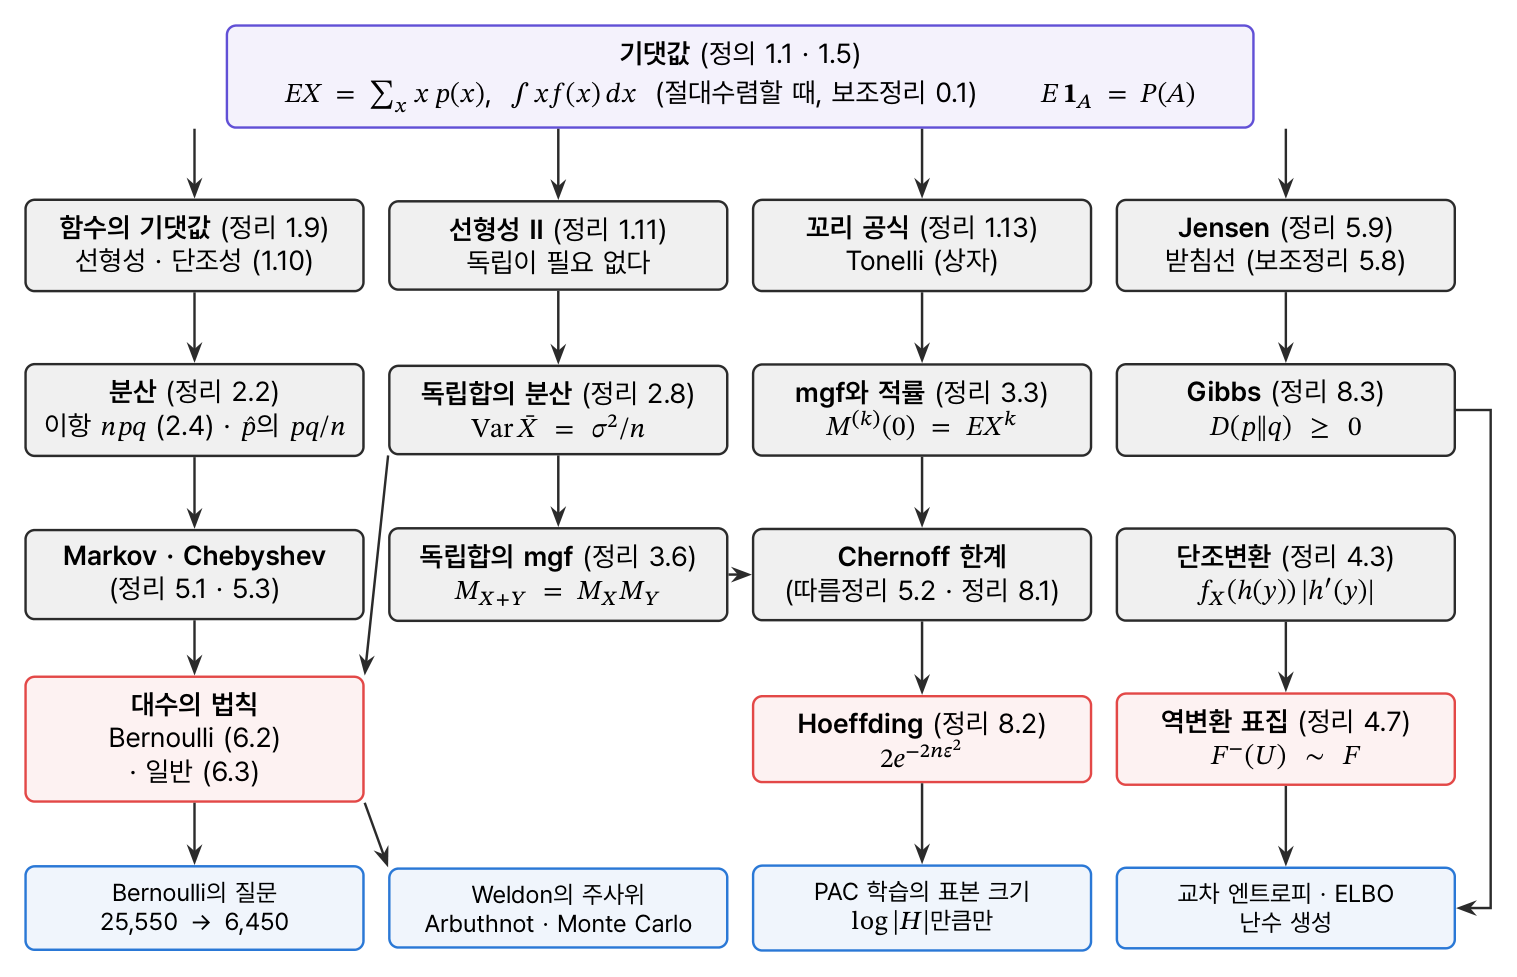
읽는 법. 각 절은 역사 → 정리 → 코드로 확인 → 📝 연습 순서다. 증명은 강의노트에 있고, 여기서는 정리가 말하는 것을 숫자와 시뮬레이션으로 확인한다. 📝 표시의 번호는 강의노트의 연습문제 번호다.
0. 설정
맨 위에 설정을 모은다. report()는 이론과 계산을 대조한 결과를 ✓/✗ 표로 보여 준다. 이번 회차의 중심 도구는 아래의 DiscreteRV 클래스다. 값과 확률만 주면 기댓값(정리 1.9), 분산(정리 2.2), mgf(정의 3.1), 분포함수, 역변환 표집(정리 4.7)을 모두 한 곳에서 계산한다. 직접 구현하고 scipy와 맞춰 보는 것이 이 노트북의 기본 리듬이다.
python
%matplotlib inline
import itertools
import math
from fractions import Fraction
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import integrate, optimize, stats

SEED = 2026
N_SIM = 200_000
rng = np.random.default_rng(SEED)

C = dict(data="#1a9e78", stat="#2a78d6", key="#e34948", assume="#eb6834",
         theta="#6250d6", ink="#2b2b2b", hist="#8a8a86", grid="#e6e6e3")
SERIES = [C["stat"], C["data"], C["key"], C["theta"]]      # 범주 색은 이 순서로만
THEORY = dict(color=C["ink"], ls="--", lw=1.6)
plt.rcParams.update({
    "figure.dpi": 110, "figure.figsize": (8, 4.2), "mathtext.fontset": "stix",
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.grid": True, "grid.color": C["grid"], "grid.linewidth": 0.8,
    "axes.edgecolor": "#9a9a96", "axes.labelcolor": C["ink"],
    "xtick.color": "#52514e", "ytick.color": "#52514e",
    "axes.titleweight": "bold", "axes.titlesize": 11, "axes.titlelocation": "left",
    "legend.frameon": False, "lines.linewidth": 2,
})

RDATASETS = "https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/master/csv/{}/{}.csv"
DATA_DIR = Path("../../data") if Path("../../.git").exists() else Path("data")

def load_rdata(item, package="HistData"):
    """Rdatasets 원자료: 로컬 캐시 → 없으면 받아서 캐시"""
    path = DATA_DIR / (f"{item}.csv" if package == "HistData" else f"{package}_{item}.csv")
    if not path.exists():
        DATA_DIR.mkdir(parents=True, exist_ok=True)
        pd.read_csv(RDATASETS.format(package, item)).drop(columns="rownames").to_csv(path, index=False)
    return pd.read_csv(path)

def report(checks):
    for name, ok in checks.items():
        print(f"  {'✓' if ok else '✗'}  {name}")
    assert all(checks.values()), "대조 실패"
python
class DiscreteRV:
    """값 x_i 와 확률 p_i 로 정한 이산 확률변수 (유한 개의 값)"""
    def __init__(self, values, probs):
        order = np.argsort(values)
        self.x = np.asarray(values, float)[order]
        self.p = np.asarray(probs, float)[order]
        assert np.all(self.p >= 0) and np.isclose(self.p.sum(), 1), "확률질량함수가 아니다"

    def E(self, g=lambda x: x):            # 정리 1.9: E g(X) = Σ g(x) p(x)
        return float(np.sum(g(self.x) * self.p))

    @property
    def mean(self):
        return self.E()

    @property
    def var(self):                          # 정의 2.1
        return self.E(lambda x: (x - self.mean) ** 2)

    def mgf(self, t):                       # 정의 3.1
        t = np.atleast_1d(t)
        return np.exp(np.outer(t, self.x)) @ self.p

    def cdf(self, q):                       # 1회 정의 6.2
        return np.array([self.p[self.x <= v].sum() for v in np.atleast_1d(q)])

    def sample(self, n, rng=rng):           # 정리 4.7(a), 알고리즘 4.8: F^-(U)
        return self.x[np.searchsorted(np.cumsum(self.p), rng.random(n))]

    def __add__(self, other):               # 독립합 (2.3절): 모든 값의 쌍을 곱한 확률로
        xs = np.add.outer(self.x, other.x).ravel()
        ps = np.multiply.outer(self.p, other.p).ravel()
        u, inv = np.unique(np.round(xs, 12), return_inverse=True)
        return DiscreteRV(u, np.bincount(inv, weights=ps))

die = DiscreteRV(range(1, 7), [1 / 6] * 6)
report({"주사위 E X = 3.5": math.isclose(die.mean, 3.5),
        "주사위 Var X = 35/12 (예제 2.3)": math.isclose(die.var, 35 / 12),
        "scipy randint 와 같은 평균·분산": np.allclose([die.mean, die.var], stats.randint(1, 7).stats("mv"))})
text
  ✓  주사위 E X = 3.5
  ✓  주사위 Var X = 35/12 (예제 2.3)
  ✓  scipy randint 와 같은 평균·분산
0.2 절대수렴 (보조정리 0.1)
는 조건수렴한다. 같은 항을 "양수 둘, 음수 하나" 순서로 더하면 가 된다(연습 0.1). 순서에 따라 값이 바뀌는 합은 기댓값이 될 수 없다. 이것이 정의 1.1에 절대수렴 조건이 붙는 이유다.
python
def alternating_harmonic(n_terms, pos_per_neg=1):
    """양수 항(1, 1/3, 1/5, …) pos_per_neg 개마다 음수 항(-1/2, -1/4, …) 하나"""
    s, odd, even, out = 0.0, 1, 2, []
    while len(out) < n_terms:
        for _ in range(pos_per_neg):
            s += 1 / odd; odd += 2; out.append(s)
        s -= 1 / even; even += 2; out.append(s)
    return np.array(out[:n_terms])

a = alternating_harmonic(300_000, 1)
b = alternating_harmonic(300_000, 2)
print(f"보통 순서:        {a[-1]:.5f}   (log 2 = {math.log(2):.5f})")
print(f"양수 둘, 음수 하나: {b[-1]:.5f}   (1.5 log 2 = {1.5 * math.log(2):.5f})")
report({"재배열하면 합이 바뀐다 (연습 0.1)": abs(b[-1] - 1.5 * math.log(2)) < 1e-4 and abs(a[-1] - math.log(2)) < 1e-4})
text
보통 순서:        0.69315   (log 2 = 0.69315)
양수 둘, 음수 하나: 1.03972   (1.5 log 2 = 1.03972)
  ✓  재배열하면 합이 바뀐다 (연습 0.1)
1. Huygens의 기대 — 기댓값
Huygens(1657) 명제 I. "나 를 같은 정도로 쉽게 얻을 수 있다면, 그 기대는 의 값어치가 있다." 근거는 확률이 아니라 공평한 내기다. 둘이 씩 걸고 이긴 쪽이 진 쪽에게 를 주면, 나는 아니면 를 받는다.
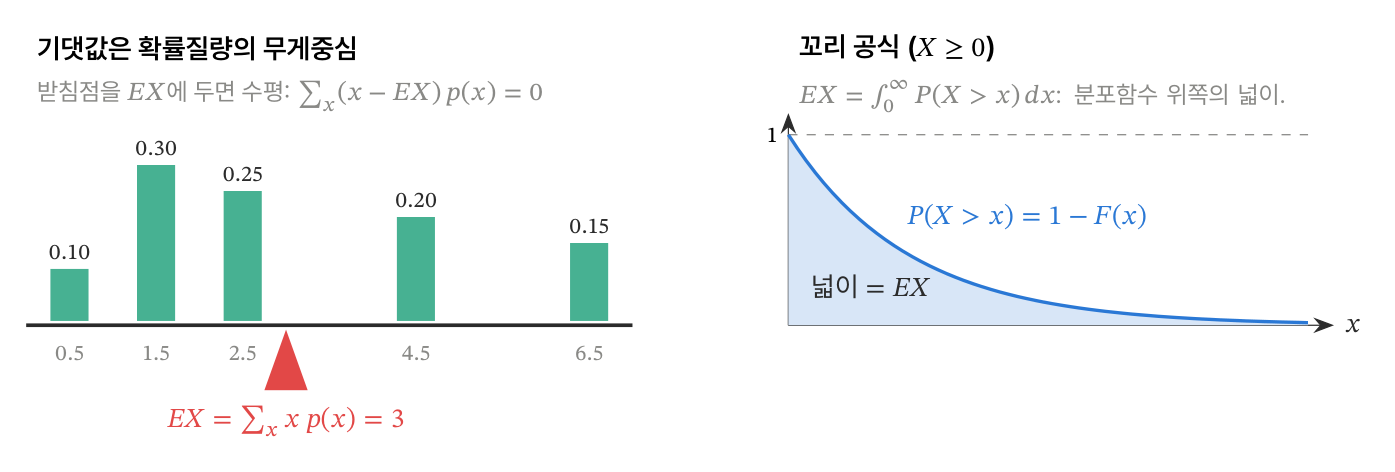
1.2 이산 확률변수의 기댓값
정의 1.1 (일 때) · 예제 1.2 · 예제 1.4 기하분포 .
Huygens의 공평한 내기를 시뮬레이션한다. 를 내고 들어간 사람이 받는 돈의 평균이 정말 인지, 그리고 de Méré의 두 내기의 기대 이익을 본다.
python
a_, b_ = 10, 50
coin = rng.random(N_SIM) < 0.5
received = np.where(coin, b_, a_)               # 이기면 판돈 a+b 에서 a 를 주고 b, 지면 a
print(f"Huygens 명제 I: 받는 돈의 평균 {received.mean():.3f}   (a+b)/2 = {(a_ + b_) / 2}")

bet1 = DiscreteRV([-1, 1], [1 - 671 / 1296, 671 / 1296])
bet2 = DiscreteRV([-1, 1], [(35 / 36) ** 24, 1 - (35 / 36) ** 24])
indicator = DiscreteRV([0, 1], [1 - 0.3, 0.3])
report({
    "예제 1.2: E 1_A = P(A)": math.isclose(indicator.mean, 0.3),
    "예제 1.2: de Méré 내기 1의 기대 이익 2·671/1296 - 1": math.isclose(bet1.mean, 2 * 671 / 1296 - 1),
    "예제 1.3: 점수 분배 (1,3) — 64 × 7/8 = 56": math.isclose(DiscreteRV([0, 64], [1 / 8, 7 / 8]).mean, 56),
})
print(f"내기 1: {bet1.mean:+.4f}   내기 2: {bet2.mean:+.4f}   (판돈 1당 기대 이익)")
text
Huygens 명제 I: 받는 돈의 평균 30.089   (a+b)/2 = 30.0
  ✓  예제 1.2: E 1_A = P(A)
  ✓  예제 1.2: de Méré 내기 1의 기대 이익 2·671/1296 - 1
  ✓  예제 1.3: 점수 분배 (1,3) — 64 × 7/8 = 56
내기 1: +0.0355   내기 2: -0.0172   (판돈 1당 기대 이익)
python
# 예제 1.4: 기하분포 — 평균 1/p, 중앙값 ≈ log 2 / p
fig, axes = plt.subplots(1, 2, figsize=(12, 3.8))
for ax, p_, name in zip(axes, [1 / 6, 1 / 36], ["one six", "double six"]):
    X = rng.geometric(p_, N_SIM)
    k = np.arange(1, int(6 / p_))
    ax.bar(k, stats.geom.pmf(k, p_), color=C["data"], width=1.0, alpha=0.8)
    ax.axvline(1 / p_, color=C["key"], lw=2, label=f"mean 1/p = {1 / p_:.0f}  (sim {X.mean():.2f})")
    ax.axvline(np.median(X), color=C["stat"], lw=2, ls=":", label=f"median = {np.median(X):.0f}  (log2/p = {math.log(2) / p_:.1f})")
    ax.set_xlabel("trials until first success"); ax.set_title(f"geometric: waiting for {name}"); ax.legend(fontsize=9)
plt.tight_layout(); plt.show()
report({"예제 1.4: E X = 1/p (scipy)": all(math.isclose(stats.geom(p_).mean(), 1 / p_) for p_ in [1 / 6, 1 / 36])})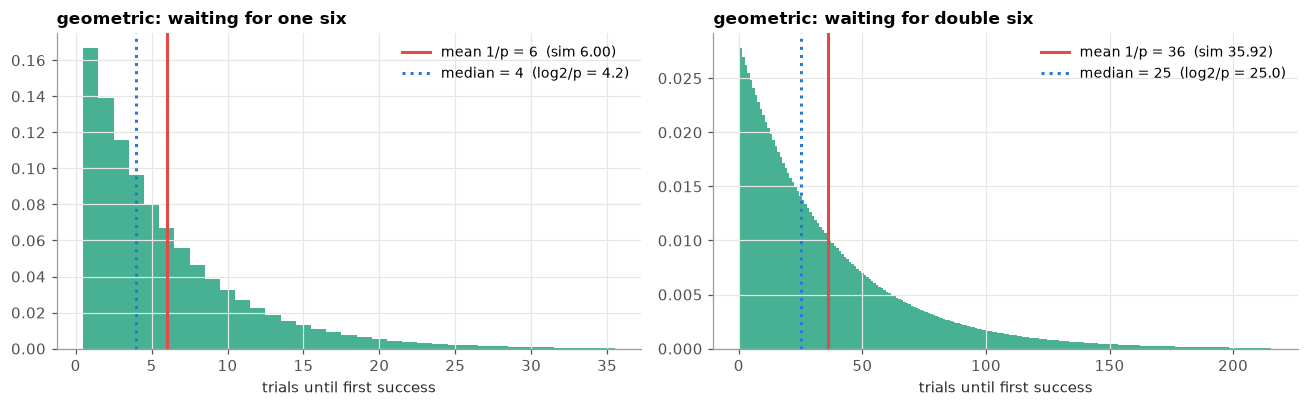
text
✓ 예제 1.4: E X = 1/p (scipy)그림 읽기. 기하분포는 오른쪽 꼬리가 길다. 드물게 아주 오래 기다리는 경우가 평균을 중앙값보다 오른쪽으로 끌어간다. de Méré가 1회에서 따진 "반 이상의 확률로 성공하는 횟수"는 중앙값 쪽이다. 평균과 중앙값은 서로 다른 질문의 답이다.
1.3 연속 확률변수의 기댓값
정의 1.5 · 예제 1.7 Bertrand의 세 현의 평균 · 예제 1.8 Cauchy는 기댓값이 없다.
적분(scipy.integrate.quad)과 시뮬레이션 두 가지로 계산한다. 현은 1회 3.1절의 세 방법을 다시 구현한다.
python
def chord_length(method, n):
    """1회 3.1절: 반지름 1인 원에서 세 가지 '무작위 현'의 길이"""
    if method == 1:                              # 두 끝점의 중심각 차이
        return 2 * np.abs(np.sin(rng.uniform(0, np.pi, n)))
    d = rng.uniform(0, 1, n) if method == 2 else np.sqrt(rng.uniform(0, 1, n))
    return 2 * np.sqrt(1 - d**2)

exact = {1: 4 / np.pi, 2: np.pi / 2, 3: 4 / 3}
dens = {1: lambda l: 2 / (np.pi * np.sqrt(4 - l**2)), 2: lambda l: l / (2 * np.sqrt(4 - l**2)), 3: lambda l: l / 2}
checks = {}
for m in [1, 2, 3]:
    by_integral = integrate.quad(lambda l: l * dens[m](l), 0, 2)[0]
    by_sim = chord_length(m, N_SIM).mean()
    print(f"방법 ({m}): ∫ ℓ f(ℓ) dℓ = {by_integral:.4f}   시뮬레이션 {by_sim:.4f}   정확 {exact[m]:.4f}")
    checks[f"예제 1.7 방법 ({m}): 적분 == 정확한 값"] = math.isclose(by_integral, exact[m], rel_tol=1e-6)
checks["예제 1.6: Exp(λ=2)의 평균 1/λ (적분)"] = math.isclose(integrate.quad(lambda x: x * 2 * np.exp(-2 * x), 0, np.inf)[0], 0.5)
report(checks)
text
방법 (1): ∫ ℓ f(ℓ) dℓ = 1.2732   시뮬레이션 1.2749   정확 1.2732
방법 (2): ∫ ℓ f(ℓ) dℓ = 1.5708   시뮬레이션 1.5697   정확 1.5708
방법 (3): ∫ ℓ f(ℓ) dℓ = 1.3333   시뮬레이션 1.3334   정확 1.3333
  ✓  예제 1.7 방법 (1): 적분 == 정확한 값
  ✓  예제 1.7 방법 (2): 적분 == 정확한 값
  ✓  예제 1.7 방법 (3): 적분 == 정확한 값
  ✓  예제 1.6: Exp(λ=2)의 평균 1/λ (적분)
python
# 예제 1.8: Cauchy — 자르는 방법에 따라 '평균'이 달라진다
f_cauchy = lambda x: 1 / (np.pi * (1 + x**2))
anti = lambda a, b: (math.log1p(b * b) - math.log1p(a * a)) / (2 * math.pi)     # ∫_a^b x f(x) dx 의 닫힌 꼴
for A in [10, 100, 1_000]:                     # 수치적분(quad)과 닫힌 꼴을 함께
    asym = integrate.quad(lambda x: x * f_cauchy(x), -A, 2 * A, limit=400, points=[0])[0]
    print(f"A = {A:>5,}:  ∫_-A^A x f = {anti(-A, A):+.4f}   ∫_-A^2A x f = {asym:.4f} (닫힌 꼴 {anti(-A, 2 * A):.4f})   "
          f"∫_-A^A |x| f = {2 * anti(0, A):.2f}")
print(f"A = 10^8:  ∫_-A^2A x f = {anti(-1e8, 2e8):.4f}   ∫_-A^A |x| f = {2 * anti(0, 1e8):.2f}   (닫힌 꼴)")
print(f"(1/π) log 2 = {math.log(2) / math.pi:.4f}   — 연습 1.8.  |x| 의 적분은 (1/π) log(1+A²) 로 끝없이 자란다")
text
A =    10:  ∫_-A^A x f = +0.0000   ∫_-A^2A x f = 0.2194 (닫힌 꼴 0.2194)   ∫_-A^A |x| f = 1.47
A =   100:  ∫_-A^A x f = +0.0000   ∫_-A^2A x f = 0.2206 (닫힌 꼴 0.2206)   ∫_-A^A |x| f = 2.93
A = 1,000:  ∫_-A^A x f = +0.0000   ∫_-A^2A x f = 0.2206 (닫힌 꼴 0.2206)   ∫_-A^A |x| f = 4.40
A = 10^8:  ∫_-A^2A x f = 0.2206   ∫_-A^A |x| f = 11.73   (닫힌 꼴)
(1/π) log 2 = 0.2206   — 연습 1.8.  |x| 의 적분은 (1/π) log(1+A²) 로 끝없이 자란다
1.4 함수의 기댓값과 선형성
정리 1.9 (함수의 기댓값) · 정리 1.11 (선형성 II) — 독립이 필요 없다.
정리 1.9의 증명은 "의 분포를 먼저 구해도, 바로 합해도 같다"는 것이다. 두 길을 모두 계산한다. 그리고 선형성의 힘을 Montmort의 짝 맞추기로 본다. 일치하는 카드 수의 평균은 카드가 몇 장이든 1이다.
python
X = DiscreteRV(np.arange(-3, 4), stats.binom.pmf(np.arange(7), 6, 0.4))   # 값 -3..3
g = lambda x: x**2
# 길 1: Y = g(X) 의 분포를 먼저 만든다
yv = g(X.x); uy = np.unique(yv)
Y = DiscreteRV(uy, [X.p[yv == v].sum() for v in uy])
report({"정리 1.9: E g(X) — Y 의 분포로 == X 의 분포로 바로": math.isclose(Y.mean, X.E(g)),
        "정리 1.10(a): E(3X + 2) = 3 EX + 2": math.isclose(X.E(lambda x: 3 * x + 2), 3 * X.mean + 2)})

# 예제 1.12: Montmort — E N = 1 (선형성), 시뮬레이션
for n in [2, 5, 52, 1000]:
    N = np.array([(rng.permutation(n) == np.arange(n)).sum() for _ in range(20_000)])
    print(f"n = {n:>4}: 평균 일치 수 {N.mean():.3f}   (정리 1.11: 1)")
# 생일: 같은 생일인 쌍의 수의 평균 C(n,2)/365
n = 23
b = rng.integers(0, 365, (20_000, n))
pairs = np.array([sum(math.comb(c, 2) for c in np.bincount(row) if c > 1) for row in b])
print(f"\n23명: 같은 생일 쌍의 평균 {pairs.mean():.3f}   C(23,2)/365 = {math.comb(23, 2) / 365:.3f}")
print("평균 쌍이 1 이상이 되는 첫 n:", next(n for n in range(2, 100) if math.comb(n, 2) / 365 >= 1))
text
  ✓  정리 1.9: E g(X) — Y 의 분포로 == X 의 분포로 바로
  ✓  정리 1.10(a): E(3X + 2) = 3 EX + 2
n =    2: 평균 일치 수 0.993   (정리 1.11: 1)
n =    5: 평균 일치 수 1.003   (정리 1.11: 1)
n =   52: 평균 일치 수 1.008   (정리 1.11: 1)
text
n = 1000: 평균 일치 수 1.000 (정리 1.11: 1)text
23명: 같은 생일 쌍의 평균 0.697   C(23,2)/365 = 0.693
평균 쌍이 1 이상이 되는 첫 n: 28
1.5 꼬리 공식
정리 1.13. (음이 아닌 정수값), ().
꼬리 공식은 이산도 연속도 아닌 확률변수에도 쓸 수 있다. 1회의 보험금(확률 0.3으로 0, 나머지는 밀도 )의 평균이 0.7임을 확인한다. 이어서 Halley 생명표의 기대여명(연습 1.7)과 쿠폰 모으기(연습 1.5)를 계산한다.
python
p_ = 1 / 6
tail_geom = sum((1 - p_) ** (k - 1) for k in range(1, 2000))            # Σ P(X ≥ k)
tail_exp = integrate.quad(lambda x: np.exp(-2 * x), 0, np.inf)[0]      # ∫ P(X > x) dx, λ = 2
insurance = np.where(rng.random(N_SIM) < 0.3, 0.0, rng.exponential(1.0, N_SIM))
tail_mixed = integrate.quad(lambda x: 0.7 * np.exp(-x), 0, np.inf)[0]
report({"꼬리 공식: 기하 Σ P(X ≥ k) == 1/p": math.isclose(tail_geom, 6),
        "꼬리 공식: 지수 ∫ P(X > x) == 1/λ": math.isclose(tail_exp, 0.5),
        "꼬리 공식: 혼합형 보험금 0.7 == 시뮬레이션 평균 (±0.01)": abs(insurance.mean() - tail_mixed) < 0.01})

# 연습 1.7: Halley 의 기대여명 e(x) = Σ_k ℓ(x+k)/ℓ(x)
halley = load_rdata("HalleyLifeTable")
ell = dict(zip(halley.age, halley.number))
e = lambda x: sum(ell.get(x + k, 0) for k in range(1, 100)) / ell[x]
print("\nHalley 기대여명 (완전히 사는 햇수):", {x: round(e(x), 1) for x in [1, 10, 20, 40, 60]})

# 연습 1.5: 쿠폰 모으기 E T = n H_n
def coupon_time(n_types):
    seen, t = set(), 0
    while len(seen) < n_types:
        seen.add(int(rng.integers(n_types))); t += 1
    return t

T = np.array([coupon_time(6) for _ in range(20_000)])
print(f"주사위 여섯 눈을 모두 볼 때까지: 시뮬레이션 {T.mean():.2f}번   6·H_6 = {6 * sum(1 / j for j in range(1, 7)):.2f}번")
text
  ✓  꼬리 공식: 기하 Σ P(X ≥ k) == 1/p
  ✓  꼬리 공식: 지수 ∫ P(X > x) == 1/λ
  ✓  꼬리 공식: 혼합형 보험금 0.7 == 시뮬레이션 평균 (±0.01)

Halley 기대여명 (완전히 사는 햇수): {1: 32.9, 10: 39.8, 20: 33.6, 40: 21.6, 60: 11.6}
text
주사위 여섯 눈을 모두 볼 때까지: 시뮬레이션 14.68번 6·H_6 = 14.70번📝 연습 1.1–1.8 (강의노트): 룰렛, Huygens의 명제 III, 기댓값이 무한대, 조건수렴은 기댓값이 아니다, 쿠폰 모으기, 제곱의 꼬리 공식, Halley의 기대여명, 대칭이어도.
2. 분산과 적률 — 흩어짐을 재는 수
정리 2.2. , , 그리고 .
(c)는 "상수 하나로 를 예측할 때 제곱오차를 가장 작게 하는 것은 평균"이라는 뜻이다. 절대오차라면 중앙값이다(연습 2.2). 기하분포처럼 치우친 분포에서 두 곡선을 그려 본다.
python
p_ = 0.25
geo = DiscreteRV(np.arange(1, 200), stats.geom.pmf(np.arange(1, 200), p_))
cs = np.linspace(0, 10, 401)
sq = [geo.E(lambda x: (x - c) ** 2) for c in cs]
ab = [geo.E(lambda x: np.abs(x - c)) for c in cs]
med = geo.x[np.searchsorted(np.cumsum(geo.p), 0.5)]

fig, axes = plt.subplots(1, 2, figsize=(12, 3.6))
axes[0].plot(cs, sq, color=C["stat"]); axes[0].axvline(geo.mean, color=C["key"], lw=1.5, label=f"mean {geo.mean:.2f}")
axes[0].plot(cs, geo.var + (geo.mean - cs) ** 2, **THEORY, label=r"Var X + $(\mu-c)^2$")
axes[0].set_title(r"$E(X-c)^2$ is smallest at the mean"); axes[0].set_xlabel("c"); axes[0].legend()
axes[1].plot(cs, ab, color=C["data"]); axes[1].axvline(med, color=C["key"], lw=1.5, label=f"median {med:.0f}")
axes[1].set_title(r"$E|X-c|$ is smallest at the median"); axes[1].set_xlabel("c"); axes[1].legend()
plt.tight_layout(); plt.show()
report({"정리 2.2(c): E(X-c)^2 == Var X + (μ-c)^2 (모든 c)": np.allclose(sq, geo.var + (geo.mean - cs) ** 2, rtol=1e-6),
        "정리 2.2(b): Var(3X+1) == 9 Var X": math.isclose(geo.E(lambda x: (3 * x + 1 - (3 * geo.mean + 1)) ** 2), 9 * geo.var, rel_tol=1e-9),
        "연습 2.3: 기하분포 Var X = q/p^2": math.isclose(geo.var, (1 - p_) / p_**2, rel_tol=1e-6)})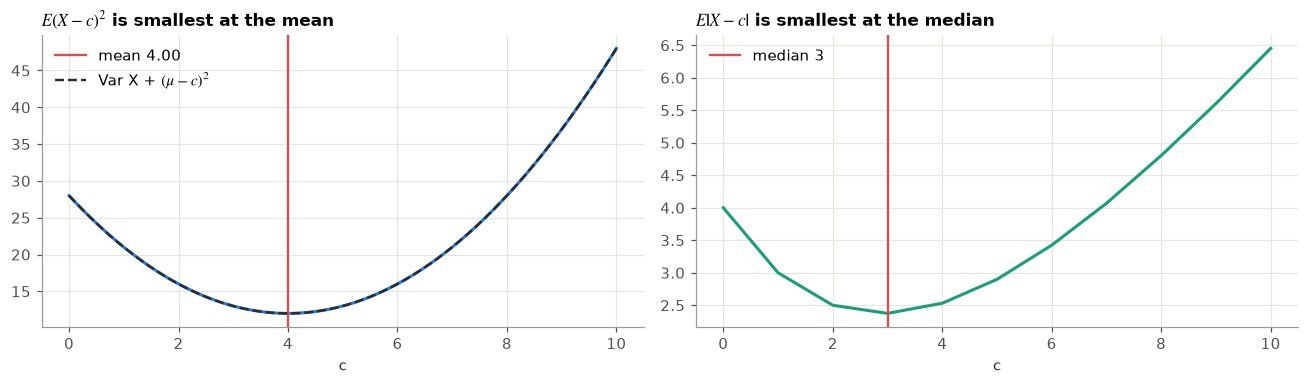
text
  ✓  정리 2.2(c): E(X-c)^2 == Var X + (μ-c)^2 (모든 c)
  ✓  정리 2.2(b): Var(3X+1) == 9 Var X
  ✓  연습 2.3: 기하분포 Var X = q/p^2
2.2 이항분포의 평균과 분산
정리 2.4 이면 , · 따름정리 2.5 이면 .
증명의 핵심 항등식 을 정수로 확인하고, pmf로 계산한 평균·분산을 공식·scipy와 대조한다.
python
checks = {"k·C(n,k) == n·C(n-1,k-1) (n ≤ 40)": all(k * math.comb(n, k) == n * math.comb(n - 1, k - 1) for n in range(1, 41) for k in range(1, n + 1)),
          "k(k-1)·C(n,k) == n(n-1)·C(n-2,k-2)": all(k * (k - 1) * math.comb(n, k) == n * (n - 1) * math.comb(n - 2, k - 2) for n in range(2, 41) for k in range(2, n + 1))}
for n, p_ in [(12, 1 / 3), (100, 0.6), (1000, 0.05)]:
    K = DiscreteRV(np.arange(n + 1), stats.binom.pmf(np.arange(n + 1), n, p_))
    checks[f"b({n}, {p_:.3g}): pmf 로 계산 == (np, npq) == scipy"] = (np.allclose([K.mean, K.var], [n * p_, n * p_ * (1 - p_)])
                                                                    and np.allclose([K.mean, K.var], stats.binom(n, p_).stats("mv")))
report(checks)
for n in [25, 100, 400, 1600]:
    print(f"n = {n:>5}:  sd(p̂) = √(pq/n) = {math.sqrt(0.24 / n):.4f}   시뮬레이션 {np.std(rng.binomial(n, 0.6, 50_000) / n):.4f}")
text
  ✓  k·C(n,k) == n·C(n-1,k-1) (n ≤ 40)
  ✓  k(k-1)·C(n,k) == n(n-1)·C(n-2,k-2)
  ✓  b(12, 0.333): pmf 로 계산 == (np, npq) == scipy
  ✓  b(100, 0.6): pmf 로 계산 == (np, npq) == scipy
  ✓  b(1000, 0.05): pmf 로 계산 == (np, npq) == scipy
n =    25:  sd(p̂) = √(pq/n) = 0.0980   시뮬레이션 0.0984
n =   100:  sd(p̂) = √(pq/n) = 0.0490   시뮬레이션 0.0488
n =   400:  sd(p̂) = √(pq/n) = 0.0245   시뮬레이션 0.0246
n =  1600:  sd(p̂) = √(pq/n) = 0.0122   시뮬레이션 0.0123
2.3 독립인 이산 확률변수
정리 2.7 독립이면 · 정리 2.8 독립이면 , 특히 .
DiscreteRV.__add__는 두 독립 확률변수의 합의 분포를 정확히 만든다(모든 값의 쌍에 확률의 곱을 준다). 주사위를 하나씩 더하며 분산이 정말 더해지는지 본다. 이어서 독립이 아닌 두 예를 본다. Bernstein의 정사면체(쌍별 독립이면 충분, 연습 2.5)와 포커의 에이스(되돌려 넣지 않으면 분산이 준다, 연습 2.4).
python
S = die
checks = {}
for n in range(2, 7):
    S = S + die
    checks[f"주사위 {n}개의 합: Var == {n}·35/12"] = math.isclose(S.var, n * 35 / 12)
report(checks)

# 정리 2.7: 독립인 두 주사위의 곱
pairs = np.array(list(itertools.product(range(1, 7), repeat=2)))
report({"정리 2.7: E(XY) == EX·EY (36가지 열거)": math.isclose(np.mean(pairs[:, 0] * pairs[:, 1]), 3.5**2)})

# 연습 2.5: Bernstein 정사면체 — 쌍별 독립이면 분산이 더해진다
faces = [("R",), ("G",), ("B",), ("R", "G", "B")]
tot = np.array([len(f) for f in faces])                  # R+G+B 의 값 (면마다)
report({"연습 2.5: Var(R+G+B) == 3·(1/4) (상호 독립이 아닌데도)": math.isclose(tot.var(), 0.75)})

# 연습 2.4: 에이스 수 — 되돌려 넣지 않으면(초기하) 분산이 이항보다 작다
hyper = stats.hypergeom(52, 4, 5)
print(f"에이스 수: 평균 {hyper.mean():.4f}   분산 {hyper.var():.4f}   (b(5, 1/13)의 분산 {5 / 13 * 12 / 13:.4f})")

# 예제 2.9: Montmort 의 일치 수 — 평균 1, 분산 1 (n ≥ 2)
for n in [3, 10, 52]:
    N = np.array([(rng.permutation(n) == np.arange(n)).sum() for _ in range(40_000)])
    print(f"n = {n:>2}: 일치 수의 평균 {N.mean():.3f}, 분산 {N.var():.3f}   (둘 다 1)")
text
  ✓  주사위 2개의 합: Var == 2·35/12
  ✓  주사위 3개의 합: Var == 3·35/12
  ✓  주사위 4개의 합: Var == 4·35/12
  ✓  주사위 5개의 합: Var == 5·35/12
  ✓  주사위 6개의 합: Var == 6·35/12
  ✓  정리 2.7: E(XY) == EX·EY (36가지 열거)
  ✓  연습 2.5: Var(R+G+B) == 3·(1/4) (상호 독립이 아닌데도)
에이스 수: 평균 0.3846   분산 0.3272   (b(5, 1/13)의 분산 0.3550)
text
n = 3: 일치 수의 평균 1.003, 분산 1.001 (둘 다 1)text
n = 10: 일치 수의 평균 1.007, 분산 1.015 (둘 다 1)text
n = 52: 일치 수의 평균 0.997, 분산 1.005 (둘 다 1)2.4 적률 — Weldon의 주사위 (1894)
정의 2.10. 왜도 , 초과첨도 .
먼저 왜도·첨도를 직접 계산해 scipy와 맞춘다(연습 2.7). 그다음 Weldon의 기록을 연다. 주사위 12개를 26,306번 굴려 5·6이 나온 주사위의 수를 셌다. 공평한 주사위라면 이다.
python
def shape(rv):
    m, s = rv.mean, math.sqrt(rv.var)
    return rv.E(lambda x: (x - m) ** 3) / s**3, rv.E(lambda x: (x - m) ** 4) / s**4 - 3

bern = DiscreteRV([0, 1], [0.7, 0.3])
xs_ = np.linspace(0, 1, 200_001)
unif_num = (integrate.simpson(((xs_ - 0.5) ** 3), x=xs_) / (1 / 12) ** 1.5,
            integrate.simpson(((xs_ - 0.5) ** 4), x=xs_) / (1 / 12) ** 2 - 3)
expo_num = (integrate.quad(lambda x: (x - 1) ** 3 * np.exp(-x), 0, np.inf)[0],
            integrate.quad(lambda x: (x - 1) ** 4 * np.exp(-x), 0, np.inf)[0] - 3)
report({"Bernoulli(0.3): γ1 == (1-2p)/√(pq) == scipy": np.allclose(shape(bern)[0], [(1 - 0.6) / math.sqrt(0.21), float(stats.bernoulli(0.3).stats("s"))]),
        "U(0,1): (γ1, γ2) == (0, -6/5) == scipy": np.allclose(unif_num, [0, -1.2], atol=1e-6) and np.allclose(stats.uniform.stats(moments="sk"), [0, -1.2]),
        "Exp(1): (γ1, γ2) == (2, 6) == scipy": np.allclose(expo_num, [2, 6]) and np.allclose(stats.expon.stats(moments="sk"), [2, 6])})
text
  ✓  Bernoulli(0.3): γ1 == (1-2p)/√(pq) == scipy
  ✓  U(0,1): (γ1, γ2) == (0, -6/5) == scipy
  ✓  Exp(1): (γ1, γ2) == (2, 6) == scipy
python
weldon = load_rdata("WeldonDice", "vcd")
k, cnt = weldon.n56.to_numpy(), weldon.Freq.to_numpy()
n_throws = cnt.sum()
kbar = (k * cnt).sum() / n_throws
s2 = ((k - kbar) ** 2 * cnt).sum() / n_throws
p_hat = kbar / 12
print(weldon.T.to_string(header=False))
print(f"\n굴린 횟수 {n_throws:,}   평균 {kbar:.4f} (공평하면 4)   분산 {s2:.4f} (공평하면 {12 * 1 / 3 * 2 / 3:.4f})")
print(f"p̂ = {p_hat:.4f} 로 맞춘 이항분포의 분산 12 p̂(1-p̂) = {12 * p_hat * (1 - p_hat):.4f}   (연습 2.9)")
print(f"평균의 표준편차 (공평, 독립) √((8/3)/{n_throws}) = {math.sqrt(8 / 3 / n_throws):.4f}  →  차이는 {(kbar - 4) / math.sqrt(8 / 3 / n_throws):.1f} 표준편차")

fig, ax = plt.subplots(figsize=(9, 3.6))
kk = np.arange(13)
ax.bar(k, cnt / n_throws, color=C["data"], alpha=0.85, label="Weldon 1894 (10 = '10 or more')")
ax.plot(kk, stats.binom.pmf(kk, 12, 1 / 3), "o", mfc="none", mec=C["ink"], ms=7, mew=1.5, label="fair dice b(12, 1/3)")
ax.plot(kk, stats.binom.pmf(kk, 12, p_hat), "x", color=C["key"], ms=7, mew=1.5, label=f"b(12, {p_hat:.4f})")
ax.set_xlabel("number of 5s and 6s among 12 dice"); ax.set_ylabel("relative frequency"); ax.legend()
ax.set_title("Weldon's dice: close to binomial, but p slightly above 1/3")
plt.tight_layout(); plt.show()
text
n56     0     1     2     3     4     5     6     7    8    9  10
Freq  185  1149  3265  5475  6114  5194  3067  1331  403  105  18

굴린 횟수 26,306   평균 4.0522 (공평하면 4)   분산 2.6962 (공평하면 2.6667)
p̂ = 0.3377 로 맞춘 이항분포의 분산 12 p̂(1-p̂) = 2.6838   (연습 2.9)
평균의 표준편차 (공평, 독립) √((8/3)/26306) = 0.0101  →  차이는 5.2 표준편차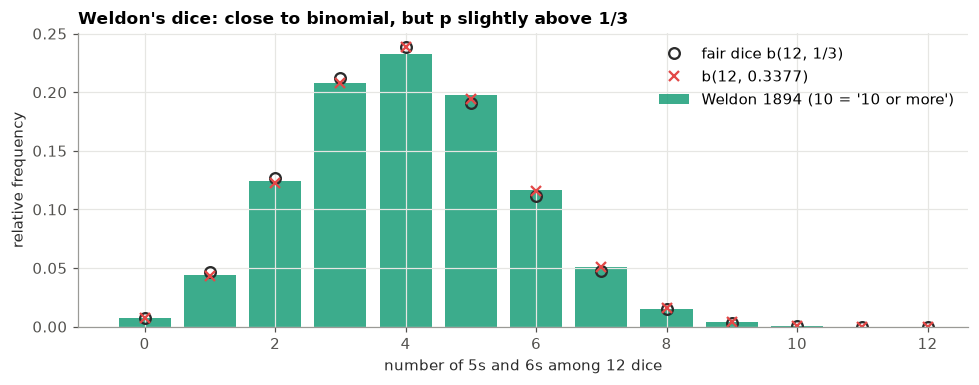
그림 읽기. 막대(Weldon)와 원(공평한 주사위)은 눈으로는 거의 같다. 그러나 26,306번의 평균은 공평한 주사위의 평균에서 표준편차의 5배나 떨어져 있다. 표본이 크면 작은 차이도 우연으로 설명할 수 없게 된다. 5절에서 이 판단을 Chebyshev 부등식으로, 분포를 가정하지 않고 내린다.
📝 연습 2.1–2.9 (강의노트): 두 주사위의 합, 중앙값과 절대오차, 기하분포의 분산, 에이스, 쌍별 독립, 독립의 정의, 모양의 수, 두 독립 복사본, Weldon의 분산.
3. 적률생성함수
정의 3.1 · 정리 3.3 · 따름정리 3.4 에서 , · 정리 3.6 독립합이면 .
mgf를 정의대로(합·적분) 계산해 닫힌 꼴과 맞추고, 에서의 수치 미분으로 적률을 되찾는다.
python
def num_deriv(f, k):
    """중심차분으로 f^(k)(0) (k = 1, 2). 오차는 h² 차수"""
    if k == 1:
        h = 1e-4
        return (f(h) - f(-h)) / (2 * h)
    h = 1e-3
    return (f(h) - 2 * f(0) + f(-h)) / h**2

closed = {
    "b(10, 0.3)": (lambda t: (0.7 + 0.3 * np.exp(t)) ** 10, DiscreteRV(np.arange(11), stats.binom.pmf(np.arange(11), 10, 0.3))),
    "geometric(0.2)": (lambda t: 0.2 * np.exp(t) / (1 - 0.8 * np.exp(t)), DiscreteRV(np.arange(1, 400), stats.geom.pmf(np.arange(1, 400), 0.2))),
}
checks = {}
for name, (M, rv) in closed.items():
    ts = np.array([-0.1, 0.05, 0.1])
    checks[f"{name}: Σ e^(tx) p(x) == 닫힌 꼴"] = np.allclose(rv.mgf(ts), M(ts))
    checks[f"{name}: M'(0) == EX,  ψ''(0) == Var X (수치 미분)"] = (math.isclose(num_deriv(M, 1), rv.mean, rel_tol=1e-5)
                                                                  and math.isclose(num_deriv(lambda t: np.log(M(t)), 2), rv.var, rel_tol=1e-4))
M_exp = lambda t: integrate.quad(lambda x: 2 * np.exp((t - 2) * x), 0, np.inf)[0]     # e^(tx)·λe^(-λx), 지수를 합쳐 넘침을 피한다
checks["Exp(2): ∫ e^(tx) f(x) dx == λ/(λ-t) (t = 0.5, 1.5)"] = all(math.isclose(M_exp(t), 2 / (2 - t)) for t in [0.5, 1.5])
checks["예제 3.5: Exp(λ)의 E X^k == k!/λ^k (k ≤ 5)"] = all(math.isclose(stats.expon(scale=0.5).moment(k), math.factorial(k) / 2**k) for k in range(1, 6))
report(checks)
text
  ✓  b(10, 0.3): Σ e^(tx) p(x) == 닫힌 꼴
  ✓  b(10, 0.3): M'(0) == EX,  ψ''(0) == Var X (수치 미분)
  ✓  geometric(0.2): Σ e^(tx) p(x) == 닫힌 꼴
  ✓  geometric(0.2): M'(0) == EX,  ψ''(0) == Var X (수치 미분)
  ✓  Exp(2): ∫ e^(tx) f(x) dx == λ/(λ-t) (t = 0.5, 1.5)
  ✓  예제 3.5: Exp(λ)의 E X^k == k!/λ^k (k ≤ 5)
python
# 예제 3.7: 독립인 Bernoulli 의 합 — mgf 의 곱 = 이항의 mgf, 분포도 이항
n, p_ = 8, 0.35
B = DiscreteRV([0, 1], [1 - p_, p_])
Ssum = B
for _ in range(n - 1):
    Ssum = Ssum + B
ts = np.linspace(-1, 1, 7)
report({"정리 3.6(b): M_(X1+…+X8) == (M_X)^8": np.allclose(Ssum.mgf(ts), B.mgf(ts) ** n),
        "예제 3.7: 합의 분포 == b(8, 0.35) (유일성)": np.allclose(Ssum.p, stats.binom.pmf(np.arange(n + 1), n, p_))})

# 예제 3.8: de Moivre 의 방법 — 세 주사위의 합은 다항식 곱셈 한 번
die_poly = np.r_[0, np.ones(6)]                         # z^0..z^6 의 계수
three = np.convolve(np.convolve(die_poly, die_poly), die_poly)
print("세 주사위: z^9 의 계수", int(three[9]), "  z^10 의 계수", int(three[10]), "  (Galileo: 25, 27)")

# 연습 3.6: Sicherman 의 주사위
def poly(faces):
    c = np.zeros(max(faces) + 1); np.add.at(c, faces, 1); return c
std = np.convolve(poly([1, 2, 3, 4, 5, 6]), poly([1, 2, 3, 4, 5, 6]))
sich = np.convolve(poly([1, 2, 2, 3, 3, 4]), poly([1, 3, 4, 5, 6, 8]))
report({"연습 3.6: Sicherman 주사위 두 개의 합 == 보통 주사위 두 개의 합": np.array_equal(std, sich)})
text
  ✓  정리 3.6(b): M_(X1+…+X8) == (M_X)^8
  ✓  예제 3.7: 합의 분포 == b(8, 0.35) (유일성)
세 주사위: z^9 의 계수 25   z^10 의 계수 27   (Galileo: 25, 27)
  ✓  연습 3.6: Sicherman 주사위 두 개의 합 == 보통 주사위 두 개의 합
python
t = np.linspace(-1.5, 0.85, 300)
rvs = [("Bernoulli(0.6)", DiscreteRV([0, 1], [0.4, 0.6]).mgf),
       ("Exp(1)", lambda t: 1 / (1 - t)),
       ("b(5, 0.3)", DiscreteRV(np.arange(6), stats.binom.pmf(np.arange(6), 5, 0.3)).mgf)]
moments = [(0.6, 0.24), (1.0, 1.0), (1.5, 1.05)]
fig, axes = plt.subplots(1, 2, figsize=(12, 3.8))
for (name, M), (mu, var), col in zip(rvs, moments, SERIES):
    axes[0].plot(t, M(t), color=col, label=name); axes[0].plot(t, 1 + mu * t, color=col, ls=":", lw=1.2)
    axes[1].plot(t, np.log(M(t)), color=col, label=name); axes[1].plot(t, mu * t + var * t**2 / 2, color=col, ls=":", lw=1.2)
axes[0].set_ylim(0, 4); axes[0].set_title("M(t): slope at 0 is the mean (dotted)"); axes[0].legend()
axes[1].set_ylim(-1.5, 1.6); axes[1].set_title(r"$\psi(t)=\log M(t)$ vs $\mu t+\sigma^2t^2/2$ (dotted)")
for ax in axes:
    ax.axvline(0, color=C["hist"], lw=0.8); ax.set_xlabel("t")
plt.tight_layout(); plt.show()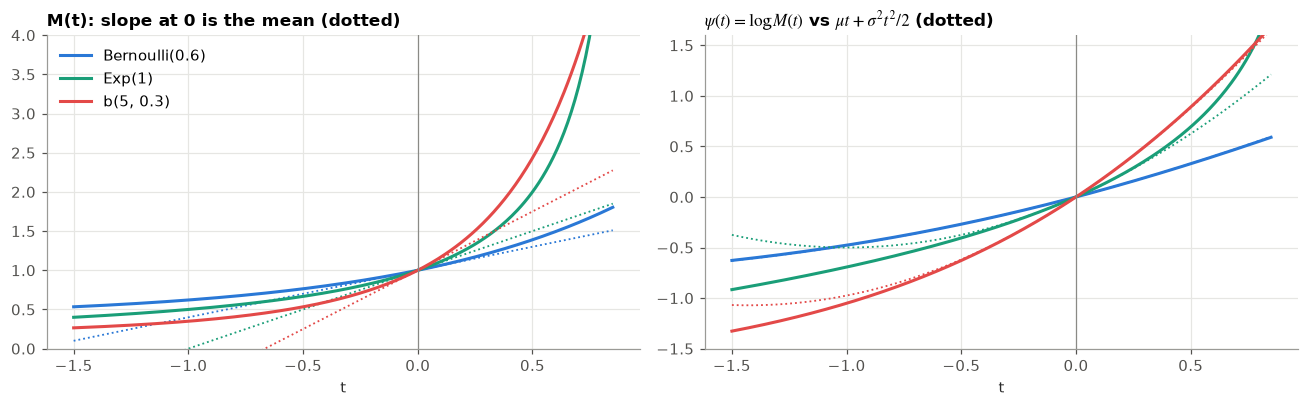
0 근처의 는 와 거의 같다. 5회에서 정규분포는 이 이차식이 정확한 분포라는 것을, 7회에서 중심극한정리는 "독립합을 표준화하면 모든 분포의 가 이 이차식으로 간다"는 것을 보인다.
📝 연습 3.1–3.6 (강의노트): 주사위의 mgf, 기하분포, mgf에서 분포로, 꼬리가 가볍다, 누율의 덧셈, Sicherman의 주사위.
4. 변수변환 — 확률변수의 함수의 분포
예제 4.1 : · 정리 4.3 (단조변환) · 예제 4.5 위치–척도 .
공식으로 만든 밀도와 시뮬레이션 히스토그램을 겹친다. 오른쪽 그림은 단조변환 ()이다. , 이므로 ()다.
python
fig, axes = plt.subplots(1, 3, figsize=(13, 3.6))
X = rng.uniform(-1, 2, N_SIM)                        # 연습 4.2
Y = X**2
yy = np.linspace(0.005, 4, 400)
fY = np.where(yy < 1, 1 / (3 * np.sqrt(yy)), 1 / (6 * np.sqrt(yy)))
axes[0].hist(Y, bins=np.linspace(0, 4, 81), density=True, color=C["data"], alpha=0.75)
axes[0].plot(yy, fY, **THEORY); axes[0].set_ylim(0, 2.5); axes[0].set_title(r"$Y=X^2$, $X\sim U(-1,2)$ (Exercise 4.2)")
Z = rng.standard_cauchy(N_SIM)
W = 1 / Z                                            # 연습 4.4: 1/Cauchy 도 Cauchy
grid = np.linspace(-6, 6, 400)
axes[1].hist(W[np.abs(W) < 6], bins=np.linspace(-6, 6, 97), density=False,
             weights=np.full((np.abs(W) < 6).sum(), 1 / (N_SIM * 0.125)), color=C["data"], alpha=0.75)
axes[1].plot(grid, stats.cauchy.pdf(grid), **THEORY); axes[1].set_title("1/X for Cauchy X (Exercise 4.4)")
E_ = np.exp(rng.random(N_SIM))
axes[2].hist(E_, bins=60, density=True, color=C["data"], alpha=0.75)
ee = np.linspace(1, np.e, 200); axes[2].plot(ee, 1 / ee, **THEORY); axes[2].set_title(r"$Y=e^X$: $f_Y(y)=1/y$ (Theorem 4.3)")
plt.tight_layout(); plt.show()

ks = {name: stats.kstest(sample, cdf).pvalue for name, sample, cdf in [
    ("1/Cauchy", W, stats.cauchy.cdf), ("e^U", E_, lambda y: np.log(y)),
    ("U(-1,2)^2", Y, lambda y: np.where(y < 1, 2 * np.sqrt(y) / 3, (np.sqrt(np.clip(y, 0, None)) + 1) / 3))]}
report({f"{name}: KS 검정이 공식과 모순되지 않는다 (p = {pv:.2f})": pv > 0.001 for name, pv in ks.items()})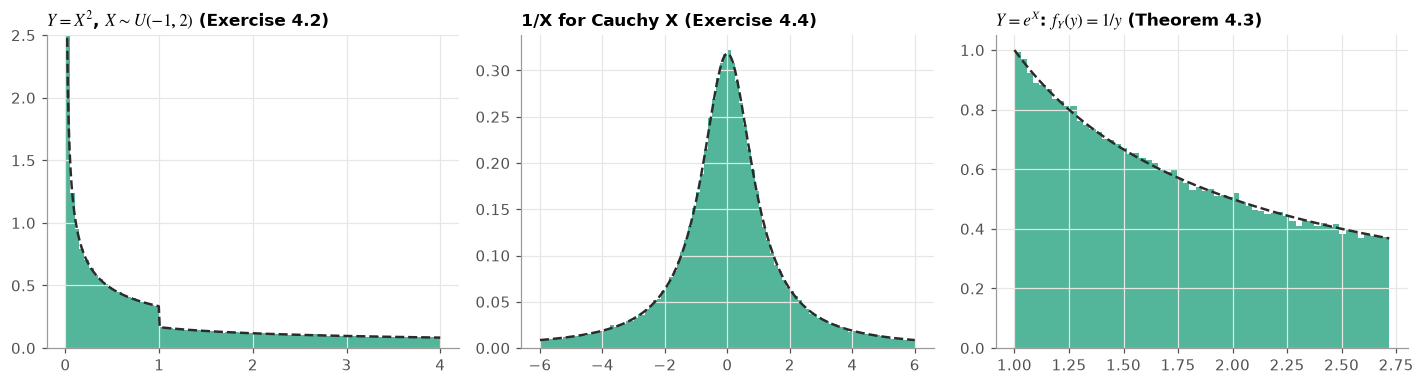
text
  ✓  1/Cauchy: KS 검정이 공식과 모순되지 않는다 (p = 0.14)
  ✓  e^U: KS 검정이 공식과 모순되지 않는다 (p = 0.06)
  ✓  U(-1,2)^2: KS 검정이 공식과 모순되지 않는다 (p = 0.10)
4.3 확률적분변환과 역변환 표집
보조정리 4.6 · 정리 4.7 (a) — 임의의 분포함수, (b) 가 연속이면 .
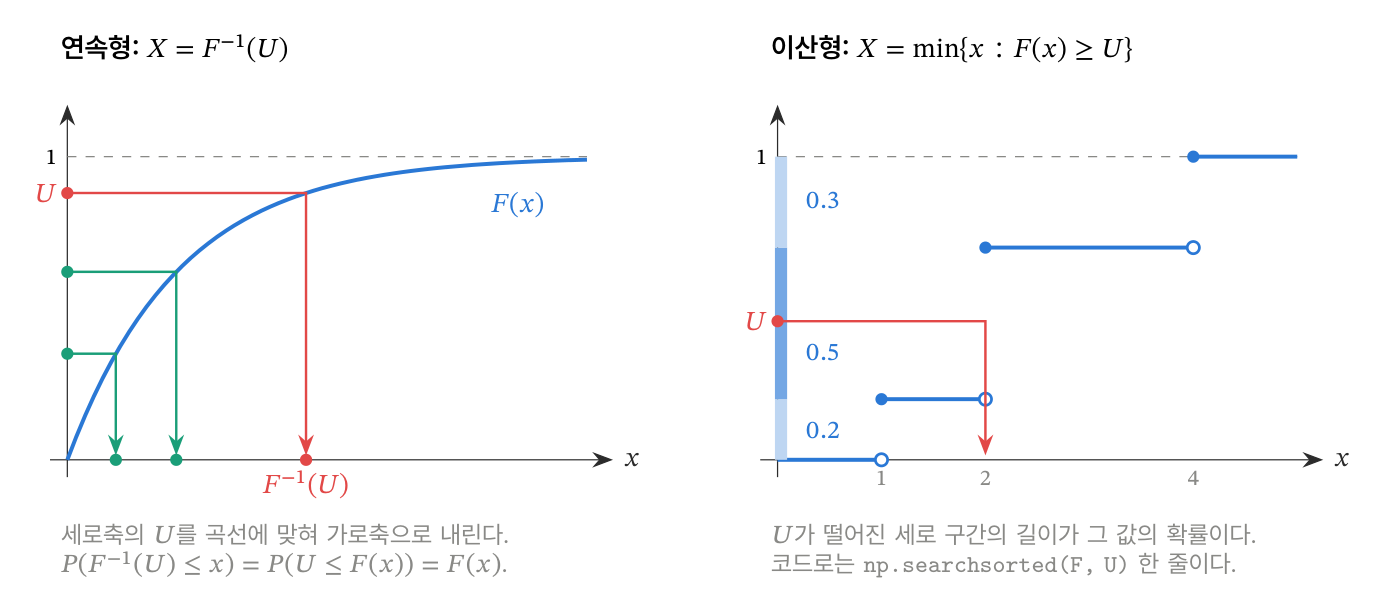
알고리즘 4.8을 그대로 구현한다. 하나의 함수 inverse_sample(F_inv, n)이 지수·Cauchy·기하·Pareto·혼합형(1회의 보험금, 연습 4.5)을 모두 만든다. 이산형은 DiscreteRV.sample의 searchsorted 한 줄이다.
python
def inverse_sample(F_inv, n):
    """알고리즘 4.8: U ~ U(0,1) 을 일반화된 역함수에 넣는다"""
    return F_inv(rng.random(n))

alpha = 1.5
targets = {
    "Exp(2)":        (lambda u: -np.log(1 - u) / 2,                 stats.expon(scale=0.5).cdf),
    "Cauchy":        (lambda u: np.tan(np.pi * (u - 0.5)),          stats.cauchy.cdf),
    "Pareto(1.5)":   (lambda u: (1 - u) ** (-1 / alpha),            lambda x: np.where(x < 1, 0, 1 - x ** (-alpha))),
    "보험금 (혼합형)": (lambda u: np.where(u <= 0.3, 0.0, np.log(0.7 / (1 - np.maximum(u, 0.3)))),
                     lambda x: np.where(x < 0, 0, 0.3 + 0.7 * (1 - np.exp(-np.maximum(x, 0))))),
}
checks = {}
for name, (Finv, F) in targets.items():
    xs_ = inverse_sample(Finv, N_SIM)
    q = np.quantile(xs_, [0.5, 0.75, 0.9])
    checks[f"{name}: 표본 분위수에서 F 값이 0.5, 0.75, 0.9 (±0.01)"] = np.allclose(F(q), [0.5, 0.75, 0.9], atol=0.01)
geomK = np.ceil(np.log(1 - rng.random(N_SIM)) / np.log(1 - 0.2))
checks["기하(0.2): ⌈log(1-U)/log q⌉ 의 평균 == 1/p (±0.05)"] = abs(geomK.mean() - 5) < 0.05
w_rv = DiscreteRV(np.arange(13), stats.binom.pmf(np.arange(13), 12, 1 / 3))
w_s = w_rv.sample(N_SIM)
checks["b(12, 1/3): searchsorted 표본의 상대도수 == pmf (±0.005)"] = np.allclose(np.bincount(w_s.astype(int), minlength=13) / N_SIM, w_rv.p, atol=0.005)
report(checks)
mixed = inverse_sample(targets["보험금 (혼합형)"][0], N_SIM)
print(f"보험금: P(X=0) = {np.mean(mixed == 0):.4f} (0.3),  평균 {mixed.mean():.4f} (꼬리 공식 0.7)")
text
  ✓  Exp(2): 표본 분위수에서 F 값이 0.5, 0.75, 0.9 (±0.01)
  ✓  Cauchy: 표본 분위수에서 F 값이 0.5, 0.75, 0.9 (±0.01)
  ✓  Pareto(1.5): 표본 분위수에서 F 값이 0.5, 0.75, 0.9 (±0.01)
  ✓  보험금 (혼합형): 표본 분위수에서 F 값이 0.5, 0.75, 0.9 (±0.01)
  ✓  기하(0.2): ⌈log(1-U)/log q⌉ 의 평균 == 1/p (±0.05)
  ✓  b(12, 1/3): searchsorted 표본의 상대도수 == pmf (±0.005)
보험금: P(X=0) = 0.2992 (0.3),  평균 0.7013 (꼬리 공식 0.7)
python
# 정리 4.7(b): F(X) 는 균등 — 모형이 맞으면 '보정이 맞는다'. 틀린 모형이면 히스토그램이 기운다
X = rng.exponential(1.0, 50_000)
fig, axes = plt.subplots(1, 3, figsize=(13, 3.2), sharey=True)
for ax, (name, F) in zip(axes, [("true model Exp(1)", stats.expon.cdf),
                                ("wrong scale Exp(mean 2)", stats.expon(scale=2).cdf),
                                ("wrong family N(1, 1)", stats.norm(1, 1).cdf)]):
    ax.hist(F(X), bins=20, density=True, color=C["data"] if "true" in name else C["assume"], alpha=0.8)
    ax.axhline(1, **THEORY); ax.set_title(f"F(X) under {name}", fontsize=10); ax.set_xlabel("F(X)")
plt.tight_layout(); plt.show()
print("KS p-value (참 모형):", round(stats.kstest(stats.expon.cdf(X), "uniform").pvalue, 3))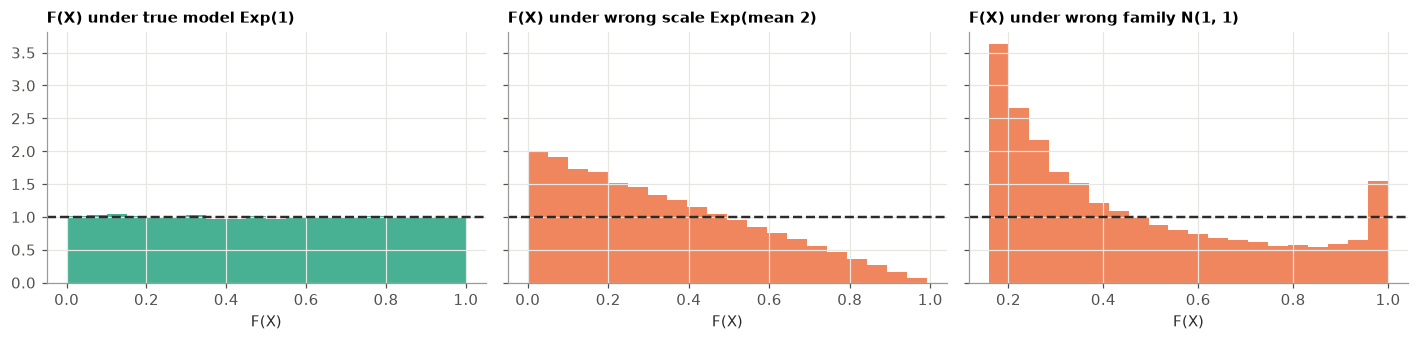
text
KS p-value (참 모형): 0.027그림 읽기. 모형이 맞으면 는 평평하다(정리 4.7(b)). 척도를 틀리면 한쪽으로 몰리고, 분포족을 틀리면 U자나 언덕 모양이 된다. 확률 예보와 분류기의 보정(calibration) 검사가 바로 이 히스토그램이다.
Benford의 법칙 (연습 4.3). 많은 양의 독립 요인을 곱한 양은 의 소수 부분이 거의 균등해진다. 균등 난수 20개를 곱한 수의 첫 자리를 세어 와 비교한다.
python
prod = np.prod(rng.uniform(0.5, 5, (N_SIM, 20)), axis=1)
first = (prod / 10 ** np.floor(np.log10(prod))).astype(int)
d = np.arange(1, 10)
obs = np.bincount(first, minlength=10)[1:] / N_SIM
print(pd.DataFrame({"first digit": d, "observed": obs.round(4), "Benford log10(1+1/d)": np.log10(1 + 1 / d).round(4)}).to_string(index=False))
report({"연습 4.3: 첫 자리 분포 ≈ Benford (±0.005)": np.allclose(obs, np.log10(1 + 1 / d), atol=0.005)})
text
 first digit  observed  Benford log10(1+1/d)
           1    0.2995                0.3010
           2    0.1759                0.1761
           3    0.1266                0.1249
           4    0.0974                0.0969
           5    0.0786                0.0792
           6    0.0668                0.0669
           7    0.0583                0.0580
           8    0.0510                0.0512
           9    0.0459                0.0458
text
✓ 연습 4.3: 첫 자리 분포 ≈ Benford (±0.005)📝 연습 4.1–4.7 (강의노트): 지수분포를 두 가지로, 일대일이 아닌 제곱, Benford, Cauchy의 역수, 혼합형 표집, Pareto, 확률적분변환은 연속이어야.
5. 부등식 — 기댓값으로 꼬리를 누르기
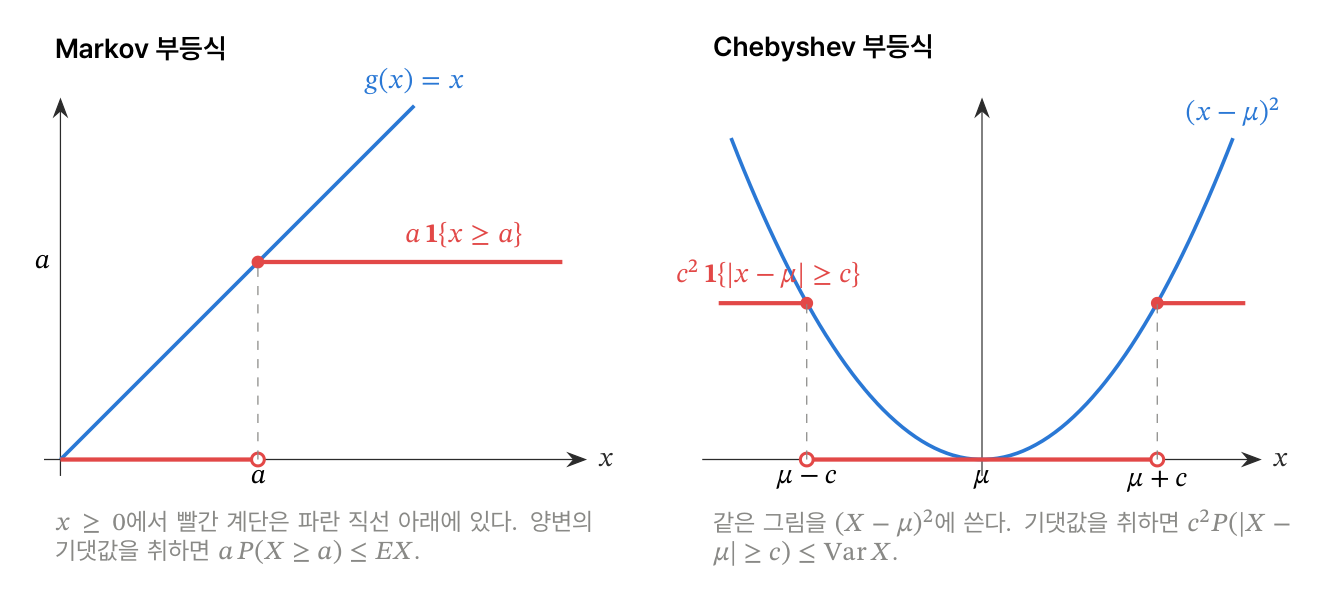
정리 5.1 (Markov) · 정리 5.3 (Chebyshev) · 예제 5.4 한계는 정확하다.
여러 분포에서 실제 꼬리 확률 를 한계 과 비교한다. 예제 5.4의 세 점 분포만 한계에 닿는다.
python
ks_ = np.linspace(1, 4, 61)
dists = {"uniform": stats.uniform(), "exponential": stats.expon(), "b(20, 0.1)": stats.binom(20, 0.1), "t(3)": stats.t(3)}
fig, ax = plt.subplots(figsize=(9, 4))
ax.plot(ks_, 1 / ks_**2, color=C["ink"], lw=2.2, label=r"Chebyshev $1/k^2$")
def two_sided_tail(dist, k):
    """P(|X-μ| ≥ kσ) = P(X ≤ μ-kσ) + P(X ≥ μ+kσ)"""
    mu, sd = dist.mean(), dist.std()
    lo, hi = mu - k * sd, mu + k * sd
    if isinstance(dist.dist, stats.rv_discrete):
        return dist.cdf(np.floor(lo)) + dist.sf(np.ceil(hi) - 1)
    return dist.cdf(lo) + dist.sf(hi)

for (name, dist), col in zip(dists.items(), SERIES):
    ax.plot(ks_, [two_sided_tail(dist, k) for k in ks_], color=col, label=name)
for kk in [1.5, 2, 3]:                                 # 예제 5.4: 세 점 분포는 한계와 같다
    ax.plot(kk, 1 / kk**2, "o", color=C["key"], ms=8)
ax.plot([], [], "o", color=C["key"], label="Example 5.4 (equality)")
ax.set_yscale("log"); ax.set_ylim(1e-4, 1.1); ax.set_xlabel(r"$k$"); ax.set_ylabel(r"$P(|X-\mu|\geq k\sigma)$"); ax.legend(fontsize=9)
ax.set_title("Chebyshev is a worst-case bound")
plt.tight_layout(); plt.show()

k = 2
three = DiscreteRV([-k, 0, k], [1 / (2 * k**2), 1 - 1 / k**2, 1 / (2 * k**2)])
report({"예제 5.4: 세 점 분포에서 σ = 1, P(|X| ≥ 2σ) = 1/4 (등호)": math.isclose(three.var, 1) and math.isclose(three.p[[0, 2]].sum(), 1 / 4),
        "연습 5.2: Exp(1) 에서 P(|X-1| ≥ 2) = e^-3": math.isclose(two_sided_tail(stats.expon(), 2), math.exp(-3)),
        "모든 분포에서 실제 꼬리 ≤ 1/k^2": all(two_sided_tail(dist, k) <= 1 / k**2 + 1e-12 for dist in dists.values() for k in ks_)})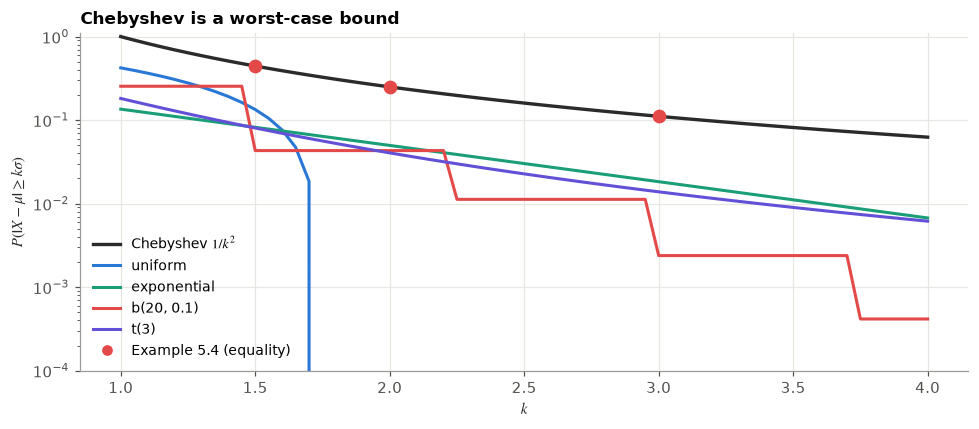
text
  ✓  예제 5.4: 세 점 분포에서 σ = 1, P(|X| ≥ 2σ) = 1/4 (등호)
  ✓  연습 5.2: Exp(1) 에서 P(|X-1| ≥ 2) = e^-3
  ✓  모든 분포에서 실제 꼬리 ≤ 1/k^2
python
# 예제 5.5: Weldon 의 주사위는 공평했나 — 분포를 가정하지 않는 판단
var_mean = (8 / 3) / n_throws
dev = kbar - 4
cheb = var_mean / dev**2
normal_tail = 2 * stats.norm.sf(dev / math.sqrt(var_mean))
cantelli = var_mean / (var_mean + dev**2)
print(f"|K̄ - 4| = {dev:.4f}")
print(f"  Chebyshev (양쪽, 분포 가정 없음):  P ≤ {cheb:.4f}")
print(f"  Cantelli  (한쪽, 연습 5.3):        P ≤ {cantelli:.4f}")
print(f"  정규근사  (7회의 CLT):             P ≈ {normal_tail:.1e}")
report({"예제 5.5: Chebyshev 한계 ≈ 0.037": abs(cheb - 0.0372) < 0.001})
text
|K̄ - 4| = 0.0522
  Chebyshev (양쪽, 분포 가정 없음):  P ≤ 0.0372
  Cantelli  (한쪽, 연습 5.3):        P ≤ 0.0358
  정규근사  (7회의 CLT):             P ≈ 2.1e-07
  ✓  예제 5.5: Chebyshev 한계 ≈ 0.037
5.2 Jensen
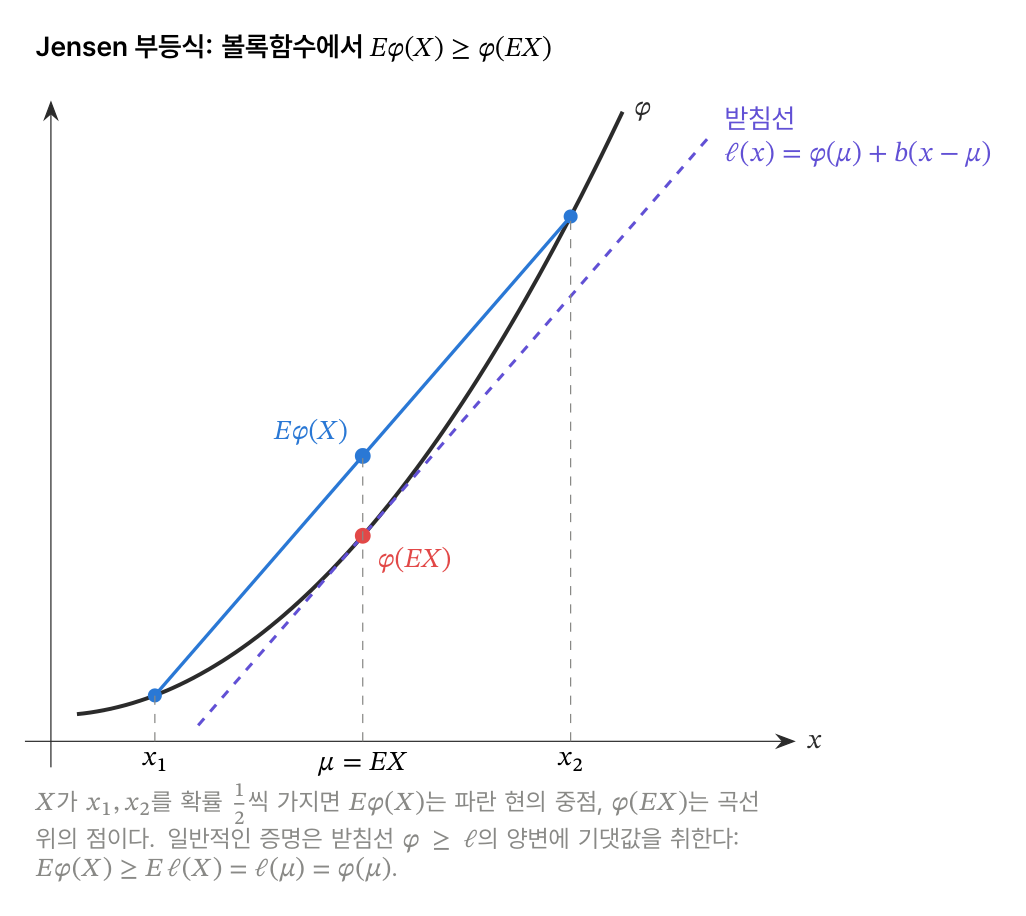
정리 5.9. 볼록함수 에 대해 · 따름정리 5.10 , 산술–기하 평균, Lyapunov 은 에 대해 증가.
python
X = rng.exponential(1.0, N_SIM) + 0.1
rs = np.linspace(0.25, 4, 40)
norms = [np.mean(X**r) ** (1 / r) for r in rs]
a_vals = rng.uniform(0.5, 4, 10)
report({"Jensen: E log X ≤ log E X": np.mean(np.log(X)) <= math.log(X.mean()),
        "Jensen: E 1/X ≥ 1/E X": np.mean(1 / X) >= 1 / X.mean(),
        "따름정리 5.10(c): 기하평균 ≤ 산술평균": np.exp(np.mean(np.log(a_vals))) <= a_vals.mean(),
        "따름정리 5.10(d): Lyapunov — (E|X|^r)^(1/r) 은 r 에 대해 증가": np.all(np.diff(norms) > 0)})
print(f"연습 5.7: 60km/h 로 가고 40km/h 로 오면 평균 속력 = 조화평균 {2 / (1 / 60 + 1 / 40):.1f} km/h (산술평균 50)")
text
  ✓  Jensen: E log X ≤ log E X
  ✓  Jensen: E 1/X ≥ 1/E X
  ✓  따름정리 5.10(c): 기하평균 ≤ 산술평균
  ✓  따름정리 5.10(d): Lyapunov — (E|X|^r)^(1/r) 은 r 에 대해 증가
연습 5.7: 60km/h 로 가고 40km/h 로 오면 평균 속력 = 조화평균 48.0 km/h (산술평균 50)
📝 연습 5.1–5.7 (강의노트): Markov도 정확하다, 한계와 실제, Cantelli, 평균과 중앙값, 기울기의 단조성, , 평균 속력.
6. 대수의 법칙 — Bernoulli의 황금정리
정리 6.2. · 정리 6.3. .
6.4 같은 질문의 다섯 답
, , 확실성 . Bernoulli의 공식(6.3절)을 그대로 구현하고, Chebyshev·Hoeffding(8절)·정규근사·정확한 이항 계산과 나란히 놓는다.
python
def bernoulli_trials(r, s, c):
    """Ars Conjectandi 4부 5장의 공식 (r 흰, s 검은, 확실성 c 대 1)"""
    t = r + s
    m1 = math.ceil(math.log(c * (s - 1)) / (math.log(r + 1) - math.log(r)))
    m2 = math.ceil(math.log(c * (r - 1)) / (math.log(s + 1) - math.log(s)))
    n1 = m1 * t + (m1 * s * t - s * t) / (r + 1)
    n2 = m2 * t + (m2 * r * t - r * t) / (s + 1)
    return m1, n1, m2, n2

def p_outside(n, p=0.6, lo=29 / 50, hi=31 / 50):
    """P(p̂_n ∉ [lo, hi]) — 정확한 이항 계산"""
    n = np.asarray(n)
    return stats.binom.cdf(np.ceil(n * lo - 1e-9) - 1, n, p) + stats.binom.sf(np.floor(n * hi + 1e-9), n, p)

p_, eps = 0.6, 0.02
rows = []
for c in [1000, 10_000, 100_000]:
    delta = 1 / (c + 1)
    m1, n1, m2, n2 = bernoulli_trials(30, 20, c)
    ns = np.arange(1000, 20_000)
    ok = p_outside(ns) <= delta
    rows.append(dict(c=c, Bernoulli=math.ceil(max(n1, n2)),
                     Chebyshev=math.ceil(p_ * (1 - p_) / (eps**2 * delta)),
                     Hoeffding=math.ceil(math.log(2 / delta) / (2 * eps**2)),
                     normal=math.ceil(stats.norm.isf(delta / 2) ** 2 * p_ * (1 - p_) / eps**2),
                     exact_first=int(ns[ok.argmax()]), exact_always=int(ns[~ok].max() + 1)))
answers = pd.DataFrame(rows).set_index("c")
print(answers.to_string())
report({"Bernoulli 공식 (c=1000): m = 301, 211 → 24,728 / 25,550": bernoulli_trials(30, 20, 1000)[0] == 301 and bernoulli_trials(30, 20, 1000)[2] == 211
        and math.ceil(bernoulli_trials(30, 20, 1000)[1]) == 24_728 and math.ceil(bernoulli_trials(30, 20, 1000)[3]) == 25_550,
        "Chebyshev (c=1000) = 600,600": answers.loc[1000, "Chebyshev"] == 600_600,
        "정확한 계산 (c=1000): 6,450 에서 처음, 6,520 부터 언제나": (answers.loc[1000, "exact_first"], answers.loc[1000, "exact_always"]) == (6450, 6520)})
text
        Bernoulli  Chebyshev  Hoeffding  normal  exact_first  exact_always
c
1000        25550     600600       9503    6498         6450          6520
10000       31258    6000600      12380    9083         9050          9096
100000      36965   60000600      15258   11707        11681         11720
  ✓  Bernoulli 공식 (c=1000): m = 301, 211 → 24,728 / 25,550
  ✓  Chebyshev (c=1000) = 600,600
  ✓  정확한 계산 (c=1000): 6,450 에서 처음, 6,520 부터 언제나
python
# 시뮬레이션으로 확인: n = 6,450 번 꺼내는 실험을 20만 번
n = 6450
phat = rng.binomial(n, p_, 200_000) / n
inside = np.mean((phat >= 29 / 50 - 1e-12) & (phat <= 31 / 50 + 1e-12))
print(f"n = {n}: 구간 안에 든 비율 {inside:.5f}   (목표 1000/1001 = {1000 / 1001:.5f},  정확 {1 - p_outside(n):.5f})")
print(f"Bernoulli 의 25,550 번에서 밖에 들 확률: {p_outside(25_550):.1e}  — 1000:1 이 아니라 약 {1 / p_outside(25_550):.1e} : 1")
d = answers.diff()
print("c 를 10배 할 때 늘어나는 시행 수:\n", d.dropna().astype(int).to_string())
text
n = 6450: 구간 안에 든 비율 0.99884   (목표 1000/1001 = 0.99900,  정확 0.99900)
Bernoulli 의 25,550 번에서 밖에 들 확률: 6.5e-11  — 1000:1 이 아니라 약 1.5e+10 : 1
c 를 10배 할 때 늘어나는 시행 수:
         Bernoulli  Chebyshev  Hoeffding  normal  exact_first  exact_always
c
10000        5708    5400000       2877    2585         2600          2576
100000       5707   54000000       2878    2624         2631          2624
표 읽기. 를 10배로 높일 때 Chebyshev는 시행 수가 10배 늘지만, 정확한 계산·정규근사·Hoeffding은 몇천 번을 더할 뿐이다. 꼬리 확률이 지수적으로 줄기 때문이다(8.1절). Bernoulli는 그의 공식에서 "5,708번씩 더하면 된다"고 썼다. 모양은 옳았고 상수가 두 배쯤 컸다.
6.5 일반적인 대수의 법칙과 Monte Carlo 적분
예제 6.4. , 오차의 표준편차 .
python
g = lambda x: np.exp(x**2)
I_true = integrate.quad(g, 0, 1)[0]
sigma_g = math.sqrt(integrate.quad(lambda x: g(x) ** 2, 0, 1)[0] - I_true**2)
ns = np.unique(np.logspace(1, 6, 30).astype(int))
err = [np.std([g(rng.random(n)).mean() for _ in range(200)]) if n <= 10**4 else
       np.std([g(rng.random(n)).mean() for _ in range(30)]) for n in ns]
fig, ax = plt.subplots(figsize=(8, 3.6))
ax.loglog(ns, err, "o", color=C["stat"], ms=5, label="sd of Monte Carlo estimate")
ax.loglog(ns, sigma_g / np.sqrt(ns), **THEORY, label=r"$\sigma_g/\sqrt{n}$")
ax.set_xlabel("n"); ax.set_ylabel("error"); ax.legend(); ax.set_title(r"Monte Carlo for $\int_0^1 e^{x^2}dx$: error $\propto 1/\sqrt{n}$")
plt.tight_layout(); plt.show()
print(f"∫ e^(x²) = {I_true:.4f},  σ_g² = {sigma_g**2:.4f},  Chebyshev 로 오차 0.01 을 99% 이상: n ≥ {sigma_g**2 / (0.01**2 * 0.01):,.0f}")
report({"예제 6.4: 오차 ∝ 1/√n (기울기 -1/2 ± 0.05)": abs(np.polyfit(np.log(ns), np.log(err), 1)[0] + 0.5) < 0.05})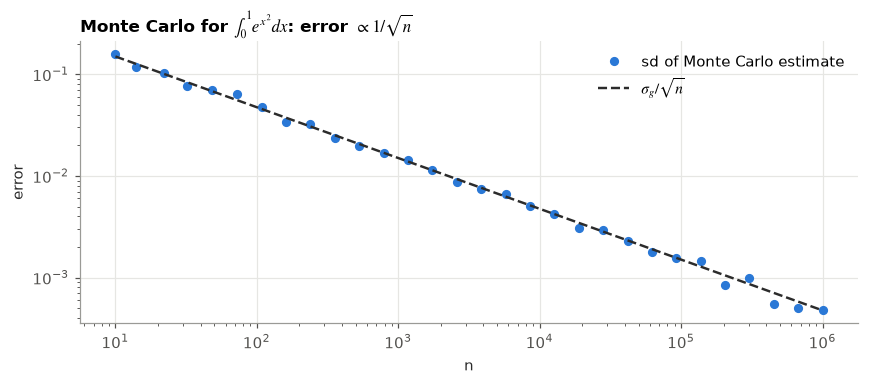
text
∫ e^(x²) = 1.4627,  σ_g² = 0.2251,  Chebyshev 로 오차 0.01 을 99% 이상: n ≥ 225,104
  ✓  예제 6.4: 오차 ∝ 1/√n (기울기 -1/2 ± 0.05)
6.6 상대도수와 확률 — Arbuthnot의 82년 (1629–1710)
대수의 법칙은 평균이 어디로 가는지 말한다. 분산은 그 모형이 맞는지 시험하게 한다. 출생이 독립이고 남아 확률이 해마다 같다면, 한 해의 남아 비율의 표준편차는 여야 한다. Lexis의 분산비 (연습 6.6)로 비교한다.
python
arb = load_rdata("Arbuthnot")
arb["N"] = arb.Males + arb.Females
arb["p"] = arb.Males / arb.N
P = arb.Males.sum() / arb.N.sum()
z = (arb.p - P) / np.sqrt(P * (1 - P) / arb.N)
Q2 = (z**2).sum() / (len(arb) - 1)
print(f"82년 전체 남아 비율 {P:.4f}   해마다 남아가 더 많았나: {bool((arb.Males > arb.Females).all())}")
print(f"연도 비율의 표준편차 {arb.p.std(ddof=1):.4f}   이항 모형의 예측 {np.sqrt(P * (1 - P) / arb.N).mean():.4f}")
print(f"Lexis 분산비 Q² = {Q2:.2f} (Q = {math.sqrt(Q2):.2f})   |z| > 2 인 해: {(np.abs(z) > 2).sum()} / 82 (모형이면 약 4)")

fig, axes = plt.subplots(1, 2, figsize=(12, 3.8))
axes[0].plot(arb.Year, np.cumsum(arb.Males) / np.cumsum(arb.N), color=C["stat"], label="cumulative proportion")
axes[0].plot(arb.Year, arb.p, ".", color=C["hist"], label="yearly proportion")
axes[0].axhline(P, **THEORY); axes[0].set_title("the proportion of boys settles (LLN)"); axes[0].legend(); axes[0].set_xlabel("year")
axes[1].hist(z, bins=np.linspace(-5, 5, 21), density=True, color=C["data"], alpha=0.8, label="observed z")
zz = np.linspace(-5, 5, 200)
axes[1].plot(zz, stats.norm.pdf(zz), **THEORY, label="binomial model (sd 1)")
axes[1].set_title(f"standardized yearly deviations: sd = {z.std(ddof=1):.2f}"); axes[1].legend(); axes[1].set_xlabel("z")
plt.tight_layout(); plt.show()
text
82년 전체 남아 비율 0.5163   해마다 남아가 더 많았나: True
연도 비율의 표준편차 0.0072   이항 모형의 예측 0.0048
Lexis 분산비 Q² = 2.09 (Q = 1.45)   |z| > 2 인 해: 13 / 82 (모형이면 약 4)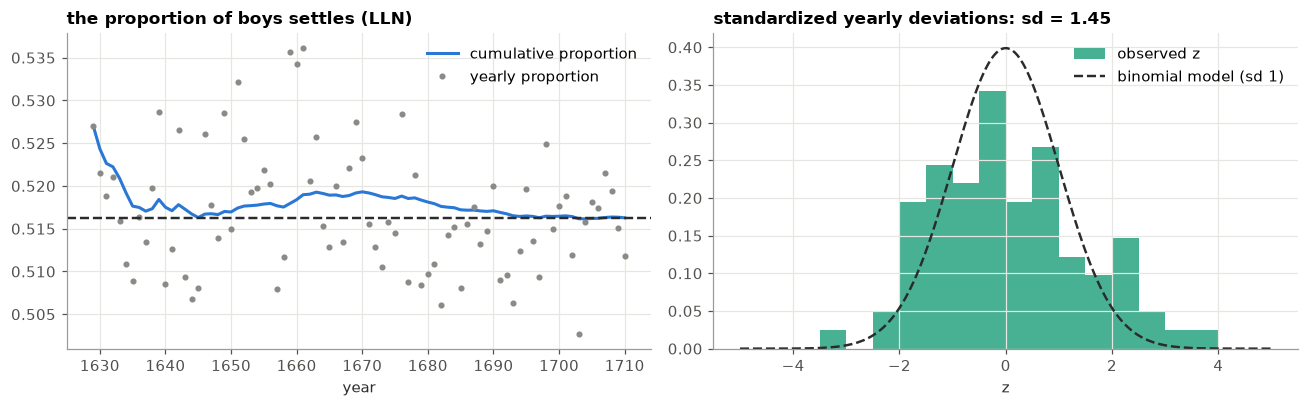
그림 읽기. 왼쪽: 누적 비율은 0.516에 정착한다. 대수의 법칙이 말한 대로다. 오른쪽: 그러나 해마다의 흔들림은 이항 모형이 허용하는 것보다 1.45배 크다. "확률 가 하나로 고정되어 있다"는 해석은 분산이 거부한다. 자료가 출생이 아니라 국교회 세례 기록이라는 사실, 내전기의 기록 혼란 같은 것이 후보다.
📝 연습 6.1–6.7 (강의노트): 여론조사의 표본 크기, Bernoulli의 공식, 주사위 평균, 쌍별 독립이면 충분, Poisson의 대수의 법칙, Lexis의 분산비, Bernoulli식 증명.
7. 부숴보기 — 가정을 빼면
7.1 기댓값이 무한대 — St. Petersburg (N. Bernoulli 1713, D. Bernoulli 1738)
상금 , 이면 . 그런데 상금의 중앙값은 2이고, 로그 효용의 확실성 등가는 두카트다. 평균 상금은 어떤 상수로도 수렴하지 않고 처럼 자란다(Feller 1945, 연습 7.3).
python
def st_petersburg(size):
    return 2.0 ** rng.geometric(0.5, size)

n = 2**16
paths = np.cumsum(st_petersburg((300, n)), axis=1) / np.arange(1, n + 1)
grid = 2 ** np.arange(4, 17) - 1
med = np.median(paths[:, grid], axis=0)
print(pd.DataFrame({"n": grid + 1, "median of average payoff": med.round(2), "log2 n": np.log2(grid + 1),
                    "ratio": (med / np.log2(grid + 1)).round(3)}).to_string(index=False))

capped = lambda cap_k: sum(2**k * 2.0**-k for k in range(1, cap_k + 1)) + 2**cap_k * 2.0**-cap_k
report({"E log2 X = Σ k 2^-k = 2 → 확실성 등가 4두카트": math.isclose(sum(k * 2.0**-k for k in range(1, 200)), 2),
        "연습 7.1: 은행 한도 2^20 이면 기대 상금 21": math.isclose(capped(20), 21)})

# 연습 7.2: 가진 돈 w 가 있을 때의 최대 참가비 c — Σ 2^-k log(w - c + 2^k) = log w
def max_fee(w):
    f = lambda c: sum(2.0**-k * math.log(w - c + 2.0**k) for k in range(1, 400)) - math.log(w)
    return optimize.brentq(f, 0, w + 1.9)
for w in [10, 100, 10_000, 10**6]:
    print(f"가진 돈 {w:>9,}두카트: 낼 의향이 있는 최대 참가비 {max_fee(w):6.2f}")
text
    n  median of average payoff  log2 n  ratio
   16                      6.12     4.0  1.531
   32                      7.41     5.0  1.481
   64                      8.30     6.0  1.383
  128                      9.84     7.0  1.406
  256                     10.91     8.0  1.364
  512                     11.72     9.0  1.302
 1024                     12.39    10.0  1.239
 2048                     13.69    11.0  1.245
 4096                     14.15    12.0  1.179
 8192                     15.24    13.0  1.172
16384                     16.40    14.0  1.171
32768                     17.30    15.0  1.153
65536                     18.87    16.0  1.179
  ✓  E log2 X = Σ k 2^-k = 2 → 확실성 등가 4두카트
  ✓  연습 7.1: 은행 한도 2^20 이면 기대 상금 21
가진 돈        10두카트: 낼 의향이 있는 최대 참가비   4.97
가진 돈       100두카트: 낼 의향이 있는 최대 참가비   7.79
가진 돈    10,000두카트: 낼 의향이 있는 최대 참가비  14.24
가진 돈 1,000,000두카트: 낼 의향이 있는 최대 참가비  20.87
7.2 기댓값이 없다 — Cauchy, 그리고 분산이 무한대인 Pareto
정규(분산 유한) · Pareto (평균 3, 분산 ) · Cauchy (평균 없음)의 누적 평균. Cauchy의 평균 은 다시 같은 Cauchy 분포를 따른다(7회). 아래 표에서 이 커져도 의 사분위 범위가 줄지 않는다.
python
n = 10**5
kk = np.arange(1, n + 1)
idx = np.unique(np.logspace(0, 5, 300).astype(int)) - 1
draws = {"normal": lambda: rng.standard_normal(n), "Pareto 1.5": lambda: (1 - rng.random(n)) ** (-1 / 1.5),
         "Cauchy": lambda: rng.standard_cauchy(n)}
fig, axes = plt.subplots(1, 3, figsize=(13, 3.6))
for ax, (name, draw), mu, ylim in zip(axes, draws.items(), [0, 3, None], [(-1.5, 1.5), (1, 7), (-8, 8)]):
    for _ in range(10):
        ax.plot(kk[idx], (np.cumsum(draw()) / kk)[idx], color=C["stat"], lw=0.8, alpha=0.6)
    if mu is not None:
        ax.axhline(mu, **THEORY)
    ax.set_xscale("log"); ax.set_ylim(*ylim); ax.set_title(name); ax.set_xlabel("n")
plt.tight_layout(); plt.show()

rows = []
for m in [1, 10, 100, 1000]:
    means = rng.standard_cauchy((20_000, m)).mean(axis=1)
    rows.append(dict(n=m, IQR_of_mean=np.subtract(*np.percentile(means, [75, 25]))))
print(pd.DataFrame(rows).round(3).to_string(index=False), "   (Cauchy 의 IQR = 2)")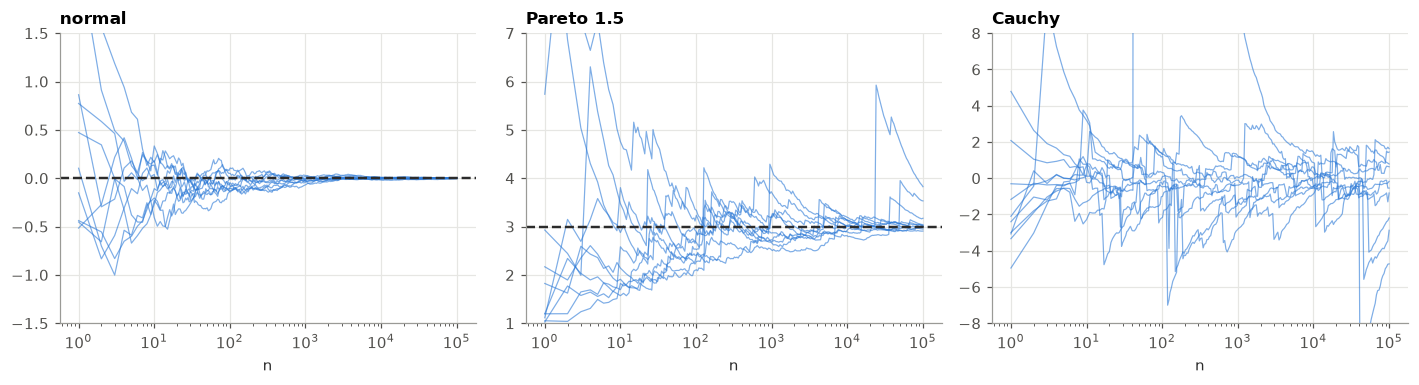
text
   n  IQR_of_mean
   1        1.995
  10        1.986
 100        2.015
1000        2.028    (Cauchy 의 IQR = 2)
7.3 적률이 분포를 정하지 못한다 — Heyde (1963)
정리 7.1. 로그정규 밀도 와 는 모든 적률 가 같다.
수치적분으로 의 적률을 계산한다. 그리고 로그정규에 mgf가 없다는 것(연습 7.4)을 의 절단 적분이 끝없이 자라는 것으로 본다.
python
f_ln = lambda x: stats.lognorm.pdf(x, 1)
f_a = lambda x, a: f_ln(x) * (1 + a * np.sin(2 * np.pi * np.log(x)))
def moment(f, k):                                   # x = e^y 로 바꿔 적분 (꼬리를 정확히)
    return integrate.quad(lambda y: np.exp(k * y) * f(np.exp(y)) * np.exp(y), -12, 12 + k, limit=400)[0]
table = pd.DataFrame({k: [moment(f_ln, k), moment(lambda x: f_a(x, 0.5), k), moment(lambda x: f_a(x, -0.5), k), math.exp(k * k / 2)]
                      for k in range(5)}, index=["lognormal", "a = +0.5", "a = -0.5", "e^(k²/2)"]).T
print(table.round(4).to_string())
report({"정리 7.1: 세 분포의 k차 적률이 모두 e^(k²/2) (k ≤ 4)": np.allclose(table.values, table[["e^(k²/2)"]].values, rtol=1e-6)})
print("로그정규에는 mgf 가 없다 (연습 7.4): t = 0.1 에서 잘라 낸 적분")
for T in [100, 200, 300, 400]:
    val = integrate.quad(lambda x: np.exp(0.1 * x) * f_ln(x), 0, T, limit=800, points=[1, 10, 50])[0]
    print(f"  ∫_0^{T} e^(0.1 x) f(x) dx = {val:.3g}")
text
   lognormal   a = +0.5   a = -0.5   e^(k²/2)
0     1.0000     1.0000     1.0000     1.0000
1     1.6487     1.6487     1.6487     1.6487
2     7.3891     7.3891     7.3891     7.3891
3    90.0171    90.0171    90.0171    90.0171
4  2980.9580  2980.9580  2980.9580  2980.9580
  ✓  정리 7.1: 세 분포의 k차 적률이 모두 e^(k²/2) (k ≤ 4)
로그정규에는 mgf 가 없다 (연습 7.4): t = 0.1 에서 잘라 낸 적분
  ∫_0^100 e^(0.1 x) f(x) dx = 1.28
  ∫_0^200 e^(0.1 x) f(x) dx = 13
  ∫_0^300 e^(0.1 x) f(x) dx = 1.6e+04
  ∫_0^400 e^(0.1 x) f(x) dx = 4.59e+07
7.4 독립이 아니면
이면 이다. 중간 정도의 의존도 같은 일을 덜 극적으로 한다. 이웃 관측끼리 상관이 있는 수열(AR(1), )의 표본평균은 독립일 때보다 훨씬 천천히 정착한다. 3회에서 근사와 유효 표본 크기를 유도한다.
python
def ar1(n, rho, size):
    x = np.empty((size, n)); x[:, 0] = rng.standard_normal(size)
    e = rng.standard_normal((size, n)) * math.sqrt(1 - rho**2)
    for t in range(1, n):
        x[:, t] = rho * x[:, t - 1] + e[:, t]
    return x

n = 1000
for rho in [0.0, 0.5, 0.9]:
    sd = ar1(n, rho, 2000).mean(axis=1).std()
    print(f"ρ = {rho}: sd(X̄) = {sd:.4f}   독립이면 1/√n = {1 / math.sqrt(n):.4f}   비 {sd * math.sqrt(n):.2f}  (√((1+ρ)/(1-ρ)) = {math.sqrt((1 + rho) / (1 - rho)):.2f})")
text
ρ = 0.0: sd(X̄) = 0.0318   독립이면 1/√n = 0.0316   비 1.00  (√((1+ρ)/(1-ρ)) = 1.00)
ρ = 0.5: sd(X̄) = 0.0546   독립이면 1/√n = 0.0316   비 1.73  (√((1+ρ)/(1-ρ)) = 1.73)
ρ = 0.9: sd(X̄) = 0.1424   독립이면 1/√n = 0.0316   비 4.50  (√((1+ρ)/(1-ρ)) = 4.36)
📝 연습 7.1–7.5 (강의노트): 은행의 한도, 가진 돈이 있으면, Feller의 정규화, 로그정규에는 mgf가 없다, 어떤 적률이 있나.
8. Beautiful insights — 같은 도구, 오늘의 문제
8.1 지수적 집중: Chernoff와 Hoeffding
정리 8.1 · 정리 8.2 .
Hoeffding의 증명에 쓴 을 확인하고, 세 한계를 정확한 꼬리와 비교한다.
python
D = lambda a, p: a * np.log(a / p) + (1 - a) * np.log((1 - a) / (1 - p))
eps_grid = np.linspace(1e-4, 0.39, 400)
report({"Pinsker (Bernoulli): D(p+ε||p) ≥ 2ε² (p = 0.6, 모든 ε)": np.all(D(0.6 + eps_grid, 0.6) >= 2 * eps_grid**2 - 1e-15),
        "Chernoff 지수: sup_t [ta - log(q+pe^t)] == D(a||p) (a = 0.62)":
            math.isclose(-optimize.minimize_scalar(lambda t: -(t * 0.62 - np.log(0.4 + 0.6 * np.exp(t))), bounds=(0, 5), method="bounded").fun,
                         D(0.62, 0.6), rel_tol=1e-6)})

ns = np.arange(200, 30_001, 100)
exact = stats.binom.cdf(np.floor(ns * 0.58 + 1e-9), ns, 0.6) + stats.binom.sf(np.ceil(ns * 0.62 - 1e-9) - 1, ns, 0.6)
fig, ax = plt.subplots(figsize=(9, 4))
ax.semilogy(ns, exact, color=C["stat"], lw=2.2, label=r"exact $P(|\hat p-p|\geq0.02)$")
ax.semilogy(ns, np.minimum(1, 0.24 / (ns * 0.02**2)), color=C["assume"], label="Chebyshev")
ax.semilogy(ns, np.minimum(1, np.exp(-ns * D(0.62, 0.6)) + np.exp(-ns * D(0.58, 0.6))), color=C["data"], label="Chernoff")
ax.semilogy(ns, np.minimum(1, 2 * np.exp(-2 * ns * 0.02**2)), color=C["key"], label="Hoeffding")
ax.axhline(1 / 1001, **THEORY); ax.set_ylim(1e-9, 1.5); ax.set_xlabel("n"); ax.legend()
ax.set_title("Chebyshev decays like 1/n, the others exponentially")
plt.tight_layout(); plt.show()
n_chernoff = next(n for n in range(1000, 30_000) if math.exp(-n * D(0.62, 0.6)) + math.exp(-n * D(0.58, 0.6)) <= 1 / 1001)
print("1/1001 에 닿는 n — Chernoff:", n_chernoff, "  Hoeffding:", math.ceil(math.log(2002) / (2 * 0.02**2)))
report({"정리 8.1 로 Bernoulli 의 질문: 9,121번": n_chernoff == 9121})
text
  ✓  Pinsker (Bernoulli): D(p+ε||p) ≥ 2ε² (p = 0.6, 모든 ε)
  ✓  Chernoff 지수: sup_t [ta - log(q+pe^t)] == D(a||p) (a = 0.62)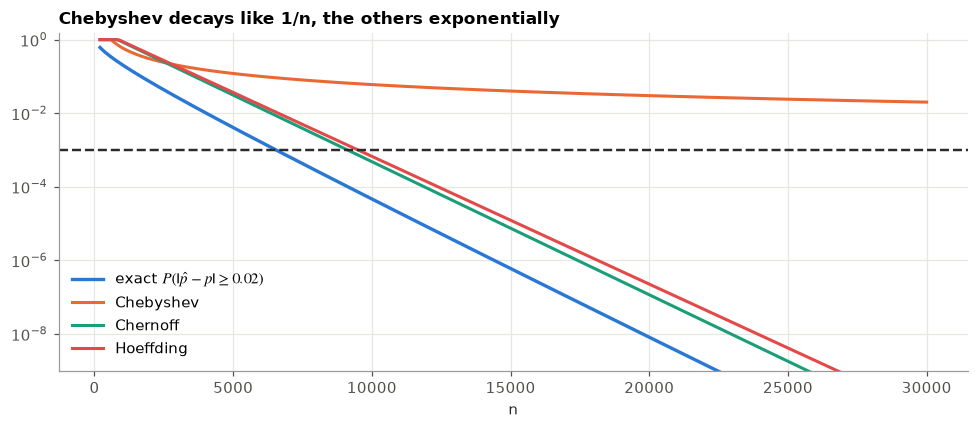
text
1/1001 에 닿는 n — Chernoff: 9121   Hoeffding: 9503
  ✓  정리 8.1 로 Bernoulli 의 질문: 9,121번
python
# 학습 이론: |H| 개의 후보를 동시에 ±ε 로 (Boole + Hoeffding)
pac_n = lambda H, eps, delta: math.ceil(math.log(2 * H / delta) / (2 * eps**2))
print(pd.DataFrame({"|H|": [1, 10, 10**3, 10**6, 10**9],
                    "n (ε = 0.02, δ = 0.01)": [pac_n(H, 0.02, 0.01) for H in [1, 10, 10**3, 10**6, 10**9]]}).to_string(index=False))
# 시뮬레이션: 오류율이 모두 0.3 인 분류기 1,000개를 n 개 표본으로 평가하면, 가장 작아 보이는 것은 얼마나 낙관적인가
H, true_err = 1000, 0.3
for n in [100, 1000, pac_n(H, 0.02, 0.01)]:
    best = (rng.binomial(n, true_err, (500, H)) / n).min(axis=1)
    print(f"n = {n:>6}: 1,000개 가운데 가장 좋아 보이는 오류율의 평균 {best.mean():.3f}  (참 0.300)")
text
       |H|  n (ε = 0.02, δ = 0.01)
         1                    6623
        10                    9502
      1000                   15258
   1000000                   23893
1000000000                   32527
n =    100: 1,000개 가운데 가장 좋아 보이는 오류율의 평균 0.160  (참 0.300)
text
n =   1000: 1,000개 가운데 가장 좋아 보이는 오류율의 평균 0.253  (참 0.300)
n =  15258: 1,000개 가운데 가장 좋아 보이는 오류율의 평균 0.288  (참 0.300)
표 읽기. 후보 1,000개를 100개의 표본으로 평가하면, 모두 오류율이 0.3인데도 가장 좋아 보이는 것은 0.17쯤으로 보인다. 고르는 행위가 낙관을 만든다. 표본이 PAC 크기에 이르면 그 착시가 안으로 줄어든다. 검증 세트를 따로 두는 이유다.
8.2 Jensen과 정보: KL ≥ 0, 교차 엔트로피, ELBO
python
def kl(p, q):
    p, q = np.asarray(p, float), np.asarray(q, float)
    m = p > 0
    return float(np.sum(p[m] * np.log(p[m] / q[m])))

fair = np.ones(6) / 6
weldon_q = np.r_[np.full(4, (1 - p_hat) / 4), np.full(2, p_hat / 2)]      # 면 1–4 와 면 5·6
report({"Gibbs: D(p||q) ≥ 0 (무작위 분포 1,000쌍)": all(kl(a, b) >= -1e-12 for a, b in (rng.dirichlet(np.ones(5), 2) for _ in range(1000))),
        "D(p||p) = 0": kl(fair, fair) == 0,
        "교차 엔트로피 = H(p) + D(p||q)": math.isclose(-np.sum(fair * np.log(weldon_q)), -np.sum(fair * np.log(fair)) + kl(fair, weldon_q))})
print(f"연습 8.2: D(fair || Weldon) = {kl(fair, weldon_q):.3e}   D(Weldon || fair) = {kl(weldon_q, fair):.3e}")
print(f"Weldon 의 {12 * n_throws:,}개 굴림에서 n·D = {12 * n_throws * kl(weldon_q, fair):.1f} nats")

# ELBO: 숨은 변수 z ∈ {0,1,2} 인 작은 모형에서 log p(x) ≥ Σ r(z) log(p(x,z)/r(z)), 등호는 r = p(z|x)
p_xz = np.array([0.05, 0.12, 0.03])                  # 관측 x 하나에 대한 p(x, z)
log_px = np.log(p_xz.sum())
elbo = lambda r: float(np.sum(r * (np.log(p_xz) - np.log(r))))
rs = rng.dirichlet(np.ones(3), 2000)
report({"ELBO ≤ log p(x) (무작위 r 2,000개)": all(elbo(r) <= log_px + 1e-12 for r in rs),
        "r = p(z|x) 이면 ELBO == log p(x)": math.isclose(elbo(p_xz / p_xz.sum()), log_px)})
text
  ✓  Gibbs: D(p||q) ≥ 0 (무작위 분포 1,000쌍)
  ✓  D(p||p) = 0
  ✓  교차 엔트로피 = H(p) + D(p||q)
연습 8.2: D(fair || Weldon) = 4.244e-05   D(Weldon || fair) = 4.254e-05
Weldon 의 315,672개 굴림에서 n·D = 13.4 nats
  ✓  ELBO ≤ log p(x) (무작위 r 2,000개)
  ✓  r = p(z|x) 이면 ELBO == log p(x)
8.3 Kelly (1956) — Daniel Bernoulli의 로그 효용, 다시
이길 확률 인 같은 배당의 내기를 1,000번. 가진 돈의 비율 를 건다. 대수의 법칙으로 이고, 를 최대로 하는 것은 다(연습 8.3).
python
p_win, n_bets = 0.6, 1000
G = lambda f: p_win * np.log(1 + f) + (1 - p_win) * np.log(1 - f)
R = np.where(rng.random((2000, n_bets)) < p_win, 1, -1)
fig, axes = plt.subplots(1, 2, figsize=(12, 3.8))
for f, col in zip([0.1, 0.2, 0.4], SERIES):
    logW = np.cumsum(np.log(1 + f * R), axis=1)
    axes[0].plot(np.median(logW, axis=0), color=col, label=f"f = {f}: G = {G(f):+.4f}")
    axes[0].fill_between(np.arange(n_bets), *np.percentile(logW, [10, 90], axis=0), color=col, alpha=0.12, lw=0)
    print(f"f = {f}: (1/n) log W_n 의 평균 {logW[:, -1].mean() / n_bets:+.4f}  (G(f) = {G(f):+.4f})   파산에 가까운(W < 0.01) 비율 {np.mean(logW[:, -1] < np.log(0.01)):.3f}")
axes[0].set_xlabel("bet number"); axes[0].set_ylabel("log wealth (median, 10–90%)"); axes[0].legend(); axes[0].set_title("Kelly: log wealth grows at rate G(f)")
ff = np.linspace(0, 0.6, 200)
axes[1].plot(ff, G(ff), color=C["stat"]); axes[1].axvline(0.2, color=C["key"], lw=1.5, label="f* = p - q")
axes[1].axhline(0, color=C["hist"], lw=0.8); axes[1].set_xlabel("fraction f"); axes[1].set_title("growth rate G(f)"); axes[1].legend()
plt.tight_layout(); plt.show()
report({"연습 8.3: G 를 최대로 하는 f = p - q": abs(ff[np.argmax(G(ff))] - 0.2) < 0.005, "f = 0.4 이면 G < 0": G(0.4) < 0})
text
f = 0.1: (1/n) log W_n 의 평균 +0.0150 (G(f) = +0.0150) 파산에 가까운(W < 0.01) 비율 0.000text
f = 0.2: (1/n) log W_n 의 평균 +0.0200  (G(f) = +0.0201)   파산에 가까운(W < 0.01) 비율 0.000
f = 0.4: (1/n) log W_n 의 평균 -0.0027  (G(f) = -0.0024)   파산에 가까운(W < 0.01) 비율 0.425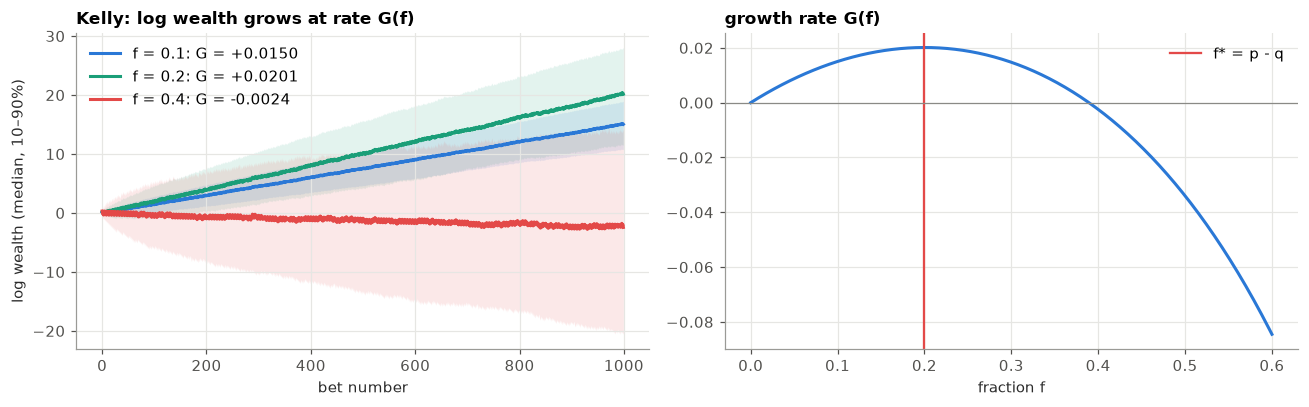
text
  ✓  연습 8.3: G 를 최대로 하는 f = p - q
  ✓  f = 0.4 이면 G < 0
그림 읽기. 는 판마다 유리한 내기에 돈을 더 많이 거는데도 가진 돈이 줄어든다. 기댓값 은 가 클수록 크지만, 그 기댓값은 극소수의 운 좋은 경로가 만든다. St. Petersburg와 같은 교훈이다. 기댓값을 최대로 하는 것과 거의 확실하게 잘 되는 것은 다르다.
📝 연습 8.1–8.4 (강의노트): Hoeffding의 여론조사, 두 주사위의 KL, Kelly 비율, 후보가 많을 때.
9. 정리 · 연습문제 지도 · 다음 회
| 내용 | 확인한 셀 | |
|---|---|---|
| 기댓값 (1.1, 1.5) | 합·적분, Cauchy는 없다 | 1.2, 1.3 |
| 함수의 기댓값 · 선형성 (1.9–1.11) | 의 분포로 == 바로, Montmort | 1.4 |
| 꼬리 공식 (1.13) | 기하·지수·혼합형, Halley 기대여명 | 1.5 |
| 분산 (2.2) | 은 평균에서, 는 중앙값에서 최소 | 2.1 |
| 이항 · 독립합 (2.4, 2.8) | , 주사위 합의 분산, Bernstein, 초기하 | 2.2, 2.3 |
| Weldon (2.11, 5.5) | 평균이 5 표준편차 벗어남, Chebyshev | 2.4, 5.1 |
| mgf (3.3, 3.6) | 수치 미분 = 적률, 곱 = 이항, Sicherman | 3절 |
| 변수변환 · 역변환 표집 (4.3, 4.7) | KS 대조, 보정 히스토그램, Benford | 4절 |
| 부등식 (5.1, 5.3, 5.9) | 한계 vs 실제, Lyapunov | 5절 |
| 대수의 법칙 (6.2, 6.3) | 다섯 답, Monte Carlo , Arbuthnot | 6절 |
| 부숴보기 (7.1) | St. Petersburg , Cauchy, Heyde, AR(1) | 7절 |
| 지수적 집중 · 정보 (8.1–8.3) | Chernoff·Hoeffding, PAC, KL, ELBO, Kelly | 8절 |
연습문제 지도 (강의노트, ★ 계산 · ★★ 증명 · ★★★ 도전, 풀이는 부록 A)
| 절 | 연습 | 이 노트북에서 확인하는 셀 |
|---|---|---|
| 0 | 0.1 재배열 ★★ · 0.2 재배열 정리의 증명 ★★ (유도형) | 0.2 |
| 1 기댓값 | 1.1 룰렛 ★ · 1.2 Huygens ★★ · 1.3 무한대 ★ · 1.4 조건수렴 ★★ · 1.5 쿠폰 ★★ · 1.6 제곱의 꼬리 ★★ · 1.7 기대여명 ★ · 1.8 Cauchy ★★ · 1.9 함수의 기댓값 증명 ★★ (유도형) | 1.3, 1.5 |
| 2 분산 | 2.1 ★ · 2.2 중앙값 ★★ · 2.3 기하 ★★ · 2.4 에이스 ★★ · 2.5 Bernstein ★★ · 2.6 ★ · 2.7 모양 ★ · 2.8 ★★ · 2.9 Weldon ★ · 2.10 분산의 계산 ★ · 2.11 이항 ★★ · 2.12 곱의 기댓값 ★★ (유도형) | 2.1–2.4 |
| 3 mgf | 3.1 ★ · 3.2 ★ · 3.3 ★ · 3.4 ★★ · 3.5 누율 ★★ · 3.6 Sicherman ★★★ | 3절 |
| 4 변환 | 4.1 ★ · 4.2 ★★ · 4.3 Benford ★★ · 4.4 Cauchy ★★ · 4.5 혼합형 ★ · 4.6 Pareto ★ · 4.7 ★ · 4.8 단조인 경우의 기댓값 ★★ (유도형) | 4절 |
| 5 부등식 | 5.1 ★ · 5.2 ★ · 5.3 Cantelli ★★★ · 5.4 ★★ · 5.5 ★★ · 5.6 ★★ · 5.7 속력 ★ · 5.8 분산이 0이면 상수 ★ · 5.9 Jensen의 따름정리 ★★ (유도형) | 5절 |
| 6 대수의 법칙 | 6.1 여론조사 ★ · 6.2 Bernoulli 공식 ★ · 6.3 ★ · 6.4 ★★ · 6.5 Poisson ★★ · 6.6 Lexis ★ · 6.7 Bernoulli식 증명 ★★★ | 6절 |
| 7 · 8 | 7.1 ★ · 7.2 ★★ · 7.3 Feller ★★★ · 7.4 ★★ · 7.5 ★ · 8.1 ★ · 8.2 ★ · 8.3 Kelly ★★ · 8.4 PAC ★ | 7절, 8절 |
다음 회 (3회) — 왜 평균을 내는가: 의 발견 (1755 → 1958). 이번 회차의 여러 정리에는 "이산에서 증명, 연속은 3회"라는 꼬리표가 붙어 있었다. 3회는 결합분포·주변분포·조건부분포·공분산으로 그 꼬리표를 뗀다. Thomas Simpson(1755)은 천문 관측을 평균내는 것이 정말 나은지를 처음으로 계산했고, 런던 조폐국의 금화 검사(Pyx 재판)는 수백 년 동안 허용오차를 에 비례하게 잡는 실수를 했다. 7.4절의 AR(1)이 보여 준 "유효 표본 크기"도 그때 유도한다.
10. 워크북 검산
워크북(02_expectation_workbook.pdf)의 문제는 손으로 먼저 푼다. 이 절은 다 푼 뒤에 쓴다.
check("A3", "161/36")— 문항 번호와 손으로 구한 답을 넣으면 맞는지만 알려 준다. 정답은 보여 주지 않는다. 답은 수(161/36,4.472)나 식의 문자열("2*y","(1-u)**(-1/2) - 1")로 넣는다. 소문항은"A10a"처럼 번호 뒤에 붙인다. 소수로 넣으면 상대오차 0.1%까지 맞다고 본다. D3의 는lam으로 쓴다.- 시뮬레이션으로 한 번 더 — 기댓값이나 확률이 답인 문항은 아래에 시뮬레이션 함수를 정의해 두었다. 손으로 구한 값이 Monte Carlo 구간 안에 드는지 본다. 함수는 정의만 해 두었고 부르지 않았다. 답을 구하기 전에 부르면 답이 보인다.
증명 문제(B, C의 대부분)는 check()가 없다. 풀이판의 증명과 단계별로 맞춰 본다.
답 열쇠 셀 (내려받은 노트북에서 실행된다)
답 열쇠를 압축해 넣은 check() 정의 셀이다. 웹에서는 이 회차의 답 확인 페이지를 쓴다.
python
check()                 # 확인할 수 있는 문항 번호
check("A3")             # 답을 넣지 않으면 쓰는 법을 알려 준다
text
확인할 수 있는 문항: A1a A1b A1c A1d A2a A2b A2c A3 A4 A5a A5b A6a A6b A6c A6d A7b A7c A7d A8a A8b A8c A9a A9b A10a A10b A10c A11a A11b A12 A13a A13b A13c A14a A14b C7c C8b C8c D1c D1d D2a D2b D2d D2e D3b D3d D4a
A3: 아직 답을 넣지 않았다. 예: check('A3', '3/8')
10.1 내 답을 모아 확인하기
푼 문항의 답을 아래 사전에 채우고 실행한다. None인 문항은 건너뛴다.
python
mine = {
    "A1a": None, "A1b": None, "A1c": None, "A1d": None, "A2a": None, "A2b": None, "A2c": None,
    "A3": None, "A4": None, "A5a": None, "A5b": None,
    "A6a": None, "A6b": None, "A6c": None, "A6d": None, "A7b": None, "A7c": None, "A7d": None,
    "A8a": None, "A8b": None, "A8c": None, "A9a": None, "A9b": None, "A10a": None, "A10b": None, "A10c": None,
    "A11a": None, "A11b": None, "A12": None, "A13a": None, "A13b": None, "A13c": None, "A14a": None, "A14b": None,
    "C7c": None, "C8b": None, "C8c": None,
    "D1c": None, "D1d": None, "D2a": None, "D2b": None, "D2d": None, "D2e": None, "D3b": None, "D3d": None, "D4a": None,
}
check_all(mine)
text
0/0 맞음10.2 시뮬레이션 함수
각 함수는 (추정값, 표준오차)를 돌려준다. 손으로 구한 값이 추정값 ± 3 × 표준오차 안에 들면 계산이 맞을 가능성이 높다. 정확한 검산은 check()가 한다.
| 함수 | 문항 | 시뮬레이션 |
|---|---|---|
sim_A3() |
A3 두 주사위의 최댓값 | 주사위 2개 |
sim_A4() |
A4 이웃한 두 에이스 | 카드 52장 섞기 |
sim_A5() |
A5 나오지 않은 눈의 수(평균) | 주사위 10번 |
sim_A9() |
A9 , | 역변환 표집 |
sim_A14() |
A14 연속형 꼬리 공식 | 역변환 표집 |
sim_C8(n, p) |
C8 성공 수가 짝수일 확률 | 이항 |
sim_D1(i, N) |
D1 무작위 걸음의 기대 판 수 | 걸음 |
sim_D2() |
D2 | 역변환 표집 |
sim_D3(lam, s) |
D3 남은 기다림의 평균 | 지수분포 |
sim_D4(n, p) |
D4 | 이항 |
python
def mc_mean(values):
    """표본평균과 그 표준오차 s/√n"""
    values = np.asarray(values, dtype=float)
    return values.mean(), values.std(ddof=1) / np.sqrt(values.size)


def mc_prob(event, n=N_SIM):
    """event(n) 이 길이 n의 불리언 배열을 돌려주면, 상대도수와 표준오차 √(p̂(1-p̂)/n)"""
    hits = np.asarray(event(n), dtype=bool)
    p = hits.mean()
    return p, np.sqrt(p * (1 - p) / n)


def sim_A3(n=N_SIM):
    return mc_mean(rng.integers(1, 7, size=(n, 2)).max(axis=1))


def sim_A4(n=50_000):
    is_ace = np.argsort(rng.random((n, 52)), axis=1) < 4          # 섞은 순서에서 카드 0–3을 에이스로
    return mc_mean((is_ace[:, :-1] & is_ace[:, 1:]).sum(axis=1))


def sim_A5(n=N_SIM):
    rolls = rng.integers(1, 7, size=(n, 10))
    missing = 6 - np.array([(rolls == f).any(axis=1) for f in range(1, 7)]).sum(axis=0)
    return mc_mean(missing)


def sim_A9(n=N_SIM):
    return mc_mean(np.exp(-rng.exponential(1 / 2, size=n)))


def sim_A14(n=N_SIM):
    return mc_mean(rng.random(n) ** (-1 / 3) - 1)               # P(X > x) = (1+x)^-3 의 역변환


def sim_C8(n_trials, p, n=N_SIM):
    return mc_prob(lambda m: rng.binomial(n_trials, p, size=m) % 2 == 0, n)


def sim_D1(i, N, n=40_000):
    x = np.full(n, i)
    steps = np.zeros(n, dtype=int)
    alive = np.ones(n, dtype=bool)
    while alive.any():
        x[alive] += np.where(rng.random(alive.sum()) < 0.5, 1, -1)
        steps[alive] += 1
        alive &= (x > 0) & (x < N)
    return mc_mean(steps)


def sim_D2(n=N_SIM):
    u = 1 - rng.random(n)                                         # (0, 1]
    x = np.floor((-1 + np.sqrt(1 + 8 / u)) / 2)                   # P(X >= m) = 2/(m(m+1)) 의 역변환
    return mc_prob(lambda m: x >= 10, n)


def sim_D3(lam, s, n=N_SIM):
    x = rng.exponential(1 / lam, size=n)
    return mc_mean(x[x > s] - s)


def sim_D4(n_trials, p, n=N_SIM):
    return mc_mean((rng.binomial(n_trials, p, size=n) / n_trials) ** 2)
python
# 자체 검사 (출력 없음): 시뮬레이션이 답 열쇠와 맞는지, check()가 답 열쇠의 값과 그 소수를 맞다고 하는지 확인한다.
def _close(sim, key, z=4.0, **pt):
    est, se = sim
    return abs(est - _value(key, **pt)) <= z * se + 1e-12

assert _close(sim_A3(), "A3")
assert _close(sim_A4(), "A4")
assert _close(sim_A5(), "A5a")
assert _close(sim_A9(), "A9b")
assert _close(sim_A14(), "A14a")
assert _close(sim_C8(10, 0.3), "C8b", p=0.3, n=10)
assert _close(sim_D1(3, 10), "D1d")
assert _close(sim_D2(), "D2d")
assert _close(sim_D3(2.0, 0.7), "D3b", lam=2.0)
assert _close(sim_D4(5, 0.3), "D4a", p=0.3, n=5)
for _k, _e in _WB.items():
    assert _same(_e, _e["value"])
    if not _e.get("vars") and "points" not in _e:
        assert _same(_e, float(sp.sympify(_e["value"])))