Skip to content

3회 · 왜 평균을 내는가 · 노트

2 조건부분포와 조건부기댓값 ​

XX의 값을 알면 YY에 대해 무엇을 말할 수 있나? 1회의 조건부확률을 확률변수로 넓힌 것이 조건부분포이고, 그 평균이 조건부기댓값이다. 이 절의 두 정리, 곧 반복기댓값과 전분산 공식은 이후 회차에서 가장 자주 쓰이는 도구 가운데 하나다. 5회의 Galton 회귀, 10회의 EM 알고리즘, 16회의 계층 베이즈 모형이 모두 이 두 줄 위에 선다.

2.1 조건부분포 ​

정의 2.1 (조건부 확률질량함수) 이산이고 pX(x)>0p_X(x)>0이면 X=xX=x일 때 YY의 조건부 확률질량함수를

pY∣X(y∣x)=P(Y=y∣X=x)=pX,Y(x,y)pX(x)p_{Y\mid X}(y\mid x)=P(Y=y\mid X=x)=\frac{p_{X,Y}(x,y)}{p_X(x)}

로 정의한다.

1회 정의 5.1을 사건 {X=x}\{X=x\}와 {Y=y}\{Y=y\}에 쓴 것이다. xx를 고정하면 y↦p(y∣x)y\mapsto p(y\mid x)는 음이 아니고 합이 1이므로 확률질량함수다(1회 정리 5.2). 연속이면 P(X=x)=0P(X=x)=0이어서 이 정의를 쓸 수 없다. 대신 밀도의 비를 쓴다.

정의 2.2 (조건부 밀도) 연속이고 fX(x)>0f_X(x)>0이면 X=xX=x일 때 YY의 조건부 밀도를

fY∣X(y∣x)=fX,Y(x,y)fX(x)f_{Y\mid X}(y\mid x)=\frac{f_{X,Y}(x,y)}{f_X(x)}

로 정의한다.

정리 1.6로 ∫fY∣X(y∣x) dy=fX(x)/fX(x)=1\int f_{Y\mid X}(y\mid x)\,dy=f_X(x)/f_X(x)=1이므로 밀도다. 정당화는 극한으로 한다. h→0h\to0이면

P(Y≤y∣x<X≤x+h)=∫xx+h ⁣∫−∞yf(s,t) dt ds∫xx+hfX(s) ds ⟶ ∫−∞yf(x,t)fX(x) dtP(Y\le y\mid x<X\le x+h)=\frac{\int_x^{x+h}\!\int_{-\infty}^yf(s,t)\,dt\,ds}{\int_x^{x+h}f_X(s)\,ds}\ \longrightarrow\ \int_{-\infty}^y\frac{f(x,t)}{f_X(x)}\,dt

(ff가 연속인 점에서). “XX가 xx 근처에 있다”는 확률이 양수인 사건에 조건을 걸고 극한을 취한 것이다. 이 극한을 어떻게 취하느냐가 답을 바꿀 수 있다는 것이 7.1절의 Borel 역설이다.

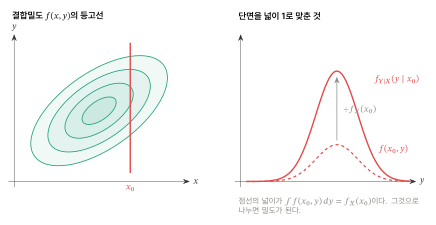
그림으로 읽으면 조건부 밀도는 결합밀도의 단면이다. xx에서 결합밀도를 세로로 자르고, 그 단면의 넓이가 1이 되도록 fX(x)f_X(x)로 나눈 것이다(그림 2.1).

그림 2.1. 결합밀도의 단면이 조건부 밀도다. X=x_0에서 자른 곡선을 그 넓이 f_X(x_0)로 나누면 f_Y|X(y|x_0)가 된다.
그림 2.1 결합밀도의 단면이 조건부 밀도다. X=x0X=x_0에서 자른 곡선을 그 넓이 fX(x0)f_X(x_0)로 나누면 fY∣X(y∣x0)f_{Y\mid X}(y\mid x_0)가 된다.

예제 2.3 (원판의 단면) 예제 1.7에서 ∣x∣<1|x|<1이면

fY∣X(y∣x)=1/π2π1−x2=121−x2,∣y∣≤1−x2.f_{Y\mid X}(y\mid x)=\frac{1/\pi}{\tfrac2\pi\sqrt{1-x^2}}=\frac1{2\sqrt{1-x^2}},\qquad |y|\le\sqrt{1-x^2}.

X=xX=x를 알면 YY는 구간 [−1−x2,1−x2][-\sqrt{1-x^2},\sqrt{1-x^2}] 위의 균등분포다. 결합분포가 균등하면 단면도 균등하다.

2.2 조건부기댓값 ​

정의 2.4 (조건부기댓값) X=xX=x일 때 YY의 조건부분포의 평균

E(Y∣X=x)=∑yy p(y∣x)또는∫y f(y∣x) dyE(Y\mid X=x)=\sum_yy\,p(y\mid x)\quad\text{또는}\quad\int y\,f(y\mid x)\,dy

를 조건부기댓값이라 한다. 이것은 xx의 함수 m(x)m(x)이고, 그 함수에 XX를 넣은 확률변수 m(X)m(X)를 E(Y∣X)E(Y\mid X)로 쓴다. 같은 방법으로 E(g(Y)∣X)E(g(Y)\mid X)와 Var⁡(Y∣X)=E[(Y−E(Y∣X))2∣X]\Var(Y\mid X)=E\bigl[(Y-E(Y\mid X))^2\mid X\bigr]를 정의한다.

E(Y∣X=x)E(Y\mid X=x)는 수이고 E(Y∣X)E(Y\mid X)는 확률변수다. 이 구별이 다음 정리의 핵심이다. 그림 1.1의 빨간 점이 m(x)=E(S∣M=m)m(x)=E(S\mid M=m)이다.

정리 2.5 (반복기댓값) E∣Y∣<∞E|Y|<\infty이면

E[E(Y∣X)]=EY.E\bigl[E(Y\mid X)\bigr]=EY .

더 일반적으로 E∣g(X)Y∣<∞E|g(X)Y|<\infty이면 E[g(X) E(Y∣X)]=E[g(X) Y]E\bigl[g(X)\,E(Y\mid X)\bigr]=E\bigl[g(X)\,Y\bigr].

증명 전략 E[g(X)m(X)]E[g(X)m(X)]를 XX에 대한 적분으로 쓰고, f(x,y)=f(y∣x)fX(x)f(x,y)=f(y\mid x)f_X(x)로 바꿔 이중적분으로 만든다. 그다음 적분 순서를 바꾼다. 연속인 경우를 쓰고, 이산은 같은 계산을 합으로 한다.

  1. m(x)=∫y f(y∣x) dym(x)=\int y\,f(y\mid x)\,dy이고, fX(x)>0f_X(x)>0인 곳에서 f(x,y)=f(y∣x) fX(x)f(x,y)=f(y\mid x)\,f_X(x)이다.정의 2.2, 2.4

  2. g(X)m(X)g(X)m(X)는 XX의 함수이므로

    E[g(X)m(X)]=∫g(x)(∫y f(y∣x) dy)fX(x) dx.E\bigl[g(X)m(X)\bigr]=\int g(x)\Bigl(\int y\,f(y\mid x)\,dy\Bigr)f_X(x)\,dx .
    2회 1.4절의 상자
  3. 1을 넣고 적분 순서를 바꾼다.

    ∫g(x)(∫y f(y∣x) dy)fX(x) dx=∬g(x) y f(x,y) dy dx.\int g(x)\Bigl(\int y\,f(y\mid x)\,dy\Bigr)f_X(x)\,dx=\iint g(x)\,y\,f(x,y)\,dy\,dx .
    Fubini [T6]
  4. 오른쪽은 E[g(X)Y]E[g(X)Y]이다.정리 1.8(b)

  5. g≡1g\equiv1이면 첫 식 E[E(Y∣X)]=EYE[E(Y\mid X)]=EY가 된다.4

조건 확인 셋째 단계에서 적분 순서를 바꾸려면 ∬∣g(x) y∣ f(x,y) dy dx<∞\iint|g(x)\,y|\,f(x,\allowbreak y)\,dy\,dx<\infty이어야 한다. 이것은 E∣g(X)Y∣<∞E|g(X)Y|<\infty라는 가정 그대로다(Fubini, [T6]). 같은 이유로 거의 모든 xx에서 ∫∣y∣ f(y∣x) dy<∞\int|y|\,f(y\mid x)\,dy<\infty이므로 m(x)m(x)가 정의된다. fX(x)=0f_X(x)=0인 xx들의 집합은 확률이 0이므로 거기서 mm을 어떻게 정해도 적분은 바뀌지 않는다. 증명은 YY 대신 (X,Y)(X,Y)의 함수 h(X,Y)h(X,Y)를 넣어도 그대로 된다. E∣h(X,Y)∣<∞E|h(X,Y)|<\infty이면 E[E(h(X,Y)∣X)]=E h(X,Y)E\bigl[E(h(X,\allowbreak Y)\mid X)\bigr]=E\,h(X,\allowbreak Y)이다.

정리는 “평균을 두 단계로 낼 수 있다”는 말이다. 먼저 XX의 값마다 YY의 평균을 내고, 그 평균들을 XX의 분포로 다시 평균한다. 1회 정리 5.4의 전확률 공식을 기댓값으로 쓴 것이기도 하다.

정리 2.6 (전분산 공식) EY2<∞EY^2<\infty이면

Var⁡Y=E[Var⁡(Y∣X)]+Var⁡(E(Y∣X)).\Var Y=E\bigl[\Var(Y\mid X)\bigr]+\Var\bigl(E(Y\mid X)\bigr) .

증명 전략 Y−EYY-EY를 “조건부 평균에서 벗어난 부분”과 “조건부 평균이 전체 평균에서 벗어난 부분”으로 쪼개 제곱한다. 교차항이 0임을 반복기댓값의 둘째 식으로 보인다.

  1. m(X)=E(Y∣X)m(X)=E(Y\mid X)로 두면 Y−EY=(Y−m(X))+(m(X)−EY)Y-EY=\bigl(Y-m(X)\bigr)+\bigl(m(X)-EY\bigr)이다.항등식

  2. 제곱해 기댓값을 취한다.

    Var⁡Y=E(Y−m(X))2+E(m(X)−EY)2+2E[(Y−m(X))(m(X)−EY)].\Var Y=E\bigl(Y-m(X)\bigr)^2+E\bigl(m(X)-EY\bigr)^2+2E\bigl[(Y-m(X))(m(X)-EY)\bigr] .
    따름정리 1.9
  3. 첫 항은 E[E((Y−m(X))2∣X)]=E[Var⁡(Y∣X)]E\bigl[E((Y-m(X))^2\mid X)\bigr]=E\bigl[\Var(Y\mid X)\bigr]이다.정리 2.5를 (Y−m(X))2(Y-m(X))^2에, 정의 2.4

  4. E m(X)=EYE\,m(X)=EY이므로 둘째 항은 Var⁡(m(X))\Var\bigl(m(X)\bigr)이다.정리 2.5

  5. g(X)=m(X)−EYg(X)=m(X)-EY로 두면 교차항은

    E[g(X) (Y−m(X))]=E[g(X) Y]−E[g(X) m(X)]=0.E\bigl[g(X)\,(Y-m(X))\bigr]=E\bigl[g(X)\,Y\bigr]-E\bigl[g(X)\,m(X)\bigr]=0 .
    정리 2.5의 둘째 식
  6. 3–5를 2에 넣으면 결론이다.

조건 확인 다섯째 단계에서 정리 2.5를 쓰려면 E∣g(X)Y∣<∞E|g(X)Y|<\infty이어야 한다. 2∣ab∣≤a2+b22|ab|\le a^2+b^2 [T4]로 E∣g(X)Y∣≤12(E g(X)2+EY2)E|g(X)Y|\le\tfrac12\bigl(E\,g(X)^2+EY^2\bigr)이고, E g(X)2≤2E m(X)2+2(EY)2E\,g(X)^2\le2E\,m(X)^2+2(EY)^2이다. 남은 E m(X)2≤EY2E\,m(X)^2\le EY^2는 아래 정리 2.8의 첫 단계다. 그 단계는 전분산 공식을 쓰지 않는다.

전체의 흩어짐은 “집단 안의 흩어짐의 평균”과 “집단 평균들의 흩어짐”의 합이다. 14회 분산분석의 분해 SStotal=SSwithin+SSbetweenSS_\text{total}=SS_\text{within}+SS_\text{between}이 이 공식의 표본판이다.

예제 2.7 (주사위를 던지고 그 수만큼 동전을) 주사위 눈 NN을 보고 공평한 동전을 NN번 던져 앞면 수 KK를 센다. N=nN=n이면 K∼b(n,12)K\sim\mathrm b(n,\tfrac12)이므로 E(K∣N)=N2E(K\mid N)=\tfrac N2, Var⁡(K∣N)=N4\Var(K\mid N)=\tfrac N4(2회 정리 2.4). 그러면

EK=E[N2]=3.52=1.75,Var⁡K=E[N4]+Var⁡(N2)=3.54+35/124≈0.875+0.729=1.604.\begin{align*} EK&=E\Bigl[\frac N2\Bigr]=\frac{3.5}2=1.75,\\ \Var K&=E\Bigl[\frac N4\Bigr]+\Var\Bigl(\frac N2\Bigr)=\frac{3.5}4+\frac{35/12}4\approx0.875+0.729=1.604 . \end{align*}

KK의 분포를 직접 구하지 않고 평균과 분산을 얻었다. 분산의 절반 가까이가 “동전을 몇 번 던지는가”의 불확실성에서 온다.

2.3 가장 좋은 예측 ​

2회 정리 2.2(c)는 상수 하나로 YY를 예측할 때 제곱오차를 가장 작게 하는 것이 평균임을 보였다. XX를 보고 예측할 수 있다면 가장 좋은 것은 조건부 평균이다.

정리 2.8 (조건부기댓값은 가장 좋은 예측) EY2<∞EY^2<\infty이면 Eg(X)2<∞Eg(X)^2<\infty인 모든 함수 gg에 대해

E(Y−g(X))2=E(Y−m(X))2+E(m(X)−g(X))2 ≥ E(Y−m(X))2.E\bigl(Y-g(X)\bigr)^2=E\bigl(Y-m(X)\bigr)^2+E\bigl(m(X)-g(X)\bigr)^2\ \ge\ E\bigl(Y-m(X)\bigr)^2 .

특히 E m(X)2≤EY2E\,m(X)^2\le EY^2이다.

증명 전략 Y−g(X)Y-g(X)를 (Y−m(X))+(m(X)−g(X))(Y-m(X))+(m(X)-g(X))로 쪼개 제곱한다. 교차항은 반복기댓값의 둘째 식으로 0이 된다. 전분산 공식과 같은 계산이다. 먼저 모든 항이 유한함을 확인한다.

  1. m(x)2≤E(Y2∣X=x)m(x)^2\le E(Y^2\mid X=x)이다. 이것을 XX의 분포로 평균하면 E m(X)2≤E[E(Y2∣X)]=EY2<∞E\,m(X)^2\le E\bigl[E(Y^2\mid X)\bigr]=EY^2<\infty이다.2회 따름정리 5.10(a), 정리 2.5

  2. h(X)=m(X)−g(X)h(X)=m(X)-g(X)로 두면 E h(X)2≤2E m(X)2+2E g(X)2<∞E\,h(X)^2\le2E\,m(X)^2+2E\,g(X)^2<\infty이다.(a+b)2≤2a2+2b2(a+b)^2\le2a^2+2b^2 [T4]

  3. Y−g(X)=(Y−m(X))+h(X)Y-g(X)=\bigl(Y-m(X)\bigr)+h(X)를 제곱해 기댓값을 취한다.

    E(Y−g(X))2=E(Y−m(X))2+E h(X)2+2E[h(X) (Y−m(X))].E\bigl(Y-g(X)\bigr)^2=E\bigl(Y-m(X)\bigr)^2+E\,h(X)^2+2E\bigl[h(X)\,(Y-m(X))\bigr] .
    따름정리 1.9
  4. 교차항은 E[h(X)Y]−E[h(X)m(X)]=0E[h(X)Y]-E[h(X)m(X)]=0이다. E∣h(X)Y∣<∞E|h(X)Y|<\infty는 2와 2∣ab∣≤a2+b22|ab|\le a^2+b^2에서 나온다.정리 2.5의 둘째 식

  5. E h(X)2≥0E\,h(X)^2\ge0이므로 부등식이 나온다. 등호는 E(m(X)−g(X))2=0E\bigl(m(X)-g(X)\bigr)^2=0일 때뿐이다.3 4

이 정리가 회귀의 수학적 정의다. m(x)=E(Y∣X=x)m(x)=E(Y\mid X=x)를 XX에 대한 YY의 회귀함수라 한다. 5회에서 이변량 정규분포의 회귀함수가 직선임을 보이고, 13회에서 회귀함수를 데이터로 추정한다. 기계학습의 제곱손실 회귀가 추정하려는 대상도 바로 이 m(x)m(x)다.

연습문제

연습 2.1 (조건부 확률질량함수 ★) 예제 1.4에서 M=4M=4일 때 SS의 조건부분포와 E(S∣M=4)E(S\mid M=4)를 구하라. E(S∣M=m)E(S\mid M=m)을 mm의 식으로 쓰고 반복기댓값으로 ES=7ES=7을 확인하라.

풀이

M=4M=4이면 SS는 5,6,75,6,7(각각 236\tfrac2{36})과 88(136\tfrac1{36})이고 pM(4)=736p_M(4)=\tfrac7{36}이므로 조건부 확률은 27,27,27,17\tfrac27,\allowbreak \tfrac27,\allowbreak \tfrac27,\allowbreak \tfrac17, E(S∣M=4)=2(5+6+7)+87=447E(S\mid M=4)=\tfrac{2(5+6+7)+8}7=\tfrac{44}7. 일반적으로

E(S∣M=m)=∑k=1m−12(m+k)+2m2m−1=m(3m−1)2m−1,E(S\mid M=m)=\frac{\sum_{k=1}^{m-1}2(m+k)+2m}{2m-1}=\frac{m(3m-1)}{2m-1},

ES=∑m2m−136⋅m(3m−1)2m−1=136∑m(3m2−m)=273−2136=7ES=\sum_m\tfrac{2m-1}{36}\cdot\tfrac{m(3m-1)}{2m-1}=\tfrac1{36}\sum_m(3m^2-m)=\tfrac{273-21}{36}=7.

연습 2.2 (삼각형의 조건부 ★) 연습 1.2의 밀도에서 fX∣Y(x∣y)f_{X\mid Y}(x\mid y)와 E(X∣Y)E(X\mid Y)를 구하고, EXEX를 반복기댓값으로 다시 구하라.

풀이

fX∣Y(x∣y)=22y=1yf_{X\mid Y}(x\mid y)=\tfrac2{2y}=\tfrac1y (0<x<y0<x<y), 곧 U(0,y)\mathrm U(0,y)이므로 E(X∣Y)=Y2E(X\mid Y)=\tfrac Y2. EX=EY2=12⋅23=13EX=E\tfrac Y2=\tfrac12\cdot\tfrac23=\tfrac13이고, 직접 계산 ∫01x⋅2(1−x)dx=13\int_0^1x\cdot2(1-x)dx=\tfrac13과 같다.

연습 2.3 (무작위 합 ★★) NN이 음이 아닌 정수값의 확률변수이고, NN과 독립인 X1,X2,…X_1,X_2,\dots가 서로 독립이며 평균 μ\mu, 분산 σ2\sigma^2를 갖는다. S=X1+⋯+XNS=X_1+\cdots+X_N(N=0N=0이면 0)에 대해 ES=μ ENES=\mu\,EN, Var⁡S=σ2EN+μ2Var⁡N\Var S=\sigma^2EN+\mu^2\Var N임을 보여라(Wald의 항등식). 보험사의 한 해 지급액의 분산이 “청구 건수의 불확실성”과 “건당 금액의 불확실성”으로 나뉘는 방식이다.

풀이

N=nN=n이면 SS는 독립인 nn개의 합이므로(그리고 NN과 XiX_i가 독립이므로) E(S∣N)=NμE(S\mid N)=N\mu, Var⁡(S∣N)=Nσ2\Var(S\mid N)=N\sigma^2. 반복기댓값으로 ES=μENES=\mu EN, 전분산 공식으로 Var⁡S=E(Nσ2)+Var⁡(Nμ)=σ2EN+μ2Var⁡N\Var S=E(N\sigma^2)+\Var(N\mu)=\sigma^2EN+\mu^2\Var N.

연습 2.4 (두 단계의 균등 ★★) X∼U(0,1)X\sim\mathrm U(0,1)이고, X=xX=x일 때 Y∼U(0,x)Y\sim\mathrm U(0,x)이다. (X,Y)(X,Y)의 결합밀도, YY의 주변 밀도, EYEY, Var⁡Y\Var Y를 구하라. 마지막 둘은 반복기댓값과 전분산 공식으로도 구하라.

풀이

f(x,y)=1⋅1xf(x,y)=1\cdot\tfrac1x (0<y<x<10<y<x<1). fY(y)=∫y1dxx=−log⁡yf_Y(y)=\int_y^1\tfrac{dx}x=-\log y (0<y<10<y<1). EY=EX2=14EY=E\tfrac X2=\tfrac14. Var⁡Y=EX212+Var⁡X2=136+148=7144\Var Y=E\tfrac{X^2}{12}+\Var\tfrac X2=\tfrac1{36}+\tfrac1{48}=\tfrac7{144}. 직접: EY2=∫01y2(−log⁡y)dy=19EY^2=\int_0^1y^2(-\log y)dy=\tfrac19이므로 Var⁡Y=19−116=7144\Var Y=\tfrac19-\tfrac1{16}=\tfrac7{144}.

연습 2.5 (조건부기댓값의 성질 ★★) 정의에서 바로 (a) E(aY1+bY2∣X)=aE(Y1∣X)+bE(Y2∣X)E(aY_1+bY_2\mid X)=aE(Y_1\mid X)+bE(Y_2\mid X), (b) E(g(X)Y∣X)=g(X)E(Y∣X)E(g(X)Y\mid X)=g(X)E(Y\mid X)를 보여라. (b)를 “아는 것은 상수처럼 밖으로 꺼낸다”고 읽는다.

풀이

(a) 조건부분포에 대한 기댓값도 합·적분이므로 선형이다. (b) X=xX=x로 고정하면 g(X)=g(x)g(X)=g(x)는 상수이므로 E(g(x)Y∣X=x)=g(x)E(Y∣X=x)E(g(x)Y\mid X=x)=g(x)E(Y\mid X=x). 이것이 모든 xx에서 성립하므로 확률변수로 쓰면 g(X)E(Y∣X)g(X)E(Y\mid X).

연습 2.6 (예측의 개선 ★) 예제 2.7에서 NN을 보고 KK를 예측하면 평균제곱오차는 얼마나 줄어드나? Var⁡(E(K∣N))/Var⁡K\Var(E(K\mid N))/\Var K를 구하라. 이 비를 “NN이 설명하는 분산의 비율”이라 부른다.

풀이

Var⁡K=4248+3548=7748\Var K=\tfrac{42}{48}+\tfrac{35}{48}=\tfrac{77}{48}이고 Var⁡E(K∣N)=3548\Var E(K\mid N)=\tfrac{35}{48}이므로 비는 3577=511≈0.45\tfrac{35}{77}=\tfrac5{11}\approx0.45. 평균제곱오차는 Var⁡K=1.604\Var K=1.604에서 EVar⁡(K∣N)=0.875E\Var(K\mid N)=0.875로 줄어든다.

이 회차에서 읽은 절 0개 · 회차 차례