Skip to content

4회 · 셈하는 분포와 섞인 분포 · 노트

4 베타분포 — Bayes의 당구대 ​

지금까지 성공 확률 pp는 알려진 수였다. 모른다면? 18세기의 Bayes와 Laplace는 pp 자체에 확률분포를 주고, 관측한 성공 수로 그 분포를 고쳤다. 그 분포가 베타분포이고, 베타분포는 두 감마분포의 비에서 나온다.

4.1 베타함수와 베타분포 ​

정의 4.1 (베타분포) a,b>0a,b>0에 대해 밀도

f(x)=1B(a,b) xa−1(1−x)b−1,0<x<1,B(a,b)=∫01xa−1(1−x)b−1dxf(x)=\frac1{B(a,b)}\,x^{a-1}(1-x)^{b-1},\qquad 0<x<1,\qquad B(a,b)=\int_0^1x^{a-1}(1-x)^{b-1}dx

를 갖는 분포를 베타분포 Beta(a,b)\mathrm{Beta}(a,b)라 하고 BB를 베타함수라 한다.

Beta(1,1)\mathrm{Beta}(1,1)은 U(0,1)\mathrm U(0,1)이다. a,ba,b가 크면 aa+b\tfrac a{a+b} 근처에 몰리고, a=b<1a=b<1이면 양 끝에 몰리는 U자 모양이 된다(그림 4.2).

정리 4.2 (베타와 감마) X∼Γ(a,1)X\sim\Gamma(a,1)과 Y∼Γ(b,1)Y\sim\Gamma(b,1)이 독립이면

U=XX+Y∼Beta(a,b),V=X+Y∼Γ(a+b,1),U=\frac X{X+Y}\sim\mathrm{Beta}(a,b),\qquad V=X+Y\sim\Gamma(a+b,1),

이고 UU와 VV는 독립이다. 따라서 B(a,b)=Γ(a)Γ(b)Γ(a+b)B(a,\allowbreak b)=\tfrac{\Gamma(a)\Gamma(b)}{\Gamma(a+b)}.

증명 전략 (X,Y)↦(U,V)(X,Y)\mapsto(U,V)의 변수변환으로 결합밀도를 구하고 [T7], 그것이 uu만의 함수와 vv만의 함수의 곱으로 인수분해됨을 보인다. 인수분해에서 독립과 두 주변분포, 그리고 정규화 상수가 함께 나온다.

  1. 변환 (x,y)↦(u,v)=(xx+y, x+y)(x,\allowbreak y)\mapsto(u,\allowbreak v)=\bigl(\tfrac x{x+y},\allowbreak \,x+y\bigr)는 (0,∞)2(0,\infty)^2에서 (0,1)×(0,∞)(0,1)\times(0,\infty)로 가는 일대일 대응이고, 역변환은 x=uvx=uv, y=(1−u)vy=(1-u)v이다.대입해 확인

  2. 역변환의 야코비안은 det⁡(vu−v1−u)=v(1−u)+uv=v\det\smat{v&u\\-v&1-u}=v(1-u)+uv=v이다.[T7]

  3. XX와 YY가 독립이므로 fX,Y(x,y)=xa−1e−xΓ(a)⋅yb−1e−yΓ(b)f_{X,Y}(x,\allowbreak y)=\tfrac{x^{a-1}e^{-x}}{\Gamma(a)}\cdot\tfrac{y^{b-1}e^{-y}}{\Gamma(b)} (x,y>0x,y>0)이다.3회 정리 3.2

  4. 변수변환 공식에 1–3을 넣고 uu와 vv로 나눠 묶는다(0<u<10<u<1, v>0v>0).

    fU,V(u,v)=fX,Y(uv,(1−u)v)⋅v=ua−1(1−u)b−1Γ(a)Γ(b)/Γ(a+b)⋅va+b−1e−vΓ(a+b).\begin{align*} f_{U,V}(u,v)&=f_{X,Y}\bigl(uv,(1-u)v\bigr)\cdot v \tag*{\htmlClass{reason}{\text{3회 정리 5.1}}}\\ &=\frac{u^{a-1}(1-u)^{b-1}}{\Gamma(a)\Gamma(b)/\Gamma(a+b)}\cdot\frac{v^{a+b-1}e^{-v}}{\Gamma(a+b)} . \tag*{\htmlClass{reason}{\text{$e^{-uv}e^{-(1-u)v}=e^{-v}$}}} \end{align*}
  5. 결합밀도가 uu만의 함수와 vv만의 함수의 곱이므로 UU와 VV는 독립이다. 둘째 인수는 Γ(a+b,1)\Gamma(a+b,1)의 밀도다.3회 정리 3.2, 정의 3.6

  6. vv로 적분하면 둘째 인수의 적분은 1이므로, 첫째 인수가 UU의 밀도이고 그 적분도 1이다. 따라서 ∫01ua−1(1−u)b−1du=Γ(a)Γ(b)Γ(a+b)\int_0^1u^{a-1}(1-u)^{b-1}du=\tfrac{\Gamma(a)\Gamma(b)}{\Gamma(a+b)}, 곧 B(a,b)=Γ(a)Γ(b)Γ(a+b)B(a,\allowbreak b)=\tfrac{\Gamma(a)\Gamma(b)}{\Gamma(a+b)}이고 U∼Beta(a,b)U\sim\mathrm{Beta}(a,b)이다.밀도의 적분은 1

따름정리 4.3 (베타분포의 적률) U∼Beta(a,b)U\sim\mathrm{Beta}(a,b)이면

EU=aa+b,Var⁡U=ab(a+b)2(a+b+1).EU=\frac a{a+b},\qquad \Var U=\frac{ab}{(a+b)^2(a+b+1)} .

증명 EUk=B(a+k,b)B(a,b)=Γ(a+k)Γ(a+b)Γ(a)Γ(a+b+k)EU^k=\tfrac{B(a+k,b)}{B(a,b)}=\tfrac{\Gamma(a+k)\Gamma(a+b)}{\Gamma(a)\Gamma(a+b+k)}이고 Γ(α+1)=αΓ(α)\Gamma(\alpha+1)=\alpha\Gamma(\alpha)를 쓴다. k=1k=1이면 aa+b\tfrac a{a+b}, k=2k=2이면 a(a+1)(a+b)(a+b+1)\tfrac{a(a+1)}{(a+b)(a+b+1)}.

예제 4.4 (균등분포의 순서통계량) U1,…,Un∼iidU(0,1)U_1,\allowbreak \dots,\allowbreak U_n\iid\mathrm U(0,\allowbreak 1)을 크기순으로 늘어놓은 kk번째 값 U(k)U_{(k)}는 Beta(k,n−k+1)\mathrm{Beta}(k,n-k+1)이다. U(k)≤xU_{(k)}\le x일 확률은 nn개 가운데 kk개 이상이 xx 이하일 확률 ∑j≥k(nj)xj(1−x)n−j\sum_{j\ge k}\tbinom njx^j(1-x)^{n-j}이고, 미분하면 망원급수로 n!(k−1)!(n−k)!xk−1(1−x)n−k\tfrac{n!}{(k-1)!(n-k)!}x^{k-1}(1-x)^{n-k}이 남는다(연습 4.1). k=nk=n이 3회 예제 3.5의 최댓값이다. 평균은 kn+1\tfrac k{n+1}이다. nn개의 점이 구간을 평균적으로 n+1n+1등분한다.

4.2 Bayes의 당구대 (1763) ​

역사 Thomas Bayes의 유고 An Essay towards Solving a Problem in the Doctrine of Chances(1763, Richard Price가 정리)는 이렇게 묻는다. 정사각형 당구대에 공 WW를 굴려 멈춘 위치의 가로 좌표를 pp라 하자(우리는 pp를 보지 못한다). 이어서 공 OO를 nn번 굴려, OO가 WW보다 왼쪽에 멈춘 횟수 SS만 듣는다. S=sS=s일 때 pp가 aa와 bb 사이에 있을 확률은? Bayes는 기하학적 논증으로 답했다. 오늘의 말로 그것은 균등 사전분포와 이항 가능도에서 베타 사후분포를 얻는 계산이다.
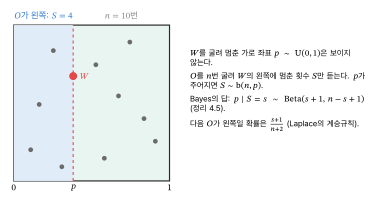
그림 4.1. Bayes의 당구대. 공 W의 위치 p는 숨겨져 있고, 공 O를 n번 굴려 W의 왼쪽에 멈춘 횟수 S만 안다.
그림 4.1 Bayes의 당구대. 공 WW의 위치 pp는 숨겨져 있고, 공 OO를 nn번 굴려 WW의 왼쪽에 멈춘 횟수 SS만 안다.

정리 4.5 (Bayes의 사후분포) p∼Beta(a,b)p\sim\mathrm{Beta}(a,b)이고 pp가 주어지면 S∼b(n,p)S\sim\mathrm b(n,p)일 때, S=sS=s가 주어진 pp의 조건부분포는

p∣S=s ∼ Beta(a+s, b+n−s).p\mid S=s\ \sim\ \mathrm{Beta}(a+s,\ b+n-s) .

특히 균등 사전분포(a=b=1a=b=1, Bayes의 당구대)이면 Beta(s+1,n−s+1)\mathrm{Beta}(s+1,n-s+1)이다.

증명 전략 결합 “밀도–질량” f(p)P(S=s∣p)f(p)P(S=s\mid p)를 ss를 고정한 pp의 함수로 보고 정규화한다. pp에 대해 비례하는 꼴만 맞으면 정규화 상수를 따로 계산하지 않아도 된다. 단계별 증명은 연습 4.6(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

사전분포와 사후분포가 같은 가족이다. 베타는 이항의 켤레 사전분포다. 성공 하나는 aa에, 실패 하나는 bb에 1을 더한다. aa와 bb를 “사전에 본 것과 같은 가상의 성공·실패 수”로 읽을 수 있다.

따름정리 4.6 (Laplace의 계승규칙 (1774)) 균등 사전분포에서 nn번 가운데 ss번 성공했다면 다음 시행이 성공할 확률은

P(다음 성공∣S=s)=E(p∣S=s)=s+1n+2.P(\text{다음 성공}\mid S=s)=E(p\mid S=s)=\frac{s+1}{n+2} .

증명 pp가 주어지면 다음 시행은 확률 pp로 성공하므로, 반복기댓값(3회 정리 2.5)으로 조건부 확률은 E(p∣S=s)E(p\mid S=s)이고, 따름정리 4.3로 s+1(s+1)+(n−s+1)\tfrac{s+1}{(s+1)+(n-s+1)}.

Laplace(1814)는 이것으로 “해가 내일도 뜰 확률”을 계산했다. 역사가 5,000년, 곧 1,826,213일 동안 매일 해가 떴다면, 내일도 뜰 확률은 1,826,2141,826,215\tfrac{1{,}826{,}214}{1{,}826{,}215}, “1,826,214 대 1”이다. 그는 곧이어, 자연의 법칙을 아는 사람에게는 이 확률이 훨씬 크다고 덧붙였다. 사전분포가 모든 것을 정한다는 비판은 이때부터 있었다(16회).
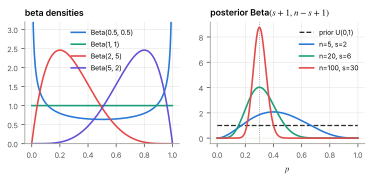
그림 4.2. 왼쪽: 베타 밀도의 여러 모양. 오른쪽: Bayes의 당구대. 균등 사전분포(점선)에서 시작해 n=5,20,100번 가운데 성공 비율 0.3을 관측했을 때의 사후분포 Beta(s+1,n-s+1). 관측이 늘수록 참값 근처로 좁아진다.
그림 4.2 왼쪽: 베타 밀도의 여러 모양. 오른쪽: Bayes의 당구대. 균등 사전분포(점선)에서 시작해 n=5,20,100n=5,20,100번 가운데 성공 비율 0.3을 관측했을 때의 사후분포 Beta(s+1,n−s+1)\mathrm{Beta}(s+1,n-s+1). 관측이 늘수록 참값 근처로 좁아진다.
연습문제

연습 4.1 (순서통계량의 밀도 ★★) 예제 4.4의 미분을 실행해 U(k)U_{(k)}의 밀도를 유도하라. 또 정리 4.2를 쓰지 않고 B(k,n−k+1)=(k−1)!(n−k)!n!B(k,\allowbreak n-k+1)=\tfrac{(k-1)!(n-k)!}{n!}임을 이 결과에서 얻어라.

풀이

ddx∑j≥k(nj)xj(1−x)n−j\tfrac d{dx}\sum_{j\ge k}\tbinom njx^j(1-x)^{n-j}의 각 항은 n(n−1j−1)xj−1(1−x)n−j−n(n−1j)xj(1−x)n−j−1n\tbinom{n-1}{j-1}x^{j-1}(1-x)^{n-j}-n\tbinom{n-1}{j}x^j(1-x)^{n-j-1}이고, 이웃 항이 소거되어 n(n−1k−1)xk−1(1−x)n−k=n!(k−1)!(n−k)!xk−1(1−x)n−kn\tbinom{n-1}{k-1}x^{k-1}(1-x)^{n-k}=\tfrac{n!}{(k-1)!(n-k)!}x^{k-1}(1-x)^{n-k}이 남는다. 밀도의 적분이 1이므로 ∫01xk−1(1−x)n−kdx=(k−1)!(n−k)!n!\int_0^1x^{k-1}(1-x)^{n-k}dx=\tfrac{(k-1)!(n-k)!}{n!}.

연습 4.2 (균등 사전분포의 예측 ★★) Bayes의 당구대에서 p∼U(0,1)p\sim\mathrm U(0,1), S∣p∼b(n,p)S\mid p\sim\mathrm b(n,p)이면 P(S=s)=1n+1P(S=s)=\tfrac1{n+1} (s=0,…,ns=0,\dots,n)임을 보여라. 공 OO를 굴리기 전에는 모든 성공 수가 똑같이 그럴듯하다.

풀이

P(S=s)=∫01(ns)ps(1−p)n−sdp=(ns)B(s+1,n−s+1)=(ns)s!(n−s)!(n+1)!=1n+1P(S=s)=\int_0^1\tbinom nsp^s(1-p)^{n-s}dp=\tbinom nsB(s+1,\allowbreak n-s+1)=\tbinom ns\tfrac{s!(n-s)!}{(n+1)!}=\tfrac1{n+1}.

연습 4.3 (사후분포의 평균과 분산 ★) Beta(1,1)\mathrm{Beta}(1,1) 사전분포에서 20번 가운데 6번 성공했다. 사후 평균과 사후 표준편차를 구하고, p^=0.3\hat p=0.3과 그 표준오차 p^(1−p^)/n\sqrt{\hat p(1-\hat p)/n}과 비교하라.

풀이

사후분포는 Beta(7,15)\mathrm{Beta}(7,15). 평균 722≈0.318\tfrac7{22}\approx0.318, 분산 7⋅15222⋅23\tfrac{7\cdot15}{22^2\cdot23}, 표준편차 ≈0.097\approx0.097. 표본 비율 0.30.3과 표준오차 0.1020.102에 가깝다. 사후 평균은 0.30.3을 사전 평균 0.50.5 쪽으로 조금 끌어당긴 값이다.

연습 4.4 (FF 분포의 씨앗 ★★) 정리 4.2의 X,YX,Y로 R=X/YR=X/Y의 밀도를 구하라. xa−1B(a,b)(1+x)a+b\tfrac{x^{a-1}}{B(a,b)(1+x)^{a+b}} (x>0x>0)이다. 6회에서 χ2\chi^2의 비로 FF 분포를 만들 때 같은 계산을 쓴다.

풀이

R=U/(1−U)R=U/(1-U), U∼Beta(a,b)U\sim\mathrm{Beta}(a,b) (정리 4.2). u=r1+ru=\tfrac r{1+r}, dudr=1(1+r)2\tfrac{du}{dr}=\tfrac1{(1+r)^2}이므로 2회 정리 4.3으로

fR(r)=1B(a,b)(r1+r)a−1(11+r)b−11(1+r)2=ra−1B(a,b)(1+r)a+b.f_R(r)=\frac{1}{B(a,b)}\Bigl(\frac r{1+r}\Bigr)^{a-1}\Bigl(\frac1{1+r}\Bigr)^{b-1}\frac1{(1+r)^2}=\frac{r^{a-1}}{B(a,b)(1+r)^{a+b}} .

연습 4.5 (Dirichlet로 가는 길 ★★★) X1,X2,X3X_1,X_2,X_3이 독립이고 Xj∼Γ(aj,1)X_j\sim\Gamma(a_j,1)이면 (X1S,X2S)\bigl(\tfrac{X_1}S,\allowbreak \tfrac{X_2}S\bigr), S=∑XjS=\sum X_j의 결합밀도가 Γ(a1+a2+a3)Γ(a1)Γ(a2)Γ(a3)u1a1−1u2a2−1(1−u1−u2)a3−1\tfrac{\Gamma(a_1+a_2+a_3)}{\Gamma(a_1)\Gamma(a_2)\Gamma(a_3)}u_1^{a_1-1}u_2^{a_2-1}(1-u_1-u_2)^{a_3-1}임을 보여라. 이것이 다항분포의 켤레 사전분포인 Dirichlet 분포다(16회, 주제 모형).

풀이

(x1,x2,x3)↦(u1,u2,s)(x_1,\allowbreak x_2,\allowbreak x_3)\mapsto(u_1,\allowbreak u_2,\allowbreak s), x1=u1sx_1=u_1s, x2=u2sx_2=u_2s, x3=(1−u1−u2)sx_3=(1-u_1-u_2)s의 야코비안은 s2s^2이다. 결합밀도는 ∏jxjaj−1e−xjΓ(aj)⋅s2=u1a1−1u2a2−1(1−u1−u2)a3−1∏Γ(aj)s∑aj−1e−s\prod_j\tfrac{x_j^{a_j-1}e^{-x_j}}{\Gamma(a_j)}\cdot s^2=\tfrac{u_1^{a_1-1}u_2^{a_2-1}(1-u_1-u_2)^{a_3-1}}{\prod\Gamma(a_j)}s^{\sum a_j-1}e^{-s}이고, ss를 적분하면 Γ(∑aj)\Gamma(\sum a_j)가 나온다.

연습 4.6 (Bayes의 사후분포: 증명 ★★ 유도형) p∼Beta(a,b)p\sim\mathrm{Beta}(a,b)이고 pp가 주어지면 S∼b(n,p)S\sim\mathrm b(n,p)이다. 정리 4.5를 다음 순서로 증명하라.

  1. (a)

    결합 “밀도–질량” h(p,s)=f(p)P(S=s∣p)h(p,s)=f(p)P(S=s\mid p)를 쓰라.

  2. (b)

    pp로 적분해 P(S=s)=(ns)B(a+s, b+n−s)B(a,b)P(S=s)=\tbinom ns\tfrac{B(a+s,\,b+n-s)}{B(a,b)}를 얻어라.

  3. (c)

    조건부 밀도 h(p,s)/P(S=s)h(p,s)/P(S=s)가 Beta(a+s,b+n−s)\mathrm{Beta}(a+s,b+n-s)의 밀도와 같음을 확인하라.

  4. (d)

    (b)의 계산 없이 “pp에 대해 pa+s−1(1−p)b+n−s−1p^{a+s-1}(1-p)^{b+n-s-1}에 비례한다”는 것만으로 같은 결론이 나오는 이유를 설명하라.

풀이

(a) h(p,s)=pa−1(1−p)b−1B(a,b)(ns)ps(1−p)n−sh(p,\allowbreak s)=\tfrac{p^{a-1}(1-p)^{b-1}}{B(a,b)}\tbinom nsp^s(1-p)^{n-s} (0<p<10<p<1, s=0,…,ns=0,\dots,n). (b) P(S=s)=∫01h(p,s) dp=(ns)B(a,b)∫01pa+s−1(1−p)b+n−s−1dp=(ns)B(a+s,b+n−s)B(a,b)P(S=s)=\int_0^1h(p,\allowbreak s)\,dp=\tfrac{\tbinom ns}{B(a,b)}\int_0^1p^{a+s-1}(1-p)^{b+n-s-1}dp=\tbinom ns\tfrac{B(a+s,b+n-s)}{B(a,b)}이다. 마지막 적분은 베타함수의 정의다. (c) h(p,s)P(S=s)=pa+s−1(1−p)b+n−s−1B(a+s,b+n−s)\tfrac{h(p,s)}{P(S=s)}=\tfrac{p^{a+s-1}(1-p)^{b+n-s-1}}{B(a+s,b+n-s)}이고, 이것이 Beta(a+s,b+n−s)\mathrm{Beta}(a+s,b+n-s)의 밀도다. (d) 조건부 밀도는 pp의 함수로서 h(p,s)h(p,s)에 pp와 무관한 상수 1/P(S=s)1/P(S=s)를 곱한 것이고 적분이 1이다. pa+s−1(1−p)b+n−s−1p^{a+s-1}(1-p)^{b+n-s-1}에 상수를 곱해 적분이 1이 되는 함수는 하나뿐이므로, 그 상수는 1/B(a+s,b+n−s)1/B(a+s,b+n-s)일 수밖에 없다. 비례하는 꼴이 정해지면 정규화 상수는 저절로 정해진다.

이 회차에서 읽은 절 0개 · 회차 차례