Skip to content

4회 · 셈하는 분포와 섞인 분포 · 노트

5 혼합분포 — 섞인 집단 ​

모든 관측이 같은 분포에서 나오지 않을 수 있다. 군단마다 위험이 다르고, 저자마다 단어 습관이 다르고, 게의 무리마다 체형이 다르다. 관측값이 “먼저 집단을 무작위로 고르고, 그 집단의 분포에서 뽑는다”는 두 단계로 만들어지면 그 분포를 혼합분포라 한다. 3회의 전분산 공식이 혼합의 평균과 분산을 한 줄로 준다.

5.1 정의와 적률 ​

정의 5.1 (혼합분포) 잠재변수 Θ\Theta가 분포 GG를 따르고, Θ=θ\Theta=\theta일 때 XX가 밀도(또는 pmf) f(x∣θ)f(x\mid\theta)를 따르면, XX의 분포

fX(x)=∑kπkf(x∣θk)(유한 혼합),fX(x)=∫f(x∣θ) g(θ) dθ(연속 혼합)f_X(x)=\sum_k\pi_kf(x\mid\theta_k)\quad\text{(유한 혼합)},\qquad f_X(x)=\int f(x\mid\theta)\,g(\theta)\,d\theta\quad\text{(연속 혼합)}

를 혼합분포라 한다. πk=P(Θ=θk)\pi_k=P(\Theta=\theta_k)를 혼합 비율이라 한다.

식은 XX와 Θ\Theta의 결합분포에서 Θ\Theta를 합하거나 적분해 없앤 주변분포(3회 정리 1.6)다.

정리 5.2 (혼합의 평균과 분산) μ(θ)=E(X∣Θ=θ)\mu(\theta)=E(X\mid\Theta=\theta), σ2(θ)=Var⁡(X∣Θ=θ)\sigma^2(\theta)=\Var(X\mid\Theta=\theta)이면

EX=E μ(Θ),Var⁡X=E σ2(Θ)⏟집단 안+Var⁡μ(Θ)⏟집단 사이.EX=E\,\mu(\Theta),\qquad \Var X=\underbrace{E\,\sigma^2(\Theta)}_{\text{집단 안}}+\underbrace{\Var\mu(\Theta)}_{\text{집단 사이}} .

증명 3회 정리 2.5와 2.6을 XX와 Θ\Theta에 쓴다.

혼합의 분산은 언제나 집단 안의 평균 분산보다 크다. 집단 사이의 차이가 더해지기 때문이다. 5회 5.3절에서 Galton의 아들과 딸의 키를 섞었을 때 분산의 절반 가까이가 “집단 사이” 항이었던 것이 이 정리다.

5.2 Poisson–감마 혼합은 음이항 ​

정리 5.3 (Poisson–감마 혼합) Λ∼Γ(r,β)\Lambda\sim\Gamma(r,\beta)이고 Λ=λ\Lambda=\lambda일 때 X∼Poi(λ)X\sim\mathrm{Poi}(\lambda)이면

X∼NB(r, p=11+β),EX=rβ,Var⁡X=rβ+rβ2.X\sim\mathrm{NB}\Bigl(r,\ p=\frac1{1+\beta}\Bigr),\qquad EX=r\beta,\qquad \Var X=r\beta+r\beta^2 .

rr은 정수가 아니어도 된다.

증명 전략 주변 pmf를 혼합의 정의대로 적분으로 쓰고, 그 적분을 감마함수로 알아본다. 적률은 혼합의 평균과 분산 공식으로 구한다.

  1. k=0,1,…k=0,1,\dots에 대해 혼합의 정의로 쓰고 λ\lambda의 거듭제곱과 지수를 모은다.

    P(X=k)=∫0∞e−λλkk!⋅λr−1e−λ/βΓ(r)βr dλ=1k! Γ(r)βr∫0∞λk+r−1e−λ(1+1/β) dλ.\begin{align*} P(X=k)&=\int_0^\infty e^{-\lambda}\frac{\lambda^k}{k!}\cdot\frac{\lambda^{r-1}e^{-\lambda/\beta}}{\Gamma(r)\beta^r}\,d\lambda \tag*{\htmlClass{reason}{\text{정의~\href{/read/04/5#def-mixture}{5.1}}}}\\ &=\frac{1}{k!\,\Gamma(r)\beta^r}\int_0^\infty\lambda^{k+r-1}e^{-\lambda(1+1/\beta)}\,d\lambda . \end{align*}
  2. y=λ(1+1/β)y=\lambda(1+1/\beta)로 치환하면 적분은 Γ(k+r)(β1+β)k+r\Gamma(k+r)\bigl(\tfrac\beta{1+\beta}\bigr)^{k+r}이다.정의 3.4, 치환 [T7]

  3. 1 2에서 P(X=k)=Γ(k+r)k! Γ(r)(11+β)r(β1+β)kP(X=k)=\tfrac{\Gamma(k+r)}{k!\,\Gamma(r)}\bigl(\tfrac1{1+\beta}\bigr)^r\bigl(\tfrac\beta{1+\beta}\bigr)^k이다.정리

  4. 정수 rr이면 Γ(k+r)k! Γ(r)=(k+r−1k)\tfrac{\Gamma(k+r)}{k!\,\Gamma(r)}=\tbinom{k+r-1}k이므로, 이것은 정리 1.3의 pmf에 p=11+βp=\tfrac1{1+\beta}, q=β1+βq=\tfrac\beta{1+\beta}를 넣은 것이다. 정수가 아닌 rr에서는 1.2절처럼 이 식이 NB(r,p)\mathrm{NB}(r,p)의 정의다.정리 3.5(a)(b)

  5. 적률은 EX=EΛ=rβEX=E\Lambda=r\beta, Var⁡X=EΛ+Var⁡Λ=rβ+rβ2\Var X=E\Lambda+\Var\Lambda=r\beta+r\beta^2이다.정리 5.2, 2.2, 3.7

조건 확인 혼합의 pmf가 합이 1인 것은 음이 아닌 항의 합과 적분의 순서를 바꿔 ∑k∫=∫∑k=∫g=1\sum_k\int=\int\sum_k=\int g=1로 확인한다(Tonelli [T6]). 2의 적분은 k+r>0k+r>0이므로 수렴한다.

이것이 음이항분포가 셈 자료의 표준 모형이 된 이유다. 개체마다 위험률 λ\lambda가 다르고(감마로 흩어져 있고), 주어진 위험률에서는 Poisson이라는 그림이다. 분산 rβ+rβ2=EX+(EX)2rr\beta+r\beta^2=EX+\tfrac{(EX)^2}r에서 둘째 항이 위험률의 흩어짐이 만든 과산포다. r→∞r\to\infty, rβ=λr\beta=\lambda로 고정하면 감마가 한 점에 몰리고 음이항은 Poisson으로 돌아간다. Greenwood와 Yule(1920)은 이 모형으로 공장 노동자의 사고 횟수가 Poisson보다 더 흩어져 있다는 것, 곧 “사고를 잘 당하는 사람”이 있다는 것을 보였다.
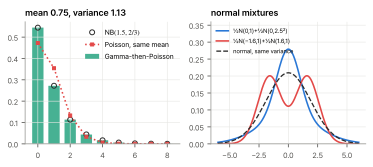
그림 5.1. 왼쪽: 위험률 Λ~Γ(r=1.5,β=0.5)를 먼저 뽑고 Poisson을 뽑은 시뮬레이션(막대)과 NB(1.5,tfrac23)(원), 같은 평균의 Poisson(점선). 오른쪽: 정규분포 두 개의 혼합. 한 봉우리이면서도 정규보다 꼬리가 무겁거나, 두 봉우리일 수 있다.
그림 5.1 왼쪽: 위험률 Λ∼Γ(r=1.5,β=0.5)\Lambda\sim\Gamma(r=1.5,\allowbreak \beta=0.5)를 먼저 뽑고 Poisson을 뽑은 시뮬레이션(막대)과 NB(1.5,23)\mathrm{NB}(1.5,\tfrac23)(원), 같은 평균의 Poisson(점선). 오른쪽: 정규분포 두 개의 혼합. 한 봉우리이면서도 정규보다 꼬리가 무겁거나, 두 봉우리일 수 있다.

5.3 정규의 혼합 — Pearson의 게 (1894) ​

역사 동물학자 Weldon은 나폴리 만의 게 1,000마리의 이마 폭을 쟀다. 분포가 약간 비대칭이었고, 그는 두 아종이 섞여 있는 것이 아닌지 Karl Pearson에게 물었다. Pearson(1894)은 두 정규분포의 혼합 πN(μ1,σ12)+(1−π)N(μ2,σ22)\pi\N(\mu_1,\allowbreak \sigma_1^2)+(1-\pi)\N(\mu_2,\allowbreak \sigma_2^2)의 모수 다섯 개를, 자료의 처음 다섯 적률을 이 모형의 적률과 같게 놓아 풀었다. 그 결과는 9차 방정식이었고, Pearson은 그것을 손으로 풀었다. 이것이 적률법의 시작이다. 9회에서 최대가능도와 비교하고, 10회의 EM 알고리즘이 같은 문제를 다른 방법으로 푼다.

유한 정규 혼합의 평균과 분산은 정리 5.2로

EX=∑kπkμk,Var⁡X=∑kπkσk2+∑kπk(μk−EX)2.EX=\sum_k\pi_k\mu_k,\qquad \Var X=\sum_k\pi_k\sigma_k^2+\sum_k\pi_k(\mu_k-EX)^2 .

평균이 같고 분산만 다른 정규를 섞으면(μk=μ\mu_k=\mu) 한 봉우리이지만 꼬리가 정규보다 무거워진다(그림 5.1 오른쪽). 5회 5.2절의 “오염된 정규”가 이것이다.

예제 5.4 (Laplace의 오차곡선은 정규의 혼합) Laplace(1774)는 관측 오차의 분포로 이중지수 밀도 f(x)=12be−∣x∣/bf(x)=\tfrac1{2b}e^{-|x|/b}를 제안했다(Laplace 분포). 분산이 V∼ExpV\sim\mathrm{Exp}(평균 2b22b^2)로 흩어져 있고 V=vV=v일 때 X∼N(0,v)X\sim\N(0,v)이면 XX가 바로 이 분포다(연습 5.3). 오차의 크기가 관측마다 다른 정밀도로 흩어져 있다는 그림이다. 13회의 최소절대편차 회귀가 이 분포의 최대가능도이고, 15회의 로버스트 방법들도 같은 생각에서 나온다.

연습문제

연습 5.1 (두 집단 ★) 남자의 키가 N(175,72)\N(175,7^2), 여자가 N(162,62)\N(162,6^2)이고 비율이 반반이다. 섞은 키의 평균과 분산을 구하고, 분산에서 “집단 사이” 항이 차지하는 비율을 구하라.

풀이

평균 168.5168.5. 분산 =12(49+36)+12(6.52+6.52)=42.5+42.25=84.75=\tfrac12(49+36)+\tfrac12\bigl(6.5^2+6.5^2\bigr)=42.5+42.25=84.75. 집단 사이 항이 약 50%50\%이다.

연습 5.2 (음이항의 과산포 ★) 정리 5.3에서 분산/평균 비가 1+β1+\beta임을 보여라. 평균이 0.66이고 분산/평균 비가 1.54인 자료라면 β\beta와 rr은 얼마인가?

풀이

Var⁡X/EX=rβ+rβ2rβ=1+β\Var X/EX=\tfrac{r\beta+r\beta^2}{r\beta}=1+\beta. D=1.54D=1.54이면 β=0.54\beta=0.54, r=0.66/0.54≈1.22r=0.66/0.54\approx1.22.

연습 5.3 (Laplace는 정규의 혼합 ★★★) V∼ExpV\sim\mathrm{Exp}(평균 2b22b^2)이고 V=vV=v일 때 X∼N(0,v)X\sim\N(0,v)이면 XX의 mgf가 11−b2t2\tfrac1{1-b^2t^2} (∣t∣<1/b|t|<1/b)임을 보여라. (힌트: E(etX∣V)=et2V/2E(e^{tX}\mid V)=e^{t^2V/2}이고 반복기댓값.) 이것이 Laplace 분포의 mgf임을 확인하고 mgf의 유일성으로 결론지어라.

풀이

E(etX∣V=v)=et2v/2E(e^{tX}\mid V=v)=e^{t^2v/2}이다(N(0,v)\N(0,v)의 mgf. 지수 tx−x22vtx-\tfrac{x^2}{2v}를 완전제곱 −(x−tv)22v+t2v2-\tfrac{(x-tv)^2}{2v}+\tfrac{t^2v}2로 바꾸고 3회 정리 5.3을 쓴다). 그리고 VV의 mgf는 11−2b2s\tfrac1{1-2b^2s}이므로 반복기댓값으로 MX(t)=11−2b2⋅t2/2=11−b2t2M_X(t)=\tfrac1{1-2b^2\cdot t^2/2}=\tfrac1{1-b^2t^2}. Laplace 분포의 mgf는 ∫12be−∣x∣/betxdx=12(11−bt+11+bt)=11−b2t2\int\tfrac1{2b}e^{-|x|/b}e^{tx}dx=\tfrac12\bigl(\tfrac1{1-bt}+\tfrac1{1+bt}\bigr)=\tfrac1{1-b^2t^2}. 유일성으로 같은 분포다.

연습 5.4 (베타–이항 ★★) p∼Beta(a,b)p\sim\mathrm{Beta}(a,b)이고 pp가 주어지면 S∼b(n,p)S\sim\mathrm b(n,p)일 때 ES=naa+bES=\tfrac{na}{a+b}, Var⁡S=npˉ(1−pˉ)a+b+na+b+1\Var S=n\bar p(1-\bar p)\tfrac{a+b+n}{a+b+1}, pˉ=aa+b\bar p=\tfrac a{a+b}임을 정리 5.2로 보여라. 이항보다 a+b+na+b+1\tfrac{a+b+n}{a+b+1}배 흩어진다.

풀이

E(S∣p)=npE(S\mid p)=np, Var⁡(S∣p)=np(1−p)\Var(S\mid p)=np(1-p). Ep=pˉEp=\bar p, Var⁡p=pˉ(1−pˉ)a+b+1\Var p=\tfrac{\bar p(1-\bar p)}{a+b+1}(따름정리 4.3). 정리 5.2로 ES=npˉES=n\bar p이고

Var⁡S=n(pˉ−Var⁡p−pˉ2)+n2Var⁡p=npˉ(1−pˉ)+n(n−1)Var⁡p=npˉ(1−pˉ)a+b+na+b+1.\Var S=n\bigl(\bar p-\Var p-\bar p^2\bigr)+n^2\Var p=n\bar p(1-\bar p)+n(n-1)\Var p=n\bar p(1-\bar p)\frac{a+b+n}{a+b+1} .

연습 5.5 (혼합의 mgf ★) 유한 혼합 f=∑πkfkf=\sum\pi_kf_k의 mgf가 ∑πkMk(t)\sum\pi_kM_k(t)임을 보이고, 독립합의 mgf(곱)와 혼동하지 말아야 할 이유를 설명하라.

풀이

E etX=∑kπkE(etX∣Θ=θk)=∑kπkMk(t)E\,e^{tX}=\sum_k\pi_kE(e^{tX}\mid\Theta=\theta_k)=\sum_k\pi_kM_k(t). 혼합은 하나의 관측이 한 성분에서 나오는 것이므로 mgf의 가중 평균이고, 독립합은 관측마다 모든 성분이 더해지는 것이므로 mgf의 곱이다.

이 회차에서 읽은 절 0개 · 회차 차례