
테마
노트북 · 4회 · 셈하는 분포와 섞인 분포
셈하는 분포와 섞인 분포 말에 차여 죽은 병사들
| 강의노트 | 04_counting_notes.pdf — 같은 절 번호, 같은 정리 번호. 증명은 노트에, 확인은 여기에 |
| 워크북 | 04_counting_workbook.pdf — 손으로 푸는 35문항. 다 푼 뒤 맨 끝 10절의 check()로 검산 |
| 원자료 | Bortkiewicz(1898)의 기병대 (vcd HorseKicks, VonBort) · Student(1907)의 효모 (HistData Yeast) · The Federalist의 may (vcd Federalist) |
| 선수 지식 | 1–3회 전체 (mgf, 야코비안, 전분산 공식, Box–Muller) |
여는 질문. 1875–1894년 프로이센 군대의 군단마다 해마다 말에 차여 죽은 병사의 수는 어떤 법칙을 따르는가? 한 군단에서 한 해에 네 명 이상이 죽는 일은 얼마나 드물어야 하는가?
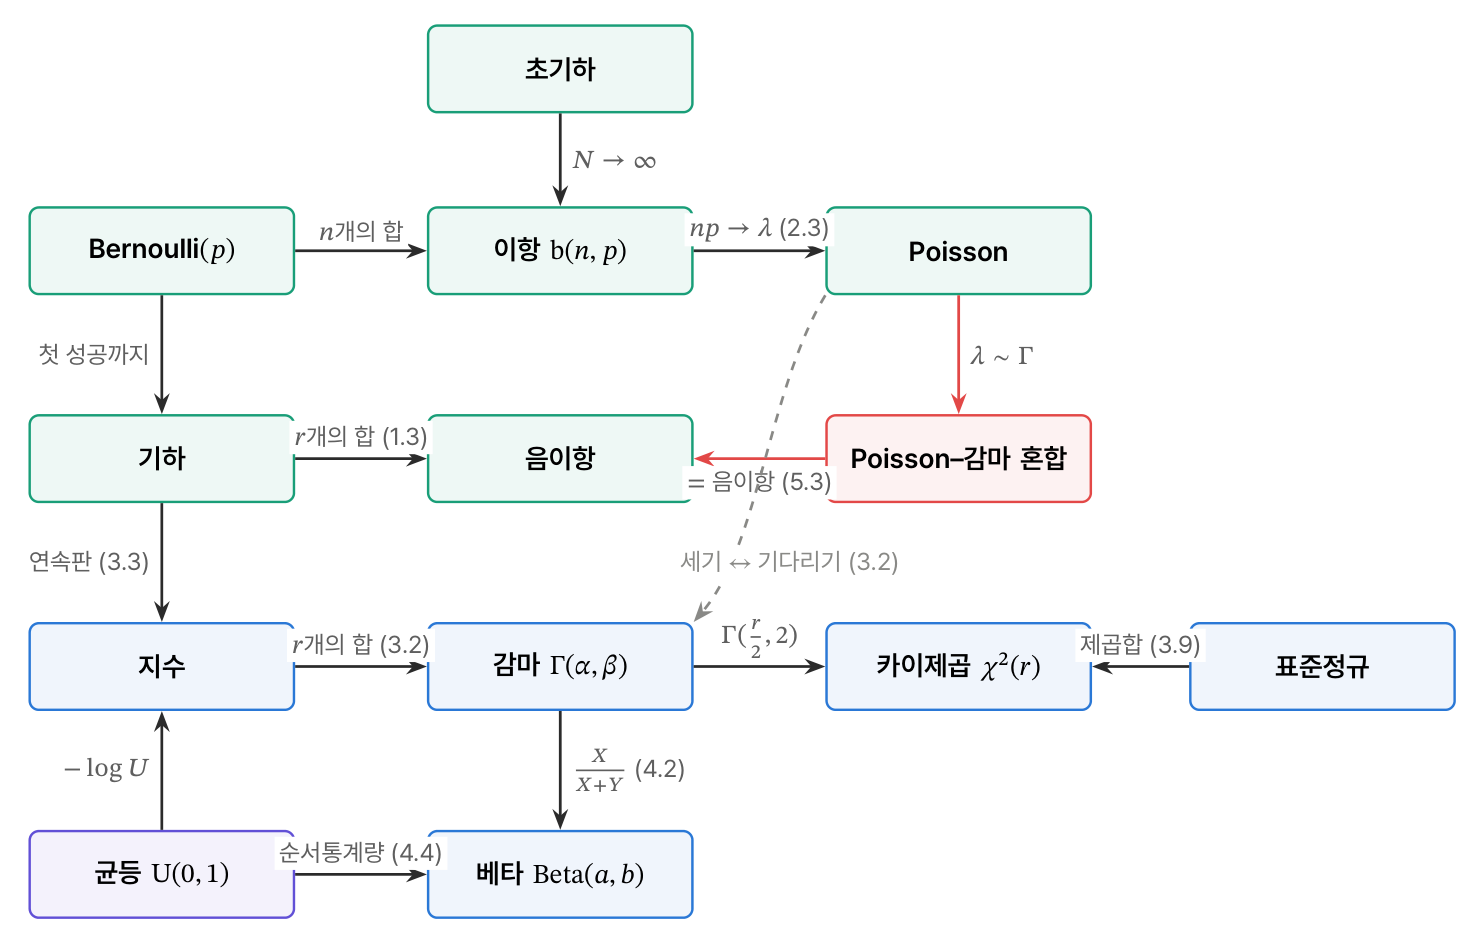
이번 회차의 지도
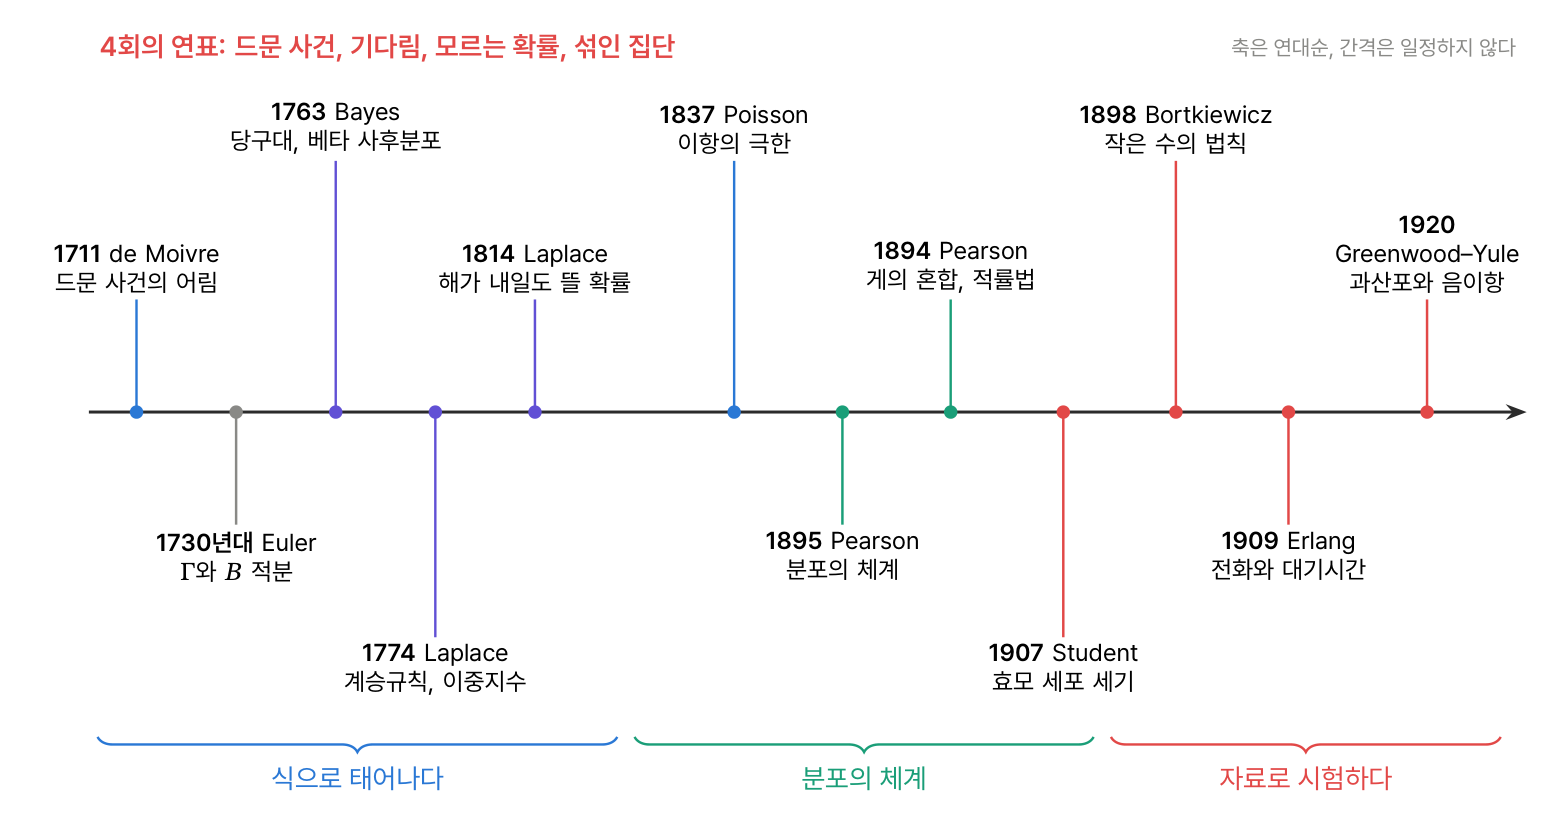
분포의 가족 — 화살표 위의 글은 한 분포에서 다른 분포를 얻는 방법이다.
학습 목표
Distribution기반 클래스와 하위 클래스(이항·음이항·초기하·Poisson·감마·베타)를 직접 구현하고 scipy와 대조한다.- 이항의 Poisson 극한, Poisson의 합과 나누기, Poisson 과정의 셈과 기다림을 시뮬레이션으로 확인한다.
- 감마 난수를 정규 난수(3회 Box–Muller)로 만드는 Marsaglia–Tsang 방법을 구현하고, 감마의 비로 베타를 만든다.
- Bayes의 당구대를 시뮬레이션하고 계승규칙을 확인한다.
- 원자료에 Poisson과 음이항을 맞추고, 분산 지수로 과산포를 진단한다.
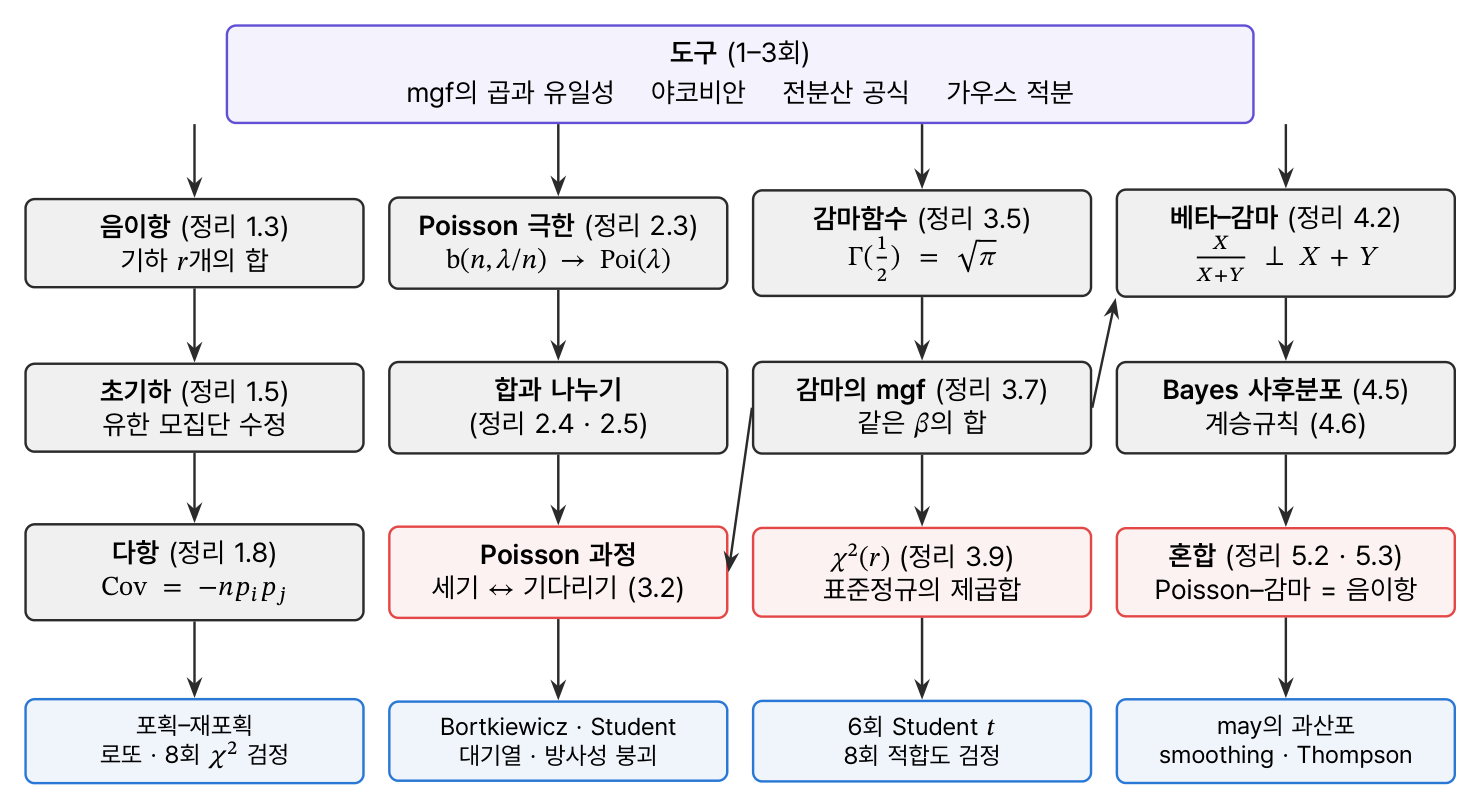
정리 지도
0. 설정과 Distribution 클래스
Legend13 노트북에서 신경망 층을 클래스로 쌓았듯, 이번 회차는 분포를 클래스로 쌓는다. 기반 클래스 Distribution은 평균·분산·mgf·표본을 정의대로 계산하고, check()가 그것을 scipy와 대조한다. 하위 클래스는 pmf나 pdf와 표본 생성 방법만 정한다.
python
%matplotlib inline
import itertools
import math
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import integrate, optimize, special, stats

SEED = 2026
N_SIM = 200_000
rng = np.random.default_rng(SEED)

C = dict(data="#1a9e78", stat="#2a78d6", key="#e34948", assume="#eb6834",
         theta="#6250d6", ink="#2b2b2b", hist="#8a8a86", grid="#e6e6e3")
SERIES = [C["stat"], C["data"], C["key"], C["theta"]]
THEORY = dict(color=C["ink"], ls="--", lw=1.6)
plt.rcParams.update({
    "figure.dpi": 110, "figure.figsize": (8, 4.2), "mathtext.fontset": "stix",
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.grid": True, "grid.color": C["grid"], "grid.linewidth": 0.8,
    "axes.edgecolor": "#9a9a96", "axes.labelcolor": C["ink"],
    "xtick.color": "#52514e", "ytick.color": "#52514e",
    "axes.titleweight": "bold", "axes.titlesize": 11, "axes.titlelocation": "left",
    "legend.frameon": False, "lines.linewidth": 2,
})

RDATASETS = "https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/master/csv/{}/{}.csv"
DATA_DIR = Path("../../data") if Path("../../.git").exists() else Path("data")

def load_rdata(item, package="HistData"):
    path = DATA_DIR / (f"{item}.csv" if package == "HistData" else f"{package}_{item}.csv")
    if not path.exists():
        DATA_DIR.mkdir(parents=True, exist_ok=True)
        pd.read_csv(RDATASETS.format(package, item)).drop(columns="rownames").to_csv(path, index=False)
    return pd.read_csv(path)

def report(checks):
    for name, ok in checks.items():
        print(f"  {'✓' if ok else '✗'}  {name}")
    assert all(checks.values()), "대조 실패"
python
class Distribution:
    """분포의 기반 클래스 — 하위 클래스는 _expect(g) 와 sample(n) 을 정한다"""
    name = "Distribution"

    def mean(self):
        return self._expect(lambda x: x)

    def var(self):
        m = self.mean()
        return self._expect(lambda x: (x - m) ** 2)

    def mgf(self, t):
        return self._expect(lambda x: np.exp(t * x))

    def check(self, ref, n=N_SIM, label=None):
        """scipy 분포 ref 와 평균·분산을 맞추고, 직접 만든 표본의 평균이 3 표준오차 안인지 본다"""
        xs = self.sample(n)
        m, v = self.mean(), self.var()
        return {f"{label or self.name}: 평균·분산 == scipy": np.allclose([m, v], [ref.mean(), ref.var()], rtol=1e-6),
                f"{label or self.name}: 표본 평균이 3 se 안": abs(xs.mean() - m) < 3 * math.sqrt(v / n)}


class Discrete(Distribution):
    def __init__(self, support):
        self.k = np.asarray(support)

    def _expect(self, g):
        return float(np.sum(g(self.k) * self.pmf(self.k)))

    def sample(self, n):                         # 2회 정리 4.7(a): searchsorted
        cdf = np.cumsum(self.pmf(self.k)); cdf /= cdf[-1]
        return self.k[np.searchsorted(cdf, rng.random(n))]


class Binomial(Discrete):
    name = "Binomial"
    def __init__(self, n, p):
        self.n, self.p = n, p; super().__init__(np.arange(n + 1))
    def pmf(self, k):
        return np.array([math.comb(self.n, int(j)) for j in k]) * self.p**k * (1 - self.p) ** (self.n - k)


class NegBinomial(Discrete):
    """r 번째 성공 전까지의 실패 수 (정의 1.2) — r 은 실수여도 된다"""
    name = "NegBinomial"
    def __init__(self, r, p, kmax=None):
        self.r, self.p = r, p
        kmax = kmax or int(r * (1 - p) / p + 40 * math.sqrt(r * (1 - p)) / p + 50)
        super().__init__(np.arange(kmax))
    def pmf(self, k):
        return np.exp(special.gammaln(k + self.r) - special.gammaln(k + 1) - special.gammaln(self.r)
                      + self.r * math.log(self.p) + k * math.log(1 - self.p))


class Hypergeom(Discrete):
    name = "Hypergeom"
    def __init__(self, N, K, n):
        self.N, self.K, self.n = N, K, n; super().__init__(np.arange(max(0, n - N + K), min(n, K) + 1))
    def pmf(self, k):
        return np.array([math.comb(self.K, int(j)) * math.comb(self.N - self.K, self.n - int(j)) for j in k]) / math.comb(self.N, self.n)


class Poisson(Discrete):
    name = "Poisson"
    def __init__(self, lam):
        self.lam = lam; super().__init__(np.arange(int(lam + 40 * math.sqrt(lam) + 40)))
    def pmf(self, k):
        return np.exp(-self.lam + k * math.log(self.lam) - special.gammaln(k + 1))

dists = [(Binomial(20, 0.3), stats.binom(20, 0.3)), (NegBinomial(3, 0.4), stats.nbinom(3, 0.4)),
         (NegBinomial(1.5, 0.65), stats.nbinom(1.5, 0.65)), (Hypergeom(52, 4, 5), stats.hypergeom(52, 4, 5)),
         (Poisson(2.5), stats.poisson(2.5))]
checks = {}
for d, ref in dists:
    checks |= d.check(ref, label=f"{d.name}")
    checks[f"{d.name}: pmf == scipy"] = np.allclose(d.pmf(d.k), ref.pmf(d.k))
report(checks)
text
  ✓  Binomial: 평균·분산 == scipy
  ✓  Binomial: 표본 평균이 3 se 안
  ✓  Binomial: pmf == scipy
  ✓  NegBinomial: 평균·분산 == scipy
  ✓  NegBinomial: 표본 평균이 3 se 안
  ✓  NegBinomial: pmf == scipy
  ✓  Hypergeom: 평균·분산 == scipy
  ✓  Hypergeom: 표본 평균이 3 se 안
  ✓  Hypergeom: pmf == scipy
  ✓  Poisson: 평균·분산 == scipy
  ✓  Poisson: 표본 평균이 3 se 안
  ✓  Poisson: pmf == scipy
1. Bernoulli 시행의 가족
정리 1.1 같은 의 독립 이항의 합은 이항 · 정리 1.3 는 독립인 기하 개의 합, , · 정리 1.5 초기하의 분산 · 정리 1.8 다항의 .
python
# 정리 1.1: b(3, 0.4) + b(5, 0.4) 의 합성곱 == b(8, 0.4)
conv = np.convolve(Binomial(3, 0.4).pmf(np.arange(4)), Binomial(5, 0.4).pmf(np.arange(6)))
# 정리 1.3: 기하(실패 수) r 개의 합 == 음이항
r, p = 4, 0.35
geo_sum = rng.geometric(p, (N_SIM, r)).sum(axis=1) - r
nb = NegBinomial(r, p)
freq = np.bincount(geo_sum, minlength=60)[:60] / N_SIM
# 연습 1.1: 확률이 다른 이항의 합은 과소산포
mixed_sum = rng.binomial(1, 0.1, N_SIM) + rng.binomial(1, 0.9, N_SIM)
report({"정리 1.1: b(3,.4) * b(5,.4) == b(8,.4)": np.allclose(conv, Binomial(8, 0.4).pmf(np.arange(9))),
        "정리 1.3: 기하 4개의 합의 상대도수 ≈ NB(4, .35) pmf (±0.005)": np.allclose(freq, nb.pmf(np.arange(60)), atol=5e-3),
        "정리 1.3: E Y = rq/p, Var Y = rq/p²": np.allclose([nb.mean(), nb.var()], [r * (1 - p) / p, r * (1 - p) / p**2]),
        "연습 1.1: b(1,.1)+b(1,.9) 의 분산 0.18 < b(2,.5) 의 0.5": abs(mixed_sum.var() - 0.18) < 0.005})

# 정리 1.5: 초기하의 분산 — 표본 비율이 클수록 유한 모집단 수정이 커진다
N, K = 100, 30
rows = []
for n in [5, 20, 50, 90, 100]:
    h = Hypergeom(N, K, n)
    rows.append(dict(n=n, var_hypergeom=h.var(), var_binomial=n * 0.3 * 0.7, ratio=h.var() / (n * 0.21), fpc=(N - n) / (N - 1)))
print(pd.DataFrame(rows).round(4).to_string(index=False))

# 정리 1.8: 다항의 공분산
probs = np.array([0.2, 0.5, 0.3]); n = 30
M = rng.multinomial(n, probs, N_SIM)
report({"정리 1.8: Cov(X1,X2) ≈ -n p1 p2 = -3 (±0.05)": abs(np.cov(M[:, 0], M[:, 1])[0, 1] + n * 0.2 * 0.5) < 0.05,
        "정리 1.8: X2 ~ b(30, 0.5) (평균·분산)": abs(M[:, 1].mean() - 15) < 0.05 and abs(M[:, 1].var() - 7.5) < 0.1})
text
  ✓  정리 1.1: b(3,.4) * b(5,.4) == b(8,.4)
  ✓  정리 1.3: 기하 4개의 합의 상대도수 ≈ NB(4, .35) pmf (±0.005)
  ✓  정리 1.3: E Y = rq/p, Var Y = rq/p²
  ✓  연습 1.1: b(1,.1)+b(1,.9) 의 분산 0.18 < b(2,.5) 의 0.5
  n  var_hypergeom  var_binomial  ratio    fpc
  5         1.0076          1.05 0.9596 0.9596
 20         3.3939          4.20 0.8081 0.8081
 50         5.3030         10.50 0.5051 0.5051
 90         1.9091         18.90 0.1010 0.1010
100         0.0000         21.00 0.0000 0.0000
  ✓  정리 1.8: Cov(X1,X2) ≈ -n p1 p2 = -3 (±0.05)
  ✓  정리 1.8: X2 ~ b(30, 0.5) (평균·분산)
python
# 예제 1.6 · 연습 1.5: 포획–재포획 — 가능도 L(N) = P_N(X = 16) 을 N 에 대해
K, n, x = 200, 100, 16
Ns = np.arange(K + n - x, 3001)
L = np.array([Hypergeom(int(N_), K, n).pmf(np.array([x]))[0] for N_ in Ns])
N_hat = Ns[np.argmax(L)]
fig, ax = plt.subplots(figsize=(8, 3.2))
ax.plot(Ns, L, color=C["stat"]); ax.axvline(n * K / x, color=C["key"], ls="--", label=f"nK/x = {n * K / x:.0f}")
ax.set_xlabel("population size N"); ax.set_ylabel("P_N(X = 16)"); ax.legend(); ax.set_title("capture–recapture: the likelihood peaks at nK/x")
plt.tight_layout(); plt.show()
report({"연습 1.5: 가능도를 최대로 하는 N == 1249 또는 1250": N_hat in (1249, 1250)})
print(f"연습 1.4: 로또 맞는 개수 — 평균 {Hypergeom(45, 6, 6).mean():.3f}, 분산 {Hypergeom(45, 6, 6).var():.4f}, P(3개) = {Hypergeom(45, 6, 6).pmf(np.array([3]))[0]:.4f}")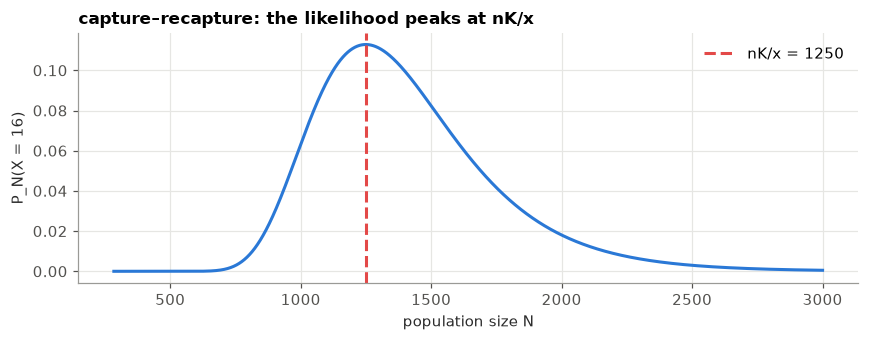
text
  ✓  연습 1.5: 가능도를 최대로 하는 N == 1249 또는 1250
연습 1.4: 로또 맞는 개수 — 평균 0.800, 분산 0.6145, P(3개) = 0.0224
📝 연습 1.1–1.6 (강의노트): 확률이 다르면, Banach의 성냥갑, 음이항의 적률, 로또와 초기하, 포획–재포획의 가능도, 다항의 조건부.
2. Poisson 분포 — 드문 사건의 법칙
정리 2.2 · 정리 2.3 · 정리 2.4 독립 Poisson의 합 · 정리 2.5 나누기(thinning): 표시된 수와 표시되지 않은 수는 독립.
이항과 Poisson의 거리(전변동 거리 )를 에 대해 그리고 Le Cam의 한계 와 비교한다.
python
def tv(p1, p2):
    return 0.5 * np.abs(p1 - p2).sum()

lam = 2.0
rows = []
for n in [5, 10, 20, 50, 100, 1000]:
    k = np.arange(0, n + 1)
    pb, pp = Binomial(n, lam / n).pmf(k), Poisson(lam).pmf(k)
    rows.append(dict(n=n, p=lam / n, TV=tv(pb, pp) + 0.5 * (1 - pp.sum()), LeCam_bound=n * (lam / n) ** 2))
tvt = pd.DataFrame(rows)
print(tvt.round(5).to_string(index=False))
report({"정리 2.3: TV 거리가 n 과 함께 0 으로": tvt.TV.is_monotonic_decreasing and tvt.TV.iloc[-1] < 1e-3,
        "Le Cam: TV ≤ n p² (모든 n)": bool((tvt.TV <= tvt.LeCam_bound).all())})

fig, axes = plt.subplots(1, 3, figsize=(13, 3.2), sharey=True)
kk = np.arange(0, 10)
for ax, n in zip(axes, [5, 20, 200]):
    ax.bar(kk, Binomial(n, lam / n).pmf(kk) if n <= 20 else stats.binom.pmf(kk, n, lam / n), color=C["data"], alpha=0.8, width=0.7, label=f"b({n}, {lam / n:g})")
    ax.plot(kk, Poisson(lam).pmf(kk), "o", mfc="none", mec=C["ink"], ms=7, mew=1.5, label="Poi(2)")
    ax.legend(); ax.set_xlabel("k")
axes[0].set_title("binomial → Poisson as p → 0 (Theorem 2.3)")
plt.tight_layout(); plt.show()

# 정리 2.5: 나누기 — N ~ Poi(5), 각 사건을 확률 0.3 으로 표시
Nn = rng.poisson(5.0, N_SIM)
N1 = rng.binomial(Nn, 0.3); N2 = Nn - N1
joint = pd.crosstab(N1, N2, normalize=True)
prod = np.outer(stats.poisson.pmf(joint.index, 1.5), stats.poisson.pmf(joint.columns, 3.5))
report({"정리 2.5: N1 ~ Poi(1.5), N2 ~ Poi(3.5) (평균·분산)": np.allclose([N1.mean(), N1.var(), N2.mean(), N2.var()], [1.5, 1.5, 3.5, 3.5], atol=0.03),
        "정리 2.5: Corr(N1, N2) ≈ 0 (독립)": abs(np.corrcoef(N1, N2)[0, 1]) < 0.01,
        "정리 2.5: 결합 pmf ≈ 두 Poisson pmf 의 곱 (±0.002)": np.allclose(joint.values, prod, atol=2e-3)})
Mfix = rng.multinomial(5, [0.3, 0.7], N_SIM)
print(f"비교: 전체가 5 로 고정된 다항이면 Corr = {np.corrcoef(Mfix[:, 0], Mfix[:, 1])[0, 1]:+.3f} (완전한 음의 상관)")
text
   n     p      TV  LeCam_bound
   5 0.400 0.12488        0.800
  10 0.200 0.05220        0.400
  20 0.100 0.02418        0.200
  50 0.040 0.00927        0.080
 100 0.020 0.00457        0.040
1000 0.002 0.00045        0.004
  ✓  정리 2.3: TV 거리가 n 과 함께 0 으로
  ✓  Le Cam: TV ≤ n p² (모든 n)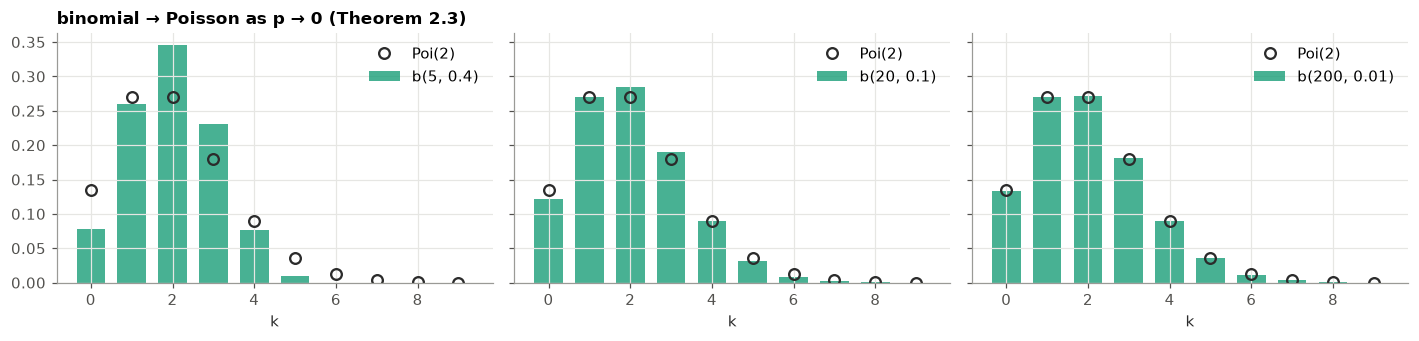
text
  ✓  정리 2.5: N1 ~ Poi(1.5), N2 ~ Poi(3.5) (평균·분산)
  ✓  정리 2.5: Corr(N1, N2) ≈ 0 (독립)
  ✓  정리 2.5: 결합 pmf ≈ 두 Poisson pmf 의 곱 (±0.002)
비교: 전체가 5 로 고정된 다항이면 Corr = -1.000 (완전한 음의 상관)
2.3 Bortkiewicz의 기병대와 Student의 효모
Fisher가 쓴 10개 군단 200개 군단–해(예제 2.6)에 Poisson을 맞추고, 연습 2.5의 꼬리 확률을 본다. 효모 네 농도(예제 2.7)의 분산 지수도 계산한다.
python
hk = load_rdata("HorseKicks", "vcd")
n_cy = hk.Freq.sum()
lam_hat = (hk.nDeaths * hk.Freq).sum() / n_cy
s2 = ((hk.nDeaths - lam_hat) ** 2 * hk.Freq).sum() / (n_cy - 1)
table = pd.DataFrame({"k": hk.nDeaths, "observed": hk.Freq, "Poisson expected": (n_cy * Poisson(lam_hat).pmf(hk.nDeaths.to_numpy())).round(1)})
print(table.to_string(index=False))
print(f"\nλ̂ = {lam_hat:.3f}   s² = {s2:.4f}   분산 지수 D = {s2 / lam_hat:.3f}")
p3, p4 = stats.poisson.sf(2, lam_hat), stats.poisson.sf(3, lam_hat)
print(f"연습 2.5: P(X ≥ 3) = {p3:.4f} → 200 × = {200 * p3:.1f} (관측 4)    P(X ≥ 4) = {p4:.4f} → {200 * p4:.2f} (관측 1)")

ye = load_rdata("Yeast")
rows = []
for s, d in ye.groupby("sample"):
    N = d.freq.sum(); m = (d["count"] * d.freq).sum() / N; v = ((d["count"] - m) ** 2 * d.freq).sum() / (N - 1)
    rows.append(dict(sample=s, squares=N, mean=round(m, 3), variance=round(v, 3), D=round(v / m, 3)))
print("\nStudent 1907, 효모:\n", pd.DataFrame(rows).to_string(index=False))
report({"예제 2.6: λ̂ = 0.61, D ≈ 1": math.isclose(lam_hat, 0.61) and abs(s2 / lam_hat - 1) < 0.01})

fig, axes = plt.subplots(1, 2, figsize=(12, 3.6))
axes[0].bar(hk.nDeaths, hk.Freq, color=C["data"], alpha=0.85, width=0.7, label="observed corps-years")
axes[0].plot(hk.nDeaths, table["Poisson expected"], "o", mfc="none", mec=C["ink"], ms=8, mew=1.5, label=f"Poisson({lam_hat:.2f})")
axes[0].legend(); axes[0].set_xlabel("deaths per corps per year"); axes[0].set_title("Bortkiewicz 1898 (Fisher's 10 corps)")
for (s, d), col in zip(ye.groupby("sample"), SERIES):
    N = d.freq.sum(); m = (d["count"] * d.freq).sum() / N
    axes[1].plot(d["count"], d.freq / N, "o", color=col, ms=5, label=f"sample {s}")
    kk = np.arange(0, d["count"].max() + 1)
    axes[1].plot(kk, stats.poisson.pmf(kk, m), color=col, lw=1, ls=":")
axes[1].legend(); axes[1].set_xlabel("yeast cells per square"); axes[1].set_title("Student 1907 (dotted: Poisson)")
plt.tight_layout(); plt.show()
text
 k  observed  Poisson expected
 0       109             108.7
 1        65              66.3
 2        22              20.2
 3         3               4.1
 4         1               0.6

λ̂ = 0.610   s² = 0.6110   분산 지수 D = 1.002
연습 2.5: P(X ≥ 3) = 0.0241 → 200 × = 4.8 (관측 4)    P(X ≥ 4) = 0.0036 → 0.71 (관측 1)

Student 1907, 효모:
 sample  squares  mean  variance     D
     A      400 0.682     0.814 1.192
     B      400 1.322     1.287 0.973
     C      400 1.800     1.965 1.092
     D      400 4.680     4.469 0.955
  ✓  예제 2.6: λ̂ = 0.61, D ≈ 1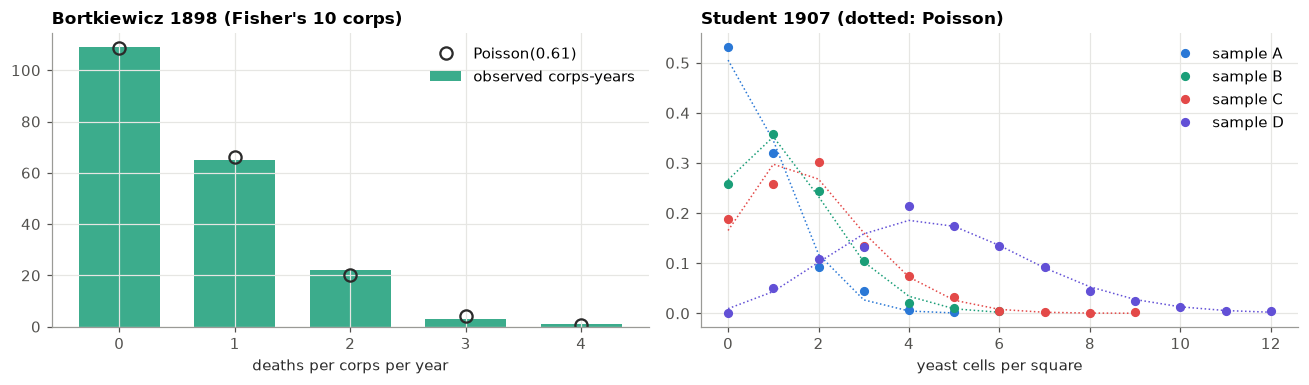
📝 연습 2.1–2.5 (강의노트): Poisson의 최빈값, mgf로 극한을, 오탈자, 조건부는 이항, 네 명 이상.
3. Poisson 과정과 감마분포
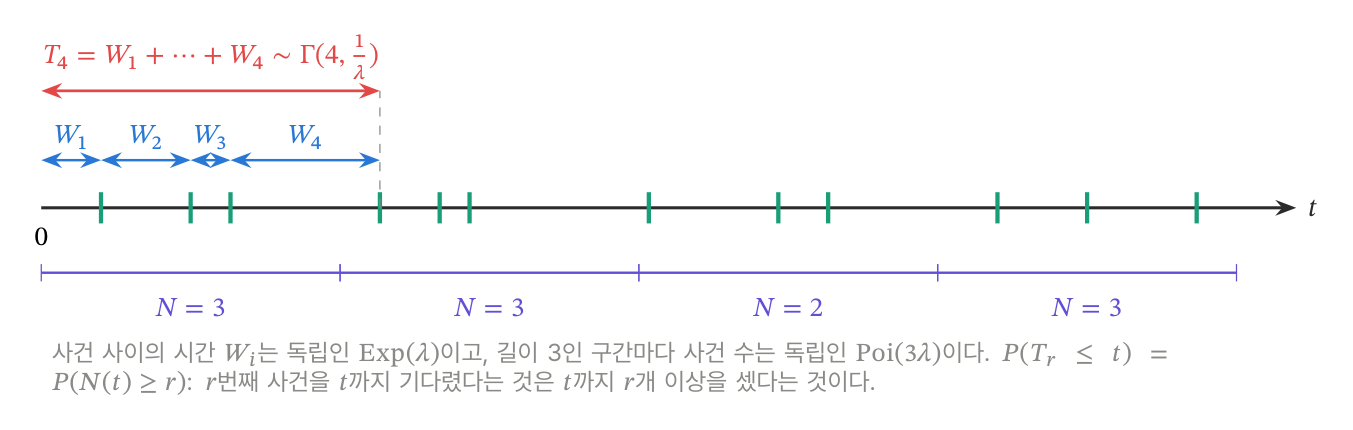
정리 3.2 , · 정리 3.3 지수분포의 무기억성 · 정리 3.5 · 정리 3.9 .
Poisson 과정을 사건 사이의 시간(독립인 지수분포)으로 만들고, 거기서 (1) 길이 1인 구간의 사건 수가 Poisson인지, (2) 번째 사건의 시각이 감마인지, (3) 무기억성을 확인한다.
python
lam, T_end = 3.0, 20_000.0
gaps = rng.exponential(1 / lam, int(lam * T_end * 1.2))
times = np.cumsum(gaps); times = times[times < T_end]
counts = np.histogram(times, bins=np.arange(0, T_end + 1))[0]            # 길이 1 인 구간의 사건 수
T5 = np.array([np.sum(rng.exponential(1 / lam, 5)) for _ in range(50_000)])
W = rng.exponential(1 / lam, N_SIM)
s_, t_ = 0.5, 0.4
report({"(1) 구간의 사건 수: 평균 ≈ 분산 ≈ λ = 3": abs(counts.mean() - 3) < 0.1 and abs(counts.var() / counts.mean() - 1) < 0.1,
        "(1) 구간의 사건 수 분포 ≈ Poi(3) (±0.01)": np.allclose(np.bincount(counts, minlength=12)[:12] / len(counts), stats.poisson.pmf(np.arange(12), 3), atol=0.01),
        "(2) 정리 3.2: T_5 ~ Γ(5, 1/λ) (KS)": stats.kstest(T5, stats.gamma(5, scale=1 / lam).cdf).pvalue > 1e-3,
        "(2) 정리 3.2: P(T_5 ≤ 2) == P(N(2) ≥ 5)": math.isclose(stats.gamma(5, scale=1 / lam).cdf(2), stats.poisson.sf(4, 2 * lam)),
        "(3) 정리 3.3: P(W > s+t | W > s) ≈ P(W > t)": abs(np.mean(W[W > s_] > s_ + t_) - np.exp(-lam * t_)) < 0.005,
        "정리 3.5: Γ(1/2)² == π, Γ(5) == 4!": math.isclose(special.gamma(0.5) ** 2, math.pi) and math.isclose(special.gamma(5), 24)})
print(f"연습 3.5: 분당 3개, 5번째 요청이 2분 안에: {stats.gamma(5, scale=1 / 3).cdf(2):.4f}")

fig, axes = plt.subplots(1, 2, figsize=(12, 3.4))
kk = np.arange(12)
axes[0].bar(kk, np.bincount(counts, minlength=12)[:12] / len(counts), color=C["data"], alpha=0.8, width=0.7, label="events per unit interval")
axes[0].plot(kk, stats.poisson.pmf(kk, lam), "o", mfc="none", mec=C["ink"], ms=7, label="Poi(3)")
axes[0].legend(); axes[0].set_title("counting: Poisson")
tt = np.linspace(0, 5, 300)
axes[1].hist(T5, bins=80, density=True, color=C["stat"], alpha=0.7, label="time of the 5th event")
axes[1].plot(tt, stats.gamma(5, scale=1 / lam).pdf(tt), **THEORY, label=r"$\Gamma(5, 1/3)$")
axes[1].legend(); axes[1].set_title("waiting: gamma (Theorem 3.2)")
plt.tight_layout(); plt.show()
text
  ✓  (1) 구간의 사건 수: 평균 ≈ 분산 ≈ λ = 3
  ✓  (1) 구간의 사건 수 분포 ≈ Poi(3) (±0.01)
  ✓  (2) 정리 3.2: T_5 ~ Γ(5, 1/λ) (KS)
  ✓  (2) 정리 3.2: P(T_5 ≤ 2) == P(N(2) ≥ 5)
  ✓  (3) 정리 3.3: P(W > s+t | W > s) ≈ P(W > t)
  ✓  정리 3.5: Γ(1/2)² == π, Γ(5) == 4!
연습 3.5: 분당 3개, 5번째 요청이 2분 안에: 0.7149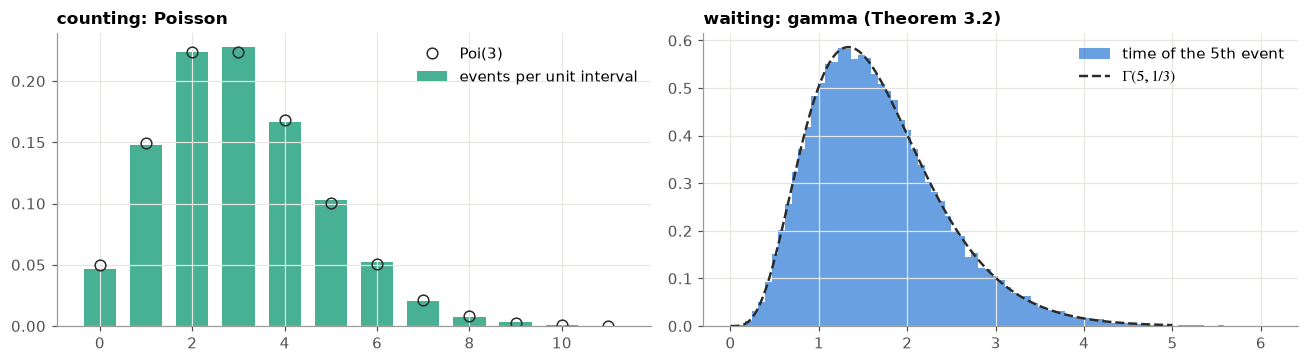
3.2 감마 난수를 직접 — Marsaglia–Tsang (2000)
정수가 아닌 의 감마 난수는 지수분포의 합으로 만들 수 없다. Marsaglia와 Tsang의 방법은 정규 난수(3회 Box–Muller)와 균등 난수로 감마 난수를 만드는 기각 표집이다. 이면 , , 으로 두고 이면 를 받아들인다. 이면 표본에 를 곱한다. 이것으로 Gamma 클래스를 만들고, 감마의 비로 Beta를 만든다(정리 4.2).
python
def box_muller(n):
    u1, u2 = rng.random(n), rng.random(n)
    return np.sqrt(-2 * np.log(u1)) * np.cos(2 * np.pi * u2)

def gamma_mt(alpha, n):
    """Marsaglia–Tsang: Γ(alpha, 1) 난수 n 개"""
    if alpha < 1:
        return gamma_mt(alpha + 1, n) * rng.random(n) ** (1 / alpha)
    d = alpha - 1 / 3; c = 1 / math.sqrt(9 * d)
    out = np.empty(0)
    while out.size < n:
        m = int((n - out.size) * 1.1) + 10
        z, u = box_muller(m), rng.random(m)
        v = (1 + c * z) ** 3
        ok = (v > 0) & (np.log(u) < 0.5 * z**2 + d - d * v + d * np.log(np.where(v > 0, v, 1)))
        out = np.concatenate([out, d * v[ok]])
    return out[:n]


class Continuous(Distribution):
    lo, hi = 0.0, np.inf
    def _expect(self, g):
        return integrate.quad(lambda x: g(x) * self.pdf(x), self.lo, self.hi, limit=200)[0]


class Gamma(Continuous):
    name = "Gamma"
    def __init__(self, alpha, beta):
        self.a, self.b = alpha, beta
    def pdf(self, x):
        return np.exp((self.a - 1) * np.log(x) - x / self.b - special.gammaln(self.a) - self.a * math.log(self.b))
    def sample(self, n):
        return self.b * gamma_mt(self.a, n)


class Beta(Continuous):
    name = "Beta"
    lo, hi = 0.0, 1.0
    def __init__(self, a, b):
        self.a, self.b = a, b
    def pdf(self, x):
        return np.exp((self.a - 1) * np.log(x) + (self.b - 1) * np.log1p(-x) - special.betaln(self.a, self.b))
    def sample(self, n):                        # 정리 4.2: X/(X+Y)
        x, y = gamma_mt(self.a, n), gamma_mt(self.b, n)
        return x / (x + y)

checks = {}
for d, ref in [(Gamma(0.5, 2.0), stats.gamma(0.5, scale=2.0)), (Gamma(2.7, 1.5), stats.gamma(2.7, scale=1.5)),
               (Beta(2, 5), stats.beta(2, 5)), (Beta(0.5, 0.5), stats.beta(0.5, 0.5))]:
    checks |= d.check(ref, label=f"{d.name}({d.a}, {d.b})")
    checks[f"{d.name}({d.a}, {d.b}): 직접 만든 표본 (KS)"] = stats.kstest(d.sample(50_000), ref.cdf).pvalue > 1e-3
chi = (box_muller(N_SIM) ** 2 + box_muller(N_SIM) ** 2 + box_muller(N_SIM) ** 2)
checks["정리 3.9: Z1²+Z2²+Z3² ~ χ²(3) (KS)"] = stats.kstest(chi, stats.chi2(3).cdf).pvalue > 1e-3
checks["정리 3.7: Γ(2,β)+Γ(1.5,β) ~ Γ(3.5,β) (KS)"] = stats.kstest(Gamma(2, 1.3).sample(50_000) + Gamma(1.5, 1.3).sample(50_000), stats.gamma(3.5, scale=1.3).cdf).pvalue > 1e-3
report(checks)

fig, axes = plt.subplots(1, 3, figsize=(13, 3.2))
for ax, d, rng_x in zip(axes, [Gamma(0.5, 2.0), Gamma(2.7, 1.5), Beta(0.5, 0.5)], [(0.02, 8), (0.01, 15), (0.005, 0.995)]):
    xs_ = d.sample(100_000)
    grid = np.linspace(*rng_x, 300)
    ax.hist(xs_[(xs_ > rng_x[0]) & (xs_ < rng_x[1])], bins=80, density=False,
            weights=np.full(((xs_ > rng_x[0]) & (xs_ < rng_x[1])).sum(), 1 / (len(xs_) * (rng_x[1] - rng_x[0]) / 80)),
            color=C["data"], alpha=0.75)
    ax.plot(grid, d.pdf(grid), **THEORY); ax.set_title(f"{d.name}({d.a}, {d.b}) by our own sampler", fontsize=10)
plt.tight_layout(); plt.show()
text
  ✓  Gamma(0.5, 2.0): 평균·분산 == scipy
  ✓  Gamma(0.5, 2.0): 표본 평균이 3 se 안
  ✓  Gamma(0.5, 2.0): 직접 만든 표본 (KS)
  ✓  Gamma(2.7, 1.5): 평균·분산 == scipy
  ✓  Gamma(2.7, 1.5): 표본 평균이 3 se 안
  ✓  Gamma(2.7, 1.5): 직접 만든 표본 (KS)
  ✓  Beta(2, 5): 평균·분산 == scipy
  ✓  Beta(2, 5): 표본 평균이 3 se 안
  ✓  Beta(2, 5): 직접 만든 표본 (KS)
  ✓  Beta(0.5, 0.5): 평균·분산 == scipy
  ✓  Beta(0.5, 0.5): 표본 평균이 3 se 안
  ✓  Beta(0.5, 0.5): 직접 만든 표본 (KS)
  ✓  정리 3.9: Z1²+Z2²+Z3² ~ χ²(3) (KS)
  ✓  정리 3.7: Γ(2,β)+Γ(1.5,β) ~ Γ(3.5,β) (KS)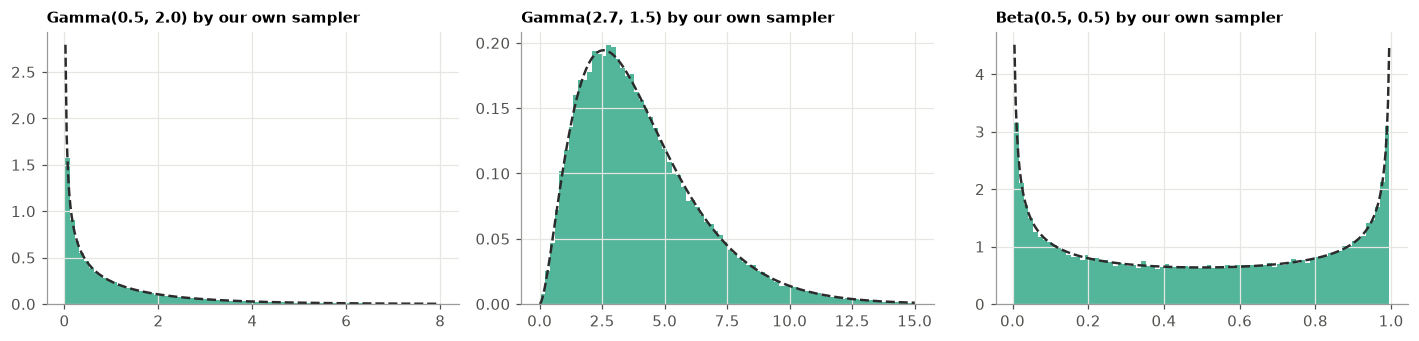
📝 연습 3.1–3.6 (강의노트): 망원급수, 사건 사이의 시간, 기하분포의 무기억성, 감마의 적률, 기다림과 셈, 반정수의 감마.
4. 베타분포 — Bayes의 당구대
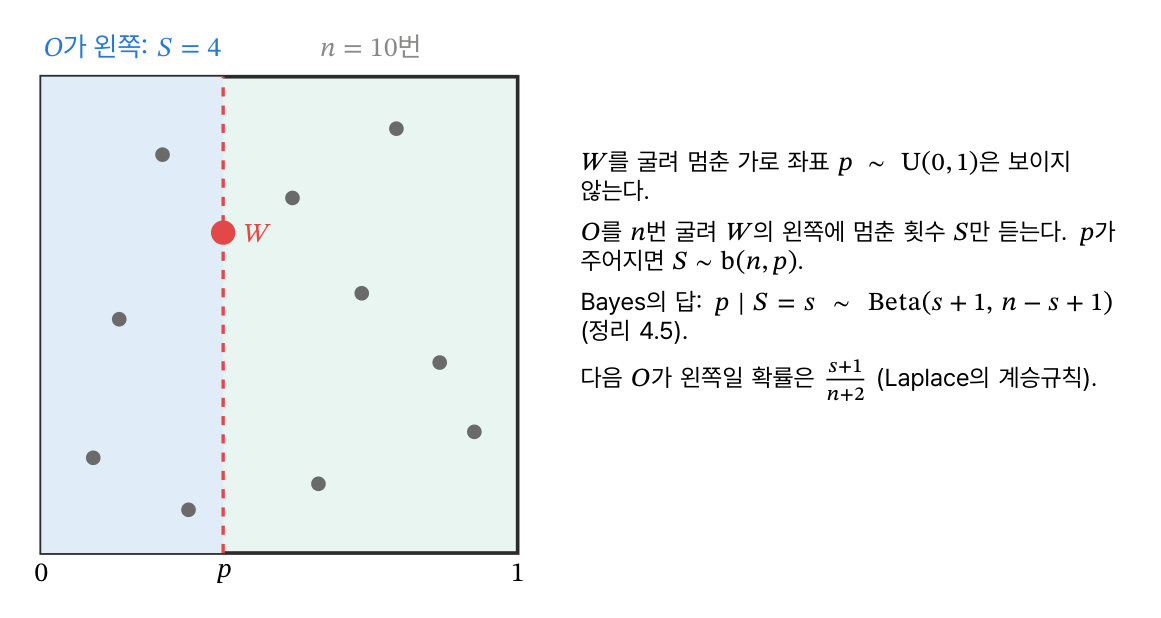
정리 4.2 이면 이고 와 독립 · 예제 4.4 · 정리 4.5 사후분포 · 따름정리 4.6 계승규칙 .
python
a, b = 2.5, 4.0
X, Y = gamma_mt(a, N_SIM), gamma_mt(b, N_SIM)
U, V = X / (X + Y), X + Y
# 독립의 확인: V 를 크기로 셋으로 나눠 각 그룹의 U 의 분포가 같은지
groups = np.digitize(V, np.quantile(V, [1 / 3, 2 / 3]))
report({"정리 4.2: U ~ Beta(2.5, 4) (KS)": stats.kstest(U, stats.beta(a, b).cdf).pvalue > 1e-3,
        "정리 4.2: V ~ Γ(6.5, 1) (KS)": stats.kstest(V, stats.gamma(a + b).cdf).pvalue > 1e-3,
        "정리 4.2: U ⊥ V — V 의 세 구간에서 U 의 평균이 같다 (±0.005)": np.ptp([U[groups == g].mean() for g in range(3)]) < 0.005,
        "정리 4.2: B(a,b) == Γ(a)Γ(b)/Γ(a+b)": math.isclose(integrate.quad(lambda x: x ** (a - 1) * (1 - x) ** (b - 1), 0, 1)[0],
                                                         special.gamma(a) * special.gamma(b) / special.gamma(a + b))})

# 예제 4.4: 균등분포 10개의 3번째로 작은 값 ~ Beta(3, 8)
U10 = np.sort(rng.random((N_SIM, 10)), axis=1)
report({"예제 4.4: U_(3) of 10 ~ Beta(3, 8) (KS)": stats.kstest(U10[:, 2], stats.beta(3, 8).cdf).pvalue > 1e-3,
        "예제 4.4: E U_(k) = k/(n+1)": np.allclose(U10.mean(axis=0), np.arange(1, 11) / 11, atol=0.002)})
text
  ✓  정리 4.2: U ~ Beta(2.5, 4) (KS)
  ✓  정리 4.2: V ~ Γ(6.5, 1) (KS)
  ✓  정리 4.2: U ⊥ V — V 의 세 구간에서 U 의 평균이 같다 (±0.005)
  ✓  정리 4.2: B(a,b) == Γ(a)Γ(b)/Γ(a+b)
  ✓  예제 4.4: U_(3) of 10 ~ Beta(3, 8) (KS)
  ✓  예제 4.4: E U_(k) = k/(n+1)
4.2 Bayes의 당구대를 굴려 본다
을 뽑고(공 ), 를 뽑는(공 를 번) 실험을 아주 많이 한다. 그 가운데 였던 실험들만 모아 의 히스토그램을 그리면, 정리 4.5의 가 나와야 한다. 조건부분포를 조건을 만족하는 실험만 골라서 보는 것이다. 연습 4.2의 "모든 가 같은 확률 "도 함께 본다.
python
n_roll = 10
p_true = rng.random(2_000_000)
S = rng.binomial(n_roll, p_true)
fig, axes = plt.subplots(1, 3, figsize=(13, 3.4))
uu = np.linspace(0.001, 0.999, 300)
checks = {}
for ax, s in zip(axes, [1, 4, 9]):
    sel = p_true[S == s]
    ax.hist(sel, bins=50, density=True, color=C["data"], alpha=0.75)
    ax.plot(uu, stats.beta.pdf(uu, s + 1, n_roll - s + 1), **THEORY)
    ax.set_title(f"S = {s} of {n_roll}: posterior Beta({s + 1}, {n_roll - s + 1})", fontsize=10)
    checks[f"정리 4.5: S={s} 인 실험의 p ~ Beta({s + 1},{n_roll - s + 1}) (KS)"] = stats.kstest(sel, stats.beta(s + 1, n_roll - s + 1).cdf).pvalue > 1e-3
    # 계승규칙: S=s 인 실험에서 '다음 공'이 왼쪽일 비율
    nxt = rng.random(sel.size) < sel
    checks[f"따름정리 4.6: S={s} → 다음 성공 비율 ≈ (s+1)/(n+2) = {(s + 1) / (n_roll + 2):.3f}"] = abs(nxt.mean() - (s + 1) / (n_roll + 2)) < 0.005
plt.tight_layout(); plt.show()
checks["연습 4.2: P(S = s) == 1/(n+1) (모든 s, ±0.002)"] = np.allclose(np.bincount(S) / S.size, 1 / (n_roll + 1), atol=2e-3)
report(checks)
print(f"Laplace 1814: 1,826,213일 연속 해가 떴으면 P(내일) = {1826214 / 1826215:.7f}  (1,826,214 대 1)")
print(f"연습 4.3: Beta(7,15) — 평균 {stats.beta(7, 15).mean():.4f}, 표준편차 {stats.beta(7, 15).std():.4f}   (p̂ = 0.3, se {math.sqrt(0.21 / 20):.4f})")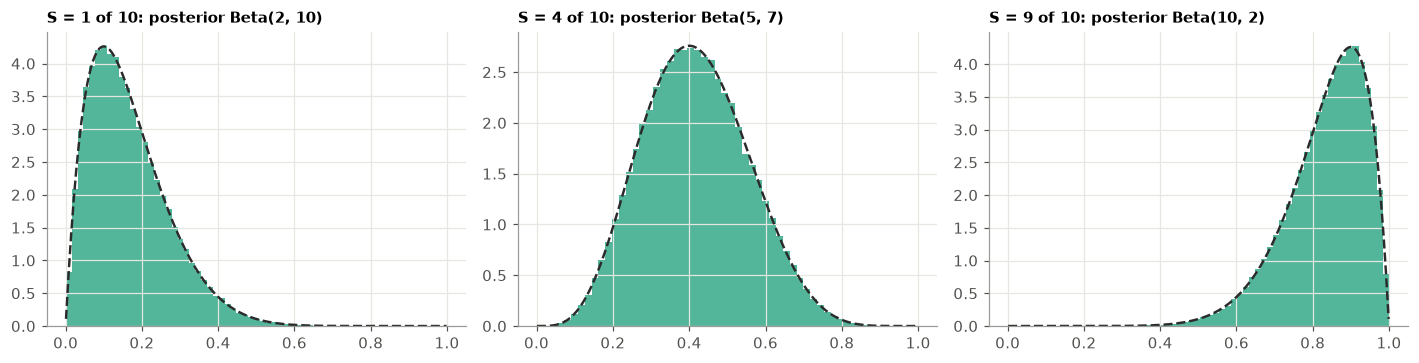
text
  ✓  정리 4.5: S=1 인 실험의 p ~ Beta(2,10) (KS)
  ✓  따름정리 4.6: S=1 → 다음 성공 비율 ≈ (s+1)/(n+2) = 0.167
  ✓  정리 4.5: S=4 인 실험의 p ~ Beta(5,7) (KS)
  ✓  따름정리 4.6: S=4 → 다음 성공 비율 ≈ (s+1)/(n+2) = 0.417
  ✓  정리 4.5: S=9 인 실험의 p ~ Beta(10,2) (KS)
  ✓  따름정리 4.6: S=9 → 다음 성공 비율 ≈ (s+1)/(n+2) = 0.833
  ✓  연습 4.2: P(S = s) == 1/(n+1) (모든 s, ±0.002)
Laplace 1814: 1,826,213일 연속 해가 떴으면 P(내일) = 0.9999995  (1,826,214 대 1)
연습 4.3: Beta(7,15) — 평균 0.3182, 표준편차 0.0971   (p̂ = 0.3, se 0.1025)
📝 연습 4.1–4.5 (강의노트): 순서통계량의 밀도, 균등 사전분포의 예측, 사후분포의 평균과 분산, 분포의 씨앗, Dirichlet로 가는 길.
5. 혼합분포 — 섞인 집단
정리 5.2 , · 정리 5.3 Poisson–감마 혼합은 음이항 · 예제 5.4 Laplace 분포는 정규의 분산 혼합.
python
# 정리 5.3: Λ ~ Γ(r, β), X | Λ ~ Poi(Λ)  →  NB(r, 1/(1+β))
r_, beta_ = 1.5, 0.5
Lam = Gamma(r_, beta_).sample(N_SIM)
Xm = rng.poisson(Lam)
nbm = NegBinomial(r_, 1 / (1 + beta_))
kk = np.arange(10)
report({"정리 5.3: 혼합의 상대도수 ≈ NB(1.5, 2/3) pmf (±0.004)": np.allclose(np.bincount(Xm, minlength=10)[:10] / N_SIM, nbm.pmf(kk), atol=4e-3),
        "정리 5.3: E X = rβ, Var X = rβ + rβ² (정리 5.2)": abs(Xm.mean() - r_ * beta_) < 0.01 and abs(Xm.var() - (r_ * beta_ + r_ * beta_**2)) < 0.02})

fig, ax = plt.subplots(figsize=(8, 3.4))
ax.bar(kk - 0.2, np.bincount(Xm, minlength=10)[:10] / N_SIM, width=0.4, color=C["data"], label="Gamma-then-Poisson (simulated)")
ax.bar(kk + 0.2, Poisson(r_ * beta_).pmf(kk), width=0.4, color=C["hist"], alpha=0.6, label="Poisson, same mean")
ax.plot(kk, nbm.pmf(kk), "o", mfc="none", mec=C["key"], ms=8, mew=1.5, label="NB(1.5, 2/3)")
ax.set_yscale("log"); ax.legend(); ax.set_title("overdispersion: the mixture has more zeros and a longer tail")
plt.tight_layout(); plt.show()

# 연습 5.1: 두 집단의 키
sex = rng.random(N_SIM) < 0.5
H = np.where(sex, rng.normal(175, 7, N_SIM), rng.normal(162, 6, N_SIM))
between = 0.5 * (175 - 168.5) ** 2 + 0.5 * (162 - 168.5) ** 2
print(f"연습 5.1: 섞은 키 분산 {H.var():.2f} (이론 {42.5 + between:.2f}),  집단 사이 비율 {between / (42.5 + between):.3f}")

# 예제 5.4 · 연습 5.3: V ~ Exp(평균 2b²), X | V ~ N(0, V)  →  Laplace(0, b)
b_ = 1.3
Vm = rng.exponential(2 * b_**2, N_SIM)
XL = rng.normal(0, np.sqrt(Vm))
report({"예제 5.4: 정규의 분산 혼합 ~ Laplace(0, 1.3) (KS)": stats.kstest(XL, stats.laplace(scale=b_).cdf).pvalue > 1e-3})

# 연습 5.4: 베타–이항의 과산포
a_, bb, n_ = 2, 3, 20
pB = rng.beta(a_, bb, N_SIM); SB = rng.binomial(n_, pB)
pbar = a_ / (a_ + bb)
report({"연습 5.4: Var S = n p̄(1-p̄)(a+b+n)/(a+b+1)": abs(SB.var() / (n_ * pbar * (1 - pbar) * (a_ + bb + n_) / (a_ + bb + 1)) - 1) < 0.02})
text
  ✓  정리 5.3: 혼합의 상대도수 ≈ NB(1.5, 2/3) pmf (±0.004)
  ✓  정리 5.3: E X = rβ, Var X = rβ + rβ² (정리 5.2)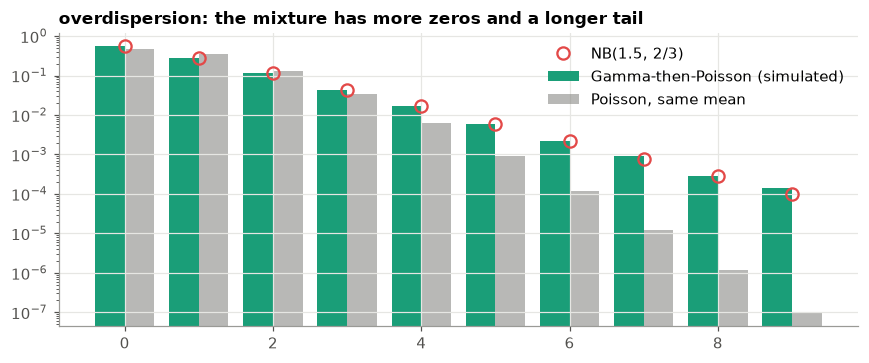
text
연습 5.1: 섞은 키 분산 84.52 (이론 84.75),  집단 사이 비율 0.499
  ✓  예제 5.4: 정규의 분산 혼합 ~ Laplace(0, 1.3) (KS)
text
✓ 연습 5.4: Var S = n p̄(1-p̄)(a+b+n)/(a+b+1)📝 연습 5.1–5.5 (강의노트): 두 집단, 음이항의 과산포, Laplace는 정규의 혼합, 베타–이항, 혼합의 mgf.
6. 데이터로 — 말발굽, 효모, 그리고 may
정의 6.1 분산 지수 · 적률법: , .
14개 군단 전체(예제 6.2)에서 군단 합계의 흩어짐을 재고, Madison의 may(예제 6.3)에 Poisson과 음이항을 맞춘다.
python
vb = load_rdata("VonBort", "vcd")
tot = vb.groupby("corps").deaths.sum()
chi2_stat = ((tot - tot.mean()) ** 2 / tot.mean()).sum()
pval = stats.chi2.sf(chi2_stat, len(tot) - 1)
D_all = vb.deaths.var() / vb.deaths.mean()
D_fisher = vb[vb.fisher == "yes"].deaths.var() / vb[vb.fisher == "yes"].deaths.mean()
print(f"14개 군단 전체: D = {D_all:.3f}    Fisher 의 10개 군단: D = {D_fisher:.3f}")
print(f"군단 합계의 산포 Σ(T_c - T̄)²/T̄ = {chi2_stat:.1f}, 자유도 {len(tot) - 1}, P(χ² ≥ 이 값) = {pval:.3f}")
print("군단별 20년 합계:", tot.sort_values().to_dict())

fe = load_rdata("Federalist", "vcd")
N = fe.Freq.sum(); xbar = (fe.nMay * fe.Freq).sum() / N; s2 = ((fe.nMay - xbar) ** 2 * fe.Freq).sum() / (N - 1)
p_hat = xbar / s2; r_hat = xbar * p_hat / (1 - p_hat)
k = fe.nMay.to_numpy()
fit = pd.DataFrame({"may": k, "observed": fe.Freq,
                    "Poisson": (N * Poisson(xbar).pmf(k)).round(1),
                    "NegBinomial": (N * NegBinomial(r_hat, p_hat).pmf(k)).round(1)})
print(f"\nMadison 의 may: n = {N}, x̄ = {xbar:.3f}, s² = {s2:.3f}, D = {s2 / xbar:.2f}   → 적률법 NB(r̂ = {r_hat:.2f}, p̂ = {p_hat:.3f}),  β̂ = {1 / p_hat - 1:.2f}")
print(fit.to_string(index=False))
lam0 = -math.log(fe.Freq.iloc[0] / N)
print(f"\n연습 6.3: 0 의 비율로 추정한 λ = {lam0:.3f}  vs  평균 {xbar:.3f}  — Poisson 이면 같아야 한다")
report({"예제 6.2: 군단 산포 χ² ≈ 27.3, p ≈ 0.011": abs(chi2_stat - 27.29) < 0.05 and abs(pval - 0.0114) < 0.001,
        "예제 6.3: D ≈ 1.54, NB 가 0 과 꼬리를 더 잘 맞춘다":
            abs(s2 / xbar - 1.535) < 0.01 and abs(fit.NegBinomial.iloc[0] - 156) < abs(fit.Poisson.iloc[0] - 156)})

fig, axes = plt.subplots(1, 2, figsize=(12, 3.6))
axes[0].bar(k, fe.Freq, color=C["data"], alpha=0.85, width=0.7, label="observed")
axes[0].plot(k, fit.Poisson, "o", mfc="none", mec=C["ink"], ms=7, label="Poisson")
axes[0].plot(k, fit.NegBinomial, "x", color=C["key"], ms=8, mew=2, label="negative binomial")
axes[0].set_yscale("log"); axes[0].set_ylim(0.05, 300); axes[0].legend(); axes[0].set_title("Madison's 'may' (log scale: the tail)")
srt = tot.sort_values()
axes[1].bar(range(len(srt)), srt.values, color=[C["assume"] if c in ("G", "I", "VI", "XI") else C["stat"] for c in srt.index])
axes[1].axhspan(tot.mean() - 2 * math.sqrt(tot.mean()), tot.mean() + 2 * math.sqrt(tot.mean()), color=C["hist"], alpha=0.25)
axes[1].set_xticks(range(len(srt))); axes[1].set_xticklabels(srt.index); axes[1].set_title("20-year deaths by corps (orange: set aside)")
plt.tight_layout(); plt.show()
text
14개 군단 전체: D = 1.090    Fisher 의 10개 군단: D = 1.002
군단 합계의 산포 Σ(T_c - T̄)²/T̄ = 27.3, 자유도 13, P(χ² ≥ 이 값) = 0.011
군단별 20년 합계: {'VIII': 7, 'IV': 8, 'XV': 8, 'V': 11, 'III': 12, 'VII': 12, 'II': 12, 'IX': 13, 'X': 15, 'I': 16, 'G': 16, 'VI': 17, 'XIV': 24, 'XI': 25}

Madison 의 may: n = 262, x̄ = 0.656, s² = 1.008, D = 1.54   → 적률법 NB(r̂ = 1.23, p̂ = 0.651),  β̂ = 0.54
 may  observed  Poisson  NegBinomial
   0       156    135.9        154.9
   1        63     89.2         66.2
   2        29     29.3         25.7
   3         8      6.4          9.6
   4         4      1.1          3.6
   5         1      0.1          1.3
   6         1      0.0          0.5

연습 6.3: 0 의 비율로 추정한 λ = 0.518  vs  평균 0.656  — Poisson 이면 같아야 한다
  ✓  예제 6.2: 군단 산포 χ² ≈ 27.3, p ≈ 0.011
  ✓  예제 6.3: D ≈ 1.54, NB 가 0 과 꼬리를 더 잘 맞춘다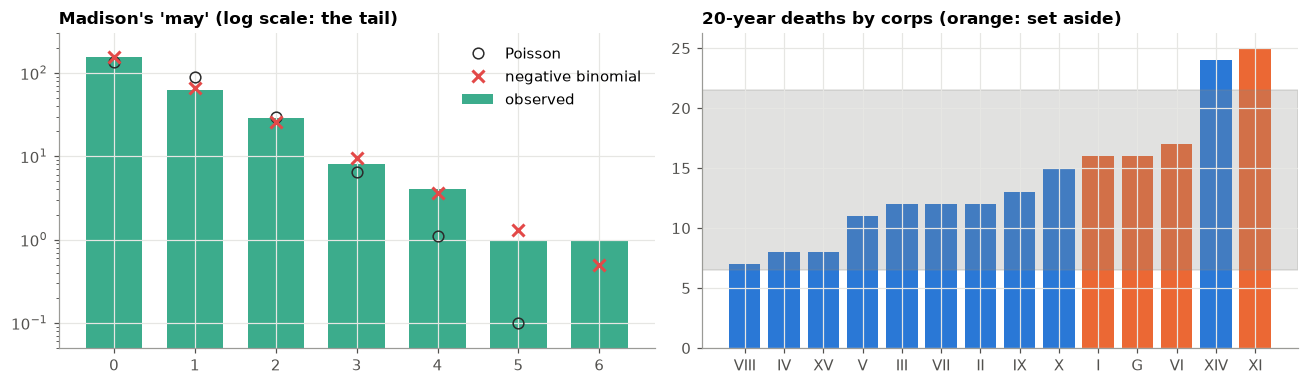
📝 연습 6.1–6.3 (강의노트): 효모의 농도, 적률법, 0의 개수.
7. 부숴보기 — 가족의 경계
(1) Poisson인 척하는 음이항의 꼬리, (2) 가 클 때 Poisson 근사의 실패, (3) 무기억성이 지수분포만의 성질이라는 것(위험함수), (4) 정규 혼합의 봉우리가 둘이 되는 경계 .
python
# (1) 연습 7.1
pt, nt = stats.poisson.sf(9, 2), stats.nbinom.sf(9, 4, 2 / 3)
print(f"(1) P(X ≥ 10): Poisson(2) {pt:.2e}   NB(4, 2/3) {nt:.2e}   비 {nt / pt:.0f}배   (평균은 둘 다 2, 분산 2 vs 3)")
# (2) b(20, 0.4) vs Poi(8)
k = np.arange(0, 41)
print(f"(2) TV(b(20,0.4), Poi(8)) = {tv(Binomial(20, 0.4).pmf(np.arange(21)), Poisson(8).pmf(np.arange(21))) + 0.5 * stats.poisson.sf(20, 8):.3f}")

# (3) 위험함수 h(t) = f/(1-F) — 연습 7.2
tt = np.linspace(0.01, 6, 300)
fig, axes = plt.subplots(1, 2, figsize=(12, 3.6))
for a_, col in zip([0.5, 1, 2, 5], SERIES):
    g = stats.gamma(a_)
    axes[0].plot(tt, g.pdf(tt) / g.sf(tt), color=col, label=rf"$\Gamma({a_}, 1)$")
axes[0].plot(tt, tt / (1 + tt), ":", color=C["ink"], lw=1.2, label=r"$t/(1+t)$ (Exercise 7.2)")
axes[0].set_ylim(0, 3); axes[0].set_xlabel("t"); axes[0].set_ylabel("hazard h(t)"); axes[0].legend(fontsize=8)
axes[0].set_title("only the exponential has a constant hazard")

# (4) 연습 7.3: ½N(-δ,1) + ½N(δ,1) — 0 이 극소가 되는 경계
xx = np.linspace(-5, 5, 600)
for dlt, col in zip([0.6, 1.0, 1.4, 2.0], SERIES):
    axes[1].plot(xx, 0.5 * stats.norm.pdf(xx, -dlt) + 0.5 * stats.norm.pdf(xx, dlt), color=col, label=rf"$\delta={dlt}$")
axes[1].legend(); axes[1].set_title("two modes only when δ > 1 (Exercise 7.3)")
plt.tight_layout(); plt.show()
second = lambda d: (0.5 * stats.norm.pdf(1e-3, -d) + 0.5 * stats.norm.pdf(1e-3, d)) - (0.5 * stats.norm.pdf(0, -d) + 0.5 * stats.norm.pdf(0, d))
report({"연습 7.3: δ = 0.9 이면 0 이 극대, δ = 1.1 이면 극소": second(0.9) < 0 < second(1.1)})
text
(1) P(X ≥ 10): Poisson(2) 4.65e-05   NB(4, 2/3) 1.65e-03   비 35배   (평균은 둘 다 2, 분산 2 vs 3)
(2) TV(b(20,0.4), Poi(8)) = 0.122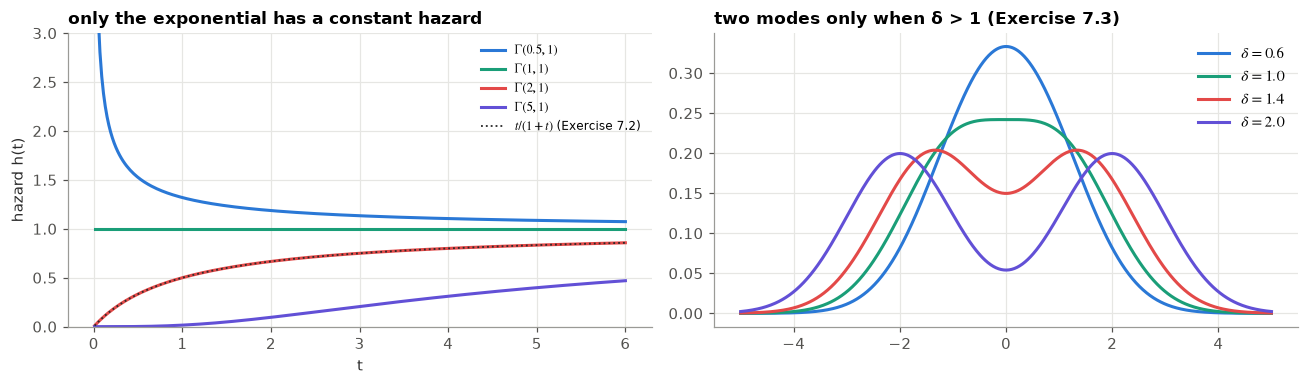
text
✓ 연습 7.3: δ = 0.9 이면 0 이 극대, δ = 1.1 이면 극소📝 연습 7.1–7.3 (강의노트): 꼬리의 차이, 위험함수, 두 봉우리의 조건.
8. Beautiful insights — 같은 가족, 오늘의 문제
8.2 Thompson 샘플링 (1933)
클릭률이 0.05와 0.07인 광고 두 개. 사후분포 에서 하나씩 뽑아 큰 쪽을 보여 준다. 늘 평균이 큰 쪽만 보여 주는 탐욕 정책, 무작위 정책과 후회(regret: 늘 좋은 광고를 보여 줬다면 얻었을 클릭과의 차이)를 비교한다.
python
true_p = np.array([0.05, 0.07])
T_steps, n_runs = 5000, 200

def run(policy):
    regret = np.zeros(T_steps)
    for _ in range(n_runs):
        s, f = np.zeros(2), np.zeros(2)
        cum = 0.0
        for t in range(T_steps):
            if policy == "thompson":
                arm = int(np.argmax(rng.beta(1 + s, 1 + f)))
            elif policy == "greedy":
                arm = int(np.argmax((1 + s) / (2 + s + f)))
            else:
                arm = int(rng.integers(2))
            r_ = rng.random() < true_p[arm]
            s[arm] += r_; f[arm] += 1 - r_
            cum += true_p.max() - true_p[arm]
            regret[t] += cum
    return regret / n_runs

fig, ax = plt.subplots(figsize=(8, 3.6))
for pol, col in zip(["random", "greedy", "thompson"], [C["hist"], C["assume"], C["stat"]]):
    ax.plot(run(pol), color=col, label=pol)
ax.set_xlabel("rounds"); ax.set_ylabel("expected regret (clicks lost)"); ax.legend(); ax.set_title("Thompson sampling: Beta posteriors decide whom to explore")
plt.tight_layout(); plt.show()

# 연습 8.2: Beta(4,8) vs Beta(2,2)
pA, pB = rng.beta(4, 8, N_SIM), rng.beta(2, 2, N_SIM)
exact = integrate.quad(lambda x: stats.beta(2, 2).pdf(x) * stats.beta(4, 8).cdf(x), 0, 1)[0]
report({"연습 8.2: P(p_B > p_A) ≈ 0.725 (시뮬레이션 == 적분)": abs(np.mean(pB > pA) - exact) < 0.005 and abs(exact - 0.7253) < 1e-3})

# 연습 8.1: add-one smoothing
V_, N_ = 10_000, 10**6
print(f"연습 8.1: p̂(처음 보는 단어) = {1 / (N_ + V_):.2e},  p̂(1,000번 나온 단어) = {1001 / (N_ + V_):.3e}  (상대도수 1.000e-03)")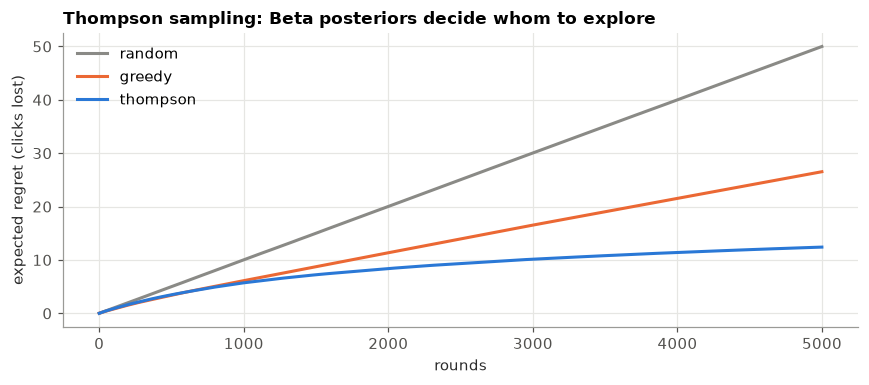
text
  ✓  연습 8.2: P(p_B > p_A) ≈ 0.725 (시뮬레이션 == 적분)
연습 8.1: p̂(처음 보는 단어) = 9.90e-07,  p̂(1,000번 나온 단어) = 9.911e-04  (상대도수 1.000e-03)
9. 정리 · 연습문제 지도 · 다음 회
| 내용 | 확인한 셀 | |
|---|---|---|
Distribution 계층 |
이항·음이항·초기하·Poisson·감마·베타를 정의대로, scipy와 대조 | 0절, 3.2 |
| Bernoulli 가족 (1.1–1.8) | 합성곱, 기하의 합 = 음이항, 유한 모집단 수정, 다항의 음의 공분산, 포획–재포획 | 1절 |
| Poisson (2.2–2.5) | TV 거리와 Le Cam, 나누기의 독립, Bortkiewicz, Student | 2절 |
| Poisson 과정 · 감마 (3.2–3.9) | 셈 ↔ 기다림, 무기억성, Marsaglia–Tsang, | 3절 |
| 베타 (4.2–4.6) | 감마의 비와 독립, 순서통계량, Bayes의 당구대, 계승규칙 | 4절 |
| 혼합 (5.2–5.4) | Poisson–감마 = 음이항, Laplace = 정규의 혼합, 베타–이항 | 5절 |
| 자료 (6.2, 6.3) | 군단의 이질성 , may의 과산포 | 6절 |
| 부숴보기 · 오늘 (7, 8절) | 꼬리 35배, 위험함수, 봉우리의 경계, Thompson 샘플링 | 7, 8절 |
연습문제 지도 (강의노트, ★ 계산 · ★★ 증명 · ★★★ 도전, 풀이는 부록 A)
| 절 | 연습 | 이 노트북에서 확인하는 셀 |
|---|---|---|
| 1 Bernoulli 가족 | 1.1 ★ · 1.2 Banach ★★ · 1.3 ★ · 1.4 로또 ★ · 1.5 포획–재포획 ★★ · 1.6 ★★ · 1.7 이항의 합 증명 ★ · 1.8 다항의 공분산 증명 ★★ (유도형) | 1절 |
| 2 Poisson | 2.1 ★ · 2.2 ★★ · 2.3 오탈자 ★ · 2.4 ★★ · 2.5 네 명 이상 ★ · 2.6 Poisson 적률 증명 ★ · 2.7 Poisson 합 증명 ★★ (유도형) | 2절 |
| 3 과정 · 감마 | 3.1 ★ · 3.2 ★★ · 3.3 ★ · 3.4 ★ · 3.5 기다림과 셈 ★ · 3.6 ★ · 3.7 감마함수 증명 ★★ · 3.8 감마 mgf 증명 ★ · 3.9 증명 ★★ (유도형) | 3절 |
| 4 베타 | 4.1 ★★ · 4.2 ★★ · 4.3 ★ · 4.4 의 씨앗 ★★ · 4.5 Dirichlet ★★★ · 4.6 사후분포 증명 ★★ (유도형) | 4절 |
| 5 혼합 | 5.1 ★ · 5.2 ★ · 5.3 Laplace ★★★ · 5.4 베타–이항 ★★ · 5.5 ★ | 5절 |
| 6 · 7 · 8 | 6.1 ★ · 6.2 적률법 ★ · 6.3 ★★ · 7.1 ★ · 7.2 위험함수 ★★ · 7.3 봉우리 ★★★ · 8.1 ★ · 8.2 Thompson ★★ | 6–8절 |
다음 회 (5회) — 정규분포의 탄생과 Galton의 타원 (1733 → 1901). 이항(큰 ), 감마(큰 ), 베타(큰 )가 모두 종 모양으로 가는 것을 이번 회차의 그림에서 보았다. 5회는 그 종이 어떻게 태어났는지(de Moivre 1733, Gauss 1809, Laplace 1810), 그리고 두 변수의 정규분포가 Galton의 회귀를 어떻게 설명하는지 본다. 이 회차의 (정리 3.9)와 감마함수가 5회의 이차형식에서 쓰인다.
10. 워크북 검산
워크북(04_counting_workbook.pdf)의 문제는 손으로 먼저 푼다. 이 절은 다 푼 뒤에 쓴다.
check("A10c", "11/16")— 문항 번호와 손으로 구한 답을 넣으면 맞는지만 알려 준다. 정답은 보여 주지 않는다. 답은 수(11/16,0.6875)나 식의 문자열("lam**3+3*lam**2+lam","exp(-1)-exp(-2)")로 넣는다. 소문항은"A5d"처럼 번호 뒤에 붙인다. 소수로 넣으면 상대오차 0.1%까지 맞다고 본다.- 시뮬레이션으로 한 번 더 — 확률이나 기댓값이 답인 문항은 아래에 시뮬레이션 함수를 정의해 두었다. 손으로 구한 값이 Monte Carlo 구간 안에 드는지 본다. 함수는 정의만 해 두었고 부르지 않았다. 답을 구하기 전에 부르면 답이 보인다.
증명 문제(B, C의 대부분)는 check()가 없다. 풀이판의 증명과 단계별로 맞춰 본다.
답 열쇠 셀 (내려받은 노트북에서 실행된다)
답 열쇠를 압축해 넣은 check() 정의 셀이다. 웹에서는 이 회차의 답 확인 페이지를 쓴다.
python
check()                 # 확인할 수 있는 문항 번호
check("A10c")           # 답을 넣지 않으면 쓰는 법을 알려 준다
text
확인할 수 있는 문항: A1a A1b A2a A2b A2c A3a A3b A3c A4a A4b A4c A5a A5b A5c A5d A6a A6b A6c A7a A7b A7c A8a A8b A8c A9a A9b A9c A10a A10b A10c A11a A11b A11c A12a A12b A12c A13a A13b A14a A14b C1c C1d C4c C5c C5d C6b C8b C9c C10a D1d D2d D2e D3d D4d D4e
A10c: 아직 답을 넣지 않았다. 예: check('A10c', '3/8')
10.1 내 답을 모아 확인하기
푼 문항의 답을 아래 사전에 채우고 실행한다. None인 문항은 건너뛴다.
python
mine = {
    "A1a": None, "A1b": None, "A2a": None, "A2b": None, "A2c": None,
    "A3a": None, "A3b": None, "A3c": None, "A4a": None, "A4b": None, "A4c": None,
    "A5a": None, "A5b": None, "A5c": None, "A5d": None, "A6a": None, "A6b": None, "A6c": None,
    "A7a": None, "A7b": None, "A7c": None, "A8a": None, "A8b": None, "A8c": None,
    "A9a": None, "A9b": None, "A9c": None, "A10a": None, "A10b": None, "A10c": None,
    "A11a": None, "A11b": None, "A11c": None, "A12a": None, "A12b": None, "A12c": None,
    "A13a": None, "A13b": None, "A14a": None, "A14b": None,
    "C1c": None, "C1d": None, "C4c": None, "C5c": None, "C5d": None, "C6b": None,
    "C8b": None, "C9c": None, "C10a": None,
    "D1d": None, "D2d": None, "D2e": None, "D3d": None, "D4d": None, "D4e": None,
}
check_all(mine)
text
0/0 맞음10.2 시뮬레이션 함수
각 함수는 (추정값, 표준오차)를 돌려준다. 손으로 구한 값이 추정값 ± 3 × 표준오차 안에 들면 계산이 맞을 가능성이 높다. 정확한 검산은 check()가 한다.
| 함수 | 문항 | 시뮬레이션 |
|---|---|---|
sim_A1() |
A1(a) 세 번째 6까지 | 주사위를 6이 세 번 나올 때까지 |
sim_A12() |
A12(c) 혼합의 사후확률 | 집단을 고르고 Poisson |
sim_A13() |
A13(a) 다섯 점의 중앙값 | 균등 난수 5개 |
sim_C1(m, n) |
C1 빈 상자의 수 (평균) | 공을 상자에 넣기 |
sim_C5(lams) |
C5(c) 최솟값의 첨자 | 경쟁하는 지수분포 |
sim_D1(lam, mu, n, m) |
D1 두 과정의 경주 | 감마 시각 두 개 |
sim_D2(r, beta, k) |
D2 | 위험률 → 두 해의 사고 |
python
def _mc(hits):
    """불리언(또는 실수) 배열의 평균과 표준오차"""
    hits = np.asarray(hits, dtype=float)
    return hits.mean(), hits.std(ddof=1) / np.sqrt(len(hits))


def sim_A1(n=N_SIM):
    fails = rng.negative_binomial(3, 1 / 6, n)          # numpy: 3번째 성공 전의 실패 수
    return _mc(fails == 5)


def sim_A12(n=N_SIM):
    low = rng.random(n) < 0.3
    x = rng.poisson(np.where(low, 1.0, 4.0))
    return _mc(low[x == 0])


def sim_A13(n=N_SIM):
    med = np.median(rng.random((n, 5)), axis=1)
    return _mc(med <= 0.25)


def sim_C1(m, n_balls, n=N_SIM // 4):
    boxes = rng.integers(0, m, size=(n, n_balls))
    occupied = np.zeros((n, m), dtype=bool)
    occupied[np.arange(n)[:, None], boxes] = True
    return _mc((~occupied).sum(axis=1))


def sim_C5(lams, n=N_SIM):
    lams = np.asarray(lams, dtype=float)
    X = rng.exponential(1 / lams, size=(n, len(lams)))
    return _mc(np.argmin(X, axis=1) == 1)               # 둘째 첨자(파이썬 1)가 최솟값


def sim_D1(lam, mu, n_a, m_b, n=N_SIM):
    tA = rng.gamma(n_a, 1 / lam, n)                     # A의 n번째 사건 시각
    tB = rng.gamma(m_b, 1 / mu, n)
    return _mc(tA < tB)


def sim_D2(r, beta, k, n=N_SIM * 2):
    L = rng.gamma(r, beta, n)
    x1, x2 = rng.poisson(L), rng.poisson(L)
    return _mc(x2[x1 == k])
python
# 자체 검사 (출력 없음): 시뮬레이션이 답 열쇠와 맞는지, check()가 답 열쇠의 값과 그 소수를 맞다고 하는지 확인한다.
def _close(sim, key, z=4.0, **pt):
    est, se = sim
    return abs(est - _value(key, **pt)) <= z * se + 1e-12

assert _close(sim_A1(), "A1a")
assert _close(sim_A12(), "A12c")
assert _close(sim_A13(), "A13a")
assert _close(sim_C1(10, 10), "C1c")
assert _close(sim_C5([1, 2, 3]), "C5c")
assert _close(sim_D1(2, 1, 2, 2), "D1d")
assert _close(sim_D2(2, 0.5, 0), "D2d") and _close(sim_D2(2, 0.5, 3), "D2e")
for _k, _e in _WB.items():
    assert _same(_e, _e["value"])
    if not _e.get("vars") and "points" not in _e:
        assert _same(_e, float(sp.sympify(_e["value"], locals={"pi": sp.pi})))