
테마
6회 · Student의 t · 노트
0 들어가며
여는 질문. 맥주 원료인 보리의 품질을 네 번 쟀다. 모집단의 표준편차는 모른다. 네 값만으로 평균의 오차를 말할 수 있는가? 말할 수 있다면, 표준편차 자리에 표본의 표준편차를 넣고 정규분포를 써도 되는가?
19세기의 천문학자와 측지학자들은 관측이 수십, 수백 개였다. 그들은 평균의 오차를 정규분포로 말하면서 모르는 자리에 관측에서 계산한 값을 넣었고, 관측이 많으니 그래도 별 문제가 없었다. 20세기 초 더블린의 맥주 회사 Guinness에 들어간 화학자 William Sealy Gosset의 사정은 달랐다. 보리 품종 시험, 맥아 실험, 효모 세포 수(4회)는 한 번에 몇 개의 측정밖에 얻을 수 없었다. 네 값의 표준편차는 에서 크게 빗나갈 수 있고, 그것을 처럼 쓰면 평균의 오차를 체계적으로 작게 말하게 된다.
Gosset은 1906–07년 런던의 Karl Pearson 연구실에서 이 문제를 풀었다. 회사가 직원의 실명 발표를 막았으므로 1908년 Biometrika에 “Student”라는 이름으로 The probable error of a mean을 냈다. 그는 표본평균과 표본분산이 독립이라고 (증명 없이) 놓고 분포를 유도했고, 그 결과를 확인하려고 범죄자 3,000명의 키를 카드에 적어 섞고 넷씩 750묶음을 뽑는 실험을 손으로 했다(6절). 엄밀한 증명은 1915년과 1925년 R. A. Fisher가 했고, 오늘 쓰는 라는 형태와 이름도 Fisher의 것이다.
이 노트는 그 증명을 따라간다. 표본분산과 자유도(1절), 정규 표본에서 평균과 분산이 독립이라는 Student의 정리(2절), 분포와 분포(3–4절), 축량으로 만드는 신뢰구간과 대응 비교(5절), 그리고 Student의 카드 실험의 재현(6절)이다. 7절은 정규성이 깨질 때 -구간이 얼마나 틀리는지 보고, 8절은 작은 배치의 정규화(BatchNorm)와 t-SNE에서 같은 분포를 만난다.
학습 목표
- 1.
표본분산이 의 불편추정량임을 보이고, 나누는 수가 인 이유를 자유도로 설명한다.
- 2.
Helmert 변환으로 정규 표본의 와 을 증명한다.
- 3.
와 의 밀도를 변수변환으로 유도하고, 꼬리·적률·정규 극한을 보인다.
- 4.
축량으로 -구간을 만들고 포함확률이 정확히 임을 증명한다. 대응 와 두 표본 를 쓴다.
- 5.
Student(1908)의 카드 실험을 원자료로 재현하고, 비정규 모집단에서 -구간의 실제 포함확률을 잰다.
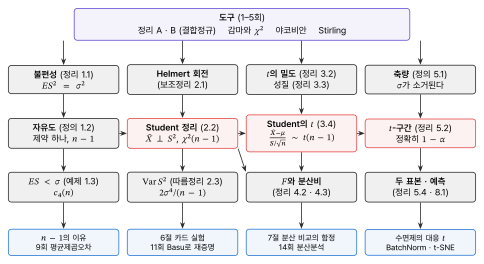
0.1 1–5회에서 가져오는 것
| 앞 회차 | 내용 |
|---|---|
| 2회 정리 2.2 · 3회 정리 4.2 | 분산의 계산, 공분산의 쌍선형성 |
| 3회 정리 5.1 · 정리 3.2 | 야코비안 변수변환, 인수분해로 독립 판정 |
| 3회 정리 5.8 | 표준정규의 비는 Cauchy |
| 4회 정리 3.5 · 3.7 · 3.9 | 감마함수, 감마의 합, |
| 4회 정리 4.2 · 연습 4.4 | 감마의 비 는 베타이고 와 독립, 의 밀도 |
| 5회 정리 3.8 · 3.11 · 따름정리 3.12 | 정리 A: 다변량 정규의 선형변환은 정규. 정리 B: 결합정규에서는 무상관 독립, 공분산행렬이 대각이면 성분이 상호 독립 |
| 5회 보조정리 1.1 | Stirling 공식 |
0.2 표기
이 표본이면 표본평균과 표본분산을
로 쓰고 를 표본표준편차라 한다. 는 자유도 인 분포의 위쪽 분위수, 곧 인 수다. 는 표준정규의 같은 분위수다().