
테마
노트북 · 6회 · Student의 t
Student의 작은 표본의 정확한 분포
| 강의노트 | 06_student_t_notes.pdf — 같은 절 번호, 같은 정리 번호. 증명은 노트에, 확인은 여기에 |
| 워크북 | 06_student_t_workbook.pdf — 손으로 푸는 34문항. 다 푼 뒤 맨 끝 10절의 check()로 검산 |
| 원자료 | Macdonell(1902)의 범죄자 3,000명 (HistData MacdonellDF) · Cushny–Peebles(1905)의 수면제 (HistData CushnyPeebles, datasets sleep) |
| 선수 지식 | 1–5회 (4회 감마와 , 5회 정리 A·B, 3회 야코비안) |
여는 질문. 맥주 원료인 보리의 품질을 네 번 쟀다. 모집단의 표준편차는 모른다. 네 값만으로 평균의 오차를 말할 수 있는가? 말할 수 있다면, 표준편차 자리에 표본의 표준편차를 넣고 정규분포를 써도 되는가?
이번 회차의 지도
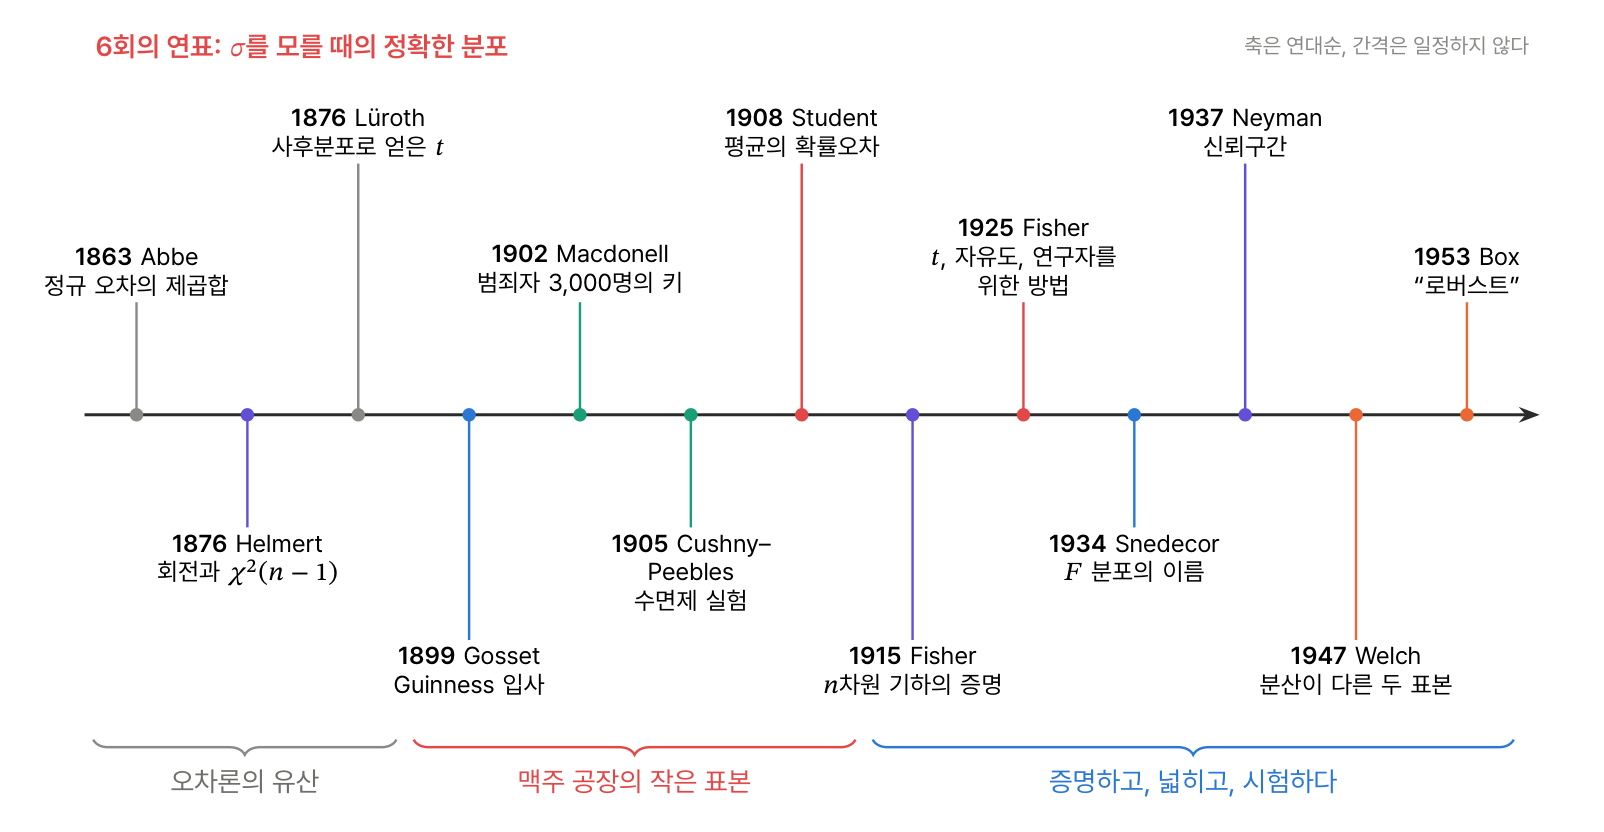
학습 목표
- 표본분산의 불편성과 자유도 을 시뮬레이션으로 확인한다.
- Helmert 행렬을 만들어 정규 표본의 와 을 확인하고, 지수 표본에서는 깨지는 것을 본다.
- 와 의 밀도를 식 그대로 구현해 scipy와 대조하고, 정의()로 만든 난수와 맞춘다.
- 일표본·대응·합동·Welch 를 직접 구현해
scipy.stats와 대조하고, Cushny–Peebles의 원자료에 쓴다. - Student(1908)의 카드 실험을 원자료로 재현하고, 비정규·의존·작은 배치에서 가 어떻게 되는지 잰다.
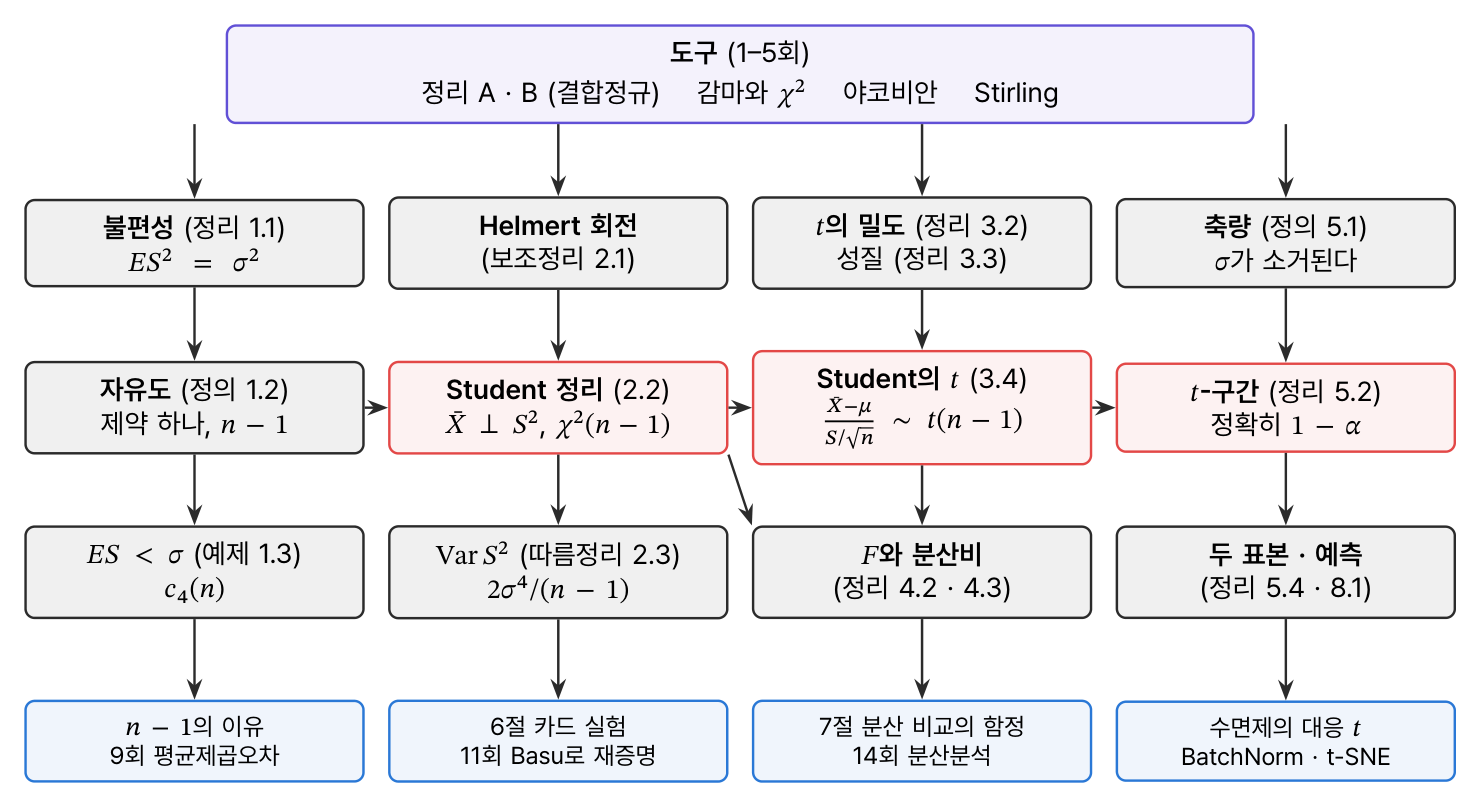
정리 지도
0. 설정
report(checks)는 이론값과 계산값의 대조 결과를 ✓/✗로 찍고, 하나라도 틀리면 멈춘다. 시뮬레이션의 허용오차는 표준오차의 몇 배로 잡았다.
python
%matplotlib inline
import math
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import integrate, special, stats

SEED = 2026
N_SIM = 200_000
rng = np.random.default_rng(SEED)

C = dict(data="#1a9e78", stat="#2a78d6", key="#e34948", assume="#eb6834",
         theta="#6250d6", ink="#2b2b2b", hist="#8a8a86", grid="#e6e6e3")
SERIES = [C["stat"], C["data"], C["key"], C["theta"]]
THEORY = dict(color=C["ink"], ls="--", lw=1.6)
plt.rcParams.update({
    "figure.dpi": 110, "figure.figsize": (8, 4.2), "mathtext.fontset": "stix",
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.grid": True, "grid.color": C["grid"], "grid.linewidth": 0.8,
    "axes.edgecolor": "#9a9a96", "axes.labelcolor": C["ink"],
    "xtick.color": "#52514e", "ytick.color": "#52514e",
    "axes.titleweight": "bold", "axes.titlesize": 11, "axes.titlelocation": "left",
    "legend.frameon": False, "lines.linewidth": 2,
})

RDATASETS = "https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/master/csv/{}/{}.csv"
DATA_DIR = Path("../../data") if Path("../../.git").exists() else Path("data")

def load_rdata(item, package="HistData"):
    path = DATA_DIR / (f"{item}.csv" if package == "HistData" else f"{package}_{item}.csv")
    if not path.exists():
        DATA_DIR.mkdir(parents=True, exist_ok=True)
        pd.read_csv(RDATASETS.format(package, item)).drop(columns="rownames").to_csv(path, index=False)
    return pd.read_csv(path)

def report(checks):
    for name, ok in checks.items():
        print(f"  {'✓' if ok else '✗'}  {name}")
    assert all(checks.values()), "대조 실패"

def sample_stats(X):
    """행마다 하나의 표본: (표본평균, 표본분산 S², 크기 n)"""
    return X.mean(axis=1), X.var(axis=1, ddof=1), X.shape[1]
1. 문제 — 를 모를 때
정리 1.1 독립이고 분산이 이면 (분포에 상관없이) · 정의 1.2 자유도 · 예제 1.3 .
먼저 노트 1.1절의 표: 의 실제 포함확률은 이다.
python
rows = []
for n in [2, 4, 10, 30]:
    X = rng.normal(5.0, 2.0, (N_SIM, n))
    xbar, s2, _ = sample_stats(X)
    covered = np.abs(xbar - 5.0) <= 1.96 * np.sqrt(s2 / n)
    rows.append(dict(n=n, simulated=covered.mean(), exact=1 - 2 * stats.t.sf(1.96, n - 1)))
cov = pd.DataFrame(rows)
print(cov.round(4).to_string(index=False))
se = math.sqrt(0.25 / N_SIM)
report({"1.1절: 시뮬레이션 == P(|T_{n-1}| ≤ 1.96) (4 se 안)": np.all(np.abs(cov.simulated - cov.exact) < 4 * se),
        "1.1절: n=2, 4, 10, 30 에서 0.700, 0.855, 0.918, 0.940": np.allclose(cov.exact, [0.700, 0.855, 0.918, 0.940], atol=6e-4)})
text
 n  simulated  exact
 2     0.6990 0.6997
 4     0.8562 0.8551
10     0.9187 0.9184
30     0.9399 0.9403
  ✓  1.1절: 시뮬레이션 == P(|T_{n-1}| ≤ 1.96) (4 se 안)
  ✓  1.1절: n=2, 4, 10, 30 에서 0.700, 0.855, 0.918, 0.940
python
# 정리 1.1: 분포에 상관없이 E S² = σ² — 지수(σ²=1), 균등(σ²=1/12), t(5)(σ²=5/3) 에서
n = 5
pops = {"exponential": (lambda sz: rng.exponential(1, sz), 1.0),
        "uniform": (lambda sz: rng.random(sz), 1 / 12),
        "t(5)": (lambda sz: rng.standard_t(5, sz), 5 / 3)}
checks = {}
for name, (gen, var) in pops.items():
    X = gen((N_SIM, n))
    s2 = X.var(axis=1, ddof=1); s2n = X.var(axis=1, ddof=0)
    se = s2.std() / math.sqrt(N_SIM)
    print(f"{name:12s}  σ² = {var:.4f}   E S² ≈ {s2.mean():.4f}   E(÷n) ≈ {s2n.mean():.4f}  (이론 {(n - 1) / n * var:.4f})")
    checks[f"정리 1.1 ({name}): E S² == σ² (4 se 안)"] = abs(s2.mean() - var) < 4 * se

# 예제 1.3 · 연습 2.4: E S = c4(n) σ  (정규 표본)
def c4(n):
    return math.sqrt(2 / (n - 1)) * math.exp(special.gammaln(n / 2) - special.gammaln((n - 1) / 2))

for n in [4, 10]:
    S = rng.standard_normal((N_SIM, n)).std(axis=1, ddof=1)
    print(f"n = {n}:  E S ≈ {S.mean():.4f},  c4 = {c4(n):.4f}")
    checks[f"예제 1.3: n={n} 에서 E S ≈ c4(n) (4 se 안)"] = abs(S.mean() - c4(n)) < 4 * S.std() / math.sqrt(N_SIM)
checks["예제 1.3: c4(4) = 0.921, c4(10) = 0.973"] = abs(c4(4) - 0.9213) < 1e-4 and abs(c4(10) - 0.9727) < 1e-4
report(checks)
text
exponential   σ² = 1.0000   E S² ≈ 1.0004   E(÷n) ≈ 0.8003  (이론 0.8000)
uniform       σ² = 0.0833   E S² ≈ 0.0833   E(÷n) ≈ 0.0666  (이론 0.0667)
t(5)          σ² = 1.6667   E S² ≈ 1.6625   E(÷n) ≈ 1.3300  (이론 1.3333)
n = 4:  E S ≈ 0.9215,  c4 = 0.9213
n = 10:  E S ≈ 0.9724,  c4 = 0.9727
  ✓  정리 1.1 (exponential): E S² == σ² (4 se 안)
  ✓  정리 1.1 (uniform): E S² == σ² (4 se 안)
  ✓  정리 1.1 (t(5)): E S² == σ² (4 se 안)
  ✓  예제 1.3: n=4 에서 E S ≈ c4(n) (4 se 안)
  ✓  예제 1.3: n=10 에서 E S ≈ c4(n) (4 se 안)
  ✓  예제 1.3: c4(4) = 0.921, c4(10) = 0.973
python
# 연습 1.1: Σ(Xi - X̄)² = ΣXi² - nX̄² = (1/2n) Σ_{i,j} (Xi - Xj)²
x = rng.normal(size=7)
f1 = ((x - x.mean()) ** 2).sum(); f2 = (x**2).sum() - 7 * x.mean() ** 2
f3 = ((x[:, None] - x[None, :]) ** 2).sum() / (2 * 7)

# 연습 1.2: Var S² = (μ4 - (n-3)/(n-1) σ⁴)/n — 지수분포 (μ4 = 9, σ = 1)
n = 6
s2 = rng.exponential(1, (N_SIM, n)).var(axis=1, ddof=1)
theory = (9 - (n - 3) / (n - 1)) / n
# 연습 1.4: c Σ(Xi - X̄)² 의 평균제곱오차는 c = 1/(n+1) 에서 최소
n = 5
Q = rng.standard_normal((N_SIM, n)).var(axis=1, ddof=0) * n
mse = {c: np.mean((c * Q - 1) ** 2) for c in [1 / (n - 1), 1 / n, 1 / (n + 1), 1 / (n + 2)]}
print("연습 1.4: MSE(c) ≈", {f"1/{round(1 / c)}": round(float(v), 4) for c, v in mse.items()}, " 이론 2/(n+1) =", round(2 / (n + 1), 4))
report({"연습 1.1: 세 식이 같다": np.allclose([f1, f2], [f3, f3]),
        f"연습 1.2: 지수 표본 n=6 에서 Var S² ≈ {theory:.3f} (3% 안)": abs(s2.var() / theory - 1) < 0.03,
        "연습 1.4: c = 1/(n+1) 의 MSE 가 가장 작고 ≈ 2/(n+1)": min(mse, key=mse.get) == 1 / (n + 1) and abs(mse[1 / (n + 1)] - 2 / (n + 1)) < 0.01})
text
연습 1.4: MSE(c) ≈ {'1/4': 0.4969, '1/5': 0.3578, '1/6': 0.3316, '1/7': 0.3456}  이론 2/(n+1) = 0.3333
  ✓  연습 1.1: 세 식이 같다
  ✓  연습 1.2: 지수 표본 n=6 에서 Var S² ≈ 1.400 (3% 안)
  ✓  연습 1.4: c = 1/(n+1) 의 MSE 가 가장 작고 ≈ 2/(n+1)
📝 연습 1.1–1.4 (강의노트): 표본분산의 다른 꼴, 의 일반식, 두 관측의 분산, 으로 나눈 추정량.
2. Student의 정리 — 평균과 분산은 독립이다
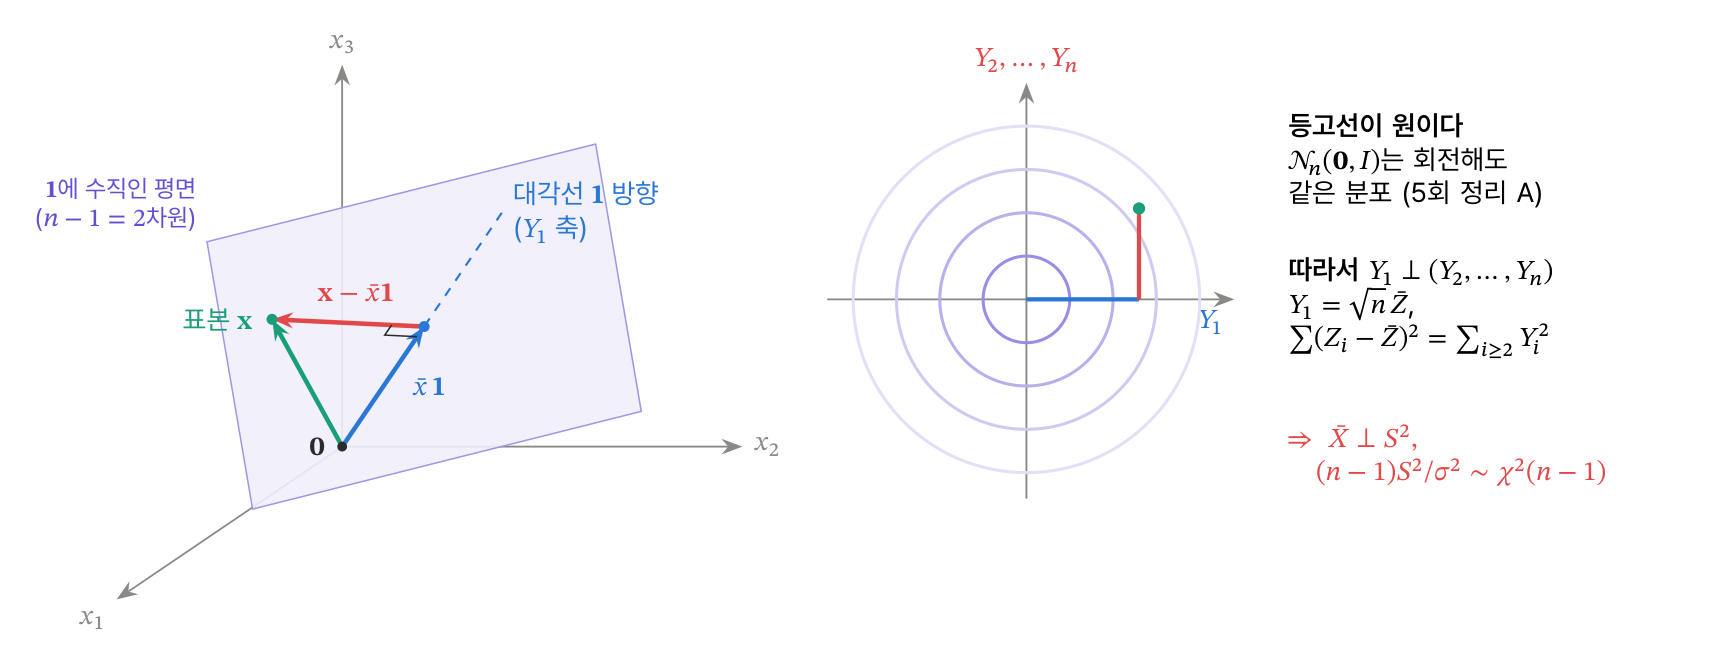
보조정리 2.1 Helmert 행렬은 직교 · 정리 2.2 정규 표본이면 (a) , (b) , (c) · 따름정리 2.3 .
python
def helmert(n):
    """보조정리 2.1 의 n×n Helmert 행렬: 첫 행 1/√n, k번째 행 (1,…,1, -(k-1), 0,…,0)/√(k(k-1))"""
    H = np.zeros((n, n))
    H[0] = 1 / math.sqrt(n)
    for k in range(2, n + 1):
        H[k - 1, : k - 1] = 1
        H[k - 1, k - 1] = -(k - 1)
        H[k - 1] /= math.sqrt(k * (k - 1))
    return H

H3 = helmert(3)
print("연습 2.1: n = 3 의 Helmert 행렬\n", H3.round(4))

n = 6
H = helmert(n)
Z = rng.standard_normal((N_SIM, n))
Y = Z @ H.T                                   # 행마다 Y = H Z
zbar, s2, _ = sample_stats(Z)
report({"보조정리 2.1: H H' = I (n = 3, 6, 20)": all(np.allclose(helmert(m) @ helmert(m).T, np.eye(m)) for m in (3, 6, 20)),
        "정리 2.2 증명 2단계: Y1 = √n Z̄": np.allclose(Y[:, 0], math.sqrt(n) * zbar),
        "정리 2.2 증명 3단계: Σ_{i≥2} Yi² = Σ(Zi - Z̄)²": np.allclose((Y[:, 1:] ** 2).sum(axis=1), (n - 1) * s2),
        "정리 2.2 증명 1단계: Y 의 표본 공분산 ≈ I (±0.01)": np.allclose(np.cov(Y.T), np.eye(n), atol=0.01)})
text
연습 2.1: n = 3 의 Helmert 행렬
 [[ 0.5774  0.5774  0.5774]
 [ 0.7071 -0.7071  0.    ]
 [ 0.4082  0.4082 -0.8165]]
  ✓  보조정리 2.1: H H' = I (n = 3, 6, 20)
  ✓  정리 2.2 증명 2단계: Y1 = √n Z̄
  ✓  정리 2.2 증명 3단계: Σ_{i≥2} Yi² = Σ(Zi - Z̄)²
  ✓  정리 2.2 증명 1단계: Y 의 표본 공분산 ≈ I (±0.01)
python
# 정리 2.2 (b), (c) 와 따름정리 2.3 — 정규 표본 n = 5, σ = 3
n, mu, sigma = 5, 10.0, 3.0
X = rng.normal(mu, sigma, (N_SIM, n))
xbar, s2, _ = sample_stats(X)
V = (n - 1) * s2 / sigma**2
ks = stats.kstest(V[:20_000], stats.chi2(n - 1).cdf)
# 독립이면 xbar 의 구간별로 S² 의 분포가 같아야 한다: 사분위로 나눠 S² 의 평균을 본다
bins = pd.qcut(xbar, 4, labels=["Q1", "Q2", "Q3", "Q4"])
by_q = pd.Series(s2).groupby(bins, observed=True).mean()
print("x̄ 의 사분위별 E S²:", by_q.round(3).to_dict(), "  (σ² = 9)")
report({"정리 2.2(a): X̄ 의 평균·분산 ≈ μ, σ²/n": abs(xbar.mean() - mu) < 0.01 and abs(xbar.var() / (sigma**2 / n) - 1) < 0.01,
        "정리 2.2(b): corr(X̄, S²) ≈ 0, corr(X̄², S²) ≈ 0 (±0.01)": abs(np.corrcoef(xbar, s2)[0, 1]) < 0.01 and abs(np.corrcoef((xbar - mu) ** 2, s2)[0, 1]) < 0.01,
        "정리 2.2(b): x̄ 의 사분위마다 E S² ≈ 9 (±0.1)": np.all(np.abs(by_q.to_numpy() - 9) < 0.1),
        "정리 2.2(c): (n-1)S²/σ² 와 χ²(4) 의 KS 유의확률 > 0.01": ks.pvalue > 0.01,
        "따름정리 2.3: Var S² ≈ 2σ⁴/(n-1) (3% 안)": abs(s2.var() / (2 * sigma**4 / (n - 1)) - 1) < 0.03})
text
x̄ 의 사분위별 E S²:text
 {'Q1': 9.011, 'Q2': 9.028, 'Q3': 9.017, 'Q4': 9.038}   (σ² = 9)
  ✓  정리 2.2(a): X̄ 의 평균·분산 ≈ μ, σ²/n
  ✓  정리 2.2(b): corr(X̄, S²) ≈ 0, corr(X̄², S²) ≈ 0 (±0.01)
  ✓  정리 2.2(b): x̄ 의 사분위마다 E S² ≈ 9 (±0.1)
  ✓  정리 2.2(c): (n-1)S²/σ² 와 χ²(4) 의 KS 유의확률 > 0.01
  ✓  따름정리 2.3: Var S² ≈ 2σ⁴/(n-1) (3% 안)
python
# factbox · 연습 2.3: 정규가 아니면 X̄ 와 S² 는 의존한다 — Exp(1), n = 2 에서 Cov(X̄, S²) = 1
E = rng.exponential(1, (N_SIM, 2))
xbar_e, s2_e, _ = sample_stats(E)
cov_e = np.cov(xbar_e, s2_e)[0, 1]
# 연습 2.2: Cov(X̄, Xi - X̄) = 0 은 분포와 상관없다
E5 = rng.exponential(1, (N_SIM, 5))
cov_res = np.cov(E5.mean(axis=1), E5[:, 0] - E5.mean(axis=1))[0, 1]

fig, axes = plt.subplots(1, 2, figsize=(12, 3.8))
for ax, (lab, xb, s2_, col) in zip(axes, [("normal, n = 5", xbar[:3000], s2[:3000], C["stat"]),
                                         ("exponential, n = 5", E5.mean(axis=1)[:3000], E5.var(axis=1, ddof=1)[:3000], C["key"])]):
    ax.plot(xb, np.sqrt(s2_), ".", ms=3, alpha=0.4, color=col)
    ax.set_xlabel(r"$\bar x$"); ax.set_ylabel("$s$"); ax.set_title(f"{lab}: corr = {np.corrcoef(xb, s2_)[0, 1]:.2f}")
plt.tight_layout(); plt.show()
report({"연습 2.3: 지수 n=2 에서 Cov(X̄, S²) ≈ 1 (±0.03)": abs(cov_e - 1) < 0.03,
        "연습 2.2: 지수 표본에서도 Cov(X̄, X1 - X̄) ≈ 0 (±0.003)": abs(cov_res) < 0.003})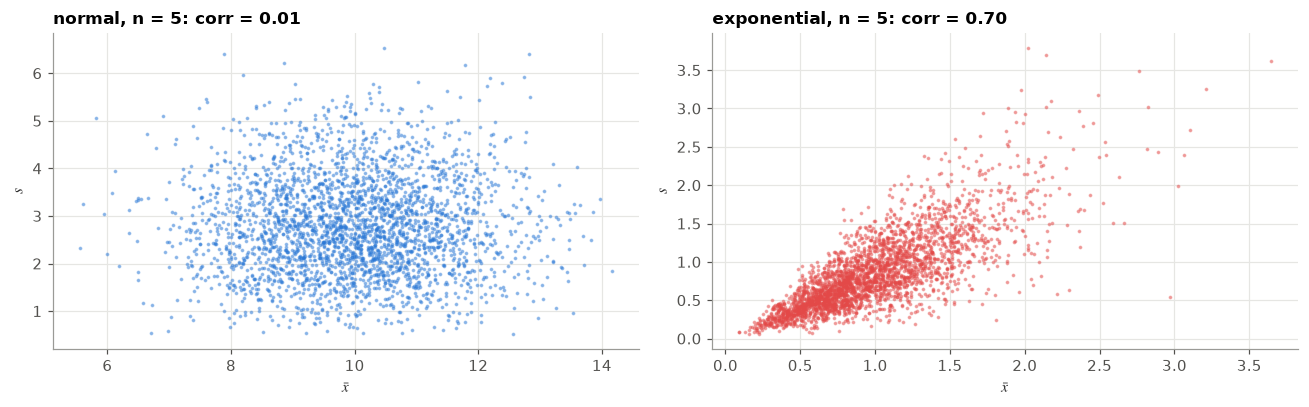
text
  ✓  연습 2.3: 지수 n=2 에서 Cov(X̄, S²) ≈ 1 (±0.03)
  ✓  연습 2.2: 지수 표본에서도 Cov(X̄, X1 - X̄) ≈ 0 (±0.003)
그림 읽기. 왼쪽(정규)의 점구름에는 기울기가 없다. 가 어디에 있든 의 흩어짐이 같다. 오른쪽(지수)은 가 크면 도 크다. 무상관(연습 2.2)은 분포와 상관없이 성립하지만, 그것이 독립으로 올라가는 것은 결합정규일 때뿐이다(5회 정리 B).
python
# 연습 2.5: σ² 의 95% 구간 — 포함확률이 정확히 0.95 인지, 그리고 n = 4, s² = 1 의 구간
n = 4
lo_q, hi_q = stats.chi2.ppf([0.025, 0.975], n - 1)           # 아래쪽 분위수 (위쪽 0.975, 0.025 분위수)
s2 = rng.normal(0, 2.0, (N_SIM, n)).var(axis=1, ddof=1)
covered = ((n - 1) * s2 / hi_q <= 4.0) & (4.0 <= (n - 1) * s2 / lo_q)
ci = ((n - 1) * 1 / hi_q, (n - 1) * 1 / lo_q)
print(f"연습 2.5: n = 4, s² = 1 → σ² ∈ [{ci[0]:.3f}, {ci[1]:.2f}]")
report({"연습 2.5: 포함확률 ≈ 0.95 (4 se 안)": abs(covered.mean() - 0.95) < 4 * math.sqrt(0.0475 / N_SIM),
        "연습 2.5: 구간 [0.321, 13.90]": abs(ci[0] - 0.321) < 1e-3 and abs(ci[1] - 13.90) < 0.01})
text
연습 2.5: n = 4, s² = 1 → σ² ∈ [0.321, 13.90]
  ✓  연습 2.5: 포함확률 ≈ 0.95 (4 se 안)
  ✓  연습 2.5: 구간 [0.321, 13.90]
📝 연습 2.1–2.5 (강의노트): 의 Helmert, 잔차와 평균의 무상관, 지수 표본의 의존, , 의 구간.
3. 분포
정의 3.1 , · 정리 3.2 · 정리 3.3 대칭, , , 이면 Cauchy, 이면 · 정리 3.4 .
밀도는 식 그대로 구현한다. 감마함수의 비는 큰 에서 넘치므로 gammaln의 차로 계산한다.
python
def t_pdf(t, r):
    """정리 3.2 — 로그 감마로 상수를 계산한다"""
    logc = special.gammaln((r + 1) / 2) - special.gammaln(r / 2) - 0.5 * math.log(r * math.pi)
    return np.exp(logc - (r + 1) / 2 * np.log1p(np.asarray(t, float) ** 2 / r))

def t_sample(r, size):
    """정의 3.1 그대로: 표준정규 / sqrt(χ²(r)/r) — χ²(r) 은 표준정규 r 개의 제곱합 (4회 정리 3.9)"""
    Z = rng.standard_normal(size)
    V = (rng.standard_normal((size, r)) ** 2).sum(axis=1)
    return Z / np.sqrt(V / r)

tt = np.linspace(-6, 6, 241)
checks = {f"정리 3.2: t_pdf == scipy (r = {r})": np.allclose(t_pdf(tt, r), stats.t.pdf(tt, r), rtol=1e-12) for r in (1, 2, 3, 10, 30, 1000)}
checks["정리 3.2: ∫ f_r = 1 (r = 3)"] = abs(integrate.quad(t_pdf, -np.inf, np.inf, args=(3,))[0] - 1) < 1e-8
for r in (3, 10):
    T = t_sample(r, N_SIM)
    checks[f"정의 3.1: Z/√(V/r) 와 t({r}) 의 KS 유의확률 > 0.01"] = stats.kstest(T[:20_000], stats.t(r).cdf).pvalue > 0.01
report(checks)

fig, axes = plt.subplots(1, 2, figsize=(12, 3.8))
T3 = t_sample(3, N_SIM)
axes[0].hist(T3[np.abs(T3) < 6], bins=np.linspace(-6, 6, 97), density=True, color=C["data"], alpha=0.5, label="Z/√(V/3), simulated")
axes[0].plot(tt, t_pdf(tt, 3), color=C["key"], label="t_pdf(t, 3)")
axes[0].plot(tt, stats.norm.pdf(tt), **THEORY, label="N(0,1)")
axes[0].legend(); axes[0].set_title("t(3): definition vs density formula")
cc = np.linspace(0, 6, 121)
for r, col in zip([1, 3, 10, 30], SERIES):
    axes[1].plot(cc, 2 * stats.t.sf(cc, r), color=col, label=f"r = {r}")
axes[1].plot(cc, 2 * stats.norm.sf(cc), **THEORY, label="normal")
axes[1].set_yscale("log"); axes[1].set_ylim(1e-8, 1.5); axes[1].legend(ncol=2); axes[1].set_title("tails P(|T| > c)")
plt.tight_layout(); plt.show()
text
✓ 정리 3.2: t_pdf == scipy (r = 1)text
  ✓  정리 3.2: t_pdf == scipy (r = 2)
  ✓  정리 3.2: t_pdf == scipy (r = 3)
  ✓  정리 3.2: t_pdf == scipy (r = 10)
  ✓  정리 3.2: t_pdf == scipy (r = 30)
  ✓  정리 3.2: t_pdf == scipy (r = 1000)
  ✓  정리 3.2: ∫ f_r = 1 (r = 3)
  ✓  정의 3.1: Z/√(V/r) 와 t(3) 의 KS 유의확률 > 0.01
  ✓  정의 3.1: Z/√(V/r) 와 t(10) 의 KS 유의확률 > 0.01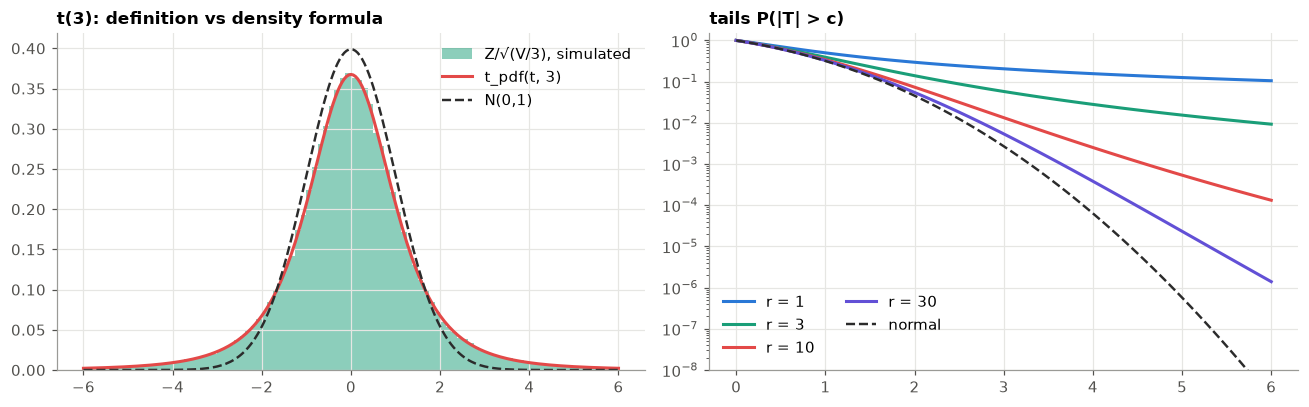
그림 읽기. 왼쪽: 정의로 만든 난수의 히스토그램이 식 그대로의 밀도(빨강)와 겹치고, 정규(점선)보다 가운데가 낮고 꼬리가 두껍다. 오른쪽: 로그 눈금에서 정규의 꼬리는 포물선으로 꺾여 떨어지지만 의 꼬리는 직선에 가깝다. 거듭제곱 로 줄기 때문이다.
python
# 정리 3.3 (b): Var T = r/(r-2), (c) r=1 은 Cauchy, (d) r→∞ 에서 정규
var_num = {r: integrate.quad(lambda t, r=r: t * t * t_pdf(t, r), -np.inf, np.inf)[0] for r in (3, 5, 10)}
# 3.2절 끝: 꼬리의 비 (본문: 자유도 30 에서 약 6배, 10 에서 약 40배) · 연습 3.4
tail = pd.DataFrame({f"P(|T|>{c})": {**{f"t({r})": 2 * stats.t.sf(c, r) for r in (3, 10, 30)}, "N(0,1)": 2 * stats.norm.sf(c)} for c in (3, 4)})
ratio = tail.div(tail.loc["N(0,1)"], axis=1)
print("연습 3.4: 꼬리 확률과 정규에 대한 비\n", pd.concat([tail.map(lambda v: f"{v:.2e}"), ratio.round(1).add_suffix(" ÷ normal")], axis=1).to_string())
# 연습 3.1: Γ(x+1/2)/(Γ(x)√x) → 1
gr = {x: math.exp(special.gammaln(x + 0.5) - special.gammaln(x)) / math.sqrt(x) for x in (1, 10, 100, 10_000)}
print("연습 3.1: Γ(x+½)/(Γ(x)√x) =", {k: round(v, 5) for k, v in gr.items()})
# 연습 3.3: t(2) 의 분포함수
F2 = lambda t: 0.5 * (1 + t / np.sqrt(2 + t**2))
report({"정리 3.3(b): ∫t² f_r = r/(r-2) (r = 3, 5, 10)": all(abs(var_num[r] - r / (r - 2)) < 1e-6 for r in var_num),
        "정리 3.3(c): t(1) == Cauchy": np.allclose(t_pdf(tt, 1), 1 / (math.pi * (1 + tt**2))),
        "정리 3.3(d): max|f_r - φ| 가 r 과 함께 0 으로": np.all(np.diff([np.abs(t_pdf(tt, r) - stats.norm.pdf(tt)).max() for r in (5, 50, 500, 5000)]) < 0)
            and np.abs(t_pdf(tt, 5000) - stats.norm.pdf(tt)).max() < 1e-4,
        "3.2절: P(|T|>4) 의 비 — r=30 에서 약 6배, r=10 에서 약 40배": abs(ratio.loc["t(30)", "P(|T|>4)"] - 6.0) < 0.3 and abs(ratio.loc["t(10)", "P(|T|>4)"] - 39.8) < 1,
        "연습 3.1: 비가 1 로 간다": abs(gr[10_000] - 1) < 1e-4,
        "연습 3.3: F_2 == scipy, F_2(4.303) = 0.975": np.allclose(F2(tt), stats.t.cdf(tt, 2)) and abs(F2(4.303) - 0.975) < 1e-4})
text
연습 3.4: 꼬리 확률과 정규에 대한 비
         P(|T|>3)  P(|T|>4)  P(|T|>3) ÷ normal  P(|T|>4) ÷ normal
t(3)    5.77e-02  2.80e-02               21.4              442.2
t(10)   1.33e-02  2.52e-03                4.9               39.8
t(30)   5.39e-03  3.82e-04                2.0                6.0
N(0,1)  2.70e-03  6.33e-05                1.0                1.0
연습 3.1: Γ(x+½)/(Γ(x)√x) = {1: 0.88623, 10: 0.98758, 100: 0.99875, 10000: 0.99999}
  ✓  정리 3.3(b): ∫t² f_r = r/(r-2) (r = 3, 5, 10)
  ✓  정리 3.3(c): t(1) == Cauchy
  ✓  정리 3.3(d): max|f_r - φ| 가 r 과 함께 0 으로
  ✓  3.2절: P(|T|>4) 의 비 — r=30 에서 약 6배, r=10 에서 약 40배
  ✓  연습 3.1: 비가 1 로 간다
  ✓  연습 3.3: F_2 == scipy, F_2(4.303) = 0.975
python
# 연습 3.2: t(r) 는 정규의 분산 혼합 — W ~ Γ(r/2, 척도 2/r), T | W ~ N(0, 1/W)
r = 4
W = rng.gamma(r / 2, 2 / r, N_SIM)
T_mix = rng.standard_normal(N_SIM) / np.sqrt(W)
mix_pdf = lambda t: integrate.quad(lambda w: stats.norm.pdf(t, scale=1 / math.sqrt(w)) * stats.gamma.pdf(w, r / 2, scale=2 / r), 0, np.inf)[0]
report({"연습 3.2: 혼합 난수와 t(4) 의 KS 유의확률 > 0.01": stats.kstest(T_mix[:20_000], stats.t(r).cdf).pvalue > 0.01,
        "연습 3.2: 혼합 밀도의 적분 == t(4) 밀도 (t = 0, 1.5, 4)": all(abs(mix_pdf(t) - t_pdf(t, r)) < 1e-8 for t in (0.0, 1.5, 4.0))})

# 정리 3.4: 정규 표본의 (X̄ - μ)/(S/√n) 는 t(n-1) — σ 가 소거된다
checks = {}
for sigma in (0.1, 1.0, 50.0):
    X = rng.normal(3.0, sigma, (N_SIM, 4))
    xbar, s2, n = sample_stats(X)
    T = (xbar - 3.0) / np.sqrt(s2 / n)
    checks[f"정리 3.4: σ = {sigma} 에서 T 와 t(3) 의 KS 유의확률 > 0.01"] = stats.kstest(T[:20_000], stats.t(3).cdf).pvalue > 0.01
report(checks)
text
  ✓  연습 3.2: 혼합 난수와 t(4) 의 KS 유의확률 > 0.01
  ✓  연습 3.2: 혼합 밀도의 적분 == t(4) 밀도 (t = 0, 1.5, 4)
  ✓  정리 3.4: σ = 0.1 에서 T 와 t(3) 의 KS 유의확률 > 0.01
  ✓  정리 3.4: σ = 1.0 에서 T 와 t(3) 의 KS 유의확률 > 0.01
  ✓  정리 3.4: σ = 50.0 에서 T 와 t(3) 의 KS 유의확률 > 0.01
📝 연습 3.1–3.4 (강의노트): 감마의 비, 정규의 분산 혼합, 의 분포함수, 꼬리의 비.
4. 분포 — 두 분산의 비
정의 4.1 · 정리 4.2 밀도, , , , · 정리 4.3 · 예제 4.4 두 기계.
python
def f_pdf(x, r1, r2):
    """정리 4.2(a) — 로그 베타함수로"""
    x = np.asarray(x, float)
    logc = -special.betaln(r1 / 2, r2 / 2) + r1 / 2 * math.log(r1 / r2)
    return np.exp(logc + (r1 / 2 - 1) * np.log(x) - (r1 + r2) / 2 * np.log1p(r1 / r2 * x))

def f_var(r1, r2):
    """연습 4.1"""
    return 2 * r2**2 * (r1 + r2 - 2) / (r1 * (r2 - 2) ** 2 * (r2 - 4))

xx = np.linspace(0.01, 6, 300)
r1, r2 = 4, 10
U = rng.chisquare(r1, N_SIM); V = rng.chisquare(r2, N_SIM)
F = (U / r1) / (V / r2)
T = t_sample(7, N_SIM)
B = (r1 / r2 * F) / (1 + r1 / r2 * F)
checks = {f"정리 4.2(a): f_pdf == scipy (r1, r2) = {p}": np.allclose(f_pdf(xx, *p), stats.f.pdf(xx, *p), rtol=1e-10) for p in [(1, 10), (4, 10), (10, 10), (30, 30)]}
checks |= {
    "정의 4.1: (U/4)/(V/10) 와 F(4,10) 의 KS 유의확률 > 0.01": stats.kstest(F[:20_000], stats.f(r1, r2).cdf).pvalue > 0.01,
    "정리 4.2(b): E F ≈ r2/(r2-2) = 1.25 (±0.01)": abs(F.mean() - 1.25) < 0.01,
    "연습 4.1: Var F 식 == scipy": all(abs(f_var(a, b) - stats.f(a, b).var()) < 1e-10 for a, b in [(4, 10), (3, 7), (20, 30)]),
    "정리 4.2(c): 1/F 와 F(10,4) 의 KS 유의확률 > 0.01": stats.kstest(1 / F[:20_000], stats.f(r2, r1).cdf).pvalue > 0.01,
    "정리 4.2(c): T² (T ~ t(7)) 와 F(1,7) 의 KS 유의확률 > 0.01": stats.kstest(T[:20_000] ** 2, stats.f(1, 7).cdf).pvalue > 0.01,
    "정리 4.2(d): 변환한 값과 Beta(2,5) 의 KS 유의확률 > 0.01": stats.kstest(B[:20_000], stats.beta(r1 / 2, r2 / 2).cdf).pvalue > 0.01,
    "연습 4.2: F_{4,10,0.95} == 1/F_{10,4,0.05}": abs(stats.f.ppf(0.05, 4, 10) - 1 / stats.f.ppf(0.95, 10, 4)) < 1e-12,
}
report(checks)
text
  ✓  정리 4.2(a): f_pdf == scipy (r1, r2) = (1, 10)
  ✓  정리 4.2(a): f_pdf == scipy (r1, r2) = (4, 10)
  ✓  정리 4.2(a): f_pdf == scipy (r1, r2) = (10, 10)
  ✓  정리 4.2(a): f_pdf == scipy (r1, r2) = (30, 30)
  ✓  정의 4.1: (U/4)/(V/10) 와 F(4,10) 의 KS 유의확률 > 0.01
  ✓  정리 4.2(b): E F ≈ r2/(r2-2) = 1.25 (±0.01)
  ✓  연습 4.1: Var F 식 == scipy
  ✓  정리 4.2(c): 1/F 와 F(10,4) 의 KS 유의확률 > 0.01
  ✓  정리 4.2(c): T² (T ~ t(7)) 와 F(1,7) 의 KS 유의확률 > 0.01
  ✓  정리 4.2(d): 변환한 값과 Beta(2,5) 의 KS 유의확률 > 0.01
  ✓  연습 4.2: F_{4,10,0.95} == 1/F_{10,4,0.05}
python
# 정리 4.3 · 예제 4.4 · 연습 4.3: 두 기계 (m = n = 11, s²X = 4.2, s²Y = 1.5)
m = n = 11
X = rng.normal(0, 2.0, (N_SIM, m)); Y = rng.normal(0, 0.5, (N_SIM, n))
R = (X.var(axis=1, ddof=1) / 4.0) / (Y.var(axis=1, ddof=1) / 0.25)
ratio = 4.2 / 1.5
p_up = stats.f.sf(ratio, m - 1, n - 1)
q = stats.f.ppf(0.975, m - 1, n - 1)
ci = (ratio / q, ratio * q)            # 연습 4.2 로 1/F_{10,10,0.975} = F_{10,10,0.025}
print(f"예제 4.4: s²X/s²Y = {ratio:.2f},  P(F(10,10) ≥ 2.8) = {p_up:.4f}")
print(f"연습 4.3: F_(10,10, 0.025) = {q:.3f},  σ1²/σ2² 의 95% 구간 = [{ci[0]:.3f}, {ci[1]:.2f}]")
report({"정리 4.3: 표준화한 분산비와 F(10,10) 의 KS 유의확률 > 0.01": stats.kstest(R[:20_000], stats.f(10, 10).cdf).pvalue > 0.01,
        "예제 4.4: P(F ≥ 2.8) ≈ 0.060": abs(p_up - 0.0599) < 5e-4,
        "연습 4.3: 구간 [0.753, 10.41] 에 1 이 들어 있다": abs(ci[0] - 0.753) < 1e-3 and abs(ci[1] - 10.41) < 0.01 and ci[0] < 1 < ci[1]})

fig, ax = plt.subplots(figsize=(8, 3.4))
for (a, b), col in zip([(1, 10), (4, 10), (10, 10), (30, 30)], SERIES):
    ax.plot(xx, f_pdf(xx, a, b), color=col, label=f"F({a},{b})")
ax.axvline(ratio, color=C["key"], ls=":", lw=1.4, label="machines: 2.8")
ax.set_xlim(0, 4); ax.set_ylim(0, 1.6); ax.legend(); ax.set_title("F densities: equal variances put the ratio near 1")
plt.tight_layout(); plt.show()
text
예제 4.4: s²X/s²Y = 2.80, P(F(10,10) ≥ 2.8) = 0.0599text
연습 4.3: F_(10,10, 0.025) = 3.717,  σ1²/σ2² 의 95% 구간 = [0.753, 10.41]
  ✓  정리 4.3: 표준화한 분산비와 F(10,10) 의 KS 유의확률 > 0.01
  ✓  예제 4.4: P(F ≥ 2.8) ≈ 0.060
  ✓  연습 4.3: 구간 [0.753, 10.41] 에 1 이 들어 있다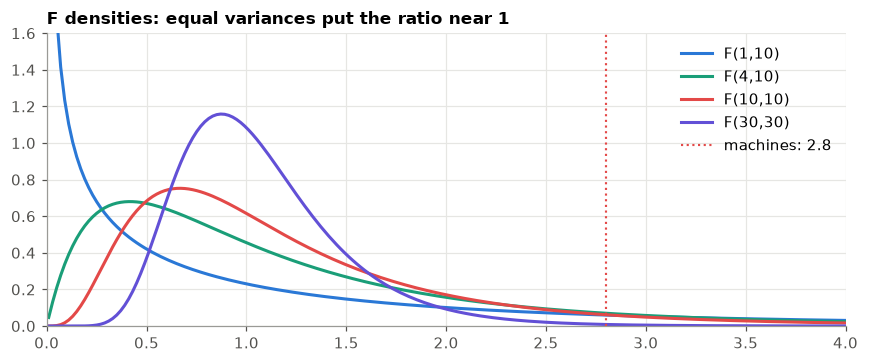
📝 연습 4.1–4.3 (강의노트): 의 분산, 분위수의 대칭, 의 구간.
5. 축량과 -구간
정의 5.1 축량 · 정리 5.2 의 포함확률은 모든 에서 정확히 · 예제 5.3 수면제의 대응 · 정리 5.4 합동분산의 두 표본 , 자유도 .
네 가지 를 직접 구현하고 scipy.stats와 대조한다. 모두 "(추정값 − 모수) ÷ 표준오차"이고, 다른 것은 표준오차와 자유도뿐이다.
python
def t_test(est, se, df, null=0.0, conf=0.95):
    """공통 골격: t = (est - null)/se, 양쪽 유의확률, conf 구간"""
    t = (est - null) / se
    q = stats.t.ppf(0.5 + conf / 2, df)
    return dict(est=est, se=se, df=df, t=t, p=2 * stats.t.sf(abs(t), df), lo=est - q * se, hi=est + q * se)

def one_sample_t(x, null=0.0, conf=0.95):
    x = np.asarray(x, float); n = len(x)
    return t_test(x.mean(), x.std(ddof=1) / math.sqrt(n), n - 1, null, conf)

def paired_t(x, y, conf=0.95):
    """대응: 차이 y - x 의 일표본 t (예제 5.3)"""
    return one_sample_t(np.asarray(y) - np.asarray(x), conf=conf)

def pooled_t(x, y, conf=0.95):
    """정리 5.4: 합동분산, 자유도 m + n - 2"""
    x, y = np.asarray(x, float), np.asarray(y, float); m, n = len(x), len(y)
    sp2 = ((m - 1) * x.var(ddof=1) + (n - 1) * y.var(ddof=1)) / (m + n - 2)
    return t_test(y.mean() - x.mean(), math.sqrt(sp2 * (1 / m + 1 / n)), m + n - 2, conf=conf)

def welch_t(x, y, conf=0.95):
    """Welch(1947): 분산을 따로 추정하고 자유도를 Satterthwaite 근사로"""
    x, y = np.asarray(x, float), np.asarray(y, float)
    a, b = x.var(ddof=1) / len(x), y.var(ddof=1) / len(y)
    df = (a + b) ** 2 / (a**2 / (len(x) - 1) + b**2 / (len(y) - 1))
    return t_test(y.mean() - x.mean(), math.sqrt(a + b), df, conf=conf)

# scipy 와 대조 (임의의 자료)
x = rng.normal(0, 1, 9); y = rng.normal(0.8, 2, 14); yp = x + rng.normal(0.5, 1, 9)
ref1 = stats.ttest_1samp(x, 0.3); ci1 = ref1.confidence_interval(0.95)
mine1 = one_sample_t(x, 0.3)
pairs = {"일표본": (mine1, ref1), "대응": (paired_t(x, yp), stats.ttest_rel(yp, x)),
         "합동": (pooled_t(x, y), stats.ttest_ind(y, x, equal_var=True)), "Welch": (welch_t(x, y), stats.ttest_ind(y, x, equal_var=False))}
checks = {f"{k} t: 통계량·유의확률 == scipy": np.allclose([mine["t"], mine["p"]], [ref.statistic, ref.pvalue]) for k, (mine, ref) in pairs.items()}
checks["일표본 t: 구간 == scipy (μ0 = 0.3 의 구간은 x̄ ± q·se)"] = np.allclose([mine1["lo"], mine1["hi"]], [ci1.low, ci1.high])
report(checks)
text
  ✓  일표본 t: 통계량·유의확률 == scipy
  ✓  대응 t: 통계량·유의확률 == scipy
  ✓  합동 t: 통계량·유의확률 == scipy
  ✓  Welch t: 통계량·유의확률 == scipy
  ✓  일표본 t: 구간 == scipy (μ0 = 0.3 의 구간은 x̄ ± q·se)
python
# 정리 5.2: 포함확률은 μ, σ 와 상관없이 정확히 0.95 — n = 3
n = 3
q = stats.t.ppf(0.975, n - 1)
checks = {}
for mu, sigma in [(0, 1), (100, 0.01), (-5, 30)]:
    X = rng.normal(mu, sigma, (N_SIM, n))
    xbar, s2, _ = sample_stats(X)
    cover = np.mean(np.abs(xbar - mu) <= q * np.sqrt(s2 / n))
    checks[f"정리 5.2: (μ, σ) = ({mu}, {sigma}) 에서 포함확률 ≈ 0.95 (4 se 안): {cover:.4f}"] = abs(cover - 0.95) < 4 * math.sqrt(0.0475 / N_SIM)
# 연습 5.1, 5.2: 평균 길이의 비, 반폭 σ/2 를 평균으로 맞추는 n
width = {n: stats.t.ppf(0.975, n - 1) * c4(n) / 1.96 for n in (4, 10, 30)}
n_needed = next(n for n in range(2, 200) if stats.t.ppf(0.975, n - 1) * c4(n) / math.sqrt(n) <= 0.5)
print("연습 5.1: 평균 길이의 비 t·c4/1.96 =", {k: round(float(v), 3) for k, v in width.items()})
print("연습 5.2: 필요한 n =", n_needed, " (σ 를 알면 16)")
checks["연습 5.1: 비 1.50, 1.12, 1.03"] = np.allclose(list(width.values()), [1.496, 1.123, 1.035], atol=1e-3)
checks["연습 5.2: n = 18"] = n_needed == 18
report(checks)
text
연습 5.1: 평균 길이의 비 t·c4/1.96 =text
 {4: 1.496, 10: 1.123, 30: 1.035}
연습 5.2: 필요한 n = 18  (σ 를 알면 16)
  ✓  정리 5.2: (μ, σ) = (0, 1) 에서 포함확률 ≈ 0.95 (4 se 안): 0.9498
  ✓  정리 5.2: (μ, σ) = (100, 0.01) 에서 포함확률 ≈ 0.95 (4 se 안): 0.9497
  ✓  정리 5.2: (μ, σ) = (-5, 30) 에서 포함확률 ≈ 0.95 (4 se 안): 0.9497
  ✓  연습 5.1: 비 1.50, 1.12, 1.03
  ✓  연습 5.2: n = 18
Cushny–Peebles의 원자료 (1905)
HistData의 CushnyPeebles는 환자 11명이 약마다 잔 평균 시간이다(11번 환자는 대조 밤이 없다). R의 sleep은 이것을 "대조 밤보다 늘어난 시간"으로 바꾼 처음 10명이다. 먼저 그것을 확인한다.
python
cp = load_rdata("CushnyPeebles")
sl = load_rdata("sleep", "datasets")
print(cp.to_string())
g1 = sl[sl.group == 1].extra.to_numpy(); g2 = sl[sl.group == 2].extra.to_numpy()
d_hyoscyamine = (cp.L_hyoscyamine - cp.Control).dropna().to_numpy()
d_hyoscine = (cp.L_hyoscine - cp.Control).dropna().to_numpy()
report({"sleep 의 group 1 == L-hyoscyamine - 대조 (환자 1–10)": np.allclose(g1, d_hyoscyamine),
        "sleep 의 group 2 == L-hyoscine - 대조 (환자 1–10)": np.allclose(g2, d_hyoscine)})

res = pd.DataFrame({
    "L-hyoscyamine vs 대조": one_sample_t(g1),
    "L-hyoscine vs 대조": one_sample_t(g2),
    "대응: hyoscine − hyoscyamine": paired_t(g1, g2),
    "대응 무시 (합동 t)": pooled_t(g1, g2),
}).T[["est", "se", "df", "t", "p", "lo", "hi"]]
print(res.astype(float).round(4).to_string())
r_xy = np.corrcoef(g1, g2)[0, 1]
pp = res.loc["대응: hyoscine − hyoscyamine"]
report({"예제 5.3: 대응 t = 4.06, p = 0.0028, 구간 [0.70, 2.46]": abs(pp.t - 4.062) < 1e-3 and abs(pp.p - 0.00283) < 1e-4
            and abs(pp.lo - 0.70) < 5e-3 and abs(pp.hi - 2.46) < 5e-3,
        "예제 5.3: 대응을 무시하면 t = 1.86, p = 0.079": abs(res.loc["대응 무시 (합동 t)", "t"] - 1.861) < 1e-3 and abs(res.loc["대응 무시 (합동 t)", "p"] - 0.0792) < 5e-4,
        "예제 5.3: 대조와 비교 t = 1.33 (p = 0.22), t = 3.68 (p = 0.005)": abs(res.iloc[0].t - 1.326) < 1e-3 and abs(res.iloc[1].t - 3.680) < 1e-3,
        "5.2절: 두 약의 상관 0.80": abs(r_xy - 0.795) < 1e-3})
text
    Control  L_hyoscyamine  L_hyoscine  DL_hyoscine
0       0.6            1.3         2.5          2.1
1       3.0            1.4         3.8          4.4
2       4.7            4.5         5.8          4.7
3       5.5            4.3         5.6          4.8
4       6.2            6.1         6.1          6.7
5       3.2            6.6         7.6          8.3
6       2.5            6.2         8.0          8.2
7       2.8            3.6         4.4          4.3
8       1.1            1.1         5.7          5.8
9       2.9            4.9         6.3          6.4
10      NaN            6.3         6.8          7.3
  ✓  sleep 의 group 1 == L-hyoscyamine - 대조 (환자 1–10)
  ✓  sleep 의 group 2 == L-hyoscine - 대조 (환자 1–10)
                             est      se    df       t       p      lo      hi
L-hyoscyamine vs 대조         0.75  0.5657   9.0  1.3257  0.2176 -0.5298  2.0298
L-hyoscine vs 대조            2.33  0.6332   9.0  3.6799  0.0051  0.8977  3.7623
대응: hyoscine − hyoscyamine  1.58  0.3890   9.0  4.0621  0.0028  0.7001  2.4599
대응 무시 (합동 t)                1.58  0.8491  18.0  1.8608  0.0792 -0.2039  3.3639
  ✓  예제 5.3: 대응 t = 4.06, p = 0.0028, 구간 [0.70, 2.46]
  ✓  예제 5.3: 대응을 무시하면 t = 1.86, p = 0.079
  ✓  예제 5.3: 대조와 비교 t = 1.33 (p = 0.22), t = 3.68 (p = 0.005)
  ✓  5.2절: 두 약의 상관 0.80
python
# 연습 5.3: 대응의 이득,  연습 5.5: 한쪽 구간
d = g2 - g1
sx, sy = g1.std(ddof=1), g2.std(ddof=1)
sd2 = sx**2 + sy**2 - 2 * r_xy * sx * sy
gain = (sx**2 + sy**2) / d.var(ddof=1)
up = d.mean() + stats.t.ppf(0.95, 9) * d.std(ddof=1) / math.sqrt(10)
low = d.mean() - stats.t.ppf(0.95, 9) * d.std(ddof=1) / math.sqrt(10)
print(f"연습 5.3: s²X + s²Y - 2 r sX sY = {sd2:.4f} == s²_d = {d.var(ddof=1):.4f},  분산의 비 {gain:.2f}")
print(f"연습 5.5: 95% 한쪽 한계 — 위 {up:.2f}, 아래 {low:.2f}")
report({"연습 5.3: 식이 맞고, 대응이 분산을 약 4.8배 줄인다": abs(sd2 - d.var(ddof=1)) < 1e-10 and abs(gain - 4.77) < 0.01,
        "연습 5.5: 위쪽 한계 2.29, 아래쪽 한계 0.87": abs(up - 2.293) < 1e-3 and abs(low - 0.867) < 1e-3})

fig, axes = plt.subplots(1, 2, figsize=(12, 3.8), gridspec_kw=dict(width_ratios=[1, 1.4]))
for a, b in zip(g1, g2):
    axes[0].plot([0, 1], [a, b], "-o", color=C["data"], ms=4, alpha=0.8)
axes[0].set_xticks([0, 1]); axes[0].set_xticklabels(["L-hyoscyamine", "L-hyoscine"]); axes[0].set_xlim(-0.3, 1.3)
axes[0].set_ylabel("extra hours"); axes[0].set_title("pairs: 9 of 10 lines go up")
for yv, (lab, rr), col in zip([1, 0], [("paired", res.loc["대응: hyoscine − hyoscyamine"]), ("pairing ignored", res.loc["대응 무시 (합동 t)"])], [C["key"], C["stat"]]):
    axes[1].errorbar(rr.est, yv, xerr=rr.est - rr.lo, fmt="o", color=col, capsize=4, lw=2)
    axes[1].text(rr.hi + 0.1, yv, f"{lab}: [{rr.lo:.2f}, {rr.hi:.2f}]", va="center", color=col)
axes[1].axvline(0, color=C["hist"], ls=":"); axes[1].set_yticks([]); axes[1].set_ylim(-0.6, 1.6); axes[1].set_xlim(-0.6, 6.2)
axes[1].set_xlabel("hyoscine − hyoscyamine (hours)"); axes[1].set_title("same 20 numbers, two intervals")
plt.tight_layout(); plt.show()
text
연습 5.3: s²X + s²Y - 2 r sX sY = 1.5129 == s²_d = 1.5129,  분산의 비 4.77
연습 5.5: 95% 한쪽 한계 — 위 2.29, 아래 0.87
  ✓  연습 5.3: 식이 맞고, 대응이 분산을 약 4.8배 줄인다
  ✓  연습 5.5: 위쪽 한계 2.29, 아래쪽 한계 0.87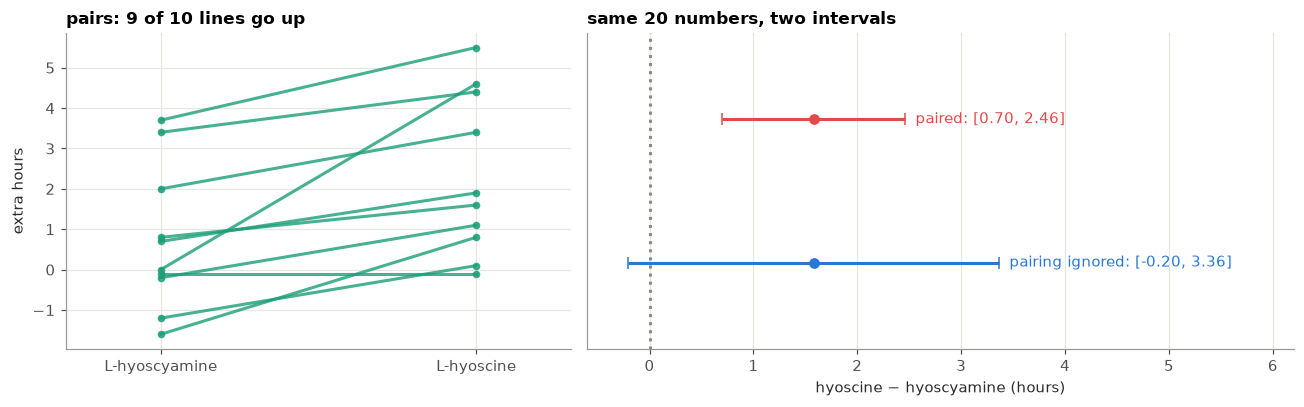
그림 읽기. 왼쪽에서 거의 모든 선이 올라가지만 선들의 높이는 크게 다르다(어떤 환자는 원래 잘 잔다). 대응 는 높이의 차이를 빼서 버리고 기울기만 본다. 대응을 무시하면 환자 사이의 변동이 분모에 들어가 구간이 0을 넘는다.
python
# 연습 5.4: 등분산이 아닐 때 — m = 5 (σ1 = 3), n = 20 (σ2 = 1). 벡터화한 합동·Welch 구간
def coverage_two_sample(m, s1, n, s2, reps=100_000):
    X = rng.normal(0, s1, (reps, m)); Y = rng.normal(0, s2, (reps, n))
    vx, vy = X.var(axis=1, ddof=1), Y.var(axis=1, ddof=1)
    diff = Y.mean(axis=1) - X.mean(axis=1)
    sp = np.sqrt(((m - 1) * vx + (n - 1) * vy) / (m + n - 2) * (1 / m + 1 / n))
    pooled = np.abs(diff) <= stats.t.ppf(0.975, m + n - 2) * sp
    a, b = vx / m, vy / n
    df = (a + b) ** 2 / (a**2 / (m - 1) + b**2 / (n - 1))
    welch = np.abs(diff) <= stats.t.ppf(0.975, df) * np.sqrt(a + b)
    return pooled.mean(), welch.mean()

cov_bad = coverage_two_sample(5, 3, 20, 1)
cov_rev = coverage_two_sample(5, 1, 20, 3)
print(f"연습 5.4: 작은 표본의 분산이 클 때 — 합동 {cov_bad[0]:.3f}, Welch {cov_bad[1]:.3f}")
print(f"         큰 표본의 분산이 클 때   — 합동 {cov_rev[0]:.3f}, Welch {cov_rev[1]:.3f}")
report({"연습 5.4: 합동 구간 ≈ 0.73, Welch ≈ 0.95": abs(cov_bad[0] - 0.733) < 0.01 and abs(cov_bad[1] - 0.946) < 0.01,
        "연습 5.4: 반대이면 합동 구간이 지나치게 보수적 (> 0.99)": cov_rev[0] > 0.99})
text
연습 5.4: 작은 표본의 분산이 클 때 — 합동 0.731, Welch 0.945text
         큰 표본의 분산이 클 때   — 합동 0.998, Welch 0.951
  ✓  연습 5.4: 합동 구간 ≈ 0.73, Welch ≈ 0.95
  ✓  연습 5.4: 반대이면 합동 구간이 지나치게 보수적 (> 0.99)
📝 연습 5.1–5.5 (강의노트): 구간의 평균 길이, 몇 개를 재야 하나, 대응의 이득, 등분산이 아닐 때, 한쪽 구간.
6. 데이터로 — Student의 카드 실험 (1908)
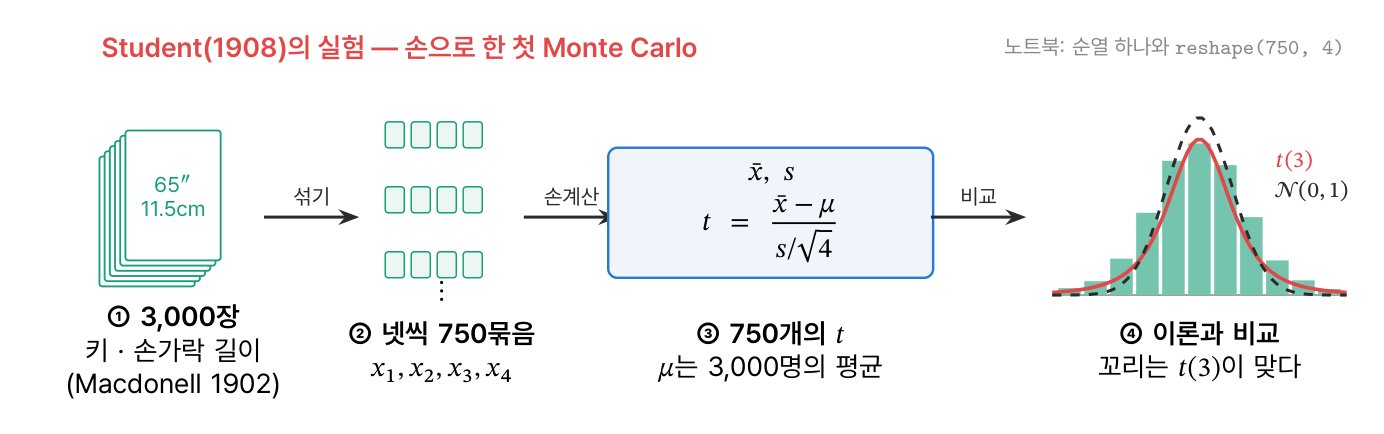
알고리즘 6.1 3,000장을 섞어 넷씩 750묶음 → 묶음마다 → 과 비교 · 예제 6.2 750개의 .
python
mac = load_rdata("MacdonellDF")
height = mac.height.to_numpy() * 12          # 피트 → 인치
finger = mac.finger.to_numpy()                # cm
for name, v in [("height (in)", height), ("finger (cm)", finger)]:
    print(f"{name:12s} N = {len(v)}, μ = {v.mean():.3f}, σ = {v.std():.3f}, 왜도 {stats.skew(v):.3f}, "
          f"초과첨도 {stats.kurtosis(v):.3f}, 서로 다른 값 {len(np.unique(v))}개")

def student_cards(values, seed, n=4):
    """알고리즘 6.1 — 모집단 values 를 섞어 n 장씩 끊고, 묶음마다 t 와 (n-1)s²/σ² 를 계산한다
    seed 는 정수이거나 Generator (Generator 를 넘기면 이어서 섞는다)"""
    mu, sigma = values.mean(), values.std()
    groups = values[np.random.default_rng(seed).permutation(len(values))].reshape(-1, n)
    s = groups.std(axis=1, ddof=1)
    ok = s > 0
    t = (groups.mean(axis=1)[ok] - mu) / (s[ok] / math.sqrt(n))
    return dict(t=t, q=(n - 1) * s**2 / sigma**2, zero=int((~ok).sum()))

def summarize(res, n=4):
    t = res["t"]
    return {"s = 0": res["zero"], "|t|>1.96": np.mean(np.abs(t) > 1.96), "|t|>3.182": np.mean(np.abs(t) > 3.182),
            "|t|>5.841": np.mean(np.abs(t) > 5.841), "KS vs t(3)": stats.kstest(t, stats.t(n - 1).cdf).pvalue,
            "KS vs N(0,1)": stats.kstest(t, stats.norm.cdf).pvalue, "KS (n-1)s²/σ² vs χ²(3)": stats.kstest(res["q"], stats.chi2(n - 1).cdf).pvalue}

run1907 = student_cards(height, 1907)
g7 = np.random.default_rng(7)
many = pd.DataFrame([summarize(student_cards(height, g7)) for _ in range(400)])
theory = {"s = 0": np.nan, "|t|>1.96": 2 * stats.t.sf(1.96, 3), "|t|>3.182": 0.05, "|t|>5.841": 0.01,
          "KS vs t(3)": np.nan, "KS vs N(0,1)": np.nan, "KS (n-1)s²/σ² vs χ²(3)": np.nan}
table = pd.DataFrame({"seed 1907": summarize(run1907), "400 shuffles (mean)": many.mean(), "t(3) theory": theory})
print("\n예제 6.2 — 키:\n", table.round(4).to_string())
s1907 = summarize(run1907)
report({"예제 6.2: s = 0 인 묶음 1개": s1907["s = 0"] == 1,
        "예제 6.2: |t|>1.96 이 14.2%, |t|>3.182 가 4.5%, |t|>5.841 이 0.8%": abs(s1907["|t|>1.96"] - 0.1415) < 1e-3 and abs(s1907["|t|>3.182"] - 0.0454) < 1e-3 and abs(s1907["|t|>5.841"] - 0.0080) < 1e-3,
        "예제 6.2: KS — t(3) 와는 0.30, 정규와는 0.005": abs(s1907["KS vs t(3)"] - 0.30) < 0.01 and abs(s1907["KS vs N(0,1)"] - 0.0054) < 1e-3,
        "예제 6.2: 섞기 400번의 평균 14.3%, 5.0%, 0.9% ≈ t(3) 이론": abs(many["|t|>1.96"].mean() - 0.1449) < 0.003 and abs(many["|t|>3.182"].mean() - 0.05) < 0.002})
text
height (in)  N = 3000, μ = 65.035, σ = 2.557, 왜도 0.050, 초과첨도 0.170, 서로 다른 값 20개
finger (cm)  N = 3000, μ = 11.547, σ = 0.549, 왜도 0.052, 초과첨도 0.109, 서로 다른 값 38개
text
예제 6.2 — 키:
                         seed 1907  400 shuffles (mean)  t(3) theory
s = 0                      1.0000               1.5025          NaN
|t|>1.96                   0.1415               0.1429       0.1449
|t|>3.182                  0.0454               0.0501       0.0500
|t|>5.841                  0.0080               0.0094       0.0100
KS vs t(3)                 0.2997               0.2467          NaN
KS vs N(0,1)               0.0054               0.0128          NaN
KS (n-1)s²/σ² vs χ²(3)     0.0280               0.0767          NaN
  ✓  예제 6.2: s = 0 인 묶음 1개
  ✓  예제 6.2: |t|>1.96 이 14.2%, |t|>3.182 가 4.5%, |t|>5.841 이 0.8%
  ✓  예제 6.2: KS — t(3) 와는 0.30, 정규와는 0.005
  ✓  예제 6.2: 섞기 400번의 평균 14.3%, 5.0%, 0.9% ≈ t(3) 이론
python
t = run1907["t"]
fig, axes = plt.subplots(1, 3, figsize=(13, 3.6))
vals, cnt = np.unique(height, return_counts=True)
axes[0].bar(vals, cnt / len(height), width=0.8, color=C["data"], alpha=0.8)
hh = np.linspace(vals.min() - 1, vals.max() + 1, 300)
axes[0].plot(hh, stats.norm.pdf(hh, height.mean(), height.std()), **THEORY)
axes[0].set_xlabel("height (inches)"); axes[0].set_title("Macdonell's 3,000 criminals")
tt = np.linspace(-6, 6, 400)
axes[1].hist(t[np.abs(t) < 6], bins=np.arange(-6, 6.01, 0.5), weights=np.full((np.abs(t) < 6).sum(), 1 / (len(t) * 0.5)), color=C["data"], alpha=0.7)
axes[1].plot(tt, stats.t.pdf(tt, 3), color=C["key"], label="t(3)"); axes[1].plot(tt, stats.norm.pdf(tt), **THEORY, label="N(0,1)")
axes[1].legend(); axes[1].set_title("749 values of t (seed 1907)")
cc = np.linspace(0, 8, 300)
axes[2].step(cc, [(np.abs(t) > c).mean() for c in cc], where="post", color=C["data"], label="cards")
axes[2].plot(cc, 2 * stats.t.sf(cc, 3), color=C["key"], label="t(3)"); axes[2].plot(cc, 2 * stats.norm.sf(cc), **THEORY, label="normal")
axes[2].set_yscale("log"); axes[2].set_ylim(1e-3, 1.2); axes[2].legend(); axes[2].set_title("P(|T| > c)")
plt.tight_layout(); plt.show()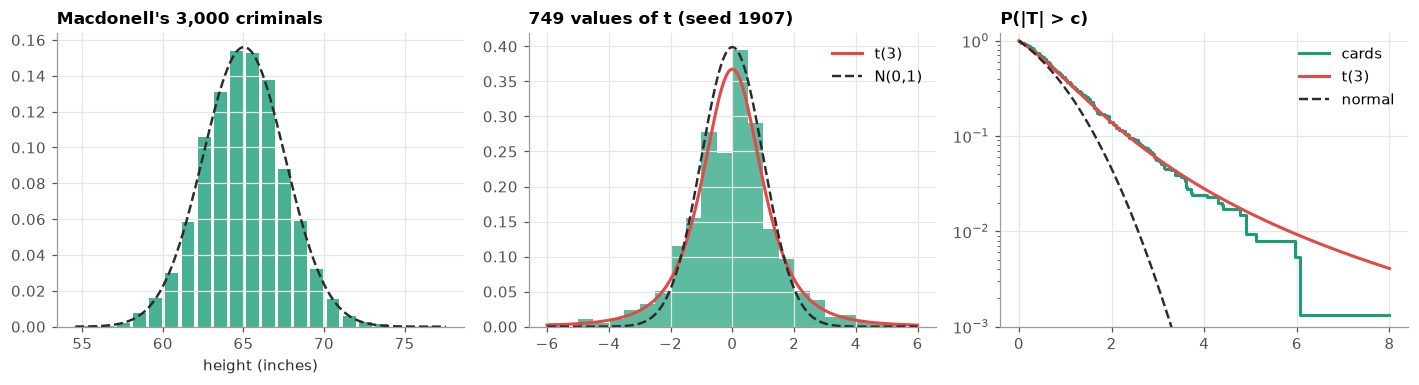
그림 읽기. 가운데: 1.96 바깥(정규 이론으로 5%)에 실제로는 14%가 있다. 오른쪽: 경험 꼬리(청록)는 (빨강)을 따라가고 정규(점선)는 에서 이미 열 배 넘게 얕잡는다. 경험 곡선이 근처에서 계단으로 끝나는 것은 표본이 749개뿐이기 때문이다(가장 작은 비율이 ).
python
# 연습 6.1: 손가락, 연습 6.3: 같은 계급에 넷, 연습 6.4: 섞기의 변동, 연습 6.2: Student 의 z
f1907 = summarize(student_cards(finger, 1907))
g7 = np.random.default_rng(7)
many_f = pd.DataFrame([summarize(student_cards(finger, g7)) for _ in range(400)])
print("연습 6.1 — 손가락 (씨앗 1907):", {k: round(float(v), 4) for k, v in f1907.items()})
print("          400번 평균:", many_f.mean().round(4).to_dict())

vals, cnt = np.unique(height, return_counts=True)
p4 = ((cnt / cnt.sum()) ** 4).sum()
N_ = len(height)
p4_wo = sum(c * (c - 1) * (c - 2) * (c - 3) for c in cnt) / (N_ * (N_ - 1) * (N_ - 2) * (N_ - 3))
print(f"연습 6.3: Σ p_k⁴ = {p4:.5f} → 750 묶음 중 기대 {750 * p4:.2f}개 (되돌려 넣지 않으면 {p4_wo:.5f}),  섞기 400번의 평균 {many['s = 0'].mean():.2f}개")

frac = many["|t|>3.182"]
f1908 = summarize(student_cards(height, 1908))["|t|>3.182"]
print(f"연습 6.4: 비율들의 표준편차 {frac.std():.4f} vs 이항 근사 {math.sqrt(0.05 * 0.95 / 750):.4f};  "
      f"씨앗 1908 은 {f1908:.3f} → 400번 중 그 이하가 {np.mean(frac <= f1908):.4f}")

# 연습 6.2: z = T/√(n-1) 의 밀도는 (1+z²)^(-n/2) 에 비례
n = 4
zz = np.linspace(-4, 4, 81)
fz = math.sqrt(n - 1) * stats.t.pdf(math.sqrt(n - 1) * zz, n - 1)
report({"연습 6.1: 손가락은 키보다 χ²(3) 에 잘 맞는다 (400번 평균 KS 유의확률)": many_f["KS (n-1)s²/σ² vs χ²(3)"].mean() > many["KS (n-1)s²/σ² vs χ²(3)"].mean(),
        "연습 6.1: 씨앗 1907 에서 손가락 |t|>3.182 가 6.3%": abs(f1907["|t|>3.182"] - 0.0627) < 1e-3,
        "연습 6.3: Σ p_k⁴ ≈ 0.00197, 기대 1.48개": abs(p4 - 0.00197) < 1e-5 and abs(750 * p4 - 1.477) < 0.01,
        "연습 6.4: 표준편차 ≈ 이항 근사 (±15%), 씨앗 1908 은 3.2%": abs(frac.std() / math.sqrt(0.05 * 0.95 / 750) - 1) < 0.15 and abs(f1908 - 0.032) < 1e-3,
        "연습 6.2: f_z / (1+z²)^(-n/2) 가 상수": np.ptp(fz / (1 + zz**2) ** (-n / 2)) < 1e-12})
text
연습 6.1 — 손가락 (씨앗 1907): {'s = 0': 0.0, '|t|>1.96': 0.1453, '|t|>3.182': 0.0627, '|t|>5.841': 0.016, 'KS vs t(3)': 0.9367, 'KS vs N(0,1)': 0.0039, 'KS (n-1)s²/σ² vs χ²(3)': 0.3075}
          400번 평균: {'s = 0': 0.1225, '|t|>1.96': 0.142, '|t|>3.182': 0.0473, '|t|>5.841': 0.0094, 'KS vs t(3)': 0.6166, 'KS vs N(0,1)': 0.0187, 'KS (n-1)s²/σ² vs χ²(3)': 0.4833}
연습 6.3: Σ p_k⁴ = 0.00197 → 750 묶음 중 기대 1.48개 (되돌려 넣지 않으면 0.00194),  섞기 400번의 평균 1.50개
연습 6.4: 비율들의 표준편차 0.0077 vs 이항 근사 0.0080;  씨앗 1908 은 0.032 → 400번 중 그 이하가 0.0025
  ✓  연습 6.1: 손가락은 키보다 χ²(3) 에 잘 맞는다 (400번 평균 KS 유의확률)
  ✓  연습 6.1: 씨앗 1907 에서 손가락 |t|>3.182 가 6.3%
  ✓  연습 6.3: Σ p_k⁴ ≈ 0.00197, 기대 1.48개
  ✓  연습 6.4: 표준편차 ≈ 이항 근사 (±15%), 씨앗 1908 은 3.2%
  ✓  연습 6.2: f_z / (1+z²)^(-n/2) 가 상수
📝 연습 6.1–6.4 (강의노트): 손가락으로, Student의 , 같은 계급에 넷, 섞기의 변동.
실험의 뜻. 씨앗 1908로 섞으면 의 비율이 3.2%로 나온다. 400번 가운데 그만큼 낮은 것은 한 번 정도다. 한 번의 시뮬레이션은 그 자체가 오차를 가진 표본이고, 7회는 그 오차를 정리로 다룬다.
7. 부숴보기 — 정규가 아니고, 독립이 아니면
명제 7.1 · 예제 7.2 한쪽으로 놓친다 · 명제 7.3 이상값 하나는 를 1로 끌고 간다 · 7.3절 AR(1)의 분산 팽창 · 7.4절 분산의 검정은 첨도에 민감하다.
python
def t_coverage(gen, mu, n, reps=50_000):
    X = gen((reps, n))
    xbar, s2, _ = sample_stats(X)
    hw = stats.t.ppf(0.975, n - 1) * np.sqrt(s2 / n)
    return np.mean(np.abs(xbar - mu) <= hw), np.mean(xbar + hw < mu), np.mean(xbar - hw > mu)

pops = {"uniform U(0,1)": (lambda sz: rng.random(sz), 0.5),
        "t(3)": (lambda sz: rng.standard_t(3, sz), 0.0),
        "exponential": (lambda sz: rng.exponential(1, sz), 1.0),
        "lognormal": (lambda sz: rng.lognormal(0, 1, sz), math.exp(0.5))}
ns = [5, 10, 30, 100]
tab = pd.DataFrame({name: [t_coverage(gen, mu, n)[0] for n in ns] for name, (gen, mu) in pops.items()}, index=[f"n={n}" for n in ns]).T
print("7.1절 표: 명목 95% t-구간의 실제 포함확률\n", tab.round(3).to_string())
notes = pd.DataFrame([[0.934, 0.946, 0.949, 0.948], [0.962, 0.960, 0.956, 0.952],
                      [0.884, 0.899, 0.927, 0.941], [0.822, 0.837, 0.882, 0.918]], index=tab.index, columns=tab.columns)
report({"7.1절: 노트의 표와 같다 (±0.01, 서로 다른 난수열)": np.allclose(tab, notes, atol=0.01),
        "7.1절: 대칭이면 n=10 부터 ≥ 0.945, 치우치면 n=30 에서도 < 0.93": (tab.iloc[:2, 1:] >= 0.945).all().all() and (tab.iloc[2:, 2] < 0.93).all()})
text
7.1절 표: 명목 95% t-구간의 실제 포함확률
                   n=5   n=10   n=30  n=100
uniform U(0,1)  0.934  0.947  0.951  0.949
t(3)            0.963  0.959  0.955  0.951
exponential     0.880  0.901  0.927  0.943
lognormal       0.823  0.840  0.885  0.918
  ✓  7.1절: 노트의 표와 같다 (±0.01, 서로 다른 난수열)
  ✓  7.1절: 대칭이면 n=10 부터 ≥ 0.945, 치우치면 n=30 에서도 < 0.93
python
# 명제 7.1 · 연습 7.1: Cov(X̄, S²) = μ3/n
checks = {}
for name, gen, mu3 in [("Exp(1), μ3 = 2", lambda sz: rng.exponential(1, sz), 2.0),
                       ("Gamma(2,1), μ3 = 4", lambda sz: rng.gamma(2.0, 1.0, sz), 4.0),
                       ("t(5), μ3 = 0", lambda sz: rng.standard_t(5, sz), 0.0)]:
    for n in (2, 10):
        xbar, s2, _ = sample_stats(gen((N_SIM, n)))
        c = np.cov(xbar, s2)[0, 1]
        se = np.std((xbar - xbar.mean()) * (s2 - s2.mean())) / math.sqrt(N_SIM)
        checks[f"명제 7.1: {name}, n = {n}: Cov ≈ {mu3 / n:.2f} (5 se 안, 계산값 {c:.3f})"] = abs(c - mu3 / n) < 5 * se

# 예제 7.2: 놓치는 방향 — 지수와 로그정규, n = 10
cov_e, below_e, above_e = t_coverage(lambda sz: rng.exponential(1, sz), 1.0, 10, N_SIM)
cov_l, below_l, above_l = t_coverage(lambda sz: rng.lognormal(0, 1, sz), math.exp(0.5), 10, N_SIM)
L = np.log(rng.lognormal(0, 1, (N_SIM, 10)))
lb, ls2, _ = sample_stats(L)
cover_log = np.mean(np.abs(lb) <= stats.t.ppf(0.975, 9) * np.sqrt(ls2 / 10))
X10 = rng.exponential(1, (N_SIM, 10))
corr_e = np.corrcoef(X10.mean(axis=1), X10.std(axis=1, ddof=1))[0, 1]
print(f"예제 7.2: 지수 — 포함 {cov_e:.3f}, 아래로 놓침 {below_e:.3f}, 위로 놓침 {above_e:.3f};  corr(X̄, S) = {corr_e:.2f}")
print(f"         로그정규 — 포함 {cov_l:.3f}, 아래로 {below_l:.3f}, 위로 {above_l:.4f};  로그 눈금의 중앙값 구간 {cover_log:.3f}")
checks |= {"예제 7.2: 지수 9.5% 와 0.4% 로 갈린다": abs(below_e - 0.095) < 0.003 and abs(above_e - 0.004) < 0.001,
           "예제 7.2: 로그정규 15.9% 와 0.1%": abs(below_l - 0.159) < 0.004 and above_l < 0.002,
           "예제 7.2: 로그를 취하면 95% 로 돌아온다": abs(cover_log - 0.95) < 0.003,
           "7.1절: 지수 n=10 에서 corr(X̄, S) ≈ 0.76": abs(corr_e - 0.76) < 0.01}
report(checks)
text
예제 7.2: 지수 — 포함 0.901, 아래로 놓침 0.095, 위로 놓침 0.004;  corr(X̄, S) = 0.76
         로그정규 — 포함 0.840, 아래로 0.159, 위로 0.0010;  로그 눈금의 중앙값 구간 0.951
  ✓  명제 7.1: Exp(1), μ3 = 2, n = 2: Cov ≈ 1.00 (5 se 안, 계산값 1.023)
  ✓  명제 7.1: Exp(1), μ3 = 2, n = 10: Cov ≈ 0.20 (5 se 안, 계산값 0.200)
  ✓  명제 7.1: Gamma(2,1), μ3 = 4, n = 2: Cov ≈ 2.00 (5 se 안, 계산값 1.975)
  ✓  명제 7.1: Gamma(2,1), μ3 = 4, n = 10: Cov ≈ 0.40 (5 se 안, 계산값 0.399)
  ✓  명제 7.1: t(5), μ3 = 0, n = 2: Cov ≈ 0.00 (5 se 안, 계산값 -0.011)
  ✓  명제 7.1: t(5), μ3 = 0, n = 10: Cov ≈ 0.00 (5 se 안, 계산값 -0.000)
  ✓  예제 7.2: 지수 9.5% 와 0.4% 로 갈린다
  ✓  예제 7.2: 로그정규 15.9% 와 0.1%
  ✓  예제 7.2: 로그를 취하면 95% 로 돌아온다
  ✓  7.1절: 지수 n=10 에서 corr(X̄, S) ≈ 0.76
python
# 명제 7.3: 이상값 하나 — 평균이 1 근처인 10개의 값
x = np.array([1.8, 0.77, 2.27, -0.66, 1.16, 1.09, 1.88, 0.82, 0.18, 0.53])
def t0(v):
    return math.sqrt(len(v)) * v.mean() / v.std(ddof=1)
Ms = [None, 5, 20, 100, 1e4]
tvals = {}
for M in Ms:
    y = x.copy()
    if M is not None:
        y[0] = M
    tvals["원자료" if M is None else f"x1 = {M:g}"] = t0(y)
print("명제 7.3:", {k: round(float(v), 3) for k, v in tvals.items()})
report({"명제 7.3: 3.58 → 1.45 (x1 = 20) → 1.09 (x1 = 100) → 1": abs(tvals["원자료"] - 3.58) < 0.01 and abs(tvals["x1 = 20"] - 1.454) < 0.01
            and abs(tvals["x1 = 100"] - 1.090) < 0.01 and abs(tvals["x1 = 10000"] - 1) < 0.002})
text
명제 7.3: {'원자료': 3.582, 'x1 = 5': 2.685, 'x1 = 20': 1.454, 'x1 = 100': 1.09, 'x1 = 10000': 1.001}
  ✓  명제 7.3: 3.58 → 1.45 (x1 = 20) → 1.09 (x1 = 100) → 1
python
# 7.3절 · 연습 7.2: AR(1) 의존 — Var X̄ 의 팽창과 t-구간의 포함확률
def ar1(rho, n, reps):
    e = rng.standard_normal((reps, n))
    x = np.empty_like(e); x[:, 0] = e[:, 0]
    for i in range(1, n):
        x[:, i] = rho * x[:, i - 1] + math.sqrt(1 - rho**2) * e[:, i]
    return x

def inflation(rho, n):
    k = np.arange(1, n)
    return 1 + 2 * np.sum((1 - k / n) * rho**k)

rows = []
for rho in (0.3, 0.5, -0.3):
    for n in (10, 30, 100):
        X = ar1(rho, n, 50_000)
        xbar, s2, _ = sample_stats(X)
        rows.append(dict(rho=rho, n=n, cover=np.mean(np.abs(xbar) <= stats.t.ppf(0.975, n - 1) * np.sqrt(s2 / n)),
                         nVar_sim=n * xbar.var(), nVar_theory=inflation(rho, n), limit=(1 + rho) / (1 - rho)))
ar = pd.DataFrame(rows)
print(ar.round(3).to_string(index=False))
r5 = ar[ar.rho == 0.5]
report({"연습 7.2: n Var X̄ == 1 + 2Σ(1-k/n)ρ^k (3% 안)": np.allclose(ar.nVar_sim, ar.nVar_theory, rtol=0.03),
        "7.3절: ρ = 0.5 에서 포함확률 0.76, 0.74, 0.74 — n 이 커져도 그대로": np.allclose(r5.cover, [0.755, 0.742, 0.744], atol=0.01),
        "7.3절: 극한 P(|Z| ≤ 1.96/√3) = 0.742": abs(2 * stats.norm.cdf(1.96 / math.sqrt(3)) - 1 - 0.742) < 1e-3,
        "연습 7.2: ρ < 0 이면 보수적 (> 0.95)": (ar[ar.rho == -0.3].cover > 0.95).all()})
text
 rho   n  cover  nVar_sim  nVar_theory  limit
 0.3  10  0.863     1.733        1.735  1.857
 0.3  30  0.852     1.822        1.816  1.857
 0.3 100  0.850     1.839        1.845  1.857
 0.5  10  0.751     2.617        2.600  3.000
 0.5  30  0.740     2.884        2.867  3.000
 0.5 100  0.739     2.985        2.960  3.000
-0.3  10  0.986     0.572        0.574  0.538
-0.3  30  0.989     0.556        0.550  0.538
-0.3 100  0.992     0.537        0.542  0.538
  ✓  연습 7.2: n Var X̄ == 1 + 2Σ(1-k/n)ρ^k (3% 안)
  ✓  7.3절: ρ = 0.5 에서 포함확률 0.76, 0.74, 0.74 — n 이 커져도 그대로
  ✓  7.3절: 극한 P(|Z| ≤ 1.96/√3) = 0.742
  ✓  연습 7.2: ρ < 0 이면 보수적 (> 0.95)
python
# 7.4절 · 연습 7.3: 분산의 F 검정의 실제 크기 vs 평균의 t 검정
fpops = {"normal": (lambda sz: rng.standard_normal(sz), 0.0, 0.0),
         "uniform": (lambda sz: rng.random(sz), -1.2, 0.5),
         "Laplace": (lambda sz: rng.laplace(0, 1, sz), 3.0, 0.0),
         "exponential": (lambda sz: rng.exponential(1, sz), 6.0, 1.0)}
rows = []
for name, (gen, kappa, mu) in fpops.items():
    row = dict(population=name, kappa=kappa, asymptotic=2 * stats.norm.sf(1.96 / math.sqrt(1 + kappa / 2)))
    for n in (11, 101):
        F = gen((60_000, n)).var(axis=1, ddof=1) / gen((60_000, n)).var(axis=1, ddof=1)
        lo, hi = stats.f.ppf([0.025, 0.975], n - 1, n - 1)
        row[f"F size, n={n}"] = np.mean((F < lo) | (F > hi))
    X = gen((60_000, 11)); xbar, s2, _ = sample_stats(X)
    row["t size, n=11"] = np.mean(np.abs(xbar - mu) > stats.t.ppf(0.975, 10) * np.sqrt(s2 / 11))
    rows.append(row)
fs = pd.DataFrame(rows).set_index("population")
print(fs.round(4).to_string())
report({"7.4절: n=11 에서 균등 1.0%, Laplace 16%, 지수 24%": np.allclose(fs.loc[["uniform", "Laplace", "exponential"], "F size, n=11"], [0.010, 0.163, 0.235], atol=0.006),
        "7.4절: n=101 에서 0.3%, 21%, 31% — 나아지지 않는다": np.allclose(fs.loc[["uniform", "Laplace", "exponential"], "F size, n=101"], [0.0025, 0.21, 0.31], atol=0.008),
        "연습 7.3: 점근 수준 Laplace 0.215, 지수 0.327": abs(fs.loc["Laplace", "asymptotic"] - 0.2151) < 1e-3 and abs(fs.loc["exponential", "asymptotic"] - 0.3271) < 1e-3,
        "7.4절: 같은 자료에서 t 검정은 지수를 빼면 4.3–5.2%": fs.drop("exponential")["t size, n=11"].between(0.040, 0.055).all()})
text
             kappa  asymptotic  F size, n=11  F size, n=101  t size, n=11
population
normal         0.0      0.0500        0.0508         0.0497        0.0498
uniform       -1.2      0.0019        0.0098         0.0023        0.0532
Laplace        3.0      0.2151        0.1618         0.2098        0.0423
exponential    6.0      0.3271        0.2345         0.3098        0.0980
  ✓  7.4절: n=11 에서 균등 1.0%, Laplace 16%, 지수 24%
  ✓  7.4절: n=101 에서 0.3%, 21%, 31% — 나아지지 않는다
  ✓  연습 7.3: 점근 수준 Laplace 0.215, 지수 0.327
  ✓  7.4절: 같은 자료에서 t 검정은 지수를 빼면 4.3–5.2%
표 읽기. 검정의 크기는 이 열 배가 되어도 점근값(asymptotic, 연습 7.3)으로 다가갈 뿐 5%로 돌아오지 않는다. 평균의 는 중심극한정리(7회)가 구해 주지만, 분산의 비교는 첨도 가 끝까지 남는다. Box(1953)가 "로버스트"라는 말을 만든 대조가 이것이다.
📝 연습 7.1–7.4 (강의노트): 지수 표본의 공분산, AR(1)의 분산, 검정의 점근 수준, 대칭이면 보수적.
8. Beautiful insights — 작은 표본의 분포, 오늘의 문제
정리 8.1 (예측구간) · 명제 8.2 배치 안의 표준화 값은 .
python
# 정리 8.1 · 연습 8.1: 예측구간
n = 5
X = rng.normal(2, 3, (N_SIM, n + 1))
xbar, s2, _ = sample_stats(X[:, :n])
hw = stats.t.ppf(0.975, n - 1) * np.sqrt(s2 * (1 + 1 / n))
cover_pred = np.mean(np.abs(X[:, n] - xbar) <= hw)
d = g2 - g1
pi = (d.mean() - stats.t.ppf(0.975, 9) * d.std(ddof=1) * math.sqrt(1.1), d.mean() + stats.t.ppf(0.975, 9) * d.std(ddof=1) * math.sqrt(1.1))
predw = {n_: stats.t.ppf(0.975, n_ - 1) * math.sqrt(1 + 1 / n_) for n_ in (4, 10, 100)}
print(f"8.1절: 다음 환자의 95% 예측구간 [{pi[0]:.2f}, {pi[1]:.2f}]  (평균의 구간 [0.70, 2.46])")
print("연습 8.1: 반폭 / σ =", {k: round(float(v), 3) for k, v in predw.items()}, " 극한 1.96")
report({"정리 8.1: 새 관측을 포함할 확률 ≈ 0.95 (4 se 안)": abs(cover_pred - 0.95) < 4 * math.sqrt(0.0475 / N_SIM),
        "8.1절: sleep 의 예측구간 [-1.34, 4.50]": abs(pi[0] + 1.338) < 1e-3 and abs(pi[1] - 4.498) < 1e-3,
        "연습 8.1: 3.56, 2.37, 1.99": np.allclose(list(predw.values()), [3.558, 2.373, 1.994], atol=1e-3)})
text
8.1절: 다음 환자의 95% 예측구간 [-1.34, 4.50]  (평균의 구간 [0.70, 2.46])
연습 8.1: 반폭 / σ = {4: 3.558, 10: 2.373, 100: 1.994}  극한 1.96
  ✓  정리 8.1: 새 관측을 포함할 확률 ≈ 0.95 (4 se 안)
  ✓  8.1절: sleep 의 예측구간 [-1.34, 4.50]
  ✓  연습 8.1: 3.56, 2.37, 1.99
BatchNorm을 직접 만든다
학습 때는 배치 통계량(분산은 로 나눈다)으로, 추론 때는 학습 중에 모은 이동평균으로 표준화한다. 활성값이 이고 배치가 4일 때 두 모드의 출력을 비교한다.
python
class BatchNorm1d:
    """한 특성의 배치 정규화 (척도 γ = 1, 위치 β = 0). running_* 는 지수 이동평균"""
    def __init__(self, momentum=0.1, eps=1e-5):
        self.momentum, self.eps = momentum, eps
        self.running_mean, self.running_var = 0.0, 1.0

    def __call__(self, x, training=True):
        if training:
            m, v = x.mean(), x.var()                          # 배치 통계량: 분산은 B 로 나눈다
            B = len(x)
            self.running_mean += self.momentum * (m - self.running_mean)
            self.running_var += self.momentum * (v * B / (B - 1) - self.running_var)   # 이동평균에는 불편분산
        else:
            m, v = self.running_mean, self.running_var
        return (x - m) / np.sqrt(v + self.eps)

B, steps = 4, 20_000
bn = BatchNorm1d()
train_out, run_var = [], []
for _ in range(steps):
    train_out.append(bn(rng.normal(3, 2, B), training=True))
    run_var.append(bn.running_var)
train_out, run_var = np.concatenate(train_out), np.array(run_var[1000:])
eval_out = bn(rng.normal(3, 2, steps * B), training=False)
# 이동평균도 흔들린다: 운동량 m 의 지수 이동평균은 Var = m/(2-m) · Var S², 따름정리 2.3 으로 Var S² = 2σ⁴/(B-1)
sd_theory = math.sqrt(0.1 / 1.9 * 2 * 16 / (B - 1))
print(f"이동평균의 분산 추정: 평균 {run_var.mean():.3f} (참 4), 표준편차 {run_var.std():.3f} (이론 {sd_theory:.3f} = σ²의 {sd_theory / 4:.0%})")
print(f"마지막 이동평균: mean {bn.running_mean:.3f}, var {bn.running_var:.3f} → 추론 출력은 N({(3 - bn.running_mean) / math.sqrt(bn.running_var):.3f}, {4 / bn.running_var:.3f})")
print(f"학습 모드: max|out| = {np.abs(train_out).max():.4f} (√3 = {math.sqrt(3):.4f}), P(|out| > 1.5) = {np.mean(np.abs(train_out) > 1.5):.3f}")
print(f"추론 모드: max|out| = {np.abs(eval_out).max():.2f}, P(|out| > 2) = {np.mean(np.abs(eval_out) > 2):.3f}")
eval_ref = stats.norm((3 - bn.running_mean) / math.sqrt(bn.running_var + bn.eps), 2 / math.sqrt(bn.running_var + bn.eps))

# 명제 8.2 · 연습 8.2 · 연습 8.3
Z2 = rng.standard_normal((N_SIM, 2)); h2 = (Z2[:, 0] - Z2.mean(axis=1)) / Z2.std(axis=1)
Z8 = rng.standard_normal((N_SIM, 8)); h8 = (Z8[:, 0] - Z8.mean(axis=1)) / Z8.std(axis=1)
newv = {}
for Bn in (4, 8):
    Zb = rng.standard_normal((N_SIM, Bn + 1))
    newv[Bn] = ((Zb[:, Bn] - Zb[:, :Bn].mean(axis=1)) / Zb[:, :Bn].std(axis=1)).var()
report({"명제 8.2: B = 4 에서 |x̂| ≤ √3 (eps 때문에 아주 조금 안쪽)": np.abs(train_out).max() <= math.sqrt(3),
        "명제 8.2: B = 2 이면 x̂ = ±1": np.allclose(np.abs(h2), 1),
        "연습 8.3: B = 4 의 학습 출력은 U(-√3, √3) (KS 유의확률 > 0.01)": stats.kstest(train_out[:20_000], stats.uniform(-math.sqrt(3), 2 * math.sqrt(3)).cdf).pvalue > 0.01,
        "연습 8.3: B = 8 에서 x̂²/7 ~ Beta(1/2, 3) (KS 유의확률 > 0.01)": stats.kstest(h8[:20_000] ** 2 / 7, stats.beta(0.5, 3).cdf).pvalue > 0.01,
        "연습 8.2: 새 값의 분산 (B+1)/(B-3) = 5, 1.8 (4% 안)": abs(newv[4] / 5 - 1) < 0.04 and abs(newv[8] / 1.8 - 1) < 0.04,
        "이동평균의 분산 추정: 평균 ≈ 4 (±0.1), 표준편차 ≈ 이론 0.75 (±15%)": abs(run_var.mean() - 4) < 0.1 and abs(run_var.std() / sd_theory - 1) < 0.15,
        "추론 모드 출력은 정규 (이동평균으로 정해진 평균·분산, KS 유의확률 > 0.01)": stats.kstest(eval_out[:20_000], eval_ref.cdf).pvalue > 0.01})

fig, ax = plt.subplots(figsize=(8, 3.4))
bins = np.linspace(-4, 4, 81)
ax.hist(train_out, bins=bins, density=True, color=C["stat"], alpha=0.55, label="training (batch of 4)")
ax.hist(eval_out, bins=bins, density=True, histtype="step", color=C["key"], lw=1.8, label="inference (running stats)")
ax.plot(bins, stats.norm.pdf(bins), **THEORY, label="N(0,1)")
ax.legend(); ax.set_title("BatchNorm with B = 4: the network trains on a flat distribution, predicts on a bell")
plt.tight_layout(); plt.show()
text
이동평균의 분산 추정: 평균 3.977 (참 4), 표준편차 0.748 (이론 0.749 = σ²의 19%)
마지막 이동평균: mean 3.139, var 3.511 → 추론 출력은 N(-0.074, 1.139)
학습 모드: max|out| = 1.7320 (√3 = 1.7321), P(|out| > 1.5) = 0.132
추론 모드: max|out| = 4.76, P(|out| > 2) = 0.063
  ✓  명제 8.2: B = 4 에서 |x̂| ≤ √3 (eps 때문에 아주 조금 안쪽)
  ✓  명제 8.2: B = 2 이면 x̂ = ±1
  ✓  연습 8.3: B = 4 의 학습 출력은 U(-√3, √3) (KS 유의확률 > 0.01)
  ✓  연습 8.3: B = 8 에서 x̂²/7 ~ Beta(1/2, 3) (KS 유의확률 > 0.01)
  ✓  연습 8.2: 새 값의 분산 (B+1)/(B-3) = 5, 1.8 (4% 안)
  ✓  이동평균의 분산 추정: 평균 ≈ 4 (±0.1), 표준편차 ≈ 이론 0.75 (±15%)
  ✓  추론 모드 출력은 정규 (이동평균으로 정해진 평균·분산, KS 유의확률 > 0.01)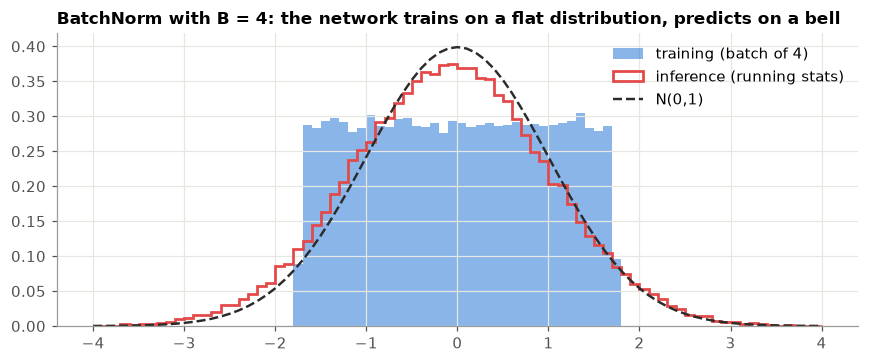
그림 읽기. 학습 때 다음 층이 받는 값은 의 평평한 분포(파랑)이고, 추론 때 받는 값은 종 모양(빨강)이다. 학습 출력의 평균과 분산은 정확히 0과 1이지만 모양이 다르다. 같은 층이 학습과 추론에서 다른 입력 분포를 본다. 게다가 추론에 쓰는 이동평균 자체가 흔들린다. 배치 4개의 분산 는 따름정리 2.3으로 표준편차가 이나 되고, 운동량 0.1의 이동평균으로 다듬어도 의 약 19%가 남는다. 학습을 언제 멈추느냐에 따라 추론 출력의 분산이 1에서 수십 % 벗어난다.
python
# 8.3절 · 연습 8.4: t-SNE 의 커널 — 같은 유사도를 주는 거리
dist = {c: (math.sqrt(-2 * math.log(c)), math.sqrt(1 / c - 1)) for c in (0.1, 0.01)}
print("연습 8.4: 유사도 c 를 주는 거리 (정규 커널, t(1) 커널):", {c: (round(a, 2), round(b, 2)) for c, (a, b) in dist.items()})
report({"연습 8.4: c = 0.1 → 2.15 와 3.0, c = 0.01 → 3.03 과 9.95": np.allclose(dist[0.1], [2.146, 3.0], atol=1e-3) and np.allclose(dist[0.01], [3.035, 9.950], atol=1e-3)})

# 8.4절: t 가능도의 로버스트 위치 추정 — IRLS (가중치 w = (ν+1)/(ν + r²), r = 잔차/척도)
def t_location(x, nu=4.0, iters=200):
    mu, sig2 = np.median(x), np.var(x)
    for _ in range(iters):
        r2 = (x - mu) ** 2 / sig2
        w = (nu + 1) / (nu + r2)
        mu = np.sum(w * x) / np.sum(w)
        sig2 = np.sum(w * (x - mu) ** 2) / len(x)
    return mu, math.sqrt(sig2), w

d_out = np.append(d, 15.0)                      # 수면 차이 10개에 엉뚱한 값 하나
mu_t, sig_t, w_t = t_location(d_out)
print(f"8.4절: 평균 {d.mean():.2f} → 이상값을 넣으면 {d_out.mean():.2f};  t(4) 위치 추정 {mu_t:.2f}, 이상값의 가중치 {w_t[-1]:.3f}")
print("       ν = 4 의 가중치 (잔차 0, 1, 3, 10):", [round((4 + 1) / (4 + r * r), 3) for r in (0, 1, 3, 10)])
report({"8.4절: t 위치 추정은 이상값에 거의 끌리지 않는다 (|μ_t - 1.58| < 0.15)": abs(mu_t - d.mean()) < 0.15,
        "8.4절: 이상값의 가중치 < 0.05": w_t[-1] < 0.05,
        "8.4절: 가중치 0.38 (잔차 3), 0.05 (잔차 10)": abs(5 / 13 - 0.385) < 1e-3 and abs(5 / 104 - 0.048) < 1e-3})
text
연습 8.4: 유사도 c 를 주는 거리 (정규 커널, t(1) 커널): {0.1: (2.15, 3.0), 0.01: (3.03, 9.95)}
  ✓  연습 8.4: c = 0.1 → 2.15 와 3.0, c = 0.01 → 3.03 과 9.95
8.4절: 평균 1.58 → 이상값을 넣으면 2.80;  t(4) 위치 추정 1.45, 이상값의 가중치 0.035
       ν = 4 의 가중치 (잔차 0, 1, 3, 10): [1.25, 1.0, 0.385, 0.048]
  ✓  8.4절: t 위치 추정은 이상값에 거의 끌리지 않는다 (|μ_t - 1.58| < 0.15)
  ✓  8.4절: 이상값의 가중치 < 0.05
  ✓  8.4절: 가중치 0.38 (잔차 3), 0.05 (잔차 10)
python
# 8.5절 · 연습 8.5: Lüroth 의 사후분포 — π(μ, σ) ∝ 1/σ
n_, xb, s = len(d), d.mean(), d.std(ddof=1)
sig2_post = (n_ - 1) * s**2 / rng.chisquare(n_ - 1, N_SIM)           # σ² | 자료
mu_post = rng.normal(xb, np.sqrt(sig2_post / n_))                    # μ | σ², 자료
post_ci = np.quantile(mu_post, [0.025, 0.975])
# σ 를 수치적분으로 없앤 주변 사후밀도 vs t(n-1) 밀도
def post_density(mu):
    A = (n_ - 1) * s**2 + n_ * (mu - xb) ** 2
    return integrate.quad(lambda sg: sg ** (-(n_ + 1)) * math.exp(-A / (2 * sg * sg)), 0, np.inf)[0]
grid = np.linspace(xb - 1.5, xb + 1.5, 7)
dens = np.array([post_density(m) for m in grid])
tden = stats.t.pdf((grid - xb) / (s / math.sqrt(n_)), n_ - 1)
print(f"8.5절: 사후분포의 95% 구간 [{post_ci[0]:.2f}, {post_ci[1]:.2f}]  vs  t-구간 [0.70, 2.46]")
report({"8.5절: 사후 구간 == t-구간 (±0.01)": np.allclose(post_ci, [0.700, 2.460], atol=0.01),
        "연습 8.5: σ 를 적분한 사후밀도 ∝ t(n-1) 밀도": np.ptp(dens / tden) / np.mean(dens / tden) < 1e-6})
text
8.5절: 사후분포의 95% 구간 [0.70, 2.46]  vs  t-구간 [0.70, 2.46]
  ✓  8.5절: 사후 구간 == t-구간 (±0.01)
  ✓  연습 8.5: σ 를 적분한 사후밀도 ∝ t(n-1) 밀도
📝 연습 8.1–8.5 (강의노트): 예측구간의 폭, 새 값의 분산, 배치 안의 값의 분포, t-SNE의 거리, Lüroth의 사후분포.
9. 정리 · 연습문제 지도 · 다음 회
| 내용 | 확인한 셀 | |
|---|---|---|
| 표본분산 (1.1–1.3) | 분포와 상관없는 불편성, , 의 실제 포함확률 | 1절 |
| Student 정리 (2.1–2.3) | Helmert 행렬, , , 지수 표본의 의존 | 2절 |
| 와 (3.2–4.3) | 밀도를 식대로 구현해 scipy와 대조, 정의로 만든 난수, 분산 혼합, 두 기계 | 3, 4절 |
| 추론 (5.2–5.4) | 일표본·대응·합동·Welch 구현, Cushny–Peebles 원자료, 등분산이 깨질 때 | 5절 |
| 카드 실험 (6.1–6.2) | 3,000장을 750묶음으로, 과 정규, 400번 섞기의 변동 | 6절 |
| 부숴보기 (7.1–7.3) | 비대칭·이상값·AR(1)·분산의 검정 | 7절 |
| 오늘 (8.1–8.2) | 예측구간, BatchNorm 직접 구현, t-SNE 커널, 가능도의 IRLS, Lüroth의 사후분포 | 8절 |
연습문제 지도 (강의노트, ★ 계산 · ★★ 증명 · ★★★ 도전, 풀이는 부록 A)
| 절 | 연습 | 이 노트북에서 확인하는 셀 |
|---|---|---|
| 1 를 모를 때 | 1.1 ★ · 1.2 ★★★ · 1.3 ★ · 1.4 평균제곱오차 ★★ | 1절 |
| 2 Student 정리 | 2.1 ★ · 2.2 ★ · 2.3 지수의 의존 ★★ · 2.4 ★★ · 2.5 의 구간 ★★ · 2.6 Helmert 직교성 증명 ★ (유도형) | 1, 2절 |
| 3 분포 | 3.1 ★★ · 3.2 분산 혼합 ★★★ · 3.3 ★★ · 3.4 꼬리 ★ · 3.5 의 성질 증명 ★★ (유도형) | 3절 |
| 4 분포 | 4.1 ★★ · 4.2 ★ · 4.3 두 기계의 구간 ★★ · 4.4 의 성질 증명 ★★ (유도형) | 4절 |
| 5 -구간 | 5.1 ★ · 5.2 ★★ · 5.3 대응의 이득 ★ · 5.4 Welch ★★ · 5.5 ★ | 5절 |
| 6 카드 실험 | 6.1 손가락 ★ · 6.2 Student의 ★★ · 6.3 ★★ · 6.4 섞기의 변동 ★★ | 6절 |
| 7 부숴보기 | 7.1 ★ · 7.2 AR(1) ★★ · 7.3 의 점근 수준 ★★★ · 7.4 ★★ · 7.5 공분산 증명 ★★ · 7.6 이상값의 극한 ★★ (유도형) | 7절 |
| 8 오늘 | 8.1 ★ · 8.2 ★★ · 8.3 배치 안의 분포 ★★★ · 8.4 ★ · 8.5 Lüroth ★★★ · 8.6 예측구간 증명 ★★ · 8.7 배치 상계 증명 ★★ (유도형) | 8절 |
다음 회 (7회) — 극한의 언어: 수렴 · CLT · Monte Carlo (1777 → 1949). 이번 회차의 정확한 분포는 모두 정규 가정에서 나왔다. 그런데 7절에서 지수 표본의 포함확률은 이 커지자 95%로 다가갔고, 카드 실험의 결과도 섞을 때마다 흔들렸다. 7회는 확률수렴·분포수렴, 중심극한정리, Slutsky 정리로 " 대신 를 넣고 1.96을 써도 큰 표본에서는 괜찮은" 이유를 증명하고, Monte Carlo의 오차를 정리로 다룬다.
10. 워크북 검산
워크북(06_student_t_workbook.pdf)의 문제는 손으로 먼저 푼다. 이 절은 다 푼 뒤에 쓴다.
check("A3", "5*exp(-4)")— 문항 번호와 손으로 구한 답을 넣으면 맞는지만 알려 준다. 정답은 보여 주지 않는다. 답은 수(0.0916)나 식의 문자열("sqrt(pi)/2")로 넣는다. 소문항은"A9a"처럼 번호 뒤에 붙인다. 소수로 넣으면 상대오차 0.1%까지 맞다고 본다. 분위수표의 값(2.776 등)으로 계산한 답도 그 범위 안에 든다.- 시뮬레이션으로 한 번 더 — 확률이 답인 문항은 아래에 시뮬레이션 함수를 정의해 두었다. 손으로 구한 값이 Monte Carlo 구간 안에 드는지 본다. 함수는 정의만 해 두었고 부르지 않았다. 답을 구하기 전에 부르면 답이 보인다.
증명 문제(B, C의 대부분)는 check()가 없다. 풀이판의 증명과 단계별로 맞춰 본다.
답 열쇠 셀 (내려받은 노트북에서 실행된다)
답 열쇠를 압축해 넣은 check() 정의 셀이다. 웹에서는 이 회차의 답 확인 페이지를 쓴다.
python
check()                 # 확인할 수 있는 문항 번호
check("A3")             # 답을 넣지 않으면 쓰는 법을 알려 준다
text
확인할 수 있는 문항: A1 A2a A2b A3 A4a A4b A5 A6 A7a A7b A8a A8b A9a A9b A10a A10b A11a A11b A12a A12b A13a A13b A14 C4a C4b C5b C9c C9d D1a D1b D1c D1d D1e D2c D2d D2e D3d D3e D4c D4d
A3: 아직 답을 넣지 않았다. 예: check('A3', '3/8')
10.1 내 답을 모아 확인하기
푼 문항의 답을 아래 사전에 채우고 실행한다. None인 문항은 건너뛴다.
python
mine = {
    "A1": None, "A2a": None, "A2b": None, "A3": None, "A4a": None, "A4b": None, "A5": None, "A6": None,
    "A7a": None, "A7b": None, "A8a": None, "A8b": None, "A9a": None, "A9b": None, "A10a": None, "A10b": None,
    "A11a": None, "A11b": None, "A12a": None, "A12b": None, "A13a": None, "A13b": None, "A14": None,
    "C4a": None, "C4b": None, "C5b": None, "C9c": None, "C9d": None,
    "D1a": None, "D1b": None, "D1c": None, "D1d": None, "D1e": None, "D2c": None, "D2d": None, "D2e": None,
    "D3d": None, "D3e": None, "D4c": None, "D4d": None,
}
check_all(mine)
text
0/0 맞음10.2 시뮬레이션 함수
각 함수는 (추정값, 표준오차)를 돌려준다(여러 값을 돌려주는 함수는 그 쌍들의 튜플). 손으로 구한 값이 추정값 ± 3 × 표준오차 안에 들면 계산이 맞을 가능성이 높다. 정확한 검산은 check()가 한다.
| 함수 | 문항 | 시뮬레이션 |
|---|---|---|
sim_A3() |
A3 | 정규 표본 5개 |
sim_A7() |
A7(a) , | 표준정규의 비 |
sim_A14() |
A14 세 관측의 1.96 구간 | 정규 표본 3개 |
sim_C4() |
C4 -구간이 더 짧을 확률 | 정규 표본 4개 |
sim_C5() |
C5 균등분포 두 개 | , , 둘 다 |
sim_D2() |
D2 대응 / 대응 무시의 검정력 | 이변량 정규 쌍 10개 |
sim_D3() |
D3(d)(e) 로그 균등의 비, Fisher 결합 | 균등분포 |
sim_D4() |
D4(d) 두 관측의 1.96 구간 | 정규 표본 2개 |
python
def _mc(hits):
    """불리언 배열 → (상대도수, 표준오차)"""
    hits = np.asarray(hits, dtype=bool)
    p = hits.mean()
    return p, np.sqrt(p * (1 - p) / hits.size)


def sim_A3(n=N_SIM):
    x = rng.normal(0, 2, size=(n, 5))
    return _mc(x.var(axis=1, ddof=1) > 8)


def sim_A7(n=N_SIM):
    return _mc(rng.standard_normal(n) / rng.standard_normal(n) > np.sqrt(3))


def _cover(m, c, n):
    """정규 표본 m개에서 x̄ ± c s/√m 이 μ = 0 을 포함하는 비율"""
    x = rng.standard_normal((n, m))
    return _mc(np.abs(x.mean(axis=1)) <= c * x.std(axis=1, ddof=1) / np.sqrt(m))


def sim_A14(n=N_SIM):
    return _cover(3, 1.96, n)


def sim_C4(n=N_SIM):
    s = rng.standard_normal((n, 4)).std(axis=1, ddof=1)
    return _mc(3.182 * s < 1.96)


def sim_C5(n=N_SIM):
    u = rng.uniform(-1, 1, size=(n, 2))
    big_mean = np.abs(u.mean(axis=1)) > 0.5
    big_var = u.var(axis=1, ddof=1) > 0.5
    return _mc(big_mean), _mc(big_var), _mc(big_mean & big_var)


def sim_D2(n=40_000, m=10, rho=0.8, delta=0.5):
    """σ = 1. (대응 검정의 검정력, 대응을 무시한 검정의 검정력)"""
    cov = np.array([[1, rho], [rho, 1]])
    xy = rng.multivariate_normal([delta, 0], cov, size=(n, m))
    dbar = (xy[..., 0] - xy[..., 1]).mean(axis=1)
    paired = np.abs(dbar) / np.sqrt(2 * (1 - rho) / m) > 1.96
    unpaired = np.abs(dbar) / np.sqrt(2 / m) > 1.96
    return _mc(paired), _mc(unpaired)


def sim_D3(n=N_SIM):
    """(P(log U / log V > 3), 귀무가설 아래 P(χ² 결합 통계량 ≥ 관측값))"""
    u, v = rng.random(n), rng.random(n)
    fisher = -2 * (np.log(rng.random(n)) + np.log(rng.random(n)))
    return _mc(np.log(u) / np.log(v) > 3), _mc(fisher >= -2 * (np.log(0.04) + np.log(0.10)))


def sim_D4(n=N_SIM):
    return _cover(2, 1.96, n)
python
# 자체 검사 (출력 없음): 시뮬레이션이 답 열쇠와 맞는지, check()가 답 열쇠의 값과 그 소수를 맞다고 하는지 확인한다.
def _close(sim, key, z=4.0):
    est, se = sim
    return abs(est - _value(key)) <= z * se + 1e-12

assert _close(sim_A3(), "A3")
assert _close(sim_A7(), "A7a")
assert _close(sim_A14(), "A14")
assert _close(sim_C4(), "C4b")
_m, _v, _both = sim_C5()
assert _close(_m, "C5b") and _close(_v, "C5b") and _both[0] == 0
_p, _u = sim_D2()
assert _close(_p, "D2c") and _close(_u, "D2d")
_r, _f = sim_D3()
assert _close(_r, "D3d") and _close(_f, "D3e")
assert _close(sim_D4(), "D4d")
for _k, _e in _WB.items():
    assert _same(_e, _e["value"])
    if not _e.get("vars") and "points" not in _e:
        assert _same(_e, float(sp.sympify(_e["value"])))