Skip to content

7회 · 극한의 언어 · 노트

3 중심극한정리 ​

역사 de Moivre(1733)는 이항분포에서(5회 1절), Laplace(1810)는 독립인 오차의 일반적인 합에서 정규 극한을 얻었다. Laplace의 논증은 오늘의 특성함수와 같은 생각이었지만 엄밀하지 않았다. Poisson(1824)은 정리를 다듬으면서, 밀도가 1π(1+x2)\tfrac1{\pi(1+x^2)}인 오차는 아무리 평균해도 정규에 가까워지지 않음을 보였다. 엄밀한 증명은 러시아 학파가 했다. Chebyshev(1887)와 Markov(1898)는 적률로, Lyapunov(1901)는 특성함수로 증명했고, Lindeberg(1922)는 거의 필요충분인 조건을 찾았으며, Feller와 Lévy(1935)가 그 조건의 필요성을 보였다. “중심”극한정리라는 이름은 Pólya(1920)가 확률론에서 중심적인 정리라는 뜻으로 붙였다.

3.1 mgf로 증명하기 ​

정리 3.1 (중심극한정리) X1,X2,…X_1,X_2,\dots가 iid이고 mgf가 어떤 h>0h>0에 대해 ∣t∣<h|t|<h에서 존재하며, 평균 μ\mu, 분산 σ2>0\sigma^2>0이면

Zn=n (Xˉn−μ)σ=∑i=1n(Xi−μ)σn →D N(0,1).Z_n=\frac{\sqrt n\,(\bar X_n-\mu)}{\sigma}=\frac{\sum_{i=1}^n(X_i-\mu)}{\sigma\sqrt n}\ \xrightarrow{D}\ \N(0,1).

증명 전략 표준화한 합의 mgf의 로그를 nψ(t/n)n\psi(t/\sqrt n)으로 쓰고, ψ\psi를 0 근처에서 2차까지 Taylor 전개한다. 상수항과 1차 항은 0이고, 2차 항만 nn을 곱해도 남는다. mgf의 극한이 정규의 mgf이면 2.3절의 상자로 끝난다.

  1. Yi=(Xi−μ)/σY_i=(X_i-\mu)/\sigma로 두면 YiY_i는 iid이고 평균 0, 분산 1이며, mgf MY(s)=e−μs/σMX(s/σ)M_Y(s)=e^{-\mu s/\sigma}M_X(s/\sigma)가 ∣s∣<σh|s|<\sigma h에서 존재한다.2회 정리 3.6

  2. ψ=log⁡MY\psi=\log M_Y는 ∣s∣<σh|s|<\sigma h에서 무한 번 미분가능하고 ψ(0)=0\psi(0)=0, ψ′(0)=EY=0\psi'(0)=EY=0, ψ′′(0)=Var⁡Y=1\psi''(0)=\Var Y=1이다.2회 정리 3.3, 따름정리 3.4

  3. Zn=1n∑i=1nYiZ_n=\tfrac1{\sqrt n}\sum_{i=1}^nY_i이므로

    MZn(t)=[MY(tn)]n,log⁡MZn(t)=n ψ(tn).M_{Z_n}(t)=\Bigl[M_Y\Bigl(\frac t{\sqrt n}\Bigr)\Bigr]^n,\qquad\log M_{Z_n}(t)=n\,\psi\Bigl(\frac t{\sqrt n}\Bigr) .
  4. ∣t∣<σh|t|<\sigma h를 고정하고 s=t/ns=t/\sqrt n으로 두면, Lagrange 나머지항이 있는 Taylor 정리로 00과 ss 사이의 ξn\xi_n이 있어

    ψ(s)=ψ(0)+ψ′(0)s+12ψ′′(ξn)s2=12ψ′′(ξn)s2.\psi(s)=\psi(0)+\psi'(0)s+\tfrac12\psi''(\xi_n)s^2=\tfrac12\psi''(\xi_n)s^2 .
    [T8], 2
  5. 따라서 nψ(t/n)=t22ψ′′(ξn)n\psi(t/\sqrt n)=\tfrac{t^2}2\psi''(\xi_n)이다. ∣ξn∣≤∣t∣/n→0|\xi_n|\le|t|/\sqrt n\to0이고 ψ′′\psi''는 0에서 연속이므로 이 값은 t22\tfrac{t^2}2로 간다.2, [T5]

  6. MZn(t)→et2/2M_{Z_n}(t)\to e^{t^2/2}이 ∣t∣<σh|t|<\sigma h의 모든 tt에서 성립한다. 이것은 N(0,1)\N(0,1)의 mgf이므로 Zn→DN(0,1)Z_n\xrightarrow{D}\N(0,1)이다.2.3절의 상자, 5회 정리 1.8(ii)

조건 확인 4에서 s=t/ns=t/\sqrt n은 모든 n≥1n\ge1에서 ∣s∣≤∣t∣<σh|s|\le|t|<\sigma h이므로 ψ\psi가 정의된 구간 안에 있다. ψ=log⁡MY\psi=\log M_Y가 정의되려면 MY>0M_Y>0이어야 하는데, MY(s)=EesYM_Y(s)=Ee^{sY}는 양수의 기댓값이다. 2.3절의 상자는 mgf의 수렴을 0을 포함하는 열린 구간에서 요구하고, 여기서는 (−σh,σh)(-\sigma h,\sigma h) 전체에서 성립한다.

증명이 왜 정규인지를 말해 준다. ψ\psi의 전개 ψ(s)=s22+κ36s3+κ424s4+⋯\psi(s)=\tfrac{s^2}2+\tfrac{\kappa_3}6s^3+\tfrac{\kappa_4}{24}s^4+\cdots에서(κj\kappa_j는 누율, κ3\kappa_3은 왜도) 1차 항은 중심화로 사라지고, 3차 이상은 nψ(t/n)n\psi(t/\sqrt n)에서

n ψ(tn)=t22+κ3t36n+κ4t424n+⋯n\,\psi\Bigl(\frac t{\sqrt n}\Bigr)=\frac{t^2}2+\frac{\kappa_3t^3}{6\sqrt n}+\frac{\kappa_4t^4}{24n}+\cdots

처럼 1/n1/\sqrt n, 1/n1/n의 속도로 사라진다(연습 3.1). 살아남는 것은 2차 항, 곧 분산뿐이고, 분산만으로 정해지는 분포가 정규다. 그리고 가장 늦게 사라지는 것은 왜도의 항이다. 6회 7절에서 치우친 모집단의 tt-구간이 1/n1/\sqrt n의 속도로만 나아진 이유가 이것이다.

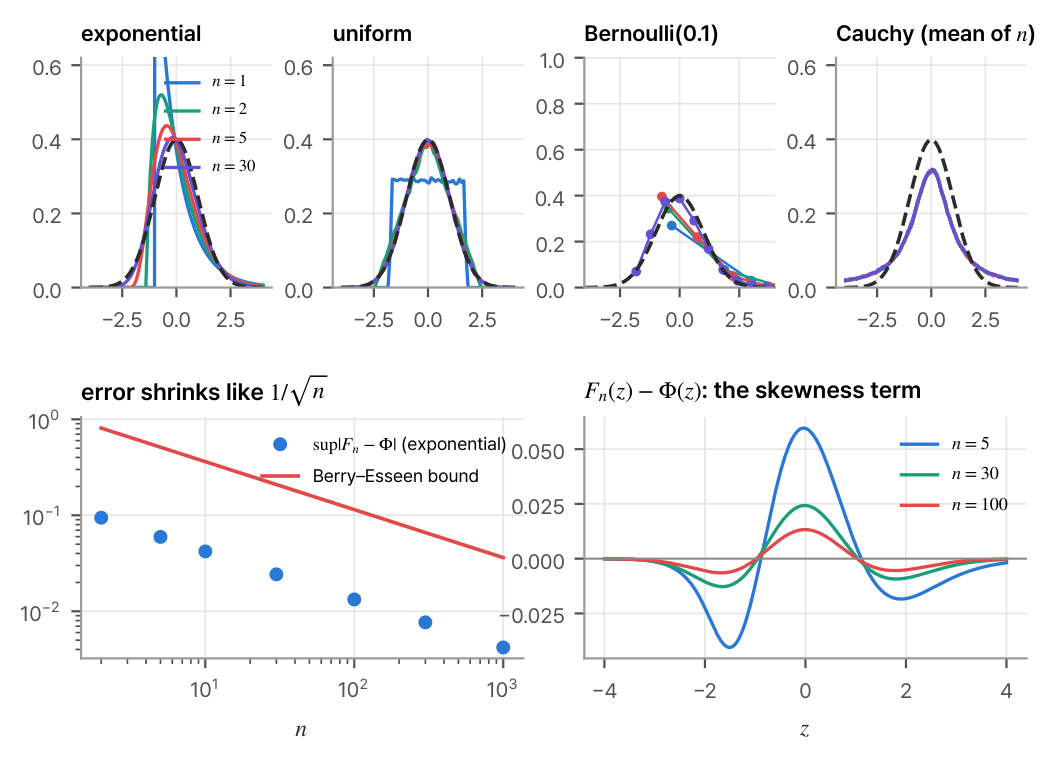
그림 3.1. 표준화한 합 Z_n의 밀도. 위: 지수, 균등, Bernoulli(0.1), Cauchy를 n=1,2,5,30개 더했다(점선은 N(0,1)). 대칭인 균등은 n=5에서 이미 정규와 겹치고, 치우친 지수와 Bernoulli는 느리며, Cauchy는 n이 커져도 모양이 그대로다. 아래 왼쪽: 지수의 경우 sup_x|F_n(x
그림 3.1 표준화한 합 ZnZ_n의 밀도. 위: 지수, 균등, Bernoulli(0.1)(0.1), Cauchy를 n=1,2,5,30n=1,2,5,30개 더했다(점선은 N(0,1)\N(0,1)). 대칭인 균등은 n=5n=5에서 이미 정규와 겹치고, 치우친 지수와 Bernoulli는 느리며, Cauchy는 nn이 커져도 모양이 그대로다. 아래 왼쪽: 지수의 경우 sup⁡x∣Fn(x)−Φ(x)∣\sup_x|F_n(x)-\Phi(x)|(점)와 Berry–Esseen 상한(선). 둘 다 1/n1/\sqrt n의 기울기다. 아래 오른쪽: 오차 Fn(z)−Φ(z)F_n(z)-\Phi(z)의 모양. 왜도 때문에 생기는 이 모양이 1/n1/\sqrt n에 비례해 줄어든다.

따름정리 3.2 (정규근사의 표준 예) n→∞n\to\infty일 때

  1. (a)

    Kn∼b(n,p)K_n\sim\mathrm b(n,p)이면 Kn−npnpq→DN(0,1)\tfrac{K_n-np}{\sqrt{npq}}\xrightarrow{D}\N(0,\allowbreak 1) (de Moivre–Laplace, 5회 따름정리 1.3).

  2. (b)

    Xλ∼Poi(λ)X_\lambda\sim\mathrm{Poi}(\lambda)이면 λ→∞\lambda\to\infty에서 Xλ−λλ→DN(0,1)\tfrac{X_\lambda-\lambda}{\sqrt\lambda}\xrightarrow{D}\N(0,\allowbreak 1).

  3. (c)

    Vr∼χ2(r)V_r\sim\chi^2(r)이면 Vr−r2r→DN(0,1)\tfrac{V_r-r}{\sqrt{2r}}\xrightarrow{D}\N(0,\allowbreak 1).

증명 (a) KnK_n은 iid Bernoulli의 합. (c) VrV_r은 iid χ2(1)\chi^2(1) rr개의 합(4회 정리 3.9)이고 χ2(1)\chi^2(1)의 mgf는 t<12t<\tfrac12에서 존재한다. (b) 정수 λ=m\lambda=m이면 XmX_m은 iid Poi(1)\mathrm{Poi}(1) mm개의 합(4회 정리 2.4)이다. 정수가 아닌 λ\lambda는 mgf를 직접 쓴다: log⁡M(t)=λ(et/λ−1)−λt=t22+O(λ−1/2)\log M(t)=\lambda(e^{t/\sqrt\lambda}-1)-\sqrt\lambda t=\tfrac{t^2}2+O(\lambda^{-1/2}).

예제 3.3 (근사는 얼마나 좋은가) 

정확한 값정규근사연속성 보정
b(100,12)\mathrm b(100,\tfrac12), P(K≤45)P(K\le45)0.18410.15870.1841
Poi(100)\mathrm{Poi}(100), P(X≥120)P(X\ge120)0.02820.02280.0256
χ2(10)\chi^2(10), P(V>r+22r)P(V>r+2\sqrt{2r})0.04100.0228—
χ2(100)\chi^2(100), P(V>r+22r)P(V>r+2\sqrt{2r})0.02980.0228—

대칭인 이항(p=12p=\tfrac12)에서는 연속성 보정(정수 kk를 구간 [k−12,k+12][k-\tfrac12,k+\tfrac12]로 보는 것)만 하면 넷째 자리까지 맞는다. 치우친 분포의 오른쪽 꼬리는 정규근사가 얕잡는다. χ2(10)\chi^2(10)에서 거의 두 배다. 8회의 χ2\chi^2 검정은 이 근사의 오차를 안고 쓴다.

3.2 더 넓은 정리와 속도 ​

정리 3.1는 mgf를 가정했지만 결론에는 분산만 나온다. 실제로 가정은 분산까지 줄일 수 있고, 같은 분포라는 가정도 뺄 수 있다.

증명 없이 쓰는 사실 (분산만 있으면 — Lindeberg–Lévy, Lindeberg–Feller) (1) iid이고 σ2<∞\sigma^2<\infty이면 mgf가 없어도 Zn→DN(0,1)Z_n\xrightarrow{D}\N(0,1)이다. 증명은 mgf 대신 언제나 존재하는 특성함수 EeitXEe^{itX}로 같은 테일러 전개를 한다(복소수가 필요하다). 이 노트는 이후 이 형태를 쓴다.

(2) 독립이지만 분포가 다르면, sn2=∑i≤nσi2s_n^2=\sum_{i\le n}\sigma_i^2에 대해 Lyapunov 조건 1sn3∑i≤nE∣Xi−μi∣3→0\tfrac1{s_n^3}\sum_{i\le n}E|X_i-\mu_i|^3\to0이면 ∑(Xi−μi)sn→DN(0,1)\tfrac{\sum(X_i-\mu_i)}{s_n}\xrightarrow{D}\N(0,\allowbreak 1)이다(Lyapunov, 1901). 더 약한 Lindeberg 조건은 “어느 한 항도 전체 분산에서 무시할 수 없을 만큼 크지 않다”는 뜻이다. 작은 독립 효과가 많이 모이면 정규라는 직관의 정확한 형태다.

증명 없이 쓰는 사실 (Berry–Esseen 한계) iid이고 ρ=E∣X−μ∣3<∞\rho=E|X-\mu|^3<\infty이면 모든 nn과 xx에서

∣P(Zn≤x)−Φ(x)∣≤C ρσ3n,C≤0.4748\bigl|P(Z_n\le x)-\Phi(x)\bigr|\le C\,\frac{\rho}{\sigma^3\sqrt n},\qquad C\le0.4748

이다(Berry 1941, Esseen 1942; 상수는 Shevtsova 2011). 정규근사의 오차는 1/n1/\sqrt n의 속도로 줄고, 그 상수는 3차 절대적률이 정한다.

예제 3.4 (지수 합의 근사 오차) Exp(1)\mathrm{Exp}(1)이면 σ=1\sigma=1이고 ρ=E∣X−1∣3=12e−2=2.415\rho=E|X-1|^3=\tfrac{12}e-2=2.415이다(연습 3.2). ∑Xi∼Γ(n,1)\sum X_i\sim\Gamma(n,1)이므로 오차를 정확히 잴 수 있다.

n=5n=5n=30n=30n=100n=100
실제 sup⁡x∣Fn(x)−Φ(x)∣\sup_x|F_n(x)-\Phi(x)|0.0600.0240.013
Berry–Esseen 상한0.5130.2090.115

상한은 실제보다 9배쯤 크지만 속도 1/n1/\sqrt n은 정확하다(그림 3.1 아래). n=30n=30에서도 분포함수가 0.024만큼 어긋난다. 이 어긋남이 꼬리에 있으면 상대오차로는 크다(7절).

예제 3.5 (Poisson의 반례 — Cauchy 분포) XiX_i가 iid 표준 Cauchy(밀도 1π(1+x2)\tfrac1{\pi(1+x^2)})이면 Xˉn\bar X_n은 모든 nn에서 다시 표준 Cauchy다(아래 상자). 평균을 내도 흩어짐이 줄지 않는다. n=100n=100이어도 P(∣Xˉ100∣>1)=12P(|\bar X_{100}|>1)=\tfrac12로 관측 하나와 같다. 평균이 없으므로(2회 예제 1.8) Khinchin도 중심극한정리도 쓸 수 없다. Poisson은 1824년에 이것을 보였고, 분포의 이름은 30년 뒤 같은 사실을 다시 논한 Cauchy(1853)에게 갔다(9.2절).

증명 없이 쓰는 사실 (Cauchy의 평균은 Cauchy) X1,…,XnX_1,\dots,X_n이 iid 표준 Cauchy이면 Xˉn\bar X_n도 표준 Cauchy다. 특성함수 EeitX=e−∣t∣Ee^{itX}=e^{-|t|}로 한 줄에 증명된다: (e−∣t∣/n)n=e−∣t∣\bigl(e^{-|t|/n}\bigr)^n=e^{-|t|}. n=2n=2는 합성곱(3회 정리 5.5)으로 직접 확인할 수 있다(연습 3.6).

연습문제

연습 3.1 (누율과 수렴 속도 ★★) ψ(s)=s22+κ36s3+O(s4)\psi(s)=\tfrac{s^2}2+\tfrac{\kappa_3}6s^3+O(s^4)이면 nψ(t/n)−t22=κ3t36n+O(1n)n\psi(t/\sqrt n)-\tfrac{t^2}2=\tfrac{\kappa_3t^3}{6\sqrt n}+O(\tfrac1n)임을 보여라. 지수분포의 κ3\kappa_3을 ψ(t)=−log⁡(1−t)−t\psi(t)=-\log(1-t)-t에서 구하라.

풀이

nψ(t/n)=n[t22n+κ3t36n3/2+O(n−2)]=t22+κ3t36n+O(1n)n\psi(t/\sqrt n)=n\bigl[\tfrac{t^2}{2n}+\tfrac{\kappa_3t^3}{6n^{3/2}}+O(n^{-2})\bigr]=\tfrac{t^2}2+\tfrac{\kappa_3t^3}{6\sqrt n}+O(\tfrac1n). 지수분포를 중심화하면 ψ(t)=−log⁡(1−t)−t=t22+t33+⋯\psi(t)=-\log(1-t)-t=\tfrac{t^2}2+\tfrac{t^3}3+\cdots이므로 κ36=13\tfrac{\kappa_3}6=\tfrac13, κ3=2\kappa_3=2. 왜도 2가 1/n1/\sqrt n의 오차를 만든다.

연습 3.2 (지수분포의 3차 절대적률 ★) X∼Exp(1)X\sim\mathrm{Exp}(1)이면 E∣X−1∣3=12e−2E|X-1|^3=\tfrac{12}e-2임을 보여라. (힌트: ∫01(1−x)3e−xdx\int_0^1(1-x)^3e^{-x}dx와 ∫1∞(x−1)3e−xdx=6e\int_1^\infty(x-1)^3e^{-x}dx=\tfrac6e로 나눈다.)

풀이

∫1∞(x−1)3e−xdx=e−1∫0∞u3e−udu=6e\int_1^\infty(x-1)^3e^{-x}dx=e^{-1}\int_0^\infty u^3e^{-u}du=\tfrac6e. 부분적분을 되풀이하면 ∫01(1−x)3e−xdx=6e−2\int_0^1(1-x)^3e^{-x}dx=\tfrac6e-2 (계산: ∫01(1−x)ke−xdx=1−kIk−1\int_0^1(1-x)^ke^{-x}dx=1-kI_{k-1}, I0=1−e−1I_0=1-e^{-1}에서 I1=e−1I_1=e^{-1}, I2=1−2e−1I_2=1-2e^{-1}, I3=1−3+6e−1I_3=1-3+6e^{-1}). 합은 12e−2=2.415\tfrac{12}e-2=2.415.

연습 3.3 (확률이 다른 동전들 ★★) Xi∼Bernoulli(pi)X_i\sim\mathrm{Bernoulli}(p_i)가 독립이고 sn2=∑i≤npiqi→∞s_n^2=\sum_{i\le n}p_iq_i\to\infty이면 Lyapunov 조건이 성립함을 보여라. (힌트: E∣Xi−pi∣3≤piqiE|X_i-p_i|^3\le p_iq_i.) 따라서 확률이 제각각인 시행의 성공 수도 정규에 가깝다.

풀이

Xi−piX_i-p_i는 확률 pip_i로 qiq_i, 확률 qiq_i로 −pi-p_i이므로 E∣Xi−pi∣3=piqi3+qipi3=piqi(pi2+qi2)≤piqiE|X_i-p_i|^3=p_iq_i^3+q_ip_i^3=p_iq_i(p_i^2+q_i^2)\le p_iq_i. 따라서 1sn3∑E∣Xi−pi∣3≤sn2sn3=1sn→0\tfrac1{s_n^3}\sum E|X_i-p_i|^3\le\tfrac{s_n^2}{s_n^3}=\tfrac1{s_n}\to0.

연습 3.4 (균등 12개 ★) 옛 컴퓨터는 U1+⋯+U12−6U_1+\cdots+U_{12}-6 (Ui∼iidU(0,1)U_i\iid\mathrm U(0,1))을 정규 난수로 썼다. 평균 0, 분산 1임을 보이고, 초과첨도가 −1.2/12=−0.1-1.2/12=-0.1임을 누율의 가법성으로 보여라. 이 난수의 결점은 무엇인가?

풀이

EU=12EU=\tfrac12, Var⁡U=112\Var U=\tfrac1{12}이므로 합은 평균 6, 분산 1이다. 누율은 독립합에서 더해진다(로그 mgf가 더해지므로). UU의 초과첨도가 κ4(U)/σU4=−1.2\kappa_4(U)/\sigma_U^4=-1.2이므로 합의 초과첨도는 12 κ4(U)(12σU2)2=112⋅κ4(U)σU4=−0.1\tfrac{12\,\kappa_4(U)}{(12\sigma_U^2)^2}=\tfrac1{12}\cdot\tfrac{\kappa_4(U)}{\sigma_U^4}=-0.1. 결점: 값이 [−6,6][-6,6] 밖으로 나가지 못하고 꼬리가 얇다(P(∣⋅∣>3)=0.0021P(|\cdot|>3)=0.0021, 정규 0.0027). 난수 12개를 쓰는 것도 비싸다.

연습 3.5 (χ2(r)\chi^2(r)의 정규 극한 ★★) Vr∼χ2(r)V_r\sim\chi^2(r)의 mgf (1−2t)−r/2(1-2t)^{-r/2}으로 Vr−r2r\tfrac{V_r-r}{\sqrt{2r}}의 mgf를 쓰고, r→∞r\to\infty에서 et2/2e^{t^2/2}로 감을 직접 보여라. (힌트: −r2log⁡(1−u)=r2(u+u22+O(u3))-\tfrac r2\log(1-u)=\tfrac r2(u+\tfrac{u^2}2+O(u^3)).)

풀이

M(t)=Eexp⁡(tVr−r2r)=e−tr/2r(1−2t2r)−r/2M(t)=E\exp\bigl(t\tfrac{V_r-r}{\sqrt{2r}}\bigr)=e^{-tr/\sqrt{2r}}\bigl(1-\tfrac{2t}{\sqrt{2r}}\bigr)^{-r/2}. u=2t2ru=\tfrac{2t}{\sqrt{2r}}로 두면 log⁡M=−r2u−r2log⁡(1−u)=r2(u22+O(u3))=r4⋅4t22r+O(r−1/2)=t22+O(r−1/2)\log M=-\tfrac{r}2u-\tfrac r2\log(1-u)=\tfrac r2\bigl(\tfrac{u^2}2+O(u^3)\bigr)=\tfrac r4\cdot\tfrac{4t^2}{2r}+O(r^{-1/2})=\tfrac{t^2}2+O(r^{-1/2}).

연습 3.6 (두 Cauchy의 평균 ★★★) X1,X2X_1,X_2가 iid 표준 Cauchy이면 X1+X2X_1+X_2의 밀도가 2π(4+z2)\tfrac{2}{\pi(4+z^2)}임을 합성곱 ∫dxπ2(1+x2)(1+(z−x)2)\int\tfrac{dx}{\pi^2(1+x^2)(1+(z-x)^2)}으로 보이고, X1+X22\tfrac{X_1+X_2}2가 다시 표준 Cauchy임을 결론지어라. (힌트: 부분분수 분해. 또는 노트북에서 수치적분으로 먼저 확인하라.)

풀이

1(1+x2)(1+(z−x)2)=Ax+B1+x2+C(x−z)+D1+(z−x)2\tfrac1{(1+x^2)(1+(z-x)^2)}=\tfrac{Ax+B}{1+x^2}+\tfrac{C(x-z)+D}{1+(z-x)^2}로 놓고 분자의 계수를 맞추면 (z≠0z\ne0) A=−C=2z(z2+4)A=-C=\tfrac2{z(z^2+4)}, B=D=1z2+4B=D=\tfrac1{z^2+4}이고, Ax/(1+x2)Ax/(1+x^2)과 C(x−z)/(1+(z−x)2)C(x-z)/(1+(z-x)^2)의 적분은 서로 상쇄된다(로그 항의 차가 x→±∞x\to\pm\infty에서 0). 남는 것은 1z2+4(∫dx1+x2+∫dx1+(z−x)2)=2πz2+4\tfrac1{z^2+4}\bigl(\int\tfrac{dx}{1+x^2}+\int\tfrac{dx}{1+(z-x)^2}\bigr)=\tfrac{2\pi}{z^2+4}. π2\pi^2으로 나누면 fX1+X2(z)=2π(4+z2)f_{X_1+X_2}(z)=\tfrac2{\pi(4+z^2)}, 척도 2의 Cauchy다. 2로 나누면(2회 예제 4.5) 밀도 2f(2w)=4π(4+4w2)=1π(1+w2)2f(2w)=\tfrac{4}{\pi(4+4w^2)}=\tfrac1{\pi(1+w^2)}.

이 회차에서 읽은 절 0개 · 회차 차례