
테마
노트북 · 7회 · 극한의 언어
극한의 언어 수렴 · CLT · Monte Carlo
| 강의노트 | 07_limits_notes.pdf — 같은 절 번호, 같은 정리 번호. 증명은 노트에, 확인은 여기에 |
| 워크북 | 07_limits_workbook.pdf — 손으로 푸는 34문항. 다 푼 뒤 맨 끝 10절의 check()로 검산 |
| 자료 | Buffon(1777)의 바늘 · Lazzarini(1901)의 3,408번 · 6회의 범죄자 3,000명 (HistData MacdonellDF) |
| 선수 지식 | 1–6회 (2회 Chebyshev·대수의 법칙·mgf, 5회 Cramér–Wold, 6회 분포) |
여는 질문. 사람의 키, 측정의 오차, 동전 백 번의 앞면 수는 모두 종 모양으로 흩어진다. 왜 그토록 많은 것이 같은 모양인가? 그리고 왜 어떤 것은 그렇지 않은가?
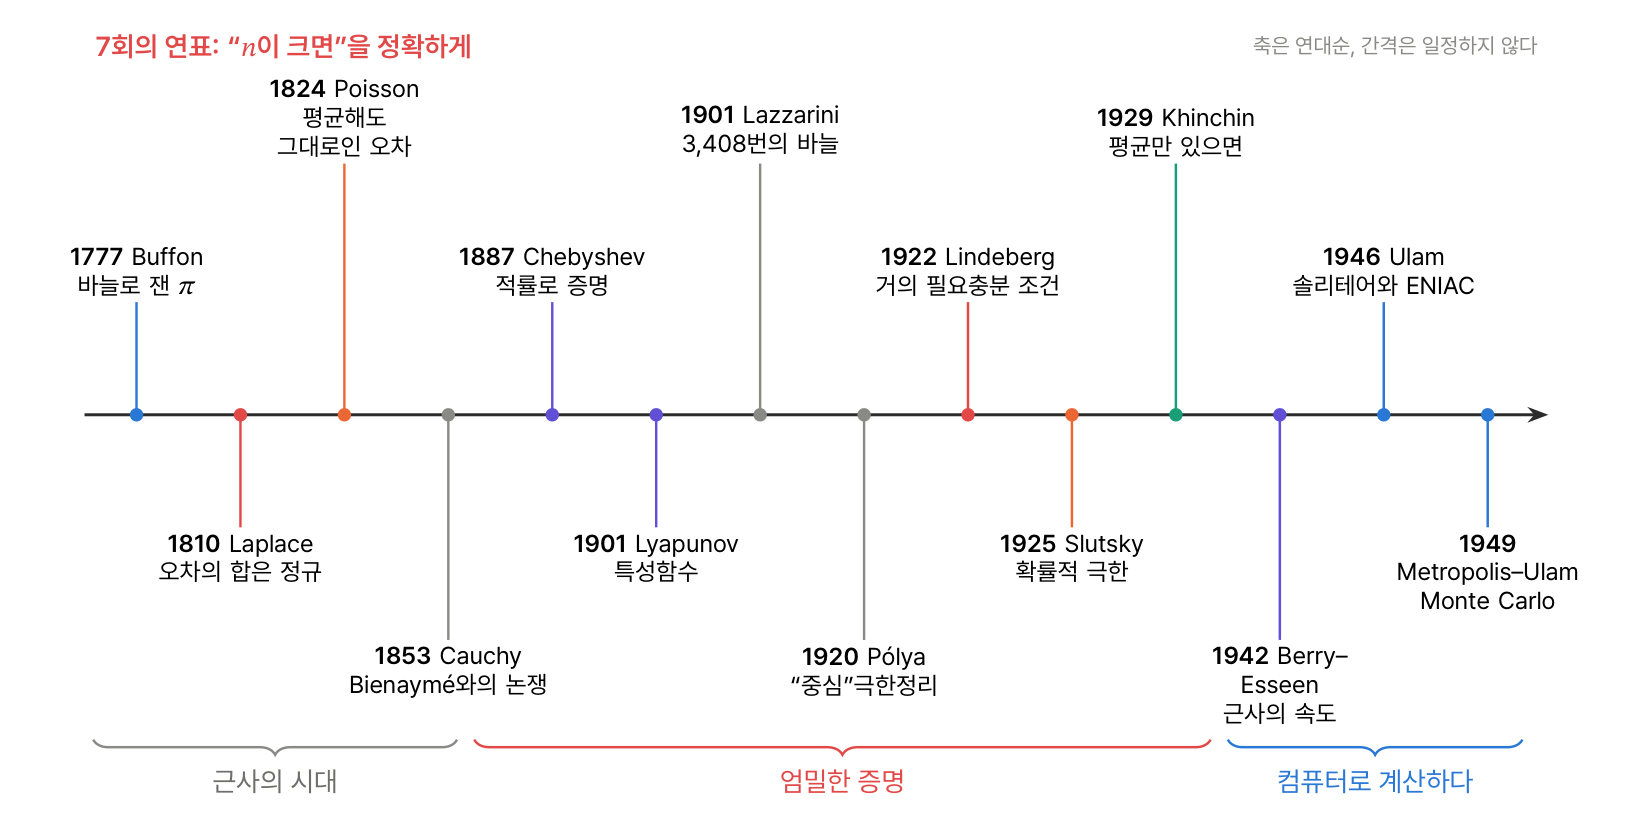
이번 회차의 지도
학습 목표
- Buffon의 바늘을 던져 를 재고, 확률수렴과 연속사상 정리로 그 일치성을, 델타 방법으로 그 오차를 확인한다.
- 분산이 없어도 평균만 있으면 성립하는 Khinchin의 대수의 법칙을 시뮬레이션으로 본다.
- 여러 모집단의 표준화한 합이 정규로 가는 속도를 정확한 분포로 재고 Berry–Esseen 한계와 비교한다. Cauchy만 실패한다.
- Slutsky와 델타 방법(로그 오즈, 분산 안정화, Lazzarini의 의심스러운 )을 계산으로 확인한다.
- Monte Carlo의 신뢰구간, 기각 표집, 중요도 표집, 반대 변량을 구현하고 분산이 무한할 때 무엇이 무너지는지 본다.
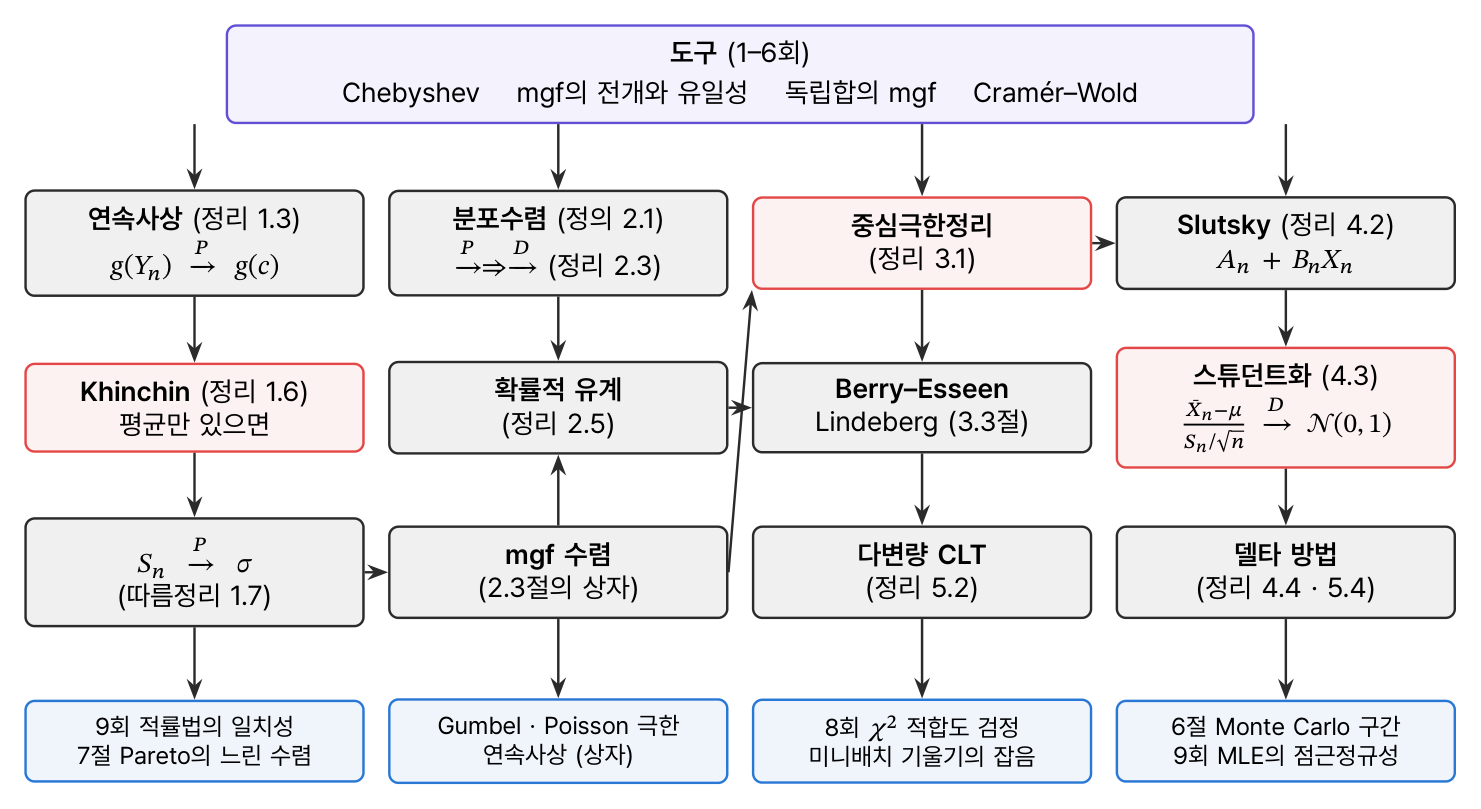
정리 지도
0. 설정
report(checks)는 이론값과 계산값의 대조 결과를 ✓/✗로 찍고, 하나라도 틀리면 멈춘다. 시뮬레이션의 허용오차는 표준오차의 몇 배로 잡았다.
python
%matplotlib inline
import math
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import integrate, special, stats

SEED = 2026
N_SIM = 200_000
rng = np.random.default_rng(SEED)

C = dict(data="#1a9e78", stat="#2a78d6", key="#e34948", assume="#eb6834",
         theta="#6250d6", ink="#2b2b2b", hist="#8a8a86", grid="#e6e6e3")
SERIES = [C["stat"], C["data"], C["key"], C["theta"]]
THEORY = dict(color=C["ink"], ls="--", lw=1.6)
plt.rcParams.update({
    "figure.dpi": 110, "figure.figsize": (8, 4.2), "mathtext.fontset": "stix",
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.grid": True, "grid.color": C["grid"], "grid.linewidth": 0.8,
    "axes.edgecolor": "#9a9a96", "axes.labelcolor": C["ink"],
    "xtick.color": "#52514e", "ytick.color": "#52514e",
    "axes.titleweight": "bold", "axes.titlesize": 11, "axes.titlelocation": "left",
    "legend.frameon": False, "lines.linewidth": 2,
})

RDATASETS = "https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/master/csv/{}/{}.csv"
DATA_DIR = Path("../../data") if Path("../../.git").exists() else Path("data")

def load_rdata(item, package="HistData"):
    path = DATA_DIR / (f"{item}.csv" if package == "HistData" else f"{package}_{item}.csv")
    if not path.exists():
        DATA_DIR.mkdir(parents=True, exist_ok=True)
        pd.read_csv(RDATASETS.format(package, item)).drop(columns="rownames").to_csv(path, index=False)
    return pd.read_csv(path)

def report(checks):
    for name, ok in checks.items():
        print(f"  {'✓' if ok else '✗'}  {name}")
    assert all(checks.values()), "대조 실패"

def within(est, truth, se, k=4):
    """시뮬레이션 추정값이 참값의 k 표준오차 안인가"""
    return abs(est - truth) <= k * se
1. 확률수렴 — Buffon의 바늘과 대수의 법칙
정리 1.1 바늘이 이음매에 걸칠 확률 () · 정리 1.3 연속사상 · 예제 1.5 · 정리 1.6 Khinchin: 이면 · 따름정리 1.7 .
바늘 던지기를 그대로 흉내 낸다. 중심에서 가장 가까운 이음매까지의 거리 와 각 를 뽑고 이면 걸친 것이다.
python
def buffon(n, ell=1.0, d=1.0, rng=rng):
    """바늘 n 개를 던져 걸친 횟수 K 를 돌려준다 (정리 1.1 의 모형)"""
    X = rng.uniform(0, d / 2, n)
    Theta = rng.uniform(0, math.pi / 2, n)
    return int(np.sum(X <= ell / 2 * np.sin(Theta)))

checks = {}
for ell in (1.0, 0.5, 5 / 6):
    K = buffon(N_SIM, ell=ell)
    p = 2 * ell / math.pi
    checks[f"정리 1.1: ℓ/d = {ell:.3f} 에서 K/n ≈ 2ℓ/(πd) = {p:.4f} (4 se 안)"] = within(K / N_SIM, p, math.sqrt(p * (1 - p) / N_SIM))

# 예제 1.5: π̂_n 이 n 과 함께 π 로 모인다 — P(|π̂_n - π| ≥ 0.05)
rows = []
for n in (100, 1000, 10_000):
    Ks = rng.binomial(n, 2 / math.pi, 20_000)          # 바늘 n 개의 걸친 수 (같은 분포를 이항으로 빠르게)
    pih = 2 * n / np.maximum(Ks, 1)
    rows.append(dict(n=n, P_far=np.mean(np.abs(pih - math.pi) >= 0.05), sd=pih.std(), delta_sd=2.37 / math.sqrt(n)))
tab = pd.DataFrame(rows)
print(tab.round(4).to_string(index=False))
checks["예제 1.5: P(|π̂ − π| ≥ 0.05) 가 n 과 함께 줄어든다"] = np.all(np.diff(tab.P_far) < 0) and tab.P_far.iloc[-1] < 0.05
checks["예제 4.6 미리: π̂ 의 표준편차 ≈ 2.37/√n (5% 안)"] = np.allclose(tab.sd, tab.delta_sd, rtol=0.05)
report(checks)
text
    n  P_far     sd  delta_sd
  100 0.8395 0.2464    0.2370
 1000 0.5196 0.0760    0.0749
10000 0.0371 0.0239    0.0237
  ✓  정리 1.1: ℓ/d = 1.000 에서 K/n ≈ 2ℓ/(πd) = 0.6366 (4 se 안)
  ✓  정리 1.1: ℓ/d = 0.500 에서 K/n ≈ 2ℓ/(πd) = 0.3183 (4 se 안)
  ✓  정리 1.1: ℓ/d = 0.833 에서 K/n ≈ 2ℓ/(πd) = 0.5305 (4 se 안)
  ✓  예제 1.5: P(|π̂ − π| ≥ 0.05) 가 n 과 함께 줄어든다
  ✓  예제 4.6 미리: π̂ 의 표준편차 ≈ 2.37/√n (5% 안)
python
# 바늘을 하나씩 던지며 π̂_n 의 경로를 그린다 (로그 눈금에서 고르게 고른 점만)
N = 100_000
nn = np.arange(1, N + 1)
idx = np.unique(np.geomspace(20, N, 2000).astype(int)) - 1
fig, ax = plt.subplots(figsize=(10, 3.6))
for col in SERIES + [C["assume"]]:
    X = rng.uniform(0, 0.5, N); Th = rng.uniform(0, math.pi / 2, N)
    K = np.cumsum(X <= 0.5 * np.sin(Th))
    ax.plot(nn[idx], 2 * nn[idx] / np.maximum(K[idx], 1), color=col, lw=1)
band = 1.96 * 2.37 / np.sqrt(nn[idx])
ax.fill_between(nn[idx], math.pi - band, math.pi + band, color=C["hist"], alpha=0.25, lw=0, label="π ± 1.96·2.37/√n (delta method)")
ax.axhline(math.pi, **THEORY)
ax.set_xscale("log"); ax.set_ylim(2.6, 3.7); ax.set_xlabel("n"); ax.set_ylabel("π̂_n"); ax.legend()
ax.set_title("Buffon's needle: π̂_n converges in probability, at the rate 1/√n")
plt.tight_layout(); plt.show()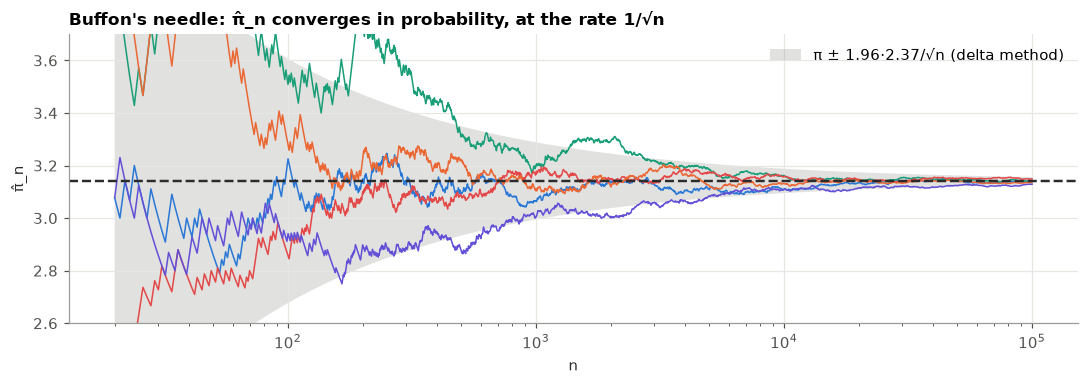
python
# 연습 1.1: Buffon 의 국수 — 길이 ℓ 이 d 보다 길어도 교차 횟수의 평균은 2ℓ/(πd)
def crossings(n, ell, d=1.0):
    """중심의 높이 Y ~ U(0, d) (주기), 각 Θ ~ U(0, π). 양 끝의 높이 사이에 있는 이음매(정수배 d)의 수"""
    Y = rng.uniform(0, d, n); Th = rng.uniform(0, math.pi, n)
    lo, hi = Y - ell / 2 * np.abs(np.sin(Th)), Y + ell / 2 * np.abs(np.sin(Th))
    return np.floor(hi / d) - np.floor(lo / d)

checks = {}
for ell in (0.5, 1.0, 3.0, 10.0):
    N = crossings(N_SIM, ell)
    checks[f"연습 1.1: ℓ = {ell}: E N ≈ 2ℓ/π = {2 * ell / math.pi:.3f} (4 se 안)"] = within(N.mean(), 2 * ell / math.pi, N.std() / math.sqrt(N_SIM))
# 연습 1.3: 확률수렴하지만 기댓값은 1
n = 1000
Y = (rng.random(N_SIM) < 1 / n) * n
checks["연습 1.3: Y_n → 0 (P(Y_n ≠ 0) ≈ 1/n) 이지만 E Y_n ≈ 1"] = abs(np.mean(Y != 0) - 1 / n) < 4 * math.sqrt(1 / n / N_SIM) and abs(Y.mean() - 1) < 0.15
report(checks)
text
  ✓  연습 1.1: ℓ = 0.5: E N ≈ 2ℓ/π = 0.318 (4 se 안)
  ✓  연습 1.1: ℓ = 1.0: E N ≈ 2ℓ/π = 0.637 (4 se 안)
  ✓  연습 1.1: ℓ = 3.0: E N ≈ 2ℓ/π = 1.910 (4 se 안)
  ✓  연습 1.1: ℓ = 10.0: E N ≈ 2ℓ/π = 6.366 (4 se 안)
  ✓  연습 1.3: Y_n → 0 (P(Y_n ≠ 0) ≈ 1/n) 이지만 E Y_n ≈ 1
python
# 정리 1.6 Khinchin · 연습 1.4: 분산이 무한해도 평균이 있으면 수렴한다 — t(2) (μ = 0), Pareto α = 1.5 (μ = 3)
rows = []
for name, gen, mu in [("t(2)", lambda sz: rng.standard_t(2, sz), 0.0),
                      ("Pareto 1.5", lambda sz: rng.pareto(1.5, sz) + 1, 3.0),
                      ("exponential", lambda sz: rng.exponential(1, sz), 1.0)]:
    for n in (100, 10_000):
        reps = 20_000 if n == 100 else 2_000
        xb = gen((reps, n)).mean(axis=1)
        rows.append(dict(population=name, n=n, **{"P(|x̄−μ|>0.1)": np.mean(np.abs(xb - mu) > 0.1)}))
kh = pd.DataFrame(rows).pivot(index="population", columns="n", values="P(|x̄−μ|>0.1)")
print(kh.round(4).to_string())
# 따름정리 1.7: 분산만 유한하면 S_n → σ (t(5): 4차 적률은 무한, 분산 5/3)
s_t5 = {n: rng.standard_t(5, (2_000 if n == 10_000 else 20_000, n)).std(axis=1, ddof=1) for n in (100, 10_000)}
report({"연습 1.4: t(2) 에서 P(|x̄|>0.1) = 0.68 → 0.018 (±0.02)": abs(kh.loc["t(2)", 100] - 0.68) < 0.02 and abs(kh.loc["t(2)", 10_000] - 0.018) < 0.01,
        "정리 1.6: 세 모집단 모두 n 이 커지면 확률이 줄어든다": (kh[10_000] < kh[100]).all(),
        "따름정리 1.7: t(5) 에서 P(|S − σ| > 0.1) 이 줄어든다 (σ = √(5/3))":
            np.mean(np.abs(s_t5[10_000] - math.sqrt(5 / 3)) > 0.1) < np.mean(np.abs(s_t5[100] - math.sqrt(5 / 3)) > 0.1)})
text
n             100     10000
population
Pareto 1.5   0.9020  0.5350
exponential  0.3202  0.0000
t(2)         0.6899  0.0165
text
  ✓  연습 1.4: t(2) 에서 P(|x̄|>0.1) = 0.68 → 0.018 (±0.02)
  ✓  정리 1.6: 세 모집단 모두 n 이 커지면 확률이 줄어든다
  ✓  따름정리 1.7: t(5) 에서 P(|S − σ| > 0.1) 이 줄어든다 (σ = √(5/3))
표 읽기. 세 모집단 모두 평균이 있으므로 대수의 법칙이 성립한다. 그러나 속도가 다르다. 분산이 유한한 지수는 에서 거의 확실히 0.1 안에 있지만, Pareto 는 아직 절반 넘게 밖에 있다. Khinchin은 수렴한다고만 말하고 얼마나 빨리는 말하지 않는다. 7절에서 그 속도()를 본다.
📝 연습 1.1–1.5 (강의노트): Buffon의 국수, 연속이 아니면, 기댓값은 따라오지 않는다, 분산이 없는 표본, 잘라 내기의 부등식.
2. 분포수렴
정의 2.1 극한의 연속점에서 · 예제 2.2 , · 정리 2.3 , 상수로의 · 정리 2.5 분포수렴하면 확률적으로 유계 · 2.3절의 상자: mgf의 수렴.
분포수렴은 분포함수끼리의 거리로 확인한다. 아래의 sup_dist는 격자 위에서 를 잰다(Kolmogorov 거리).
python
def sup_dist(Fn, F, grid):
    return float(np.max(np.abs(Fn(grid) - F(grid))))

x = np.linspace(0, 10, 4001)
rows = []
for n in (2, 5, 50, 500):
    rows.append(dict(n=n,
                     unif_max=sup_dist(lambda t: 1 - np.clip(1 - t / n, 0, None) ** n, lambda t: 1 - np.exp(-t), x),
                     gumbel=sup_dist(lambda t: np.where(t + math.log(n) > 0, (1 - np.exp(-(t + math.log(n)))) ** n, 0.0),
                                     lambda t: np.exp(-np.exp(-t)), np.linspace(-5, 10, 4001)),
                     geom_exp=sup_dist(lambda t: 1 - (1 - 2 / n) ** np.floor(n * t), lambda t: 1 - np.exp(-2 * t), x)))
cd = pd.DataFrame(rows).set_index("n")
print("sup|F_n − F| — 예제 2.2(b), 연습 2.2 (Gumbel), 연습 2.3 (기하 → 지수, λ = 2)\n", cd.round(4).to_string())
# 예제 2.2(b): n = 5 에서 P(n(1-M_n) > 1)
U = rng.random((N_SIM, 5))
p_sim = np.mean(5 * (1 - U.max(axis=1)) > 1)
# 연습 2.2: 지수 n 개의 최댓값 - log n 을 시뮬레이션
Mx = rng.exponential(1, (20_000, 100)).max(axis=1) - math.log(100)
report({"예제 2.2(b): n=5 에서 P(n(1−M_n)>1) ≈ 0.328 (4 se 안)": within(p_sim, 0.8**5, math.sqrt(0.328 * 0.672 / N_SIM)),
        "예제 2.2, 연습 2.2, 2.3: 세 거리가 모두 n 과 함께 0 으로": (cd.diff().dropna() < 0).all().all() and (cd.iloc[-1] < 0.01).all(),
        "연습 2.2: 시뮬레이션한 M_n − log n 과 Gumbel 의 KS 유의확률 > 0.01": stats.kstest(Mx, stats.gumbel_r.cdf).pvalue > 0.01})
text
sup|F_n − F| — 예제 2.2(b), 연습 2.2 (Gumbel), 연습 2.3 (기하 → 지수, λ = 2)
      unif_max  gumbel  geom_exp
n
2      0.1619  0.1619    0.6303
5      0.0580  0.0580    0.3263
50     0.0054  0.0054    0.0344
500    0.0005  0.0005    0.0029
  ✓  예제 2.2(b): n=5 에서 P(n(1−M_n)>1) ≈ 0.328 (4 se 안)
  ✓  예제 2.2, 연습 2.2, 2.3: 세 거리가 모두 n 과 함께 0 으로
  ✓  연습 2.2: 시뮬레이션한 M_n − log n 과 Gumbel 의 KS 유의확률 > 0.01
python
# 정리 2.3 의 주의: 분포수렴은 값이 가까워지는 것이 아니다 (X_n = −Z)
Z = rng.standard_normal(N_SIM)
Xn = -Z
# 연습 2.4: Z_n → N(0,1) 이면 Z_n² → χ²(1) — Z_n 을 표준화한 Poisson(λ) 로
lam = 400
Zn = (rng.poisson(lam, N_SIM) - lam) / math.sqrt(lam)
# 2.3절의 상자 · 예제 2.6(a): b(n, λ/n) 의 mgf → Poi(λ) 의 mgf
t = np.linspace(-1, 1, 21)
mgf_gap = {n: np.max(np.abs((1 + 3 * (np.exp(t) - 1) / n) ** n - np.exp(3 * (np.exp(t) - 1)))) for n in (10, 100, 1000, 10_000)}
print("예제 2.6(a): max_t |M_b(n,3/n)(t) − M_Poi(3)(t)| =", {k: f"{v:.2e}" for k, v in mgf_gap.items()})
report({"정리 2.3 주의: −Z 와 Z 는 분포가 같다 (KS) 그러나 |X_n − Z| = 2|Z| 는 0 이 아니다":
            stats.kstest(Xn[:20_000], "norm").pvalue > 0.01 and np.mean(np.abs(Xn - Z) > 0.5) > 0.6,
        "연습 2.4: Z_n² 와 χ²(1) 의 거리가 작다 (분포함수 차 < 0.03)":
            np.max(np.abs(np.mean(Zn[:, None] ** 2 <= np.array([0.5, 1, 2, 4]), axis=0) - stats.chi2.cdf([0.5, 1, 2, 4], 1))) < 0.03,
        "예제 2.6(a): mgf 의 차가 n 과 함께 0 으로": np.all(np.diff(list(mgf_gap.values())) < 0)})
text
예제 2.6(a): max_t |M_b(n,3/n)(t) − M_Poi(3)(t)| = {10: '1.09e+02', 100: '2.09e+01', 1000: '2.28e+00', 10000: '2.30e-01'}
  ✓  정리 2.3 주의: −Z 와 Z 는 분포가 같다 (KS) 그러나 |X_n − Z| = 2|Z| 는 0 이 아니다
  ✓  연습 2.4: Z_n² 와 χ²(1) 의 거리가 작다 (분포함수 차 < 0.03)
  ✓  예제 2.6(a): mgf 의 차가 n 과 함께 0 으로
📝 연습 2.1–2.5 (강의노트): 최솟값, 지수의 최댓값과 Gumbel, 기다림의 극한, 제곱의 분포수렴, 합은 따라오지 않는다.
3. 중심극한정리
정리 3.1 iid, mgf 존재 · 따름정리 3.2 이항·Poisson· · 예제 3.3 근사의 정확도 · 3.3절의 상자: Lindeberg–Lévy, Lyapunov, Berry–Esseen · 예제 3.4 지수 합의 오차 · 예제 3.5 Cauchy.
증명의 핵심은 이다. 먼저 이것을 수치로 본다. 지수분포를 중심화한 누율생성함수는 이다.
python
psi_exp = lambda s: -np.log1p(-s) - s           # 중심화한 Exp(1) 의 누율생성함수
t = 0.8
rows = []
for n in (1, 10, 100, 1000, 10_000, 1_000_000):
    v = n * psi_exp(t / math.sqrt(n))
    rows.append(dict(n=n, n_psi=v, minus_half_t2=v - t**2 / 2, edgeworth=2 * t**3 / (6 * math.sqrt(n))))
ed = pd.DataFrame(rows)
print(ed.round(6).to_string(index=False))
report({"정리 3.1 증명: n ψ(t/√n) → t²/2 = 0.32": abs(ed.n_psi.iloc[-1] - 0.32) < 1e-3,
        "연습 3.1: 차이 ≈ κ3 t³/(6√n), κ3 = 2 (n ≥ 1000 에서 5% 안)": np.allclose(ed.minus_half_t2.iloc[3:], ed.edgeworth.iloc[3:], rtol=0.05)})
text
      n    n_psi  minus_half_t2  edgeworth
      1 0.809438       0.489438   0.170667
     10 0.386841       0.066841   0.053970
    100 0.338161       0.018161   0.017067
   1000 0.325501       0.005501   0.005397
  10000 0.321717       0.001717   0.001707
1000000 0.320171       0.000171   0.000171
  ✓  정리 3.1 증명: n ψ(t/√n) → t²/2 = 0.32
  ✓  연습 3.1: 차이 ≈ κ3 t³/(6√n), κ3 = 2 (n ≥ 1000 에서 5% 안)
python
# 예제 3.4 · 연습 3.2: 지수 합의 정확한 분포(감마)로 잰 sup|F_n − Φ| 와 Berry–Esseen 상한
rho = integrate.quad(lambda x: abs(x - 1) ** 3 * math.exp(-x), 0, np.inf)[0]
z = np.linspace(-8, 8, 16001)
be = pd.DataFrame([dict(n=n, actual=np.abs(stats.gamma.cdf(n + z * math.sqrt(n), n) - stats.norm.cdf(z)).max(),
                        bound=0.4748 * rho / math.sqrt(n)) for n in (5, 30, 100, 1000)])
be["ratio"] = be.bound / be.actual
print(be.round(4).to_string(index=False))
report({"연습 3.2: E|X−1|³ = 12/e − 2 = 2.415": abs(rho - (12 / math.e - 2)) < 1e-8,
        "예제 3.4: 실제 오차 0.060, 0.024, 0.013 (n = 5, 30, 100)": np.allclose(be.actual[:3], [0.0596, 0.0243, 0.0133], atol=5e-4),
        "예제 3.4: 상한은 언제나 실제보다 크고, 둘 다 1/√n 의 속도": (be.bound > be.actual).all() and np.allclose(be.actual * np.sqrt(be.n), be.actual.iloc[-1] * math.sqrt(1000), rtol=0.15)})
text
   n  actual  bound  ratio
   5  0.0596 0.5127 8.5982
  30  0.0243 0.2093 8.6166
 100  0.0133 0.1146 8.6197
1000  0.0042 0.0363 8.6209
  ✓  연습 3.2: E|X−1|³ = 12/e − 2 = 2.415
  ✓  예제 3.4: 실제 오차 0.060, 0.024, 0.013 (n = 5, 30, 100)
  ✓  예제 3.4: 상한은 언제나 실제보다 크고, 둘 다 1/√n 의 속도
python
# 여러 모집단의 CLT — 정확한 분포 또는 시뮬레이션으로 sup|F_n − Φ| (Kolmogorov 거리)
def kolmogorov_to_normal(sample):
    s = np.sort(sample); m = len(s)
    F = stats.norm.cdf(s)
    return max(np.max(np.arange(1, m + 1) / m - F), np.max(F - np.arange(m) / m))

pops = {"uniform": (lambda sz: rng.random(sz), 0.5, math.sqrt(1 / 12)),
        "exponential": (lambda sz: rng.exponential(1, sz), 1.0, 1.0),
        "Bernoulli(0.1)": (lambda sz: (rng.random(sz) < 0.1).astype(float), 0.1, 0.3),
        "Cauchy": (lambda sz: rng.standard_cauchy(sz), 0.0, 1.0)}
rows = []
for name, (gen, mu, sd) in pops.items():
    for n in (1, 5, 30, 200):
        X = gen((20_000, n))
        Zs = math.sqrt(n) * (X.mean(axis=1) - mu) / sd if name != "Cauchy" else X.mean(axis=1)
        rows.append(dict(population=name, n=n, dist=kolmogorov_to_normal(Zs)))
clt = pd.DataFrame(rows).pivot(index="population", columns="n", values="dist")
print("sup|F_n − Φ| (시뮬레이션 2만 번; 잡음 수준 ≈ 0.01)\n", clt.round(3).to_string())
report({"정리 3.1: 균등·지수는 n = 200 에서 거리 < 0.04": (clt.loc[["uniform", "exponential"], 200] < 0.04).all(),
        "정리 3.1: Bernoulli 는 거리가 줄지만 계단의 반 높이(≈ φ(0)/√(npq))보다 작아지지 못한다":
            np.all(np.diff(clt.loc["Bernoulli(0.1)"]) < 0) and clt.loc["Bernoulli(0.1)", 200] < 1.2 * stats.norm.pdf(0) / math.sqrt(200 * 0.09),
        "예제 3.5: Cauchy 는 n 이 커져도 거리가 그대로 (> 0.05)": (clt.loc["Cauchy"] > 0.05).all()})

fig, axes = plt.subplots(1, 4, figsize=(15, 3.2), sharey=True)
zz = np.linspace(-4, 4, 200)
for ax, (name, (gen, mu, sd)) in zip(axes, pops.items()):
    for n, col in zip((1, 5, 30), SERIES):
        X = gen((50_000, n))
        Zs = math.sqrt(n) * (X.mean(axis=1) - mu) / sd if name != "Cauchy" else X.mean(axis=1)
        ax.hist(Zs[np.abs(Zs) < 4], bins=np.linspace(-4, 4, 41), weights=np.full((np.abs(Zs) < 4).sum(), 1 / (len(Zs) * 0.2)),
                histtype="step", color=col, lw=1.6, label=f"n={n}")
    ax.plot(zz, stats.norm.pdf(zz), **THEORY)
    ax.set_title(name); ax.set_ylim(0, 0.8)
axes[0].legend()
plt.tight_layout(); plt.show()
text
sup|F_n − Φ| (시뮬레이션 2만 번; 잡음 수준 ≈ 0.01)text
 n                 1      5      30     200
population
Bernoulli(0.1)  0.531  0.361  0.142  0.059
Cauchy          0.127  0.127  0.127  0.128
exponential     0.159  0.057  0.023  0.013
uniform         0.062  0.007  0.006  0.006
  ✓  정리 3.1: 균등·지수는 n = 200 에서 거리 < 0.04
  ✓  정리 3.1: Bernoulli 는 거리가 줄지만 계단의 반 높이(≈ φ(0)/√(npq))보다 작아지지 못한다
  ✓  예제 3.5: Cauchy 는 n 이 커져도 거리가 그대로 (> 0.05)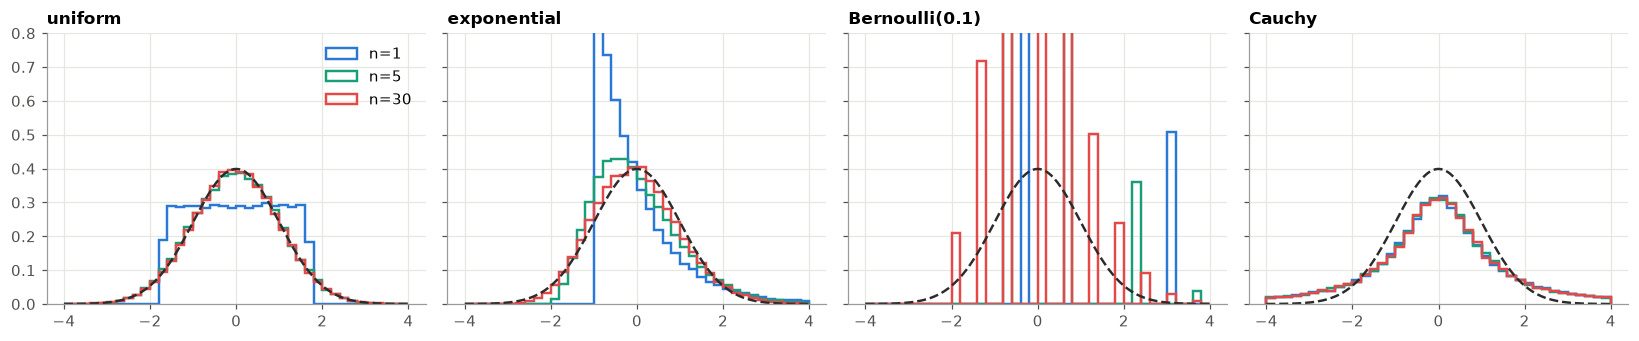
그림 읽기. 대칭인 균등은 에서 이미 점선과 겹친다. 치우친 지수와 Bernoulli$(0.1)$는 에서도 봉우리가 왼쪽으로 기울어 있다(왜도 항 ). Bernoulli의 계단은 이산분포의 흔적이다. Cauchy는 을 바꿔도 같은 곡선이다. 평균을 내도 흩어짐이 줄지 않는다.
python
# 따름정리 3.2 · 예제 3.3: 정규근사의 정확도
acc = pd.DataFrame({
    "exact": [stats.binom.cdf(45, 100, 0.5), stats.poisson.sf(119, 100), stats.chi2.sf(10 + 2 * math.sqrt(20), 10), stats.chi2.sf(100 + 2 * math.sqrt(200), 100)],
    "normal": [stats.norm.cdf(-1), stats.norm.sf(2), stats.norm.sf(2), stats.norm.sf(2)],
    "continuity": [stats.norm.cdf((45.5 - 50) / 5), stats.norm.sf((119.5 - 100) / 10), np.nan, np.nan]},
    index=["b(100,½): P(K≤45)", "Poi(100): P(X≥120)", "χ²(10): P(V>r+2√2r)", "χ²(100): P(V>r+2√2r)"])
print(acc.round(4).to_string())
# 연습 3.3: 확률이 제각각인 동전 400개 — 표준화한 합의 분포함수가 정규와 가깝다 (연속성 보정)
p = rng.uniform(0.05, 0.6, 400)
K = (rng.random((40_000, 400)) < p).sum(axis=1)
sd = math.sqrt((p * (1 - p)).sum())
grid = np.arange(int(p.sum()) - 20, int(p.sum()) + 21)
emp = np.array([np.mean(K <= k) for k in grid])
gap = np.max(np.abs(emp - stats.norm.cdf((grid + 0.5 - p.sum()) / sd)))
# 연습 3.4: 균등 12개
U12 = rng.random((N_SIM, 12)).sum(axis=1) - 6
# 연습 3.6: 두 Cauchy 의 합의 밀도 (수치 합성곱) == 2/(π(4+z²))
conv = lambda zv: integrate.quad(lambda x: 1 / (math.pi**2 * (1 + x * x) * (1 + (zv - x) ** 2)), -np.inf, np.inf)[0]
report({"예제 3.3: 표의 정확한 값 0.1841, 0.0282, 0.0410, 0.0298": np.allclose(acc.exact, [0.1841, 0.0282, 0.0410, 0.0298], atol=1e-4),
        "예제 3.3: 연속성 보정이면 이항은 넷째 자리까지": abs(acc.iloc[0].exact - acc.iloc[0].continuity) < 1e-4,
        "연습 3.3: Poisson-이항 합의 분포함수가 정규(연속성 보정)와 0.01 안": gap < 0.01,
        "연습 3.4: 평균 0, 분산 1, 초과첨도 −0.1, |값| ≤ 6": abs(U12.mean()) < 0.01 and abs(U12.var() - 1) < 0.01 and abs(stats.kurtosis(U12) + 0.1) < 0.03 and np.abs(U12).max() <= 6,
        "연습 3.6: 합성곱 == 2/(π(4+z²)) (z = 0, 1, 3)": all(abs(conv(zv) - 2 / (math.pi * (4 + zv * zv))) < 1e-8 for zv in (0.0, 1.0, 3.0))})
text
                       exact  normal  continuity
b(100,½): P(K≤45)     0.1841  0.1587      0.1841
Poi(100): P(X≥120)    0.0282  0.0228      0.0256
χ²(10): P(V>r+2√2r)   0.0410  0.0228         NaN
χ²(100): P(V>r+2√2r)  0.0298  0.0228         NaN
  ✓  예제 3.3: 표의 정확한 값 0.1841, 0.0282, 0.0410, 0.0298
  ✓  예제 3.3: 연속성 보정이면 이항은 넷째 자리까지
  ✓  연습 3.3: Poisson-이항 합의 분포함수가 정규(연속성 보정)와 0.01 안
  ✓  연습 3.4: 평균 0, 분산 1, 초과첨도 −0.1, |값| ≤ 6
  ✓  연습 3.6: 합성곱 == 2/(π(4+z²)) (z = 0, 1, 3)
📝 연습 3.1–3.6 (강의노트): 누율과 수렴 속도, 지수분포의 3차 절대적률, 확률이 다른 동전들, 균등 12개, 의 정규 극한, 두 Cauchy의 평균.
4. Slutsky의 정리와 델타 방법
보조정리 4.1 , · 정리 4.2 Slutsky · 따름정리 4.3 · 정리 4.4 델타 방법 · 예제 4.5 로그 오즈 · 예제 4.6 Buffon의 · 예제 4.7 분산 안정화.
python
# 따름정리 4.3: 지수 모집단에서 x̄ ± 1.96 s/√n 의 포함확률 → 0.95
rows = []
for n in (30, 200, 1000):
    X = rng.exponential(1, (40_000, n))
    T = (X.mean(axis=1) - 1) / (X.std(axis=1, ddof=1) / math.sqrt(n))
    rows.append(dict(n=n, cover_z=np.mean(np.abs(T) <= 1.96), cover_t=np.mean(np.abs(T) <= stats.t.ppf(0.975, n - 1))))
st = pd.DataFrame(rows)
print(st.round(4).to_string(index=False))
report({"따름정리 4.3: 포함확률 0.919, 0.945, 0.948 (±0.006)": np.allclose(st.cover_z, [0.919, 0.945, 0.948], atol=0.006),
        "따름정리 4.3: t 분위수를 써도 같은 극한": abs(st.cover_t.iloc[-1] - 0.95) < 0.006})
text
   n  cover_z  cover_t
  30   0.9144   0.9246
 200   0.9430   0.9444
1000   0.9490   0.9494
  ✓  따름정리 4.3: 포함확률 0.919, 0.945, 0.948 (±0.006)
  ✓  따름정리 4.3: t 분위수를 써도 같은 극한
python
def delta_se(g_prime, theta, sigma, n):
    """정리 4.4: g(Y_n) 의 근사 표준오차 |g'(θ)| σ/√n"""
    return abs(g_prime(theta)) * sigma / math.sqrt(n)

# 예제 4.5: 로그 오즈, p = 0.2, n = 50
p, n = 0.2, 50
K = rng.binomial(n, p, 400_000)
ok = (K > 0) & (K < n)
logit = np.log(K[ok] / (n - K[ok]))
se_d = delta_se(lambda q: 1 / (q * (1 - q)), p, math.sqrt(p * (1 - p)), n)
# 예제 4.6 · 연습 4.3: Buffon 의 π̂ 의 표준편차 (r = ℓ/d)
def buffon_sd(r, n):
    q = 2 * r / math.pi
    return math.pi * math.sqrt((1 - q) / q) / math.sqrt(n)
# 연습 4.1: √n log X̄ → N(0,1) (지수)
L = math.sqrt(400) * np.log(rng.exponential(1, (40_000, 400)).mean(axis=1))
print(f"예제 4.5: Var logit(p̂) = {logit.var():.4f}, 델타 방법 {se_d**2:.4f}, P(p̂ ∈ {{0,1}}) = {1 - ok.mean():.1e}")
print(f"예제 4.6: sd(π̂) — r = 1: {buffon_sd(1, 1):.3f}/√n,  r = 5/6: {buffon_sd(5 / 6, 1):.3f}/√n (비 {buffon_sd(5 / 6, 1) / buffon_sd(1, 1):.3f})")
print(f"         소수 셋째 자리(sd 0.0005)에 필요한 n ≈ {(buffon_sd(1, 1) / 0.0005) ** 2:.2e}")
report({"예제 4.5: Var logit(p̂) = 0.143 vs 델타 0.125": abs(logit.var() - 0.1426) < 0.003 and abs(se_d**2 - 0.125) < 1e-12,
        "예제 4.6: r = 1 의 상수 2.37, 연습 4.3: r = 5/6 은 2.96 (1.25배)": abs(buffon_sd(1, 1) - 2.374) < 1e-3 and abs(buffon_sd(5 / 6, 1) - 2.956) < 1e-3,
        "연습 4.3: 점근분산 π²(1−p)/p 는 r 에 대해 감소": np.all(np.diff([buffon_sd(r, 1) for r in np.linspace(0.1, 1, 10)]) < 0),
        "연습 4.1: √n log X̄ 의 평균 ≈ 0, 분산 ≈ 1": abs(L.mean()) < 0.05 and abs(L.var() - 1) < 0.03})
text
예제 4.5: Var logit(p̂) = 0.1419, 델타 방법 0.1250, P(p̂ ∈ {0,1}) = 2.3e-05
예제 4.6: sd(π̂) — r = 1: 2.374/√n,  r = 5/6: 2.955/√n (비 1.245)
         소수 셋째 자리(sd 0.0005)에 필요한 n ≈ 2.25e+07
  ✓  예제 4.5: Var logit(p̂) = 0.143 vs 델타 0.125
  ✓  예제 4.6: r = 1 의 상수 2.37, 연습 4.3: r = 5/6 은 2.96 (1.25배)
  ✓  연습 4.3: 점근분산 π²(1−p)/p 는 r 에 대해 감소
  ✓  연습 4.1: √n log X̄ 의 평균 ≈ 0, 분산 ≈ 1
python
fig, axes = plt.subplots(1, 2, figsize=(12, 3.6))
zl = (logit - math.log(p / (1 - p))) / se_d
zz = np.linspace(-4, 4, 200)
zs = np.sort(zl)
axes[0].step(zs[::200], np.arange(1, len(zs) + 1)[::200] / len(zs), where="post", color=C["data"], label="simulated (lattice)")
axes[0].plot(zz, stats.norm.cdf(zz), **THEORY, label="Φ")
axes[0].legend(); axes[0].set_title("cdf of standardized log-odds, p = 0.2, n = 50")
ps = np.linspace(0.02, 0.98, 49)
v_raw = [100 * (rng.binomial(100, q_, 20_000) / 100).var() for q_ in ps]
v_vst = [400 * np.arcsin(np.sqrt(rng.binomial(100, q_, 20_000) / 100)).var() for q_ in ps]
axes[1].plot(ps, np.array(v_raw) / 0.25, color=C["stat"], label="n·Var p̂ / 0.25")
axes[1].plot(ps, v_vst, color=C["key"], label="4n·Var arcsin√p̂")
axes[1].axhline(1, **THEORY); axes[1].set_xlabel("p"); axes[1].legend(); axes[1].set_title("variance stabilization (n = 100)")
plt.tight_layout(); plt.show()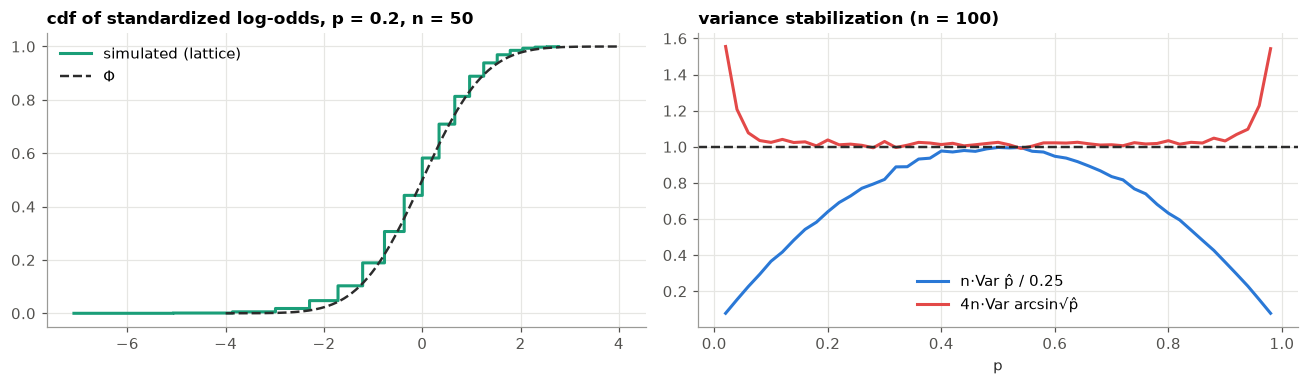
그림 읽기. 왼쪽: 로그 오즈의 분포함수는 가 의 값만 가지므로 계단이지만, 계단의 중심이 를 따라간다. 오른쪽: 의 분산은 에 따라 0에서 최대까지 변하지만 의 분산은 가운데에서 거의 평평하다. 양 끝()에서는 이 아직 작아 근사가 무너진다.
Lazzarini(1901)는 정말 바늘을 던졌을까
, , 이면 다. 델타 방법의 표준편차는 0.051이다. 이 에서 기대 교차 수와 일 확률을 구하고, "355/113이 나오면 멈춘다"는 전략(연습 4.4)을 시뮬레이션한다.
python
r = 5 / 6; q = 2 * r / math.pi
nL, KL = 3408, 1808
pi_L = 2 * r * nL / KL
print(f"π̂ = {pi_L:.7f}, 오차 {pi_L - math.pi:.2e}, 표준편차 {buffon_sd(r, nL):.4f} → 오차/표준편차 = 1/{buffon_sd(r, nL) / (pi_L - math.pi):,.0f}")
print(f"E K = {nL * q:.4f},  P(K = 1808) = {stats.binom.pmf(KL, nL, q):.4f}")

# 연습 4.4: 213 의 배수 n 마다 K_n/n == 113/213 인지 보고, 처음 맞으면 멈춘다 (n ≤ 5000)
g = np.random.default_rng(1901)
reps, Nmax = 20_000, 5000
K = np.cumsum(g.random((reps, Nmax)) < q, axis=1)
stopped = np.zeros(reps, bool); stop_at = np.full(reps, -1)
for nn in range(213, Nmax + 1, 213):
    hit = (K[:, nn - 1] == 113 * nn // 213) & ~stopped
    stop_at[hit] = nn; stopped |= hit
print(f"연습 4.4: n ≤ 5000 안에 멈출 확률 {stopped.mean():.3f}, 멈춘 n 의 중앙값 {np.median(stop_at[stopped]):.0f}")
report({"Lazzarini: E K = 1808.0, P(K=1808) = 0.014": abs(nL * q - 1808) < 0.01 and abs(stats.binom.pmf(KL, nL, q) - 0.0137) < 2e-4,
        "Lazzarini: 오차는 표준편차의 약 19만분의 1": 1.7e5 < buffon_sd(r, nL) / (pi_L - math.pi) < 2.1e5,
        "연습 4.4: 멈출 확률 ≈ 0.34 (±0.02)": abs(stopped.mean() - 0.337) < 0.02})
text
π̂ = 3.1415929, 오차 2.67e-07, 표준편차 0.0506 → 오차/표준편차 = 1/189,773
E K = 1808.0002,  P(K = 1808) = 0.0137
text
연습 4.4: n ≤ 5000 안에 멈출 확률 0.337, 멈춘 n 의 중앙값 1278
  ✓  Lazzarini: E K = 1808.0, P(K=1808) = 0.014
  ✓  Lazzarini: 오차는 표준편차의 약 19만분의 1
  ✓  연습 4.4: 멈출 확률 ≈ 0.34 (±0.02)
python
# 예제 4.7 · 연습 4.5: 분산 안정화
vst = pd.DataFrame({
    "4n Var arcsin√p̂ (n=100)": {p_: 400 * np.arcsin(np.sqrt(rng.binomial(100, p_, 400_000) / 100)).var() for p_ in (0.05, 0.2, 0.5)},
    "n Var p̂ (n=100)": {p_: 100 * (rng.binomial(100, p_, 400_000) / 100).var() for p_ in (0.05, 0.2, 0.5)}})
print(vst.round(3).to_string())
sq = {lam: np.sqrt(rng.poisson(lam, 400_000)).var() for lam in (2, 10, 100)}
print("Var √X (Poisson):", {k: round(float(v), 3) for k, v in sq.items()}, " → 1/4")
# 연습 4.2: g'(θ) = 0 — μ = 0 이면 n X̄² → σ² χ²(1)
X = rng.exponential(1, (100_000, 200)) - 1
v = 200 * X.mean(axis=1) ** 2
report({"예제 4.7: arcsin 변환의 4n Var 는 p 와 거의 무관 (1.14, 1.02, 1.01)": np.allclose(vst.iloc[:, 0], [1.14, 1.02, 1.01], atol=0.02),
        "예제 4.7: Var √X → 1/4 (0.39, 0.26, 0.25)": np.allclose(list(sq.values()), [0.390, 0.262, 0.251], atol=0.006),
        "연습 4.2: n X̄² 의 평균 ≈ 1, P(> 3.84) ≈ 0.05": abs(v.mean() - 1) < 0.02 and abs(np.mean(v > 3.841) - 0.05) < 0.003})
text
      4n Var arcsin√p̂ (n=100)  n Var p̂ (n=100)
0.05                     1.133             0.047
0.20                     1.012             0.160
0.50                     1.012             0.251
Var √X (Poisson): {2: 0.39, 10: 0.261, 100: 0.251}  → 1/4
text
  ✓  예제 4.7: arcsin 변환의 4n Var 는 p 와 거의 무관 (1.14, 1.02, 1.01)
  ✓  예제 4.7: Var √X → 1/4 (0.39, 0.26, 0.25)
  ✓  연습 4.2: n X̄² 의 평균 ≈ 1, P(> 3.84) ≈ 0.05
📝 연습 4.1–4.6 (강의노트): 로그 평균, 2차 델타 방법, 가장 좋은 바늘, 원하는 답이 나올 때 멈추기, 두 변환, Slutsky의 함정.
5. 다변량으로 — 선형결합 하나면 된다
정리 5.2 · 예제 5.3 다항분포, · 정리 5.4 다변량 델타 방법 · 예제 5.5 .
python
# 예제 5.3 · 연습 5.1: 원핫 벡터와 다항분포
pv = np.array([0.5, 0.3, 0.2]); k = 3; n = 200
onehot = np.eye(k)[rng.choice(k, size=50_000, p=pv)]
Sig_p = np.diag(pv) - np.outer(pv, pv)
Nm = rng.multinomial(n, pv, 50_000)
Zv = np.sqrt(n) * (Nm / n - pv)
# 정리 5.2 증명의 방향: 아무 방향 t 에서 t'Z 가 N(0, t'Σt)
tdir = np.array([1.0, -2.0, 0.5])
proj = Zv @ tdir
# 95% 타원 안의 비율 (처음 두 성분, χ²(2) 분위수)
S2 = Sig_p[:2, :2]
d2 = np.einsum("ij,jk,ik->i", Zv[:, :2], np.linalg.inv(S2), Zv[:, :2])
X2 = (((Nm - n * pv) ** 2) / (n * pv)).sum(axis=1)
report({"연습 5.1: 원핫 벡터의 공분산 == diag(p) − pp' (±0.005)": np.allclose(np.cov(onehot.T), Sig_p, atol=0.005),
        "연습 5.1: Σ_p 의 계수 = k − 1 = 2": np.linalg.matrix_rank(Sig_p) == 2 and np.allclose(Sig_p @ np.ones(k), 0),
        "정리 5.2: t'Z 의 분산 ≈ t'Σt (2% 안)": abs(proj.var() / (tdir @ Sig_p @ tdir) - 1) < 0.02,
        "예제 5.3: 정규 타원 안의 비율 ≈ 0.95 (±0.006)": abs(np.mean(d2 <= stats.chi2.ppf(0.95, 2)) - 0.95) < 0.006,
        "5.1절 끝: Pearson 의 X² 의 평균 ≈ k−1 = 2, P(X² > χ²_{2,0.05}) ≈ 0.05": abs(X2.mean() - 2) < 0.03 and abs(np.mean(X2 > stats.chi2.ppf(0.95, 2)) - 0.05) < 0.004})
text
  ✓  연습 5.1: 원핫 벡터의 공분산 == diag(p) − pp' (±0.005)
  ✓  연습 5.1: Σ_p 의 계수 = k − 1 = 2
  ✓  정리 5.2: t'Z 의 분산 ≈ t'Σt (2% 안)
  ✓  예제 5.3: 정규 타원 안의 비율 ≈ 0.95 (±0.006)
  ✓  5.1절 끝: Pearson 의 X² 의 평균 ≈ k−1 = 2, P(X² > χ²_{2,0.05}) ≈ 0.05
python
def mdelta_var(grad, Sigma):
    """정리 5.4: 점근분산 ∇g' Σ ∇g"""
    grad = np.asarray(grad, float)
    return float(grad @ Sigma @ grad)

# 예제 5.5: √n (S² − σ²) 의 분산 = μ4 − σ⁴ — 지수 (9 − 1 = 8), 정규 (2)
checks = {}
for name, gen, theory in [("exponential", lambda sz: rng.exponential(1, sz), 8.0), ("normal", lambda sz: rng.standard_normal(sz), 2.0)]:
    s2 = gen((40_000, 400)).var(axis=1, ddof=1)
    checks[f"예제 5.5: {name} 에서 n Var S² ≈ μ4 − σ⁴ = {theory:g} (3% 안)"] = abs(400 * s2.var() / theory - 1) < 0.03
# 연습 5.2: 비율 추정량
mx, my, sx, sy, rxy, n = 2.0, 3.0, 1.0, 1.5, 0.6, 400
cov = np.array([[sx**2, rxy * sx * sy], [rxy * sx * sy, sy**2]])
XY = np.random.default_rng(52).multivariate_normal([mx, my], cov, (20_000, n))
Rh = XY[:, :, 1].mean(axis=1) / XY[:, :, 0].mean(axis=1)
R = my / mx
th_ratio = mdelta_var([-R / mx, 1 / mx], cov)
checks["연습 5.2: n Var R̂ ≈ (σ_Y² − 2Rσ_XY + R²σ_X²)/μ_X² = 0.45 (5% 안)"] = abs(n * Rh.var() / th_ratio - 1) < 0.05 and abs(th_ratio - 0.45) < 1e-12
# 연습 5.4: 정규 표본의 변동계수 S/X̄, c = σ/μ = 0.25
mu, sig, n = 4.0, 1.0, 300
Xn = rng.normal(mu, sig, (20_000, n))
cvh = Xn.std(axis=1, ddof=1) / Xn.mean(axis=1)
c = sig / mu
checks["연습 5.4: n Var(S/X̄) ≈ c²/2 + c⁴ (5% 안)"] = abs(n * cvh.var() / (c**2 / 2 + c**4) - 1) < 0.05
# 연습 5.3: Fisher 의 z — 이변량 정규에서 artanh(r) 의 n·분산 ≈ 1 (ρ 와 무관)
for rho_ in (0.0, 0.5, 0.9):
    n = 200
    Z1 = rng.standard_normal((5_000, n)); Z2 = rho_ * Z1 + math.sqrt(1 - rho_**2) * rng.standard_normal((5_000, n))
    Z1c = Z1 - Z1.mean(axis=1, keepdims=True); Z2c = Z2 - Z2.mean(axis=1, keepdims=True)
    r_ = (Z1c * Z2c).sum(axis=1) / np.sqrt((Z1c**2).sum(axis=1) * (Z2c**2).sum(axis=1))
    checks[f"연습 5.3: ρ = {rho_}: n Var artanh(r) ≈ 1 (8% 안)"] = abs(n * np.arctanh(r_).var() - 1) < 0.08
report(checks)
text
  ✓  예제 5.5: exponential 에서 n Var S² ≈ μ4 − σ⁴ = 8 (3% 안)
  ✓  예제 5.5: normal 에서 n Var S² ≈ μ4 − σ⁴ = 2 (3% 안)
  ✓  연습 5.2: n Var R̂ ≈ (σ_Y² − 2Rσ_XY + R²σ_X²)/μ_X² = 0.45 (5% 안)
  ✓  연습 5.4: n Var(S/X̄) ≈ c²/2 + c⁴ (5% 안)
  ✓  연습 5.3: ρ = 0.0: n Var artanh(r) ≈ 1 (8% 안)
  ✓  연습 5.3: ρ = 0.5: n Var artanh(r) ≈ 1 (8% 안)
  ✓  연습 5.3: ρ = 0.9: n Var artanh(r) ≈ 1 (8% 안)
📝 연습 5.1–5.4 (강의노트): 원핫 벡터의 공분산, 비율 추정량, Fisher의 , 변동계수.
6. 계산으로 — Monte Carlo (1946 → 1949)
정리 6.1 · 예제 6.2 Chebyshev 대신 CLT · 알고리즘 6.3 · 정리 6.4 기각 표집 · 예제 6.5 지수로 정규 만들기 · 정리 6.6 중요도 표집 · 예제 6.7 · 예제 6.8 반대 변량.
Monte Carlo 추정량을 하나의 함수로 만든다. 추정값, 표준오차, 구간을 함께 돌려준다.
python
def mc_estimate(h_values, conf=0.95):
    """정리 6.1: 추정값, 표준오차, 근사 신뢰구간"""
    h_values = np.asarray(h_values, float)
    n = len(h_values); est = h_values.mean(); se = h_values.std(ddof=1) / math.sqrt(n)
    z = stats.norm.ppf(0.5 + conf / 2)
    return dict(est=est, se=se, lo=est - z * se, hi=est + z * se)

I_true = integrate.quad(lambda x: math.exp(x * x), 0, 1)[0]
sig2 = integrate.quad(lambda x: math.exp(2 * x * x), 0, 1)[0] - I_true**2
print("한 번의 추정 (n = 10,000):", {k: round(float(v), 4) for k, v in mc_estimate(np.exp(rng.random(10_000) ** 2)).items()}, " 참값", round(I_true, 4))
# 정리 6.1(b): 구간의 포함확률 (n = 1,000, 4,000번 반복)
U = rng.random((4_000, 1_000))
H = np.exp(U**2)
est, se = H.mean(axis=1), H.std(axis=1, ddof=1) / math.sqrt(1000)
cover = np.mean(np.abs(est - I_true) <= 1.96 * se)
n_clt = (stats.norm.ppf(0.995) * math.sqrt(sig2) / 0.01) ** 2
n_cheb = sig2 / (0.01**2 * 0.01)
# 연습 6.1: 원으로 잰 π
Q = 4 * (rng.random(10_000) ** 2 + rng.random(10_000) ** 2 <= 1)
print(f"예제 6.2: CLT 로 n ≈ {n_clt:,.0f}, Chebyshev 로 n ≥ {n_cheb:,.0f} (비 {n_cheb / n_clt:.1f})")
report({"정리 6.1: 구간의 포함확률 ≈ 0.95 (±0.01)": abs(cover - 0.95) < 0.01,
        "예제 6.2: σ_h² = 0.2251, CLT n ≈ 1.49×10⁴, Chebyshev 2.25×10⁵": abs(sig2 - 0.2251) < 1e-4 and abs(n_clt - 14_935) < 10 and abs(n_cheb - 225_104) < 10,
        "연습 6.1: 원으로 잰 π 의 표준오차 ≈ 0.016": abs(mc_estimate(Q)["se"] - 0.0164) < 0.001})
text
한 번의 추정 (n = 10,000): {'est': 1.4559, 'se': 0.0047, 'lo': 1.4466, 'hi': 1.4651}  참값 1.4627
예제 6.2: CLT 로 n ≈ 14,935, Chebyshev 로 n ≥ 225,104 (비 15.1)
  ✓  정리 6.1: 구간의 포함확률 ≈ 0.95 (±0.01)
  ✓  예제 6.2: σ_h² = 0.2251, CLT n ≈ 1.49×10⁴, Chebyshev 2.25×10⁵
  ✓  연습 6.1: 원으로 잰 π 의 표준오차 ≈ 0.016
python
class RejectionSampler:
    """알고리즘 6.3: f ≤ M g 일 때 g 에서 뽑아 확률 f/(Mg) 로 받아들인다"""
    def __init__(self, f, g_sample, g_pdf, M):
        self.f, self.g_sample, self.g_pdf, self.M = f, g_sample, g_pdf, M
        self.tries = self.accepted = 0

    def sample(self, n):
        out = []
        while sum(len(o) for o in out) < n:
            m = int(1.2 * self.M * n) + 10
            Y = self.g_sample(m); U = rng.random(m)
            self.tries += m
            keep = Y[U <= self.f(Y) / (self.M * self.g_pdf(Y))]
            self.accepted += len(keep)
            out.append(keep)
        return np.concatenate(out)[:n]

# 예제 6.5: 반정규를 Exp(1) 로 덮고, 무작위 부호로 N(0,1)
half = RejectionSampler(f=lambda y: math.sqrt(2 / math.pi) * np.exp(-y**2 / 2),
                        g_sample=lambda m: -np.log(rng.random(m)),        # 2회 정리 4.7: 지수 난수
                        g_pdf=lambda y: np.exp(-y), M=math.sqrt(2 * math.e / math.pi))
Hn = half.sample(100_000)
Zr = Hn * rng.choice([-1.0, 1.0], len(Hn))
acc_rate = half.accepted / half.tries
# 연습 6.3: Beta(2.7, 6.3) 을 균등으로
a, b = 2.7, 6.3
Mb = stats.beta.pdf((a - 1) / (a + b - 2), a, b)
beta_s = RejectionSampler(lambda y: stats.beta.pdf(y, a, b), lambda m: rng.random(m), lambda y: np.ones_like(y), Mb)
Bs = beta_s.sample(50_000)
# 연습 6.2: 받아들이는 조건
yy = np.linspace(0, 5, 50)
ratio = (math.sqrt(2 / math.pi) * np.exp(-yy**2 / 2)) / (math.sqrt(2 * math.e / math.pi) * np.exp(-yy))
report({"예제 6.5: M = √(2e/π) = 1.3155, 받아들일 확률 ≈ 1/M = 0.760 (±0.01)": abs(half.M - 1.3155) < 1e-4 and abs(acc_rate - 0.760) < 0.01,
        "정리 6.4: 부호를 붙인 값과 N(0,1) 의 KS 유의확률 > 0.01": stats.kstest(Zr[:20_000], "norm").pvalue > 0.01,
        "연습 6.2: f/(Mg) == exp(−(y−1)²/2)": np.allclose(ratio, np.exp(-(yy - 1) ** 2 / 2)),
        "연습 6.3: M = 2.67, 받아들일 확률 0.375, 표본과 Beta(2.7,6.3) 의 KS > 0.01":
            abs(Mb - 2.6697) < 1e-3 and abs(beta_s.accepted / beta_s.tries - 0.375) < 0.01 and stats.kstest(Bs[:20_000], stats.beta(a, b).cdf).pvalue > 0.01})
text
  ✓  예제 6.5: M = √(2e/π) = 1.3155, 받아들일 확률 ≈ 1/M = 0.760 (±0.01)
  ✓  정리 6.4: 부호를 붙인 값과 N(0,1) 의 KS 유의확률 > 0.01
  ✓  연습 6.2: f/(Mg) == exp(−(y−1)²/2)
  ✓  연습 6.3: M = 2.67, 받아들일 확률 0.375, 표본과 Beta(2.7,6.3) 의 KS > 0.01
python
# 정리 6.6 · 예제 6.7: P(Z > 4) — 보통의 Monte Carlo 와 중요도 표집 (제안분포 N(4, 1))
theta = stats.norm.sf(4)
n = 10_000
plain = (rng.standard_normal((500, n)) > 4).mean(axis=1)
Y = rng.normal(4, 1, (500, n))
w = np.exp(-4 * Y + 8)                     # φ(y)/φ(y−4)
isamp = ((Y > 4) * w).mean(axis=1)
var_is = integrate.quad(lambda y: math.exp(-4 * y + 8) ** 2 * stats.norm.pdf(y - 4), 4, np.inf)[0] - theta**2
print(f"θ = {theta:.4e}")
print(f"보통 MC (n = 10⁴): 추정값이 0 인 비율 {np.mean(plain == 0):.2f}, 상대 표준편차 {plain.std() / theta:.2f} (이론 {math.sqrt((1 - theta) / (n * theta)):.2f})")
print(f"중요도 표집 (n = 10⁴): 평균/θ = {isamp.mean() / theta:.4f}, 상대 표준편차 {isamp.std() / theta:.4f} (이론 {math.sqrt(var_is / n) / theta:.4f})")
# 연습 6.4: 제안분포의 꼬리가 얇으면 — N(0, τ²) 로 E Z² 를 추정
def is_second_moment(tau, m=200_000):
    Yt = rng.normal(0, tau, m)
    wt = stats.norm.pdf(Yt) / stats.norm.pdf(Yt, scale=tau)
    return Yt**2 * wt
fat, thin = is_second_moment(1.5), is_second_moment(0.6)
# 예제 6.8 · 연습 6.5: 반대 변량
U = rng.random(N_SIM)
pairs = 0.5 * (np.exp(U**2) + np.exp((1 - U) ** 2))
report({"예제 6.7: 보통 MC 는 대개 0 (비율 > 0.6), 상대 표준편차 ≈ 1.78": np.mean(plain == 0) > 0.6 and abs(plain.std() / theta - 1.78) < 0.15,
        "정리 6.6: 중요도 표집은 불편이고 상대 표준편차 ≈ 0.021": abs(isamp.mean() / theta - 1) < 0.005 and abs(isamp.std() / theta - 0.0212) < 0.003,
        "예제 6.7: 한 표본의 분산비 θ(1−θ)/Var_IS ≈ 7,000": 6_500 < theta * (1 - theta) / var_is < 7_500,
        "연습 6.4: τ = 1.5 는 표본분산이 안정, τ = 0.6 (τ² < 1/2) 은 최댓값이 평균을 지배": fat.max() / fat.sum() < 0.01 and thin.max() / thin.sum() > fat.max() / fat.sum(),
        "예제 6.8: 반대 변량 쌍의 분산 0.0280 vs 독립 두 개 0.1126 (4.0배)": abs(pairs.var() - 0.0280) < 0.001 and abs(sig2 / 2 / pairs.var() - 4.03) < 0.15})
text
θ = 3.1671e-05text
보통 MC (n = 10⁴): 추정값이 0 인 비율 0.75, 상대 표준편차 1.78 (이론 1.78)
중요도 표집 (n = 10⁴): 평균/θ = 0.9996, 상대 표준편차 0.0214 (이론 0.0212)
text
  ✓  예제 6.7: 보통 MC 는 대개 0 (비율 > 0.6), 상대 표준편차 ≈ 1.78
  ✓  정리 6.6: 중요도 표집은 불편이고 상대 표준편차 ≈ 0.021
  ✓  예제 6.7: 한 표본의 분산비 θ(1−θ)/Var_IS ≈ 7,000
  ✓  연습 6.4: τ = 1.5 는 표본분산이 안정, τ = 0.6 (τ² < 1/2) 은 최댓값이 평균을 지배
  ✓  예제 6.8: 반대 변량 쌍의 분산 0.0280 vs 독립 두 개 0.1126 (4.0배)
연습 6.4 읽기. 꼬리가 얇은 제안분포에서는 가중치 가 꼬리에서 폭발해, 드물게 나오는 한 표본이 합 전체를 지배한다. 분산이 무한한 추정량은 평균은 맞아도(불편) 그 평균에 다가가는 속도를 말할 수 없다. 7절의 Pareto와 같은 병이다.
📝 연습 6.1–6.5 (강의노트): 원으로 잰 , 받아들이는 조건, 베타 난수, 두꺼운 꼬리가 필요하다, 반대 변량의 분산.
7. 부숴보기 — 분산이 무한하고, 꼬리를 물을 때
예제 7.1 Pareto 의 평균 · 7.1절의 상자: 안정분포와 · 7.2절: Cauchy의 중앙값 · 예제 7.2 꼬리의 상대오차.
python
# 예제 7.1 · 연습 7.1: Pareto α = 1.5 (X = U^(−1/α), 평균 3, 분산 무한)
alpha = 1.5
Xp = rng.random(1_000_000) ** (-1 / alpha)
rows = []
for n, reps in ((100, 20_000), (1000, 5_000), (10_000, 1_000)):
    X = rng.random((reps, n)) ** (-1 / alpha)
    xb, s = X.mean(axis=1), X.std(axis=1, ddof=1)
    T = (xb - 3) / (s / math.sqrt(n))
    rows.append({"n": n, "P(|x̄−3|<0.1)": np.mean(np.abs(xb - 3) < 0.1), "P(x̄<3)": np.mean(xb < 3),
                 "t-cover": np.mean(np.abs(T) <= stats.t.ppf(0.975, n - 1)), "miss below": np.mean(T < -stats.t.ppf(0.975, n - 1))})
par = pd.DataFrame(rows)
print(par.round(3).to_string(index=False))
report({"연습 7.1: U^(−1/α) 는 Pareto (KS 유의확률 > 0.01), 평균 ≈ 3": stats.kstest(Xp[:20_000], lambda x: 1 - x ** (-alpha)).pvalue > 0.01,
        "연습 7.2: 중앙값 2^(1/α) = 1.59": abs(np.median(Xp) - 2 ** (1 / alpha)) < 0.01,
        "예제 7.1: n=100 에서 P(|x̄−3|<0.1) ≈ 0.10, P(x̄<3) ≈ 0.71, t-구간 0.71": abs(par.iloc[0, 1] - 0.10) < 0.01 and abs(par.iloc[0, 2] - 0.705) < 0.012 and abs(par.iloc[0, 3] - 0.706) < 0.012,
        "예제 7.1: n=1000 에서도 t-구간 0.76, 놓친 구간은 거의 모두 아래": abs(par.iloc[1, 3] - 0.759) < 0.015 and par.iloc[1, 4] > 0.95 * (1 - par.iloc[1, 3])})
text
    n  P(|x̄−3|<0.1)  P(x̄<3)  t-cover  miss below
  100          0.099    0.706    0.709       0.291
 1000          0.212    0.689    0.758       0.242
10000          0.429    0.673    0.783       0.217
  ✓  연습 7.1: U^(−1/α) 는 Pareto (KS 유의확률 > 0.01), 평균 ≈ 3
  ✓  연습 7.2: 중앙값 2^(1/α) = 1.59
  ✓  예제 7.1: n=100 에서 P(|x̄−3|<0.1) ≈ 0.10, P(x̄<3) ≈ 0.71, t-구간 0.71
  ✓  예제 7.1: n=1000 에서도 t-구간 0.76, 놓친 구간은 거의 모두 아래
python
# 누적 평균의 경로 — 분산 유한(지수), 분산 무한(Pareto 1.5), 평균 없음(Cauchy)
N = 100_000
nn = np.arange(1, N + 1)
idx = np.unique(np.geomspace(1, N, 4000).astype(int)) - 1
fig, ax = plt.subplots(figsize=(10, 3.6))
for lab, Xs, mu, col in [("exponential", rng.exponential(1, N), 1.0, C["stat"]),
                         ("Pareto 1.5", rng.random(N) ** (-1 / alpha), 3.0, C["key"]),
                         ("Cauchy", rng.standard_cauchy(N), 0.0, C["theta"])]:
    ax.plot(nn[idx], (np.cumsum(Xs) / nn - mu)[idx], color=col, lw=1.1, label=lab)
ax.axhline(0, color=C["ink"], lw=0.8)
ax.set_xscale("log"); ax.set_ylim(-3, 3); ax.set_xlabel("n"); ax.set_ylabel("running mean − center"); ax.legend()
ax.set_title("the law of large numbers needs a mean; the √n rate needs a variance")
plt.tight_layout(); plt.show()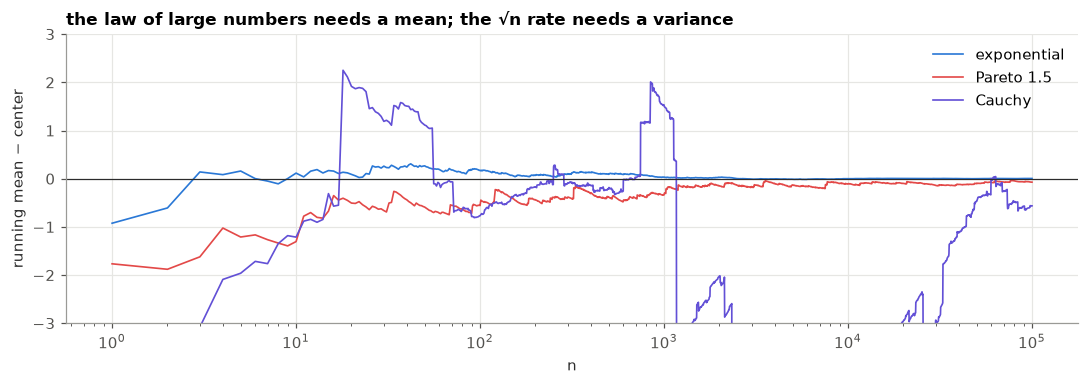
python
# 7.1절: 척도는 √n 이 아니라 n^(1/α) — n^(1/3)(X̄ − 3) 의 분위수가 n 에 따라 안정
q = {}
for n, reps in ((100, 20_000), (10_000, 2_000)):
    xb = (rng.random((reps, n)) ** (-1 / alpha)).mean(axis=1)
    q[n] = {"n^(1/3) 척도": np.quantile(n ** (1 / 3) * (xb - 3), [0.25, 0.5, 0.75]),
            "√n 척도": np.quantile(math.sqrt(n) * (xb - 3), [0.25, 0.5, 0.75])}
print("사분위수 (25, 50, 75%):")
for n in q:
    print(f"  n = {n:>6}:  n^(1/3)(x̄−3) {np.round(q[n]['n^(1/3) 척도'], 2)}    √n(x̄−3) {np.round(q[n]['√n 척도'], 2)}")
# 7.2절 · 연습 7.3: Cauchy 의 표본중앙값, n Var → π²/4
med = np.median(rng.standard_cauchy((40_000, 101)), axis=1)
# 예제 7.2 · 연습 7.4: 지수 합의 꼬리
tails = pd.DataFrame({n: {"right ratio": stats.gamma.sf(n + 3 * math.sqrt(n), n) / stats.norm.sf(3),
                          "left ratio": stats.gamma.cdf(n - 3 * math.sqrt(n), n) / stats.norm.sf(3)} for n in (30, 300, 3000)})
print(tails.round(3).to_string())
report({"7.1절: n^(1/3) 척도의 사분위 범위는 n 에 거의 무관 (20% 안), √n 척도는 커진다":
            abs(np.ptp(q[10_000]["n^(1/3) 척도"][[0, 2]]) / np.ptp(q[100]["n^(1/3) 척도"][[0, 2]]) - 1) < 0.2
            and np.ptp(q[10_000]["√n 척도"][[0, 2]]) > 1.5 * np.ptp(q[100]["√n 척도"][[0, 2]]),
        "연습 7.3: Cauchy 중앙값 n Var ≈ π²/4 = 2.47 (5% 안)": abs(101 * med.var() / (math.pi**2 / 4) - 1) < 0.05,
        "예제 7.2: n = 30 에서 오른쪽 3.1배, 왼쪽 0.06배 (17배 과장)": abs(tails.loc["right ratio", 30] - 3.08) < 0.01 and abs(tails.loc["left ratio", 30] - 0.059) < 0.001,
        "연습 7.4: 비가 1 로 간다 (3.08 → 1.56 → 1.17)": np.allclose(tails.loc["right ratio"], [3.084, 1.562, 1.166], atol=0.005)})
text
사분위수 (25, 50, 75%):
  n =    100:  n^(1/3)(x̄−3) [-2.72 -1.44  0.47]    √n(x̄−3) [-5.87 -3.1   1.02]
  n =  10000:  n^(1/3)(x̄−3) [-2.95 -1.4   0.73]    √n(x̄−3) [-13.68  -6.51   3.37]
              30     300    3000
right ratio  3.084  1.562  1.166
left ratio   0.059  0.558  0.846
  ✓  7.1절: n^(1/3) 척도의 사분위 범위는 n 에 거의 무관 (20% 안), √n 척도는 커진다
  ✓  연습 7.3: Cauchy 중앙값 n Var ≈ π²/4 = 2.47 (5% 안)
  ✓  예제 7.2: n = 30 에서 오른쪽 3.1배, 왼쪽 0.06배 (17배 과장)
  ✓  연습 7.4: 비가 1 로 간다 (3.08 → 1.56 → 1.17)
📝 연습 7.1–7.4 (강의노트): Pareto의 적률, 중앙값은 왜 대개 작은가, Cauchy의 중앙값, 꼬리의 비.
8. Beautiful insights — 평균을 내는 기계들
명제 8.1 미니배치 기울기: , · 8.2절 MC dropout · 명제 8.2 Hutchinson 추정량.
python
# 명제 8.1: 선형회귀 (N = 2000, d = 5) 의 β = 0 에서의 기울기
g = np.random.default_rng(2017)
N, d = 2000, 5
Xd = g.normal(size=(N, d)); beta = np.arange(1, d + 1) / d; y = Xd @ beta + g.normal(0, 1, N)
G = -(Xd * y[:, None])                       # 표본마다의 기울기 ∇ℓ_i = −x_i (y_i − x_i'β), β = 0
full = G.mean(axis=0); Sig = np.cov(G.T, ddof=0)
rows = []
for B in (8, 64, 512):
    gb = np.array([G[g.choice(N, B, replace=False)].mean(axis=0) for _ in range(20_000)])
    rows.append(dict(B=B, tr_emp=np.trace(np.cov(gb.T)), tr_theory=np.trace(Sig) / B * (N - B) / (N - 1),
                     tr_no_fpc=np.trace(Sig) / B, bias=np.abs(gb.mean(axis=0) - full).max()))
sg = pd.DataFrame(rows)
print(sg.round(4).to_string(index=False))
# 연습 8.1: 지시변수의 공분산
B = 64
I = np.zeros((40_000, N), bool)
for r_ in range(40_000):
    I[r_, g.choice(N, B, replace=False)] = True
c01 = np.cov(I[:, 0], I[:, 1])[0, 1]
report({"명제 8.1: 대각합이 이론값 2.19, 0.266, 0.0256 과 맞는다 (4% 안)": np.allclose(sg.tr_emp, sg.tr_theory, rtol=0.04)
            and np.allclose(sg.tr_theory, [2.193, 0.2664, 0.02559], rtol=1e-3),
        "명제 8.1: B = 512 에서 유한 모집단 수정이 없으면 34% 과대": abs(sg.tr_no_fpc.iloc[2] / sg.tr_theory.iloc[2] - 1.343) < 0.005,
        "명제 8.1: 미니배치 기울기는 불편 (평균 ≈ 전체 기울기)": (sg.bias < 0.01).all(),
        "연습 8.1: Cov(I_i, I_j) ≈ −B(N−B)/(N²(N−1))": abs(c01 + B * (N - B) / (N**2 * (N - 1))) < 4 * 0.032 / math.sqrt(40_000) * 0.032 + 2e-4})
text
  B  tr_emp  tr_theory  tr_no_fpc   bias
  8  2.1990     2.1928     2.2005 0.0076
 64  0.2650     0.2664     0.2751 0.0034
512  0.0256     0.0256     0.0344 0.0004
  ✓  명제 8.1: 대각합이 이론값 2.19, 0.266, 0.0256 과 맞는다 (4% 안)
  ✓  명제 8.1: B = 512 에서 유한 모집단 수정이 없으면 34% 과대
  ✓  명제 8.1: 미니배치 기울기는 불편 (평균 ≈ 전체 기울기)
  ✓  연습 8.1: Cov(I_i, I_j) ≈ −B(N−B)/(N²(N−1))
python
# 8.2절 · 연습 8.3: MC dropout 의 Monte Carlo 오차 — 작은 2층 망을 예측 때에도 드롭아웃으로
h = np.random.default_rng(2016)
x_tr = np.sort(h.uniform(-3, 3, 40)); y_tr = np.sin(x_tr) + h.normal(0, 0.2, 40)
W1 = h.normal(0, 1.5, 200); b1 = h.uniform(-3, 3, 200)
feat = lambda x: np.maximum(0, np.outer(x, W1) + b1)          # 고정된 무작위 ReLU 특성 200개
Phi = feat(x_tr)
w2 = np.linalg.solve(Phi.T @ Phi + 1.0 * np.eye(200), Phi.T @ y_tr)   # 마지막 층은 능선회귀로 학습
def mc_dropout_predict(x, T, q=0.2):
    masks = (h.random((T, 200)) > q) / (1 - q)                # 켜 둔 드롭아웃: 뉴런을 확률 q 로 끄고 1/(1−q) 로 보정
    return (feat(np.atleast_1d(x))[None, :, :] * masks[:, None, :]) @ w2   # (T, x 의 수)
x0 = 1.0
for T in (10, 100, 1000):
    reps = np.array([mc_dropout_predict(x0, T).mean() for _ in range(300)])
    s = mc_dropout_predict(x0, 20_000).std()
    print(f"T = {T:5d}: MC 평균의 표준편차 {reps.std():.4f}, s/√T = {s / math.sqrt(T):.4f}")
report({"연습 8.3: MC 평균의 오차 ≈ s/√T (T = 1000 에서 15% 안), 5% 이하이려면 T ≥ 400":
            abs(reps.std() / (s / math.sqrt(1000)) - 1) < 0.15 and math.ceil((1 / 0.05) ** 2) == 400})
text
T =    10: MC 평균의 표준편차 0.0920, s/√T = 0.0946
T =   100: MC 평균의 표준편차 0.0287, s/√T = 0.0299
text
T =  1000: MC 평균의 표준편차 0.0096, s/√T = 0.0095
  ✓  연습 8.3: MC 평균의 오차 ≈ s/√T (T = 1000 에서 15% 안), 5% 이하이려면 T ≥ 400
python
# 명제 8.2 · 연습 8.4, 8.5: Hutchinson 추정량
hh = np.random.default_rng(1989)
m = 30
A = hh.normal(size=(m, m)); A = (A + A.T) / 2
fro2, diag2 = (A**2).sum(), (np.diag(A) ** 2).sum()
zr = hh.choice([-1.0, 1.0], size=(200_000, m)); zg = hh.normal(size=(200_000, m))
qr = np.einsum("ij,jk,ik->i", zr, A, zr); qg = np.einsum("ij,jk,ik->i", zg, A, zg)
print(f"tr A = {np.trace(A):.3f};  Rademacher: 평균 {qr.mean():.3f}, 분산 {qr.var():.1f} (이론 {2 * (fro2 - diag2):.1f});  "
      f"정규: 평균 {qg.mean():.3f}, 분산 {qg.var():.1f} (이론 {2 * fro2:.1f})")
I30 = np.eye(m)
q_id = np.einsum("ij,jk,ik->i", zr[:10], I30, zr[:10])
report({"명제 8.2: 두 추정량 모두 불편 (4 se 안)": within(qr.mean(), np.trace(A), qr.std() / math.sqrt(len(qr))) and within(qg.mean(), np.trace(A), qg.std() / math.sqrt(len(qg))),
        "명제 8.2(a): Rademacher 분산 ≈ 2(‖A‖² − Σa_ii²) = 872 (3% 안)": abs(qr.var() / (2 * (fro2 - diag2)) - 1) < 0.03 and abs(2 * (fro2 - diag2) - 871.7) < 0.1,
        "연습 8.4: 정규 분산 ≈ 2‖A‖² = 916 (3% 안)": abs(qg.var() / (2 * fro2) - 1) < 0.03,
        "연습 8.5: A = I 이면 Rademacher 탐침 하나로 정확": np.allclose(q_id, m)})
text
tr A = 9.698;  Rademacher: 평균 9.762, 분산 872.0 (이론 871.7);  정규: 평균 9.602, 분산 916.5 (이론 915.8)
  ✓  명제 8.2: 두 추정량 모두 불편 (4 se 안)
  ✓  명제 8.2(a): Rademacher 분산 ≈ 2(‖A‖² − Σa_ii²) = 872 (3% 안)
  ✓  연습 8.4: 정규 분산 ≈ 2‖A‖² = 916 (3% 안)
  ✓  연습 8.5: A = I 이면 Rademacher 탐침 하나로 정확
📝 연습 8.1–8.5 (강의노트): 지시변수의 공분산, 선형 스케일링, 몇 번 통과시키나, 정규 탐침의 분산, 탐침의 수.
9. 정리 · 연습문제 지도 · 다음 회
| 내용 | 확인한 셀 | |
|---|---|---|
| 확률수렴 (1.1–1.7) | Buffon의 바늘, 연속사상, Khinchin(분산 없이), | 1절 |
| 분포수렴 (2.1–2.6) | 최댓값의 극한, Gumbel, 기하 → 지수, mgf의 수렴 | 2절 |
| 중심극한정리 (3.1–3.5) | , Berry–Esseen, 네 모집단, Cauchy의 실패 | 3절 |
| Slutsky · 델타 (4.1–4.7) | 스튜던트화한 평균, 로그 오즈, Buffon의 , Lazzarini, 분산 안정화 | 4절 |
| 다변량 (5.1–5.5) | 다항분포의 정규 극한, Pearson의 , 의 점근분산, 비율, Fisher | 5절 |
| Monte Carlo (6.1–6.8) | 구간, RejectionSampler, 중요도 표집 7,000배, 반대 변량 4배 |
6절 |
| 부숴보기 (7.1–7.2) | Pareto의 , Cauchy의 중앙값, 꼬리의 상대오차 | 7절 |
| 오늘 (8.1–8.2) | 미니배치 잡음과 유한 모집단 수정, MC dropout의 오차, Hutchinson | 8절 |
연습문제 지도 (강의노트, ★ 계산 · ★★ 증명 · ★★★ 도전, 풀이는 부록 A)
| 절 | 연습 | 이 노트북에서 확인하는 셀 |
|---|---|---|
| 1 확률수렴 | 1.1 국수 ★★ · 1.2 ★ · 1.3 ★ · 1.4 ★★ · 1.5 ★★ · 1.6 Buffon 증명 ★ · 1.7 표본적률 ★ (유도형) | 1절 |
| 2 분포수렴 | 2.1 ★ · 2.2 Gumbel ★★ · 2.3 ★★ · 2.4 제곱 ★★ · 2.5 ★ · 2.6 확률적 유계 ★★ (유도형) | 2절 |
| 3 중심극한정리 | 3.1 누율 ★★ · 3.2 ★ · 3.3 Lyapunov ★★ · 3.4 균등 12개 ★ · 3.5 ★★ · 3.6 두 Cauchy ★★★ | 3절 |
| 4 Slutsky · 델타 | 4.1 ★ · 4.2 2차 ★★ · 4.3 바늘 ★★ · 4.4 Lazzarini ★★ · 4.5 ★★ · 4.6 ★ · 4.7 무시할 수 있는 항 ★★ (유도형) | 4절 |
| 5 다변량 | 5.1 ★ · 5.2 비율 ★★ · 5.3 Fisher ★ · 5.4 변동계수 ★★ · 5.5 다변량 CLT ★★ · 5.6 다변량 델타 ★★ (유도형) | 5절 |
| 6 Monte Carlo | 6.1 ★ · 6.2 ★ · 6.3 베타 ★★ · 6.4 꼬리 ★★ · 6.5 반대 변량 ★★★ · 6.6 중요도 표집 증명 ★ (유도형) | 6절 |
| 7 부숴보기 | 7.1 ★ · 7.2 ★★ · 7.3 Cauchy 중앙값 ★★ · 7.4 ★ | 7절 |
| 8 오늘 | 8.1 ★★ · 8.2 ★ · 8.3 ★ · 8.4 ★★★ · 8.5 ★★ | 8절 |
다음 회 (8회) — 추론의 기초: 표본 · 신뢰구간 · 유의성 검정 (1710 → 1937). 이번 회차의 극한 정리들로 통계적 추론을 세운다. Arbuthnot(1710)이 82년 연속 남아가 더 많이 태어난 기록으로 "우연인가 섭리인가"를 물은 최초의 검정에서 출발해, 5절의 다항분포 극한으로 Pearson(1900)의 적합도 검정을 증명하고, 4절의 스튜던트화한 평균으로 대표본 신뢰구간을 만든다. 그리고 4.4절의 Lazzarini처럼 "원하는 결과가 나올 때까지" 하는 분석이 왜 틀리는지(p-해킹)를 본다.
10. 워크북 검산
워크북(07_limits_workbook.pdf)의 문제는 손으로 먼저 푼다. 이 절은 다 푼 뒤에 쓴다.
check("A5", "1/4")— 문항 번호와 손으로 구한 답을 넣으면 맞는지만 알려 준다. 정답은 보여 주지 않는다. 답은 수(0.1711,2/27)나 식의 문자열("lam**2")로 넣는다. 는lam으로 쓴다. 소문항은"A12b"처럼 번호 뒤에 붙인다. 소수로 넣으면 상대오차 0.1%까지 맞다고 본다(A12b, D4b는 1%).- 시뮬레이션으로 한 번 더 — 확률이나 분산이 답인 문항은 아래에 시뮬레이션 함수를 정의해 두었다. 손으로 구한 값이
추정값 ± 3 × 표준오차안에 드는지 본다. 함수는 정의만 해 두었고 부르지 않았다. 답을 구하기 전에 부르면 답이 보인다.
증명 문제(B, C의 대부분)는 check()가 없다. 풀이판의 증명과 단계별로 맞춰 본다.
답 열쇠 셀 (내려받은 노트북에서 실행된다)
답 열쇠를 압축해 넣은 check() 정의 셀이다. 웹에서는 이 회차의 답 확인 페이지를 쓴다.
python
check()                 # 확인할 수 있는 문항 번호
check("A5")             # 답을 넣지 않으면 쓰는 법을 알려 준다
text
확인할 수 있는 문항: A1a A1b A2a A2b A3 A4a A4b A5 A6 A7a A7b A8a A8b A8c A9 A10 A11a A11b A12a A12b A13 A14a A14b A14c C5b C6b C9b D1b D1c D1d D2b D2c D2d D3a D3c D3d D4b
A5: 아직 답을 넣지 않았다. 예: check('A5', '3/8')
10.1 내 답을 모아 확인하기
푼 문항의 답을 아래 사전에 채우고 실행한다. None인 문항은 건너뛴다.
python
mine = {
    "A1a": None, "A1b": None, "A2a": None, "A2b": None, "A3": None, "A4a": None, "A4b": None,
    "A5": None, "A6": None, "A7a": None, "A7b": None, "A8a": None, "A8b": None, "A8c": None,
    "A9": None, "A10": None, "A11a": None, "A11b": None, "A12a": None, "A12b": None,
    "A13": None, "A14a": None, "A14b": None, "A14c": None,
    "C5b": None, "C6b": None, "C9b": None,
    "D1b": None, "D1c": None, "D1d": None, "D2b": None, "D2c": None, "D2d": None,
    "D3a": None, "D3c": None, "D3d": None, "D4b": None,
}
check_all(mine)
text
0/0 맞음10.2 시뮬레이션 함수
각 함수는 (추정값, 표준오차)를 돌려준다. 분산을 추정하는 함수의 표준오차는 표본의 4차 적률로 계산한다.
| 함수 | 문항 | 시뮬레이션 |
|---|---|---|
sim_A2() |
A2 , | 이항 난수 |
sim_A4() |
A4 | 균등 10개의 최댓값 |
sim_A8() |
A8 받아들일 확률 | 기각 표집 한 번 |
sim_A12() |
A12 | 평균 3인 지수분포 |
sim_A14() |
A14 반대 변량 평균의 분산 | 와 |
sim_C6(n) |
C6 , | 이항 난수 |
sim_D1(lam, n) |
D1 | Poisson 표본 |
sim_D2(theta, n) |
D2 | 균등 표본의 최댓값 |
sim_D4(a, mu) |
D4 | 제안 |
python
def mean_se(x):
    x = np.asarray(x, dtype=float)
    return x.mean(), x.std(ddof=1) / np.sqrt(len(x))


def var_se(x):
    """표본분산과 그 표준오차 √((m4 − s⁴)/R)"""
    x = np.asarray(x, dtype=float)
    d = x - x.mean()
    s2 = d.var(ddof=1)
    return s2, np.sqrt(max((d**4).mean() - s2**2, 0.0) / len(x))


def sim_A2(R=N_SIM):
    return mean_se(rng.binomial(400, 0.5, size=R) <= 190)


def sim_A4(R=N_SIM):
    return mean_se(10 * (1 - rng.random((R, 10)).max(axis=1)) > 2)


def sim_A8(R=N_SIM):
    y, u = rng.random(R), rng.random(R)
    return mean_se(u <= 6 * y * (1 - y) / 1.5)


def sim_A12(R=N_SIM):
    y = rng.exponential(3.0, size=R)
    w = 3 * np.exp(-2 * y / 3)
    return mean_se((y > 3) * w**2)


def sim_A14(R=N_SIM):
    u = rng.random(R)
    return var_se((u**2 + (1 - u) ** 2) / 2)


def sim_C6(n=1000, R=N_SIM):
    return mean_se(rng.binomial(n, 1 / n, size=R) > 0)


def sim_D1(lam=1.0, n=400, R=20_000):
    xbar = rng.poisson(lam, size=(R, n)).mean(axis=1)
    v, se = var_se(np.exp(-xbar))
    return n * v, n * se


def sim_D2(theta=1.0, n=10, R=N_SIM):
    m = theta * rng.random((R, n)).max(axis=1)
    return var_se((n + 1) / n * m)


def sim_D4(a=3.0, mu=3.0, R=N_SIM):
    y = rng.normal(mu, 1.0, size=R)
    w = np.exp(-mu * y + mu**2 / 2)
    return mean_se((y > a) * w**2)
python
# 자체 검사 (출력 없음): 시뮬레이션이 답 열쇠와 맞는지, check()가 답 열쇠의 값과 그 소수를 맞다고 하는지 확인한다.
def _close(sim, target, z=4.0):
    est, se = sim
    return abs(est - target) <= z * se + 1e-12

assert _close(sim_A2(), _value("A2a"))
assert _close(sim_A4(), _value("A4a"))
assert _close(sim_A8(), _value("A8b"))
assert _close(sim_A12(), _value("A12a"))
assert _close(sim_A14(), _value("A14c"))
assert _close(sim_C6(), _value("C6b"))
_d1, _d1se = sim_D1()
assert abs(_d1 - _value("D1c", lam=1.0)) <= 4 * _d1se + 0.01 * _value("D1c", lam=1.0)   # n=400의 유한 표본 차이 1%
assert _close(sim_D2(), _value("D2c", theta=1.0, n=10))
assert _close(sim_D4(), math.exp(9) * stats.norm.sf(6))
for _k, _e in _WB.items():
    assert _same(_e, _e["value"])
    if not _e.get("vars") and "points" not in _e:
        assert _same(_e, float(sp.sympify(_e["value"]).evalf()))