Skip to content

7회 · 극한의 언어 · 노트

6 계산으로 — Monte Carlo (1946 → 1949) ​

역사 1946년 수학자 Stanisław Ulam은 병상에서 카드 놀이(Canfield 솔리테어)가 이길 확률을 계산하다가, 조합론으로 풀기보다 백 번 해 보고 세는 편이 빠르다는 것을 깨달았다. 그는 이 생각을 Los Alamos의 John von Neumann에게 말했고, 둘은 핵분열 장치 안의 중성자 확산을 난수로 흉내 내는 계획을 세웠다. 1948년 ENIAC이 그 계산을 했다. 동료 Nicholas Metropolis가 Ulam의 삼촌이 드나들던 도박장의 이름을 따 이 방법을 Monte Carlo라 불렀고, Metropolis와 Ulam(1949)이 JASA에 같은 이름의 논문을 냈다. 방법 자체는 Buffon의 바늘(1절)과 Student의 카드(6회)부터 있었다. 새로운 것은 컴퓨터, 그리고 결과의 오차를 함께 말하는 습관이었다.

6.1 오차를 아는 시뮬레이션 ​

정리 6.1 (Monte Carlo 추정) θ=E h(X)\theta=E\,h(X)를 구하려고 XX의 분포에서 iid 표본 X1,…,XnX_1,\dots,X_n을 만들어 θ^n=1n∑h(Xi)\hat\theta_n=\tfrac1n\sum h(X_i)로 둔다.

  1. (a)

    E∣h(X)∣<∞E|h(X)|<\infty이면 Eθ^n=θE\hat\theta_n=\theta이고 θ^n→Pθ\hat\theta_n\xrightarrow{P}\theta.

  2. (b)

    σh2=Var⁡h(X)<∞\sigma_h^2=\Var h(X)<\infty이고 sh2s_h^2이 h(Xi)h(X_i)들의 표본분산이면, θ^n±zα/2 sh/n\hat\theta_n\pm z_{\alpha/2}\,s_h/\sqrt n의 포함확률은 1−α1-\alpha로 간다.

증명 (a) 선형성과 정리 1.6. (b) 따름정리 4.3를 iid 변수 h(Xi)h(X_i)에 쓴다.

정리는 Monte Carlo의 두 가지 성질을 말한다. 오차는 σh/n\sigma_h/\sqrt n으로 차원과 상관없고, 오차의 크기를 같은 표본으로 어림할 수 있다. 정확도를 한 자리 높이려면 nn을 100배 해야 하므로, 실제의 기술은 σh\sigma_h를 줄이는 데 있다(6.3절).

예제 6.2 (Chebyshev 대신 중심극한정리) 2회 예제 6.4에서 ∫01ex2dx=1.4627\int_0^1e^{x^2}dx=1.4627을 균등 난수로 구할 때, 오차가 0.010.01 이상일 확률을 1% 이하로 하려면 Chebyshev로 n≥σh20.012⋅0.01=2.25×10⁵n\ge\tfrac{\sigma_h^2}{0.01^2\cdot0.01}=2.25\times10^5이면 충분했다(σh2=0.2251\sigma_h^2=0.2251). 중심극한정리로는 P(∣θ^n−θ∣≥0.01)≈P(∣Z∣≥0.01nσh)=0.01P(|\hat\theta_n-\theta|\ge0.01)\approx P\bigl(|Z|\ge\tfrac{0.01\sqrt n}{\sigma_h}\bigr)=0.01에서

n≈(z0.005 σh0.01)2=(2.576×0.4740.01)2≈1.49×104.n\approx\Bigl(\frac{z_{0.005}\,\sigma_h}{0.01}\Bigr)^2=\Bigl(\frac{2.576\times0.474}{0.01}\Bigr)^2\approx1.49\times10^4 .

15분의 1이다. Chebyshev는 모든 분포에 맞는 보장이라 보수적이고, 중심극한정리는 이 분포에 맞는 근사다. 6회의 카드 실험에서 섞기 400번의 비율이 표준편차 0.0077≈0.05⋅0.95/7500.0077\approx\sqrt{0.05\cdot0.95/750}로 흩어진 것도 이 정리의 예다.

6.2 원하는 분포에서 뽑기 — 기각 표집 ​

h(X)h(X)의 평균을 구하려면 XX의 분포에서 뽑을 수 있어야 한다. 분포함수의 역함수를 알면 역함수 표집(2회 정리 4.7)을 쓰고, 정규처럼 역함수가 닫힌 꼴이 아니면 Box–Muller(3회 정리 5.4) 같은 변환을 찾는다. 밀도만 알 때 쓰는 일반적인 방법이 von Neumann(1951)의 기각 표집이다.

알고리즘 6.3 (기각 표집) 목표 밀도 ff, 뽑기 쉬운 제안 밀도 gg, 상수 MM이 모든 xx에서 f(x)≤Mg(x)f(x)\le Mg(x)를 만족한다.

  1. 1.

    Y∼gY\sim g와 U∼U(0,1)U\sim\mathrm U(0,1)을 독립으로 뽑는다.

  2. 2.

    U≤f(Y)Mg(Y)U\le\dfrac{f(Y)}{Mg(Y)}이면 YY를 받아들여 내놓고, 아니면 1로 돌아간다.

정리 6.4 (기각 표집의 정당성) 알고리즘 6.3이 내놓는 값의 밀도는 ff이다. 한 번 시도에서 받아들일 확률은 1/M1/M이고, 시도 횟수는 평균 MM인 기하분포를 따른다.

증명 전략 한 번의 시도에서 “받아들이고 Y≤xY\le x”인 확률을 이중적분으로 계산하면 F(x)/MF(x)/M이 된다. 시도들이 독립이므로 내놓는 값의 분포는 받아들인 시도의 조건부분포이고, 시도 횟수는 기하분포다.

  1. 한 번의 시도에서 (Y,U)(Y,U)의 결합밀도는 g(y)⋅1g(y)\cdot1 (0<u<10<u<1)이다.독립, 3회 정리 3.2

  2. 받아들이는 사건을 A={U≤f(Y)/(Mg(Y))}A=\{U\le f(Y)/(Mg(Y))\}라 하면

    P(Y≤x, A)=∫−∞xg(y) P(U≤f(y)Mg(y))dy=∫−∞xg(y)f(y)Mg(y) dy=F(x)M.\begin{align*} P(Y\le x,\ A)&=\int_{-\infty}^xg(y)\,P\Bigl(U\le\frac{f(y)}{Mg(y)}\Bigr)dy \tag*{\htmlClass{reason}{\text{\htmlClass{sref}{\text{1}}, 반복적분 \htmlClass{tool}{\href{/read/00/6}{\text{[T6]}}}}}}\\ &=\int_{-\infty}^xg(y)\frac{f(y)}{Mg(y)}\,dy=\frac{F(x)}M . \tag*{\htmlClass{reason}{\text{$0\le f/(Mg)\le1$}}} \end{align*}
  3. x→∞x\to\infty로 보내면 P(A)=1MP(A)=\tfrac1M이다.1회 정리 4.7

  4. kk번째 시도에서 처음 받아들이고 그 값이 xx 이하일 확률은 (1−1M)k−1F(x)M(1-\tfrac1M)^{k-1}\tfrac{F(x)}M이다.시도들의 독립, 2 3

  5. kk에 대해 더하면 내놓는 값이 xx 이하일 확률은 F(x)M∑k≥1(1−1M)k−1=F(x)\tfrac{F(x)}M\sum_{k\ge1}(1-\tfrac1M)^{k-1}=F(x)이다.가산가법성, 기하급수 [T5]

  6. 4에서 F(x)F(x)를 11로 바꾸면 처음 받아들일 때까지의 시도 횟수가 성공 확률 1/M1/M의 기하분포이고 평균이 MM임을 얻는다.4회 1절

조건 확인 g(y)=0g(y)=0인 곳에서는 f(y)≤Mg(y)=0f(y)\le Mg(y)=0이므로 비 f/(Mg)f/(Mg)를 정의하지 않아도 그 yy는 적분에 기여하지 않는다. 2의 반복적분은 음이 아닌 함수의 적분이므로 Tonelli로 순서를 정할 수 있다 [T6]. M≥1M\ge1인 것은 1=∫f≤M∫g=M1=\int f\le M\int g=M에서 나온다.

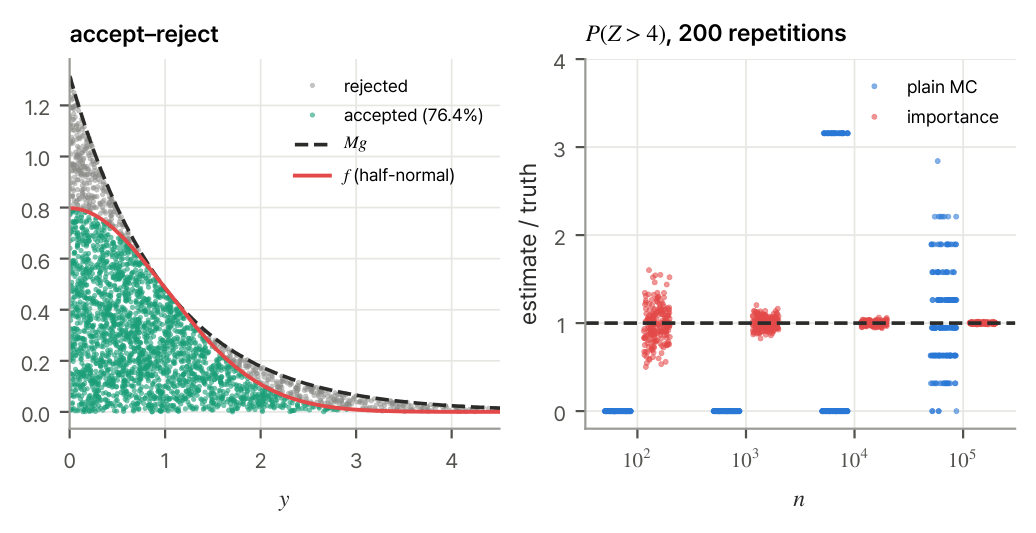
예제 6.5 (지수 난수로 정규 난수 만들기) 반정규 밀도 f(x)=2/π e−x2/2f(x)=\sqrt{2/\pi}\,e^{-x^2/2} (x>0x>0)를 g(x)=e−xg(x)=e^{-x}로 덮는다. fg=2/π ex−x2/2\tfrac fg=\sqrt{2/\pi}\,e^{x-x^2/2}은 x=1x=1에서 최대이므로 M=2e/π=1.3155M=\sqrt{2e/\pi}=1.3155이고, 받아들일 확률은 0.7600.760이다. 받아들인 값에 무작위 부호를 붙이면 N(0,1)\N(0,1)이다. 지수 난수는 −log⁡U-\log U로 만든다(2회 정리 4.7). 받아들이는 조건은 U≤e−(Y−1)2/2U\le e^{-(Y-1)^2/2}로 간단해진다(연습 6.2).

그림 6.1. 왼쪽: 기각 표집. (Y,UMg(Y))를 Mg 아래에 고르게 뿌리고(회색) f 아래의 점만(청록) 남긴다. 남은 점의 가로 좌표가 f를 따른다. 오른쪽: P(Z>4)의 추정. 보통의 Monte Carlo(파랑)는 n=10^4에서 거의 언제나 0을 내놓고, 중요도 표집(빨강)은 같은 n에서 상대오차 2%로 맞힌다.
그림 6.1 왼쪽: 기각 표집. (Y,UMg(Y))(Y,UMg(Y))를 MgMg 아래에 고르게 뿌리고(회색) ff 아래의 점만(청록) 남긴다. 남은 점의 가로 좌표가 ff를 따른다. 오른쪽: P(Z>4)P(Z>4)의 추정. 보통의 Monte Carlo(파랑)는 n=104n=10^4에서 거의 언제나 0을 내놓고, 중요도 표집(빨강)은 같은 nn에서 상대오차 2%로 맞힌다.

6.3 오차를 줄이기 — 중요도 표집과 반대 변량 ​

정리 6.6 (중요도 표집) h(x)f(x)≠0h(x)f(x)\ne0인 곳에서 g(x)>0g(x)>0이면, Yi∼iidgY_i\iid g에 대해

θ^nIS=1n∑i=1nh(Yi) w(Yi),w=fg\hat\theta^{\mathrm{IS}}_n=\frac1n\sum_{i=1}^nh(Y_i)\,w(Y_i),\qquad w=\frac fg

는 θ=Efh(X)\theta=E_fh(X)의 불편추정량이고 분산은 1n(Eg[h(Y)2w(Y)2]−θ2)\tfrac1n\bigl(E_g[h(Y)^2w(Y)^2]-\theta^2\bigr)이다. h≥0h\ge0이면 g∝hfg\propto hf일 때 분산이 0이다.

증명 전략 가중치 w=f/gw=f/g가 gg로 뽑은 표본을 ff의 기댓값으로 되돌린다는 것을 적분 한 줄로 보이고, 분산은 iid 평균의 분산 공식으로 계산한다. 단계별 증명은 연습 6.6(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

분산이 0인 gg는 θ\theta를 알아야 만들 수 있으므로 실제로는 쓸 수 없다. 그러나 방향은 알려 준다. “hfhf가 큰 곳에서 많이 뽑고, 가중치로 바로잡아라.”

예제 6.7 (드문 사건) θ=P(Z>4)=3.17×10⁻⁵\theta=P(Z>4)=3.17\times10^{-5}를 보통의 Monte Carlo로 구하면 h=1{Z>4}h=1\{Z>4\}이고 상대 표준오차는 (1−θ)/(nθ)\sqrt{(1-\theta)/(n\theta)}다. n=104n=10^4이면 1.78, 곧 추정값이 대개 0이다. 상대오차를 10%로 하려면 n≈3×10⁶n\approx3\times10^6이 필요하다. 제안분포를 g=N(4,1)g=\N(4,1)로 옮기면 w(y)=ϕ(y)/ϕ(y−4)=e−4y+8w(y)=\phi(y)/\phi(y-4)=e^{-4y+8}이고, 한 표본의 분산이 4.5×10−94.5\times10^{-9}로 보통 Monte Carlo의 θ(1−θ)=3.2×10⁻⁵\theta(1-\theta)=3.2\times10^{-5}보다 약 7,000배 작다. n=104n=10^4에서 상대오차가 2%다. 금융의 극단 손실, 통신의 오류율, 희귀 변이의 검정처럼 작은 확률을 다루는 계산이 모두 이 방법을 쓴다.

예제 6.8 (반대 변량) UU와 1−U1-U는 같은 분포이고, hh가 단조이면 h(U)h(U)와 h(1−U)h(1-U)는 음의 상관을 갖는다. 그래서 12(h(U)+h(1−U))\tfrac12\bigl(h(U)+h(1-U)\bigr)를 쓰면 같은 계산량에서 분산이 줄어든다. h(x)=ex2h(x)=e^{x^2}이면 난수 2개의 평균의 분산 σh2/2=0.1126\sigma_h^2/2=0.1126이 반대 변량에서는 0.02800.0280으로 4.0배 작다(연습 6.5).

연습문제

연습 6.1 (원으로 잰 π\pi ★) U1,U2∼iidU(0,1)U_1,U_2\iid\mathrm U(0,1)이면 4⋅1{U12+U22≤1}4\cdot1\{U_1^2+U_2^2\le1\}의 평균은 π\pi이다. 분산을 구하고, n=104n=10^4에서 표준오차가 0.016임을 보여라. Buffon의 바늘(n=104n=10^4에서 0.024)보다 나은가?

풀이

P(U12+U22≤1)=π4P(U_1^2+U_2^2\le1)=\tfrac\pi4이므로 분산은 16⋅π4(1−π4)=2.7016\cdot\tfrac\pi4(1-\tfrac\pi4)=2.70, n=104n=10^4에서 표준오차 2.70/100=0.016\sqrt{2.70}/100=0.016. Buffon(ℓ=d\ell=d)은 2.37/100=0.0242.37/100=0.024이므로 원이 낫다. 같은 난수 수로 비교하면(바늘 하나에 난수 2개) 차이는 더 크다.

연습 6.2 (받아들이는 조건 ★) 예제 6.5에서 f(y)Mg(y)=e−(y−1)2/2\tfrac{f(y)}{Mg(y)}=e^{-(y-1)^2/2}임을 보여라.

풀이

f(y)Mg(y)=2/πe−y2/22e/π e−y=e−y2/2+y−1/2=e−(y−1)2/2\tfrac{f(y)}{Mg(y)}=\tfrac{\sqrt{2/\pi}e^{-y^2/2}}{\sqrt{2e/\pi}\,e^{-y}}=e^{-y^2/2+y-1/2}=e^{-(y-1)^2/2}.

연습 6.3 (베타 난수 ★★) Beta(2.7,6.3)\mathrm{Beta}(2.7,6.3)을 g=U(0,1)g=\mathrm U(0,1)로 기각 표집할 때 가장 작은 MM은 밀도의 최댓값이다. 최빈값 a−1a+b−2\tfrac{a-1}{a+b-2}에서 M=2.67M=2.67, 받아들일 확률 0.3750.375임을 확인하라. 4회 정리 4.2의 감마의 비를 쓰는 방법과 비교하면?

풀이

최빈값 1.77=0.243\tfrac{1.7}{7}=0.243에서 밀도는 2.672.67이므로 M=2.67M=2.67, 수락 확률 1/M=0.3751/M=0.375. 평균 2.67번 시도에 난수 5.3개. 4회 정리 4.2로는 Γ(2.7)\Gamma(2.7)과 Γ(6.3)\Gamma(6.3) 난수 둘로 G1G1+G2\tfrac{G_1}{G_1+G_2}를 만들면 기각이 없지만 감마 난수 자체가 기각 표집(Marsaglia–Tsang)을 쓴다. 모양 모수가 커지면 밀도가 뾰족해져 균등 제안의 MM이 커지므로 감마의 비가 유리하다.

연습 6.4 (두꺼운 꼬리가 필요하다 ★★) f=N(0,1)f=\N(0,1), h(x)=x2h(x)=x^2을 제안분포 g=N(0,τ2)g=\N(0,\tau^2)로 중요도 표집하면 τ2≤12\tau^2\le\tfrac12일 때 분산이 무한임을 보여라. 제안분포의 꼬리가 목표보다 얇으면 가중치 ww가 폭발한다.

풀이

w=f/gw=f/g이고 Eg[h2w2]=∫x4f(x)2g(x)dx∝∫x4exp⁡(−x2+x22τ2)dxE_g[h^2w^2]=\int x^4\tfrac{f(x)^2}{g(x)}dx\propto\int x^4\exp\bigl(-x^2+\tfrac{x^2}{2\tau^2}\bigr)dx. 지수의 계수 −(1−12τ2)-(1-\tfrac1{2\tau^2})가 음이어야 적분이 유한하므로 τ2>12\tau^2>\tfrac12이 필요하다. τ2≤12\tau^2\le\tfrac12이면 무한대다.

연습 6.5 (반대 변량의 분산 ★★★) Var⁡h(U)+h(1−U)2=12(σh2+Cov⁡(h(U),h(1−U)))\Var\tfrac{h(U)+h(1-U)}2=\tfrac12\bigl(\sigma_h^2+\Cov(h(U),\allowbreak h(1-U))\bigr)임을 보이고, hh가 증가함수이면 Cov⁡(h(U),h(1−U))≤0\Cov(h(U),h(1-U))\le0임을 보여라. (힌트: 독립인 U,VU,V에 대해 (h(U)−h(V))(h(1−U)−h(1−V))≤0\bigl(h(U)-h(V)\bigr)\bigl(h(1-U)-h(1-V)\bigr)\le0.)

풀이

Var⁡A+B2=14(Var⁡A+Var⁡B+2Cov⁡(A,B))=12(σh2+Cov⁡(A,B))\Var\tfrac{A+B}2=\tfrac14(\Var A+\Var B+2\Cov(A,\allowbreak B))=\tfrac12(\sigma_h^2+\Cov(A,\allowbreak B)) (A=h(U)A=h(U), B=h(1−U)B=h(1-U), 같은 분포). U,VU,V가 독립이고 hh가 증가하면 h(U)−h(V)h(U)-h(V)와 h(1−U)−h(1−V)h(1-U)-h(1-V)는 부호가 반대이므로 곱의 기댓값 ≤0\le0이다. 전개하면 E[⋅]=2(E[h(U)h(1−U)]−Eh(U) Eh(1−U))=2Cov⁡(A,B)E[\cdot]=2\bigl(E[h(U)h(1-U)]-Eh(U)\,Eh(1-U)\bigr)=2\Cov(A,\allowbreak B)이므로 Cov⁡(A,B)≤0\Cov(A,B)\le0. ex2e^{x^2}에서 분산은 0.11260.1126에서 0.02800.0280으로 줄었다.

연습 6.6 (중요도 표집 증명 ★ 유도형) 정리 6.6를 다음 순서로 증명하라.

  1. (a)

    Eg[h(Y)w(Y)]=∫hfg g=∫hf=θE_g[h(Y)w(Y)]=\int h\tfrac fg\,g=\int hf=\theta를 보여라. g(x)=0g(x)=0이고 h(x)f(x)≠0h(x)f(x)\ne0인 점이 있으면 어느 등호가 틀리는가?

  2. (b)

    Var⁡g(h(Y)w(Y))=Eg[h2w2]−θ2\Var_g\bigl(h(Y)w(Y)\bigr)=E_g[h^2w^2]-\theta^2을 써서 θ^nIS\hat\theta^{\mathrm{IS}}_n의 분산을 구하라(2회 정리 2.2, 2.8).

  3. (c)

    h≥0h\ge0, θ>0\theta>0이고 g=hf/θg=hf/\theta이면 h(Y)w(Y)=θh(Y)w(Y)=\theta가 상수임을 보여 분산이 0임을 확인하라.

  4. (d)

    (c)의 gg가 실제로 쓸 수 없는 이유를 설명하라.

풀이

(a) Eg[h(Y)w(Y)]=∫g>0h(y)f(y)g(y)g(y) dy=∫g>0hfE_g[h(Y)w(Y)]=\int_{g>0}h(y)\tfrac{f(y)}{g(y)}g(y)\,dy=\int_{g>0}hf이다. 가정으로 g=0g=0인 곳에서는 hf=0hf=0이므로 이것은 ∫hf=θ\int hf=\theta이다. g(x)=0g(x)=0이면서 h(x)f(x)≠0h(x)f(x)\ne0인 구간이 있으면 마지막 등호가 틀린다. 그 구간의 기여가 빠지기 때문이다. (b) h(Yi)w(Yi)h(Y_i)w(Y_i)들은 iid이므로(3회 정리 3.4) Var⁡θ^nIS=1nVar⁡g(hw)\Var\hat\theta^{\mathrm{IS}}_n=\tfrac1n\Var_g(hw)이다(2회 정리 2.8). Var⁡g(hw)=Eg[h2w2]−(Eg[hw])2=Eg[h2w2]−θ2\Var_g(hw)=E_g[h^2w^2]-(E_g[hw])^2=E_g[h^2w^2]-\theta^2이다(2회 정리 2.2). (c) g=hf/θg=hf/\theta이면 g≥0g\ge0이고 ∫g=1\int g=1이다. g(y)>0g(y)>0인 yy에서 h(y)w(y)=h(y)f(y)θh(y)f(y)=θh(y)w(y)=h(y)\tfrac{f(y)\theta}{h(y)f(y)}=\theta이므로 hwhw는 상수이고 분산이 0이다. (d) g=hf/θg=hf/\theta를 쓰려면 정규화 상수 θ\theta를 알아야 하는데, θ\theta는 구하려던 값이다. 이 정리는 쓸 gg를 주지 않고, gg를 hfhf와 비슷한 모양으로 고르라는 방향을 준다.

이 회차에서 읽은 절 0개 · 회차 차례