Skip to content

7회 · 극한의 언어 · 노트

8 Beautiful insights — 평균을 내는 기계들 ​

8.1 미니배치 경사의 잡음 ​

신경망의 손실은 학습 자료 NN개의 평균 L(θ)=1N∑i=1Nℓi(θ)L(\boldsymbol\theta)=\tfrac1N\sum_{i=1}^N\ell_i(\boldsymbol\theta)이다. 확률적 경사하강법(SGD)은 매 단계 BB개를 뽑아 그 평균 기울기 g^=1B∑i∈배치∇ℓi\hat{\mathbf g}=\tfrac1B\sum_{i\in\text{배치}}\nabla\ell_i로 θ←θ−ηg^\boldsymbol\theta\leftarrow\boldsymbol\theta-\eta\hat{\mathbf g}를 한다. g^\hat{\mathbf g}는 NN개의 기울기라는 유한 모집단에서 되돌려 넣지 않고 뽑은 표본평균이다.

명제 8.1 (미니배치 기울기의 평균과 공분산) g1,…,gN\mathbf g_1,\dots,\mathbf g_N의 평균을 gˉ=∇L\bar{\mathbf g}=\nabla L, 공분산을 Σ=1N∑(gi−gˉ)(gi−gˉ)′\Sigma=\tfrac1N\sum(\mathbf g_i-\bar{\mathbf g})(\mathbf g_i-\bar{\mathbf g})\T라 하면, 크기 BB의 단순무작위 배치에 대해

Eg^=∇L,Cov⁡(g^)=ΣB⋅N−BN−1.E\hat{\mathbf g}=\nabla L,\qquad\Cov(\hat{\mathbf g})=\frac\Sigma B\cdot\frac{N-B}{N-1}.

증명 IiI_i를 ii가 배치에 들어가는 사건의 지시변수라 하면 g^=1B∑iIigi\hat{\mathbf g}=\tfrac1B\sum_iI_i\mathbf g_i, EIi=BNEI_i=\tfrac BN이므로 평균이 나온다. ∑Ii=B\sum I_i=B가 상수이므로 gi\mathbf g_i를 g~i=gi−gˉ\tilde{\mathbf g}_i=\mathbf g_i-\bar{\mathbf g}로 바꿔도 공분산은 같다. Var⁡Ii=BN(1−BN)\Var I_i=\tfrac BN(1-\tfrac BN), i≠ji\ne j이면 Cov⁡(Ii,Ij)=−Var⁡IiN−1\Cov(I_i,\allowbreak I_j)=-\tfrac{\Var I_i}{N-1}이다(Var⁡∑Ii=0\Var\sum I_i=0에서). 3회 정리 4.2로

Cov⁡(g^)=Var⁡I1B2[∑ig~ig~i′−1N−1∑i≠jg~ig~j′]=Var⁡I1B2[NΣ+NΣN−1],\Cov(\hat{\mathbf g})=\frac{\Var I_1}{B^2}\Bigl[\sum_i\tilde{\mathbf g}_i\tilde{\mathbf g}_i\T-\frac1{N-1}\sum_{i\ne j}\tilde{\mathbf g}_i\tilde{\mathbf g}_j\T\Bigr]=\frac{\Var I_1}{B^2}\Bigl[N\Sigma+\frac{N\Sigma}{N-1}\Bigr],

∑i≠jg~ig~j′=(∑g~i)(∑g~i)′−∑g~ig~i′=−NΣ\sum_{i\ne j}\tilde{\mathbf g}_i\tilde{\mathbf g}_j\T=(\sum\tilde{\mathbf g}_i)(\sum\tilde{\mathbf g}_i)\T-\sum\tilde{\mathbf g}_i\tilde{\mathbf g}_i\T=-N\Sigma이기 때문이다. 정리하면 결론이다.

N−BN−1\tfrac{N-B}{N-1}은 4회 정리 1.5의 유한 모집단 수정 그대로다. B≪NB\ll N이면 무시되고, 다변량 중심극한정리로 g^≈N(∇L,Σ/B)\hat{\mathbf g}\approx\N(\nabla L,\allowbreak \Sigma/B)이다. 그러면 SGD의 한 단계는

θ←θ−η∇L+ηξ,ξ≈N(0,Σ/B)\boldsymbol\theta\leftarrow\boldsymbol\theta-\eta\nabla L+\eta\boldsymbol\xi,\qquad\boldsymbol\xi\approx\N(\mathbf 0,\Sigma/B)

곧 경사하강에 정규 잡음을 더한 것이다. 잡음의 세기를 정하는 것은 η\eta와 BB 따로가 아니라 대략 비 η/B\eta/B다(Mandt, Hoffman, Blei 2017; Smith와 Le 2018). 배치를 kk배로 키울 때 학습률도 kk배로 키우라는 선형 스케일링 규칙(Goyal 외, 2017)이 여기서 나온다. 노트북의 선형회귀(N=2000N=2000)에서 기울기 공분산의 대각합은 B=8,64,512B=8,64,512에서 이론값 2.19, 0.266, 0.02562.19,\ 0.266,\ 0.0256과 맞고, B=512B=512에서는 유한 모집단 수정이 없으면 0.03440.0344로 34% 틀린다.

가정 주의 정규 잡음이라는 근사는 개별 기울기의 분산이 유한하다는 가정 위에 있다. 깊은 신경망의 기울기 잡음이 꼬리가 두꺼운 안정분포에 가깝다는 관찰(Simsekli 외, 2019)과 보통의 배치 크기에서는 정규에 가깝다는 반론이 함께 있다. 7절의 그림이 둘 중 어느 쪽이냐에 따라 달라진다.
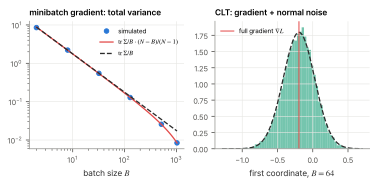
그림 8.1. 왼쪽: 미니배치 기울기 공분산의 대각합(점)과 명제 8.1(실선). 점선은 유한 모집단 수정이 없는 trΣ/B. 오른쪽: 한 좌표의 미니배치 기울기(B=64)의 히스토그램과 정규 근사.
그림 8.1 왼쪽: 미니배치 기울기 공분산의 대각합(점)과 명제 8.1(실선). 점선은 유한 모집단 수정이 없는 tr Σ/B\mathrm{tr}\,\Sigma/B. 오른쪽: 한 좌표의 미니배치 기울기(B=64B=64)의 히스토그램과 정규 근사.

8.2 MC dropout — 예측을 여러 번 평균하기 ​

드롭아웃은 학습 중에 뉴런을 확률 qq로 끈다. Gal과 Ghahramani(2016)는 예측할 때도 드롭아웃을 켜고 같은 입력을 TT번 통과시키자고 했다. 출력 f1(x),…,fT(x)f_1(x),\dots,f_T(x)는 무작위 마스크에 대한 iid 표본이므로 그 평균은 기대 예측 Emf(x;m)E_mf(x;m)의 Monte Carlo 추정이고, 표본표준편차는 예측의 흔들림, 곧 모형의 불확실성을 나타낸다. 이 해석이 근사적인 베이즈 추론이라는 논증은 16회에서 본다. 여기서 중요한 것은 정리 6.1다. 평균의 Monte Carlo 오차는 s/Ts/\sqrt T이므로 T=100T=100이면 불확실성의 10%가 계산 자체의 잡음이다. 불확실성의 크기를 말하려면 그것을 재는 계산의 오차부터 알아야 한다.

8.3 대각합을 무작위로 — Hutchinson 추정량 ​

큰 행렬 AA의 대각합 trA\mathrm{tr}A가 필요하지만 AA를 만들 수는 없고 곱 AzA\mathbf z만 계산할 수 있는 경우가 많다(신경망의 헤시안, 연속 정규화 흐름의 야코비안, 점수 맞추기의 발산). Hutchinson(1989)의 방법은 무작위 벡터 하나로 대각합을 추정한다.

명제 8.2 (Hutchinson 추정량) Ez=0E\mathbf z=\mathbf 0, Ezz′=IE\mathbf z\mathbf z\T=I이면 E z′Az=trAE\,\mathbf z\T A\mathbf z=\mathrm{tr}A이다. AA가 대칭일 때

  1. (a)

    ziz_i가 iid Rademacher(±1\pm1이 반반)이면 Var⁡ z′Az=2(∥A∥F2−∑iaii2)\Var\,\mathbf z\T A\mathbf z=2\bigl(\|A\|_F^2-\sum_ia_{ii}^2\bigr),

  2. (b)

    z∼N(0,I)\mathbf z\sim\N(\mathbf 0,I)이면 Var⁡ z′Az=2∥A∥F2\Var\,\mathbf z\T A\mathbf z=2\|A\|_F^2.

증명 Ez′Az=∑i,jaijEzizj=∑iaiiE\mathbf z\T A\mathbf z=\sum_{i,j}a_{ij}Ez_iz_j=\sum_ia_{ii}. (a) zi2=1z_i^2=1이므로 z′Az=trA+∑i≠jaijzizj\mathbf z\T A\mathbf z=\mathrm{tr}A+\sum_{i\ne j}a_{ij}z_iz_j이고, E(zizjzkzl)E(z_iz_jz_kz_l) (i≠ji\ne j, k≠lk\ne l)은 {k,l}={i,j}\{k,l\}=\{i,j\}일 때만 1이다. 따라서 분산은 ∑i≠jaij(aij+aji)=2∑i≠jaij2\sum_{i\ne j}a_{ij}(a_{ij}+a_{ji})=2\sum_{i\ne j}a_{ij}^2. (b)는 연습 8.4.

Rademacher가 대각 성분만큼 분산이 작다. mm개의 탐침을 평균하면 분산이 1/m1/m로 줄고, 정리 6.1로 오차 막대를 함께 낸다. 노트북의 30×3030\times30 대칭행렬에서 탐침 하나의 분산의 이론값은 Rademacher 872, 정규 916이고, 시뮬레이션이 이를 확인한다.

연습문제

연습 8.1 (지시변수의 공분산 ★★) 명제 8.1의 증명에서 Cov⁡(Ii,Ij)=−B(N−B)N2(N−1)\Cov(I_i,\allowbreak I_j)=-\tfrac{B(N-B)}{N^2(N-1)}을 P(Ii=Ij=1)=B(B−1)N(N−1)P(I_i=I_j=1)=\tfrac{B(B-1)}{N(N-1)}로 직접 확인하라.

풀이

Cov⁡(Ii,Ij)=B(B−1)N(N−1)−B2N2=B[N(B−1)−B(N−1)]N2(N−1)=B(B−N)N2(N−1)\Cov(I_i,\allowbreak I_j)=\tfrac{B(B-1)}{N(N-1)}-\tfrac{B^2}{N^2}=\tfrac{B[N(B-1)-B(N-1)]}{N^2(N-1)}=\tfrac{B(B-N)}{N^2(N-1)}.

연습 8.2 (선형 스케일링 ★) B=256B=256, η=0.1\eta=0.1로 학습하던 모형을 B=8192B=8192로 옮긴다. 잡음의 세기 η/B\eta/B를 유지하는 학습률은? 한 에폭의 단계 수는 몇 배가 되나?

풀이

BB가 32배이므로 η=3.2\eta=3.2. 한 에폭의 단계 수는 132\tfrac1{32}이다. 실제로는 처음 몇 에폭 동안 학습률을 서서히 올린다(warm-up). 큰 학습률에서는 ηΣ/B\eta\Sigma/B의 정규 근사와 1차 전개가 함께 무너지기 때문이다.

연습 8.3 (몇 번 통과시키나 ★) MC dropout에서 예측 평균의 Monte Carlo 오차를 예측 표준편차의 5% 이하로 하려면 TT는 얼마여야 하나?

풀이

s/T≤0.05ss/\sqrt T\le0.05s에서 T≥400T\ge400.

연습 8.4 (정규 탐침의 분산 ★★★) z∼N(0,I)\mathbf z\sim\N(\mathbf 0,I)이고 AA가 대칭이면 A=QΛQ′A=Q\Lambda Q\T로 대각화해 z′Az=∑iλiWi2\mathbf z\T A\mathbf z=\sum_i\lambda_iW_i^2 (Wi∼iidN(0,1)W_i\iid\N(0,1))임을 보이고(5회 정리 3.8), Var⁡=2∑λi2=2∥A∥F2\Var=2\sum\lambda_i^2=2\|A\|_F^2을 유도하라.

풀이

A=QΛQ′A=Q\Lambda Q\T이면 z′Az=w′Λw\mathbf z\T A\mathbf z=\mathbf w\T\Lambda\mathbf w, w=Q′z∼N(0,Q′Q)=N(0,I)\mathbf w=Q\T\mathbf z\sim\N(\mathbf0,\allowbreak Q\T Q)=\N(\mathbf0,\allowbreak I)(5회 정리 3.8). 따라서 ∑λiWi2\sum\lambda_iW_i^2이고 Wi2W_i^2은 독립인 χ2(1)\chi^2(1)(분산 2)이므로 분산은 2∑λi2=2 tr(A2)=2∥A∥F22\sum\lambda_i^2=2\,\mathrm{tr}(A^2)=2\|A\|_F^2.

연습 8.5 (탐침의 수 ★★) Rademacher 탐침 mm개로 trA\mathrm{tr}A를 상대오차 1%(표준오차 기준)로 추정하려면 m≥2(∥A∥F2−∑aii2)(0.01 trA)2m\ge\tfrac{2(\|A\|_F^2-\sum a_{ii}^2)}{(0.01\,\mathrm{tr}A)^2}이어야 함을 보여라. A=IdA=I_d이면? AA가 양의 정부호이고 고윳값이 고르면 mm은 차원 dd에 대해 어떻게 변하나?

풀이

mm개 평균의 표준오차는 2(∥A∥F2−∑aii2)/m\sqrt{2(\|A\|_F^2-\sum a_{ii}^2)/m}이므로 이것이 0.01∣trA∣0.01|\mathrm{tr}A| 이하인 조건이 식이다. A=IdA=I_d이면 비대각 성분이 없어 분산이 0이고 m=1m=1로 정확하다. 고윳값이 모두 λ\lambda 근처이면 trA≈dλ\mathrm{tr}A\approx d\lambda, ∥A∥F2≈dλ2\|A\|_F^2\approx d\lambda^2이므로 m≳2dλ210−4d2λ2=2×10⁴dm\gtrsim\tfrac{2d\lambda^2}{10^{-4}d^2\lambda^2}=\tfrac{2\times10^4}d로, 차원이 클수록 탐침이 적게 필요하다. 대각합은 많은 항의 합이어서 상대오차가 저절로 줄기 때문이다.

이 회차에서 읽은 절 0개 · 회차 차례