Skip to content

8회 · 추론의 기초 · 노트

1 통계량과 순서통계량 — 독일 전차 문제 ​

1.1 통계량 ​

정의 1.1 (통계량과 추정량) 자료 X\X의 함수로서 모르는 모수에 의존하지 않는 것 T=T(X)T=T(\X)를 통계량이라 한다. 모수 θ\theta(또는 그 함수)를 어림하려고 쓰는 통계량을 추정량, 그 관측값을 추정값이라 한다. EθT=θE_\theta T=\theta가 모든 θ\theta에서 성립하면 TT는 불편이고, Tn→PθT_n\xrightarrow{P}\theta가 모든 θ\theta에서 성립하면 일치한다.

Xˉ\bar X, S2S^2, 표본중앙값은 통계량이다. 6회의 T=Xˉ−μS/nT=\tfrac{\bar X-\mu}{S/\sqrt n}은 μ\mu를 포함하므로 통계량이 아니라 축량이다. 추정량의 좋고 나쁨을 재는 기준(평균제곱오차, 효율)은 9회와 11회에서 다룬다. 이 절은 그 재료인 순서통계량을 준비한다.

1.2 순서통계량의 분포 ​

정리 1.2 (순서통계량의 결합밀도) X1,…,XnX_1,\dots,X_n이 밀도 ff를 갖는 iid이면 순서통계량의 벡터 (X(1),…,X(n))(X_{(1)},\dots,X_{(n)})은 다음 결합밀도를 갖는다.

g(y1,…,yn)=n! ∏i=1nf(yi),y1<y2<⋯<yng(y_1,\dots,y_n)=n!\,\prod_{i=1}^nf(y_i),\qquad y_1<y_2<\cdots<y_n

그 밖에서 g=0g=0이다.

증명 전략 순서통계량이 집합 A⊂{y1<⋯<yn}A\subset\{y_1<\cdots<y_n\}에 들어가는 사건을 “어느 XiX_i가 몇 번째로 작은가”에 따라 n!n!개의 서로소인 조각으로 나눈다. iid이므로 조각마다 확률이 같다.

  1. i≠ji\ne j이면 P(Xi=Xj)=∫P(Xj=x)f(x) dx=0P(X_i=X_j)=\int P(X_j=x)f(x)\,dx=0이다. 따라서 확률 1로 X1,…,XnX_1,\dots,X_n은 모두 다르다.독립, 1회 정리 6.7(b)

  2. 순열 π\pi마다 Eπ={Xπ(1)<⋯<Xπ(n)}E_\pi=\{X_{\pi(1)}<\cdots<X_{\pi(n)}\}로 두면 EπE_\pi들은 쌍마다 서로소이고, 확률 0인 사건을 빼면 합집합이 Ω\Omega이다. EπE_\pi 위에서 (X(1),…,X(n))=(Xπ(1),…,Xπ(n))(X_{(1)},\allowbreak \dots,\allowbreak X_{(n)})=(X_{\pi(1)},\allowbreak \dots,\allowbreak X_{\pi(n)})이다.1, 원소 추적 [T1]

  3. AA의 점은 성분이 증가하므로 {(Xπ(1),…,Xπ(n))∈A}⊂Eπ\{(X_{\pi(1)},\allowbreak \dots,\allowbreak X_{\pi(n)})\in A\}\subset E_\pi이고

    P((X(1),…,X(n))∈A)=∑πP((Xπ(1),…,Xπ(n))∈A).P\bigl((X_{(1)},\dots,X_{(n)})\in A\bigr)=\sum_\pi P\bigl((X_{\pi(1)},\dots,X_{\pi(n)})\in A\bigr) .
    2, 유한가법성
  4. iid이므로 순서를 바꾼 벡터 (Xπ(1),…,Xπ(n))(X_{\pi(1)},\dots,X_{\pi(n)})도 결합밀도 ∏if(yi)\prod_if(y_i)를 갖고, 각 항은 ∫A∏if(yi) dy\int_A\prod_if(y_i)\,d\mathbf y이다.독립, 곱은 순서와 무관

  5. 항이 n!n!개이므로 P((X(1),…,X(n))∈A)=∫An!∏if(yi) dyP\bigl((X_{(1)},\allowbreak \dots,\allowbreak X_{(n)})\in A\bigr)=\int_An!\prod_if(y_i)\,d\mathbf y이고, 이것이 밀도의 정의다.밀도의 정의

따름정리 1.3 (kk번째 순서통계량) 분포함수가 FF이면 X(k)X_{(k)}의 밀도는

f(k)(x)=n!(k−1)! (n−k)! F(x)k−1(1−F(x))n−kf(x).f_{(k)}(x)=\frac{n!}{(k-1)!\,(n-k)!}\,F(x)^{k-1}\bigl(1-F(x)\bigr)^{n-k}f(x).

증명 전략 X(k)≤xX_{(k)}\le x는 “xx 이하인 관측이 kk개 이상”과 같으므로 분포함수가 이항분포의 꼬리다. 그것을 xx로 미분하면 합의 항들이 차례로 지워지고 한 항만 남는다. 단계별 증명은 연습 1.6(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

밀도의 모양은 셈으로 읽힌다. xx 근처에 하나(f(x)f(x)), 그 아래에 k−1k-1개(Fk−1F^{k-1}), 위에 n−kn-k개((1−F)n−k(1-F)^{n-k})가 있고, 누가 어디에 있을지의 경우의 수가 다항계수다. k=nk=n이 3회 예제 3.5의 최댓값이다.

1.3 표본분위수의 점근정규성 ​

정리 1.4 (표본분위수) 0<p<10<p<1이고 FF가 분위수 ξp=F−1(p)\xi_p=F^{-1}(p) 근처에서 연속인 밀도 ff를 가지며 f(ξp)>0f(\xi_p)>0이면, kn/n→pk_n/n\to p이고 kn=np+o(n)k_n=np+o(\sqrt n)인 knk_n에 대해

n(X(kn)−ξp) →D N(0, p(1−p)f(ξp)2).\sqrt n\bigl(X_{(k_n)}-\xi_p\bigr)\ \xrightarrow{D}\ \N\Bigl(0,\ \frac{p(1-p)}{f(\xi_p)^2}\Bigr).

증명 전략 균등분포에서 먼저 증명한다. U(k)≤uU_{(k)}\le u는 “uu 이하인 관측의 수”라는 이항 사건이므로 이항분포의 정규근사로 극한을 구한다. 그다음 X(k)=F−1(U(k))X_{(k)}=F^{-1}(U_{(k)})에 델타 방법을 쓴다.

1단계: 균등분포

  1. Ui∼iidU(0,1)U_i\iid\mathrm U(0,1), xx를 고정하고 pn=p+xnp_n=p+\tfrac x{\sqrt n}, Bn=#{i:Ui≤pn}∼b(n,pn)B_n=\#\{i:U_i\le p_n\}\sim\mathrm b(n,\allowbreak p_n)으로 두면 {U(kn)≤pn}={Bn≥kn}\{U_{(k_n)}\le p_n\}=\{B_n\ge k_n\}이다.kk번째로 작은 값이 tt 이하   ⟺  \iff tt 이하가 kk개 이상 [T1]

  2. qn=1−pnq_n=1-p_n, Zn=Bn−npnnpnqnZ_n=\tfrac{B_n-np_n}{\sqrt{np_nq_n}}, cn=kn−npnnpnqnc_n=\tfrac{k_n-np_n}{\sqrt{np_nq_n}}이면 P(n(U(kn)−p)≤x)=P(Zn≥cn)P\bigl(\sqrt n(U_{(k_n)}-p)\le x\bigr)=P(Z_n\ge c_n)이다.1, 표준화

  3. kn−npn=(kn−np)−xn=−xn+o(n)k_n-np_n=(k_n-np)-x\sqrt n=-x\sqrt n+o(\sqrt n)이므로 cn→−x/pqc_n\to-x/\sqrt{pq}이다.kn=np+o(n)k_n=np+o(\sqrt n) [T8]

  4. pn→p∈(0,1)p_n\to p\in(0,1)이므로 sup⁡t∣P(Zn<t)−Φ(t)∣≤C/n\sup_t|P(Z_n<t)-\Phi(t)|\le C/\sqrt n인 상수 CC가 nn에 관계없이 있다.Berry–Esseen, 7회 3.2절의 상자

  5. 3 4와 Φ\Phi의 연속성으로 P(Zn≥cn)→1−Φ(−x/pq)=Φ(x/pq)P(Z_n\ge c_n)\to1-\Phi(-x/\sqrt{pq})=\Phi(x/\sqrt{pq}), 곧 n(U(kn)−p)→DN(0,pq)\sqrt n(U_{(k_n)}-p)\xrightarrow{D}\N(0,\allowbreak pq)이다.분포수렴의 정의

2단계: 역함수

  1. F−1F^{-1}은 비감소이므로 순서를 보존하고, (F−1(U1),…,F−1(Un))(F^{-1}(U_1),\allowbreak \dots,\allowbreak F^{-1}(U_n))은 (X1,…,Xn)(X_1,\dots,X_n)과 분포가 같다. 따라서 X(kn)X_{(k_n)}과 F−1(U(kn))F^{-1}(U_{(k_n)})은 분포가 같다.2회 정리 4.7

  2. ff가 ξp\xi_p 근처에서 연속이고 양수이므로 FF는 그 근처에서 순증가하고 미분가능하며, F−1F^{-1}은 pp에서 미분계수 1f(ξp)\tfrac1{f(\xi_p)}를 갖는다.역함수의 미분

  3. 1단계와 2에 델타 방법을 쓰면 n(F−1(U(kn))−ξp)→DN(0,pqf(ξp)2)\sqrt n\bigl(F^{-1}(U_{(k_n)})-\xi_p\bigr)\xrightarrow{D}\N\bigl(0,\allowbreak \tfrac{pq}{f(\xi_p)^2}\bigr)이다.7회 정리 4.4

조건 확인 Berry–Esseen 한계의 상수는 E∣ξ−pn∣3/(pnqn)3/2E|\xi-p_n|^3/(p_nq_n)^{3/2}에 비례한다(ξ∼\xi\sim 베르누이(pn)(p_n)). pnqn→pq>0p_nq_n\to pq>0이므로 이 양은 nn에 대해 유계이고, 4의 고른 한계가 정당하다. 2단계의 델타 방법은 F−1F^{-1}이 pp에서 미분가능하기만 하면 된다.

예제 1.5 (표본중앙값) p=12p=\tfrac12이면 표본중앙값의 점근분산은 14nf(m)2\tfrac1{4nf(m)^2}이다(7회 연습 7.3에서 받아들였던 식). 정규 N(μ,σ2)\N(\mu,\sigma^2)이면 f(μ)=1σ2πf(\mu)=\tfrac1{\sigma\sqrt{2\pi}}이므로 πσ22n\tfrac{\pi\sigma^2}{2n}, 평균의 σ2n\tfrac{\sigma^2}n보다 1.57배 크다. Laplace 분포(밀도 12be−∣x−μ∣/b\tfrac1{2b}e^{-|x-\mu|/b}, 분산 2b22b^2)이면 b2n\tfrac{b^2}n으로 평균의 2b2n\tfrac{2b^2}n보다 작다. 꼬리가 두꺼우면 중앙값이 평균을 이긴다. 5회 1절에서 Laplace 오차의 가능도가 중앙값에서 최대였던 것과 같은 이야기다.
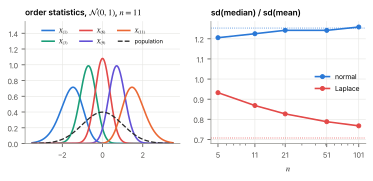
그림 1.1. 왼쪽: 정규 표본 n=11의 순서통계량 X_(1),X_(3),X_(6),X_(9),X_(11)의 밀도(따름정리 1.3). 오른쪽: 표본중앙값과 표본평균의 표준편차의 비 ×√n — 정규(파랑)에서는 sqrtπ/2=1.25로 평균이 낫고, Laplace(빨강)에서는 1/√2=0.71로 중앙값이 낫다.
그림 1.1 왼쪽: 정규 표본 n=11n=11의 순서통계량 X(1),X(3),X(6),X(9),X(11)X_{(1)},\allowbreak X_{(3)},\allowbreak X_{(6)},\allowbreak X_{(9)},\allowbreak X_{(11)}의 밀도(따름정리 1.3). 오른쪽: 표본중앙값과 표본평균의 표준편차의 비 ×n\times\sqrt n — 정규(파랑)에서는 π/2=1.25\sqrt{\pi/2}=1.25로 평균이 낫고, Laplace(빨강)에서는 1/2=0.711/\sqrt2=0.71로 중앙값이 낫다.

1.4 독일 전차 문제 ​

역사 2차 대전 중 연합군은 노획한 독일 전차의 바퀴와 변속기에 찍힌 일련번호로 독일의 월 생산량을 추정했다. Ruggles와 Brodie(1947)의 보고에 따르면 1940년 6월의 생산량을 정보기관은 1,000대, 통계적 추정은 169대로 보았고, 전후에 확인한 독일 기록은 122대였다. 1941년 6월에는 정보기관 1,550대, 통계 244대, 기록 271대였다. 첩보보다 일련번호의 최댓값이 훨씬 정확했다.

전차에 1,2,…,N1,2,\dots,N의 일련번호가 있고, 그 가운데 kk대를 되돌려 넣지 않고 무작위로 노획했다고 하자. NN을 어떻게 추정할까? 노획한 번호의 최댓값 MM은 NN 이하이므로 NN을 작게 어림한다. 얼마나 작은지는 계산할 수 있다.

정리 1.6 (최댓값의 기댓값과 불편추정량) {1,…,N}\{1,\dots,N\}에서 kk개를 되돌려 넣지 않고 뽑은 최댓값 MM에 대해

P(M=m)=(m−1k−1)(Nk)(m=k,…,N),EM=k(N+1)k+1.P(M=m)=\frac{\binom{m-1}{k-1}}{\binom Nk}\quad(m=k,\dots,N),\qquad EM=\frac{k(N+1)}{k+1}.

따라서 N^=k+1kM−1\hat N=\dfrac{k+1}kM-1은 NN의 불편추정량이다.

증명 전략 최댓값이 mm인 표본을 세어 분포를 얻는다. 기댓값의 합은 m(m−1k−1)=k(mk)m\binom{m-1}{k-1}=k\binom mk로 바꿔 하키스틱 항등식의 꼴로 만든다.

  1. (Nk)\binom Nk개의 표본이 같은 확률이다. 최댓값이 mm이려면 mm을 뽑고 나머지 k−1k-1개를 {1,…,m−1}\{1,\dots,m-1\}에서 뽑아야 하므로 P(M=m)=(m−1k−1)/(Nk)P(M=m)=\binom{m-1}{k-1}/\binom Nk이다.1회 따름정리 4.10, 정리 1.4

  2. m(m−1k−1)=m!(k−1)! (m−k)!=k(mk)m\binom{m-1}{k-1}=\tfrac{m!}{(k-1)!\,(m-k)!}=k\binom mk이다.계승으로 정리

  3. 따라서

    EM=1(Nk)∑m=kNm(m−1k−1)=k(Nk)∑m=kN(mk)=k(N+1k+1)(Nk)=k(N+1)k+1.\begin{align*} EM&=\frac1{\binom Nk}\sum_{m=k}^Nm\binom{m-1}{k-1}=\frac{k}{\binom Nk}\sum_{m=k}^N\binom mk \tag*{\htmlClass{reason}{\text{\htmlClass{sref}{\text{1}}\,\htmlClass{sref}{\text{2}}}}}\\ &=\frac{k\binom{N+1}{k+1}}{\binom Nk}=\frac{k(N+1)}{k+1} . \tag*{\htmlClass{reason}{\text{하키스틱, 연습~\href{/read/08/1#ex-hockey}{1.3}}}} \end{align*}
  4. EN^=k+1kEM−1=NE\hat N=\tfrac{k+1}kEM-1=N이다.기댓값의 선형성

N^=M+Mk−1\hat N=M+\tfrac Mk-1은 “관측한 최댓값에 번호 사이의 평균 간격만큼 더한다”로 읽힌다. 같은 문제를 적률법으로 풀면 EXˉ=N+12E\bar X=\tfrac{N+1}2에서 2Xˉ−12\bar X-1이 나온다. 둘 다 불편이지만 분산이 다르다. Var⁡N^=(N+1)(N−k)k(k+2)\Var\hat N=\tfrac{(N+1)(N-k)}{k(k+2)}이고 Var⁡(2Xˉ−1)=(N+1)(N−k)3k\Var(2\bar X-1)=\tfrac{(N+1)(N-k)}{3k}이므로(연습 1.4) 최댓값 쪽이 k+23\tfrac{k+2}3배 정확하다. N=300N=300, k=5k=5이면 표준편차가 50과 77이다. 11회에서 N^\hat N이 모든 불편추정량 가운데 분산이 가장 작음(UMVUE)을 증명하고, 15회에서는 부트스트랩이 바로 이 최댓값에서 실패함을 본다.

연습문제

연습 1.1 (최솟값과 범위 ★) U(0,1)\mathrm U(0,1) 표본에서 X(1)X_{(1)}과 X(n)X_{(n)}의 결합밀도를 정리 1.2를 적분해 구하고, 범위 R=X(n)−X(1)R=X_{(n)}-X_{(1)}이 Beta(n−1,2)\mathrm{Beta}(n-1,2)임을 보여라.

풀이

정리 1.2의 밀도 n!n!을 가운데 n−2n-2개의 좌표에 대해 y1<y2<⋯<yn−1<yny_1<y_2<\cdots<y_{n-1}<y_n 위에서 적분하면 (X(1),X(n))(X_{(1)},X_{(n)})의 결합밀도는 n(n−1)(v−u)n−2n(n-1)(v-u)^{n-2} (0<u<v<10<u<v<1)이다(가운데 n−2n-2개가 (u,v)(u,v)에 있는 부피 (v−u)n−2(n−2)!\tfrac{(v-u)^{n-2}}{(n-2)!}). R=V−UR=V-U, W=UW=U로 바꾸면(야코비안 1) f(r,w)=n(n−1)rn−2f(r,w)=n(n-1)r^{n-2}, 0<w<1−r0<w<1-r이고, ww로 적분하면 fR(r)=n(n−1)rn−2(1−r)f_R(r)=n(n-1)r^{n-2}(1-r), 곧 Beta(n−1,2)\mathrm{Beta}(n-1,2).

연습 1.2 (지수 표본의 간격 ★★) Exp(1)\mathrm{Exp}(1) 표본의 간격 Di=X(i)−X(i−1)D_i=X_{(i)}-X_{(i-1)} (X(0)=0X_{(0)}=0)에 대해 (n−i+1)Di(n-i+1)D_i가 iid Exp(1)\mathrm{Exp}(1)임을 보여라. (힌트: 결합밀도 n! e−∑yin!\,e^{-\sum y_i}에서 ∑yi=∑i(n−i+1)di\sum y_i=\sum_i(n-i+1)d_i.) 따라서 EX(k)=∑i=1k1n−i+1EX_{(k)}=\sum_{i=1}^k\tfrac1{n-i+1}.

풀이

yi=∑j≤idjy_i=\sum_{j\le i}d_j로 바꾸면 야코비안이 1이고 ∑iyi=∑i(n−i+1)di\sum_iy_i=\sum_i(n-i+1)d_i이므로 결합밀도는 n!exp⁡(−∑(n−i+1)di)=∏i(n−i+1)e−(n−i+1)din!\exp\bigl(-\sum(n-i+1)d_i\bigr)=\prod_i(n-i+1)e^{-(n-i+1)d_i} (di>0d_i>0)이다. 인수분해되므로 DiD_i는 독립이고 Di∼ExpD_i\sim\mathrm{Exp} (비율 n−i+1n-i+1), 곧 (n−i+1)Di∼Exp(1)(n-i+1)D_i\sim\mathrm{Exp}(1). 3회 예제 3.5의 “최솟값은 비율 nλn\lambda의 지수”를 되풀이한 것이다. EX(k)=∑i≤kEDiEX_{(k)}=\sum_{i\le k}ED_i.

연습 1.3 (하키스틱 항등식 ★) ∑m=kN(mk)=(N+1k+1)\sum_{m=k}^N\binom mk=\binom{N+1}{k+1}을 “{1,…,N+1}\{1,\dots,N+1\}에서 k+1k+1개를 고를 때 가장 큰 수가 m+1m+1”로 나누어 세어 보여라.

풀이

{1,…,N+1}\{1,\dots,N+1\}에서 k+1k+1개를 고르는 방법 (N+1k+1)\binom{N+1}{k+1}가지를 가장 큰 수 m+1m+1 (m=k,…,Nm=k,\dots,N)로 나누면, 나머지 kk개를 {1,…,m}\{1,\dots,m\}에서 고르는 (mk)\binom mk가지씩이다.

연습 1.4 (전차 추정량의 분산 ★★★) E[M(M+1)]=k(N+1)(N+2)k+2E[M(M+1)]=\tfrac{k(N+1)(N+2)}{k+2}을 정리 1.6의 증명과 같은 방법(m(m+1)(m−1k−1)=k(k+1)(m+1k+1)m(m+1)\binom{m-1}{k-1}=k(k+1)\binom{m+1}{k+1})으로 보이고, Var⁡N^=(N+1)(N−k)k(k+2)\Var\hat N=\tfrac{(N+1)(N-k)}{k(k+2)}을 유도하라. 4회 정리 1.5(초기하의 분산, 유한 모집단 수정)로 Var⁡(2Xˉ−1)=(N+1)(N−k)3k\Var(2\bar X-1)=\tfrac{(N+1)(N-k)}{3k}도 보여라.

풀이

m(m+1)(m−1k−1)=(m+1)!(k−1)!(m−k)!=k(k+1)(m+1k+1)m(m+1)\binom{m-1}{k-1}=\tfrac{(m+1)!}{(k-1)!(m-k)!}=k(k+1)\binom{m+1}{k+1}이고 하키스틱으로 ∑m=kN(m+1k+1)=(N+2k+2)\sum_{m=k}^N\binom{m+1}{k+1}=\binom{N+2}{k+2}이므로 E[M(M+1)]=k(k+1)(N+2k+2)(Nk)=k(N+1)(N+2)k+2E[M(M+1)]=\tfrac{k(k+1)\binom{N+2}{k+2}}{\binom Nk}=\tfrac{k(N+1)(N+2)}{k+2}. 따라서

Var⁡M=E[M(M+1)]−EM−(EM)2=k(N+1)(N−k)(k+1)2(k+2),Var⁡N^=(k+1k)2Var⁡M=(N+1)(N−k)k(k+2).\begin{align*} \Var M&=E[M(M+1)]-EM-(EM)^2=\frac{k(N+1)(N-k)}{(k+1)^2(k+2)},\\ \Var\hat N&=\Bigl(\frac{k+1}k\Bigr)^2\Var M=\frac{(N+1)(N-k)}{k(k+2)} . \end{align*}

한편 {1,…,N}\{1,\dots,N\}의 분산은 N2−112\tfrac{N^2-1}{12}이고, 비복원 표본평균의 분산은 4회 정리 1.5의 유한 모집단 수정으로 N2−112k⋅N−kN−1=(N+1)(N−k)12k\tfrac{N^2-1}{12k}\cdot\tfrac{N-k}{N-1}=\tfrac{(N+1)(N-k)}{12k}. 4배 하면 Var⁡(2Xˉ−1)\Var(2\bar X-1). N=300N=300, k=5k=5이면 표준편차 50.4와 76.9(시뮬레이션 50.3, 77.0).

연습 1.5 (Laplace에서 중앙값 ★★) 정리 1.4로 Laplace 분포에서 표본중앙값의 점근분산이 b2n\tfrac{b^2}n임을 보이고, 평균과의 효율비를 구하라. t(3)t(3)이면?

풀이

Laplace의 중앙값 μ\mu에서 f(μ)=12bf(\mu)=\tfrac1{2b}이므로 점근분산 14nf2=b2n\tfrac1{4nf^2}=\tfrac{b^2}n. 평균의 분산 2b2n\tfrac{2b^2}n의 절반이다. 중앙값이 평균보다 두 배 효율적이다. t(3)t(3)이면 f(0)=Γ(2)3πΓ(3/2)=0.368f(0)=\tfrac{\Gamma(2)}{\sqrt{3\pi}\Gamma(3/2)}=0.368이므로 중앙값의 분산은 1.85n\tfrac{1.85}n, 평균의 분산은 Var⁡Tn=3n\tfrac{\Var T}n=\tfrac3n이다. 중앙값이 1.62배 효율적이다.

연습 1.6 (kk번째 순서통계량의 밀도 ★★ 유도형) 따름정리 1.3를 다음 순서로 증명하라.

  1. (a)

    {X(k)≤x}\{X_{(k)}\le x\}가 “xx 이하인 XiX_i가 kk개 이상”과 같음을 보이고, P(X(k)≤x)=∑j=kn(nj)F(x)j(1−F(x))n−jP(X_{(k)}\le x)=\sum_{j=k}^n\binom njF(x)^j\bigl(1-F(x)\bigr)^{n-j}을 얻어라.

  2. (b)

    j(nj)=n(n−1j−1)j\binom nj=n\binom{n-1}{j-1}, (n−j)(nj)=n(n−1j)(n-j)\binom nj=n\binom{n-1}j를 써서 (a)를 xx로 미분한 식이 다음과 같음을 보여라.

    nf(x)∑j=kn[(n−1j−1)Fj−1(1−F)n−j−(n−1j)Fj(1−F)n−1−j]nf(x)\sum_{j=k}^n\Bigl[\tbinom{n-1}{j-1}F^{j-1}(1-F)^{n-j}-\tbinom{n-1}{j}F^{j}(1-F)^{n-1-j}\Bigr]
  3. (c)

    (b)의 합에서 이웃한 항이 지워져 j=kj=k의 첫 항만 남음을 보이고 따름정리의 식을 얻어라.

  4. (d)

    다른 길로도 같은 식이 나온다. U(k)∼Beta(k,n−k+1)U_{(k)}\sim\mathrm{Beta}(k,\allowbreak n-k+1)(4회 예제 4.4)과 X(k)=F−1(U(k))X_{(k)}=F^{-1}(U_{(k)})에 단조변환의 밀도(2회 정리 4.3)를 쓰면 같은 식이 나옴을 확인하라.

풀이

(a) X(k)≤xX_{(k)}\le x이면 X(1),…,X(k)X_{(1)},\dots,X_{(k)}이 모두 xx 이하이므로 xx 이하인 관측이 kk개 이상이다. 거꾸로 xx 이하인 관측이 kk개 이상이면 kk번째로 작은 값은 xx 이하다. xx 이하인 관측의 수는 b(n,F(x))\mathrm b(n,F(x))이므로 P(X(k)≤x)=∑j=kn(nj)Fj(1−F)n−jP(X_{(k)}\le x)=\sum_{j=k}^n\binom njF^j(1-F)^{n-j}이다.

(b) FF가 미분가능한 점에서 ddxFj(1−F)n−j=f[jFj−1(1−F)n−j−(n−j)Fj(1−F)n−j−1]\tfrac{d}{dx}F^j(1-F)^{n-j}=f\bigl[jF^{j-1}(1-F)^{n-j}-(n-j)F^j(1-F)^{n-j-1}\bigr]이다. 여기에 (nj)\binom nj를 곱하고 j(nj)=n(n−1j−1)j\binom nj=n\binom{n-1}{j-1}, (n−j)(nj)=n(n−1j)(n-j)\binom nj=n\binom{n-1}j를 쓰면 주어진 식이다. (j=nj=n이면 둘째 항은 (n−1n)=0\binom{n-1}n=0이다.)

(c) aj=(n−1j−1)Fj−1(1−F)n−ja_j=\binom{n-1}{j-1}F^{j-1}(1-F)^{n-j}로 두면 둘째 항은 aj+1a_{j+1}이다. 합은 ∑j=kn(aj−aj+1)=ak−an+1=ak\sum_{j=k}^n(a_j-a_{j+1})=a_k-a_{n+1}=a_k (an+1=0a_{n+1}=0)이므로

f(k)(x)=n(n−1k−1)Fk−1(1−F)n−kf=n!(k−1)! (n−k)!F(x)k−1(1−F(x))n−kf(x).f_{(k)}(x)=n\binom{n-1}{k-1}F^{k-1}(1-F)^{n-k}f=\frac{n!}{(k-1)!\,(n-k)!}F(x)^{k-1}\bigl(1-F(x)\bigr)^{n-k}f(x) .

(d) Ui=F(Xi)U_i=F(X_i)가 아니라 Xi=F−1(Ui)X_i=F^{-1}(U_i)로 표본을 만들면(2회 정리 4.7) F−1F^{-1}이 비감소이므로 X(k)=F−1(U(k))X_{(k)}=F^{-1}(U_{(k)})이다. U(k)U_{(k)}의 밀도 n!(k−1)!(n−k)!uk−1(1−u)n−k\tfrac{n!}{(k-1)!(n-k)!}u^{k-1}(1-u)^{n-k}에 단조변환의 밀도 공식을 쓰면 f(k)(x)=fBeta(F(x)) f(x)f_{(k)}(x)=f_{\mathrm{Beta}}(F(x))\,f(x)로 같은 식이다.

이 회차에서 읽은 절 0개 · 회차 차례