
테마
15회 · 가정이 틀리면 · 노트
0 들어가며
여는 질문. Cavendish(1798)는 지구의 밀도를, Michelson(1879)은 빛의 속도를, Newcomb(1882)은 빛이 7.4 km를 왕복하는 시간을 쟀다. 오늘 우리는 참값을 안다. 그들의 평균은 얼마나 틀렸나? 큰 오차에 덜 흔들리는 다른 추정량을 썼다면 더 맞았을까? 그리고 정규분포를 믿지 않을 때, 그 추정량의 오차는 무엇으로 재는가?
13회의 와 , 14회의 분산분석은 오차가 정규분포를 따른다고 가정했다. 정규분포는 계산을 아름답게 만든다. 그러나 1950년대의 통계학자들은 그 가정이 얼마나 위험한지 하나씩 드러냈다. 측정에는 가끔 엉뚱하게 큰 오차가 섞인다. 11회에서 본 Newcomb의 측정 66개 가운데 두 개가 그랬다. 평균은 그런 오차 하나에 끌려가고, 표준편차는 더 크게 끌려간다. 분포의 꼴을 모르면 분포의 임계값도 근거를 잃는다.
통계학은 세 가지로 답했다. 첫째는 순위다. Frank Wilcoxon(1945)은 관측값 대신 순위를 쓰면 귀무가설 아래의 분포가 자료의 분포와 무관해진다는 것을 보였다. 둘째는 로버스트 추정이다. John Tukey(1960)는 정규분포에 아주 조금만 다른 분포가 섞여도 평균이 최선의 자리를 잃는다는 것을 보였고, Peter Huber(1964)는 그런 섞임에 가장 강한 추정량을 찾았다. 셋째는 부트스트랩이다. Bradley Efron(1979)은 모르는 분포를 자료의 경험분포로 바꾸고 컴퓨터로 다시 뽑아, 거의 모든 추정량의 표준오차와 신뢰구간을 구했다.
이 노트는 그 순서를 따른다. 1절은 순열검정과 Wilcoxon의 순위검정, 2절은 그 효율(Pitman, Hodges–Lehmann의 0.864)을 증명한다. 3절은 M-추정, 영향함수, 붕괴점을, 4절은 참값이 알려진 역사적 측정으로 로버스트 추정량을 시험한 Stigler(1977)를 재현한다. 5절은 부트스트랩, 6절은 로버스트 회귀, 7절은 부트스트랩과 순위검정이 실패하는 곳, 8절은 bagging과 신경망의 Huber 손실이다.
학습 목표
- 1.
교환가능성에서 순열검정의 정확성을 보이고, Wilcoxon 순위합·부호순위 통계량의 귀무분포와 적률을 증명한다.
- 2.
Pitman 효율 을 유도하고, Hodges–Lehmann의 하한 를 증명한다.
- 3.
M-추정량의 점근분산, 영향함수, 붕괴점을 계산하고 Huber 추정량을 구현한다.
- 4.
경험분포와 plug-in 원리로 부트스트랩을 정의하고, 평균에서 그 일치성을 증명하며 BCa 구간을 계산한다.
- 5.
참값이 알려진 측정으로 추정량들을 비교하고, 부트스트랩이 실패하는 경우와 bagging·Huber 손실 속의 같은 생각을 안다.
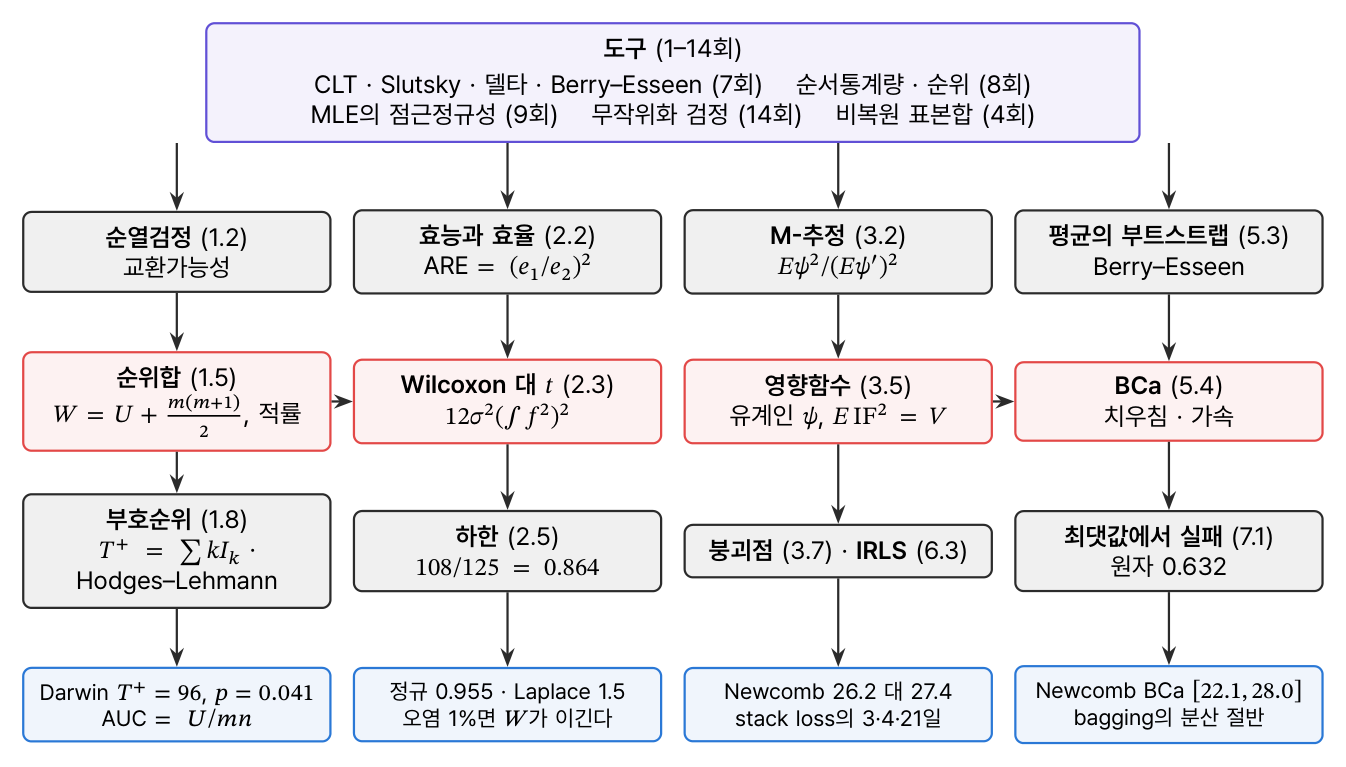
0.1 1–14회에서 가져오는 것
0.2 표기
표본 은 분포함수 , 밀도 에서 온다. 경험분포함수는 , 곧 각 관측에 확률 을 주는 분포다. 순서통계량은 이다. 추정량을 분포의 함수 로 보면(평균 , 중앙값 ) 표본의 추정량은 이다. 이것을 plug-in 추정량이라 한다.