
테마
15회 · 가정이 틀리면 · 노트
8 오늘 — bagging과 Huber 손실
8.1 Bagging과 random forest
Leo Breiman(1996)은 부트스트랩을 추정량의 오차를 재는 데가 아니라 예측기를 만드는 데 썼다. 부트스트랩 표본마다 예측기를 학습하고 그 예측을 평균한다. bagging(bootstrap aggregating)이다.
명제 8.1 (평균한 예측기의 분산) 예측값 가 같은 분산 과 쌍마다 같은 상관 를 가지면 이다.
증명 를 정리한다(3회 8절).
부트스트랩 표본들은 같은 자료에서 왔으므로 가 0이 아니다. 그래서 를 늘려도 분산은 밑으로 내려가지 않는다. Breiman(2001)의 random forest는 나무마다 쓸 수 있는 변수를 무작위로 제한해 를 줄인다. 이득이 큰 것은 결정 나무처럼 자료가 조금 바뀌면 예측이 크게 바뀌는 “불안정한” 예측기다.
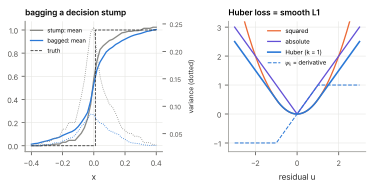
예제 8.2 (결정 그루터기) , 인 자료 100개에 분기 하나짜리 나무(그루터기)를 맞추고 에서 예측한다. 자료를 200번 새로 만들면 그루터기 예측의 분산은 0.131, 부트스트랩 50번으로 bagging한 예측의 분산은 0.068로 절반쯤이 된다. 대신 평균은 0.86에서 0.77로 참값 1에서 조금 더 멀어진다. 분기점 근처에서 bagging은 계단을 매끄러운 경사로 바꾼다. 분산이 크게 줄고 치우침이 조금 는다.
부트스트랩 표본마다 뽑히지 않은 약 36.8%의 관측(연습 5.3)은 그 나무의 검증 자료로 쓸 수 있다. 이것이 out-of-bag 오차이고, 교차검증 없이 일반화 오차를 추정한다.
8.2 Huber 손실과 smooth L1
신경망의 회귀 손실로 널리 쓰이는 Huber 손실과 객체 검출의 smooth L1 손실(Girshick 2015)은 Huber(1964)의 그대로다.
명제 8.3 (Huber 손실의 세 얼굴) (), ()에 대해
- (a)
이다. 경사하강의 한 걸음은 잔차를 로 자른 것을 쓴다.
- (b)
이다. 큰 잔차를 “이상치 몫” 와 “정상 몫” 로 나누어, 이상치 몫에는 절댓값 벌점을 준 것이다.
- (c)
smooth L1 손실 (), (그 밖)은 다.
증명 전략 (a)는 구간마다 미분하고 에서 양쪽 도함수가 같음을 확인한다. (b)는 에 대한 최소화를 의 부호로 나눠 푼다. (c)는 두 식을 구간마다 비교한다. 단계별 증명은 연습 8.3(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.
(b)의 는 16회에서 볼 lasso와 같은 연성 임계값이다. 로버스트 회귀는 “관측마다 이상치 몫이 있을 수 있고, 그 몫은 드물다(희소하다)”고 가정한 lasso와 같다. 경사 자르기(gradient clipping)도 같은 생각이다. 한 미니배치의 큰 기울기가 학습을 끌고 가지 못하게 자른다.
연습문제
연습 8.1 (상관이 남기는 분산 ★) , 이면 에서 명제 8.1의 분산은 얼마인가?
풀이
: 이면 1, 10이면 0.46, 100이면 0.406, 이면 0.4.
연습 8.2 (연성 임계값 ★★) 명제 8.3(b)의 최소화를 , , 의 경우로 나눠 풀어라.
풀이
이면 미분해 이고 일 때만 양수다. 이면 이고 일 때만 음수다. 나머지 경우()는 이 최소다. 값은 에서 , 에서 .
연습 8.3 (Huber 손실의 세 얼굴: 증명 ★ 유도형) 명제 8.3를 증명하라.
- (a)
와 에서 을 구하고, 에서 왼쪽과 오른쪽 도함수가 같아 가 미분가능함을 보여라. 를 확인하라.
- (b)
연습 8.2의 결과 를 에 넣어 를 얻어라.
- (c)
가 아니라 가 smooth L1 손실임을 와 에서 각각 확인하라.
풀이
(a) 에서 , 에서 , 에서 이다. 에서 왼쪽 도함수는 , 오른쪽 도함수도 이고 에서도 둘 다 이므로 는 미분가능하고 이다. (b) 를 넣는다. 이면 이고 값은 다. 이면 이고 값은 다. 도 대칭이다. (c) 이면 이고, 이면 이다. 둘 다 smooth L1의 식이다. 는 첫 구간에서 가 되어 맞지 않는다.