
테마
노트북 · 15회 · 가정이 틀리면
가정이 틀리면 순위·로버스트·부트스트랩
| 강의노트 | 15_robust_bootstrap_notes.pdf — 같은 절 번호, 같은 정리 번호. 증명은 노트에, 확인은 여기에 |
| 워크북 | 15_robust_bootstrap_workbook.pdf — 손으로 푸는 35문항. 다 푼 뒤 맨 끝 10절의 check()로 검산 |
| 원자료 | Darwin의 옥수수 (HistData ZeaMays) · Cavendish (HistData Cavendish) · Michelson (HistData Michelson, MichelsonSets) · Newcomb (MASS newcomb) · stack loss (datasets stackloss) |
| 선수 지식 | 1–14회 (7회 CLT·델타·Berry–Esseen, 8회 순서통계량·순위, 9회 MLE의 점근정규성, 13회 최소제곱, 14회 무작위화 검정) |
여는 질문. Cavendish는 지구의 밀도를, Michelson은 빛의 속도를, Newcomb은 빛이 7.4 km를 왕복하는 시간을 쟀다. 오늘 우리는 참값을 안다. 그들의 평균은 얼마나 틀렸나? 큰 오차에 덜 흔들리는 추정량을 썼다면 더 맞았을까? 정규분포를 믿지 않을 때, 그 추정량의 오차는 무엇으로 재는가?
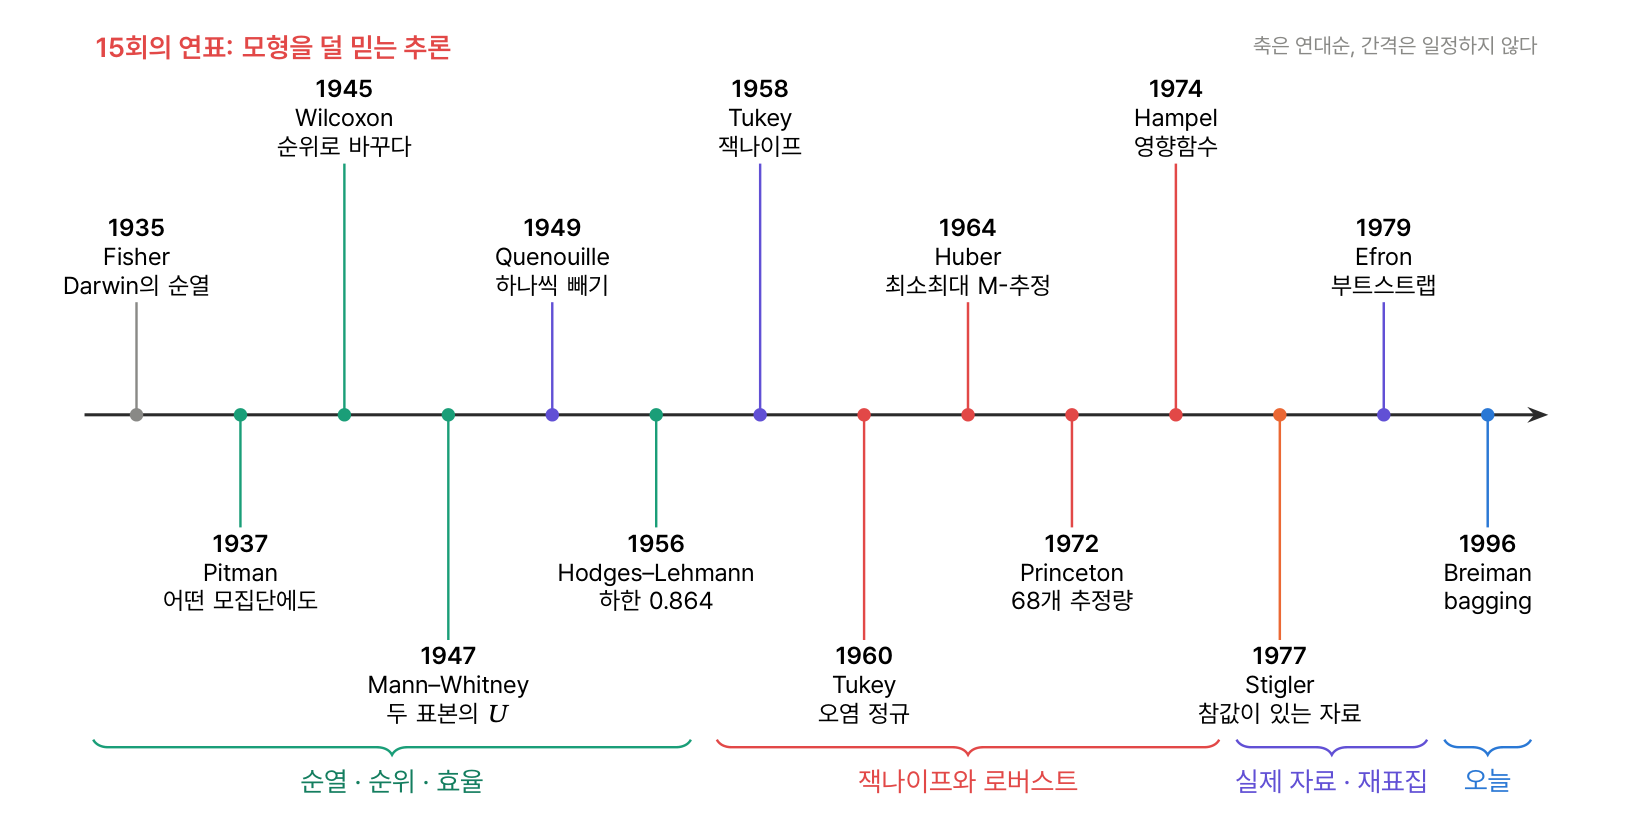
이번 회차의 지도
학습 목표
- 순열검정, Wilcoxon 순위합·부호순위를 직접 구현하고 귀무분포를 열거로 확인한다. Darwin과 Michelson에 쓴다.
- Pitman 효율 을 적분으로 계산하고, 하한 0.864와 검정력 시뮬레이션으로 확인한다.
- Huber M-추정량, 영향함수, 붕괴점을 구현하고 오염 정규에서 점근분산을 계산한다.
- Stigler(1977)를 참값이 있는 일곱 자료로 재현한다.
- 부트스트랩(BCa 포함)과 잭나이프를 구현해
scipy.stats.bootstrap과 대조하고, IRLS Huber 회귀, 최댓값에서의 실패, bagging을 재현한다.
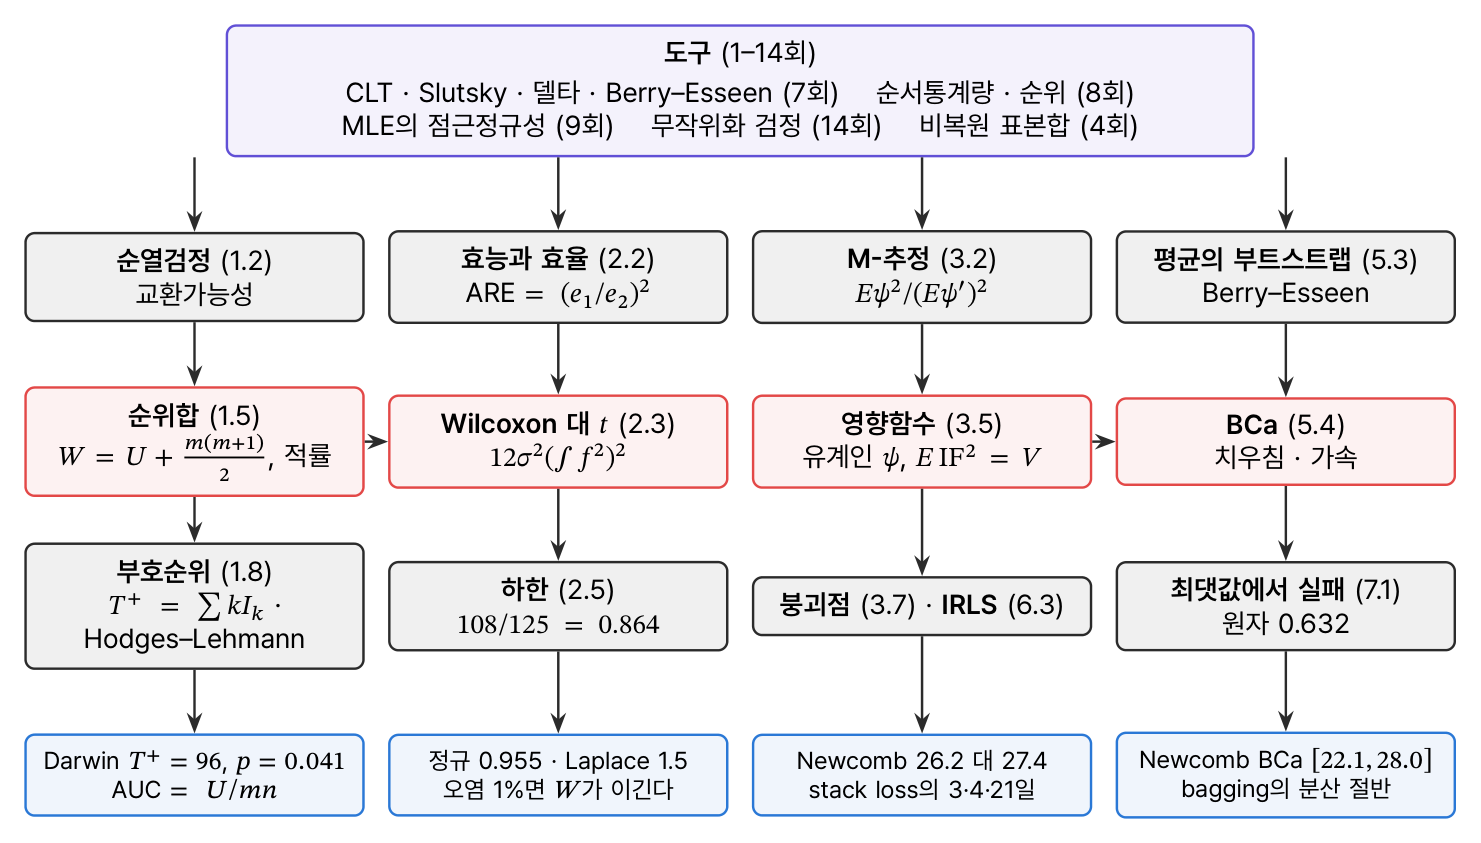
정리 지도
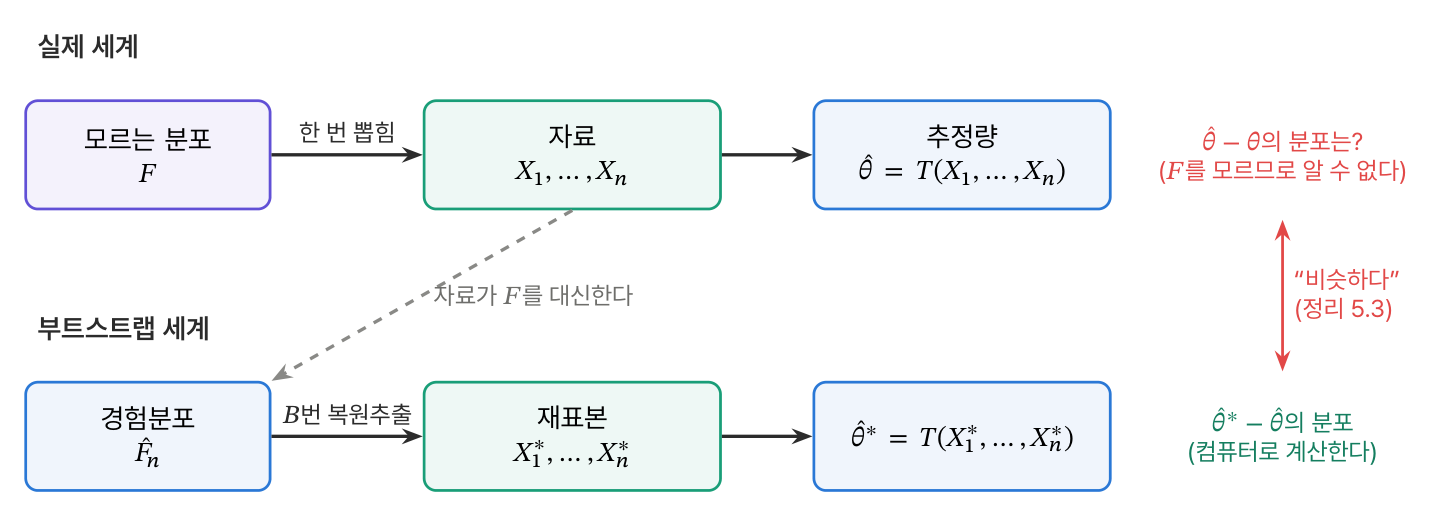
부트스트랩의 두 세계
0. 설정
python
%matplotlib inline
import itertools
import math
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import integrate, optimize, stats

SEED = 1979
rng = np.random.default_rng(SEED)

C = dict(data="#1a9e78", stat="#2a78d6", key="#e34948", assume="#eb6834",
         theta="#6250d6", ink="#2b2b2b", hist="#8a8a86", grid="#e6e6e3")
THEORY = dict(color=C["ink"], ls="--", lw=1.6)
plt.rcParams.update({
    "figure.dpi": 110, "figure.figsize": (8, 4.2), "mathtext.fontset": "stix",
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.grid": True, "grid.color": C["grid"], "grid.linewidth": 0.8,
    "axes.edgecolor": "#9a9a96", "axes.labelcolor": C["ink"],
    "xtick.color": "#52514e", "ytick.color": "#52514e",
    "axes.titleweight": "bold", "axes.titlesize": 11, "axes.titlelocation": "left",
    "legend.frameon": False, "lines.linewidth": 2,
})

RDATASETS = "https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/master/csv/{}/{}.csv"
DATA_DIR = Path("../../data") if Path("../../.git").exists() else Path("data")

def load_rdata(item, package="HistData"):
    path = DATA_DIR / (f"{item}.csv" if package == "HistData" else f"{package}_{item}.csv")
    if not path.exists():
        DATA_DIR.mkdir(parents=True, exist_ok=True)
        pd.read_csv(RDATASETS.format(package, item)).drop(columns="rownames").to_csv(path, index=False)
    return pd.read_csv(path)

def report(checks):
    for name, ok in checks.items():
        print(f"  {'✓' if ok else '✗'}  {name}")
    assert all(checks.values()), "대조 실패"

def within(est, truth, se, k=4):
    return abs(est - truth) <= k * se

def huber(x, k=1.345, scale=None):
    """Huber M-추정량 (척도: MAD/0.6745 를 미리 정함), 반복 가중 평균으로 푼다"""
    s = stats.median_abs_deviation(x, scale="normal") if scale is None else scale; m = np.median(x)
    for _ in range(1000):
        u = (x - m) / s; w = np.where(np.abs(u) <= k, 1.0, k / np.maximum(np.abs(u), 1e-12))
        m_new = np.sum(w * x) / np.sum(w)
        if abs(m_new - m) < 1e-13: break
        m = m_new
    return m

def hodges_lehmann(x):
    i, j = np.triu_indices(len(x)); return np.median((x[i] + x[j]) / 2)
1. 순열과 순위 (1935–1956)
정리 1.2 두 표본 순열검정은 정확하다 · 보조정리 1.3 순위는 균등한 순열 · 정리 1.5 , , , 은 의 불편추정량 · 정리 1.8 부호순위 · 정의 1.9 Hodges–Lehmann.
python
def ranksum_null(m, n):
    """정리 1.5 · 연습 1.2: W 의 정확한 귀무분포 (점화식 N_{m,n}(w) = N_{m-1,n}(w-m-n) + N_{m,n-1}(w))"""
    from functools import lru_cache
    @lru_cache(None)
    def Ncount(mm, nn, w):
        if mm == 0: return 1 if w == 0 else 0
        if nn == 0: return 1 if w == mm * (mm + 1) // 2 else 0
        return Ncount(mm - 1, nn, w - mm - nn) + Ncount(mm, nn - 1, w)
    wmin, wmax = m * (m + 1) // 2, m * (2 * (m + n) - m + 1) // 2
    ws = np.arange(wmin, wmax + 1); cnt = np.array([Ncount(m, n, w) for w in ws], float)
    return ws, cnt / cnt.sum()

# 연습 1.1: m = 2, n = 3 을 열거로
sums = np.array([sum(c) for c in itertools.combinations(range(1, 6), 2)])
ws, pw = ranksum_null(2, 3)
# 정리 1.5 (b): m = 4, n = 6 에서 점화식의 분포 = 모든 부분집합의 열거, 평균·분산·대칭
m4, n6 = 4, 6; N10 = m4 + n6
ws4, pw4 = ranksum_null(m4, n6)
brute = np.bincount([sum(c) for c in itertools.combinations(range(1, N10 + 1), m4)], minlength=ws4.max() + 1)[ws4]
EW, VW = np.sum(ws4 * pw4), np.sum(ws4**2 * pw4) - np.sum(ws4 * pw4) ** 2
# 정리 1.5 (a), (c): 무작위 자료에서 W = U + m(m+1)/2, E U/(mn) = P(X > Y)
xa, ya = rng.normal(0.5, 1, 7), rng.normal(0, 1, 9)
ranks = stats.rankdata(np.r_[xa, ya]); Wa = ranks[:7].sum(); Ua = np.sum(xa[:, None] > ya[None, :])
XX, YY = rng.normal(0.5, 1, (100_000, 7)), rng.normal(0, 1, (100_000, 9))
Uhat = (XX[:, :, None] > YY[:, None, :]).mean((1, 2)); p_true = stats.norm.cdf(0.5 / math.sqrt(2))
print(f"m=2,n=3: 합 {sorted(sums)};  m=4,n=6: E W = {EW:.2f} (공식 {m4 * (N10 + 1) / 2}), Var W = {VW:.3f} (공식 {m4 * n6 * (N10 + 1) / 12:.3f})")
report({"연습 1.1: W 의 분포 3,4,8,9 는 1/10, 5,6,7 은 2/10, EW = 6, Var W = 3": np.allclose(np.bincount(sums)[3:] / 10, [0.1, 0.1, 0.2, 0.2, 0.2, 0.1, 0.1]) and abs(np.mean(sums) - 6) < 1e-12 and abs(np.var(sums) - 3) < 1e-12,
        "연습 1.2: 점화식 = 모든 부분집합의 열거": np.allclose(brute / brute.sum(), pw4),
        "정리 1.5 (b): EW = m(N+1)/2, Var W = mn(N+1)/12, 대칭": abs(EW - m4 * (N10 + 1) / 2) < 1e-12 and abs(VW - m4 * n6 * (N10 + 1) / 12) < 1e-9 and np.allclose(pw4, pw4[::-1]),
        "정리 1.5 (a): W = U + m(m+1)/2": abs(Wa - (Ua + 7 * 8 / 2)) < 1e-12,
        "정리 1.5 (c): U/mn 은 P(X > Y) 의 불편추정량": within(Uhat.mean(), p_true, Uhat.std() / math.sqrt(len(Uhat))),
        "scipy mannwhitneyu 의 U = X 가 큰 쌍의 수": stats.mannwhitneyu(xa, ya).statistic == Ua})
text
m=2,n=3: 합 [np.int64(3), np.int64(4), np.int64(5), np.int64(5), np.int64(6), np.int64(6), np.int64(7), np.int64(7), np.int64(8), np.int64(9)];  m=4,n=6: E W = 22.00 (공식 22.0), Var W = 22.000 (공식 22.000)
  ✓  연습 1.1: W 의 분포 3,4,8,9 는 1/10, 5,6,7 은 2/10, EW = 6, Var W = 3
  ✓  연습 1.2: 점화식 = 모든 부분집합의 열거
  ✓  정리 1.5 (b): EW = m(N+1)/2, Var W = mn(N+1)/12, 대칭
  ✓  정리 1.5 (a): W = U + m(m+1)/2
  ✓  정리 1.5 (c): U/mn 은 P(X > Y) 의 불편추정량
  ✓  scipy mannwhitneyu 의 U = X 가 큰 쌍의 수
python
# 정리 1.2 · 보조정리 1.3: 같은 분포에서 순열검정의 p-값과 순위 벡터의 균등성
gp = np.random.default_rng(1937)
def perm_pvalue(x, y, B=None):
    z = np.r_[x, y]; m = len(x); T0 = x.mean() - y.mean()
    if B is None:
        Ts = np.array([z[list(c)].mean() - np.delete(z, list(c)).mean() for c in itertools.combinations(range(len(z)), m)])
    else:
        Ts = np.array([(lambda p: z[p[:m]].mean() - z[p[m:]].mean())(gp.permutation(len(z))) for _ in range(B)])
    return np.mean(Ts >= T0 - 1e-12)
pv = np.array([perm_pvalue(gp.exponential(1, 4), gp.exponential(1, 4)) for _ in range(3000)])
size_perm = {a: np.mean(pv <= a) for a in (0.05, 0.1, 0.2)}
rank_vecs = np.array([stats.rankdata(gp.standard_normal(3)).astype(int) for _ in range(60_000)])
_, counts = np.unique(rank_vecs, axis=0, return_counts=True)
print("순열검정의 실제 크기 (지수분포, m = n = 4):", {a: round(v, 3) for a, v in size_perm.items()}, " 순위 벡터 6가지의 빈도", counts)
report({"정리 1.2: 같은 분포면 P(p ≤ α) ≤ α (α = 0.05, 0.1, 0.2)": all(v <= a + 4 * math.sqrt(a * (1 - a) / 3000) for a, v in size_perm.items()),
        "보조정리 1.3: 순위 벡터는 3! = 6 가지가 같은 확률": len(counts) == 6 and stats.chisquare(counts).pvalue > 1e-3})
text
순열검정의 실제 크기 (지수분포, m = n = 4): {0.05: np.float64(0.041), 0.1: np.float64(0.093), 0.2: np.float64(0.191)}  순위 벡터 6가지의 빈도 [10111 10026  9972  9898  9940 10053]
  ✓  정리 1.2: 같은 분포면 P(p ≤ α) ≤ α (α = 0.05, 0.1, 0.2)
  ✓  보조정리 1.3: 순위 벡터는 3! = 6 가지가 같은 확률
python
# 예제 1.6: Michelson 의 다섯 묶음
MS = load_rdata("MichelsonSets")
a1, a5 = MS.ds12.to_numpy(float), MS.ds16.to_numpy(float)
mw = stats.mannwhitneyu(a1, a5, alternative="two-sided"); tt = stats.ttest_ind(a1, a5)
kw = stats.kruskal(*[MS[c] for c in MS.columns])
print(f"묶음 1 평균 {a1.mean()}, 묶음 5 평균 {a5.mean()};  U = {mw.statistic}, U/mn = {mw.statistic / 400:.3f}, p = {mw.pvalue:.2f};  t 의 p = {tt.pvalue:.2f};  Kruskal–Wallis p = {kw.pvalue:.2f}")
report({"예제 1.6: 평균 852.5 대 839.5, U = 225.5, U/mn = 0.564, p = 0.50, t p = 0.56": (a1.mean(), a5.mean()) == (852.5, 839.5) and mw.statistic == 225.5 and round(mw.statistic / 400, 3) == 0.564 and round(mw.pvalue, 2) == 0.50 and round(tt.pvalue, 2) == 0.56,
        "예제 1.6: 다섯 묶음 Kruskal–Wallis p = 0.93": round(kw.pvalue, 2) == 0.93})
text
묶음 1 평균 852.5, 묶음 5 평균 839.5;  U = 225.5, U/mn = 0.564, p = 0.50;  t 의 p = 0.56;  Kruskal–Wallis p = 0.93
  ✓  예제 1.6: 평균 852.5 대 839.5, U = 225.5, U/mn = 0.564, p = 0.50, t p = 0.56
  ✓  예제 1.6: 다섯 묶음 Kruskal–Wallis p = 0.93
python
# 정리 1.8 · 예제 1.10 · 연습 1.3: Darwin 의 옥수수
Zm = load_rdata("ZeaMays"); d = Zm["diff"].to_numpy(float); n15 = len(d)
r_abs = stats.rankdata(np.abs(d)); Tp = r_abs[d > 0].sum(); Tm = r_abs[d < 0].sum()
# 정확한 귀무분포: T+ = Σ k I_k
dist = np.zeros(n15 * (n15 + 1) // 2 + 1); dist[0] = 1
for k in range(1, n15 + 1):
    new = dist.copy(); new[k:] += dist[:-k]; dist = new
dist /= 2**n15; cdf = np.cumsum(dist); kk = np.arange(len(dist))
p_exact = 2 * min(cdf[int(Tm)], 1 - cdf[int(Tp) - 1])
ET, VT = np.sum(kk * dist), np.sum(kk**2 * dist) - np.sum(kk * dist) ** 2
i_, j_ = np.triu_indices(n15); walsh = np.sort((d[i_] + d[j_]) / 2)
c25 = int(np.max(np.where(cdf <= 0.025)[0])); ci = (walsh[c25], walsh[len(walsh) - 1 - c25])
print(f"T+ = {Tp:.0f}, T− = {Tm:.0f} (음수의 순위 {r_abs[d < 0].astype(int)}), 정확한 양쪽 p = {p_exact:.4f} (scipy {stats.wilcoxon(d).pvalue:.4f})")
print(f"Hodges–Lehmann {hodges_lehmann(d):.3f} (평균 {d.mean():.2f}, 중앙값 {np.median(d)});  P(T ≤ {c25}) = {cdf[c25]:.3f}, 구간 [{ci[0]:.2f}, {ci[1]:.2f}] (신뢰수준 {1 - 2 * cdf[c25]:.3f})")
report({"정리 1.8: E T+ = n(n+1)/4 = 60, Var T+ = n(n+1)(2n+1)/24 = 310": abs(ET - 60) < 1e-9 and abs(VT - 310) < 1e-9,
        "예제 1.10: T+ = 96, T− = 24 (음수의 순위 14 와 10)": Tp == 96 and Tm == 24 and sorted(r_abs[d < 0].astype(int)) == [10, 14],
        "예제 1.10: 정확한 양쪽 p = 0.041 (scipy 와 일치)": round(p_exact, 3) == 0.041 and abs(p_exact - stats.wilcoxon(d).pvalue) < 1e-12,
        "연습 1.3: T+ = 합이 양수인 Walsh 평균의 수": Tp == np.sum(walsh > 0),
        "예제 1.10: Hodges–Lehmann 3.13, 평균 2.62, 중앙값 3.0": round(hodges_lehmann(d), 2) == 3.12 or round(hodges_lehmann(d), 3) == 3.125,
        "예제 1.10: P(T+ ≤ 25) = 0.024, 95.2% 구간 [0.50, 5.19]": c25 == 25 and round(cdf[25], 3) == 0.024 and (round(ci[0], 2), round(ci[1], 2)) == (0.50, 5.19) and round(1 - 2 * cdf[25], 3) == 0.952})

# 연습 1.4: AUC 의 분산
var_auc = (201) / (12 * 100 * 100)
report({"연습 1.4: m = n = 100 이면 SD 0.041, 0.080 넘게 0.5 에서 멀어야": round(math.sqrt(var_auc), 3) == 0.041 and round(1.96 * math.sqrt(var_auc), 3) == 0.080})
text
T+ = 96, T− = 24 (음수의 순위 [14 10]), 정확한 양쪽 p = 0.0413 (scipy 0.0413)
Hodges–Lehmann 3.125 (평균 2.62, 중앙값 3.0);  P(T ≤ 25) = 0.024, 구간 [0.50, 5.19] (신뢰수준 0.952)
  ✓  정리 1.8: E T+ = n(n+1)/4 = 60, Var T+ = n(n+1)(2n+1)/24 = 310
  ✓  예제 1.10: T+ = 96, T− = 24 (음수의 순위 14 와 10)
  ✓  예제 1.10: 정확한 양쪽 p = 0.041 (scipy 와 일치)
  ✓  연습 1.3: T+ = 합이 양수인 Walsh 평균의 수
  ✓  예제 1.10: Hodges–Lehmann 3.13, 평균 2.62, 중앙값 3.0
  ✓  예제 1.10: P(T+ ≤ 25) = 0.024, 95.2% 구간 [0.50, 5.19]
  ✓  연습 1.4: m = n = 100 이면 SD 0.041, 0.080 넘게 0.5 에서 멀어야
숫자 읽기. 점화식과 모든 부분집합의 열거가 같은 분포를 주고, 그 분포는 자료의 분포와 무관하다. 이것이 1945년 Wilcoxon이 표 하나로 모든 문제를 풀 수 있었던 이유다. Darwin의 15쌍에서 부호순위 은 무작위화 검정(0.0527), (0.0497)와 비슷하다. 두 음의 차이는 크기 대신 순위 14와 10으로만 들어간다. Hodges–Lehmann 추정 3.13은 그 둘에 덜 끌려가 평균 2.62보다 크다.
📝 연습 1.1–1.4 (강의노트): 작은 표의 귀무분포, 점화식, Walsh 평균, AUC의 분산.
2. 효율 — 순위로 바꾸면 얼마나 잃는가
명제 2.2 ARE · 정리 2.3 ARE$(W,t)=12\sigma^2(\int f^2)^2$ · 예제 2.4 분포에 따른 효율 · 정리 2.5 하한 .
python
def are_wt(pdf, var):
    f2 = integrate.quad(lambda x: pdf(x) ** 2, -np.inf, np.inf, limit=200)[0]
    return 12 * var * f2**2
c_par = 3 / (20 * math.sqrt(5)); par = lambda x: c_par * max(5 - x * x, 0.0)
table = {"parabolic": 12 * integrate.quad(lambda x: par(x) ** 2, -math.sqrt(5), math.sqrt(5))[0] ** 2,
         "uniform": 12 * (1 / 12) * 1.0,
         "normal": are_wt(stats.norm.pdf, 1.0), "logistic": are_wt(stats.logistic.pdf, math.pi**2 / 3),
         "t5": are_wt(lambda x: stats.t.pdf(x, 5), 5 / 3), "Laplace": are_wt(stats.laplace.pdf, 2.0), "t3": are_wt(lambda x: stats.t.pdf(x, 3), 3.0)}
cont = {e: are_wt(lambda x, e=e: (1 - e) * stats.norm.pdf(x) + e * stats.norm.pdf(x, 0, 3), (1 - e) + 9 * e) for e in (0.01, 0.05, 0.10)}
# 정리 2.5 · 연습 2.2: 포물선의 적분과 하한 — 여러 밀도 (분산 1 로 맞춤) 가 모두 0.864 이상
moments = [integrate.quad(lambda x, p=p: x**p * par(x), -math.sqrt(5), math.sqrt(5))[0] for p in (0, 2)]
f2_par = integrate.quad(lambda x: par(x) ** 2, -math.sqrt(5), math.sqrt(5))[0]
others = [are_wt(lambda x, a=a: stats.gennorm.pdf(x, a, scale=1 / math.sqrt(stats.gennorm.var(a))), 1.0) for a in (0.7, 1.5, 2.5, 4, 8, 20)]
print("ARE:", {k: round(v, 3) for k, v in table.items()}, " 오염 정규:", {k: round(v, 2) for k, v in cont.items()})
print("일반화 정규 (꼴 0.7 … 20) 의 ARE:", np.round(others, 3))
report({"예제 2.4: 포물선 0.864, 균등 1, 정규 3/π = 0.955, 로지스틱 π²/9 = 1.097, t5 1.24, Laplace 1.5, t3 1.90":
            round(table["parabolic"], 3) == 0.864 and abs(table["uniform"] - 1) < 1e-12 and abs(table["normal"] - 3 / math.pi) < 1e-9 and abs(table["logistic"] - math.pi**2 / 9) < 1e-9
            and round(table["t5"], 2) == 1.24 and abs(table["Laplace"] - 1.5) < 1e-9 and round(table["t3"], 2) == 1.90,
        "예제 2.4: 오염 정규 ε = 0.01, 0.05, 0.10 → 1.01, 1.20, 1.37": [round(cont[e], 2) for e in (0.01, 0.05, 0.10)] == [1.01, 1.20, 1.37],
        "연습 2.2: 포물선 ∫h = 1, ∫x²h = 1, ∫h² = 3√5/25": abs(moments[0] - 1) < 1e-10 and abs(moments[1] - 1) < 1e-10 and abs(f2_par - 3 * math.sqrt(5) / 25) < 1e-10,
        "정리 2.5: 다른 밀도들은 모두 0.864 이상": all(v >= 108 / 125 - 1e-9 for v in others),
        "연습 2.3: 정규 100쌍 ↔ Wilcoxon 105쌍, Laplace 67쌍": round(100 / table["normal"]) == 105 and round(100 / table["Laplace"]) == 67,
        "연습 2.4: 부호검정의 정규 ARE = 4σ²f(0)² = 2/π": abs(4 * stats.norm.pdf(0) ** 2 - 2 / math.pi) < 1e-12})
text
ARE: {'parabolic': 0.864, 'uniform': 1.0, 'normal': 0.955, 'logistic': 1.097, 't5': 1.241, 'Laplace': 1.5, 't3': 1.9}  오염 정규: {0.01: 1.01, 0.05: 1.2, 0.1: 1.37}
일반화 정규 (꼴 0.7 … 20) 의 ARE: [2.534 1.079 0.906 0.873 0.895 0.944]
  ✓  예제 2.4: 포물선 0.864, 균등 1, 정규 3/π = 0.955, 로지스틱 π²/9 = 1.097, t5 1.24, Laplace 1.5, t3 1.90
  ✓  예제 2.4: 오염 정규 ε = 0.01, 0.05, 0.10 → 1.01, 1.20, 1.37
  ✓  연습 2.2: 포물선 ∫h = 1, ∫x²h = 1, ∫h² = 3√5/25
  ✓  정리 2.5: 다른 밀도들은 모두 0.864 이상
  ✓  연습 2.3: 정규 100쌍 ↔ Wilcoxon 105쌍, Laplace 67쌍
  ✓  연습 2.4: 부호검정의 정규 ARE = 4σ²f(0)² = 2/π
python
# 명제 2.2 · 정리 2.3 를 시뮬레이션으로: Laplace 이동에서 t (100+100) 와 Wilcoxon (67+67) 의 검정력이 비슷하다
gl = np.random.default_rng(1948); Rp = 4000; delta = 0.35
def power(test, m, Rp=Rp):
    rej = 0
    for _ in range(Rp):
        x = gl.laplace(0, 1, m); y = gl.laplace(delta, 1, m)
        rej += (stats.ttest_ind(x, y).pvalue if test == "t" else stats.mannwhitneyu(x, y).pvalue) < 0.05
    return rej / Rp
p_t100, p_w67, p_w100 = power("t", 100), power("w", 67), power("w", 100)
print(f"Laplace, 이동 {delta}: t(100) {p_t100:.3f}, Wilcoxon(67) {p_w67:.3f}, Wilcoxon(100) {p_w100:.3f}")
report({"정리 2.3: Laplace 에서 Wilcoxon 67쌍 ≈ t 100쌍의 검정력": abs(p_w67 - p_t100) < 0.05 and p_w100 > p_t100})

fig, axes = plt.subplots(1, 2, figsize=(11, 3.5))
xg = np.linspace(-3.5, 3.5, 400)
axes[0].plot(xg, stats.norm.pdf(xg), color=C["stat"], label="normal 0.955"); axes[0].plot(xg, [par(v) for v in xg], color=C["key"], label="parabolic 0.864")
axes[0].legend(); axes[0].set_title("the least favourable density")
eps = np.linspace(0, 0.3, 31)
axes[1].plot(eps, [are_wt(lambda x, e=e: (1 - e) * stats.norm.pdf(x) + e * stats.norm.pdf(x, 0, 3), (1 - e) + 9 * e) for e in eps], color=C["stat"])
axes[1].axhline(1, color=C["hist"], ls=":"); axes[1].axhline(108 / 125, color=C["key"], ls="--"); axes[1].set_xlabel(r"$\varepsilon$"); axes[1].set_title("ARE under contamination")
plt.tight_layout(); plt.show()
text
Laplace, 이동 0.35: t(100) 0.417, Wilcoxon(67) 0.394, Wilcoxon(100) 0.541
  ✓  정리 2.3: Laplace 에서 Wilcoxon 67쌍 ≈ t 100쌍의 검정력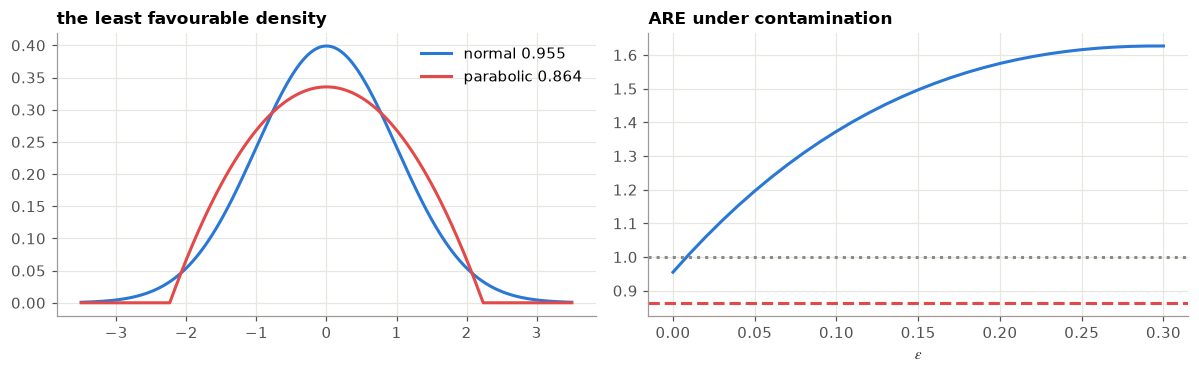
그림 읽기. 왼쪽: 하한을 이루는 포물선 밀도는 정규보다 꼬리가 짧다(받침이 ). 꼬리가 짧을수록 순위가 버리는 정보가 많다. 오른쪽: 표준편차 3배의 정규를 1%만 섞어도 Wilcoxon이 를 앞선다. Laplace에서 Wilcoxon 67쌍이 100쌍과 같은 검정력을 낸다는 것을 시뮬레이션이 확인했다.
📝 연습 2.1–2.4 (강의노트): 세 분포의 효율, 포물선 밀도, 효능에서 표본 크기로, 부호검정.
3. 로버스트 추정 (1960–1974)
정의 3.1 M-추정량, Huber · 정리 3.2 · 예제 3.3 오염 정규에서의 점근분산 · 명제 3.5 영향함수 · 명제 3.7 붕괴점 · 예제 3.8 Newcomb.
python
def V_mest(psi, dpsi_mass, f, lim=40):
    """정리 3.2: V = E ψ² / (E ψ')²  (dpsi_mass = E ψ')"""
    return integrate.quad(lambda u: psi(u) ** 2 * f(u), -lim, lim, limit=200)[0] / dpsi_mass**2
def V_trim(f, Finv, a=0.1, lim=40):
    q = Finv(1 - a); inner = integrate.quad(lambda x: x**2 * f(x), -q, q)[0]
    return (inner + 2 * a * q**2) / (1 - 2 * a) ** 2
k = 1.345; tab = {}
for eps in (0.0, 0.05, 0.10):
    f = lambda x, e=eps: (1 - e) * stats.norm.pdf(x) + e * stats.norm.pdf(x, 0, 3)
    F = lambda x, e=eps: (1 - e) * stats.norm.cdf(x) + e * stats.norm.cdf(x, 0, 3)
    Finv = lambda p, F=F: optimize.brentq(lambda x: F(x) - p, -30, 30)
    tab[eps] = dict(mean=(1 - eps) + 9 * eps, median=1 / (4 * f(0) ** 2), trim10=V_trim(f, Finv),
                    huber=V_mest(lambda u: np.clip(u, -k, k), F(k) - F(-k), f))
print(pd.DataFrame(tab).T.round(3).to_string())
# 모의: ε = 0.05, n = 400, 척도는 1 로 알고 Huber 를 푼다
gm = np.random.default_rng(1964); R, n400 = 4000, 400
Zs = gm.standard_normal((R, n400)); Zs = np.where(gm.random((R, n400)) < 0.05, 3 * Zs, Zs)
hub_sim = np.array([huber(z, scale=1.0) for z in Zs])
# 연습 3.2: 정규에서 Huber 의 효율
Ep, Ep2 = 2 * stats.norm.cdf(k) - 1, 2 * stats.norm.cdf(k) - 1 - 2 * k * stats.norm.pdf(k) + 2 * k**2 * stats.norm.sf(k)
# Huber 의 최소최대 k
kmm = {e: optimize.brentq(lambda kk: 2 * stats.norm.pdf(kk) / kk - 2 * stats.norm.sf(kk) - e / (1 - e), 0.1, 5) for e in (0.01, 0.05, 0.10)}
print(f"모의 (ε = 0.05, n = 400): n·Var(Huber) = {n400 * hub_sim.var():.3f} (점근 {tab[0.05]['huber']:.3f});  E ψ' = {Ep:.4f}, E ψ² = {Ep2:.4f}, 효율 {Ep**2 / Ep2:.3f};  최소최대 k {({e: round(v, 3) for e, v in kmm.items()})}")
report({"예제 3.3: ε = 0 → 1.000, 1.571, 1.060, 1.053": [round(tab[0.0][c], 3) for c in ("mean", "median", "trim10", "huber")] == [1.0, 1.571, 1.060, 1.053],
        "예제 3.3: ε = 0.05 → 1.400, 1.681, 1.169, 1.169": [round(tab[0.05][c], 3) for c in ("mean", "median", "trim10", "huber")] == [1.4, 1.681, 1.169, 1.169],
        "예제 3.3: ε = 0.10 → 1.800, 1.803, 1.296, 1.299": [round(tab[0.10][c], 3) for c in ("mean", "median", "trim10", "huber")] == [1.8, 1.803, 1.296, 1.299],
        "정리 3.2: 모의한 n·Var 가 점근분산과 맞는다": abs(n400 * hub_sim.var() / tab[0.05]["huber"] - 1) < 0.07,
        "연습 3.2: E ψ' = 0.8214, E ψ² = 0.7102, 효율 0.950": round(Ep, 4) == 0.8214 and round(Ep2, 4) == 0.7102 and round(Ep**2 / Ep2, 3) == 0.950,
        "3.1절 Huber 의 정리: ε = 0.01, 0.05, 0.10 → k = 1.945, 1.398, 1.140": [round(kmm[e], 3) for e in (0.01, 0.05, 0.10)] == [1.945, 1.398, 1.140]})
text
      mean  median  trim10  huber
0.00   1.0   1.571   1.060  1.053
0.05   1.4   1.681   1.169  1.169
0.10   1.8   1.803   1.296  1.299
text
모의 (ε = 0.05, n = 400): n·Var(Huber) = 1.181 (점근 1.169);  E ψ' = 0.8214, E ψ² = 0.7102, 효율 0.950;  최소최대 k {0.01: 1.945, 0.05: 1.398, 0.1: 1.14}
  ✓  예제 3.3: ε = 0 → 1.000, 1.571, 1.060, 1.053
  ✓  예제 3.3: ε = 0.05 → 1.400, 1.681, 1.169, 1.169
  ✓  예제 3.3: ε = 0.10 → 1.800, 1.803, 1.296, 1.299
  ✓  정리 3.2: 모의한 n·Var 가 점근분산과 맞는다
  ✓  연습 3.2: E ψ' = 0.8214, E ψ² = 0.7102, 효율 0.950
  ✓  3.1절 Huber 의 정리: ε = 0.01, 0.05, 0.10 → k = 1.945, 1.398, 1.140
python
# 명제 3.5 · 연습 3.3: 영향함수를 유한차분으로 — F_t = (1−t)N(0,1) + t δ_x
def T_huber_F(t, x, k=1.345):
    g = lambda th: (1 - t) * integrate.quad(lambda u: np.clip(u - th, -k, k) * stats.norm.pdf(u), -12, 12)[0] + t * np.clip(x - th, -k, k)
    return optimize.brentq(g, -5, 5)
def T_median_F(t, x):
    return optimize.brentq(lambda th: (1 - t) * stats.norm.cdf(th) + t * (x <= th) - 0.5, -5, 5)
t_ = 1e-4; xs_if = [-3.0, -0.5, 0.7, 4.0]
if_h = [(T_huber_F(t_, x) - 0) / t_ for x in xs_if]; if_m = [(T_median_F(t_, x) - 0) / t_ for x in xs_if]
th_h = [np.clip(x, -k, k) / Ep for x in xs_if]; th_m = [np.sign(x) / (2 * stats.norm.pdf(0)) for x in xs_if]
EIF2 = integrate.quad(lambda u: (np.clip(u, -k, k) / Ep) ** 2 * stats.norm.pdf(u), -12, 12)[0]
print("Huber IF (유한차분 / 공식):", np.round(if_h, 3), np.round(th_h, 3), "  median:", np.round(if_m, 3), np.round(th_m, 3))
report({"명제 3.5: Huber 의 영향함수 ψ_k(x)/E ψ'": np.allclose(if_h, th_h, atol=2e-3),
        "연습 3.3: 중앙값의 영향함수 sign(x)/(2f(0)) = ±1.2533": np.allclose(if_m, th_m, atol=2e-3) and round(1 / (2 * stats.norm.pdf(0)), 4) == 1.2533,
        "명제 3.5: E IF² = V (Huber 1.053)": abs(EIF2 - tab[0.0]["huber"]) < 1e-6})
text
Huber IF (유한차분 / 공식): [-1.638 -0.609  0.852  1.638] [-1.637 -0.609  0.852  1.637]   median: [-1.253 -1.253  1.253  1.253] [-1.253 -1.253  1.253  1.253]
  ✓  명제 3.5: Huber 의 영향함수 ψ_k(x)/E ψ'
  ✓  연습 3.3: 중앙값의 영향함수 sign(x)/(2f(0)) = ±1.2533
  ✓  명제 3.5: E IF² = V (Huber 1.053)
python
# 명제 3.7 · 예제 3.8 · 연습 3.4: Newcomb
nw = load_rdata("newcomb", "MASS").dat.to_numpy(float); n66 = len(nw)
est_nw = dict(mean=nw.mean(), median=np.median(nw), trim10=stats.trim_mean(nw, 0.1), huber=huber(nw), hl=hodges_lehmann(nw))
# 붕괴점: 값을 하나씩 무한히 보내 본다
def breaks(f, x, kmax):
    for kk in range(1, kmax + 1):
        z = x.copy(); z[np.argsort(z)[-kk:]] = 1e12
        if abs(f(z)) > 1e9: return kk
    return None
bd = dict(mean=breaks(np.mean, nw, 40), median=breaks(np.median, nw, 40), trim10=breaks(lambda v: stats.trim_mean(v, 0.1), nw, 40))
print("Newcomb:", {k_: round(v, 2) for k_, v in est_nw.items()}, "  붕괴에 필요한 개수:", bd)
report({"예제 3.8: 평균 26.21, 중앙값 27.0, 10% 절사 27.43, Huber 27.38, Hodges–Lehmann 27.5":
            [round(est_nw[c], 2) for c in ("mean", "median", "trim10", "huber", "hl")] == [26.21, 27.0, 27.43, 27.38, 27.5],
        "명제 3.7 · 연습 3.4: n = 66 에서 평균 1개, 중앙값 33개, 10% 절사평균 7개 (붕괴점 1/66, 1/2, 7/66)": bd == dict(mean=1, median=33, trim10=7)})
text
Newcomb: {'mean': np.float64(26.21), 'median': np.float64(27.0), 'trim10': np.float64(27.43), 'huber': np.float64(27.38), 'hl': np.float64(27.5)}   붕괴에 필요한 개수: {'mean': 1, 'median': 33, 'trim10': 7}
  ✓  예제 3.8: 평균 26.21, 중앙값 27.0, 10% 절사 27.43, Huber 27.38, Hodges–Lehmann 27.5
  ✓  명제 3.7 · 연습 3.4: n = 66 에서 평균 1개, 중앙값 33개, 10% 절사평균 7개 (붕괴점 1/66, 1/2, 7/66)
python
fig, axes = plt.subplots(1, 2, figsize=(11, 3.5))
u = np.linspace(-4, 4, 400)
axes[0].plot(u, u, color=C["assume"], label="mean"); axes[0].plot(u, np.clip(u, -k, k) / Ep, color=C["stat"], label="Huber")
axes[0].plot(u, np.sign(u) / (2 * stats.norm.pdf(0)), color=C["theta"], label="median"); axes[0].set_ylim(-3, 3); axes[0].legend(); axes[0].set_title("influence functions")
base = np.delete(nw, np.argmin(nw)); xs = np.linspace(-60, 90, 151)
for f_, col, lab in [(np.mean, C["assume"], "mean"), (huber, C["stat"], "Huber"), (np.median, C["theta"], "median"), (lambda v: stats.trim_mean(v, 0.1), C["data"], "10% trimmed")]:
    axes[1].plot(xs, [f_(np.r_[base, xv]) for xv in xs], color=col, label=lab)
axes[1].axvline(-44, color=C["hist"], ls=":"); axes[1].legend(fontsize=8); axes[1].set_title("sensitivity curve (Newcomb)")
plt.tight_layout(); plt.show()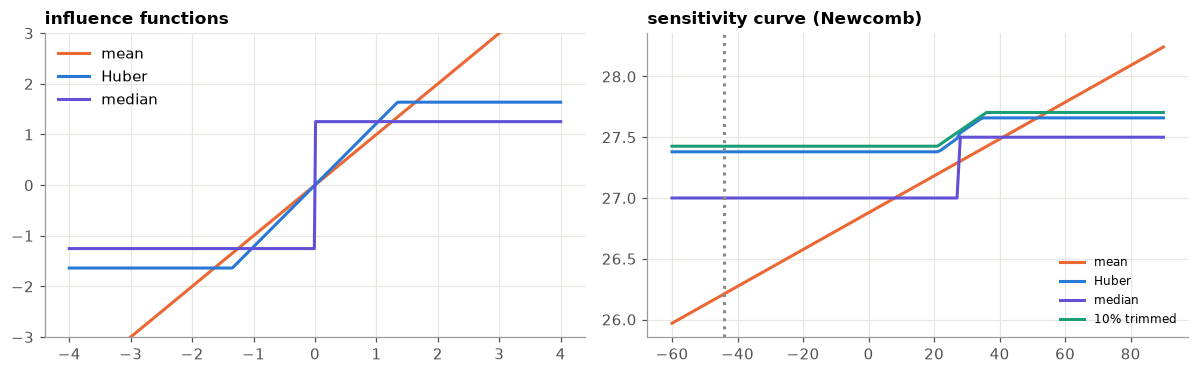
그림 읽기. 왼쪽: 평균의 영향함수는 끝없이 올라가고, Huber와 중앙값은 일정한 높이에서 멈춘다. 오른쪽: Newcomb의 가장 큰 오차()를 다른 값으로 바꿔 넣어 보면 평균만 직선으로 따라가고, 로버스트 추정량들은 그 값이 무엇이든 거의 움직이지 않는다. 정규 표본에서 Huber는 평균의 95% 효율을 지키면서(대가 5%) 오염 5%에서는 평균보다 17% 낫다.
📝 연습 3.1–3.4 (강의노트): Huber 추정량은 MLE, 정규에서의 효율, 중앙값의 영향함수, 붕괴점.
4. 참값이 있는 자료로 — Stigler (1977)
예제 4.1 일곱 개의 자료에 여섯 추정량.
python
Cav = load_rdata("Cavendish").density2.to_numpy(float)
Mi = load_rdata("Michelson").velocity.to_numpy(float)
sets = {"Cavendish": (Cav, 5.513), "Newcomb": (nw, 33.02), "Michelson": (Mi, 734.5)}
for j, c in enumerate(MS.columns, start=1):
    sets[f"  묶음 {j}"] = (MS[c].to_numpy(float), 734.5)
ests = {"평균": np.mean, "중앙값": np.median, "10%": lambda v: stats.trim_mean(v, 0.1), "25%": lambda v: stats.trim_mean(v, 0.25), "Huber": huber, "HL": hodges_lehmann}
rows = {}
for name, (x, tv) in sets.items():
    rows[name] = {"n": len(x), **{e: f_(x) for e, f_ in ests.items()}, "(평균−참)/SE": (x.mean() - tv) / (x.std(ddof=1) / math.sqrt(len(x)))}
st = pd.DataFrame(rows).T; print(st.round(3).to_string())
# 연습 4.1 · 4.2
bias2, var_ = (Mi.mean() - 734.5) ** 2, Mi.var(ddof=1) / len(Mi)
nw64 = np.sort(nw)[2:]
report({"예제 4.1: Cavendish 5.482 · 5.470 · 5.484 · 5.479 · 5.483 · 5.480, t = −0.8":
            [round(st.loc["Cavendish", e], 3) for e in ests] == [5.482, 5.470, 5.484, 5.479, 5.483, 5.480] and round(st.loc["Cavendish", "(평균−참)/SE"], 1) == -0.8,
        "예제 4.1: Newcomb t = −5.1, 25% 절사 27.27": round(st.loc["Newcomb", "(평균−참)/SE"], 1) == -5.1 and abs(st.loc["Newcomb", "25%"] - 27.265) < 1e-3,
        "예제 4.1: Michelson 852.4 · 850.0 · 852.3 · 849.0 · 851.5 · 850.0, t = 14.9":
            np.allclose([st.loc["Michelson", e] for e in ests], [852.4, 850.0, 852.25, 849.0, 851.546, 850.0], atol=1e-3) and round(st.loc["Michelson", "(평균−참)/SE"], 1) == 14.9,
        "예제 4.1: 다섯 묶음의 t = 7.3, 5.8, 8.0, 5.7, 7.1": [round(st.loc[f"  묶음 {j}", "(평균−참)/SE"], 1) for j in range(1, 6)] == [7.3, 5.8, 8.0, 5.7, 7.1],
        "예제 4.1: 묶음 2 의 10% 절사·Huber 859.4, 묶음 5 의 Huber 836.8": round(st.loc["  묶음 2", "10%"], 1) == 859.4 and round(st.loc["  묶음 2", "Huber"], 1) == 859.4 and round(st.loc["  묶음 5", "Huber"], 1) == 836.8,
        "연습 4.1: Michelson 의 평균제곱오차 가운데 편향이 99.6%": round(bias2 / (bias2 + var_), 3) == 0.996,
        "연습 4.2: 두 오차를 빼면 평균 27.75, SD 5.08": round(nw64.mean(), 2) == 27.75 and round(nw64.std(ddof=1), 2) == 5.08})
text
               n       평균     중앙값      10%      25%    Huber      HL  (평균−참)/SE
Cavendish   29.0    5.482    5.47    5.484    5.479    5.483    5.48     -0.797
Newcomb     66.0   26.212   27.00   27.426   27.265   27.380   27.50     -5.147
Michelson  100.0  852.400  850.00  852.250  849.000  851.546  850.00     14.922
  묶음 1      20.0  852.500  850.00  853.125  853.000  852.857  852.50      7.334
  묶음 2      20.0  854.500  850.00  859.375  857.000  859.391  860.00      5.821
  묶음 3      20.0  858.500  850.00  854.375  848.000  853.095  852.50      7.967
  묶음 4      20.0  857.000  855.00  856.250  851.000  855.000  855.00      5.657
  묶음 5      20.0  839.500  840.00  837.500  841.000  836.845  840.00      7.092
  ✓  예제 4.1: Cavendish 5.482 · 5.470 · 5.484 · 5.479 · 5.483 · 5.480, t = −0.8
  ✓  예제 4.1: Newcomb t = −5.1, 25% 절사 27.27
  ✓  예제 4.1: Michelson 852.4 · 850.0 · 852.3 · 849.0 · 851.5 · 850.0, t = 14.9
  ✓  예제 4.1: 다섯 묶음의 t = 7.3, 5.8, 8.0, 5.7, 7.1
  ✓  예제 4.1: 묶음 2 의 10% 절사·Huber 859.4, 묶음 5 의 Huber 836.8
  ✓  연습 4.1: Michelson 의 평균제곱오차 가운데 편향이 99.6%
  ✓  연습 4.2: 두 오차를 빼면 평균 27.75, SD 5.08
숫자 읽기. Cavendish에서는 여섯 추정량이 0.02 안에서 같고 참값과의 차이도 표준오차 안이다. Newcomb에서는 로버스트 추정량들이 평균보다 참값에 1 이상 가깝지만, 여전히 5 넘게 빗나갔다. Michelson의 다섯 묶음에서는 어느 추정량이든 참값에서 표준오차의 6–8배 떨어져 있다. 평균제곱오차의 99.6%가 편향이다. 로버스트 추정은 분포의 꼬리를 고치고, 장치의 보정은 고치지 못한다.
📝 연습 4.1–4.2 (강의노트): 오차의 분해, Newcomb의 두 오차를 빼면.
5. 부트스트랩 (1949–1979)
정의 5.1 부트스트랩 · 알고리즘 5.2 몬테카를로 부트스트랩 · 정리 5.3 평균의 부트스트랩: , , 일치성 · 정의 5.4 BCa · 예제 5.5 Newcomb와 Cavendish · 정의 5.6 잭나이프.
python
def boot_reps(x, stat, B, g):
    idx = g.integers(0, len(x), (B, len(x)))
    return stat(x[idx])                                      # stat 은 axis=1 로 계산하는 함수

def jackknife_vals(x, stat1):
    return np.array([stat1(np.delete(x, i)) for i in range(len(x))])

def bca_interval(x, stat1, reps, alpha=0.05):
    """정의 5.4: 치우침 z0 와 가속 a (잭나이프) 로 고친 백분위 구간"""
    theta = stat1(x); z0 = stats.norm.ppf(np.mean(reps < theta))
    jv = jackknife_vals(x, stat1); dv = jv.mean() - jv
    a = np.sum(dv**3) / (6 * np.sum(dv**2) ** 1.5)
    out = []
    for zq in (stats.norm.ppf(alpha / 2), stats.norm.ppf(1 - alpha / 2)):
        out.append(np.quantile(reps, stats.norm.cdf(z0 + (z0 + zq) / (1 - a * (z0 + zq)))))
    return tuple(out)

gb = np.random.default_rng(1979); B = 20_000
Xb = nw[gb.integers(0, n66, (B, n66))]
bm, bmed, bt = Xb.mean(1), np.median(Xb, 1), stats.trim_mean(Xb, 0.1, axis=1)
se = dict(mean=bm.std(ddof=1), median=bmed.std(ddof=1), trim=bt.std(ddof=1), formula=nw.std(ddof=1) / math.sqrt(n66))
t_ci = nw.mean() + np.array([-1, 1]) * stats.t.ppf(0.975, n66 - 1) * se["formula"]
my_bca_m = bca_interval(nw, np.mean, bm); my_bca_t = bca_interval(nw, lambda v: stats.trim_mean(v, 0.1), bt)
sc_m = stats.bootstrap((nw,), np.mean, n_resamples=9999, method="BCa", random_state=1).confidence_interval
sc_t = stats.bootstrap((nw,), lambda v, axis=-1: stats.trim_mean(v, 0.1, axis=axis), n_resamples=9999, method="BCa", random_state=1).confidence_interval
print("Newcomb 부트스트랩 SE:", {k_: round(v, 3) for k_, v in se.items()})
print(f"평균: t [{t_ci[0]:.1f}, {t_ci[1]:.1f}], BCa (직접) [{my_bca_m[0]:.1f}, {my_bca_m[1]:.1f}], scipy [{sc_m.low:.1f}, {sc_m.high:.1f}];  절사: BCa (직접) [{my_bca_t[0]:.1f}, {my_bca_t[1]:.1f}], scipy [{sc_t.low:.1f}, {sc_t.high:.1f}]")
gc_ = np.random.default_rng(1798); Xc = Cav[gc_.integers(0, len(Cav), (B, len(Cav)))]; bmc = Xc.mean(1)
sc_c = stats.bootstrap((Cav,), np.mean, n_resamples=9999, method="BCa", random_state=1).confidence_interval
print(f"Cavendish: 부트스트랩 SE {bmc.std(ddof=1):.4f}, 공식 {Cav.std(ddof=1) / math.sqrt(len(Cav)):.4f};  BCa [{sc_c.low:.2f}, {sc_c.high:.2f}], t {np.round(Cav.mean() + np.array([-1, 1]) * stats.t.ppf(0.975, 28) * Cav.std(ddof=1) / math.sqrt(29), 2)}")
report({"예제 5.5: 부트스트랩 SE 평균 1.32 (공식 1.32), 중앙값 0.68, 10% 절사 0.68": [round(se[k_], 2) for k_ in ("mean", "formula", "median", "trim")] == [1.32, 1.32, 0.68, 0.68],
        "예제 5.5: t 구간 [23.6, 28.9], BCa (scipy) [22.1, 28.0], 절사의 BCa [26.1, 28.8]":
            np.allclose(np.round(t_ci, 1), [23.6, 28.9]) and (round(sc_m.low, 1), round(sc_m.high, 1)) == (22.1, 28.0) and (round(sc_t.low, 1), round(sc_t.high, 1)) == (26.1, 28.8),
        "정의 5.4: 직접 구현한 BCa = scipy (±0.25)": all(abs(a - b) < 0.25 for a, b in zip(my_bca_m + my_bca_t, (sc_m.low, sc_m.high, sc_t.low, sc_t.high))),
        "예제 5.5: 어느 구간도 참값 33.02 를 포함하지 않는다": max(t_ci[1], sc_m.high, sc_t.high) < 33.02,
        "예제 5.5: Cavendish 부트스트랩 SE 0.038 = 공식 0.038, BCa [5.41, 5.56]": round(bmc.std(ddof=1), 3) == 0.038 and round(Cav.std(ddof=1) / math.sqrt(29), 3) == 0.038 and (round(sc_c.low, 2), round(sc_c.high, 2)) == (5.41, 5.56)})
text
Newcomb 부트스트랩 SE: {'mean': np.float64(1.318), 'median': np.float64(0.684), 'trim': np.float64(0.679), 'formula': np.float64(1.323)}
평균: t [23.6, 28.9], BCa (직접) [22.0, 28.0], scipy [22.1, 28.0];  절사: BCa (직접) [26.1, 28.8], scipy [26.1, 28.8]
Cavendish: 부트스트랩 SE 0.0379, 공식 0.0384;  BCa [5.41, 5.56], t [5.4  5.56]
  ✓  예제 5.5: 부트스트랩 SE 평균 1.32 (공식 1.32), 중앙값 0.68, 10% 절사 0.68
  ✓  예제 5.5: t 구간 [23.6, 28.9], BCa (scipy) [22.1, 28.0], 절사의 BCa [26.1, 28.8]
  ✓  정의 5.4: 직접 구현한 BCa = scipy (±0.25)
  ✓  예제 5.5: 어느 구간도 참값 33.02 를 포함하지 않는다
  ✓  예제 5.5: Cavendish 부트스트랩 SE 0.038 = 공식 0.038, BCa [5.41, 5.56]
python
# 정리 5.3: 모멘트와 일치성 — 지수분포 표본 (n = 400) 하나로
ge = np.random.default_rng(1981); n400 = 400; xe = ge.exponential(1, n400)
be = xe[ge.integers(0, n400, (40_000, n400))].mean(1)
sig_hat2 = xe.var(ddof=0)
boot_z = math.sqrt(n400) * (be - xe.mean())
true_z = math.sqrt(n400) * (ge.exponential(1, (40_000, n400)).mean(1) - 1)
ks = stats.ks_2samp(boot_z, true_z).statistic
rho_hat = np.mean(np.abs(xe - xe.mean()) ** 3); be_bound = 0.4748 * rho_hat / (math.sqrt(sig_hat2) ** 3 * math.sqrt(n400))
print(f"E* X̄* − X̄ = {be.mean() - xe.mean():.5f}, Var* X̄* = {be.var():.6f} (σ̂²/n = {sig_hat2 / n400:.6f});  KS(부트스트랩, 참 분포) = {ks:.3f}, Berry–Esseen 상한 {be_bound:.3f}")
report({"정리 5.3 (a): E* X̄* = X̄, Var* X̄* = σ̂²/n": within(be.mean(), xe.mean(), be.std() / math.sqrt(len(be))) and abs(be.var() / (sig_hat2 / n400) - 1) < 0.03,
        "정리 5.3 (b): 부트스트랩 분포와 참 표본분포의 거리가 작다 (KS < 0.05)": ks < 0.05})
text
E* X̄* − X̄ = 0.00005, Var* X̄* = 0.002364 (σ̂²/n = 0.002368);  KS(부트스트랩, 참 분포) = 0.010, Berry–Esseen 상한 0.052
  ✓  정리 5.3 (a): E* X̄* = X̄, Var* X̄* = σ̂²/n
  ✓  정리 5.3 (b): 부트스트랩 분포와 참 표본분포의 거리가 작다 (KS < 0.05)
python
# 정의 5.6 · 연습 5.1–5.4
xs20 = rng.normal(0, 1, 20)
jm = jackknife_vals(xs20, np.mean); se_jm = math.sqrt((19 / 20) * np.sum((jm - jm.mean()) ** 2))
x10 = np.sort(rng.normal(0, 1, 10)); jmed = jackknife_vals(x10, np.median)
d_gap = x10[5] - x10[4]; se_jmed = math.sqrt((9 / 10) * np.sum((jmed - jmed.mean()) ** 2))
# 연습 5.4: (1, 2, 6) 의 정확한 부트스트랩
data3 = np.array([1, 2, 6]); prob = {}
for tup in itertools.product(range(3), repeat=3):
    med = np.median(data3[list(tup)]); prob[med] = prob.get(med, 0) + 1 / 27
# 연습 5.3: 부트스트랩 표본에 들어가는 서로 다른 관측의 비율
distinct = np.array([len(np.unique(rng.integers(0, 100, 100))) for _ in range(20_000)]) / 100
print(f"평균의 잭나이프 SE {se_jm:.5f} = s/√n {xs20.std(ddof=1) / math.sqrt(20):.5f};  중앙값의 잭나이프 값 {sorted(set(np.round(jmed, 6)))}, SE = √(n−1)·d/2 = {math.sqrt(9) * d_gap / 2:.5f} ({se_jmed:.5f})")
print(f"(1,2,6) 의 중앙값: {({k_: round(v * 27) for k_, v in prob.items()})}/27;  서로 다른 관측의 비율 {distinct.mean():.4f} (1 − (1−1/n)^n = {1 - 0.99**100:.4f})")
report({"연습 5.1: 평균의 잭나이프 SE = s/√n (정확히)": abs(se_jm - xs20.std(ddof=1) / math.sqrt(20)) < 1e-12,
        "연습 5.2: 중앙값의 잭나이프 값은 X_(m), X_(m+1) 둘뿐, SE = √(n−1)·d/2": set(np.round(jmed, 12)) == {round(x10[4], 12), round(x10[5], 12)} and abs(se_jmed - 3 * d_gap / 2) < 1e-12,
        "연습 5.4: 중앙값 1, 2, 6 의 확률 7/27, 13/27, 7/27": {k_: round(v * 27) for k_, v in prob.items()} == {1.0: 7, 2.0: 13, 6.0: 7},
        "연습 5.3: 서로 다른 관측의 비율 → 1 − (1 − 1/n)^n ≈ 0.634 (n = 100)": within(distinct.mean(), 1 - 0.99**100, distinct.std() / math.sqrt(len(distinct)))})

fig, axes = plt.subplots(1, 2, figsize=(11, 3.4))
bins = np.linspace(21, 31, 80)
axes[0].hist(bm, bins=bins, density=True, color=C["assume"], alpha=0.5, label=f"mean (SE {se['mean']:.2f})")
axes[0].hist(bt, bins=bins, density=True, color=C["stat"], alpha=0.55, label=f"10% trimmed (SE {se['trim']:.2f})"); axes[0].legend(); axes[0].set_title("Newcomb: bootstrap distributions")
for yv, (lo, hi), col, lab in [(2, t_ci, C["hist"], "t (mean)"), (1, (sc_m.low, sc_m.high), C["assume"], "BCa (mean)"), (0, (sc_t.low, sc_t.high), C["stat"], "BCa (trimmed)")]:
    axes[1].plot([lo, hi], [yv, yv], color=col, lw=4); axes[1].text(lo, yv + 0.2, lab)
axes[1].axvline(33.02, color=C["key"], ls="--"); axes[1].set_xlim(20, 35); axes[1].set_yticks([]); axes[1].set_title("95% intervals vs truth 33.02")
plt.tight_layout(); plt.show()
text
평균의 잭나이프 SE 0.25963 = s/√n 0.25963;  중앙값의 잭나이프 값 [np.float64(-0.242503), np.float64(-0.076439)], SE = √(n−1)·d/2 = 0.24910 (0.24910)
(1,2,6) 의 중앙값: {np.float64(1.0): 7, np.float64(2.0): 13, np.float64(6.0): 7}/27;  서로 다른 관측의 비율 0.6341 (1 − (1−1/n)^n = 0.6340)
  ✓  연습 5.1: 평균의 잭나이프 SE = s/√n (정확히)
  ✓  연습 5.2: 중앙값의 잭나이프 값은 X_(m), X_(m+1) 둘뿐, SE = √(n−1)·d/2
  ✓  연습 5.4: 중앙값 1, 2, 6 의 확률 7/27, 13/27, 7/27
  ✓  연습 5.3: 서로 다른 관측의 비율 → 1 − (1 − 1/n)^n ≈ 0.634 (n = 100)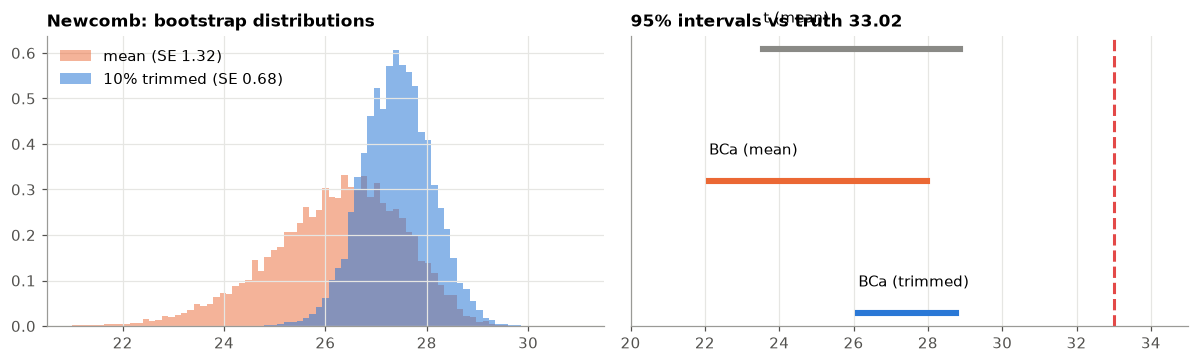
그림 읽기. 평균의 부트스트랩 분포는 두 큰 음의 오차 때문에 왼쪽 꼬리가 길고, 표준오차가 절사평균의 두 배다. BCa는 그 비대칭을 반영해 구간을 아래로 늘렸다. 직접 쓴 BCa가 scipy.stats.bootstrap과 0.25 안에서 일치한다. 그러나 어느 구간도 참값 33.02에 닿지 않는다. 부트스트랩은 표본추출의 변동만 재고, 측정의 편향은 재지 못한다.
📝 연습 5.1–5.4 (강의노트): 평균의 잭나이프, 중앙값의 잭나이프, 부트스트랩 표본의 다양성, 정확한 부트스트랩.
6. 원자료로 — 회귀도 로버스트하게
정의 6.1 회귀의 M-추정 · 알고리즘 6.2 IRLS · 명제 6.3 고정점 = M-추정 방정식 · 예제 6.4 stack loss.
python
SL = load_rdata("stackloss", "datasets")
Xs = np.column_stack([np.ones(len(SL)), SL[["Air.Flow", "Water.Temp", "Acid.Conc."]].to_numpy(float)]); ys = SL["stack.loss"].to_numpy(float)

def irls_huber(X, y, k=1.345, tol=1e-12, maxit=500):
    """알고리즘 6.2: 반복 가중 최소제곱"""
    b = np.linalg.lstsq(X, y, rcond=None)[0]
    for it in range(maxit):
        r = y - X @ b; s = stats.median_abs_deviation(r, scale="normal"); u = r / s
        w = np.where(np.abs(u) <= k, 1.0, k / np.maximum(np.abs(u), 1e-12))
        b_new = np.linalg.solve(X.T @ (w[:, None] * X), X.T @ (w * y))
        if np.max(np.abs(b_new - b)) < tol: return b_new, w, s, it
        b = b_new
    return b, w, s, maxit

b_ols = np.linalg.lstsq(Xs, ys, rcond=None)[0]
b_hub, w_hub, s_hub, its = irls_huber(Xs, ys)
nS, pS = Xs.shape
lp = optimize.linprog(np.r_[np.zeros(pS), np.ones(2 * nS)], A_eq=np.hstack([Xs, np.eye(nS), -np.eye(nS)]), b_eq=ys,
                      bounds=[(None, None)] * pS + [(0, None)] * (2 * nS), method="highs")
b_lad = lp.x[:pS]
psi_eq = Xs.T @ np.clip((ys - Xs @ b_hub) / s_hub, -1.345, 1.345)
low = np.where(w_hub < 0.999)[0] + 1
print("OLS", np.round(b_ols, 3), " Huber", np.round(b_hub, 3), f"({its}번)", " LAD", np.round(b_lad, 3))
print("무게가 줄어든 날:", low, np.round(w_hub[w_hub < 0.999], 2))
report({"예제 6.4: 최소제곱 (−39.92, 0.716, 1.295, −0.152)": np.allclose(np.round(b_ols, 3), [-39.920, 0.716, 1.295, -0.152]),
        "예제 6.4: Huber (−41.05, 0.827, 0.939, −0.129)": np.allclose(np.round(b_hub, 3), [-41.051, 0.827, 0.939, -0.129], atol=1.5e-3),
        "예제 6.4: 최소절댓값 (−39.69, 0.832, 0.574, −0.061)": np.allclose(np.round(b_lad, 3), [-39.690, 0.832, 0.574, -0.061], atol=1.5e-3),
        "예제 6.4: 3, 4, 21일째의 무게 0.82, 0.53, 0.38": list(low) == [3, 4, 21] and np.allclose(np.round(w_hub[low - 1], 2), [0.82, 0.53, 0.38]),
        "명제 6.3: 고정점에서 Σ ψ(r_i/s) x_i = 0": np.allclose(psi_eq, 0, atol=1e-8),
        "연습 6.2: 무게 0.38 이면 |u| = 1.345/0.38 = 3.5": round(1.345 / 0.38, 1) == 3.5})

fit = Xs @ b_ols; res = ys - fit; flag = np.isin(np.arange(1, 22), [3, 4, 21])
fig, axes = plt.subplots(1, 2, figsize=(11, 3.4))
axes[0].scatter(fit[~flag], res[~flag], color=C["stat"]); axes[0].scatter(fit[flag], res[flag], color=C["key"])
for i in np.where(flag)[0]:
    axes[0].annotate(str(i + 1), (fit[i], res[i]), xytext=(4, 2), textcoords="offset points", color=C["key"])
axes[0].axhline(0, color=C["hist"]); axes[0].set_xlabel("OLS fitted"); axes[0].set_ylabel("residual"); axes[0].set_title("stack loss")
axes[1].bar(np.arange(1, 22), w_hub, color=np.where(flag, C["key"], C["stat"])); axes[1].set_xlabel("day"); axes[1].set_title("Huber IRLS weights")
plt.tight_layout(); plt.show()
text
OLS [-39.92    0.716   1.295  -0.152]  Huber [-41.051   0.827   0.939  -0.129] (19번)  LAD [-39.69    0.832   0.574  -0.061]
무게가 줄어든 날: [ 3  4 21] [0.82 0.53 0.38]
  ✓  예제 6.4: 최소제곱 (−39.92, 0.716, 1.295, −0.152)
  ✓  예제 6.4: Huber (−41.05, 0.827, 0.939, −0.129)
  ✓  예제 6.4: 최소절댓값 (−39.69, 0.832, 0.574, −0.061)
  ✓  예제 6.4: 3, 4, 21일째의 무게 0.82, 0.53, 0.38
  ✓  명제 6.3: 고정점에서 Σ ψ(r_i/s) x_i = 0
  ✓  연습 6.2: 무게 0.38 이면 |u| = 1.345/0.38 = 3.5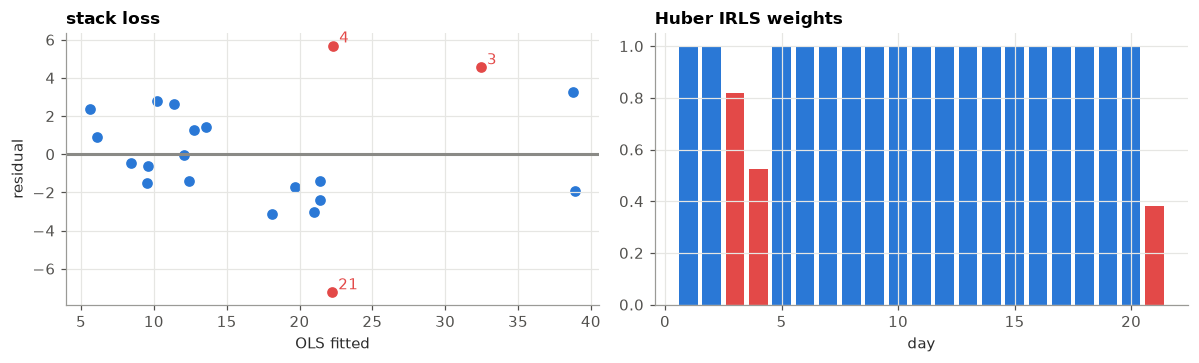
그림 읽기. 최소제곱의 잔차에서 3, 4, 21일째가 크게 벗어나고, Huber의 IRLS는 바로 그날들의 무게를 0.82, 0.53, 0.38로 줄였다. 고정점에서 이 기계 정밀도로 성립한다. 냉각수 온도의 계수는 1.30(최소제곱)에서 0.94(Huber), 0.57(최소절댓값)로 줄어든다. 몇 날의 큰 잔차가 그 기울기를 끌어올리고 있었다.
📝 연습 6.1–6.2 (강의노트): 최소절댓값도 IRLS, 무게의 해석.
7. 부숴보기 — 분포를 덜 믿어도 깨지는 곳
정리 7.1 최댓값의 부트스트랩: 원자 · 예제 7.2 분산만 다른 두 집단 · 예제 7.3 한쪽으로만 섞이면.
python
# 정리 7.1 · 연습 7.1: 균등분포의 최댓값
gx = np.random.default_rng(1943); n50 = 50
xu = gx.uniform(0, 1, n50); mx = xu.max()
bmax = xu[gx.integers(0, n50, (20_000, n50))].max(1)
atom = np.mean(bmax == mx)
true_scaled = n50 * (1 - gx.uniform(0, 1, (20_000, n50)).max(1))           # n(θ − X_(n))/θ, θ = 1
boot_scaled = n50 * (mx - bmax) / mx
atoms = {n_: 1 - (1 - 1 / n_) ** n_ for n_ in (10, 50, 1000)}
print(f"n = 50: P*(max* = max) = {atom:.4f} (공식 {atoms[50]:.4f});  참 분포의 P(= 0) = {np.mean(true_scaled == 0):.4f}, KS(참, Exp(1)) p = {stats.kstest(true_scaled, 'expon').pvalue:.3f}")
print("원자의 크기:", {k_: round(v, 3) for k_, v in atoms.items()}, "→", round(1 - math.exp(-1), 4))
report({"정리 7.1: n = 50 에서 부트스트랩 최댓값의 63.6% 가 원래 최댓값": round(atom, 3) == 0.636 or abs(atom - atoms[50]) < 4 * math.sqrt(0.64 * 0.36 / 20_000),
        "정리 7.1: 참 분포 n(θ − X_(n)) 은 Exp(1) 에 가깝고 원자가 없다": stats.kstest(true_scaled, "expon").pvalue > 1e-3 and np.mean(true_scaled == 0) == 0,
        "정리 7.1: 부트스트랩 분포는 Exp(1) 과 다르다": stats.kstest(boot_scaled, "expon").pvalue < 1e-10,
        "연습 7.1: n = 10, 50, 1000 → 0.651, 0.636, 0.632": [round(atoms[k_], 3) for k_ in (10, 50, 1000)] == [0.651, 0.636, 0.632]})
text
n = 50: P*(max* = max) = 0.6353 (공식 0.6358);  참 분포의 P(= 0) = 0.0000, KS(참, Exp(1)) p = 0.754
원자의 크기: {10: 0.651, 50: 0.636, 1000: 0.632} → 0.6321
  ✓  정리 7.1: n = 50 에서 부트스트랩 최댓값의 63.6% 가 원래 최댓값
  ✓  정리 7.1: 참 분포 n(θ − X_(n)) 은 Exp(1) 에 가깝고 원자가 없다
  ✓  정리 7.1: 부트스트랩 분포는 Exp(1) 과 다르다
  ✓  연습 7.1: n = 10, 50, 1000 → 0.651, 0.636, 0.632
python
# 예제 7.2: 분산만 다른 두 집단 (크기 10 과 40)
def sizes(sd_small, sd_large, seed, R=20_000):
    g = np.random.default_rng(seed); rm = rt = rw = 0
    for _ in range(R):
        a = g.normal(0, sd_small, 10); b = g.normal(0, sd_large, 40)
        rm += stats.mannwhitneyu(a, b).pvalue < 0.05; rt += stats.ttest_ind(a, b).pvalue < 0.05
        rw += stats.ttest_ind(a, b, equal_var=False).pvalue < 0.05
    return rm / R, rt / R, rw / R
s1, s2 = sizes(4, 1, 1945), sizes(1, 4, 1947)
print(f"작은 집단 sd 4: Mann–Whitney {s1[0]:.3f}, 합동 t {s1[1]:.3f}, Welch {s1[2]:.3f};  작은 집단 sd 1: {s2[0]:.3f}, {s2[1]:.4f}, {s2[2]:.3f}")
# 예제 7.3: 0.9 N(0,1) + 0.1 N(5,1)
fa = lambda x: 0.9 * stats.norm.pdf(x) + 0.1 * stats.norm.pdf(x, 5, 1)
med_a = optimize.brentq(lambda t: integrate.quad(fa, -15, t)[0] - 0.5, -1, 3)
hub_a = optimize.brentq(lambda t: integrate.quad(lambda x: np.clip(x - t, -1.345, 1.345) * fa(x), -15, 20)[0], -1, 3)
# 연습 7.2: Cauchy 에서 평균의 부트스트랩 SE (= σ̂/√n) 는 n 과 함께 커진다
gcau = np.random.default_rng(1853)
se_c = {n_: np.median([np.std(gcau.standard_cauchy(n_)) / math.sqrt(n_) for _ in range(40)]) for n_ in (100, 1000, 10_000)}
print(f"한쪽 오염: 평균 0.5, 중앙값 {med_a:.3f}, Huber {hub_a:.3f};  Cauchy 평균의 부트스트랩 SE (중앙값): {({k_: round(v, 2) for k_, v in se_c.items()})}")
report({"예제 7.2: Mann–Whitney 0.147, 합동 t 0.293, Welch 0.051": [round(v, 3) for v in s1] == [0.147, 0.293, 0.051],
        "예제 7.2: 뒤집으면 0.007, 0.00025, 0.049": round(s2[0], 3) == 0.007 and abs(s2[1] - 0.00025) < 1e-12 and round(s2[2], 3) == 0.049,
        "예제 7.3: 중앙값 0.140, Huber 0.182 (평균 0.5)": round(med_a, 3) == 0.140 and round(hub_a, 3) == 0.182,
        "연습 7.2: Cauchy 의 부트스트랩 SE 는 n 이 100배가 되어도 줄지 않는다 (정규라면 1/10)": se_c[10_000] > 0.5 * se_c[100] and min(se_c.values()) > 0.5})
text
작은 집단 sd 4: Mann–Whitney 0.147, 합동 t 0.293, Welch 0.051; 작은 집단 sd 1: 0.007, 0.0003, 0.049text
한쪽 오염: 평균 0.5, 중앙값 0.140, Huber 0.182;  Cauchy 평균의 부트스트랩 SE (중앙값): {100: np.float64(1.34), 1000: np.float64(0.97), 10000: np.float64(1.12)}
  ✓  예제 7.2: Mann–Whitney 0.147, 합동 t 0.293, Welch 0.051
  ✓  예제 7.2: 뒤집으면 0.007, 0.00025, 0.049
  ✓  예제 7.3: 중앙값 0.140, Huber 0.182 (평균 0.5)
  ✓  연습 7.2: Cauchy 의 부트스트랩 SE 는 n 이 100배가 되어도 줄지 않는다 (정규라면 1/10)
숫자 읽기. 균등 표본 50개의 부트스트랩에서 63.6%가 원래 최댓값을 그대로 준다. 참 분포 은 연속인 이어서 그런 원자가 없다. 부트스트랩은 분포의 끝을 흉내 내지 못한다. 중앙값이 같아도 분산이 다르면 Mann–Whitney의 크기는 0.147이나 0.007이 된다. 순위검정의 귀무가설은 "분포가 같다"이지 "중앙값이 같다"가 아니다. Welch의 만 두 경우 모두 5%를 지킨다.
📝 연습 7.1–7.3 (강의노트): 원자의 크기, Cauchy의 부트스트랩, 두 중앙값을 비교하려면.
8. 오늘의 로버스트와 부트스트랩 — bagging과 Huber 손실
명제 8.1 · 예제 8.2 결정 그루터기 · 명제 8.3 Huber 손실 , .
python
def stump_fit(x, y):
    o = np.argsort(x); xs, ys = x[o], y[o]; n = len(y); cs = np.cumsum(ys); cs2 = np.cumsum(ys**2)
    i = np.arange(1, n); l = cs[:-1] / i; r = (cs[-1] - cs[:-1]) / (n - i)
    sse = (cs2[:-1] - i * l**2) + ((cs2[-1] - cs2[:-1]) - (n - i) * r**2)
    j = int(np.argmin(sse)); return (xs[j] + xs[j + 1]) / 2, l[j], r[j]

grid = np.linspace(-0.4, 0.4, 41); Rg, Bg = 200, 50
P1, P2 = np.empty((Rg, len(grid))), np.empty((Rg, len(grid)))
gbag = np.random.default_rng(1996)
for rr in range(Rg):
    xx = gbag.uniform(-1, 1, 100); yy = (xx > 0).astype(float) + gbag.normal(0, 1, 100)
    t0, l0, r0 = stump_fit(xx, yy); P1[rr] = np.where(grid > t0, r0, l0)
    acc = np.zeros(len(grid))
    for _ in range(Bg):
        ii = gbag.integers(0, 100, 100); t1, l1, r1 = stump_fit(xx[ii], yy[ii]); acc += np.where(grid > t1, r1, l1)
    P2[rr] = acc / Bg
i5 = int(np.argmin(np.abs(grid - 0.05)))
v1, v2, m1, m2 = P1[:, i5].var(), P2[:, i5].var(), P1[:, i5].mean(), P2[:, i5].mean()
# 명제 8.1: 상관 ρ 인 예측 B개의 평균
gr = np.random.default_rng(2001); rho_b, Bm = 0.4, 10
common = gr.standard_normal((100_000, 1)); indiv = gr.standard_normal((100_000, Bm))
fhat = math.sqrt(rho_b) * common + math.sqrt(1 - rho_b) * indiv
print(f"x0 = 0.05: 분산 그루터기 {v1:.3f} → bagging {v2:.3f} (비 {v2 / v1:.2f});  평균 {m1:.2f} → {m2:.2f} (참값 1)")
report({"예제 8.2: 분산 0.131 → 0.068, 평균 0.86 → 0.77": round(v1, 3) == 0.131 and round(v2, 3) == 0.068 and round(m1, 2) == 0.86 and round(m2, 2) == 0.77,
        "명제 8.1 · 연습 8.1: ρ = 0.4, B = 10 이면 0.46": abs(fhat.mean(1).var() - (rho_b + (1 - rho_b) / Bm)) < 0.01 and round(rho_b + (1 - rho_b) / 10, 2) == 0.46 and round(rho_b + (1 - rho_b) / 100, 3) == 0.406})
text
x0 = 0.05: 분산 그루터기 0.131 → bagging 0.068 (비 0.52); 평균 0.86 → 0.77 (참값 1)text
  ✓  예제 8.2: 분산 0.131 → 0.068, 평균 0.86 → 0.77
  ✓  명제 8.1 · 연습 8.1: ρ = 0.4, B = 10 이면 0.46
python
# 명제 8.3 · 연습 8.2: Huber 손실의 세 얼굴
kk_ = 1.0; u = np.linspace(-3, 3, 601)
rho = np.where(np.abs(u) <= kk_, u**2 / 2, kk_ * np.abs(u) - kk_**2 / 2)
zgrid = np.linspace(-5, 5, 20001)
env = np.array([np.min(0.5 * (uu - zgrid) ** 2 + kk_ * np.abs(zgrid)) for uu in u])
zstar = np.sign(u) * np.maximum(np.abs(u) - kk_, 0)
deriv = np.gradient(rho, u)
beta = 1.0; smooth_l1 = np.where(np.abs(u) < beta, 0.5 * u**2 / beta, np.abs(u) - beta / 2)
report({"명제 8.3 (a): ρ_k′ = ψ_k (수치 미분)": np.allclose(deriv[1:-1], np.clip(u, -kk_, kk_)[1:-1], atol=0.01),
        "명제 8.3 (b): ρ_k(u) = min_z {½(u − z)² + k|z|}, 최소점은 연성 임계값": np.allclose(env, rho, atol=1e-6) and np.allclose(0.5 * (u - zstar) ** 2 + kk_ * np.abs(zstar), rho),
        "명제 8.3 (c): smooth L1 = ρ_β/β": np.allclose(smooth_l1, np.where(np.abs(u) <= beta, u**2 / 2, beta * np.abs(u) - beta**2 / 2) / beta)})

fig, axes = plt.subplots(1, 2, figsize=(11, 3.5))
axes[0].plot(grid, P1.mean(0), color=C["hist"], label="stump"); axes[0].plot(grid, P2.mean(0), color=C["stat"], label="bagged")
axes[0].step(grid, (grid > 0).astype(float), where="mid", **THEORY, label="truth"); axes[0].legend(); axes[0].set_title("bagging: mean prediction")
ax2 = axes[0].twinx(); ax2.plot(grid, P1.var(0), color=C["hist"], ls=":"); ax2.plot(grid, P2.var(0), color=C["stat"], ls=":"); ax2.grid(False)
axes[1].plot(u, u**2 / 2, color=C["assume"], label="squared"); axes[1].plot(u, np.abs(u), color=C["theta"], label="absolute")
axes[1].plot(u, rho, color=C["stat"], label="Huber"); axes[1].plot(u, np.clip(u, -1, 1), color=C["stat"], ls="--", label=r"$\psi_k$")
axes[1].set_ylim(-1.3, 3.2); axes[1].legend(); axes[1].set_title("Huber loss = smooth L1")
plt.tight_layout(); plt.show()
text
  ✓  명제 8.3 (a): ρ_k′ = ψ_k (수치 미분)
  ✓  명제 8.3 (b): ρ_k(u) = min_z {½(u − z)² + k|z|}, 최소점은 연성 임계값
  ✓  명제 8.3 (c): smooth L1 = ρ_β/β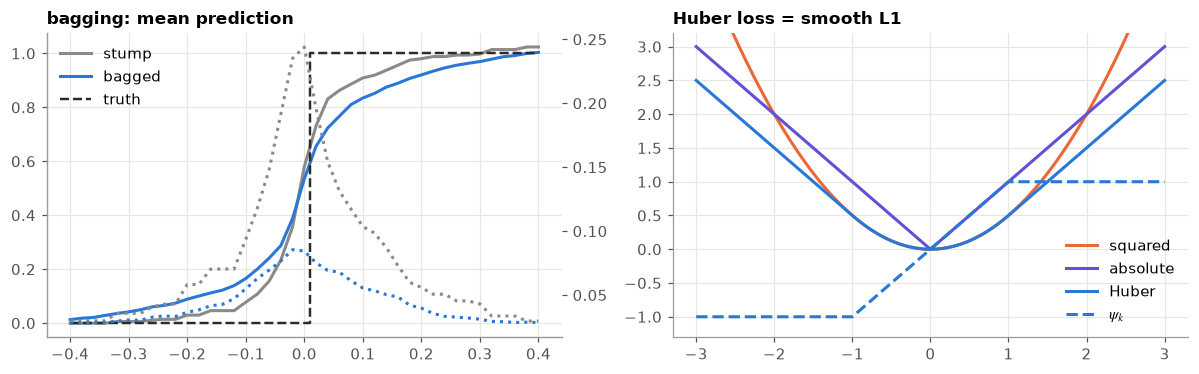
그림 읽기. 왼쪽: 그루터기의 평균 예측은 0 근처에서 급하게 뛰고, 그 근처의 분산(점선)이 크다. bagging은 계단을 경사로 바꿔 분산을 절반으로 줄이고 치우침을 조금 늘린다. 오른쪽: Huber 손실은 가운데서 제곱, 바깥에서 절댓값이고, 그 기울기는 에서 잘린다. 회귀의 Huber 손실, 객체 검출의 smooth L1, 경사 자르기가 모두 1964년의 다.
📝 연습 8.1–8.2 (강의노트): 상관이 남기는 분산, 연성 임계값.
9. 정리 · 연습문제 지도 · 다음 회
| 내용 | 확인한 셀 | |
|---|---|---|
| 순위 (1.1–1.10) | 점화식 = 열거, ·, 의 불편성, 순열검정의 크기, Michelson 묶음 , Darwin , HL 3.13, | 1절 |
| 효율 (2.1–2.5) | 적분으로 0.864·1·0.955·1.097·1.24·1.5·1.90, 오염 1.01·1.20·1.37, 하한, Laplace 67 대 100의 검정력 | 2절 |
| 로버스트 (3.1–3.8) | 점근분산 표, Huber 효율 0.950, 최소최대 , 유한차분 영향함수, 붕괴점 1·33·7, Newcomb의 다섯 추정 | 3절 |
| Stigler (4.1) | 일곱 자료의 표, 편향 99.6%, 두 오차를 빼면 27.75 | 4절 |
| 부트스트랩 (5.1–5.6) | SE 1.32·0.68, 직접 쓴 BCa = scipy, 일치성 KS 0.01, 잭나이프, 정확한 부트스트랩 7/13/7 | 5절 |
| 로버스트 회귀 (6.1–6.4) | IRLS = M-추정 방정식, stack loss의 세 적합과 무게 0.82·0.53·0.38 | 6절 |
| 부숴보기 (7) | 최댓값의 원자 0.636, Mann–Whitney 0.147·0.007, 한쪽 오염 0.140·0.182 | 7절 |
| 오늘 (8) | bagging 0.131 → 0.068, Huber 손실 = 연성 임계값의 최소 | 8절 |
연습문제 지도 (강의노트, ★ 계산 · ★★ 증명 · ★★★ 도전, 풀이는 부록 A)
| 절 | 연습 | 이 노트북에서 확인하는 셀 |
|---|---|---|
| 1 순위 | 1.1 ★ · 1.2 점화식 ★★ · 1.3 Walsh ★★ · 1.4 AUC ★ | 1절 |
| 2 효율 | 2.1 ★ · 2.2 포물선 ★★ · 2.3 ★ · 2.4 부호검정 ★★ · 2.5 효능과 효율 증명 ★★ (유도형) | 2절 |
| 3 로버스트 | 3.1 ★ · 3.2 Huber 효율 ★★ · 3.3 중앙값 IF ★★ · 3.4 붕괴점 ★ · 3.5 M-추정량의 IF 증명 ★★ · 3.6 붕괴점 증명 ★★ (유도형) | 3절 |
| 4 Stigler | 4.1 ★ · 4.2 ★ | 4절 |
| 5 부트스트랩 | 5.1 ★ · 5.2 ★★ · 5.3 ★★ · 5.4 정확한 부트스트랩 ★★ | 5절 |
| 6 회귀 | 6.1 ★★ · 6.2 ★ | 6절 |
| 7 부숴보기 | 7.1 ★ · 7.2 Cauchy ★★ · 7.3 ★★ · 7.4 최댓값의 부트스트랩 증명 ★★ (유도형) | 7절 |
| 8 오늘 | 8.1 ★ · 8.2 ★★ · 8.3 Huber 손실 증명 ★ (유도형) | 8절 |
다음 회 (16회) — 베이즈의 귀환: MCMC와 Stein의 역설 (1763 → 1990). 과정의 처음, Bayes의 당구대로 돌아간다. Laplace의 출생 기록, Fisher의 거부, 숨은 생존, Metropolis와 Gibbs 표집이 계산의 벽을 허문 이야기다. James–Stein(1961)은 정규 평균 세 개 이상을 동시에 추정할 때 표본평균이 최선이 아님을 보였다. 모수가 확률변수가 되는 순간 13회의 ridge와 이번 회차의 Huber 손실은 사전분포가 된다.
10. 워크북 검산
워크북(15_robust_bootstrap_workbook.pdf)의 문제는 손으로 먼저 푼다. 이 절은 다 푼 뒤에 쓴다.
check("A2c", "11/35")— 문항 번호와 손으로 구한 답을 넣으면 맞는지만 알려 준다. 정답은 보여 주지 않는다. 답은 수(11/35,0.314)나 식의 문자열("pi**2/12","(2-4*exp(-1))/(1-exp(-1))**2")로 넣는다. 소문항은"A2c"처럼 번호 뒤에 붙인다. 소수로 넣으면 상대오차 0.1%까지(표를 쓰는 문항은 표의 정밀도까지) 맞다고 본다.- 시뮬레이션으로 한 번 더 — 확률이 답인 문항은 아래에 시뮬레이션 함수를 정의해 두었다. 손으로 구한 값이 Monte Carlo 구간 안에 드는지 본다. 함수는 정의만 해 두었고 부르지 않았다. 답을 구하기 전에 부르면 답이 보인다.
증명 문제(B, C의 대부분)는 check()가 없다. 풀이판의 증명과 단계별로 맞춰 본다.
답 열쇠 셀 (내려받은 노트북에서 실행된다)
답 열쇠를 압축해 넣은 check() 정의 셀이다. 웹에서는 이 회차의 답 확인 페이지를 쓴다.
python
check()                 # 확인할 수 있는 문항 번호
check("A2c")            # 답을 넣지 않으면 쓰는 법을 알려 준다
text
확인할 수 있는 문항: A1a A1b A2a A2b A2c A3a A3b A3c A4 A5 A6a A6b A7a A7b A8a A8b A9a A9b A9c A10a A10b A11a A11b A12 A13a A13b A13c A14 C3c C4c C7b D1a D1b D1c D2a D2b D2c D2d D3a D3b D3c D4b D4c
A2c: 아직 답을 넣지 않았다. 예: check('A2c', '3/8')
10.1 내 답을 모아 확인하기
푼 문항의 답을 아래 사전에 채우고 실행한다. None인 문항은 건너뛴다.
python
mine = {
    "A1a": None, "A1b": None, "A2a": None, "A2b": None, "A2c": None,
    "A3a": None, "A3b": None, "A3c": None, "A4": None, "A5": None,
    "A6a": None, "A6b": None, "A7a": None, "A7b": None, "A8a": None, "A8b": None,
    "A9a": None, "A9b": None, "A9c": None, "A10a": None, "A10b": None,
    "A11a": None, "A11b": None, "A12": None, "A13a": None, "A13b": None, "A13c": None, "A14": None,
    "C3c": None, "C4c": None, "C7b": None,
    "D1a": None, "D1b": None, "D1c": None, "D2a": None, "D2b": None, "D2c": None, "D2d": None,
    "D3a": None, "D3b": None, "D3c": None, "D4b": None, "D4c": None,
}
check_all(mine)
text
0/0 맞음10.2 시뮬레이션 함수
각 함수는 (추정값, 표준오차)를 돌려준다(sim_D1은 두 검정의 검정력 두 쌍). 손으로 구한 값이 추정값 ± 3 × 표준오차 안에 들면 계산이 맞을 가능성이 높다. 정확한 검산은 check()가 한다.
| 함수 | 문항 | 시뮬레이션 |
|---|---|---|
sim_A2() |
A2(c) | 연속분포에서 , |
sim_A3() |
A3(c) | 0에 대칭인 차이 6개 |
sim_A11() |
A11(b) | 자료 에서 복원추출 |
sim_A12(n) |
A12 둘째로 큰 값 | 서로 다른 개에서 복원추출 |
sim_D1(theta) |
D1 국소 검정력 | 정규 이동, , Wilcoxon과 |
sim_D2() |
D2(d) | 지수 두 표본, |
sim_D3() |
D3(a) | 자료 에서 복원추출 |
python
N_WB = 200_000


def _prop(hits):
    p = float(np.mean(hits))
    return p, math.sqrt(p * (1 - p) / len(hits))


def sim_A2(R=N_WB):
    z = rng.normal(size=(R, 7))
    ranks = z.argsort(axis=1).argsort(axis=1) + 1
    return _prop(ranks[:, :3].sum(axis=1) <= 10)


def sim_A3(R=N_WB):
    d = rng.normal(size=(R, 6))
    r = np.abs(d).argsort(axis=1).argsort(axis=1) + 1
    return _prop((r * (d > 0)).sum(axis=1) >= 16)


def sim_A11(R=N_WB):
    x = np.array([0, 3, 9.0])
    return _prop(rng.choice(x, size=(R, 3)).mean(axis=1) > 4 + 1e-12)


def sim_A12(n=5, R=N_WB):
    idx = rng.integers(0, n, size=(R, n))          # 0..n-1 이 크기 순서, n-2 가 둘째로 큰 값
    return _prop(idx.max(axis=1) == n - 2)


def sim_D1(theta=0.5, m=50, R=4_000):
    x = rng.normal(size=(R, m))
    y = rng.normal(theta, 1, size=(R, m))
    N = 2 * m
    W = stats.rankdata(np.hstack([y, x]), axis=1)[:, :m].sum(axis=1)       # Y 쪽 순위합
    zW = (W - m * (N + 1) / 2) / math.sqrt(m * m * (N + 1) / 12)
    tt = stats.ttest_ind(y, x, axis=1).statistic
    za = stats.norm.ppf(0.95)
    return _prop(zW > za), _prop(tt > stats.t.ppf(0.95, N - 2))


def sim_D2(R=100_000):
    x = rng.exponential(1.0, size=(R, 10))
    y = rng.exponential(0.5, size=(R, 10))
    u = (x[:, :, None] > y[:, None, :]).mean(axis=(1, 2))
    v = u.var()
    m4 = np.mean((u - u.mean()) ** 4)
    return float(v), math.sqrt((m4 - v ** 2) / R)


def sim_D3(R=N_WB):
    x = np.array([0, 0, 0, 0, 10.0])
    return _prop(rng.choice(x, size=(R, 5)).mean(axis=1) == 0)
python
# 자체 검사 (출력 없음): 시뮬레이션이 답 열쇠와 맞는지, check()가 답 열쇠의 값과 그 소수를 맞다고 하는지 확인한다.
def _close(sim, key, z=4.0):
    est, se = sim
    return abs(est - _value(key)) <= z * se + 1e-12

assert _close(sim_A2(), "A2c")
assert _close(sim_A3(), "A3c")
assert _close(sim_A11(), "A11b")
assert _close(sim_A12(), "A12")
assert _close(sim_D2(), "D2d")
assert _close(sim_D3(), "D3a")
_d1w, _d1t = sim_D1()
assert abs(_d1w[0] - _value("D1b")) < 0.05 and abs(_d1t[0] - _value("D1c")) < 0.05   # 국소 근사이므로 느슨하게
for _k, _e in _WB.items():
    assert _same(_e, _e["value"])
    if not _e.get("vars") and "points" not in _e:
        assert _same(_e, float(sp.sympify(_e["value"])))