Skip to content

15회 · 가정이 틀리면 · 노트

2 효율 — 순위로 바꾸면 얼마나 잃는가 ​

역사 순위 검정이 처음 나왔을 때 많은 통계학자는 그것을 “빠르지만 거친” 방법으로 여겼다. 값을 버리고 순서만 쓰니 정보를 잃는다는 것이다. 1948년 Pitman은 콜럼비아 대학 강의록에서 두 검정을 비교하는 기준을 내놓았다. 같은 대립가설에 같은 검정력을 얻는 데 필요한 표본 크기의 비다. Hodges와 Lehmann(1956)은 그 기준으로 Wilcoxon 검정이 정규분포에서조차 tt 검정의 95.5%의 효율을 갖고, 어떤 분포에서도 86.4%보다 못하지 않으며, 꼬리가 두꺼우면 얼마든지 나을 수 있음을 증명했다. “빠르고 거친” 방법이 사실상 공짜였던 것이다.

2.1 Pitman 효율 ​

정의 2.1 (점근상대효율) 같은 가설을 검정하는 두 검정이 있고, 대립가설 θ\theta가 0에 다가갈 때 같은 크기와 같은 검정력에 필요한 표본 크기를 N1(θ)N_1(\theta), N2(θ)N_2(\theta)라 하자. lim⁡θ→0N2/N1\lim_{\theta\to0}N_2/N_1을 검정 1의 검정 2에 대한 Pitman 점근상대효율(ARE)이라 한다. ARE가 1.5면 검정 1은 같은 일을 표본 2/32/3로 한다.

증명 없이 쓰는 사실 (국소 대립가설 아래의 점근정규성) θN=h/N\theta_N=h/\sqrt N일 때 N(TN−μ(0))/σ(0)→DN(h μ′(0)/σ(0), 1)\sqrt N\bigl(T_N-\mu(0)\bigr)/\sigma(0)\xrightarrow{D}\N\bigl(h\,\mu^\prime(0)/\sigma(0),\allowbreak \ 1\bigr)이 성립한다고 하자. 두 표본 평균의 차에서는 중심극한정리(7회 정리 3.1)로 바로 나오고, Mann–Whitney 통계량에서는 U-통계량의 사영(Hoeffding 1948)과 대립가설의 “근접성”(Le Cam)이 필요하다. 이 과정에서는 그것을 증명 없이 쓴다.

명제 2.2 (효능과 효율) 위의 조건 아래 크기 α\alpha의 한쪽 검정의 검정력은 1−Φ(zα−h e)1-\Phi\bigl(z_\alpha-h\,e\bigr)로 수렴한다. e=μ′(0)/σ(0)e=\mu^\prime(0)/\sigma(0)을 효능이라 한다. 두 검정의 ARE는 효능의 비의 제곱 (e1/e2)2(e_1/e_2)^2이다.

증명 전략 기각역을 표준화한 통계량으로 쓰고 위 상자의 극한분포를 넣어 검정력의 극한을 얻는다. 두 검정의 검정력이 같아지는 조건을 표본 크기에 대해 푼다. 단계별 증명은 연습 2.5(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

정리 2.3 (Wilcoxon 대 tt) X∼FX\sim F, Y∼F(⋅−θ)Y\sim F(\cdot-\theta), FF의 밀도 ff와 분산 σ2\sigma^2이 있고, m/N→λ∈(0,1)m/N\to\lambda\in(0,1)이라 하자. Wilcoxon–Mann–Whitney 검정의 두 표본 tt 검정에 대한 ARE는

ARE(W,t)=12 σ2(∫f(x)2 dx)2.\mathrm{ARE}(W,t)=12\,\sigma^2\Bigl(\int f(x)^2\,dx\Bigr)^2 .

증명 전략 명제 2.2로 ARE는 효능의 비의 제곱이다. 두 통계량마다 평균의 θ\theta에 대한 도함수와 귀무가설 아래의 표준편차(N\sqrt N을 곱한 것)를 구한다.

  1. tt: T=Yˉ−XˉT=\bar Y-\bar X의 평균은 θ\theta이고 분산은 σ2(1m+1n)=σ2Nλ(1−λ)\sigma^2(\tfrac1m+\tfrac1n)=\tfrac{\sigma^2}{N\lambda(1-\lambda)}이다. 따라서 μ′(0)=1\mu^\prime(0)=1, σ(0)=σ/λ(1−λ)\sigma(0)=\sigma/\sqrt{\lambda(1-\lambda)}, et=λ(1−λ)/σe_t=\sqrt{\lambda(1-\lambda)}/\sigma이다.2회 정리 2.8, m/N→λm/N\to\lambda

  2. Wilcoxon: T=U/(mn)T=U/(mn)의 평균은 p(θ)=P(Y>X)=∫F(x+θ)f(x) dxp(\theta)=P(Y>X)=\int F(x+\theta)f(x)\,dx이다.정리 1.5(c), 반복기댓값

  3. p′(0)=∫f(x)2 dxp^\prime(0)=\int f(x)^2\,dx이다.적분 기호 아래 미분 [T6]

  4. 귀무가설 아래 Var⁡T=N+112mn≈112Nλ(1−λ)\Var T=\tfrac{N+1}{12mn}\approx\tfrac1{12N\lambda(1-\lambda)}이므로 σ(0)=1/12λ(1−λ)\sigma(0)=1/\sqrt{12\lambda(1-\lambda)}, eW=12λ(1−λ)∫f2e_W=\sqrt{12\lambda(1-\lambda)}\int f^2이다.정리 1.5(b), 연습 1.4

  5. (eW/et)2=12 σ2(∫f2)2(e_W/e_t)^2=12\,\sigma^2\bigl(\int f^2\bigr)^2이다. λ(1−λ)\lambda(1-\lambda)는 지워진다.명제 2.2

조건 확인 3에서 F(x+θ)−F(x)θ\tfrac{F(x+\theta)-F(x)}\theta는 ff의 구간 [x,x+θ][x,x+\theta] 위의 평균이다. ff가 유계(≤M\le M)이면 차분몫과 f(x)f(x)의 곱은 적분가능한 Mf(x)Mf(x)로 눌리고, ff의 연속점에서 f(x)2f(x)^2로 수렴하므로 지배수렴으로 미분과 적분을 바꿀 수 있다 [T6]. 명제 2.2는 위의 상자(국소 대립가설 아래의 점근정규성)를 가정한다. Mann–Whitney 통계량에 대한 그 사실은 이 과정에서 증명하지 않는다.

예제 2.4 (분포에 따른 효율) 

분포포물선균등정규로지스틱t5t_5Laplacet3t_3
ARE(W,t)(W,t)0.86413/π=0.9553/\pi=0.955π2/9=1.097\pi^2/9=1.0971.241.51.90

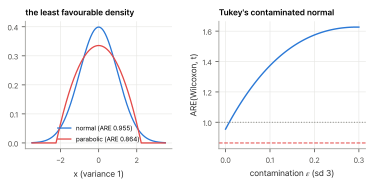
정규분포에 표준편차가 3배인 정규를 ε\varepsilon만큼 섞으면(Tukey의 오염 정규) ARE는 ε=0.01\varepsilon=0.01에서 1.01, 0.05에서 1.20, 0.10에서 1.37이다. 오염이 1%만 되어도 Wilcoxon이 tt를 앞선다. Cauchy처럼 분산이 없으면 tt 검정은 근거를 잃고 ARE는 무한대다.

2.2 하한 0.864 ​

정리 2.5 (Hodges–Lehmann (1956)) 분산이 유한한 모든 밀도 ff에 대해 ARE(W,t)≥108/125=0.864\mathrm{ARE}(W,\allowbreak t)\ge108/125=0.864이다. 등호는 포물선 밀도 f(x)∝(5σ2−x2)+f(x)\propto(5\sigma^2-x^2)_+일 때다.

증명 전략 ARE는 위치와 척도에 무관하므로 평균 0, 분산 1인 밀도에서 ∫f2\int f^2의 최솟값을 찾으면 된다. 후보 hh와의 차의 제곱 (f−h)2≥0(f-h)^2\ge0을 적분해 ∫f2\int f^2를 아래에서 누른다 [T4].

  1. ff를 1sf(x−as)\tfrac1sf(\tfrac{x-a}s)로 바꾸면 σ2\sigma^2은 s2s^2배, ∫f2\int f^2은 1s\tfrac1s배가 되어 12σ2(∫f2)212\sigma^2(\int f^2)^2은 그대로다. 그래서 평균 0, 분산 1로 놓는다.치환 [T7]

  2. h(x)=c (5−x2)+h(x)=c\,(5-x^2)_+, c=3205c=\tfrac3{20\sqrt5}로 두면 ∫h=1\int h=1, ∫x2h=1\int x^2h=1이다. a=5ca=5c, b=cb=c로 쓰면 받침 위에서 h=a−bx2h=a-bx^2이다.직접 적분, 연습 2.2

  3. 0≤∫(f−h)2=∫f2−2∫fh+∫h20\le\int(f-h)^2=\int f^2-2\int fh+\int h^2이므로 ∫f2≥2∫fh−∫h2\int f^2\ge2\int fh-\int h^2이다.전개 [T4]

  4. 모든 xx에서 h(x)≥a−bx2h(x)\ge a-bx^2이고(받침 밖에서 오른쪽이 음수) f≥0f\ge0이므로 ∫fh≥∫f (a−bx2)=a−b\int fh\ge\int f\,(a-bx^2)=a-b이다.∫f=1\int f=1, ∫x2f=1\int x^2f=1

  5. hh의 받침 위에서 h=a−bx2h=a-bx^2이므로 ∫h2=∫h (a−bx2)=a−b=4c=3525\int h^2=\int h\,(a-bx^2)=a-b=4c=\tfrac{3\sqrt5}{25}이다.2

  6. 3–5로 ∫f2≥2(a−b)−(a−b)=3525\int f^2\ge2(a-b)-(a-b)=\tfrac{3\sqrt5}{25}이고, 12(∫f2)2≥12⋅45625=10812512(\int f^2)^2\ge12\cdot\tfrac{45}{625}=\tfrac{108}{125}이다. 등호는 ∫(f−h)2=0\int(f-h)^2=0, 곧 f=hf=h일 때다.3의 등호 조건

정리 2.5는 “보험료”를 알려 준다. Wilcoxon을 쓰면 최악의 경우에도 표본의 13.6%만큼 손해고, 정규에서는 4.5%이며, 꼬리가 두꺼우면 큰 이득이다. Chernoff와 Savage(1958)는 순위 대신 정규분포의 분위수(정규 점수)를 쓰는 검정이 모든 분포에서 tt 이상의 효율을 가짐을 보였다.

그림 2.1. 왼쪽: 하한을 이루는 포물선 밀도와 같은 분산의 정규밀도. 오른쪽: 오염 비율 ε (표준편차 3배의 정규를 섞음)에 따른 Wilcoxon의 t에 대한 효율(정리 2.3). 회색 점선은 1, 빨간 점선은 하한 0.864다. ε≈0.01에서 1을 넘는다.
그림 2.1 왼쪽: 하한을 이루는 포물선 밀도와 같은 분산의 정규밀도. 오른쪽: 오염 비율 ε\varepsilon (표준편차 3배의 정규를 섞음)에 따른 Wilcoxon의 tt에 대한 효율(정리 2.3). 회색 점선은 1, 빨간 점선은 하한 0.864다. ε≈0.01\varepsilon\approx0.01에서 1을 넘는다.
연습문제

연습 2.1 (세 분포의 효율 ★) 정규에서 ∫ϕ2=1/(2π)\int\phi^2=1/(2\sqrt\pi), Laplace 12e−∣x∣\tfrac12e^{-|x|}에서 σ2=2\sigma^2=2, ∫f2=1/4\int f^2=1/4, 로지스틱에서 σ2=π2/3\sigma^2=\pi^2/3, ∫f2=1/6\int f^2=1/6임을 보이고 표의 3/π3/\pi, 1.51.5, π2/9\pi^2/9를 얻어라.

풀이

정규: ∫ϕ2=12π∫e−x2dx=12π\int\phi^2=\tfrac1{2\pi}\int e^{-x^2}dx=\tfrac1{2\sqrt\pi}, 12⋅14π=3/π12\cdot\tfrac1{4\pi}=3/\pi. Laplace: ∫x212e−∣x∣=2\int x^2\tfrac12e^{-|x|}=2, ∫14e−2∣x∣=14\int\tfrac14e^{-2|x|}=\tfrac14, 12⋅2⋅116=1.512\cdot2\cdot\tfrac1{16}=1.5. 로지스틱: σ2=π2/3\sigma^2=\pi^2/3, ∫f2=∫01u(1−u) du=1/6\int f^2=\int_0^1u(1-u)\,du=1/6 (u=F(x)u=F(x), f=u(1−u)f=u(1-u)로 치환), 12⋅π23⋅136=π2/912\cdot\tfrac{\pi^2}3\cdot\tfrac1{36}=\pi^2/9.

연습 2.2 (포물선 밀도 ★★) 정리 2.5의 hh에서 ∫h=1\int h=1, ∫x2h=1\int x^2h=1, ∫h2=35/25\int h^2=3\sqrt5/25를 직접 계산하라.

풀이

∫−55(5−x2) dx=2053\int_{-\sqrt5}^{\sqrt5}(5-x^2)\,dx=\tfrac{20\sqrt5}3이므로 c=3205c=\tfrac3{20\sqrt5}. c∫x2(5−x2) dx=c⋅2053=1c\int x^2(5-x^2)\,dx=c\cdot\tfrac{20\sqrt5}3=1. ∫h2=c∫h(x)(5−x2) dx\int h^2=c\int h(x)(5-x^2)\,dx (받침 위)=c(5−1)=4c=355=3525=c(5-1)=4c=\tfrac{3}{5\sqrt5}=\tfrac{3\sqrt5}{25}.

연습 2.3 (효능에서 표본 크기로 ★) 정규 자료에서 tt 검정이 100쌍으로 얻는 검정력을 Wilcoxon으로 얻으려면 대략 몇 쌍이 필요한가? Laplace 자료에서는?

풀이

정규에서는 100/0.955≈105100/0.955\approx105쌍, Laplace에서는 100/1.5≈67100/1.5\approx67쌍이다.

연습 2.4 (부호검정 ★★) 한 표본 위치 문제에서 양수의 개수로 하는 부호검정의 효능이 2f(0)2f(0), tt 검정의 효능이 1/σ1/\sigma임을 보이고 ARE 4σ2f(0)24\sigma^2f(0)^2을 구하라. 정규분포에서는 2/π=0.6372/\pi=0.637이다. (8회 정리 1.4의 표본 중앙값의 분산과 비교하라.)

풀이

S=1n#{Xi>0}S=\tfrac1n\#\{X_i>0\}의 평균은 P(X>0)=1−F(−θ)P(X>0)=1-F(-\theta)이므로 μ′(0)=f(0)\mu^\prime(0)=f(0), 귀무가설 아래 표준편차는 1/(2n)1/(2\sqrt n)이어서 효능은 2f(0)2f(0). tt의 효능은 1/σ1/\sigma이므로 ARE =4σ2f(0)2=4\sigma^2f(0)^2. 정규에서 4⋅12π=2π4\cdot\tfrac1{2\pi}=\tfrac2\pi. 이것은 평균과 표본 중앙값의 분산의 비 σ2/(1/(4f(0)2))\sigma^2/(1/(4f(0)^2))와 같다(8회 정리 1.4).

연습 2.5 (효능과 효율의 증명 ★★ 유도형) 명제 2.2를 다음 순서로 증명하라. θ=h/N\theta=h/\sqrt N이다.

  1. (a)

    크기 α\alpha의 한쪽 검정의 기각역이 ZN=N(TN−μ(0))/σ(0)>zαZ_N=\sqrt N\bigl(T_N-\mu(0)\bigr)/\sigma(0)>z_\alpha임을 적고, 위 상자의 가정으로 ZN→DN(he,1)Z_N\xrightarrow{D}\N(he,1)임을 확인하라.

  2. (b)

    극한분포가 연속이므로 P(ZN>zα)→1−Φ(zα−he)P(Z_N>z_\alpha)\to1-\Phi(z_\alpha-he)임을 보여라. 분포수렴의 정의에서 어느 점의 연속성을 쓰는가?

  3. (c)

    같은 고정된 θ\theta에서 h=θNh=\theta\sqrt N이다. 두 검정의 극한 검정력이 같으려면 θN1e1=θN2e2\theta\sqrt{N_1}e_1=\theta\sqrt{N_2}e_2이어야 함을 보이고 N2/N1=(e1/e2)2N_2/N_1=(e_1/e_2)^2을 얻어라.

풀이

(a) 귀무가설 아래 ZN=N(TN−μ(0))/σ(0)→DN(0,1)Z_N=\sqrt N(T_N-\mu(0))/\sigma(0)\xrightarrow{D}\N(0,\allowbreak 1)이므로 크기 α\alpha의 한쪽 검정은 ZN>zαZ_N>z_\alpha에서 기각한다. θN=h/N\theta_N=h/\sqrt N 아래에서는 상자의 가정으로 ZN→DN(hμ′(0)/σ(0),1)=N(he,1)Z_N\xrightarrow{D}\N(h\mu^\prime(0)/\sigma(0),\allowbreak 1)=\N(he,\allowbreak 1)이다. (b) N(he,1)\N(he,1)의 분포함수는 연속이므로 분포수렴의 정의가 모든 점에서, 특히 zαz_\alpha에서 성립한다(7회 정의 2.1). 따라서 P(ZN>zα)=1−P(ZN≤zα)→1−Φ(zα−he)P(Z_N>z_\alpha)=1-P(Z_N\le z_\alpha)\to1-\Phi(z_\alpha-he)이다. (c) 고정된 작은 θ\theta에서 표본 크기 NjN_j를 쓰면 hj=θNjh_j=\theta\sqrt{N_j}이고 극한 검정력은 1−Φ(zα−θNjej)1-\Phi(z_\alpha-\theta\sqrt{N_j}e_j)이다. Φ\Phi는 순증가이므로 두 검정력이 같은 것은 θN1e1=θN2e2\theta\sqrt{N_1}e_1=\theta\sqrt{N_2}e_2일 때이고, 곧 N2/N1=(e1/e2)2N_2/N_1=(e_1/e_2)^2이다.

이 회차에서 읽은 절 0개 · 회차 차례