Skip to content

15회 · 가정이 틀리면 · 노트

5 부트스트랩 (1949–1979) ​

역사 로버스트 추정량에는 곤란한 점이 하나 있었다. 표준오차의 공식이 분포에 의존한다는 것이다. 정리 3.2의 V(ψ,F)V(\psi,F)에는 모르는 FF가 들어 있다. Maurice Quenouille(1949)는 관측을 하나씩 빼고 다시 계산해 치우침을 줄이는 방법을 냈고, Tukey(1958)는 그것으로 분산까지 재며 “잭나이프”(무엇에든 쓰는 주머니칼)라 불렀다. 1979년 Bradley Efron은 Annals of Statistics에서 더 단순하고 더 일반적인 생각을 내놓았다. 모르는 FF를 경험분포 F^n\hat F_n으로 바꾸고, F^n\hat F_n에서 표본을 다시 뽑아 추정량의 분포를 컴퓨터로 만든다. 이름은 “자기 장화 끈을 잡아당겨 스스로를 들어 올린다”는 허풍에서 왔다.

5.1 plug-in과 부트스트랩 ​

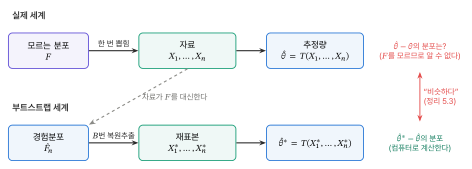
정의 5.1 (부트스트랩) 자료 X1,…,XnX_1,\dots,X_n이 주어졌을 때 F^n\hat F_n에서 뽑은 크기 nn의 표본, 곧 원래 자료에서 복원추출한 X1∗,…,Xn∗X_1^*,\dots,X_n^*를 부트스트랩 표본이라 한다. 통계량 θ^=T(X1,…,Xn)\hat\theta=T(X_1,\dots,X_n)의 부트스트랩 분포는 자료를 고정했을 때 θ^∗=T(X1∗,…,Xn∗)\hat\theta^*=T(X_1^*,\allowbreak \dots,\allowbreak X_n^*)의 분포다. 원리는 한 줄이다.

F 에서의 θ^−θ 의 분포 ≈ F^n 에서의 θ^∗−θ^ 의 분포.F\ \text{에서의}\ \hat\theta-\theta\ \text{의 분포}\ \approx\ \hat F_n\ \text{에서의}\ \hat\theta^*-\hat\theta\ \text{의 분포}.
그림 5.1. 부트스트랩의 두 세계. 실제 세계에서는 모르는 F에서 자료가 한 번 뽑히고, 추정량의 오차 분포를 알 수 없다. 부트스트랩 세계에서는 자료의 경험분포 F̂_n이 F의 자리에 서고, 거기서는 표본을 몇 번이든 다시 뽑을 수 있다. 두 세계의 오차 분포가 비슷하다는 것이 정리 5.3의 내용이다.
그림 5.1 부트스트랩의 두 세계. 실제 세계에서는 모르는 FF에서 자료가 한 번 뽑히고, 추정량의 오차 분포를 알 수 없다. 부트스트랩 세계에서는 자료의 경험분포 F^n\hat F_n이 FF의 자리에 서고, 거기서는 표본을 몇 번이든 다시 뽑을 수 있다. 두 세계의 오차 분포가 비슷하다는 것이 정리 5.3의 내용이다.

알고리즘 5.2 (몬테카를로 부트스트랩) 

  1. 1.

    b=1,…,Bb=1,\dots,B에 대해 자료에서 nn개를 복원추출해 θ^b∗\hat\theta_b^*를 계산한다.

  2. 2.

    표준오차: SE^=1B−1∑(θ^b∗−θˉ∗)2\widehat{\mathrm{SE}}=\sqrt{\tfrac1{B-1}\sum(\hat\theta_b^*-\bar\theta^*)^2}.

  3. 3.

    백분위 구간: θ^b∗\hat\theta_b^*들의 α/2\alpha/2, 1−α/21-\alpha/2 분위수.

F^n\hat F_n에서의 분포는 원리적으로 정확히 계산할 수 있는 양이다(nnn^n가지 표본). 몬테카를로는 그것을 근사할 뿐이다(7회). BB가 수천이면 그 오차는 무시할 만하다.

정리 5.3 (평균의 부트스트랩) X1,X2,…∼iidFX_1,X_2,\dots\iid F이고 E∣X∣3<∞E|X|^3<\infty, σ2=Var⁡X>0\sigma^2=\Var X>0이라 하자. 자료를 고정한 조건부 확률 P∗P^*에서

  1. (a)

    E∗Xˉ∗=XˉE^*\bar X^*=\bar X, Var⁡∗Xˉ∗=σ^2/n\Var^*\bar X^*=\hat\sigma^2/n, 여기서 σ^2=1n∑(Xi−Xˉ)2\hat\sigma^2=\tfrac1n\sum(X_i-\bar X)^2이다.

  2. (b)

    거의 확실하게 sup⁡x∣P∗(n(Xˉ∗−Xˉ)≤x)−P(n(Xˉ−μ)≤x)∣→0\sup_x\bigl|P^*\bigl(\sqrt n(\bar X^*-\bar X)\le x\bigr)-P\bigl(\sqrt n(\bar X-\mu)\le x\bigr)\bigr|\to0이다.

증명 전략 자료를 고정하면 부트스트랩 표본은 F^n\hat F_n에서 뽑은 iid 표본이다. (a)는 그 평균과 분산이다. (b)는 두 분포함수를 모두 정규분포함수와 비교한다. 부트스트랩 쪽은 F^n\hat F_n에 쓴 Berry–Esseen 한계로, 실제 쪽은 FF에 쓴 같은 한계로 누르고, 가운데를 삼각부등식으로 잇는다 [T4].

(a)

  1. P∗P^*에서 Xi∗X_i^*는 F^n\hat F_n에서 독립으로 뽑히므로 E∗Xi∗=1n∑Xj=XˉE^*X_i^*=\tfrac1n\sum X_j=\bar X, Var⁡∗Xi∗=1n∑(Xj−Xˉ)2=σ^2\Var^*X_i^*=\tfrac1n\sum(X_j-\bar X)^2=\hat\sigma^2이다.정의 5.1

  2. E∗Xˉ∗=XˉE^*\bar X^*=\bar X, Var⁡∗Xˉ∗=σ^2/n\Var^*\bar X^*=\hat\sigma^2/n이다.선형성, 독립합의 분산(2회 정리 2.8)

(b)

  1. ρ^=1n∑∣Xi−Xˉ∣3\hat\rho=\tfrac1n\sum|X_i-\bar X|^3으로 두면, 조건부로 iid인 Xi∗X_i^*에 Berry–Esseen 한계를 써서

    sup⁡x∣P∗(n(Xˉ∗−Xˉ)≤x)−Φ(x/σ^)∣≤Cρ^σ^3n.\sup_x\Bigl|P^*\bigl(\sqrt n(\bar X^*-\bar X)\le x\bigr)-\Phi(x/\hat\sigma)\Bigr|\le\frac{C\hat\rho}{\hat\sigma^3\sqrt n} .
    7회 3절의 상자, F^n\hat F_n에
  2. σ^→σ>0\hat\sigma\to\sigma>0이고 ρ^→E∣X−μ∣3<∞\hat\rho\to E|X-\mu|^3<\infty이므로 1의 오른쪽은 0으로 간다.대수의 법칙, 연속사상 [T5]

  3. 같은 한계를 FF에 쓰면 sup⁡x∣P(n(Xˉ−μ)≤x)−Φ(x/σ)∣≤Cρ/(σ3n)→0\sup_x\bigl|P\bigl(\sqrt n(\bar X-\mu)\le x\bigr)-\Phi(x/\sigma)\bigr|\le C\rho/(\sigma^3\sqrt n)\to0이다.7회 3절의 상자

  4. sup⁡x∣Φ(x/σ^)−Φ(x/σ)∣→0\sup_x|\Phi(x/\hat\sigma)-\Phi(x/\sigma)|\to0이다. 평균값 정리로 이 차는 ∣x∣ ∣1σ^−1σ∣ ϕ(ξ)|x|\,|\tfrac1{\hat\sigma}-\tfrac1\sigma|\,\phi(\xi)이고, ∣x∣ϕ(ξ)|x|\phi(\xi)는 σ^\hat\sigma가 σ\sigma 근처에 있는 동안 xx에 대해 유계다.평균값 정리 [T8]

  5. 1–4를 삼각부등식으로 이으면 결론이 나온다.[T4]

조건 확인 2에서 “거의 확실하게”라고 쓴 수렴은 강한 대수의 법칙이 필요하다. 이 과정은 그것을 진술만 했다(7회 1절). 약한 대수의 법칙(7회 정리 1.6)만 쓰면 같은 논증으로 5의 상한이 확률수렴으로 0으로 간다는, 조금 약한 결론이 나온다. ρ^\hat\rho의 수렴은 ∣Xi−Xˉ∣3|X_i-\bar X|^3을 ∣Xi−μ∣3|X_i-\mu|^3과 Xˉ−μ\bar X-\mu의 다항식으로 눌러 얻는다(E∣X∣3<∞E|X|^3<\infty를 쓴다).

부트스트랩 표준오차 σ^/n\hat\sigma/\sqrt n은 보통의 공식 s/ns/\sqrt n과 (n−1)/n\sqrt{(n-1)/n}배 다를 뿐이다. 평균에서는 새것이 없다. 부트스트랩의 값은 공식이 없는 추정량, 곧 중앙값, 절사평균, Huber 추정량, 상관계수, 회귀계수의 비 같은 것에서 같은 계산이 그대로 통한다는 데 있다.

5.2 더 나은 구간: BCa ​

백분위 구간은 θ^∗\hat\theta^*의 분포가 θ^\hat\theta를 중심으로 대칭이고 치우침이 없을 때 잘 맞는다. Efron(1987)의 BCa(치우침 수정·가속) 구간은 두 가지를 고친다.

정의 5.4 (BCa 구간) z^0=Φ−1(#{θ^b∗<θ^}/B)\hat z_0=\Phi^{-1}\bigl(\#\{\hat\theta_b^*<\hat\theta\}/B\bigr) (치우침), 잭나이프 값 θ^(i)\hat\theta_{(i)} (관측 ii를 뺀 추정)과 그 평균 θ^(⋅)\hat\theta_{(\cdot)}으로

a^=∑(θ^(⋅)−θ^(i))36[∑(θ^(⋅)−θ^(i))2]3/2(가속),αj=Φ(z^0+z^0+z(j)1−a^(z^0+z(j)))\hat a=\frac{\sum(\hat\theta_{(\cdot)}-\hat\theta_{(i)})^3}{6\bigl[\sum(\hat\theta_{(\cdot)}-\hat\theta_{(i)})^2\bigr]^{3/2}}\quad\text{(가속)},\qquad \alpha_j=\Phi\Bigl(\hat z_0+\frac{\hat z_0+z_{(j)}}{1-\hat a(\hat z_0+z_{(j)})}\Bigr)

로 두고, 부트스트랩 분포의 α1\alpha_1, α2\alpha_2 분위수를 구간으로 쓴다(z(1)=zα/2z_{(1)}=z_{\alpha/2}의 아래쪽, z(2)z_{(2)}는 위쪽 분위수).

증명 없이 쓰는 사실 (BCa의 정확도 (Efron 1987, Hall 1988)) 매끄러운 통계량에서 BCa 구간의 포함확률 오차는 O(1/n)O(1/n)이고, 백분위 구간과 정규근사 구간은 O(1/n)O(1/\sqrt n)이다. 변환 불변이어서, θ\theta의 구간을 g(θ)g(\theta)로 옮기면 g(θ)g(\theta)의 BCa 구간이 된다.

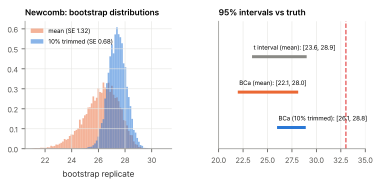
예제 5.5 (Newcomb와 Cavendish의 부트스트랩) B=20,000B=20{,}000으로 Newcomb의 66번에서 표준오차를 구하면 평균 1.32 (공식 s/n=1.32s/\sqrt n=1.32), 중앙값 0.68, 10% 절사평균 0.68이다. 평균의 95% 구간은 tt로 [23.6, 28.9][23.6,\ 28.9], BCa로 [22.1, 28.0][22.1,\ 28.0]이다. BCa는 두 큰 음의 오차가 만든 왼쪽 꼬리를 반영해 아래로 늘어난다. 절사평균의 BCa 구간은 [26.1, 28.8][26.1,\ 28.8]로 절반쯤 좁다. 어느 구간도 참값 33.02를 포함하지 않는다. Cavendish의 평균에서는 부트스트랩 표준오차 0.038이 공식 0.038과 같고, BCa 구간 [5.41, 5.56][5.41,\ 5.56]이 tt 구간과 거의 같다(그림 5.2).

그림 5.2. Newcomb의 부트스트랩 분포. 왼쪽: 평균(주황)과 10% 절사평균(파랑)의 부트스트랩 분포. 평균의 분포는 넓고 왼쪽 꼬리가 길다. 오른쪽: 세 가지 95% 구간(t, 평균의 BCa, 절사평균의 BCa)과 참값 33.02(빨간 점선).
그림 5.2 Newcomb의 부트스트랩 분포. 왼쪽: 평균(주황)과 10% 절사평균(파랑)의 부트스트랩 분포. 평균의 분포는 넓고 왼쪽 꼬리가 길다. 오른쪽: 세 가지 95% 구간(tt, 평균의 BCa, 절사평균의 BCa)과 참값 33.02(빨간 점선).

5.3 잭나이프 ​

정의 5.6 (잭나이프 표준오차) θ^(i)\hat\theta_{(i)}를 관측 ii를 뺀 추정, θ^(⋅)=1n∑θ^(i)\hat\theta_{(\cdot)}=\tfrac1n\sum\hat\theta_{(i)}라 할 때 SE^jack=n−1n∑(θ^(i)−θ^(⋅))2\widehat{\mathrm{SE}}_{\mathrm{jack}}=\sqrt{\tfrac{n-1}n\sum(\hat\theta_{(i)}-\hat\theta_{(\cdot)})^2}이다.

잭나이프는 nn번의 계산으로 끝나고 매끄러운 통계량에서는 부트스트랩과 비슷한 답을 준다. 그러나 중앙값처럼 매끄럽지 않은 통계량에서는 일치하지 않는다(연습 5.2). 부트스트랩이 더 일반적인 이유다.

연습문제

연습 5.1 (평균의 잭나이프 ★) θ^=Xˉ\hat\theta=\bar X이면 SE^jack=s/n\widehat{\mathrm{SE}}_{\mathrm{jack}}=s/\sqrt n으로 보통의 공식과 정확히 같음을 보여라.

풀이

θ^(i)=(nXˉ−Xi)/(n−1)\hat\theta_{(i)}=(n\bar X-X_i)/(n-1)이므로 θ^(i)−θ^(⋅)=−(Xi−Xˉ)/(n−1)\hat\theta_{(i)}-\hat\theta_{(\cdot)}=-(X_i-\bar X)/(n-1). n−1n∑(Xi−Xˉ)2(n−1)2=s2n\tfrac{n-1}n\sum\tfrac{(X_i-\bar X)^2}{(n-1)^2}=\tfrac{s^2}n.

연습 5.2 (중앙값의 잭나이프 ★★) n=2mn=2m이 짝수이면 관측 하나를 뺀 중앙값은 X(m)X_{(m)} 또는 X(m+1)X_{(m+1)}의 두 값뿐임을 보이고, 잭나이프 표준오차가 X(m+1)−X(m)X_{(m+1)}-X_{(m)} 하나에만 의존해 일치추정량이 될 수 없음을 설명하라.

풀이

X(m)X_{(m)} 이하의 관측을 빼면 남은 2m−12m-1개의 중앙값은 X(m+1)X_{(m+1)}이고, X(m+1)X_{(m+1)} 이상을 빼면 X(m)X_{(m)}이다. 각각 mm번이므로 SE^jack2=n−1n⋅n⋅(d/2)2\widehat{\mathrm{SE}}^2_{\mathrm{jack}}=\tfrac{n-1}n\cdot n\cdot(d/2)^2, d=X(m+1)−X(m)d=X_{(m+1)}-X_{(m)}이다. dd는 가운데 이웃한 두 순서통계량의 간격으로, nn을 곱해도 상수로 가지 않는 무작위한 양(대략 지수분포)이다. 그래서 잭나이프 분산과 참 분산의 비가 1로 가지 않는다.

연습 5.3 (부트스트랩 표본의 다양성 ★★) 크기 nn의 부트스트랩 표본에 원래 관측 ii가 한 번도 들어가지 않을 확률이 (1−1/n)n→e−1=0.368(1-1/n)^n\to e^{-1}=0.368임을 보이고, 부트스트랩 표본에 서로 다른 관측이 평균 n(1−(1−1/n)n)≈0.632nn(1-(1-1/n)^n)\approx0.632n개 있음을 보여라. (8절의 out-of-bag이 이것이다.)

풀이

nn번의 복원추출이 모두 관측 ii를 피할 확률은 (1−1/n)n→e−1(1-1/n)^n\to e^{-1}. 서로 다른 관측의 수는 지시변수 nn개의 합이므로 평균은 n(1−(1−1/n)n)≈0.632nn(1-(1-1/n)^n)\approx0.632n.

연습 5.4 (정확한 부트스트랩 ★★) n=3n=3, 자료 (1,2,6)(1,2,6)일 때 서로 다른 부트스트랩 표본(다중집합)이 (53)=10\binom53=10개임을 보이고, 각각의 확률(다항계수/27/27)로 중앙값의 부트스트랩 분포를 정확히 계산하라.

풀이

(1,2,6)(1,2,6)의 개수 (a,b,c)(a,b,c), a+b+c=3a+b+c=3인 다중집합이 10개이고 확률은 3!a!b!c!/27\tfrac{3!}{a!b!c!}/27이다. 중앙값은 1이 두 번 이상이면 1 (1+3+327=727\tfrac{1+3+3}{27}=\tfrac7{27}), 6이 두 번 이상이면 6 (727\tfrac7{27}), 그 밖에는 2 (1327\tfrac{13}{27})이다.

이 회차에서 읽은 절 0개 · 회차 차례