
테마
15회 · 가정이 틀리면 · 노트
3 로버스트 추정 (1960–1974)
역사 1960년 Tukey는 정규분포에 표준편차가 세 배인 정규를 조금 섞은 분포에서 여러 추정량을 비교했다. 섞는 비율이 1%만 되어도 표본평균은 최선의 자리를 잃었다(11회 7절의 은 그 극단이다). 1964년 취리히의 Peter Huber는 위치모수의 로버스트 추정에서 질문을 뒤집었다. 오염의 비율만 알고 꼴은 모를 때, 최악의 경우의 분산이 가장 작은 추정량은 무엇인가? 답은 가운데서는 평균처럼, 바깥에서는 중앙값처럼 행동하는 추정량이었다. Frank Hampel(1968, 1974)은 관측 하나가 추정량을 얼마나 움직이는지 재는 영향함수와, 추정량이 무너지기 전에 견딜 수 있는 오염의 비율인 붕괴점을 정의했다. 1972년 Princeton의 대규모 모의실험은 68개의 추정량을 비교했고, Robert Hogg(1974)는 자료의 꼬리 모양을 보고 추정량을 고르는 적응적 방법을 내놓았다.
3.1 M-추정
정의 3.1 (M-추정량) 함수 와 척도 에 대해 의 해 를 M-추정량이라 한다. 이면 평균, 이면 중앙값이고,
이면 Huber 추정량이다. 척도는 보통 중앙절대편차를 로 나눈 값(정규분포에서 의 일치추정량)으로 미리 정한다.
Huber 추정량은 표준화한 잔차가 안이면 평균처럼 값을 그대로 쓰고, 밖이면 로 잘라 쓴다. MLE는 인 M-추정량이다(9회). 그래서 Huber 추정량은 가운데는 정규, 꼬리는 Laplace인 밀도의 MLE이기도 하다.
정리 3.2 (M-추정량의 점근정규성) 척도를 1로 알고, 가 0에 대해 대칭이며, 가 홀함수이고 단조증가하며 거의 어디서나 미분가능하고, , 라 하자. 그러면 에서
증명 전략 9회 정리 3.1의 증명에서 점수함수 자리에 를 둔다. 의 영점을 0 둘레에서 전개해 를 분자와 분모의 비로 쓰고 [T8], 분자는 중심극한정리로, 분모는 대수의 법칙으로 다룬 뒤 Slutsky 정리로 합친다.
가 단조증가이므로 는 에 대해 감소하고, 는 그 영점이다.정의 3.1
로 두면 이고(가 홀함수, 가 대칭) 이다. 그래서 작은 에서 이다.대칭, 적분 기호 아래 미분 [T6]
이므로 이다. 그 사건 위에서 이므로 이다.Khinchin(7회 정리 1.6), 1
로 두면, 과 사이의 이 있어
Taylor [T8]정리하면
4분자: 는 평균 0(), 분산 인 iid이므로 이다.중심극한정리, 7회 정리 3.1
분모: 이고, 이다.Khinchin(7회 정리 1.6), 3
극한은 이다.Slutsky, 7회 정리 4.2
조건 확인 2의 미분은 가 거의 어디서나 미분가능하고 인 데서 지배수렴으로 정당화된다 [T6]. 4와 7은 가 두 번 미분가능하고 가 유계라고 쓴 것이다. 9회 정리 3.1의 5와 같은 자리다. Huber의 는 에서 꺾이므로 이 조건을 만족하지 않는다. 그때는 의 단조성으로 나머지를 다룬다(Huber 1964). 이 부분은 증명 없이 쓴다.
예제 3.3 (오염 정규에서의 점근분산) 에서 를 정확히 적분하면
| 평균 | 중앙값 | 10% 절사평균 | Huber () | |
|---|---|---|---|---|
| 0 | 1.000 | 1.571 | 1.060 | 1.053 |
| 0.05 | 1.400 | 1.681 | 1.169 | 1.169 |
| 0.10 | 1.800 | 1.803 | 1.296 | 1.299 |
이다. 정규분포에서 Huber 추정량은 평균의 95% 효율을 갖고(), 오염이 5%면 평균보다 17% 낫다. 중앙값은 정규에서 36%를 잃지만 오염이 커지면 평균을 따라잡는다. 는 정규에서 효율이 정확히 0.95가 되도록 고른 값이다.
증명 없이 쓰는 사실 (Huber의 최소최대 정리 (1964)) (는 아무 대칭 분포) 꼴의 모든 분포 가운데 최악의 점근분산을 가장 작게 하는 M-추정량은 이고, 는 으로 정해진다. 이면 이다. 최악의 분포는 가운데가 정규이고 꼬리가 지수적으로 줄어드는 분포다.
3.2 영향함수와 붕괴점
정의 3.4 (영향함수) 추정량을 분포의 함수 로 쓸 때, 점 에 질량 를 더한 분포 에 대해
를 영향함수라 한다. 관측 하나가 에 더해질 때 추정량이 움직이는 양의 배쯤이다.
명제 3.5 (M-추정량의 영향함수) 정리 3.2의 조건에서 이다. 따라서 평균의 영향함수는 로 유계가 아니고, 중앙값은 , Huber 추정량은 로 유계다. 그리고 이다.
증명 전략 가 만족하는 추정 방정식을 로 미분하고 을 넣는다(음함수 미분). 마지막 식은 영향함수의 정의를 정리 3.2의 에 넣어 비교한다. 단계별 증명은 연습 3.5(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.
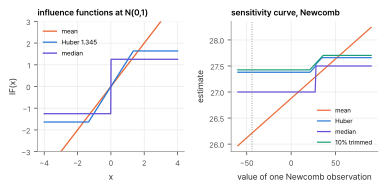
영향함수는 3절의 모든 이야기를 한 그림에 담는다(그림 3.1). 평균은 이상치 하나에 끝없이 끌려가고, Huber 추정량과 중앙값은 일정한 양 이상 끌려가지 않는다. 그리고 점근분산은 영향함수의 제곱의 평균이다. 이상치에 둔감할수록, 정규 자료에서는 조금씩 정보를 버린다.
정의 3.6 (붕괴점) 표본 개 가운데 개를 마음대로 바꿔 추정량을 원하는 만큼 멀리 보낼 수 있는 가장 작은 를 라 할 때 을 유한 표본 붕괴점이라 한다.
명제 3.7 (세 추정량의 붕괴점) 표본평균의 붕괴점은 , 표본중앙값은 (곧 근처), 양쪽에서 개씩 자른 절사평균은 이다.
증명 전략 추정량마다 두 가지를 보인다. 개를 바꾸면 추정량을 끝없이 보낼 수 있다는 것, 그보다 적게 바꾸면 추정량이 원래 표본의 최솟값과 최댓값 사이에 묶인다는 것이다. 단계별 증명은 연습 3.6(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.
예제 3.8 (Newcomb의 66번) Newcomb의 통과 시간(24,800나노초에서 뺀 값)에는 와 의 두 큰 오차가 있다. 여러 추정량은
이다. 로버스트 추정량들은 서로 0.5 안에서 일치하고 평균만 1 넘게 떨어져 있다. 부트스트랩 표준오차(5절)는 평균이 1.32, 중앙값과 절사평균이 0.68로, 로버스트 추정량이 두 배 정밀하다. 그러나 오늘의 값으로 옮긴 참값은 33.02다(Stigler 1977). 어느 추정량도 5 넘게 빗나갔다. 4절의 주제다.
연습문제
연습 3.1 (Huber 추정량은 MLE다 ★) , (), ()의 위치모수 MLE가 Huber 추정량임을 보여라.
풀이
상수이고 는 볼록하며 이다. 최소점의 조건은 이다.
연습 3.2 (정규에서의 Huber 효율 ★★) 에서 , 임을 보이고, 에서 효율 를 확인하라.
풀이
이므로 . 이고 (부분적분). 에서 , , , 효율 .
연습 3.3 (중앙값의 영향함수 ★★) 에 대해 의 중앙값을 직접 계산해 을 보이고, 이 8회 정리 1.4의 점근분산 임을 확인하라.
풀이
이면 의 중앙값 는 를 풀므로 , 곧 . 이면 에서 . 로 상수이므로 평균도 같다.
연습 3.4 (붕괴점 ★) 인 Newcomb의 자료에서 평균, 중앙값, 10% 절사평균의 붕괴점을 구하라. 큰 오차가 몇 개까지면 10% 절사평균이 그것을 모두 버리는가?
풀이
평균 , 중앙값 . 10% 절사평균은 양쪽에서 개씩 자르므로 붕괴점은 이고, 한쪽의 큰 오차가 6개까지는 모두 잘려 나간다. Newcomb의 두 오차는 넉넉히 버려진다.
연습 3.5 (M-추정량의 영향함수: 증명 ★★ 유도형) 명제 3.5를 다음 순서로 증명하라. , 로 쓴다.
- (a)
가 을 만족함을 M-추정량의 정의에서 보여라.
- (b)
(a)를 로 미분하고 을 넣어 를 얻어라. 을 어디서 쓰는가? (미분과 적분의 교환은 [T6]의 조건으로 확인한다.)
- (c)
중앙값()에서는 이 없다. 대신 를 쓰면 이 됨을 보여라. Huber 추정량의 분모 도 구하라().
- (d)
임을 보여라.
연습 3.6 (세 추정량의 붕괴점: 증명 ★★ 유도형) 명제 3.7를 증명하라. 표본 을 고정하고 개를 마음대로 바꾼 표본을 라 한다.
- (a)
평균: 로 를 원하는 만큼 멀리 보낼 수 있음을 보여라.
- (b)
중앙값(이 홀수, ): 이면 의 중앙값이 원래 표본의 최솟값과 최댓값 사이에 있음을 보여라. (바뀌지 않은 값이 개 이상 남는다. 중앙값보다 작거나 같은 값이 개, 크거나 같은 값이 개다.) 이면 끝없이 보낼 수 있음을 보여라.
- (c)
절사평균: 양쪽에서 개씩 자를 때, 이면 남는 값이 모두 원래 표본의 최솟값과 최댓값 사이에 있음을, 이면 그렇지 않음을 보여라.
풀이
(a) 을 로 바꾸면 이고 는 마음대로다. 따라서 이다. (b) 이면 중앙값은 번째 순서통계량이다. 개만 바꾸면 바뀌지 않은 원래 값이 개 남는다. 이 값들은 모두 이하이므로 에서 이하인 값이 개 이상이고, 이다. 같은 방법으로 이다. 이면 개를 모두 아주 큰 값 로 바꿔 로 만들 수 있다. 붕괴점은 이다. (c) 이면 보다 작은 값은 기껏 개이므로 이고, 같은 방법으로 이다. 남는 값 는 모두 에 있다. 이면 개를 큰 값 로 바꿔 로 만들 수 있고 절사평균은 이상으로 커진다. 붕괴점은 이다.