
테마
15회 · 가정이 틀리면 · 노트
4 참값이 있는 자료로 — Stigler (1977)
역사 로버스트 추정량들은 대부분 시뮬레이션으로 비교되었다. 오염 정규, 분포, Cauchy 같은 “두꺼운 꼬리”의 표본을 만들어 분산을 잰 것이다. 1977년 Stephen Stigler는 로버스트 추정량은 실제 자료를 다루는가?에서 다른 길을 택했다. 18–19세기의 과학자들이 오늘 참값을 아는 양을 잰 기록 24개를 모았다. Cavendish의 지구 밀도, Michelson과 Newcomb의 빛의 속도, Short(1763)의 태양 시차 같은 것이다. 그리고 11개의 추정량을 각 자료에 써서 참값과의 거리를 쟀다. 결론은 겸손했다. 약하게 자른 평균(10% 절사평균)이 전체적으로 가장 나았고, 표본평균도 크게 뒤지지 않았으며, 극단적으로 로버스트한 추정량은 오히려 나빴다. 그리고 어느 추정량이든 오차의 대부분은 측정의 체계적 편향이었다.
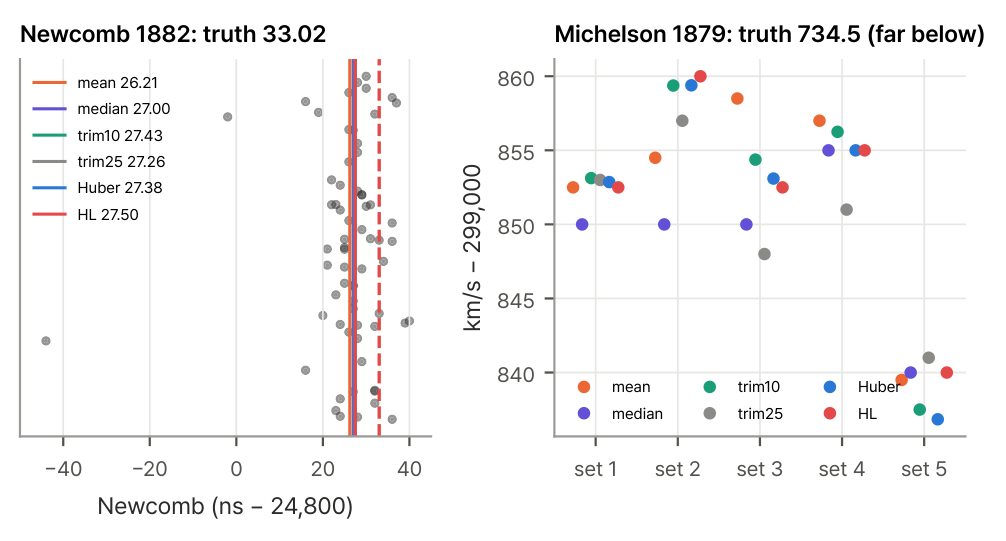
예제 4.1 (일곱 개의 자료) Cavendish(29개, 참값 5.513), Newcomb(66개, 33.02), Michelson(100개 전체와 20개씩의 다섯 묶음, 734.5)에 여섯 추정량을 쓰면 다음과 같다. 마지막 열은 평균의 오차를 평균의 표준오차로 나눈 것이다.
| 자료 | 평균 | 중앙값 | 10% 절사 | 25% 절사 | Huber | HL | (평균참)/SE | |
|---|---|---|---|---|---|---|---|---|
| Cavendish | 29 | 5.482 | 5.470 | 5.484 | 5.479 | 5.483 | 5.480 | |
| Newcomb | 66 | 26.21 | 27.00 | 27.43 | 27.27 | 27.38 | 27.50 | |
| Michelson | 100 | 852.4 | 850.0 | 852.3 | 849.0 | 851.5 | 850.0 | 14.9 |
| 묶음 1 | 20 | 852.5 | 850.0 | 853.1 | 853.0 | 852.9 | 852.5 | 7.3 |
| 묶음 2 | 20 | 854.5 | 850.0 | 859.4 | 857.0 | 859.4 | 860.0 | 5.8 |
| 묶음 3 | 20 | 858.5 | 850.0 | 854.4 | 848.0 | 853.1 | 852.5 | 8.0 |
| 묶음 4 | 20 | 857.0 | 855.0 | 856.3 | 851.0 | 855.0 | 855.0 | 5.7 |
| 묶음 5 | 20 | 839.5 | 840.0 | 837.5 | 841.0 | 836.8 | 840.0 | 7.1 |
표를 세 갈래로 읽을 수 있다. 첫째, Cavendish에서는 모든 추정량이 0.02 안에서 같고 참값과의 차이도 표준오차 안이다. 큰 오차가 없으면 무엇을 써도 같다. 둘째, Newcomb에서는 두 큰 오차 때문에 로버스트 추정량들이 평균보다 참값에 1 이상 가깝다. 3절의 이론이 말한 그대로다. 셋째, Michelson에서는 추정량들의 차이가 몇 km/s인데 참값과의 거리는 100 km/s를 넘는다. 표준오차의 6–15배다. 이 오차는 분포의 꼬리가 아니라 장치의 보정에서 왔다. 어떤 추정량도 체계적 편향을 고치지 못한다(3회 7절).
가정 주의 로버스트 추정량은 “분포가 정규에서 조금 벗어난” 경우를 지킨다. 모든 관측이 같은 방향으로 틀린 편향은 자료 안에서 보이지 않는다. 그것을 잡으려면 다른 방법으로 잰 측정과 비교해야 한다. Michelson 자신이 그 일을 했다. 그의 1879년 값은 1882년, 1924년, 1926년의 측정으로 차례로 고쳐졌다.
연습문제
연습 4.1 (오차의 분해 ★) Michelson 100개의 평균 852.4, 표준편차 79.0으로 평균제곱오차 를 편향의 제곱과 분산 으로 나누어 각각의 비율을 구하라. 로버스트 추정량이 줄일 수 있는 것은 어느 쪽인가?
풀이
편향의 제곱 , 분산 이므로 평균제곱오차의 99.6%가 편향이다. 로버스트 추정량이 줄일 수 있는 것은 분산 쪽뿐이고, 그것도 이 자료에서는 크지 않다.
연습 4.2 (Newcomb의 두 오차를 빼면 ★) 와 를 빼면 평균과 표준편차가 어떻게 되는가? 그 평균을 표 속의 로버스트 추정량들과 비교하라(노트북).
풀이
두 값을 빼면 64개의 평균은 , 표준편차는 5.08이다(11회 예제 6.2의 계산과 같다). 로버스트 추정량들(27.0–27.5)과 가깝다. 이상치를 “골라 빼는” 것과 로버스트 추정량은 이 자료에서 거의 같은 답을 준다.