
테마
11회 · 충분성 · 노트
6 데이터로 — Fisher의 계산과 Newcomb의 빛
6.1 1920년의 계산
정규 표본 에서 를 재는 두 통계량을 비교한다. 표준편차 와 평균편차 이다. 둘은 척도가 다르므로() 로그를 취해 비교한다. 와 의 점근분산의 비가 상대효율이다.
증명 없이 쓰는 사실 (중심을 추정해도 극한은 같다) 가 에 대해 대칭이고 평균 근처에서 연속이면, 와 의 차는 이다. 직관은 이렇다. 의 에서의 미분은 이므로, 중심을 만큼 잘못 잡아도 평균편차는 그 제곱의 크기로만 변한다. 증명은 경험과정의 논증이 필요해 생략한다. 표준편차에서는 같은 사실이 정확한 계산으로 성립한다(7회 예제 5.5).
명제 6.1 (평균편차의 효율 (Fisher 1920)) 정규 표본에서 와 의 점근분산은 각각 과 이고, 평균편차의 상대효율은
이다. 곧 같은 정밀도를 얻으려면 평균편차는 표준편차보다 관측이 배 필요하다.
증명 전략 상자의 사실로 를 iid 평균 로 바꾸고, 중심극한정리와 델타 방법을 두 통계량에 각각 쓴다 [T8]. 단계별 증명은 연습 6.4(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.
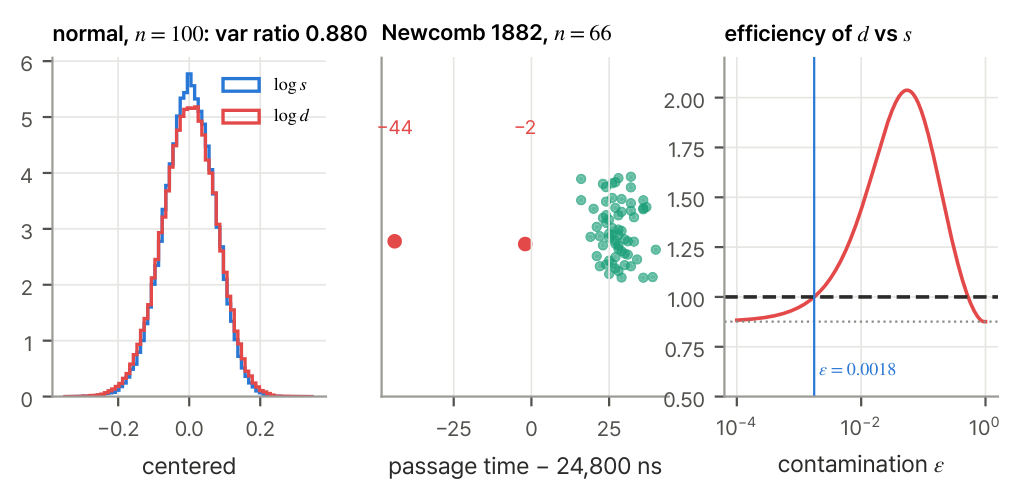
에서 10만 번 시뮬레이션하면 분산의 비는 약 0.88로 극한값 0.876에 가깝다. Fisher가 옳았다. 다만 그것은 오차가 정규분포를 따른다면의 이야기다. Eddington은 실제 관측에는 가끔 큰 오차가 섞인다는 것을 알고 있었다.
6.2 Newcomb의 빛의 통과 시간 (1882)
예제 6.2 (큰 오차 두 개) Simon Newcomb는 1882년 Potomac 강가의 실험실에서 Washington 기념탑 아래의 거울까지 빛이 갔다 오는 시간(약 7.4 km 왕복)을 66번 쟀다(MASS::newcomb, 24,800나노초에서 뺀 값). 64개는 16에서 40 사이에 있지만 두 개가 와 로 동떨어져 있다. 66개 전체의 표준편차는 10.75, 두 값을 빼면 5.08로 절반이 된다. 평균편차로 만든 같은 척도의 추정량 는 6.80에서 4.90으로, 덜 변한다. 표본을 다시 뽑아(부트스트랩, 15회) 와 의 분산의 비를 재면, 66개 전체에서 2.48로 평균편차가 훨씬 안정하다. 두 값을 뺀 64개에서는 0.78로, 정규 이론의 0.876 근처로 돌아간다(그림 6.1).
표준편차는 정규 모형 아래에서 충분하다. 모형이 맞지 않으면 충분성은 아무것도 보장하지 않는다. 큰 오차 하나가 을 지배하고, 표준편차는 그 하나를 정직하게 따라간다. 7절은 “정규에 아주 조금 섞인 큰 오차”만으로 순서가 뒤집힘을 보인다. 15회의 로버스트 통계가 Newcomb의 자료에서 다시 시작한다(Stigler 1977).
6.3 기병대와 독일 전차
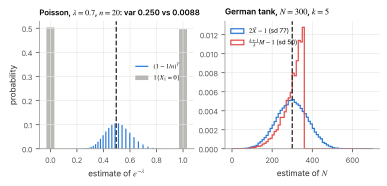
예제 6.3 (세 추정량의 비교) 기병대 자료의 추정값은 UMVUE , MLE , 관측 비율 이다. 앞의 둘은 에서 사실상 같고, 셋째(9회 연습 1.4의 비교)는 Poisson 모형을 쓰지 않은 추정이다. 모형을 쓰면 표준오차가 줄지만(관측 비율의 대 UMVUE의 ), 모형이 틀리면 치우친다. 이 자료에서 0.018의 차이는 표준오차보다 작아 우연으로 설명되지만, 군단 사이의 이질성(4회 , 9회 )은 Poisson 모형의 가정 자체를 의심하게 한다.
독일 전차에서 Rao–Blackwell화의 효과는 그림 6.2에 있다. 같은 다섯 개의 일련번호에서, 평균을 쓰는 적률법보다 최댓값을 쓰는 UMVUE가 표준편차 77 대 50으로 훨씬 좁다. 3절의 결론대로 최댓값 쪽은 모든 불편추정량 가운데 최선이다.
연습문제
연습 6.1 (평균편차의 적률 ★) 이면 , 임을 보이고 명제 6.1의 을 확인하라.
풀이
, . 비는 .
연습 6.2 (Laplace 오차에서는 ★★) 오차가 Laplace(이중지수) 분포이면 평균편차의 상대효율이 1보다 큼을 보여라. (, , .) 4회의 Laplace(1774)는 이 분포에서 중앙값을 권했다.
풀이
명제 7.1의 식으로 와 이므로 효율은 1.25다. Laplace 오차에서는 평균편차가 표준편차보다 낫다. 꼬리가 두꺼우면 제곱이 큰 오차에 너무 큰 무게를 준다.
연습 6.3 (Newcomb의 부트스트랩 ★) 노트북에서 Newcomb 자료의 부트스트랩 분산 비 2.48과 0.78을 재현하라. 두 값만 뺐는데 왜 이렇게 달라지는가?
풀이
66개의 제곱합 가운데 와 두 값이 약 5,700(76%)을 차지한다. 부트스트랩 표본마다 이 두 값이 뽑히는 횟수가 0, 1, 2, …로 달라지므로 가 크게 흔들린다. 평균편차는 거리를 제곱하지 않아 덜 흔들린다. 두 값을 빼면 자료가 정규에 가까워 0.78(정규 이론 0.876)이 된다.
연습 6.4 (평균편차의 효율: 증명 ★★ 유도형) 명제 6.1를 다음 순서로 증명하라. 상자의 사실을 받아들여 대신 를 쓴다.
- (a)
- (b)
델타 방법(7회 정리 4.4)을 에 써서 의 점근분산이 임을 보여라.
- (c)
의 점근분산 (7회 예제 5.5)에 로 델타 방법을 써서 의 점근분산 를 얻어라.
- (d)
두 점근분산의 비로 상대효율 를 얻고, 같은 정밀도에 필요한 관측 수의 비로 읽어라.
풀이
(a) 들은 iid이고 평균 , 분산 이다(연습 6.1에 ). 중심극한정리로 이다. (b) , 이므로 델타 방법으로 점근분산은 이다. 척도 가 약분되므로 를 취해 비교하는 것이 공정하다. (c) 이고 , 이므로 점근분산은 이다. (d) 상대효율은 이다. 점근분산이 이면 같은 분산을 얻는 데 드는 관측 수는 에 비례하므로, 평균편차는 표준편차보다 관측이 배 필요하다.