Skip to content

9회 · 최대가능도 · 노트

1 가능도와 최대가능도 추정량 ​

역사 Daniel Bernoulli의 1778년 논문(서로 어긋나는 여러 관측의 가장 그럴듯한 판정)의 문제의식은 이랬다. 천문학자들은 관측들의 평균을 취하는데, 모든 관측에 같은 무게를 주는 것이 옳은가? 크게 벗어난 관측은 덜 믿어야 하지 않는가? 그는 오차의 밀도로 반원 r2−x2\sqrt{r^2-x^2}을 골라 그 곱을 최대로 하는 값을 찾았고, 그 값이 평균보다 덜 벗어난 관측에 무게를 준다는 것을 보였다. 같은 해 Euler는 논평에서 확률을 곱하는 원리를 비판했다. 130여 년 뒤 Fisher는 케임브리지를 졸업하던 1912년에 같은 원리를 다시 제안했고, 1921년 “가능도”(likelihood)라는 이름을 붙였다. 그는 가능도가 확률이 아니라는 점을 강조했다. θ\theta에 대한 확률분포가 아니라, 자료를 고정한 θ\theta의 함수다.

1.1 정의 ​

정의 1.1 (가능도와 최대가능도 추정량) 관측값 x=(x1,…,xn)\x=(x_1,\dots,x_n)이 주어질 때 θ\theta의 함수

L(θ)=L(θ;x)=∏i=1nf(xi;θ),ℓ(θ)=log⁡L(θ)=∑i=1nlog⁡f(xi;θ)L(\theta)=L(\theta;\x)=\prod_{i=1}^nf(x_i;\theta),\qquad\ell(\theta)=\log L(\theta)=\sum_{i=1}^n\log f(x_i;\theta)

를 가능도와 로그가능도라 한다. LL을 Ω\Omega 위에서 최대로 하는 θ^=θ^(x)\hat\theta=\hat\theta(\x)를 최대가능도 추정량(MLE)이라 한다.

이산이면 L(θ)L(\theta)는 “θ\theta일 때 지금의 자료가 나올 확률”이다. 연속이면 밀도이므로 확률이 아니지만, 관측을 작은 구간으로 읽으면 확률에 비례한다. 로그는 단조이므로 LL과 ℓ\ell의 최대점은 같고, 곱이 합이 되어 미분이 쉽다. 내부의 최대점은 가능도 방정식 ℓ′(θ)=0\ell'(\theta)=0을 푼다.

예제 1.2 (다섯 가지 MLE) 

  1. (a)

    Bernoulli. ℓ(p)=klog⁡p+(n−k)log⁡(1−p)\ell(p)=k\log p+(n-k)\log(1-p), ℓ′(p)=kp−n−k1−p=0\ell'(p)=\tfrac kp-\tfrac{n-k}{1-p}=0에서 p^=k/n\hat p=k/n.

  2. (b)

    Poisson. ℓ(λ)=∑xilog⁡λ−nλ−∑log⁡xi!\ell(\lambda)=\sum x_i\log\lambda-n\lambda-\sum\log x_i!에서 λ^=xˉ\hat\lambda=\bar x. 프로이센 기병대 280군단–해(4회)에서 λ^=196/280=0.70\hat\lambda=196/280=0.70.

  3. (c)

    정규. ℓ(μ,σ2)=−n2log⁡(2πσ2)−12σ2∑(xi−μ)2\ell(\mu,\allowbreak \sigma^2)=-\tfrac n2\log(2\pi\sigma^2)-\tfrac1{2\sigma^2}\sum(x_i-\mu)^2. μ\mu에 대해 미분하면 μ^=xˉ\hat\mu=\bar x, 이것을 넣고 σ2\sigma^2에 대해 미분하면 σ^2=1n∑(xi−xˉ)2\hat\sigma^2=\tfrac1n\sum(x_i-\bar x)^2. MLE는 nn으로 나눈다. 불편이 아니다(6회 정리 1.1).

  4. (d)

    균등 U(0,θ)\mathrm U(0,\theta). L(θ)=θ−n1{θ≥x(n)}L(\theta)=\theta^{-n}1\{\theta\ge x_{(n)}\}은 θ≥x(n)\theta\ge x_{(n)}에서 감소하므로 θ^=x(n)\hat\theta=x_{(n)}. 최대점이 경계에 있어 가능도 방정식이 아니다. 8회의 독일 전차 문제와 같은 구조다.

  5. (e)

    Laplace 위치. ℓ(θ)=−∑∣xi−θ∣+상수\ell(\theta)=-\sum|x_i-\theta|+\text{상수}를 최대로 하는 것은 표본중앙값이다(5회 연습 1.4).

정리 1.3 (불변성) θ^\hat\theta가 θ\theta의 MLE이면, 어떤 함수 gg에 대해서도 g(θ^)g(\hat\theta)는 η=g(θ)\eta=g(\theta)의 MLE이다. 여기서 η\eta의 가능도는 L∗(η)=sup⁡θ:g(θ)=ηL(θ)L^*(\eta)=\sup_{\theta:g(\theta)=\eta}L(\theta)로 정한다.

증명 전략 η^=g(θ^)\hat\eta=g(\hat\theta)에서 L∗L^*의 값을 아래와 위에서 누른다. θ^\hat\theta는 g(θ)=η^g(\theta)=\hat\eta인 θ\theta 가운데 하나이고, L∗L^*는 어느 η\eta에서도 LL의 전체 최댓값을 넘지 않는다. 단계별 증명은 연습 1.6(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

정규 표준편차의 MLE는 σ^=σ^2\hat\sigma=\sqrt{\hat\sigma^2}이고, Poisson에서 “한 해에 아무도 죽지 않을 확률” e−λe^{-\lambda}의 MLE는 e−xˉ=0.497e^{-\bar x}=0.497이다. 불편성은 이런 변환에서 보존되지 않지만(Jensen) 최대가능도는 보존된다.

1.2 왜 참값으로 가는가 — Gibbs 부등식 ​

로그가능도의 평균 1nℓ(θ)\tfrac1n\ell(\theta)는 대수의 법칙으로 Eθ0log⁡f(X;θ)E_{\theta_0}\log f(X;\theta)로 간다. 그 극한이 참값 θ0\theta_0에서 최대라는 것이 일치성의 열쇠다.

보조정리 1.4 (기대 로그가능도는 참값에서 최대) θ≠θ0\theta\ne\theta_0이면 f(⋅;θ)≠f(⋅;θ0)f(\cdot;\theta)\ne f(\cdot;\theta_0)라 하자(식별가능성). 기댓값이 존재하면

Eθ0log⁡f(X;θ)<Eθ0log⁡f(X;θ0)(θ≠θ0).E_{\theta_0}\log f(X;\theta)<E_{\theta_0}\log f(X;\theta_0)\qquad(\theta\ne\theta_0).

증명 전략 두 밀도의 비의 로그에 Jensen 부등식을 써서 기댓값과 로그의 순서를 바꾸고, 밀도의 적분이 1을 넘지 않음을 쓴다. 등호의 경우를 따로 보아 식별가능성으로 엄격한 부등식을 얻는다.

  1. A={x:f(x;θ0)>0}A=\{x:f(x;\theta_0)>0\}으로 두고 Y=f(X;θ)/f(X;θ0)Y=f(X;\theta)/f(X;\theta_0)라 하자. Pθ0(X∈A)=1P_{\theta_0}(X\in A)=1이므로 YY는 확률 1로 정의되고 Y≥0Y\ge0이다.받침의 정의

  2. log⁡\log는 오목하므로

    Eθ0log⁡Y≤log⁡Eθ0Y.E_{\theta_0}\log Y\le\log E_{\theta_0}Y .
  3. 오른쪽의 기댓값은

    Eθ0Y=∫Af(x;θ)f(x;θ0) f(x;θ0) dx=∫Af(x;θ) dx≤1.E_{\theta_0}Y=\int_A\frac{f(x;\theta)}{f(x;\theta_0)}\,f(x;\theta_0)\,dx=\int_Af(x;\theta)\,dx\le1 .
    기댓값의 정의
  4. 2 3과 log⁡\log의 단조성으로 Eθ0log⁡Y≤log⁡1=0E_{\theta_0}\log Y\le\log1=0, 곧 Eθ0log⁡f(X;θ)≤Eθ0log⁡f(X;θ0)E_{\theta_0}\log f(X;\theta)\le E_{\theta_0}\log f(X;\theta_0)이다.기댓값의 선형성

  5. 등호이면 2와 3이 모두 등호다. log⁡\log가 순오목이므로 2의 등호는 YY가 확률 1로 상수 cc일 때뿐이고, 3의 등호와 log⁡c=0\log c=0에서 c=1c=1이다. 그러면 AA 위에서 f(x;θ)=f(x;θ0)f(x;\theta)=f(x;\theta_0)이고 ∫Af(x;θ)dx=1\int_Af(x;\theta)dx=1이므로 AA 밖에서는 f(x;θ)=0f(x;\theta)=0이다.Jensen의 등호 조건

  6. 5는 두 밀도가 같다는 뜻이므로 식별가능성에 어긋난다. 따라서 θ≠θ0\theta\ne\theta_0이면 부등식은 엄격하다.식별가능성 [T2]

조건 확인 4에서 Elog⁡Y=Elog⁡f(X;θ)−Elog⁡f(X;θ0)E\log Y=E\log f(X;\theta)-E\log f(X;\theta_0)로 쓰는 데 두 기댓값의 존재를 쓴다. Jensen 부등식 2는 EY≤1EY\le1로 유한하므로 Elog⁡Y=−∞E\log Y=-\infty인 경우에도 성립한다. “두 밀도가 같다”는 확률 0인 집합을 빼고 같다는 뜻이다. 이산이면 적분이 합으로 바뀌고, 2회 정리 8.3(Gibbs 부등식) 그대로다.

두 기댓값의 차 D(θ0∥θ)=Eθ0log⁡f(X;θ0)f(X;θ)≥0D(\theta_0\|\theta)=E_{\theta_0}\log\tfrac{f(X;\theta_0)}{f(X;\theta)}\ge0이 Kullback–Leibler 발산이다(5회 명제 6.2). MLE는 “자료의 분포에서 KL 발산으로 가장 가까운 모형”을 고르는 것이다(8절).

정리 1.5 (참값의 가능도가 이긴다) 식별가능하고 위 기댓값들이 유한하면, 고정된 θ≠θ0\theta\ne\theta_0에 대해 lim⁡n→∞Pθ0(L(θ0;X)>L(θ;X))=1\lim_{n\to\infty}P_{\theta_0}\bigl(L(\theta_0;\X)>L(\theta;\X)\bigr)=1.

증명 전략 로그가능도의 차를 nn으로 나누면 iid 확률변수의 평균이다. 대수의 법칙(7회 정리 1.6)으로 그 평균은 보조정리 1.4의 음수 −D(θ0∥θ)-D(\theta_0\|\theta)로 확률수렴하고, 음수로 가는 평균이 0 이상일 확률은 0으로 간다. 단계별 증명은 연습 1.7(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

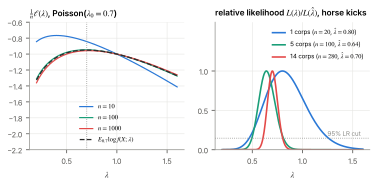
그림 1.1의 왼쪽이 이 수렴이다. 표본이 커질수록 평균 로그가능도가 기대 로그가능도에 붙고, 그 꼭대기가 참값 0.7로 모인다. 오른쪽은 기병대 자료를 군단 1개, 5개, 14개로 늘려 가며 그린 상대가능도 L(λ)/L(λ^)L(\lambda)/L(\hat\lambda)다. 관측이 쌓일수록 가능도가 λ^\hat\lambda 둘레로 좁아진다. 그 폭이 1/nI1/\sqrt{nI}에 비례한다는 것이 3절의 내용이다.

그림 1.1. 왼쪽: Poisson(λ_0=0.7) 표본의 평균 로그가능도(λ에 의존하지 않는 항은 뺐다)와 그 극한 E_0.7logf(X;λ)(점선). 극한은 참값에서 최대다(보조정리 1.4). 오른쪽: 기병대 자료의 상대가능도. 점선 아래로 떨어지는 λ는 95% 가능도비 구간(5절) 밖이다.
그림 1.1 왼쪽: Poisson(λ0=0.7\lambda_0=0.7) 표본의 평균 로그가능도(λ\lambda에 의존하지 않는 항은 뺐다)와 그 극한 E0.7log⁡f(X;λ)E_{0.7}\log f(X;\lambda)(점선). 극한은 참값에서 최대다(보조정리 1.4). 오른쪽: 기병대 자료의 상대가능도. 점선 아래로 떨어지는 λ\lambda는 95% 가능도비 구간(5절) 밖이다.

정리 1.6 (가능도 방정식의 일치하는 근) θ\theta가 실수이고 정리 1.5의 조건에 더해 θ0\theta_0가 모수공간의 내점이며 ℓ(θ)\ell(\theta)가 θ\theta에 대해 미분가능하면, 확률이 1로 가는 사건 위에서 가능도 방정식의 근 θ^n\hat\theta_n이 있어 θ^n→Pθ0\hat\theta_n\xrightarrow{P}\theta_0이다.

증명 전략 θ0\theta_0의 양옆 두 점보다 θ0\theta_0의 가능도가 높은 사건 위에서는 그 사이에 극대점이 있고, 그곳에서 미분이 0이다. 그 사건의 확률이 1로 감을 정리 1.5로 보인다.

  1. a>0a>0을 [θ0−a,θ0+a][\theta_0-a,\theta_0+a]가 모수공간 안에 들도록 작게 잡는다.θ0\theta_0는 내점

  2. Sn={ℓ(θ0)>ℓ(θ0−a)}∩{ℓ(θ0)>ℓ(θ0+a)}S_n=\{\ell(\theta_0)>\ell(\theta_0-a)\}\cap\{\ell(\theta_0)>\ell(\theta_0+a)\}로 두면 P(Snc)P(S_n^c)는 두 사건의 여사건의 확률의 합 이하이고, 그 둘이 0으로 가므로 P(Sn)→1P(S_n)\to1이다.정리 1.5를 두 점에, Boole 부등식

  3. SnS_n 위에서 연속함수 ℓ\ell은 닫힌 구간 [θ0−a,θ0+a][\theta_0-a,\theta_0+a]에서 최댓값을 갖는다. 끝점의 값이 ℓ(θ0)\ell(\theta_0)보다 작으므로 최대점 tt는 열린 구간 안에 있다.미분가능하면 연속, 최대·최소 정리

  4. 안쪽의 최대점에서 미분가능한 함수의 미분은 0이므로 ℓ′(t)=0\ell'(t)=0이다.Fermat의 정리

  5. 가능도 방정식의 근 가운데 θ0\theta_0에 가장 가까운 것을 θ^n\hat\theta_n이라 하자(근이 없으면 아무 값). SnS_n 위에서는 4의 근 tt가 있으므로 ∣θ^n−θ0∣≤∣t−θ0∣<a|\hat\theta_n-\theta_0|\le|t-\theta_0|<a이다.3 4

  6. P(∣θ^n−θ0∣<a)≥P(Sn)→1P(|\hat\theta_n-\theta_0|<a)\ge P(S_n)\to1이다. 5의 θ^n\hat\theta_n은 aa에 의존하지 않으므로 이것이 충분히 작은 모든 a>0a>0에서 성립하고, θ^n→Pθ0\hat\theta_n\xrightarrow{P}\theta_0이다.확률수렴의 정의

조건 확인 가장 가까운 근이 있으려면 근의 집합이 닫혀 있어야 한다. ℓ′\ell'가 연속이면(2.1절의 정칙조건 (R3)이 그렇다) 근의 집합은 닫힌 집합이다. 5의 θ^n\hat\theta_n은 모르는 θ0\theta_0를 쓰므로 통계량이 아니다. 정리는 “일치하는 근이 있다”는 존재의 주장이다.

정리는 “가능도 방정식의 어떤 근”이 일치한다고 말한다. 근이 하나뿐이면 그것이 MLE이고 일치한다. 근이 여럿이면(4절의 Cauchy) 가장 큰 극대점이 MLE이며, 일반적인 일치성은 Wald(1949)의 더 강한 조건이 필요하다.

연습문제

연습 1.1 (지수분포 ★) Exp\mathrm{Exp} (평균 θ\theta)의 MLE가 Xˉ\bar X임을 보이고, 비율 λ=1/θ\lambda=1/\theta의 MLE 1/Xˉ1/\bar X가 불편이 아님을 보여라(E(1/Xˉ)=nn−1λE(1/\bar X)=\tfrac{n}{n-1}\lambda).

풀이

ℓ(θ)=−nlog⁡θ−1θ∑xi\ell(\theta)=-n\log\theta-\tfrac1\theta\sum x_i, ℓ′(θ)=−nθ+∑xiθ2=0\ell'(\theta)=-\tfrac n\theta+\tfrac{\sum x_i}{\theta^2}=0에서 θ^=xˉ\hat\theta=\bar x. 불변성으로 λ^=1/Xˉ\hat\lambda=1/\bar X. ∑Xi∼Γ(n,1/λ)\sum X_i\sim\Gamma(n,\allowbreak 1/\lambda)이므로 E1∑Xi=λn−1E\tfrac1{\sum X_i}=\tfrac{\lambda}{n-1}(4회 연습 3.4)이고 E1Xˉ=nλn−1E\tfrac1{\bar X}=\tfrac{n\lambda}{n-1}.

연습 1.2 (두 모수 지수 ★★) 밀도 1βe−(x−μ)/β\tfrac1\beta e^{-(x-\mu)/\beta} (x≥μx\ge\mu)의 (μ,β)(\mu,\beta)의 MLE가 (X(1), Xˉ−X(1))(X_{(1)},\ \bar X-X_{(1)})임을 보여라.

풀이

L(μ,β)=β−nexp⁡(−1β∑(xi−μ))1{μ≤x(1)}L(\mu,\allowbreak \beta)=\beta^{-n}\exp\bigl(-\tfrac1\beta\sum(x_i-\mu)\bigr)1\{\mu\le x_{(1)}\}. β\beta를 고정하면 LL은 μ\mu에 대해 증가하므로 μ^=x(1)\hat\mu=x_{(1)}. 이것을 넣고 β\beta로 미분하면 β^=1n∑(xi−x(1))=xˉ−x(1)\hat\beta=\tfrac1n\sum(x_i-x_{(1)})=\bar x-x_{(1)}.

연습 1.3 (다항분포 ★★) 다항분포의 pjp_j의 MLE가 Nj/nN_j/n임을 Lagrange 승수로 보여라. 이것으로 8회 따름정리 5.2에서 독립 모형의 MLE가 p^i⋅p^⋅j\hat p_{i\cdot}\hat p_{\cdot j}임을 설명하라.

풀이

ℓ=∑jNjlog⁡pj\ell=\sum_jN_j\log p_j를 ∑pj=1\sum p_j=1 아래에서 최대화한다. ∂∂pj[ℓ−λ(∑pj−1)]=Njpj−λ=0\tfrac{\partial}{\partial p_j}[\ell-\lambda(\sum p_j-1)]=\tfrac{N_j}{p_j}-\lambda=0에서 pj=Nj/λp_j=N_j/\lambda이고 합이 1이므로 λ=n\lambda=n. 독립 모형 pij=pi⋅p⋅jp_{ij}=p_{i\cdot}p_{\cdot j}이면 ℓ=∑iNi⋅log⁡pi⋅+∑jN⋅jlog⁡p⋅j\ell=\sum_iN_{i\cdot}\log p_{i\cdot}+\sum_jN_{\cdot j}\log p_{\cdot j}로 행과 열이 따로 떨어지므로 각각 다항의 MLE Ni⋅/nN_{i\cdot}/n, N⋅j/nN_{\cdot j}/n이다.

연습 1.4 (기병대의 확률 ★) 기병대 자료에서 한 군단–해에 죽은 병사가 없을 확률의 MLE를 구하고 관측 비율 144/280144/280과 비교하라.

풀이

P(X=0)=e−λP(X=0)=e^{-\lambda}의 MLE는 불변성으로 e−0.70=0.497e^{-0.70}=0.497. 관측 비율은 144/280=0.514144/280=0.514로 기대도수 139와 관측 144의 차이다.

연습 1.5 (균등분포의 KL ★★) U(0,θ0)\mathrm U(0,\theta_0)와 U(0,θ)\mathrm U(0,\theta)의 D(θ0∥θ)D(\theta_0\|\theta)를 구하라. θ<θ0\theta<\theta_0이면 무한대인 이유를 설명하고, 이것이 MLE가 x(n)x_{(n)}보다 작아질 수 없는 이유와 같음을 보여라.

풀이

θ≥θ0\theta\ge\theta_0이면 D(θ0∥θ)=∫0θ01θ0log⁡1/θ01/θdx=log⁡θθ0D(\theta_0\|\theta)=\int_0^{\theta_0}\tfrac1{\theta_0}\log\tfrac{1/\theta_0}{1/\theta}dx=\log\tfrac\theta{\theta_0}. θ<θ0\theta<\theta_0이면 (θ,θ0)(\theta,\theta_0)에서 f(x;θ)=0f(x;\theta)=0이지만 f(x;θ0)>0f(x;\theta_0)>0이므로 log⁡f(x;θ0)f(x;θ)=∞\log\tfrac{f(x;\theta_0)}{f(x;\theta)}=\infty인 곳에 양의 확률이 있어 D=∞D=\infty. 자료에서도 같다. θ<x(n)\theta<x_{(n)}이면 관측 x(n)x_{(n)}의 밀도가 0이어서 L(θ)=0L(\theta)=0이다.

연습 1.6 (불변성의 증명 ★ 유도형) 정리 1.3를 다음 순서로 증명하라. η^=g(θ^)\hat\eta=g(\hat\theta)이다.

  1. (a)

    L∗(η^)≥L(θ^)L^*(\hat\eta)\ge L(\hat\theta)임을 보여라. 상한 sup⁡\sup의 정의 가운데 어느 부분을 쓰는가?

  2. (b)

    모든 η\eta에서 L∗(η)≤L(θ^)L^*(\eta)\le L(\hat\theta)임을 보여라.

  3. (c)

    (a)와 (b)로 L∗(η^)=sup⁡ηL∗(η)L^*(\hat\eta)=\sup_\eta L^*(\eta)를 결론지어라.

  4. (d)

    gg가 일대일이면 L∗(η)=L(g−1(η))L^*(\eta)=L(g^{-1}(\eta))임을 확인하라. g(θ)=θ2g(\theta)=\theta^2, θ∈R\theta\in\R처럼 일대일이 아니면 왜 L∗L^*를 상한으로 정의해야 하는지 설명하라.

풀이

(a) g(θ^)=η^g(\hat\theta)=\hat\eta이므로 θ^\hat\theta는 {θ:g(θ)=η^}\{\theta:g(\theta)=\hat\eta\}의 원소다. 상한은 그 집합의 모든 원소에서의 값 이상이므로 L∗(η^)=sup⁡g(θ)=η^L(θ)≥L(θ^)L^*(\hat\eta)=\sup_{g(\theta)=\hat\eta}L(\theta)\ge L(\hat\theta)이다. 상한이 “상계”라는 성질만 썼다. (b) {θ:g(θ)=η}\{\theta:g(\theta)=\eta\}는 모수공간의 부분집합이므로 그 위의 상한은 전체 위의 상한 sup⁡θL(θ)=L(θ^)\sup_\theta L(\theta)=L(\hat\theta)를 넘지 않는다. (c) (b)를 η=η^\eta=\hat\eta에 쓰고 (a)와 합치면 L∗(η^)=L(θ^)L^*(\hat\eta)=L(\hat\theta)이고, (b)로 이것은 모든 L∗(η)L^*(\eta) 이상이다. 따라서 η^\hat\eta는 L∗L^*의 최대점이다. (d) gg가 일대일이면 {θ:g(θ)=η}={g−1(η)}\{\theta:g(\theta)=\eta\}=\{g^{-1}(\eta)\}이므로 상한은 그 한 점의 값이다. g(θ)=θ2g(\theta)=\theta^2이면 η>0\eta>0에 θ=±η\theta=\pm\sqrt\eta 두 값이 대응하므로 “η\eta의 가능도”를 하나로 정하려면 둘 중 큰 값을 골라야 한다. 상한이 그 선택이다.

연습 1.7 (참값의 가능도가 이긴다: 증명 ★★ 유도형) Yi=log⁡f(Xi;θ)f(Xi;θ0)Y_i=\log\tfrac{f(X_i;\theta)}{f(X_i;\theta_0)}로 두고 정리 1.5를 다음 순서로 증명하라.

  1. (a)

    {L(θ0;X)>L(θ;X)}={Yˉn<0}\{L(\theta_0;\X)>L(\theta;\X)\}=\{\bar Y_n<0\}임을 보여라.

  2. (b)

    YiY_i들이 iid이고 EYi=−D(θ0∥θ)<0EY_i=-D(\theta_0\|\theta)<0임을 보조정리 1.4로 보이고, Khinchin의 대수의 법칙(7회 정리 1.6)으로 Yˉn→P−D\bar Y_n\xrightarrow{P}-D를 얻어라.

  3. (c)

    D>0D>0이면 P(Yˉn≥0)≤P(∣Yˉn+D∣≥D)P(\bar Y_n\ge0)\le P(|\bar Y_n+D|\ge D)임을 보이고 결론을 내려라.

  4. (d)

    Var⁡Yi=σ2<∞\Var Y_i=\sigma^2<\infty이면 P(Yˉn≥0)≤σ2nD2P(\bar Y_n\ge0)\le\tfrac{\sigma^2}{nD^2}임을 Chebyshev 부등식(2회 정리 5.3)으로 보여라. 확률이 1로 가는 속도에 대해 무엇을 말하는가?

풀이

(a) log⁡\log는 증가하므로 L(θ0)>L(θ)  ⟺  ℓ(θ)−ℓ(θ0)<0  ⟺  1n∑iYi<0L(\theta_0)>L(\theta)\iff\ell(\theta)-\ell(\theta_0)<0\iff\tfrac1n\sum_iY_i<0이다. (b) YiY_i는 iid인 XiX_i의 같은 함수이므로 iid이다. EYi=Eθ0log⁡f(X;θ)−Eθ0log⁡f(X;θ0)=−D(θ0∥θ)EY_i=E_{\theta_0}\log f(X;\theta)-E_{\theta_0}\log f(X;\theta_0)=-D(\theta_0\|\theta)이고, 보조정리 1.4로 D>0D>0이다. Khinchin의 대수의 법칙은 평균의 존재만 요구하므로 Yˉn→P−D\bar Y_n\xrightarrow{P}-D이다. (c) Yˉn≥0\bar Y_n\ge0이면 Yˉn+D≥D\bar Y_n+D\ge D이므로 {Yˉn≥0}⊂{∣Yˉn+D∣≥D}\{\bar Y_n\ge0\}\subset\{|\bar Y_n+D|\ge D\}이다. 오른쪽의 확률은 확률수렴의 정의로 0으로 가므로 P(L(θ0)>L(θ))=1−P(Yˉn≥0)→1P(L(\theta_0)>L(\theta))=1-P(\bar Y_n\ge0)\to1이다. (d) Chebyshev 부등식으로 P(∣Yˉn+D∣≥D)≤Var⁡YˉnD2=σ2nD2P(|\bar Y_n+D|\ge D)\le\tfrac{\Var\bar Y_n}{D^2}=\tfrac{\sigma^2}{nD^2}이다. 틀린 값이 이길 확률은 적어도 1/n1/n의 속도로 줄고, 그 상수는 KL 발산의 제곱에 반비례한다. 참값과 가까운 θ\theta일수록 DD가 작아 더 많은 자료가 필요하다.

이 회차에서 읽은 절 0개 · 회차 차례