
테마
노트북 · 9회 · 최대가능도
최대가능도 가장 그럴듯한 값의 이론
| 강의노트 | 09_mle_notes.pdf — 같은 절 번호, 같은 정리 번호. 증명은 노트에, 확인은 여기에 |
| 워크북 | 09_mle_workbook.pdf — 손으로 푸는 34문항. 다 푼 뒤 맨 끝 10절의 check()로 검산 |
| 원자료 | von Bortkiewicz의 프로이센 기병대 (vcd VonBort) · Michelson(1879)의 빛의 속도 (HistData Michelson) · The Federalist의 may (vcd Federalist) |
| 선수 지식 | 1–8회 (2회 Gibbs 부등식, 3회 Cauchy–Schwarz, 7회 중심극한정리·Slutsky·델타 방법, 8회 검정과 구간) |
여는 질문. 같은 별의 위치를 다섯 번 쟀는데 값이 서로 어긋난다. 그 가운데 "가장 그럴듯한" 참값은 무엇인가? 평균인가, 중앙값인가, 아니면 관측의 오차가 어떤 모양인지에 따라 달라지는가?
이번 회차의 지도
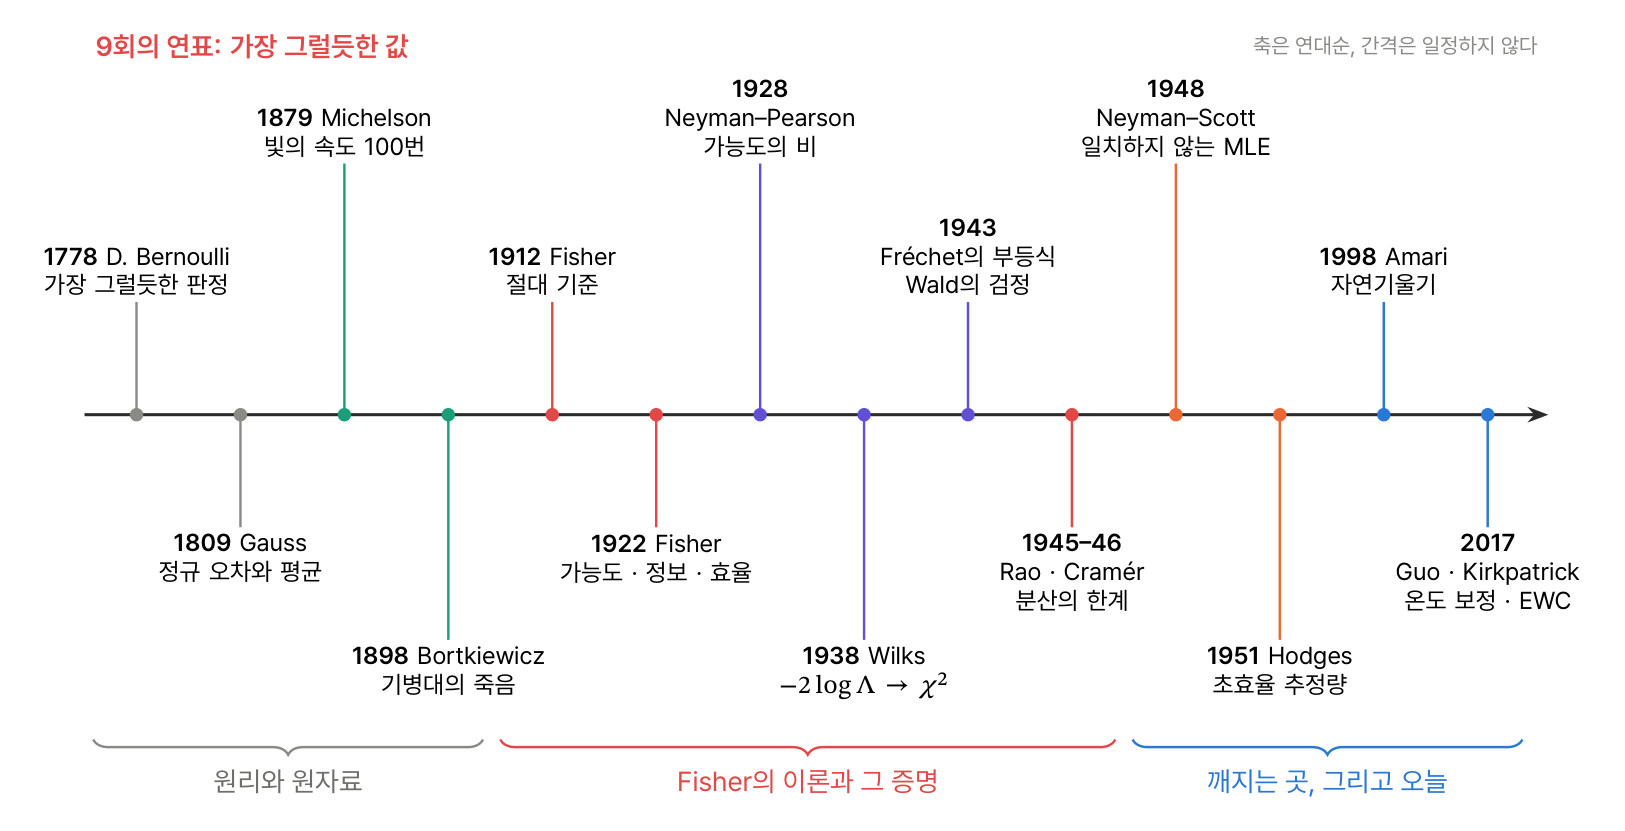
학습 목표
- 여러 모형에서 가능도를 수치로 최대화해 닫힌 꼴의 MLE와 맞춰 보고, 불변성과 일치성(Gibbs 부등식)을 확인한다.
- 점수의 평균이 0이고 정보의 두 표현이 같음을 수치적분으로 확인하고, Cramér–Rao 한계와 추정량들의 분산을 비교한다.
- MLE의 표본분포를 시뮬레이션해 정규 극한 와 맞춰 본다.
- Newton–Raphson과 Fisher 채점을 구현하고, 봉우리가 여럿인 Cauchy 가능도에서 둘의 차이를 본다.
- 가능도비·Wald·점수 검정을 구현하고, Wilks 정리를 정확한 계산과 시뮬레이션으로 확인한다.
- 세 원자료(기병대, Michelson, may)에 쓰고, Hodges의 초효율과 Neyman–Scott 문제를 재현한다.
- 교차엔트로피 = 음의 로그가능도, KL과 Fisher 정보, 온도 보정을 코드로 확인한다.
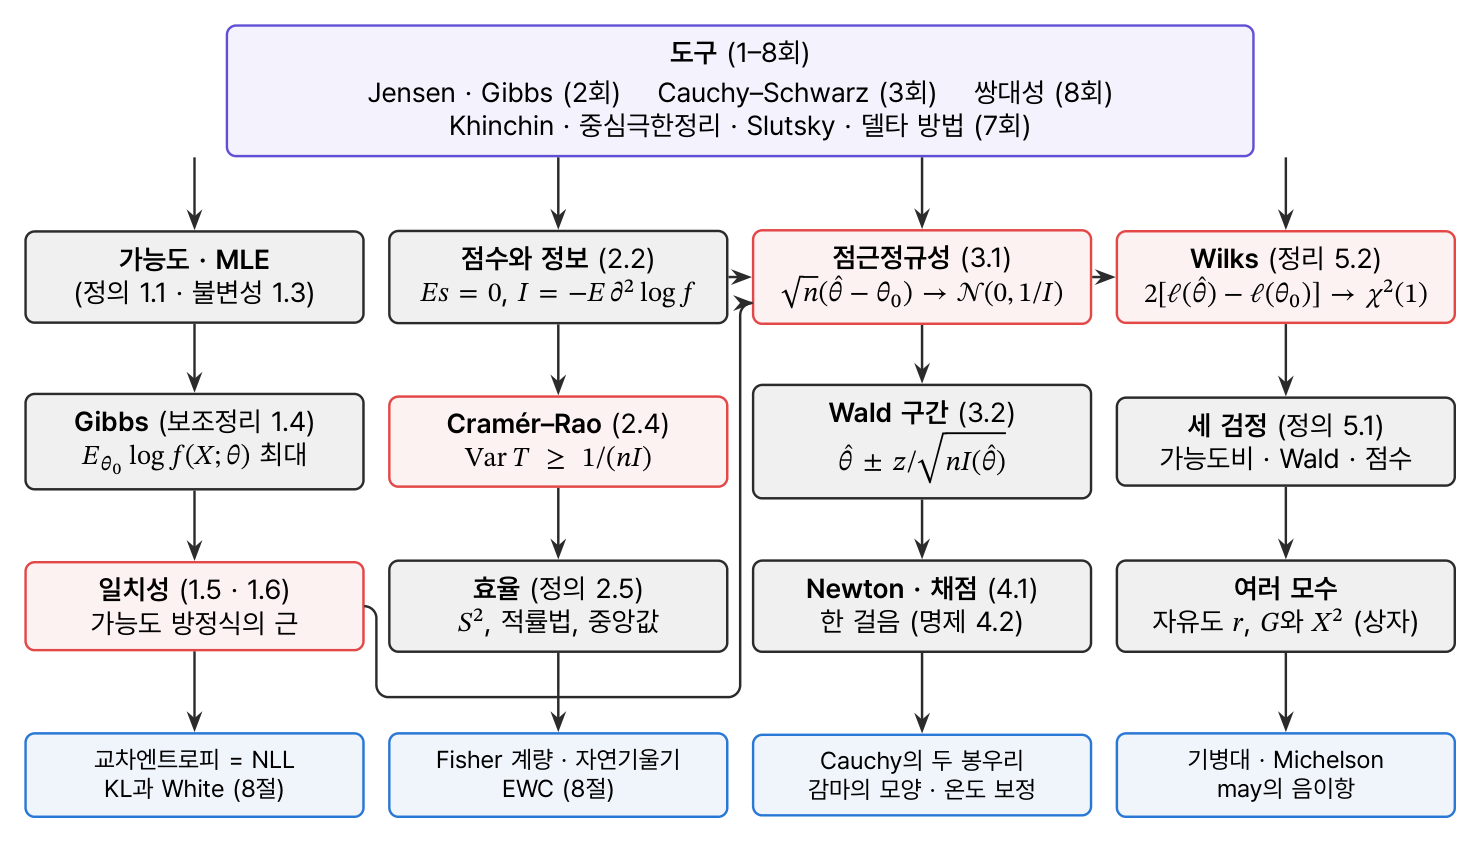
정리 지도
0. 설정
python
%matplotlib inline
import math
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import integrate, optimize, special, stats

SEED = 1778
N_SIM = 200_000
rng = np.random.default_rng(SEED)

C = dict(data="#1a9e78", stat="#2a78d6", key="#e34948", assume="#eb6834",
         theta="#6250d6", ink="#2b2b2b", hist="#8a8a86", grid="#e6e6e3")
SERIES = [C["stat"], C["data"], C["key"], C["theta"]]
THEORY = dict(color=C["ink"], ls="--", lw=1.6)
plt.rcParams.update({
    "figure.dpi": 110, "figure.figsize": (8, 4.2), "mathtext.fontset": "stix",
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.grid": True, "grid.color": C["grid"], "grid.linewidth": 0.8,
    "axes.edgecolor": "#9a9a96", "axes.labelcolor": C["ink"],
    "xtick.color": "#52514e", "ytick.color": "#52514e",
    "axes.titleweight": "bold", "axes.titlesize": 11, "axes.titlelocation": "left",
    "legend.frameon": False, "lines.linewidth": 2,
})

RDATASETS = "https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/master/csv/{}/{}.csv"
DATA_DIR = Path("../../data") if Path("../../.git").exists() else Path("data")

def load_rdata(item, package="HistData"):
    path = DATA_DIR / (f"{item}.csv" if package == "HistData" else f"{package}_{item}.csv")
    if not path.exists():
        DATA_DIR.mkdir(parents=True, exist_ok=True)
        pd.read_csv(RDATASETS.format(package, item)).drop(columns="rownames").to_csv(path, index=False)
    return pd.read_csv(path)

def report(checks):
    for name, ok in checks.items():
        print(f"  {'✓' if ok else '✗'}  {name}")
    assert all(checks.values()), "대조 실패"

def within(est, truth, se, k=4):
    return abs(est - truth) <= k * se

vb = load_rdata("VonBort", "vcd")          # 14개 군단 × 20년 (1875–1894)
T_ALL, N_ALL = int(vb.deaths.sum()), len(vb)
print(f"기병대: {N_ALL} 군단–해, 죽은 병사 {T_ALL}명, λ̂ = {T_ALL / N_ALL:.2f}")
text
기병대: 280 군단–해, 죽은 병사 196명, λ̂ = 0.701. 가능도와 최대가능도 추정량
정의 1.1 , , MLE는 의 최대점 · 예제 1.2 다섯 가지 MLE · 정리 1.3 불변성: 는 의 MLE · 보조정리 1.4 는 에서 최대 · 정리 1.5 · 정리 1.6 가능도 방정식의 일치하는 근.
먼저 "가능도를 수치로 최대화하는 함수" 하나를 만들고, 그것이 예제 1.2의 닫힌 꼴과 같은 답을 내는지 본다.
python
def mle_1d(loglik, bounds):
    """정의 1.1: 1차원 로그가능도를 구간 위에서 수치로 최대화 (경계 최대점은 따로 다룬다)"""
    res = optimize.minimize_scalar(lambda t: -loglik(t), bounds=bounds, method="bounded",
                                   options=dict(xatol=1e-10))
    return res.x

x_norm = rng.normal(5, 2, 40)
x_bern = rng.random(60) < 0.3
x_lap = rng.laplace(1.5, 1, 41)
horse = vb.deaths.to_numpy()

cases = {
    "(a) Bernoulli p̂ = k/n": (mle_1d(lambda p: x_bern.sum() * np.log(p) + (~x_bern).sum() * np.log(1 - p), (1e-6, 1 - 1e-6)), x_bern.mean()),
    "(b) Poisson λ̂ = x̄ (기병대)": (mle_1d(lambda l: horse.sum() * np.log(l) - len(horse) * l, (0.01, 5)), horse.mean()),
    "(c) 정규 σ̂² = (1/n)Σ(x−x̄)² (μ = x̄ 대입)": (mle_1d(lambda s2: -len(x_norm) / 2 * np.log(s2) - np.sum((x_norm - x_norm.mean()) ** 2) / (2 * s2), (0.01, 50)), x_norm.var()),
    "(e) Laplace 위치 = 표본중앙값": (mle_1d(lambda t: -np.sum(np.abs(x_lap - t)), (-5, 5)), np.median(x_lap)),
}
for name, (num, closed) in cases.items():
    print(f"{name:42s} 수치 {num:.6f}   닫힌 꼴 {closed:.6f}")
# (d) 균등: L(θ) = θ^{-n} 1{θ ≥ x_(n)} — 최대점은 경계, 미분이 0인 점이 아니다
x_unif = rng.uniform(0, 3, 15)
grid = np.linspace(0.5, 6, 100_001)
Lu = np.where(grid >= x_unif.max(), grid ** -15.0, 0.0)
report({"예제 1.2 (a)(b)(c)(e): 수치 최대화 = 닫힌 꼴 (1e-5 안)": all(abs(a - b) < 1e-5 for a, b in cases.values()),
        "예제 1.2 (b): 기병대 λ̂ = 196/280 = 0.70": T_ALL == 196 and N_ALL == 280,
        "예제 1.2 (d): 균등의 MLE 는 x_(n) (격자 최대점)": abs(grid[Lu.argmax()] - x_unif.max()) < 1e-4})
text
(a) Bernoulli p̂ = k/n                     수치 0.366667   닫힌 꼴 0.366667
(b) Poisson λ̂ = x̄ (기병대)                  수치 0.700000   닫힌 꼴 0.700000
(c) 정규 σ̂² = (1/n)Σ(x−x̄)² (μ = x̄ 대입)     수치 4.131656   닫힌 꼴 4.131656
(e) Laplace 위치 = 표본중앙값                     수치 1.597899   닫힌 꼴 1.597899
  ✓  예제 1.2 (a)(b)(c)(e): 수치 최대화 = 닫힌 꼴 (1e-5 안)
  ✓  예제 1.2 (b): 기병대 λ̂ = 196/280 = 0.70
  ✓  예제 1.2 (d): 균등의 MLE 는 x_(n) (격자 최대점)
python
# 정리 1.3 · 연습 1.4: 불변성 — P(X=0) = e^{−λ} 의 MLE
lam_hat = T_ALL / N_ALL
p0_mle = math.exp(-lam_hat)
p0_obs = np.mean(horse == 0)
# 불변성을 직접: η = e^{−λ} 로 모수를 바꾼 가능도를 수치로 최대화
eta_hat = mle_1d(lambda e: T_ALL * np.log(-np.log(e)) - N_ALL * (-np.log(e)), (0.01, 0.99))
print(f"e^(−λ̂) = {p0_mle:.3f},  η 로 바꿔 최대화 = {eta_hat:.3f},  관측 비율 {np.sum(horse == 0)}/280 = {p0_obs:.3f},  기대도수 {280 * p0_mle:.1f}")

# 연습 1.1: E(1/X̄) = nλ/(n−1) — 지수분포 비율의 MLE 는 위로 치우친다
n = 8
lh = 1 / rng.exponential(1 / 2.0, (N_SIM, n)).mean(1)
# 연습 1.2: 두 모수 지수 — 프로파일 가능도로 확인
xs = 3 + rng.exponential(2, 25)
def nll_shift(par):
    mu, beta = par
    return np.inf if (mu > xs.min() or beta <= 0) else len(xs) * np.log(beta) + np.sum(xs - mu) / beta
num = optimize.minimize(nll_shift, [xs.min() - 0.5, 1.0], method="Nelder-Mead", options=dict(xatol=1e-9, fatol=1e-12, maxiter=4000)).x
# 연습 1.3: 다항의 MLE N_j/n — 다른 어떤 확률벡터도 가능도가 더 작다
N = np.array([12, 30, 7, 51])
ll_mult = lambda p: np.sum(N * np.log(p))
alts = rng.dirichlet(np.ones(4), 20_000)
report({"정리 1.3: η = e^{−λ} 로 직접 최대화해도 e^{−λ̂} = 0.497": abs(eta_hat - p0_mle) < 1e-5 and abs(p0_mle - 0.497) < 5e-4,
        "연습 1.4: 관측 비율 144/280 = 0.514": np.sum(horse == 0) == 144,
        "연습 1.1: E(1/X̄) = nλ/(n−1) (n=8, λ=2)": within(lh.mean(), n * 2 / (n - 1), lh.std() / math.sqrt(N_SIM)),
        "연습 1.2: (μ̂, β̂) = (x_(1), x̄ − x_(1))": np.allclose(num, [xs.min(), xs.mean() - xs.min()], atol=1e-5),
        "연습 1.3: 무작위 확률벡터 2만 개 모두 N/n 보다 가능도가 작다": np.all([ll_mult(a) < ll_mult(N / N.sum()) for a in alts])})
text
e^(−λ̂) = 0.497,  η 로 바꿔 최대화 = 0.497,  관측 비율 144/280 = 0.514,  기대도수 139.0
  ✓  정리 1.3: η = e^{−λ} 로 직접 최대화해도 e^{−λ̂} = 0.497
  ✓  연습 1.4: 관측 비율 144/280 = 0.514
  ✓  연습 1.1: E(1/X̄) = nλ/(n−1) (n=8, λ=2)
  ✓  연습 1.2: (μ̂, β̂) = (x_(1), x̄ − x_(1))
  ✓  연습 1.3: 무작위 확률벡터 2만 개 모두 N/n 보다 가능도가 작다
python
# 보조정리 1.4 · 정리 1.5: 기대 로그가능도는 참값에서 최대, 그래서 참값의 가능도가 이긴다
lam0 = 0.7
k = np.arange(0, 60)
expected_ll = lambda l: np.sum(stats.poisson.pmf(k, lam0) * stats.poisson.logpmf(k, l))
lam_grid = np.linspace(0.2, 1.6, 1401)
E_ll = np.array([expected_ll(l) for l in lam_grid])
kl = lambda l: expected_ll(lam0) - expected_ll(l)          # D(λ0 || λ)
wins = {}
for n in (10, 100, 1000):
    X = rng.poisson(lam0, (20_000, n)); S = X.sum(1)
    wins[n] = np.mean(S * np.log(lam0) - n * lam0 > S * np.log(0.9) - n * 0.9)
print("P(L(0.7) > L(0.9)):", {n: round(float(v), 3) for n, v in wins.items()})
# 연습 1.5: 균등분포의 KL = log(θ/θ0) (θ ≥ θ0), θ < θ0 이면 무한대
th0, th = 2.0, 3.0
kl_unif = integrate.quad(lambda x: (1 / th0) * math.log((1 / th0) / (1 / th)), 0, th0)[0]
report({"보조정리 1.4: E_{0.7} log f(X;λ) 의 최대점이 0.7 (격자 0.001)": abs(lam_grid[E_ll.argmax()] - lam0) < 1e-3,
        "보조정리 1.4: D(λ0‖λ) = λ0 log(λ0/λ) − λ0 + λ ≥ 0": all(abs(kl(l) - (lam0 * math.log(lam0 / l) - lam0 + l)) < 1e-10 for l in (0.3, 0.9, 1.5)),
        "정리 1.5: P(L(θ0) > L(θ)) 가 n 과 함께 1로 (0.99 이상 at n=1000)": wins[10] < wins[100] < wins[1000] and wins[1000] > 0.99,
        "연습 1.5: D(U(0,2) ‖ U(0,3)) = log(3/2)": abs(kl_unif - math.log(1.5)) < 1e-12})

fig, axes = plt.subplots(1, 2, figsize=(11, 3.6))
for m, col in zip([10, 100, 1000], SERIES):
    xs_ = rng.poisson(lam0, m)
    axes[0].plot(lam_grid, xs_.mean() * np.log(lam_grid) - lam_grid, color=col, lw=1.4, label=f"n = {m}")
axes[0].plot(lam_grid, lam0 * np.log(lam_grid) - lam_grid, **THEORY, label="E log f(X; λ)")
axes[0].axvline(lam0, color=C["hist"], lw=0.8, ls=":"); axes[0].set_ylim(-2.2, -0.6)
axes[0].set_xlabel("λ"); axes[0].set_title("(1/n) ℓ(λ) → E log f(X; λ), max at λ0 = 0.7"); axes[0].legend(fontsize=8)
corps = vb.corps.unique()
for kk, col in zip([1, 5, 14], SERIES):
    sub = vb[vb.corps.isin(corps[:kk])]; T, m = sub.deaths.sum(), len(sub); lh_ = T / m
    axes[1].plot(lam_grid, np.exp(T * np.log(lam_grid / lh_) - m * (lam_grid - lh_)), color=col, label=f"{kk} corps (n = {m})")
axes[1].axhline(math.exp(-3.841 / 2), color=C["hist"], lw=0.8, ls=":")
axes[1].set_xlabel("λ"); axes[1].set_title("relative likelihood L(λ)/L(λ̂), horse kicks"); axes[1].legend(fontsize=8)
plt.tight_layout(); plt.show()
text
P(L(0.7) > L(0.9)): {10: 0.6, 100: 0.873, 1000: 1.0}
  ✓  보조정리 1.4: E_{0.7} log f(X;λ) 의 최대점이 0.7 (격자 0.001)
  ✓  보조정리 1.4: D(λ0‖λ) = λ0 log(λ0/λ) − λ0 + λ ≥ 0
  ✓  정리 1.5: P(L(θ0) > L(θ)) 가 n 과 함께 1로 (0.99 이상 at n=1000)
  ✓  연습 1.5: D(U(0,2) ‖ U(0,3)) = log(3/2)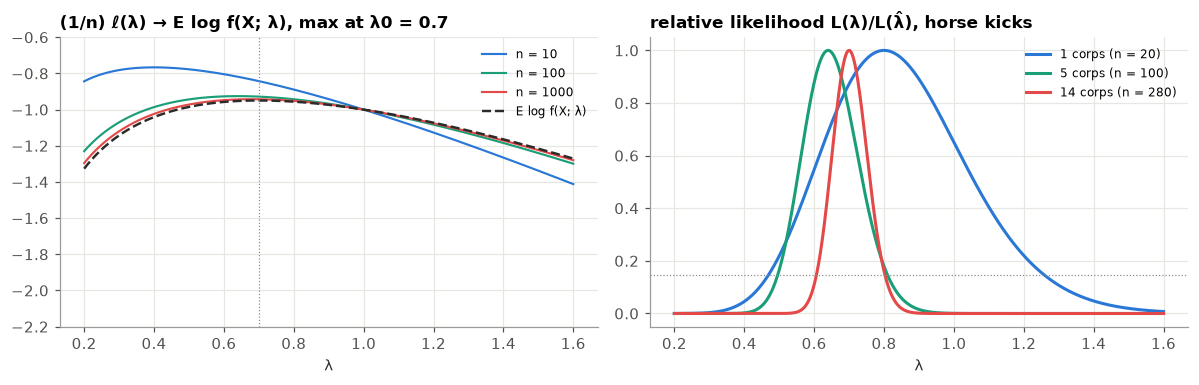
그림 읽기. 왼쪽: 표본이 커질수록 평균 로그가능도(색)가 기대 로그가능도(점선)에 붙고, 꼭대기가 참값 0.7로 모인다. 이것이 정리 1.5–1.6의 내용이다. 오른쪽: 기병대 자료를 군단 1개, 5개, 14개로 늘리면 상대가능도가 둘레로 좁아진다. 점선(높이 ) 위의 들이 95% 가능도비 구간이다(5절).
📝 연습 1.1–1.5 (강의노트): 지수분포, 두 모수 지수, 다항분포, 기병대의 확률, 균등분포의 KL.
2. Fisher 정보와 Cramér–Rao 한계
정의 2.1 점수 , 정보 · 정리 2.2 , · 예제 2.3 정보의 표 · 정리 2.4 · 정의 2.5 효율 · 예제 2.6 한계에 닿는 것과 닿지 않는 것.
정보를 "점수의 분산"과 "곡률의 기댓값" 두 가지로 수치적분해 같은지 본다. 미분은 중앙차분으로 해서 손으로 유도한 식에 기대지 않는다.
python
def fisher_info(logf, theta, support, h=1e-4):
    """정리 2.2: 두 표현 — E[s²] 와 −E[∂² log f] — 를 수치미분·수치적분(또는 합)으로"""
    s = lambda x: (logf(x, theta + h) - logf(x, theta - h)) / (2 * h)
    d2 = lambda x: (logf(x, theta + h) - 2 * logf(x, theta) + logf(x, theta - h)) / h**2
    if isinstance(support, np.ndarray):                     # 이산: 합
        p = np.exp(logf(support, theta))
        return np.sum(p * s(support)), np.sum(p * s(support) ** 2), -np.sum(p * d2(support))
    E = lambda g: integrate.quad(lambda x: np.exp(logf(x, theta)) * g(x), *support, limit=200)[0]
    return E(s), E(lambda x: s(x) ** 2), -E(d2)

models = {   # 이름: (log f(x; θ), θ, 받침, 예제 2.3 의 I(θ))
    "Bernoulli(p=0.3)": (lambda x, p: x * np.log(p) + (1 - x) * np.log(1 - p), 0.3, np.array([0, 1]), 1 / (0.3 * 0.7)),
    "Poisson(λ=0.7)": (lambda x, l: stats.poisson.logpmf(x, l), 0.7, np.arange(0, 60), 1 / 0.7),
    "N(μ, σ²=4), μ=1": (lambda x, m: stats.norm.logpdf(x, m, 2), 1.0, (-np.inf, np.inf), 1 / 4),
    "N(0, σ²), σ²=4": (lambda x, v: stats.norm.logpdf(x, 0, np.sqrt(v)), 4.0, (-np.inf, np.inf), 1 / (2 * 16)),
    "Cauchy 위치 θ=0": (lambda x, t: stats.cauchy.logpdf(x, t), 0.0, (-np.inf, np.inf), 0.5),
}
rows = []
for name, (logf, th, sup, I_true) in models.items():
    Es, Es2, Ecurv = fisher_info(logf, th, sup)
    rows.append(dict(model=name, E_score=Es, E_score2=Es2, minus_E_curv=Ecurv, table=I_true))
info_tab = pd.DataFrame(rows).set_index("model")
print((info_tab.round(5) + 0.0).to_string())
report({"정리 2.2: 점수의 평균 = 0 (1e-6 안)": np.allclose(info_tab.E_score, 0, atol=1e-6),
        "정리 2.2 · 연습 2.1: E s² = −E ∂² log f = 예제 2.3 의 표 (상대오차 1e-4)": np.allclose(info_tab.E_score2, info_tab.table, rtol=1e-4) and np.allclose(info_tab.minus_E_curv, info_tab.table, rtol=1e-4)})
text
                  E_score  E_score2  minus_E_curv    table
model
Bernoulli(p=0.3)      0.0   4.76191       4.76190  4.76190
Poisson(λ=0.7)        0.0   1.42857       1.42857  1.42857
N(μ, σ²=4), μ=1       0.0   0.25000       0.25000  0.25000
N(0, σ²), σ²=4        0.0   0.03125       0.03125  0.03125
Cauchy 위치 θ=0         0.0   0.50000       0.50000  0.50000
  ✓  정리 2.2: 점수의 평균 = 0 (1e-6 안)
  ✓  정리 2.2 · 연습 2.1: E s² = −E ∂² log f = 예제 2.3 의 표 (상대오차 1e-4)
python
# 정리 2.4 · 예제 2.6 · 연습 2.3–2.4: 불편추정량들의 분산과 Cramér–Rao 한계 1/(nI)
n, R = 10, N_SIM
out = []
X = rng.poisson(3.0, (R, n));                 out.append(("Poisson x̄", X.mean(1).var(), 3.0 / n))
X = rng.normal(0, 2, (R, n));                 out.append(("정규 S²", X.var(1, ddof=1).var(), 2 * 16 / n))
X = rng.exponential(1 / 2.0, (R, n));         out.append(("지수 비율 (n−1)/(nX̄)", ((n - 1) / (n * X.mean(1))).var(), 4.0 / n))
X = rng.uniform(0, 3, (R, n));                out.append(("균등 (n+1)/n·X_(n)", ((n + 1) / n * X.max(1)).var(), 9.0 / n))
cr = pd.DataFrame(out, columns=["estimator", "Var (sim)", "CR bound 1/(nI)"]).set_index("estimator")
cr["exact Var"] = [3.0 / n, 2 * 16 / (n - 1), 4.0 / (n - 2), 9.0 / (n * (n + 2))]
cr["Var / bound"] = cr["Var (sim)"] / cr["CR bound 1/(nI)"]
print(cr.round(4).to_string())
# 예제 2.6 (c): σ² 의 세 추정량의 평균제곱오차 (단위 σ⁴)
X = rng.normal(0, 1, (R, n)); ss = ((X - X.mean(1, keepdims=True)) ** 2).sum(1)
mse = {d: np.mean((ss / d - 1) ** 2) for d in (n - 1, n, n + 1)}
print("MSE(σ²) / σ⁴ — 나누는 수 n−1, n, n+1:", {d: round(float(v), 4) for d, v in mse.items()})
rel = lambda a, b: abs(a / b - 1)
report({"예제 2.6 (a): Poisson x̄ 는 한계에 닿는다 (2% 안)": rel(cr.iloc[0, 0], cr.iloc[0, 1]) < 0.02,
        "예제 2.6 (b): Var S² = 2σ⁴/(n−1), 효율 (n−1)/n": rel(cr.iloc[1, 0], cr.iloc[1, 2]) < 0.02,
        "연습 2.3: 지수 비율의 불편추정량 Var = λ²/(n−2) > λ²/n": rel(cr.iloc[2, 0], cr.iloc[2, 2]) < 0.03 and cr.iloc[2, 0] > cr.iloc[2, 1],
        "연습 2.4: 균등에서는 \"한계\"보다 작다 — θ²/(n(n+2)), 정칙조건 (R1) 위반": rel(cr.iloc[3, 0], cr.iloc[3, 2]) < 0.02 and cr.iloc[3, 0] < cr.iloc[3, 1],
        "예제 2.6 (c): n=10 에서 MSE 0.22 (n−1), 0.19 (n) — 공식 2/(n−1), (2n−1)/n²":
            rel(mse[n - 1], 2 / (n - 1)) < 0.02 and rel(mse[n], (2 * n - 1) / n**2) < 0.02 and mse[n] < mse[n - 1]})
text
                   Var (sim)  CR bound 1/(nI)  exact Var  Var / bound
estimator
Poisson x̄            0.3005              0.3     0.3000       1.0016
정규 S²                 3.5554              3.2     3.5556       1.1110
지수 비율 (n−1)/(nX̄)     0.4941              0.4     0.5000       1.2353
균등 (n+1)/n·X_(n)      0.0751              0.9     0.0750       0.0834
MSE(σ²) / σ⁴ — 나누는 수 n−1, n, n+1: {9: 0.2207, 10: 0.1891, 11: 0.1813}
  ✓  예제 2.6 (a): Poisson x̄ 는 한계에 닿는다 (2% 안)
  ✓  예제 2.6 (b): Var S² = 2σ⁴/(n−1), 효율 (n−1)/n
  ✓  연습 2.3: 지수 비율의 불편추정량 Var = λ²/(n−2) > λ²/n
  ✓  연습 2.4: 균등에서는 "한계"보다 작다 — θ²/(n(n+2)), 정칙조건 (R1) 위반
  ✓  예제 2.6 (c): n=10 에서 MSE 0.22 (n−1), 0.19 (n) — 공식 2/(n−1), (2n−1)/n²
python
# 연습 2.2: 모수를 바꾸면 I*(η) = I(θ)/g'(θ)² — 로그 오즈의 정보 p(1−p)
p, n = 0.3, 400
k_ = rng.binomial(n, p, N_SIM)
k_ = k_[(k_ > 0) & (k_ < n)]
eta_hat = np.log(k_ / (n - k_))
info_eta = fisher_info(lambda x, e: x * e - np.log1p(np.exp(e)), math.log(p / (1 - p)), np.array([0, 1]))[1]
print(f"n Var(η̂) = {n * eta_hat.var():.3f},  1/(p(1−p)) = {1 / (p * (1 - p)):.3f},  I*(η) 수치 = {info_eta:.4f} (p(1−p) = {p * (1 - p):.4f})")
report({"연습 2.2: 로그 오즈의 정보 = p(1−p)": abs(info_eta - p * (1 - p)) < 1e-6,
        "연습 2.2: n Var(η̂) ≈ 1/(p(1−p)) — 7회 델타 방법과 같은 답 (3% 안)": abs(n * eta_hat.var() * p * (1 - p) - 1) < 0.03})
text
n Var(η̂) = 4.808,  1/(p(1−p)) = 4.762,  I*(η) 수치 = 0.2100 (p(1−p) = 0.2100)
  ✓  연습 2.2: 로그 오즈의 정보 = p(1−p)
  ✓  연습 2.2: n Var(η̂) ≈ 1/(p(1−p)) — 7회 델타 방법과 같은 답 (3% 안)
표 읽기. Poisson의 는 한계에 정확히 닿고(효율 1), 은 배, 지수 비율의 불편추정량은 배 크다. 균등분포의 은 분산이 "한계"의 밖에 되지 않는다. 받침이 모수에 의존해서 정리 2.4의 증명(적분 기호 안의 미분)이 무너졌기 때문이다(7.2절).
📝 연습 2.1–2.4 (강의노트): 정보의 계산, 모수를 바꾸면, 지수 비율의 한계, 균등분포에서는.
3. 최대가능도 추정량의 점근정규성
정리 3.1 — 증명은 점수의 테일러 전개 + CLT + Khinchin + Slutsky · 따름정리 3.2 Wald 구간 , 의 델타 방법 · 예제 3.3 Cauchy: MLE 대 중앙값 · 상자: 여러 모수의 정보 행렬.
증명의 단계 ③–⑤를 숫자로 따라간다. 분자 는 정규로(③), 분모 는 로 간다(④).
python
# 정리 3.1 의 증명 ③④: 분자와 분모를 따로 본다 (Poisson λ0 = 0.7, n = 280)
lam0, n = 0.7, 280
X = rng.poisson(lam0, (N_SIM, n)); S = X.sum(1)
numer = (S / lam0 - n) / math.sqrt(n)            # n^{-1/2} ℓ'(λ0) = n^{-1/2} Σ (X/λ0 − 1)
denom = S / lam0**2 / n                          # −n^{-1} ℓ''(λ0) = n^{-1} Σ X/λ0²
z = (S / n - lam0) / math.sqrt(lam0 / n)         # √(nI)(λ̂ − λ0)
print(f"분자: 평균 {numer.mean():+.4f}, 분산 {numer.var():.4f} (I = {1 / lam0:.4f});  분모: 평균 {denom.mean():.4f}, sd {denom.std():.4f}")
print(f"표준화한 MLE: 평균 {z.mean():+.4f}, 분산 {z.var():.4f}, 왜도 {stats.skew(z):.3f} (이론 1/√(nλ0) = {1 / math.sqrt(n * lam0):.3f})")
# 지수분포 비율: 1/X̄ 는 작은 n 에서 치우친다 — E λ̂ = nλ/(n−1), 왜도는 n 과 함께 준다
skews = {}
for m in (10, 100, 1000):
    lh = 1 / rng.exponential(1, (100_000, m)).mean(1)
    skews[m] = stats.skew(math.sqrt(m) * (lh - 1))
print("지수 비율 √n(λ̂−λ)/λ 의 왜도:", {m: round(float(v), 3) for m, v in skews.items()})
report({"③ 분자: n^{-1/2} ℓ'(θ0) 의 평균 0, 분산 I(θ0)": within(numer.mean(), 0, numer.std() / math.sqrt(N_SIM)) and abs(numer.var() * lam0 - 1) < 0.01,
        "④ 분모: −n^{-1} ℓ''(θ0) 의 평균 = I, sd = 1/√(nλ0³) = 0.10 (→ 0)": within(denom.mean(), 1 / lam0, denom.std() / math.sqrt(N_SIM)) and abs(denom.std() * math.sqrt(n * lam0**3) - 1) < 0.01,
        "정리 3.1: √(nI)(λ̂ − λ0) 의 분산 ≈ 1 (Poisson, n = 280)": abs(z.var() - 1) < 0.01,
        "그림 3.1: 지수 비율의 왜도가 n 과 함께 0으로 (10 > 100 > 1000)": skews[10] > skews[100] > skews[1000] > 0})
text
분자: 평균 -0.0054, 분산 1.4272 (I = 1.4286);  분모: 평균 1.4281, sd 0.1020
표준화한 MLE: 평균 -0.0045, 분산 0.9990, 왜도 0.066 (이론 1/√(nλ0) = 0.071)
text
지수 비율 √n(λ̂−λ)/λ 의 왜도: {10: 1.625, 100: 0.413, 1000: 0.12}
  ✓  ③ 분자: n^{-1/2} ℓ'(θ0) 의 평균 0, 분산 I(θ0)
  ✓  ④ 분모: −n^{-1} ℓ''(θ0) 의 평균 = I, sd = 1/√(nλ0³) = 0.10 (→ 0)
  ✓  정리 3.1: √(nI)(λ̂ − λ0) 의 분산 ≈ 1 (Poisson, n = 280)
  ✓  그림 3.1: 지수 비율의 왜도가 n 과 함께 0으로 (10 > 100 > 1000)
python
# 예제 3.3: Cauchy 위치 — MLE 대 중앙값. MLE 는 4절의 Fisher 채점으로 구한다
def cauchy_mle(X, iters=200):
    """중앙값에서 출발한 Fisher 채점 (알고리즘 4.1): θ ← θ + ℓ'(θ)/(n/2). 걸음이 2를 넘지 않는다"""
    t = np.median(X, axis=1)
    m = X.shape[1]
    for _ in range(iters):
        u = X - t[:, None]
        t = t + np.sum(2 * u / (1 + u * u), axis=1) / (m / 2)
    return t

def order_stat_var(n, k, dist):
    """8회 따름정리 1.3 의 밀도로 k 번째 순서통계량의 분산 (평균 0 인 대칭분포)"""
    logc = special.gammaln(n + 1) - special.gammaln(k) - special.gammaln(n - k + 1)
    f = lambda x: x * x * np.exp(logc + (k - 1) * dist.logcdf(x) + (n - k) * dist.logsf(x) + dist.logpdf(x))
    return integrate.quad(f, -np.inf, np.inf, limit=200)[0]

m = 51
X = rng.standard_cauchy((N_SIM, m))
th_mle, th_med = cauchy_mle(X), np.median(X, axis=1)
u = X - th_med[:, None]
th_one = th_med + np.sum(2 * u / (1 + u * u), axis=1) / (m / 2)      # 명제 4.2: 한 걸음
nv = {"MLE": m * th_mle.var(), "one-step": m * th_one.var(), "median": m * th_med.var()}
nv_med_exact = m * order_stat_var(m, 26, stats.cauchy())
se_nv = lambda est: est * math.sqrt(2 / N_SIM) * 3          # 꼬리가 두꺼운 것을 감안한 넉넉한 표준오차
print({k: round(float(v), 3) for k, v in nv.items()}, f" 중앙값 정확히: {nv_med_exact:.3f};  극한: MLE 2, 중앙값 π²/4 = {math.pi**2 / 4:.3f}")
# 매 표본에서 Fisher 채점이 찾은 점이 정말 가능도 방정식의 근이고 극대인지
u = X[:2000] - th_mle[:2000, None]
score_at = np.abs(np.sum(2 * u / (1 + u * u), axis=1)).max()
curv_at = np.sum(2 * (u * u - 1) / (1 + u * u) ** 2, axis=1).max()
report({"예제 3.3: n Var(MLE) ≈ 2.11 (n = 51; 극한 2)": abs(nv["MLE"] - 2.11) < se_nv(2.11),
        "예제 3.3: n Var(중앙값) = 2.618 (순서통계량의 밀도로 정확히) 과 시뮬레이션이 맞는다": abs(nv["median"] - nv_med_exact) < se_nv(2.62) and abs(nv_med_exact - 2.618) < 1e-3,
        "예제 3.3: 비 MLE/중앙값 ≈ 0.81 (n=51 에서도 극한 8/π² = 0.811 근처)": abs(nv["MLE"] / nv["median"] - 8 / math.pi**2) < 0.02,
        "명제 4.2: 한 걸음 추정량 2.13 ≈ MLE 2.11 ≪ 중앙값 2.62": abs(nv["one-step"] - 2.13) < se_nv(2.13) and nv["one-step"] < nv["median"] - 0.4,
        "Fisher 채점의 도착점: ℓ'(θ̂) = 0, ℓ''(θ̂) < 0 (2000개 표본)": score_at < 1e-8 and curv_at < 0})
text
{'MLE': 2.1, 'one-step': 2.128, 'median': 2.615}  중앙값 정확히: 2.618;  극한: MLE 2, 중앙값 π²/4 = 2.467
  ✓  예제 3.3: n Var(MLE) ≈ 2.11 (n = 51; 극한 2)
  ✓  예제 3.3: n Var(중앙값) = 2.618 (순서통계량의 밀도로 정확히) 과 시뮬레이션이 맞는다
  ✓  예제 3.3: 비 MLE/중앙값 ≈ 0.81 (n=51 에서도 극한 8/π² = 0.811 근처)
  ✓  명제 4.2: 한 걸음 추정량 2.13 ≈ MLE 2.11 ≪ 중앙값 2.62
  ✓  Fisher 채점의 도착점: ℓ'(θ̂) = 0, ℓ''(θ̂) < 0 (2000개 표본)
python
fig, axes = plt.subplots(1, 3, figsize=(12, 3.4))
zz = np.linspace(-4, 4, 300)
t = np.arange(stats.poisson.ppf(1e-6, 196), stats.poisson.ppf(1 - 1e-6, 196) + 1)
axes[0].vlines((t / 280 - 0.7) / math.sqrt(0.7 / 280), 0, stats.poisson.pmf(t, 196) * math.sqrt(196), color=C["stat"], lw=1)
axes[0].plot(zz, stats.norm.pdf(zz), **THEORY); axes[0].set_title("Poisson, n = 280 (exact)")
for mm, col in [(10, C["key"]), (100, C["stat"])]:
    lh = 1 / rng.exponential(1, (100_000, mm)).mean(1)
    axes[1].hist(math.sqrt(mm) * (lh - 1), bins=np.linspace(-4, 4, 41), density=True, histtype="step", color=col, lw=1.5, label=f"n = {mm}")
axes[1].plot(zz, stats.norm.pdf(zz), **THEORY); axes[1].set_title("exponential rate 1/X̄"); axes[1].legend()
b6 = np.linspace(-6, 6, 49); z6 = np.linspace(-6, 6, 300)
axes[2].hist(math.sqrt(m) * th_mle, bins=b6, density=True, histtype="step", color=C["key"], lw=1.5, label="MLE")
axes[2].hist(math.sqrt(m) * th_med, bins=b6, density=True, histtype="step", color=C["stat"], lw=1.5, label="median")
axes[2].plot(z6, stats.norm.pdf(z6, scale=math.sqrt(2)), **THEORY, label="N(0, 2)")
axes[2].set_title("Cauchy location, n = 51"); axes[2].legend(fontsize=8)
plt.tight_layout(); plt.show()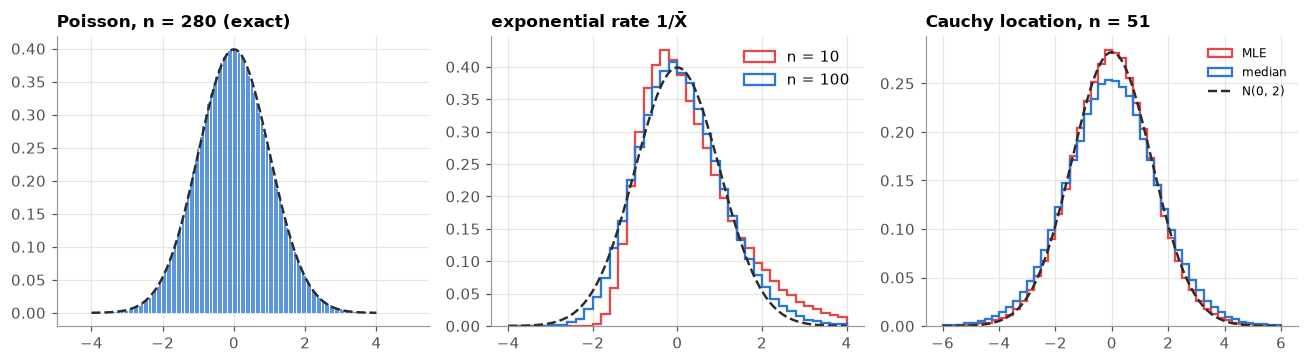
그림 읽기. 정규 근사가 맞는 속도는 모형마다 다르다. 기병대 규모의 Poisson()은 이미 정규 곡선 위에 있고, 지수 비율 는 에서 오른쪽 꼬리가 길다. Cauchy에서는 MLE(빨강)가 중앙값(파랑)보다 가운데에 더 몰려 있다. 같은 자료에서 정보를 더 많이 뽑아낸다.
python
# 따름정리 3.2 · 연습 3.1: Wald 구간 — 기병대, 그리고 e^{−λ} 의 구간
lam_hat, n = T_ALL / N_ALL, N_ALL
half = 1.96 * math.sqrt(lam_hat / n)
ci = (lam_hat - half, lam_hat + half)
ci_p0 = (math.exp(-ci[1]), math.exp(-ci[0]))                   # 단조변환: 끝점을 옮긴다
se_p0 = math.exp(-lam_hat) * math.sqrt(lam_hat / n)            # 델타 방법: |g'| = e^{−λ}
ci_p0_delta = (math.exp(-lam_hat) - 1.96 * se_p0, math.exp(-lam_hat) + 1.96 * se_p0)
print(f"λ: [{ci[0]:.3f}, {ci[1]:.3f}];  e^(−λ): 끝점 변환 [{ci_p0[0]:.3f}, {ci_p0[1]:.3f}], 델타 [{ci_p0_delta[0]:.3f}, {ci_p0_delta[1]:.3f}]")
# 정확한 포함확률: T = ΣX ~ Poi(nλ) 이므로 시뮬레이션 없이
def wald_coverage(lam, n):
    t = np.arange(0, int(n * lam + 15 * math.sqrt(n * lam) + 30))
    lh = t / n
    return np.sum(stats.poisson.pmf(t, n * lam) * (np.abs(lh - lam) <= 1.96 * np.sqrt(lh / n)))
cov = {m_: wald_coverage(0.7, m_) for m_ in (10, 50, 280)}
print("Wald 구간의 정확한 포함확률 (λ = 0.7):", {k: round(float(v), 4) for k, v in cov.items()})
report({"연습 3.1: λ 의 95% 구간 [0.602, 0.798]": np.allclose(ci, (0.602, 0.798), atol=5e-4),
        "연습 3.1: e^{−λ} 의 구간 [0.450, 0.548], 델타 방법 [0.448, 0.545]": np.allclose(ci_p0, (0.450, 0.548), atol=5e-4) and np.allclose(ci_p0_delta, (0.448, 0.545), atol=5e-4),
        "따름정리 3.2: n = 280 에서 포함확률 ≈ 0.95 (±0.01)": abs(cov[280] - 0.95) < 0.01})
text
λ: [0.602, 0.798];  e^(−λ): 끝점 변환 [0.450, 0.548], 델타 [0.448, 0.545]
Wald 구간의 정확한 포함확률 (λ = 0.7): {10: 0.9125, 50: 0.9368, 280: 0.9486}
  ✓  연습 3.1: λ 의 95% 구간 [0.602, 0.798]
  ✓  연습 3.1: e^{−λ} 의 구간 [0.450, 0.548], 델타 방법 [0.448, 0.545]
  ✓  따름정리 3.2: n = 280 에서 포함확률 ≈ 0.95 (±0.01)
python
# 3절의 상자 · 연습 3.2–3.4: 정보 행렬, 관측 정보, 감마의 모양 모수
def score_cov(score_fn, sample):
    """점수 벡터의 표본 공분산 ≈ 정보 행렬"""
    s = score_fn(sample)
    return np.cov(s)

# 연습 3.4: 정규 (μ, σ²) — 정보 행렬은 대각 diag(1/σ², 1/(2σ⁴))
mu, s2 = 1.0, 4.0
xn = rng.normal(mu, math.sqrt(s2), 1_000_000)
I_norm = score_cov(lambda x: np.vstack([(x - mu) / s2, -0.5 / s2 + (x - mu) ** 2 / (2 * s2**2)]), xn)
# 연습 3.3: 감마(α, β) — I = [[ψ'(α), 1/β], [1/β, α/β²]],  (I⁻¹)₁₁ = α/(αψ'(α) − 1)
a, b = 2.0, 1.5
xg = rng.gamma(a, b, 1_000_000)
I_gam = score_cov(lambda x: np.vstack([-special.digamma(a) - np.log(b) + np.log(x), -a / b + x / b**2]), xg)
I_gam_th = np.array([[special.polygamma(1, a), 1 / b], [1 / b, a / b**2]])
avar_alpha = np.linalg.inv(I_gam_th)[0, 0]
print("정규 정보 행렬 (시뮬레이션):\n", I_norm.round(4), "\n감마 정보 행렬 (시뮬레이션 / 이론):\n", I_gam.round(4), "\n", I_gam_th.round(4))
print(f"β 를 모를 때 α̂ 의 점근분산 × n = {avar_alpha:.3f};  β 를 알면 1/ψ'(α) = {1 / special.polygamma(1, a):.3f}")
# 연습 3.2: 곡률 J(θ) = −ℓ''(θ) 는 음수가 될 수 있다 — 예제 4.3 의 표본, 골짜기에서
x7 = np.array([-4.2, -2.8, 0.3, 0.8, 1.1, 9.5, 12.1])
J = lambda t: np.sum(2 * (1 - (x7 - t) ** 2) / (1 + (x7 - t) ** 2) ** 2)
E_J1 = integrate.quad(lambda uu: 2 * (1 - uu * uu) / (1 + uu * uu) ** 2 * stats.cauchy.pdf(uu), -np.inf, np.inf)[0]
print(f"J(0.62) = {J(0.6218):.3f} (극대: 양수),  J(7.53) = {J(7.5344):.3f} (골짜기: 음수),  한 관측의 E J = {E_J1:.4f}")
report({"연습 3.4: 정규의 정보 행렬은 대각, diag(1/σ², 1/(2σ⁴))": np.allclose(I_norm, np.diag([1 / s2, 1 / (2 * s2**2)]), atol=3e-3),
        "연습 3.3: 감마의 정보 행렬 (2% 안)": np.allclose(I_gam, I_gam_th, rtol=0.02),
        "연습 3.3: α = 2 에서 α/(αψ'(α) − 1) = 6.90, ψ'(2) = π²/6 − 1": abs(avar_alpha - 6.90) < 0.005 and abs(special.polygamma(1, 2) - (math.pi**2 / 6 - 1)) < 1e-12,
        "3절의 상자: 다른 모수를 모르면 점근분산이 커진다 (6.90 > 1/ψ'(2) = 1.55)": avar_alpha > 1 / special.polygamma(1, a),
        "연습 3.2: 골짜기에서 J = −0.48 < 0, 극대에서 J > 0, E J = 1/2 (한 관측)": abs(J(7.5344) + 0.48) < 0.005 and J(0.6218) > 0 and abs(E_J1 - 0.5) < 1e-8})
text
정규 정보 행렬 (시뮬레이션):
 [[2.50e-01 1.00e-04]
 [1.00e-04 3.12e-02]]
감마 정보 행렬 (시뮬레이션 / 이론):
 [[0.6452 0.667 ]
 [0.667  0.8892]]
 [[0.6449 0.6667]
 [0.6667 0.8889]]
β 를 모를 때 α̂ 의 점근분산 × n = 6.900;  β 를 알면 1/ψ'(α) = 1.551
J(0.62) = 4.066 (극대: 양수),  J(7.53) = -0.480 (골짜기: 음수),  한 관측의 E J = 0.5000
  ✓  연습 3.4: 정규의 정보 행렬은 대각, diag(1/σ², 1/(2σ⁴))
  ✓  연습 3.3: 감마의 정보 행렬 (2% 안)
  ✓  연습 3.3: α = 2 에서 α/(αψ'(α) − 1) = 6.90, ψ'(2) = π²/6 − 1
  ✓  3절의 상자: 다른 모수를 모르면 점근분산이 커진다 (6.90 > 1/ψ'(2) = 1.55)
  ✓  연습 3.2: 골짜기에서 J = −0.48 < 0, 극대에서 J > 0, E J = 1/2 (한 관측)
📝 연습 3.1–3.4 (강의노트): Poisson의 구간, 관측 정보, 감마의 모양 모수, 정규의 두 모수.
4. 계산 — Newton–Raphson과 Fisher 채점
알고리즘 4.1 Newton , Fisher 채점 · 명제 4.2 한 걸음 추정량 · 예제 4.3 Cauchy 표본의 두 봉우리 · 예제 4.4 감마의 모양: 적률법 대 MLE.
두 반복법을 하나의 클래스로 만든다. 점수, 곡률, 정보만 넘겨주면 어떤 1차원 모형에도 쓸 수 있다.
python
class ScoreSolver:
    """알고리즘 4.1: 가능도 방정식 ℓ'(θ) = 0 을 Newton–Raphson 또는 Fisher 채점으로 푼다"""
    def __init__(self, score, hessian=None, info=None):
        self.score, self.hessian, self.info = score, hessian, info

    def step(self, t, method):
        if method == "newton":
            return t - self.score(t) / self.hessian(t)
        return t + self.score(t) / self.info(t)                   # info = n I(θ)

    def solve(self, t0, method="newton", tol=1e-10, maxit=100, bound=1e4):
        path = [t0]
        for _ in range(maxit):
            t_new = self.step(path[-1], method)
            if not np.isfinite(t_new) or abs(t_new) > bound:
                return np.nan, path                               # 발산
            path.append(t_new)
            if abs(path[-1] - path[-2]) < tol:
                return t_new, path
        return np.nan, path                                       # 수렴하지 않음

# 연습 4.1: Poisson — Newton 의 한 걸음은 2θ − θ²/x̄, Fisher 채점은 한 걸음에 x̄
xbar, n = 0.7, 280
pois = ScoreSolver(score=lambda l: n * (xbar / l - 1), hessian=lambda l: -n * xbar / l**2, info=lambda l: n / l)
one_newton = {t0: pois.step(t0, "newton") for t0 in (0.3, 1.0, 1.5)}
print("Newton 한 걸음:", {k: round(v, 4) for k, v in one_newton.items()}, " Fisher 채점 한 걸음:", pois.step(1.5, "fisher"))
# 연습 4.2: 이차 수렴 — 오차의 비 e_{t+1}/e_t² → ℓ‴/(2ℓ″)
x7 = np.array([-4.2, -2.8, 0.3, 0.8, 1.1, 9.5, 12.1])
d1 = lambda t: np.sum(2 * (x7 - t) / (1 + (x7 - t) ** 2))
d2 = lambda t: np.sum(2 * ((x7 - t) ** 2 - 1) / (1 + (x7 - t) ** 2) ** 2)
cauchy7 = ScoreSolver(score=d1, hessian=d2, info=lambda t: len(x7) / 2)
root, path = cauchy7.solve(1.0, "newton", tol=1e-14)
e = np.abs(np.array(path[:-1]) - root)
h = 1e-4
d3 = (d2(root + h) - d2(root - h)) / (2 * h)
print("Newton 오차:", [f"{v:.1e}" for v in e[:5]], f" 비 e_(t+1)/e_t² = {e[2] / e[1]**2:.3f}, 이론 |ℓ‴/(2ℓ″)| = {abs(d3 / (2 * d2(root))):.3f}")
report({"연습 4.1: Newton 한 걸음 = 2θ − θ²/x̄, 시작이 2x̄ 를 넘으면 음수": all(abs(v - (2 * t0 - t0**2 / xbar)) < 1e-12 for t0, v in one_newton.items()) and one_newton[1.5] < 0,
        "연습 4.1: Fisher 채점은 한 걸음에 x̄": abs(pois.step(1.5, "fisher") - xbar) < 1e-12,
        "연습 4.2: e_{t+1} ≈ |ℓ‴/(2ℓ″)| e_t² (10% 안)": abs(e[2] / e[1] ** 2 / abs(d3 / (2 * d2(root))) - 1) < 0.1})
text
Newton 한 걸음: {0.3: 0.4714, 1.0: 0.5714, 1.5: -0.2143}  Fisher 채점 한 걸음: 0.6999999999999997
Newton 오차: ['3.8e-01', '2.1e-02', '1.2e-04', '3.8e-09', '0.0e+00']  비 e_(t+1)/e_t² = 0.277, 이론 |ℓ‴/(2ℓ″)| = 0.257
  ✓  연습 4.1: Newton 한 걸음 = 2θ − θ²/x̄, 시작이 2x̄ 를 넘으면 음수
  ✓  연습 4.1: Fisher 채점은 한 걸음에 x̄
  ✓  연습 4.2: e_{t+1} ≈ |ℓ‴/(2ℓ″)| e_t² (10% 안)
python
# 예제 4.3: 시작점 211개 — Newton 과 Fisher 채점이 각각 어디에 닿는가
crit = {"global max 0.62": None, "valley 7.53": None, "local max 9.31": None}
g = np.linspace(-6, 15, 4001); dd = np.array([d1(t) for t in g])
roots = [optimize.brentq(d1, g[i], g[i + 1]) for i in np.nonzero(np.sign(dd[:-1]) != np.sign(dd[1:]))[0]]
crit = dict(zip(crit, roots))
print("정류점:", {k: round(v, 4) for k, v in crit.items()}, " 곡률 ℓ'':", [round(d2(r), 3) for r in roots])
starts = np.linspace(-6, 15, 211)
ends = {mth: np.array([cauchy7.solve(s, mth)[0] for s in starts]) for mth in ("newton", "fisher")}
counts = {mth: {k: int(np.sum(np.abs(e_ - v) < 1e-6)) for k, v in crit.items()} | {"fail": int(np.isnan(e_).sum())} for mth, e_ in ends.items()}
print(pd.DataFrame(counts).T.to_string())
glob = starts[np.abs(ends["newton"] - crit["global max 0.62"]) < 1e-6]
fis_left = starts[np.abs(ends["fisher"] - crit["global max 0.62"]) < 1e-6]
report({"예제 4.3: 극대 0.62 · 9.31, 골짜기 7.53": np.allclose(roots, [0.6218, 7.5344, 9.3097], atol=1e-4) and d2(roots[1]) > 0,
        "예제 4.3: Newton — 전역 최대 15, 골짜기 82, 작은 봉우리 14, 발산·미수렴 100": counts["newton"] == {"global max 0.62": 15, "valley 7.53": 82, "local max 9.31": 14, "fail": 100},
        "예제 4.3: 전역 최대에 닿는 15개 중 14개는 중앙값 0.8 근처 [0, 1.3] 에서 출발": np.sum((glob >= 0) & (glob <= 1.3 + 1e-9)) == 14,
        "예제 4.3: Fisher 채점은 골짜기에 멈추거나 발산하지 않는다": counts["fisher"]["valley 7.53"] == 0 and counts["fisher"]["fail"] == 0,
        "예제 4.3: Fisher 채점 — 7.53 의 왼쪽은 0.62, 오른쪽은 9.31": fis_left.max() < 7.53 and np.all(np.abs(ends["fisher"][starts > 7.6] - crit["local max 9.31"]) < 1e-6)})

ccol = {"global max 0.62": C["key"], "valley 7.53": C["assume"], "local max 9.31": C["stat"]}
fig, axes = plt.subplots(1, 2, figsize=(12, 3.6))
grid = np.linspace(-6, 15, 2001)
axes[0].plot(grid, [-np.sum(np.log1p((x7 - t) ** 2)) for t in grid], color=C["ink"])
axes[0].plot(x7, np.full(7, -34.5), "o", color=C["data"])
for k_, v in crit.items():
    axes[0].plot(v, -np.sum(np.log1p((x7 - v) ** 2)), "o", color=ccol[k_], ms=8, label=k_)
axes[0].set_title("Cauchy log-likelihood, n = 7"); axes[0].set_xlabel("θ"); axes[0].legend(fontsize=8)
for row, mth in [(1, "newton"), (0, "fisher")]:
    e_ = ends[mth]
    axes[1].plot(starts[np.isnan(e_)], np.full(np.isnan(e_).sum(), row), "x", color=C["hist"])
    for k_, v in crit.items():
        hit = np.abs(e_ - v) < 1e-6
        axes[1].plot(starts[hit], np.full(hit.sum(), row), "o", color=ccol[k_], ms=4)
axes[1].set_yticks([0, 1]); axes[1].set_yticklabels(["Fisher scoring", "Newton"]); axes[1].set_ylim(-0.5, 1.5)
axes[1].set_xlabel("starting point"); axes[1].set_title("where each start ends (gray ×: diverges)")
plt.tight_layout(); plt.show()
text
정류점: {'global max 0.62': 0.6218, 'valley 7.53': 7.5344, 'local max 9.31': 9.3097}  곡률 ℓ'': [np.float64(-4.066), np.float64(0.48), np.float64(-1.517)]
        global max 0.62  valley 7.53  local max 9.31  fail
newton               15           82              14   100
fisher              136            0              75     0
  ✓  예제 4.3: 극대 0.62 · 9.31, 골짜기 7.53
  ✓  예제 4.3: Newton — 전역 최대 15, 골짜기 82, 작은 봉우리 14, 발산·미수렴 100
  ✓  예제 4.3: 전역 최대에 닿는 15개 중 14개는 중앙값 0.8 근처 [0, 1.3] 에서 출발
  ✓  예제 4.3: Fisher 채점은 골짜기에 멈추거나 발산하지 않는다
  ✓  예제 4.3: Fisher 채점 — 7.53 의 왼쪽은 0.62, 오른쪽은 9.31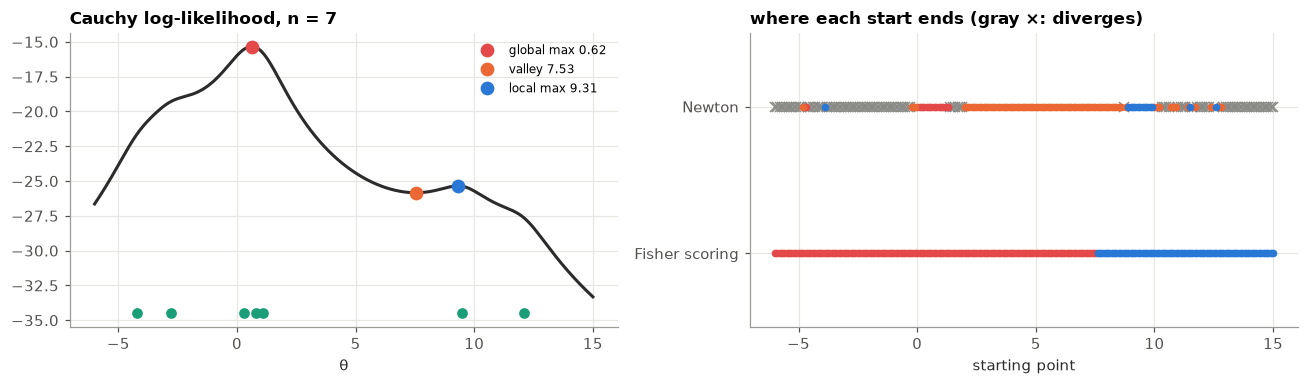
그림 읽기. Newton–Raphson(위)은 인 점을 찾을 뿐이어서 곡률이 양수인 골짜기 7.53(주황)에도 기꺼이 멈추고, 곡률이 0에 가까운 곳에서 출발하면 멀리 튕겨 나간다(회색 ×). Fisher 채점(아래)은 곡률 대신 그 기댓값 을 써서 언제나 오르막으로 가므로, 출발점이 속한 봉우리에 정직하게 닿는다. 실전의 처방은 중앙값처럼 좋은 출발점과 여러 출발점이다.
python
# 예제 4.4 · 연습 4.3: 감마의 모양 — 적률법 대 MLE (α = 2)
def gamma_shape_mle(x):
    """β 를 소거한 방정식 log α − ψ(α) = log x̄ − mean(log x) 를 Newton 으로 (좋은 출발점: Minka 의 근사)"""
    s = math.log(x.mean()) - np.log(x).mean()
    a = (3 - s + math.sqrt((s - 3) ** 2 + 24 * s)) / (12 * s)
    solver = ScoreSolver(score=lambda a_: math.log(a_) - special.digamma(a_) - s,
                         hessian=lambda a_: 1 / a_ - special.polygamma(1, a_))
    return solver.solve(a, "newton", tol=1e-12)[0]

def gamma_shape_mle_vec(G, iters=30):
    """같은 Newton 을 표본마다 한꺼번에 (행 = 표본)"""
    s = np.log(G.mean(1)) - np.log(G).mean(1)
    a = (3 - s + np.sqrt((s - 3) ** 2 + 24 * s)) / (12 * s)
    for _ in range(iters):
        a = a - (np.log(a) - special.digamma(a) - s) / (1 / a - special.polygamma(1, a))
    return a

alpha = 2.0
avar = {"MoM": 2 * alpha * (alpha + 1), "MLE": alpha / (alpha * special.polygamma(1, alpha) - 1)}
nvar = {}
for n, R in [(200, 20_000), (1000, 10_000)]:
    G = rng.gamma(alpha, 1.0, (R, n))
    nvar[n] = (n * (G.mean(1) ** 2 / G.var(1, ddof=1)).var(), n * gamma_shape_mle_vec(G).var())
    print(f"n = {n}: n Var 적률법 {nvar[n][0]:.2f} (극한 {avar['MoM']:.2f}),  MLE {nvar[n][1]:.2f} (극한 {avar['MLE']:.2f})")
report({"예제 4.4: 한 표본의 MLE 가 scipy.stats.gamma.fit 과 같고, 벡터화한 Newton 과도 같다": abs(gamma_shape_mle(G[0]) - stats.gamma.fit(G[0], floc=0)[0]) < 1e-4 and abs(gamma_shape_mle(G[0]) - gamma_shape_mle_vec(G[:1])[0]) < 1e-10,
        "연습 4.3: 적률법의 점근분산 2α(α+1) = 12 (n = 200, 1000 모두 5% 안)": all(abs(v[0] / avar["MoM"] - 1) < 0.05 for v in nvar.values()),
        "예제 4.4: MLE 의 n Var 7.3 (n=200) → 7.0 (n=1000) → 극한 6.90": abs(nvar[200][1] - 7.3) < 0.3 and abs(nvar[1000][1] / avar["MLE"] - 1) < 0.05 and nvar[1000][1] < nvar[200][1],
        "예제 4.4: 적률법의 효율 0.58 — 정보의 40% 를 버린다": abs(avar["MLE"] / avar["MoM"] - 0.575) < 0.001})
text
n = 200: n Var 적률법 11.97 (극한 12.00), MLE 7.35 (극한 6.90)text
n = 1000: n Var 적률법 12.09 (극한 12.00),  MLE 6.98 (극한 6.90)
  ✓  예제 4.4: 한 표본의 MLE 가 scipy.stats.gamma.fit 과 같고, 벡터화한 Newton 과도 같다
  ✓  연습 4.3: 적률법의 점근분산 2α(α+1) = 12 (n = 200, 1000 모두 5% 안)
  ✓  예제 4.4: MLE 의 n Var 7.3 (n=200) → 7.0 (n=1000) → 극한 6.90
  ✓  예제 4.4: 적률법의 효율 0.58 — 정보의 40% 를 버린다
📝 연습 4.1–4.3 (강의노트): Poisson의 Newton, 이차 수렴, 적률법의 분산.
5. 가능도로 검정하기 — Wilks, Wald, Rao
정의 5.1 , , · 정리 5.2 (Wilks) 셋 모두 , 차는 · 상자: 여러 모수의 Wilks, 와 · 예제 5.3 기병대의 세 검정.
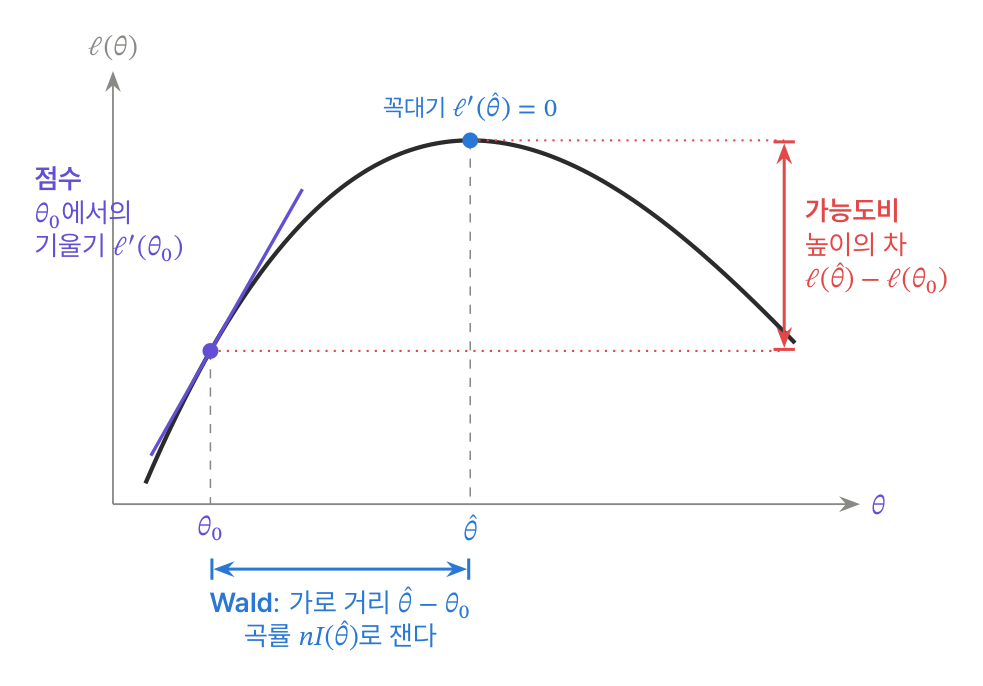
세 통계량을 한 클래스로 만들고, 같은 클래스로 구간(검정을 뒤집은 것)까지 구한다.
python
class LikelihoodTests:
    """정의 5.1: 1모수 모형의 가능도비 · Wald · 점수 통계량과, 그것을 뒤집은 구간 (8회 정리 3.5)"""
    def __init__(self, loglik, score, info, mle):
        self.ll, self.score, self.info, self.mle = loglik, score, info, mle   # info(θ) = n I(θ)

    def stats(self, t0):
        th = self.mle
        return {"Wald": self.info(th) * (th - t0) ** 2,
                "LR": 2 * (self.ll(th) - self.ll(t0)),
                "score": self.score(t0) ** 2 / self.info(t0)}

    def pvalues(self, t0):
        return {k: stats.chi2.sf(v, 1) for k, v in self.stats(t0).items()}

    def interval(self, kind, alpha=0.05, lo=1e-6, hi=None):
        crit = stats.chi2.ppf(1 - alpha, 1)
        hi = hi or 10 * self.mle
        f = lambda t: self.stats(t)[kind] - crit
        return optimize.brentq(f, lo, self.mle - 1e-12), optimize.brentq(f, self.mle + 1e-12, hi)

T, n = T_ALL, N_ALL
horse_tests = LikelihoodTests(loglik=lambda l: T * np.log(l) - n * l,
                              score=lambda l: T / l - n,
                              info=lambda l: n / l, mle=T / n)
tab = pd.DataFrame({"statistic": horse_tests.stats(0.61), "p": horse_tests.pvalues(0.61),
                    "CI": {k: horse_tests.interval(k) for k in ("Wald", "LR", "score")}})
print(tab.to_string(formatters={"statistic": "{:.2f}".format, "p": "{:.3f}".format, "CI": lambda c: f"[{c[0]:.3f}, {c[1]:.3f}]"}))
# 연습 5.1: 닫힌 꼴
xb, l0 = T / n, 0.61
closed = {"LR": 2 * n * (xb * math.log(xb / l0) - (xb - l0)), "Wald": n * (xb - l0) ** 2 / xb, "score": n * (xb - l0) ** 2 / l0}
# 연습 5.3: log λ 의 Wald 구간을 되돌리면
se_log = 1 / math.sqrt(n * xb)                                   # I*(log λ) = λ, 그래서 se = 1/√(nλ̂)
ci_log = (math.exp(math.log(xb) - 1.96 * se_log), math.exp(math.log(xb) + 1.96 * se_log))
# 가능도비 구간은 모수를 바꿔도 같은 구간 (log λ 로 다시 계산)
tests_log = LikelihoodTests(loglik=lambda e: T * e - n * np.exp(e), score=lambda e: T - n * np.exp(e),
                            info=lambda e: n * np.exp(e), mle=math.log(xb))
lr_log = tests_log.interval("LR", lo=-5, hi=2)
print(f"연습 5.3: log λ 의 Wald 를 되돌리면 [{ci_log[0]:.3f}, {ci_log[1]:.3f}];  log λ 척도의 LR 구간을 되돌리면 [{math.exp(lr_log[0]):.3f}, {math.exp(lr_log[1]):.3f}]")
report({"예제 5.3: Wald 3.24 (p .072), LR 3.55 (p .060), 점수 3.72 (p .054)":
            np.allclose([tab.statistic.Wald, tab.statistic.LR, tab.statistic.score], [3.24, 3.55, 3.72], atol=0.005)
            and np.allclose([tab.p.Wald, tab.p.LR, tab.p.score], [0.072, 0.060, 0.054], atol=5e-4),
        "예제 5.3: 구간 Wald [0.602, 0.798], LR [0.607, 0.803], 점수 [0.609, 0.805]":
            np.allclose(tab.CI.Wald, (0.602, 0.798), atol=5e-4) and np.allclose(tab.CI.LR, (0.607, 0.803), atol=5e-4) and np.allclose(tab.CI.score, (0.609, 0.805), atol=5e-4),
        "연습 5.1: 닫힌 꼴과 같다": all(abs(closed[k] - tab.statistic[k]) < 1e-10 for k in closed),
        "연습 5.3: log λ 의 Wald 를 되돌리면 [0.609, 0.805]": np.allclose(ci_log, (0.609, 0.805), atol=5e-4),
        "연습 5.3: 가능도비 구간은 모수를 바꿔도 정확히 같은 구간": np.allclose(np.exp(lr_log), tab.CI.LR, atol=1e-8)})
text
      statistic     p             CI
Wald       3.24 0.072 [0.602, 0.798]
LR         3.55 0.060 [0.607, 0.803]
score      3.72 0.054 [0.609, 0.805]
연습 5.3: log λ 의 Wald 를 되돌리면 [0.609, 0.805];  log λ 척도의 LR 구간을 되돌리면 [0.607, 0.803]
  ✓  예제 5.3: Wald 3.24 (p .072), LR 3.55 (p .060), 점수 3.72 (p .054)
  ✓  예제 5.3: 구간 Wald [0.602, 0.798], LR [0.607, 0.803], 점수 [0.609, 0.805]
  ✓  연습 5.1: 닫힌 꼴과 같다
  ✓  연습 5.3: log λ 의 Wald 를 되돌리면 [0.609, 0.805]
  ✓  연습 5.3: 가능도비 구간은 모수를 바꿔도 정확히 같은 구간
python
# 정리 5.2 · 연습 5.4: Wilks — Poisson(2), n = 50, 10만 번
n, l0, R = 50, 2.0, 100_000
lh = rng.poisson(l0, (R, n)).mean(1)
safe = np.where(lh > 0, lh, 1.0)
LR = 2 * n * (np.where(lh > 0, lh * np.log(safe / l0), 0.0) - (lh - l0))
Wd = np.where(lh > 0, n * (lh - l0) ** 2 / safe, np.inf)
Rs = n * (lh - l0) ** 2 / l0
print(f"평균: LR {LR.mean():.3f}, Wald {Wd.mean():.3f}, 점수 {Rs.mean():.3f};  P(Λ > 3.84) = {np.mean(LR > 3.841):.4f}")
print(f"세 통계량의 차: median |LR − W| = {np.median(np.abs(LR - Wd)):.4f}, median |LR − R| = {np.median(np.abs(LR - Rs)):.4f}")

# 그림 5.2: 정확한 크기 — ΣX ~ Poi(nλ0) 이므로 합으로
CRIT = stats.chi2.ppf(0.95, 1)
def exact_size(n, l0):
    t = np.arange(0, int(n * l0 + 20 * math.sqrt(n * l0) + 50)); p = stats.poisson.pmf(t, n * l0); xb = t / n
    safe = np.where(xb > 0, xb, 1.0)
    st = {"LR": 2 * n * (np.where(xb > 0, xb * np.log(safe / l0), 0.0) - (xb - l0)),
          "Wald": np.where(xb > 0, n * (xb - l0) ** 2 / safe, np.inf), "score": n * (xb - l0) ** 2 / l0}
    return {k: float(np.sum(p * (v > CRIT))) for k, v in st.items()}
ns = np.arange(5, 301)
sizes = pd.DataFrame([exact_size(m_, 0.7) for m_ in ns], index=ns)
print("λ0 = 0.7 의 정확한 크기:\n", sizes.loc[[10, 50, 280]].round(3).to_string())
# 연습 5.4 를 정확히: Poisson(2), n = 50 의 Λ 의 평균과 크기
t = np.arange(0, 400); pt = stats.poisson.pmf(t, 100); xt = t / 50
LRt = 2 * 50 * (np.where(xt > 0, xt * np.log(np.where(xt > 0, xt, 1) / 2.0), 0.0) - (xt - 2.0))
exact_mean, exact_sz = np.sum(pt * LRt), np.sum(pt * (LRt > CRIT))
print(f"연습 5.4 정확히: 평균 {exact_mean:.4f}, 크기 {exact_sz:.4f}  (시뮬레이션 {LR.mean():.4f}, {np.mean(LR > 3.841):.4f})")
report({"연습 5.4: 평균 1.002, 크기 0.0517 (정확한 계산), 시뮬레이션이 그 4 se 안": abs(exact_mean - 1.002) < 5e-4 and abs(exact_sz - 0.0517) < 5e-5
            and within(LR.mean(), exact_mean, LR.std() / math.sqrt(R)) and within(np.mean(LR > 3.841), exact_sz, math.sqrt(0.05 * 0.95 / R)),
        "정리 5.2: 세 통계량의 차는 작다 (중앙값 0.05 미만)": np.median(np.abs(LR - Wd)) < 0.05 and np.median(np.abs(LR - Rs)) < 0.05,
        "5.1절: n = 10 의 크기 LR 0.057, Wald 0.087, 점수 0.034": np.allclose(sizes.loc[10], [0.057, 0.087, 0.034], atol=5e-4),
        "5.1절: n = 280 의 크기 0.050, 0.051, 0.049": np.allclose(sizes.loc[280], [0.050, 0.051, 0.049], atol=5e-4)})

fig, axes = plt.subplots(1, 2, figsize=(12, 3.6))
q = np.linspace(0, 6, 400)
axes[0].hist(LR, bins=np.linspace(0, 6, 61), density=True, color=C["stat"], alpha=0.35, label="LR, Poisson(2), n = 50")
axes[0].plot(q[1:], stats.chi2.pdf(q[1:], 1), **THEORY, label="χ²(1)"); axes[0].set_ylim(0, 1.5)
axes[0].set_title("Wilks: 2[ℓ(θ̂) − ℓ(θ0)] ≈ χ²(1)"); axes[0].legend()
for k_, col in [("LR", C["key"]), ("Wald", C["stat"]), ("score", C["theta"])]:
    axes[1].plot(ns, sizes[k_], color=col, lw=1, label=k_)
axes[1].axhline(0.05, **THEORY); axes[1].set_ylim(0, 0.16); axes[1].set_xlabel("n")
axes[1].set_title("exact size at nominal 0.05, λ0 = 0.7"); axes[1].legend()
plt.tight_layout(); plt.show()
text
평균: LR 1.001, Wald 1.019, 점수 1.000;  P(Λ > 3.84) = 0.0526
세 통계량의 차: median |LR − W| = 0.0210, median |LR − R| = 0.0110
λ0 = 0.7 의 정확한 크기:
         LR   Wald  score
10   0.057  0.087  0.034
50   0.054  0.063  0.051
280  0.050  0.051  0.049
연습 5.4 정확히: 평균 1.0017, 크기 0.0517  (시뮬레이션 1.0009, 0.0526)
  ✓  연습 5.4: 평균 1.002, 크기 0.0517 (정확한 계산), 시뮬레이션이 그 4 se 안
  ✓  정리 5.2: 세 통계량의 차는 작다 (중앙값 0.05 미만)
  ✓  5.1절: n = 10 의 크기 LR 0.057, Wald 0.087, 점수 0.034
  ✓  5.1절: n = 280 의 크기 0.050, 0.051, 0.049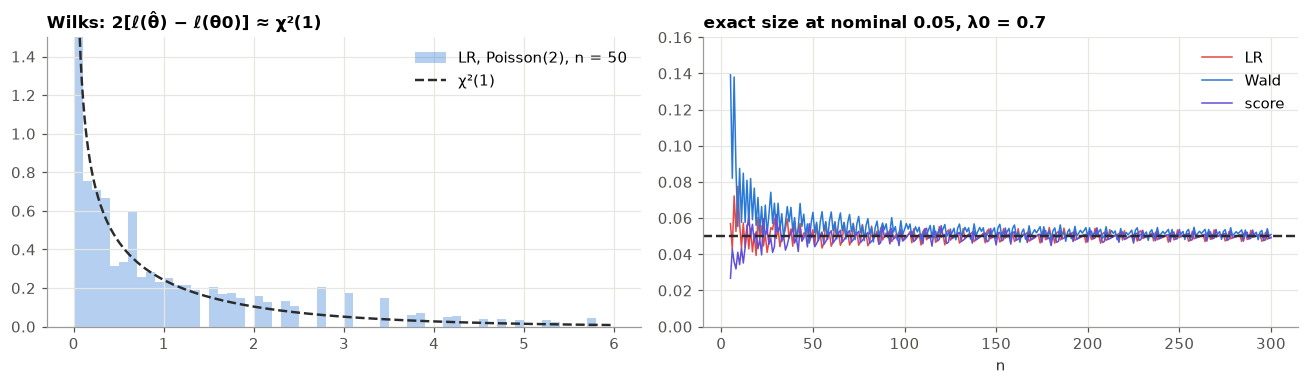
그림 읽기. 왼쪽: 가능도비 통계량의 히스토그램이 밀도(점선) 위에 놓인다. 오른쪽: 이산분포라서 크기가 톱니 모양이다. 작은 에서 Wald(파랑)는 0.05보다 크게 튀어 오르고 점수 검정(보라)은 보수적이다. 이 수백이면 셋이 모두 0.05 근처에 모인다.
python
# 5.1절의 상자 · 연습 5.2: 다항분포의 G 와 X², 점수 통계량은 정확히 X²
def multinomial_score_stat(N, p0):
    """자유 모수 p_1..p_{k−1} (p_k = 1 − 합) 로 쓴 점수 Uᵀ I⁻¹ U, H0 의 값 p0 에서"""
    N, p0 = np.asarray(N, float), np.asarray(p0, float); n = N.sum()
    U = N[:-1] / p0[:-1] - N[-1] / p0[-1]
    I = n * (np.diag(1 / p0[:-1]) + 1 / p0[-1])
    return float(U @ np.linalg.solve(I, U))

p0 = np.array([0.1, 0.2, 0.3, 0.4])
N = rng.multinomial(500, [0.12, 0.18, 0.31, 0.39])
E = 500 * p0
X2 = np.sum((N - E) ** 2 / E); G = 2 * np.sum(N * np.log(N / E)); Rsc = multinomial_score_stat(N, p0)
# 크기: H0 아래 G 와 X² 모두 χ²(3)
sims = rng.multinomial(500, p0, 50_000)
Gs = 2 * np.sum(np.where(sims > 0, sims * np.log(np.where(sims > 0, sims, 1) / E), 0), axis=1)
X2s = np.sum((sims - E) ** 2 / E, axis=1)
crit3 = stats.chi2.ppf(0.95, 3)
print(f"X² = {X2:.4f}, 점수 = {Rsc:.4f}, G = {G:.4f};  크기 (χ²(3) 기준): G {np.mean(Gs > crit3):.4f}, X² {np.mean(X2s > crit3):.4f}")
report({"연습 5.2: 점수 통계량은 정확히 Pearson 의 X²": abs(Rsc - X2) < 1e-9,
        "연습 5.2: G ≈ X² (차가 X² 의 5% 미만)": abs(G - X2) < 0.05 * X2,
        "상자: H0 아래 G, X² 의 크기 ≈ 0.05 (자유도 k − 1 = 3)": abs(np.mean(Gs > crit3) - 0.05) < 0.005 and abs(np.mean(X2s > crit3) - 0.05) < 0.005})
text
X² = 6.0817, 점수 = 6.0817, G = 5.9396;  크기 (χ²(3) 기준): G 0.0504, X² 0.0496
  ✓  연습 5.2: 점수 통계량은 정확히 Pearson 의 X²
  ✓  연습 5.2: G ≈ X² (차가 X² 의 5% 미만)
  ✓  상자: H0 아래 G, X² 의 크기 ≈ 0.05 (자유도 k − 1 = 3)
📝 연습 5.1–5.4 (강의노트): Poisson의 세 통계량, 통계량, 가능도비 구간의 불변성, Wilks의 시뮬레이션.
6. 데이터로 — 기병대, 빛의 속도, 그리고 "may"
예제 6.1 군단마다 다른 인가: · 예제 6.2 Michelson: 정밀하지만 정확하지 않다 · 예제 6.3 may의 음이항: 적률법 대 MLE, 경계의 가능도비.
python
# 예제 6.1 · 연습 6.1: 군단마다 다른 λ — G 와 X²
tot = vb.groupby("corps").deaths.sum(); years = vb.groupby("corps").size()
lam_hat = T_ALL / N_ALL
E_c = years * lam_hat
ll1 = np.sum(stats.poisson.logpmf(vb.deaths, vb.corps.map(tot / years)))       # H1: 군단마다 λ_c
ll0 = np.sum(stats.poisson.logpmf(vb.deaths, lam_hat))                          # H0: 하나의 λ
G_c = 2 * (ll1 - ll0)
G_formula = 2 * np.sum(np.where(tot > 0, tot * np.log(np.where(tot > 0, tot, 1) / E_c), 0))
X2_c = np.sum((tot - E_c) ** 2 / E_c)
df = len(tot) - 1
print(pd.DataFrame({"T_c": tot, "λ̂_c": tot / years}).T.round(2).to_string())
print(f"G = {G_c:.2f} (p = {stats.chi2.sf(G_c, df):.3f}),  X² = {X2_c:.2f} (p = {stats.chi2.sf(X2_c, df):.3f}),  자유도 {df}")
# 모수적 부트스트랩: H0 아래 G 의 분포가 χ²(13) 에 맞는가 (여러 모수의 Wilks)
Ts = rng.poisson(20 * lam_hat, (20_000, 14)); lh_b = Ts.sum(1, keepdims=True) / 280
Gb = 2 * np.sum(np.where(Ts > 0, Ts * np.log(np.where(Ts > 0, Ts, 1) / (20 * lh_b)), 0), axis=1)
print(f"H0 아래 G 의 평균 {Gb.mean():.2f} (χ²(13) 의 평균 13), 부트스트랩 p = {np.mean(Gb >= G_c):.3f}")
report({"예제 6.1: G = 26.1, p = 0.016": abs(G_c - 26.1) < 0.05 and abs(stats.chi2.sf(G_c, 13) - 0.016) < 5e-4,
        "예제 6.1: Pearson X² = 27.3, p = 0.011": abs(X2_c - 27.3) < 0.05 and abs(stats.chi2.sf(X2_c, 13) - 0.011) < 5e-4,
        "연습 6.1: G = 2 Σ T_c log(T_c/(20λ̂)) — 로그가능도의 차와 같다": abs(G_c - G_formula) < 1e-9,
        "상자 (여러 모수의 Wilks): H0 아래 G 의 평균 ≈ 13": abs(Gb.mean() - 13) < 0.3})
text
corps     G     I    II   III   IV     IX      V     VI   VII  VIII      X     XI   XIV   XV
T_c    16.0  16.0  12.0  12.0  8.0  13.00  11.00  17.00  12.0  7.00  15.00  25.00  24.0  8.0
λ̂_c    0.8   0.8   0.6   0.6  0.4   0.65   0.55   0.85   0.6  0.35   0.75   1.25   1.2  0.4
G = 26.14 (p = 0.016),  X² = 27.29 (p = 0.011),  자유도 13
H0 아래 G 의 평균 13.17 (χ²(13) 의 평균 13), 부트스트랩 p = 0.017
  ✓  예제 6.1: G = 26.1, p = 0.016
  ✓  예제 6.1: Pearson X² = 27.3, p = 0.011
  ✓  연습 6.1: G = 2 Σ T_c log(T_c/(20λ̂)) — 로그가능도의 차와 같다
  ✓  상자 (여러 모수의 Wilks): H0 아래 G 의 평균 ≈ 13
python
# 예제 6.2 · 그림 6.1: Michelson 1879
v = load_rdata("Michelson").velocity.to_numpy(float)
n = len(v); mh, sh = v.mean(), v.std()                   # MLE: n 으로 나눈다
half = sh * math.sqrt(math.exp(stats.chi2.ppf(0.95, 1) / n) - 1)    # n log(1 + (x̄−μ)²/σ̂²) = 3.84 의 근
lr_ci = (mh - half, mh + half)
t_ci = stats.t.interval(0.95, n - 1, mh, v.std(ddof=1) / math.sqrt(n))
z_true = (mh - 734.5) / (v.std(ddof=1) / math.sqrt(n))
print(f"n = {n}, μ̂ = {mh:.1f}, σ̂ = {sh:.1f};  LR 구간 [{lr_ci[0]:.1f}, {lr_ci[1]:.1f}],  t-구간 [{t_ci[0]:.1f}, {t_ci[1]:.1f}];  (μ̂ − 734.5)/se = {z_true:.1f}")
print(f"최솟값 {v.min():.0f}, 최댓값 {v.max():.0f}, 중앙값 {np.median(v):.0f}")

# 연습 6.2: t(4) 위치–척도 MLE — 큰 잔차의 무게를 줄인다 (6회 8.4절)
nll_t = lambda par: -np.sum(stats.t.logpdf(v, 4, par[0], math.exp(par[1])))
res = optimize.minimize(nll_t, [np.median(v), math.log(sh)], method="Nelder-Mead", options=dict(xatol=1e-8, fatol=1e-10, maxiter=4000))
loc_t, scale_t = res.x[0], math.exp(res.x[1])
r = (v - loc_t) / scale_t; w = 5 / (4 + r**2)              # 가중치 (ν + 1)/(ν + r²)
print(f"t(4) MLE: 위치 {loc_t:.1f}, 척도 {scale_t:.1f};  가장 작은 무게 {w.min():.2f} (관측 {v[w.argmin()]:.0f})")
report({"예제 6.2: μ̂ = 852.4, σ̂ = 78.6": abs(mh - 852.4) < 0.05 and abs(sh - 78.6) < 0.05,
        "예제 6.2: LR 구간 [836.8, 868.0], t-구간 [836.7, 868.1]": np.allclose(lr_ci, (836.8, 868.0), atol=0.05) and np.allclose(t_ci, (836.7, 868.1), atol=0.05),
        "예제 6.2: 오늘의 값 734.5 는 14.9 표준오차 밖": abs(z_true - 14.9) < 0.05,
        "연습 6.2: t(4) MLE 위치 850.9, 척도 63.9 — 정규 평균과 1.5 차이": abs(loc_t - 850.9) < 0.05 and abs(scale_t - 63.9) < 0.05 and abs(mh - loc_t - 1.5) < 0.1,
        "연습 6.2: 자료의 범위 620–1070, 중앙값 850, 620 의 무게 0.29": v.min() == 620 and v.max() == 1070 and np.median(v) == 850 and abs(w.min() - 0.29) < 0.005})

fig, axes = plt.subplots(1, 2, figsize=(12, 3.6))
axes[0].hist(v, bins=np.arange(600, 1100, 25), density=True, color=C["data"], alpha=0.35, edgecolor="white")
xx = np.linspace(600, 1100, 300)
axes[0].plot(xx, stats.norm.pdf(xx, mh, sh), color=C["stat"], label="normal MLE")
axes[0].plot(xx, stats.t.pdf(xx, 4, loc_t, scale_t), color=C["theta"], lw=1.4, label="t(4) MLE")
axes[0].axvline(734.5, color=C["key"], label="today's value 734.5"); axes[0].legend(fontsize=8)
axes[0].set_xlabel("km/s − 299,000"); axes[0].set_title("Michelson 1879")
mus = np.linspace(720, 890, 600)
axes[1].plot(mus, -n / 2 * np.log(1 + (mh - mus) ** 2 / sh**2), color=C["ink"])
axes[1].plot(lr_ci, [-1.92, -1.92], color=C["stat"], lw=4, label="95% LR interval")
axes[1].plot(734.5, -n / 2 * math.log(1 + (mh - 734.5) ** 2 / sh**2), "o", color=C["key"], label="734.5")
axes[1].set_xlabel("μ"); axes[1].set_title("profile log-likelihood ℓp(μ) − ℓp(μ̂)"); axes[1].legend(fontsize=8)
plt.tight_layout(); plt.show()
text
n = 100, μ̂ = 852.4, σ̂ = 78.6;  LR 구간 [836.8, 868.0],  t-구간 [836.7, 868.1];  (μ̂ − 734.5)/se = 14.9
최솟값 620, 최댓값 1070, 중앙값 850
t(4) MLE: 위치 850.9, 척도 63.9;  가장 작은 무게 0.29 (관측 620)
  ✓  예제 6.2: μ̂ = 852.4, σ̂ = 78.6
  ✓  예제 6.2: LR 구간 [836.8, 868.0], t-구간 [836.7, 868.1]
  ✓  예제 6.2: 오늘의 값 734.5 는 14.9 표준오차 밖
  ✓  연습 6.2: t(4) MLE 위치 850.9, 척도 63.9 — 정규 평균과 1.5 차이
  ✓  연습 6.2: 자료의 범위 620–1070, 중앙값 850, 620 의 무게 0.29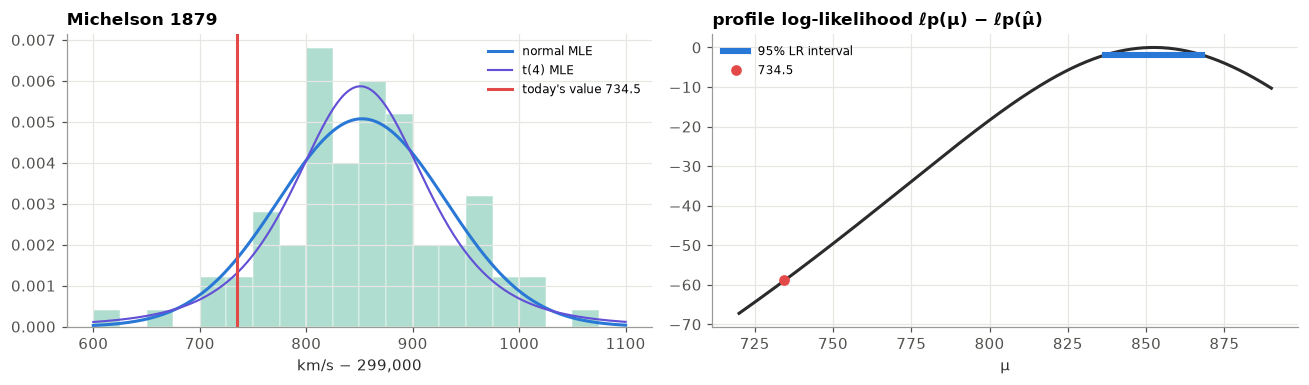
그림 읽기. 정규 적합(파랑)과 적합(보라)은 거의 같은 자리에 있고, 둘 다 오늘의 값(빨강)에서 멀다. 오른쪽의 프로파일 로그가능도는 734.5에서 꼭대기보다 59나 낮다. 가능도는 "모형이 맞다면"의 불확실성만 재므로, 모든 측정에 같은 방향으로 들어간 계통 오차는 보지 못한다.
python
# 예제 6.3: The Federalist 의 may — 음이항, 적률법 대 MLE, 그리고 경계의 가능도비
fe = load_rdata("Federalist", "vcd")
k = fe.nMay.to_numpy(); f = fe.Freq.to_numpy(); N = f.sum()
xb = np.sum(k * f) / N; s2 = np.sum((k - xb) ** 2 * f) / (N - 1)
p_mm = xb / s2; r_mm = xb * p_mm / (1 - p_mm)
def nll_nb(par):
    r_, p_ = math.exp(par[0]), special.expit(par[1])
    return -np.sum(f * stats.nbinom.logpmf(k, r_, p_))
res = optimize.minimize(nll_nb, [math.log(r_mm), special.logit(p_mm)], method="Nelder-Mead", options=dict(xatol=1e-10, fatol=1e-12, maxiter=5000))
r_ml, p_ml = math.exp(res.x[0]), special.expit(res.x[1])
mean_ml = r_ml * (1 - p_ml) / p_ml
LR_nb = 2 * (-res.fun - np.sum(f * stats.poisson.logpmf(k, xb)))
fit = pd.DataFrame({"observed": f, "Poisson": N * stats.poisson.pmf(k, xb),
                    "NB (MoM)": N * stats.nbinom.pmf(k, r_mm, p_mm), "NB (MLE)": N * stats.nbinom.pmf(k, r_ml, p_ml)}, index=k)
print(fit.round(1).to_string())
print(f"적률법 r = {r_mm:.2f}, p = {p_mm:.3f};  MLE r = {r_ml:.2f}, p = {p_ml:.3f};  평균 {mean_ml:.3f} = x̄ {xb:.3f};  2[ℓ_NB − ℓ_Poi] = {LR_nb:.1f}")

# 연습 6.3: 경계의 가능도비 — N(μ, 1), H0: μ = 0 대 μ ≥ 0
n_b = 30
xbar_b = rng.normal(0, 1 / math.sqrt(n_b), N_SIM)
Lb = n_b * xbar_b**2 * (xbar_b > 0)
print(f"P(Λ = 0) = {np.mean(Lb == 0):.3f};  P(Λ > 2.71) = {np.mean(Lb > 2.706):.4f} (반반 혼합의 5% 임계값),  P(Λ > 3.84) = {np.mean(Lb > 3.841):.4f}")
report({"예제 6.3: 적률법 r = 1.23, p = 0.651": abs(r_mm - 1.23) < 0.005 and abs(p_mm - 0.651) < 5e-4,
        "예제 6.3: MLE r = 1.19, p = 0.644, 평균은 두 방법 모두 x̄ = 0.656": abs(r_ml - 1.19) < 0.005 and abs(p_ml - 0.644) < 5e-4 and abs(mean_ml - xb) < 1e-5 and abs(xb - 0.656) < 5e-4,
        "예제 6.3: 262 조각, 음이항 대 Poisson 의 가능도비 23.3": N == 262 and abs(LR_nb - 23.3) < 0.05,
        "연습 6.3: 경계에서 Λ ~ ½χ²₀ + ½χ²₁ — P(Λ=0) ≈ ½, χ²₁ 의 3.84 를 쓰면 크기 0.025": within(np.mean(Lb == 0), 0.5, 0.5 / math.sqrt(N_SIM)) and within(np.mean(Lb > 3.841), 0.025, math.sqrt(0.025 * 0.975 / N_SIM)),
        "연습 6.3: 반반 혼합의 5% 임계값은 2.71": within(np.mean(Lb > 2.706), 0.05, math.sqrt(0.05 * 0.95 / N_SIM))})
text
   observed  Poisson  NB (MoM)  NB (MLE)
0       156    135.9     154.9     155.4
1        63     89.2      66.2      65.7
2        29     29.3      25.7      25.6
3         8      6.4       9.6       9.7
4         4      1.1       3.6       3.6
5         1      0.1       1.3       1.3
6         1      0.0       0.5       0.5
적률법 r = 1.23, p = 0.651;  MLE r = 1.19, p = 0.644;  평균 0.656 = x̄ 0.656;  2[ℓ_NB − ℓ_Poi] = 23.3
P(Λ = 0) = 0.499;  P(Λ > 2.71) = 0.0502 (반반 혼합의 5% 임계값),  P(Λ > 3.84) = 0.0252
  ✓  예제 6.3: 적률법 r = 1.23, p = 0.651
  ✓  예제 6.3: MLE r = 1.19, p = 0.644, 평균은 두 방법 모두 x̄ = 0.656
  ✓  예제 6.3: 262 조각, 음이항 대 Poisson 의 가능도비 23.3
  ✓  연습 6.3: 경계에서 Λ ~ ½χ²₀ + ½χ²₁ — P(Λ=0) ≈ ½, χ²₁ 의 3.84 를 쓰면 크기 0.025
  ✓  연습 6.3: 반반 혼합의 5% 임계값은 2.71
표 읽기. Poisson은 0을 너무 적게, 3 이상을 너무 적게 예측한다. 음이항은 두 끝을 모두 맞춘다. 적률법과 MLE의 차이는 작고, MLE는 평균을 정확히 에 맞춘다(평균에 대한 가능도 방정식이 를 준다). 귀무가설()이 경계에 있으므로 의 임계값 3.84를 그대로 쓰면 보수적이다. 반반 혼합의 임계값은 2.71이다(연습 6.3). 어느 쪽이든 23.3은 압도적이다.
📝 연습 6.1–6.3 (강의노트): 군단의 가능도비, Michelson의 -모형, 경계에서의 가능도비.
7. 부숴보기 — 초효율과 너무 많은 모수
예제 7.1 Hodges(1951): 에서만 MLE를 이기는 추정량 · 7.2절: 받침이 모수에 의존하면 속도가 · 예제 7.2 Neyman–Scott(1948): 모수가 자료와 함께 늘면 MLE가 일치하지 않는다.
Hodges 추정량 의 위험은 정규분포의 절단 적률로 정확히 계산된다. , , 이면
python
def hodges_risk(theta, n):
    """예제 7.1: 정규화한 위험 n E(T_n − θ)² — 정확한 식"""
    c = n ** -0.25
    a, b = np.sqrt(n) * (-c - theta), np.sqrt(n) * (c - theta)
    inside = stats.norm.cdf(b) - stats.norm.cdf(a)
    trunc = inside - (b * stats.norm.pdf(b) - a * stats.norm.pdf(a))
    return 1 - trunc + n * theta**2 * inside

def hodges_sim(theta, n, R=400_000):
    xb = rng.normal(theta, 1 / math.sqrt(n), R)
    T = np.where(np.abs(xb) >= n ** -0.25, xb, 0.0)
    return n * np.mean((T - theta) ** 2)

th = np.linspace(0, 0.6, 60_001)
peak = {n: (hodges_risk(th, n).max(), th[hodges_risk(th, n).argmax()]) for n in (100, 10_000)}
print({n: f"최대 위험 {v:.2f} at θ = {t:.3f}" for n, (v, t) in peak.items()}, f"; θ = 0 에서 (n=100) {hodges_risk(0.0, 100):.4f}")
sim_ok = all(abs(hodges_sim(t_, 100) / hodges_risk(t_, 100) - 1) < 0.02 for t_ in (0.0, 0.1, 0.3, 0.5))
# 연습 7.1: θ = 0 이면 E[Z²; |Z| ≥ n^{1/4}] = 2[c φ(c) + 1 − Φ(c)] (c = n^{1/4}) → 0
tail = lambda n: 2 * (n**0.25 * stats.norm.pdf(n**0.25) + stats.norm.sf(n**0.25))
# 연습 7.1: θ_n = c n^{-1/4} (c = 0.5) 이면 위험 ≈ c²√n → ∞
grow = {n: hodges_risk(0.5 * n ** -0.25, n) / (0.25 * math.sqrt(n)) for n in (1e2, 1e4, 1e6, 1e8)}
print("위험 / (c²√n):", {f"{int(n):.0e}": round(float(v), 3) for n, v in grow.items()})
report({"예제 7.1: 최대 위험 5.6 (n = 100), 69 (n = 10⁴)": abs(peak[100][0] - 5.6) < 0.05 and abs(peak[10_000][0] - 68.9) < 0.05,
        "예제 7.1: θ = 0 에서 위험 0.019 (n = 100) — MLE 의 1 보다 훨씬 작다": abs(hodges_risk(0.0, 100) - 0.0186) < 1e-4,
        "예제 7.1: 정확한 식 = 시뮬레이션 (θ = 0, 0.1, 0.3, 0.5; 2% 안)": sim_ok,
        "연습 7.1: θ = 0 의 위험 = E[Z²; |Z| ≥ n^{1/4}] → 0": all(abs(tail(n) - hodges_risk(0.0, n)) < 1e-12 for n in (16, 100, 1e4)) and tail(1e4) < 1e-20,
        "연습 7.1: θ_n = c n^{-1/4} 이면 위험 / (c²√n) → 1, 곧 위험 → ∞": abs(grow[1e8] - 1) < 0.01})

fig, ax = plt.subplots(figsize=(10, 3.6))
thf = np.linspace(-0.6, 0.6, 4001)
for n, col in [(100, C["stat"]), (10_000, C["key"])]:
    ax.plot(thf, hodges_risk(thf, n), color=col, lw=1.4, label=f"Hodges, n = {n:,}")
    ax.axvline(n ** -0.25, color=col, lw=0.7, ls=":")
ax.axhline(1, **THEORY, label="MLE x̄"); ax.set_yscale("log"); ax.set_ylim(0.01, 150)
ax.set_xlabel("θ"); ax.set_ylabel("n E(T − θ)²"); ax.set_title("superefficiency at one point, a price near it"); ax.legend()
plt.tight_layout(); plt.show()
text
{100: '최대 위험 5.58 at θ = 0.297', 10000: '최대 위험 68.89 at θ = 0.088'} ; θ = 0 에서 (n=100) 0.0186
위험 / (c²√n): {'1e+02': 1.038, '1e+04': 1.0, '1e+06': 1.0, '1e+08': 1.0}
  ✓  예제 7.1: 최대 위험 5.6 (n = 100), 69 (n = 10⁴)
  ✓  예제 7.1: θ = 0 에서 위험 0.019 (n = 100) — MLE 의 1 보다 훨씬 작다
  ✓  예제 7.1: 정확한 식 = 시뮬레이션 (θ = 0, 0.1, 0.3, 0.5; 2% 안)
  ✓  연습 7.1: θ = 0 의 위험 = E[Z²; |Z| ≥ n^{1/4}] → 0
  ✓  연습 7.1: θ_n = c n^{-1/4} 이면 위험 / (c²√n) → 1, 곧 위험 → ∞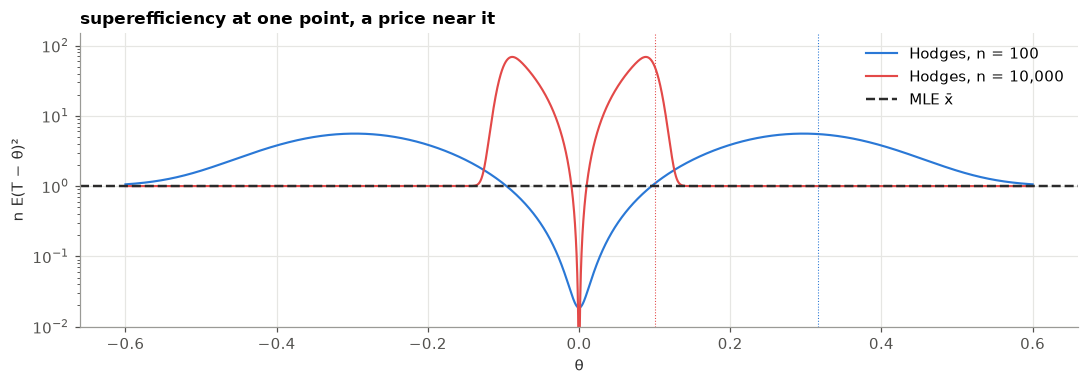
그림 읽기. 0에서는 Hodges 추정량의 위험이 MLE의 1보다 훨씬 작지만, (점선) 근처에서는 크게 진다. 표본이 커질수록 이기는 곳은 좁아지고 지는 봉우리는 높아진다. "모든 를 함께 보면" MLE를 이길 수 없다는 Le Cam–Hájek 이론의 그림이다.
python
# 7.2절 · 연습 7.2: 균등분포의 MLE 는 1/n 의 속도 — n(θ − X_(n)) → Exp(평균 θ)
theta = 3.0
res = {}
for n in (10, 100, 1000):
    M = rng.uniform(0, theta, (50_000, n)).max(1)
    res[n] = (np.mean(n * (theta - M)), stats.kstest(n * (theta - M), stats.expon(scale=theta).cdf).statistic,
              np.mean((n + 1) / n * M))
print(pd.DataFrame(res, index=["mean of n(θ − X_(n))", "KS distance to Exp(θ)", "mean of (n+1)/n·X_(n)"]).round(4).to_string())
# 예제 7.2 · 연습 7.3: Neyman–Scott — 두 번씩 잰 n 명
sigma2 = 4.0
ns_res = {}
for n in (10, 100, 10_000):
    mu_i = rng.normal(0, 10, n)
    Xp = mu_i[:, None] + rng.normal(0, math.sqrt(sigma2), (n, 2))
    D = Xp[:, 0] - Xp[:, 1]
    ns_res[n] = (np.sum(D**2) / (4 * n), np.sum(D**2) / (2 * n))
print("Neyman–Scott (σ² = 4):", {n: f"MLE {a:.3f}, 차의 가능도 {b:.3f}" for n, (a, b) in ns_res.items()})
report({"7.2절: n(θ − X_(n)) 의 평균 → θ = 3, 분포 → Exp (KS < 0.01 at n = 1000)": abs(res[1000][0] - theta) < 0.05 and res[1000][1] < 0.01,
        "연습 7.2: (n+1)/n·X_(n) 은 불편": all(abs(r_[2] - theta) < 0.01 for r_ in res.values()),
        "예제 7.2: MLE σ̂² → σ²/2 = 2 (n = 10⁴)": abs(ns_res[10_000][0] - sigma2 / 2) < 0.1,
        "연습 7.3: 차 D_i 의 가능도로 만든 (1/2n)ΣD² → σ² = 4": abs(ns_res[10_000][1] - sigma2) < 0.2})
text
                         10      100     1000
mean of n(θ − X_(n))   2.7187  2.9609  3.0028
KS distance to Exp(θ)  0.0308  0.0059  0.0035
mean of (n+1)/n·X_(n)  3.0009  3.0001  3.0000
Neyman–Scott (σ² = 4): {10: 'MLE 2.516, 차의 가능도 5.032', 100: 'MLE 2.053, 차의 가능도 4.106', 10000: 'MLE 1.994, 차의 가능도 3.988'}
  ✓  7.2절: n(θ − X_(n)) 의 평균 → θ = 3, 분포 → Exp (KS < 0.01 at n = 1000)
  ✓  연습 7.2: (n+1)/n·X_(n) 은 불편
  ✓  예제 7.2: MLE σ̂² → σ²/2 = 2 (n = 10⁴)
  ✓  연습 7.3: 차 D_i 의 가능도로 만든 (1/2n)ΣD² → σ² = 4
📝 연습 7.1–7.3 (강의노트): Hodges의 위험, 균등분포의 MLE의 속도, Neyman–Scott의 고침.
8. Beautiful insights — 손실함수 속의 가능도
8.1절 교차엔트로피 = 음의 로그가능도, MLE는 KL로 가장 가까운 모형 · 8.2절 , 자연기울기, EWC · 8.3절 온도 하나의 MLE — 신경망의 보정.
python
# 8.1절: 교차엔트로피 손실 = 범주형 모형의 음의 로그가능도
def softmax(z):
    z = z - z.max(axis=-1, keepdims=True)
    e = np.exp(z)
    return e / e.sum(axis=-1, keepdims=True)

def cross_entropy(logits, y):
    """딥러닝 라이브러리의 cross-entropy 손실과 같은 식: −log softmax(z)_y 의 합"""
    z = logits - logits.max(axis=1, keepdims=True)
    return float(np.sum(np.log(np.exp(z).sum(1)) - z[np.arange(len(y)), y]))

n, K, d = 600, 3, 2
Xf = rng.normal(0, 1, (n, d)); W_true = np.array([[2.0, -1.0, 0.0], [0.5, 1.5, -2.0]])
y = np.array([rng.choice(K, p=p_) for p_ in softmax(Xf @ W_true)])
nll_multinomial = lambda W: -sum(stats.multinomial.logpmf(np.eye(K)[y_i], 1, p_i) for y_i, p_i in zip(y, softmax(Xf @ W)))
W0 = rng.normal(0, 1, (d, K))
# 교차엔트로피를 최소화 (= MLE). 마지막 범주의 가중치는 0 으로 고정해 식별가능하게 한다
fitW = lambda w: np.column_stack([w.reshape(d, K - 1), np.zeros(d)])
res = optimize.minimize(lambda w: cross_entropy(Xf @ fitW(w), y), np.zeros(d * (K - 1)), method="BFGS")
W_hat = fitW(res.x)
print(f"cross-entropy {cross_entropy(Xf @ W0, y):.6f} = −ℓ (scipy.stats.multinomial) {nll_multinomial(W0):.6f}")
print("W_true − (마지막 열):\n", (W_true - W_true[:, -1:]).round(2), "\nW_hat:\n", W_hat.round(2))
# 연습 8.2: 정규 오차의 MLE = 최소제곱
xr = np.linspace(-2, 2, 80); yr = 1 + 0.5 * xr - 0.8 * xr**2 + rng.normal(0, 0.3, 80)
nll_norm = lambda par: -np.sum(stats.norm.logpdf(yr, np.polyval(par[:3], xr), math.exp(par[3])))
mle_par = optimize.minimize(nll_norm, [0, 0, 0, 0], method="BFGS").x
ls = np.polyfit(xr, yr, 2); rss = np.sum((yr - np.polyval(ls, xr)) ** 2)
report({"8.1절: 교차엔트로피 = 범주형(다항, n=1) 모형의 음의 로그가능도": abs(cross_entropy(Xf @ W0, y) - nll_multinomial(W0)) < 1e-8,
        "8.1절: 교차엔트로피 최소화로 얻은 W 가 참값 근처 (식별가능한 차이로, 0.5 안)": np.abs(W_hat - (W_true - W_true[:, -1:])).max() < 0.5,
        "연습 8.2: 정규 MLE 의 계수 = np.polyfit (최소제곱), σ̂² = RSS/n": np.allclose(mle_par[:3], ls, atol=1e-4) and abs(math.exp(2 * mle_par[3]) - rss / 80) < 1e-4})
text
cross-entropy 801.545319 = −ℓ (scipy.stats.multinomial) 801.545319
W_true − (마지막 열):
 [[ 2.  -1.   0. ]
 [ 2.5  3.5  0. ]]
W_hat:
 [[ 1.62 -1.31  0.  ]
 [ 2.59  3.7   0.  ]]
  ✓  8.1절: 교차엔트로피 = 범주형(다항, n=1) 모형의 음의 로그가능도
  ✓  8.1절: 교차엔트로피 최소화로 얻은 W 가 참값 근처 (식별가능한 차이로, 0.5 안)
  ✓  연습 8.2: 정규 MLE 의 계수 = np.polyfit (최소제곱), σ̂² = RSS/n
python
# 8.2절 · 연습 8.1: KL 은 국소적으로 ½ I δ²
kl_pois = lambda l, l2: l * math.log(l / l2) - l + l2
kl_bern = lambda p, q: p * math.log(p / q) + (1 - p) * math.log((1 - p) / (1 - q))
for delta in (0.1, 0.01, 0.001):
    print(f"δ = {delta}: Poisson D/(δ²/2) = {kl_pois(0.7, 0.7 + delta) / (delta**2 / 2):.4f} (I = {1 / 0.7:.4f}),  "
          f"Bernoulli D/(δ²/2) = {kl_bern(0.3, 0.3 + delta) / (delta**2 / 2):.4f} (I = {1 / 0.21:.4f})")

# 8.2절: 자연기울기는 모수화에 무관하다 — Bernoulli(k = 7, n = 10), p 와 로그 오즈 η 두 가지로
k, n, steps, h = 7, 10, 4000, 1e-3
score_p = lambda p: k / p - (n - k) / (1 - p)
def flow(kind, param):
    """연속시간 상승을 작은 걸음으로: 보통 기울기 또는 자연기울기 (정보의 역행렬을 곱한다)"""
    p = 0.05; path = [p]
    for _ in range(steps):
        if param == "p":
            g = score_p(p); I = n / (p * (1 - p))
            p = p + h * (g if kind == "plain" else g / I)
        else:                                            # η = logit p, dℓ/dη = ℓ'(p)·p(1−p), I*(η) = n p(1−p)
            eta = special.logit(p); g = score_p(p) * p * (1 - p); I = n * p * (1 - p)
            p = special.expit(eta + h * (g if kind == "plain" else g / I))
        path.append(p)
    return np.array(path)
paths = {(kd, pr): flow(kd, pr) for kd in ("plain", "natural") for pr in ("p", "eta")}
gap_plain = np.abs(paths[("plain", "p")] - paths[("plain", "eta")]).max()
gap_nat = np.abs(paths[("natural", "p")] - paths[("natural", "eta")]).max()
print(f"같은 시각의 p 의 최대 차이 — 보통 기울기 {gap_plain:.3f}, 자연기울기 {gap_nat:.5f}")
report({"연습 8.1: D(λ‖λ+δ) / (δ²/2) → I(λ) = 1/λ (δ = 0.001 에서 0.2% 안)": abs(kl_pois(0.7, 0.701) / (0.001**2 / 2) * 0.7 - 1) < 2e-3,
        "8.2절: Bernoulli 도 D / (δ²/2) → 1/(p(1−p))": abs(kl_bern(0.3, 0.301) / (0.001**2 / 2) * 0.21 - 1) < 3e-3,
        "8.2절: 자연기울기의 경로는 모수화에 무관 (차이 < 0.005), 보통 기울기는 크게 다르다 (> 0.1)": gap_nat < 0.005 and gap_plain > 0.1})

fig, ax = plt.subplots(figsize=(9, 3.4))
tt = np.arange(steps + 1) * h
for (kd, pr), col, ls_ in [(("plain", "p"), C["stat"], "-"), (("plain", "eta"), C["stat"], "--"),
                           (("natural", "p"), C["key"], "-"), (("natural", "eta"), C["key"], ":")]:
    ax.plot(tt, paths[(kd, pr)], color=col, ls=ls_, lw=1.6, label=f"{kd} gradient in {'p' if pr == 'p' else 'log-odds'}")
ax.axhline(0.7, **THEORY); ax.set_xlabel("time"); ax.set_ylabel("p"); ax.set_title("same model, two parametrizations")
ax.legend(fontsize=8); plt.tight_layout(); plt.show()
text
δ = 0.1: Poisson D/(δ²/2) = 1.3056 (I = 1.4286),  Bernoulli D/(δ²/2) = 4.3202 (I = 4.7619)
δ = 0.01: Poisson D/(δ²/2) = 1.4151 (I = 1.4286),  Bernoulli D/(δ²/2) = 4.7034 (I = 4.7619)
δ = 0.001: Poisson D/(δ²/2) = 1.4272 (I = 1.4286),  Bernoulli D/(δ²/2) = 4.7559 (I = 4.7619)
같은 시각의 p 의 최대 차이 — 보통 기울기 0.606, 자연기울기 0.00031
  ✓  연습 8.1: D(λ‖λ+δ) / (δ²/2) → I(λ) = 1/λ (δ = 0.001 에서 0.2% 안)
  ✓  8.2절: Bernoulli 도 D / (δ²/2) → 1/(p(1−p))
  ✓  8.2절: 자연기울기의 경로는 모수화에 무관 (차이 < 0.005), 보통 기울기는 크게 다르다 (> 0.1)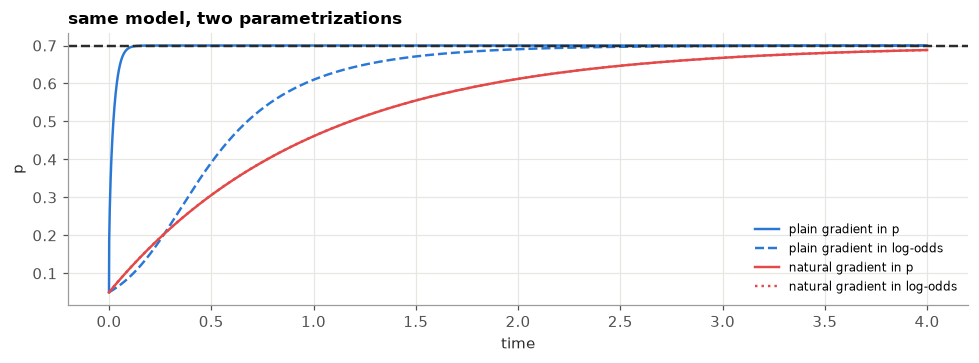
그림 읽기. 보통 기울기(파랑)는 로 올라가느냐 로그 오즈로 올라가느냐에 따라 전혀 다른 속도로 MLE 0.7에 다가간다. 자연기울기(빨강)는 두 경로가 겹친다. 기울기에 정보의 역행렬을 곱하면 "모수공간의 거리"가 아니라 "분포 사이의 거리(KL)"로 걸음을 재기 때문이다. 4절의 Fisher 채점이 걸음 크기 1의 자연기울기다.
python
# 8.2절: EWC — 과제 A 의 가능도를 Fisher 정보로 만든 이차 벌점으로 기억한다 (Poisson 의 예)
TA, nA = rng.poisson(0.7, 200).sum(), 200          # 과제 A
TB, nB = rng.poisson(1.0, 100).sum(), 100          # 과제 B
lamA = TA / nA; F_A = nA / lamA                    # 과제 A 의 MLE 와 관측 정보
joint = (TA + TB) / (nA + nB)                      # 두 과제를 함께 본 MLE
only_B = TB / nB                                   # B 만 배우면 A 를 \"잊는다\"
ewc = optimize.minimize_scalar(lambda l: -(TB * math.log(l) - nB * l) + 0.5 * F_A * (l - lamA) ** 2, bounds=(0.05, 3), method="bounded").x
print(f"A 만 {lamA:.4f},  B 만 {only_B:.4f},  A∪B 의 MLE {joint:.4f},  EWC (B + ½F_A(λ−λ̂_A)²) {ewc:.4f}")
report({"8.2절: EWC 는 함께 학습한 MLE 에 가깝고 (차 < 0.01), B 만 배운 것은 멀다": abs(ewc - joint) < 0.01 and abs(only_B - joint) > 0.05})
text
A 만 0.7350,  B 만 1.0700,  A∪B 의 MLE 0.8467,  EWC (B + ½F_A(λ−λ̂_A)²) 0.8372
  ✓  8.2절: EWC 는 함께 학습한 MLE 에 가깝고 (차 < 0.01), B 만 배운 것은 멀다
python
# 8.3절 · 연습 8.3: 온도 보정 — 확신이 지나친 분류기의 logit 을 T 로 나눈다
class TemperatureScaler:
    """검증 자료의 음의 로그가능도를 최소화하는 T. a = 1/T 로 쓰면 ℓ(a) 가 오목이어서 극대점이 하나뿐이다.
    그래도 Newton 걸음은 넘칠 수 있으므로(a = 1 에서 출발하면 음수로 튕긴다) ℓ 이 늘 때까지 걸음을 반으로 줄인다"""
    def fit(self, logits, y, iters=100, tol=1e-12):
        zy = logits[np.arange(len(y)), y]
        ll = lambda a: np.sum(a * zy - special.logsumexp(a * logits, axis=1))
        a = 1.0
        for _ in range(iters):
            p = softmax(a * logits)
            Ez = np.sum(p * logits, axis=1)
            score = np.sum(zy - Ez)                               # ℓ'(a) — 0 이면 연습 8.3 의 방정식
            curv = -np.sum(np.sum(p * logits**2, axis=1) - Ez**2)  # ℓ''(a) = −Σ Var_p(z) < 0
            step = -score / curv
            while a + step <= 0 or ll(a + step) < ll(a):
                step /= 2
            a += step
            if abs(step) < tol:
                break
        self.T = 1 / a
        return self

    def predict_proba(self, logits):
        return softmax(logits / self.T)

def ece(prob, y, bins=15):
    """expected calibration error: 최대 확률의 구간별 |정답률 − 평균 확신|"""
    conf, pred = prob.max(1), prob.argmax(1)
    edges = np.linspace(0, 1, bins + 1); out = 0.0
    for lo, hi in zip(edges[:-1], edges[1:]):
        m_ = (conf > lo) & (conf <= hi)
        if m_.any():
            out += m_.mean() * abs((pred[m_] == y[m_]).mean() - conf[m_].mean())
    return out

K, n_val = 10, 20_000
z_true = rng.normal(0, 1.2, (n_val, K))
y_val = (rng.random(n_val)[:, None] > np.cumsum(softmax(z_true), axis=1)).sum(1)
logits = 3.0 * z_true                                            # 순위는 맞지만 확신이 3배 지나친 모형
ts = TemperatureScaler().fit(logits, y_val)
p_raw, p_cal = softmax(logits), ts.predict_proba(logits)
zy = logits[np.arange(n_val), y_val]
lhs, rhs = zy.sum(), np.sum(p_cal * logits)
nll = lambda P: -np.sum(np.log(P[np.arange(n_val), y_val]))
print(f"T̂ = {ts.T:.3f} (참 3);  NLL {nll(p_raw):.0f} → {nll(p_cal):.0f};  ECE {ece(p_raw, y_val):.3f} → {ece(p_cal, y_val):.3f};  정확도 {np.mean(p_raw.argmax(1) == y_val):.3f} → {np.mean(p_cal.argmax(1) == y_val):.3f}")
print(f"연습 8.3: Σ z_(i,y_i) = {lhs:.2f},  Σ_i Σ_k p_ik(T̂) z_ik = {rhs:.2f}")
report({"8.3절: T̂ ≈ 3 (참 온도, 0.1 안)": abs(ts.T - 3) < 0.1,
        "8.3절: 정확도는 그대로 (순위가 바뀌지 않는다)": np.array_equal(p_raw.argmax(1), p_cal.argmax(1)),
        "8.3절: NLL 과 ECE 가 크게 준다 (ECE 0.02 미만으로)": nll(p_cal) < nll(p_raw) and ece(p_cal, y_val) < 0.02 < ece(p_raw, y_val),
        "연습 8.3: 가능도 방정식 — 정답의 logit 의 합 = 예측 기댓값의 합": abs(lhs - rhs) < 1e-6 * abs(lhs)})

fig, axes = plt.subplots(1, 2, figsize=(11, 3.6))
for ax, P, title in [(axes[0], p_raw, "before (T = 1)"), (axes[1], p_cal, f"after (T̂ = {ts.T:.2f})")]:
    conf, acc = P.max(1), (P.argmax(1) == y_val)
    edges = np.linspace(0, 1, 11); mids = (edges[:-1] + edges[1:]) / 2
    rate = [acc[(conf > lo) & (conf <= hi)].mean() if ((conf > lo) & (conf <= hi)).any() else np.nan for lo, hi in zip(edges[:-1], edges[1:])]
    ax.bar(mids, rate, width=0.09, color=C["stat"], alpha=0.7, label="accuracy in bin")
    ax.plot([0, 1], [0, 1], **THEORY, label="perfect calibration")
    ax.set_xlabel("confidence (max probability)"); ax.set_title(f"reliability diagram, {title}"); ax.legend(fontsize=8)
plt.tight_layout(); plt.show()
text
T̂ = 3.001 (참 3);  NLL 52323 → 35986;  ECE 0.344 → 0.006;  정확도 0.367 → 0.367
연습 8.3: Σ z_(i,y_i) = 66095.13,  Σ_i Σ_k p_ik(T̂) z_ik = 66095.13
text
  ✓  8.3절: T̂ ≈ 3 (참 온도, 0.1 안)
  ✓  8.3절: 정확도는 그대로 (순위가 바뀌지 않는다)
  ✓  8.3절: NLL 과 ECE 가 크게 준다 (ECE 0.02 미만으로)
  ✓  연습 8.3: 가능도 방정식 — 정답의 logit 의 합 = 예측 기댓값의 합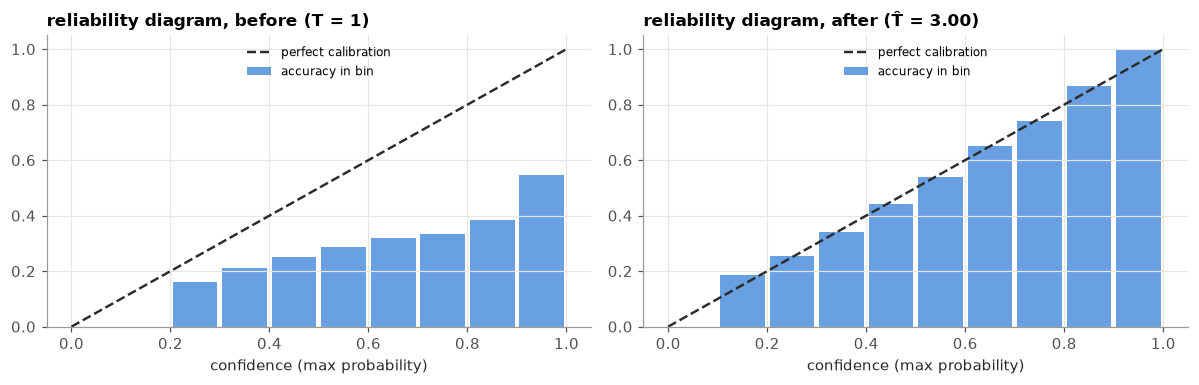
그림 읽기. 보정 전(왼쪽)에는 막대가 대각선 아래에 있다. "90% 확신"한 예측이 실제로는 그보다 덜 맞는다. 온도 하나를 MLE로 고르면(오른쪽) 막대가 대각선에 붙는다. 모수가 하나뿐인 MLE이고, 로 쓰면 로그가능도가 오목하다(지수족의 자연모수). 오목해도 Newton의 첫걸음은 크게 넘칠 수 있어서(에서 출발하면 음수로 튕긴다), 로그가능도가 늘 때까지 걸음을 반으로 줄이는 안전장치를 달았다. 4절에서 본 Newton의 약점이 여기서도 나온다.
📝 연습 8.1–8.3 (강의노트): KL과 Fisher 정보, 제곱오차와 정규, 온도의 가능도 방정식.
9. 정리 · 연습문제 지도 · 다음 회
| 내용 | 확인한 셀 | |
|---|---|---|
| 가능도와 MLE (1.1–1.6) | mle_1d와 닫힌 꼴, 불변성 , 기대 로그가능도의 최대점, 참값의 가능도가 이긴다 |
1절 |
| 정보와 한계 (2.1–2.6) | fisher_info의 두 표현, 네 추정량의 분산과 Cramér–Rao 한계, 평균제곱오차 |
2절 |
| 점근정규성 (3.1–3.3) | 증명의 분자·분모, Cauchy의 MLE 대 중앙값, Wald 구간의 정확한 포함확률, 정보 행렬 | 3절 |
| 계산 (4.1–4.4) | ScoreSolver, 이차 수렴, Cauchy의 211개 출발점, 감마의 적률법 대 MLE |
4절 |
| 검정 (5.1–5.3) | LikelihoodTests, 기병대의 세 검정과 세 구간, Wilks, 정확한 크기, 점수 = |
5절 |
| 데이터 (6.1–6.3) | 군단의 , Michelson의 정규· 적합, may의 음이항과 경계 | 6절 |
| 부숴보기 (7) | Hodges의 정확한 위험, 균등분포의 속도, Neyman–Scott | 7절 |
| 오늘 (8) | 교차엔트로피 = NLL, KL ≈ ½Iδ², 자연기울기의 불변성, EWC, TemperatureScaler |
8절 |
연습문제 지도 (강의노트, ★ 계산 · ★★ 증명 · ★★★ 도전, 풀이는 부록 A)
| 절 | 연습 | 이 노트북에서 확인하는 셀 |
|---|---|---|
| 1 가능도 | 1.1 ★ · 1.2 ★★ · 1.3 다항 ★★ · 1.4 ★ · 1.5 KL ★★ · 1.6 불변성 증명 ★ · 1.7 참값이 이긴다 증명 ★★ (유도형) | 1절 |
| 2 정보 | 2.1 ★ · 2.2 모수 바꾸기 ★★ · 2.3 ★★ · 2.4 균등 ★★ | 2절 |
| 3 점근정규성 | 3.1 ★ · 3.2 관측 정보 ★★ · 3.3 감마 ★★★ · 3.4 ★★ · 3.5 대표본 구간 증명 ★★ (유도형) | 3절 |
| 4 계산 | 4.1 ★ · 4.2 이차 수렴 ★★ · 4.3 적률법 ★★★ · 4.4 한 걸음 추정량 증명 ★★ (유도형) | 4절 |
| 5 검정 | 5.1 ★ · 5.2 ★★ · 5.3 불변성 ★★ · 5.4 Wilks ★ | 5절 |
| 6 데이터 | 6.1 ★ · 6.2 -모형 ★★ · 6.3 경계 ★★★ | 6절 |
| 7 부숴보기 | 7.1 Hodges ★★ · 7.2 ★ · 7.3 Neyman–Scott ★★ | 7절 |
| 8 오늘 | 8.1 KL ★★ · 8.2 ★ · 8.3 온도 ★★ | 8절 |
다음 회 (10회) — 숨은 변수와 EM (1894 → 1977). 이번 회차의 가능도는 직접 최대화할 수 있었다. 각 관측이 혼합분포의 어느 성분에서 왔는지처럼 자료의 일부가 보이지 않으면, 가능도가 합의 로그가 되어 다루기 어렵다. 10회는 Pearson(1894)이 적률법으로 손으로 풀었던 게의 혼합분포에서 출발한다. 보이지 않는 것을 기댓값으로 채우고 최대화하기를 되풀이하는 EM 알고리즘(Dempster–Laird–Rubin 1977)을 증명하고, 가능도가 매 단계 줄지 않음을 보인다. 7절의 Neyman–Scott 문제도 다시 본다.
10. 워크북 검산
워크북(09_mle_workbook.pdf)의 문제는 손으로 먼저 푼다. 이 절은 다 푼 뒤에 쓴다.
check("A1a", "1/3")— 문항 번호와 손으로 구한 답을 넣으면 맞는지만 알려 준다. 정답은 보여 주지 않는다. 답은 수(1/3,0.3333)나 식의 문자열("lam*exp(-2*lam)/n")로 넣는다. 그리스 문자는theta,sigma,lam으로 쓴다(lambda는 파이썬 예약어다). 소문항은"A6b"처럼 번호 뒤에 붙인다. 소수로 넣으면 상대오차 0.1%까지 맞다고 본다.- 시뮬레이션으로 한 번 더 — 정보와 극한값이 답인 문항은 아래에 시뮬레이션 함수를 정의해 두었다. 정보는 점수의 제곱의 평균으로, 극한은 큰 표본으로 잰다. 함수는 정의만 해 두었고 부르지 않았다. 답을 구하기 전에 부르면 답이 보인다.
증명 문제(B, C의 대부분)는 check()가 없다. 풀이판의 증명과 단계별로 맞춰 본다.
답 열쇠 셀 (내려받은 노트북에서 실행된다)
답 열쇠를 압축해 넣은 check() 정의 셀이다. 웹에서는 이 회차의 답 확인 페이지를 쓴다.
python
check()                 # 확인할 수 있는 문항 번호
check("A1a")            # 답을 넣지 않으면 쓰는 법을 알려 준다
text
확인할 수 있는 문항: A1a A1b A2a A2b A3a A3b A4 A5a A5b A6a A6b A6c A7a A7b A8a A8b A9a A9b A9c A10a A10b A11 A12a A12b A13a A13b A13c A14 C4c C4d C6a C6b C6c C7d D1b D1c D1d D2b D2c D3a D3b D3c D3d D4a D4b D4c D4d
A1a: 아직 답을 넣지 않았다. 예: check('A1a', '3/8')
10.1 내 답을 모아 확인하기
푼 문항의 답을 아래 사전에 채우고 실행한다. None인 문항은 건너뛴다.
python
mine = {
    "A1a": None, "A1b": None, "A2a": None, "A2b": None, "A3a": None, "A3b": None, "A4": None,
    "A5a": None, "A5b": None, "A6a": None, "A6b": None, "A6c": None, "A7a": None, "A7b": None,
    "A8a": None, "A8b": None, "A9a": None, "A9b": None, "A9c": None, "A10a": None, "A10b": None,
    "A11": None, "A12a": None, "A12b": None, "A13a": None, "A13b": None, "A13c": None, "A14": None,
    "C4c": None, "C4d": None, "C6a": None, "C6b": None, "C6c": None, "C7d": None,
    "D1b": None, "D1c": None, "D1d": None, "D2b": None, "D2c": None,
    "D3a": None, "D3b": None, "D3c": None, "D3d": None, "D4a": None, "D4b": None, "D4c": None, "D4d": None,
}
check_all(mine)
text
0/0 맞음10.2 시뮬레이션 함수
각 함수는 (추정값, 표준오차)를 돌려준다. 손으로 구한 값이 추정값 ± 3 × 표준오차 안에 들면 계산이 맞을 가능성이 높다. 정확한 검산은 check()가 한다.
| 함수 | 문항 | 시뮬레이션 |
|---|---|---|
sim_A11(theta) |
A11 의 정보 | 점수의 제곱의 평균 |
sim_A12() |
A12 균등분포의 가능도비가 3.84를 넘을 확률 | 아래의 표본 |
sim_A13() |
A13 Laplace의 | 표본평균의 분산 |
sim_C4c(lam, c) |
C4(c) 끝났는지만 볼 때의 정보 | 점수의 제곱의 평균 |
sim_D1b(lam, c) |
D1(b) 중도절단 관측의 정보 | 점수의 제곱의 평균 |
sim_D2b(k, sigma) |
D2(b) Neyman–Scott의 극한 | 사람 수가 큰 표본 |
sim_D4b(theta) |
D4(b) 의 정보 | 점수의 제곱의 평균 |
python
def _mean_se(v):
    v = np.asarray(v, dtype=float)
    return v.mean(), v.std(ddof=1) / math.sqrt(len(v))


def sim_A11(theta, n=N_SIM):
    x = rng.normal(theta, math.sqrt(theta), n)
    s = -1 / (2 * theta) + (x - theta) / theta + (x - theta) ** 2 / (2 * theta ** 2)   # 점수
    return _mean_se(s ** 2)


def sim_A12(n_obs=5, n=N_SIM):
    xmax = rng.uniform(0, 1, (n, n_obs)).max(axis=1)
    return _mean_se(-2 * n_obs * np.log(xmax) > 3.84)


def sim_A13(n_obs=50, reps=40_000):
    xbar = rng.laplace(0, 1, (reps, n_obs)).mean(axis=1)
    v = n_obs * xbar ** 2                       # 평균이 0이므로 n·X̄² 의 평균이 n·Var X̄
    return _mean_se(v)


def sim_C4c(lam, c, n=N_SIM):
    y = rng.exponential(1 / lam, n) <= c
    q = 1 - math.exp(-lam * c)
    dq = c * math.exp(-lam * c)                 # dq/dλ
    s = np.where(y, dq / q, -dq / (1 - q))      # Bernoulli(q(λ)) 의 λ 에 대한 점수
    return _mean_se(s ** 2)


def sim_D1b(lam, c, n=N_SIM):
    x = rng.exponential(1 / lam, n)
    y, d = np.minimum(x, c), (x <= c)
    s = d / lam - y                             # log λ^δ e^{-λy} 의 점수
    return _mean_se(s ** 2)


def sim_D2b(k, sigma, people=20_000, reps=20):
    est = []
    for _ in range(reps):
        mu = rng.normal(0, 5, people)[:, None]
        x = rng.normal(mu, sigma, (people, k))
        est.append(((x - x.mean(axis=1, keepdims=True)) ** 2).sum() / (people * k))
    return _mean_se(est)


def sim_D4b(theta, n=N_SIM):
    x = rng.normal(theta, theta, n)
    s = -1 / theta + (x - theta) / theta ** 2 + (x - theta) ** 2 / theta ** 3
    return _mean_se(s ** 2)
python
# 자체 검사 (출력 없음): 시뮬레이션이 답 열쇠와 맞는지, check()가 답 열쇠의 값과 그 소수를 맞다고 하는지 확인한다.
def _close(sim, key, z=4.0, **pt):
    est, se = sim
    return abs(est - _value(key, **pt)) <= z * se + 1e-12

assert _close(sim_A11(1.5), "A11", theta=1.5)
assert _close(sim_A12(), "A12b")
assert _close(sim_A13(), "A13b")
assert _close(sim_C4c(1.0, 1.0), "C4c", lam=1.0, c=1.0)
assert _close(sim_D1b(0.25, 3.0), "D1b", lam=0.25, c=3.0)
assert _close(sim_D2b(3, 2.0), "D2b", k=3, sigma=2.0)
assert _close(sim_D4b(1.7), "D4b", theta=1.7)
for _k, _e in _WB.items():
    assert _same(_e, _e["value"])
    if not _e.get("vars") and "points" not in _e:
        assert _same(_e, float(sp.sympify(_e["value"])))